

“我们目前还不敢说完全理解了这个证明。”这句话出自 OpenAI 任命的审查委员会,他们负责审核 OpenAI 声称的 Yang-Mills 成果,Scientific American 引用了这句话。这个由物理学家 David Gross 领导的小组刚刚确认,问题一半的证明在 Lean 中验证通过(Lean 是一种用来检查数学推导的编程语言)。但他们仍然说不清这个证明是怎么成立的。
我们读完了最新的 AI-for-science 材料:上面那篇文章、五篇 Anthropic 的文章、一个 OpenAI 的湿实验基准测试、TechCrunch 关于初创公司 PSI 的报道,以及一位博主的博客文章,他的 AI agent 发现了一处墨西哥官方登记册中没有的玛雅遗址。这些材料的标题,全都比实际内容夸张得多。所以我们挑出六个流行说法,逐一对照来源实际所说的内容做了核查。
说法 1:AI 现在能独立发现新科学
结论:不能独立完成。 最好的案例是真实的,但每一个案例里,都是人选定了问题、做了验证,或者两者都是人做的。
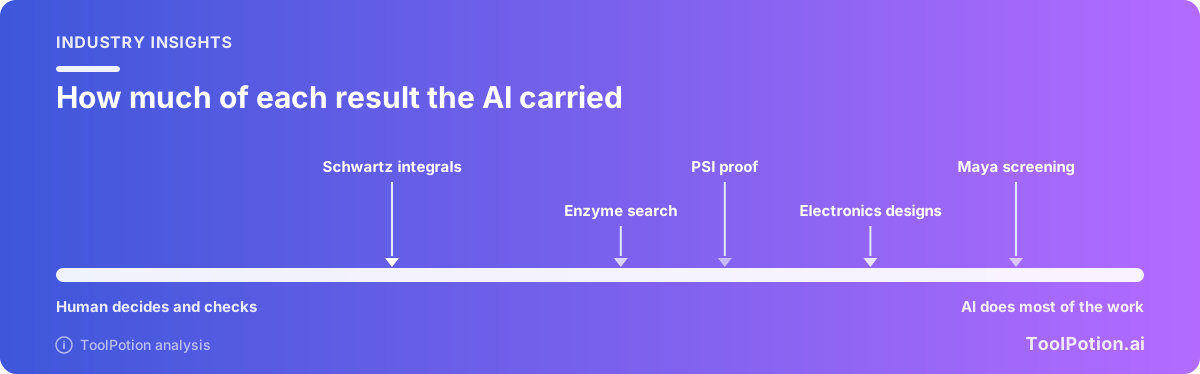
先说生物学。Anthropic 称,Claude agent 发现了一个带有类 CRISPR 重复序列的酶系统,动用了约 950 个 agent、2.1 亿 token,耗时 21 小时(Anthropic)。其中一个 agent 发现了重复模式。起始 prompt 由 Anthropic 的科学家给出,所有实验室工作也都是他们完成的,Claude 的候选结果大多在评审中被淘汰,而且文章只是预印本。关于该系统主要功能的研究仍在进行中。文中说 Claude“似乎是第一个注意到”该系统典型特征的,还说 Claude“能够自主发现异常”:这对搜索阶段是公平的,对其余阶段则不然。MIT 和 Broad Institute 的 Feng Zhang 在读完预印本后,在同一篇文章中被引用,他称这是“AI agent 如何促进生物学发现的一个令人兴奋的例子”,并表示这一发现“值得进一步研究”。
物理学家 Matthew Schwartz 是 Anthropic 的访问研究员,他比大多数人都坦率。他在 Anthropic 的一篇客座文章中,报告了用 Claude 端到端跑完 30 个积分,其中 15 个复现了已知结果,15 个是以前从未算出过的(Anthropic)。他把合适的目标称为“Claude 型”问题,并补充说:“要让它们产出有科学价值的东西,往往需要大量手把手的指导。”请外部专家加入后,他发现:“几乎所有情况下,Claude 在技术上都是正确的,但在专家帮我们把握方向之前,结果并没有多大意思。”他说,Claude“似乎偏爱那些旧争论,被高度引用却早已被遗忘的那种”。什么值得去解决,这个判断仍然留在人类手里。
再说 PSI。TechCrunch 报道,初创实验室 Physical Superintelligence(PSI)的技术人员 David Turturean,利用提前获得的 Anthropic Fable 5.2 模型使用权,解决了量子计算领域一个存在 18 年的问题,即 Aaronson-Ambainis 猜想(TechCrunch)。提出这个问题的 Scott Aaronson 写道,他不太看得懂这个证明,但相信它是对的,因为它在 Lean 中完成了自动形式化,PSI 也把它交给一组顶尖研究者审阅并得到了讲解。Turturean 自己的描述很克制:“这是一个否定性的结果,让大家知道,好,我们不用再往那个方向找了。”这个解法看起来堵上了通往量子加速的一条路,而不是全部。
我们的看法是:这是一个快速、不知疲倦的合作者,但需要别人来选问题。这已经很了不起了。但这不是自主,而且只要读到注意事项部分,这些公司自己的文章也是这么说的。
说法 2:结果已经过验证
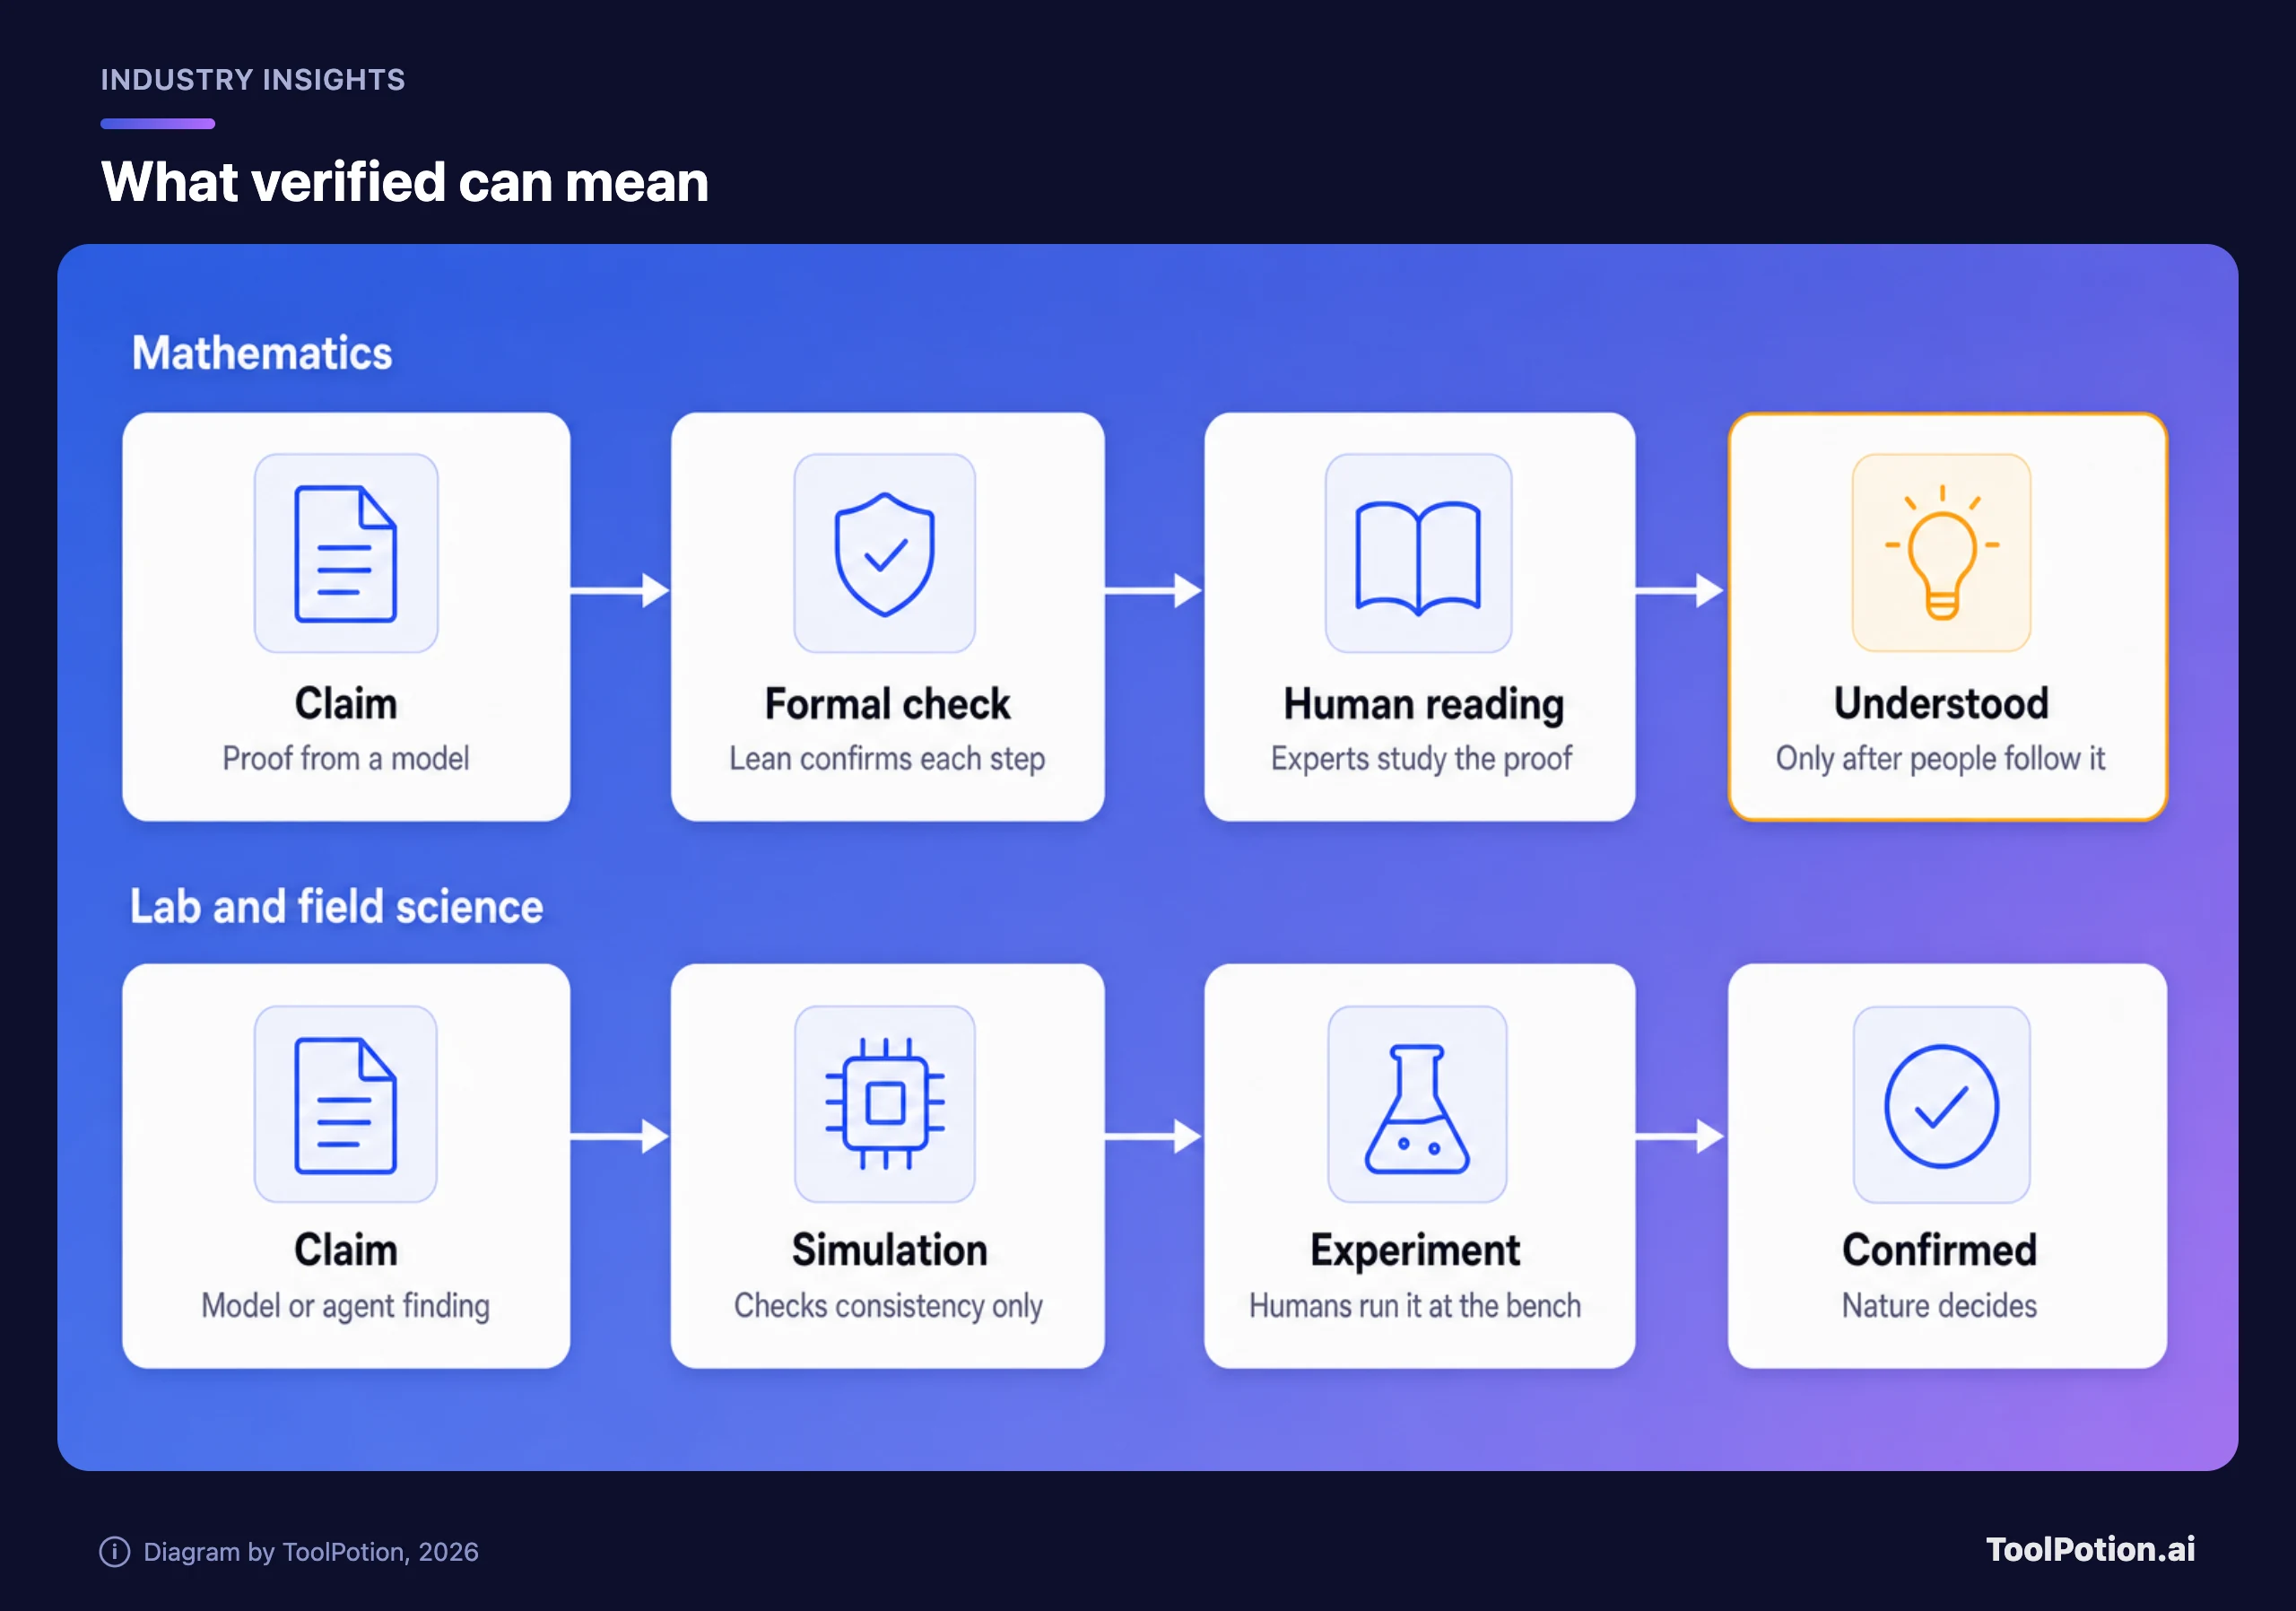
结论:部分成立。在数学中,形式化检查器是很强的检验;在其他领域,“已验证”可能指从一次模拟到一次登记册查询的任何事情。
在数学中,Lean 能机械地确认一个证明确实从给定命题推出。这是很强的检验,也正是 PSI 和 OpenAI 的结果能被认真对待的原因。但 Scientific American 的报道显示了它的局限。OpenAI 的主张涵盖的是 Yang-Mills 问题的存在性那一半;另一半质量间隙问题尚未解决。委员会借助 OpenAI 自家的 Astra 模型来消化 Lean 代码,并明确表示还不敢说理解了这个证明。
再看公开性。Scientific American 指出,这种“牧羊式”审查方式与一个隶属 OpenAI 的顾问小组提出的透明度建议相悖,也惹恼了一些数学家,他们认为这是在设门槛。Lean 证明现在已经公开。纽约大学的 Scott Armstrong 说他很高兴终于公开了,并补充道:“这种审查在公开环境下可以做得更高效、更快”(Scientific American)。我们同意他的看法。一个只有 OpenAI 指定委员会见过的证明,只是一个等待审查的说法,而审查现在终于可以开始了。
数学之外没有 Lean。PSI 的 CEO Matt Pines 对 TechCrunch 说,物理学不同于数学,因为“在你对现实的建模中,自然有投票权”,而机器驱动的理论物理“还没到,但正在路上”。Schwartz 发现“自动化检查仍然不可信”。还有玛雅那篇文章,我们稍后再说,它收到了官方回复:墨西哥研究所发现报告的位置上没有登记在册的遗址。这确认的是登记册里没有记录,并不能确认那里有遗址。
说法 3:agent 能运营一个实验室
结论:还不能。 它们能做规划、设计和分析。移液和焊接,还得人来。
Anthropic 的电子设计文章是近期最强的例子,值得通读。Claude(Fable 5.2 模型)与电路板厂商 Diode 合作(Anthropic 称与该公司有商业关系),设计了一个 USB-C 免提通话器、一个语音助手中枢和一个手持虚拟宠物,从原理图到布局再到固件全包(Anthropic)。Diode 的工程师根据 Claude 的设计文件制造了电路板,并手工搭建和测试了原型,因为 Claude 没有连接测试设备,也没有连接制造电路板的机器。这些设备还没有经过电气验证、天线调试、热测试或认证。文章还引用了基准测试的提升(在 Diode 内部的 PCB Gym 布局测试中为 69%,上一代模型为 25%),这些是 Anthropic 的数字,测试也是应其要求进行的,而且成本只出现在图表坐标轴上,正文里没有。
生物学方面,OpenAI 发布了 BioBasicsBench,一个包含 100 项任务的基准测试,据称用来衡量 AI agent 解读原始实验数据、处理日常湿实验科学的能力(OpenAI)。这是厂商自建的测试,而基准测试在厂商之外的人跑过之前,只是一个说法。
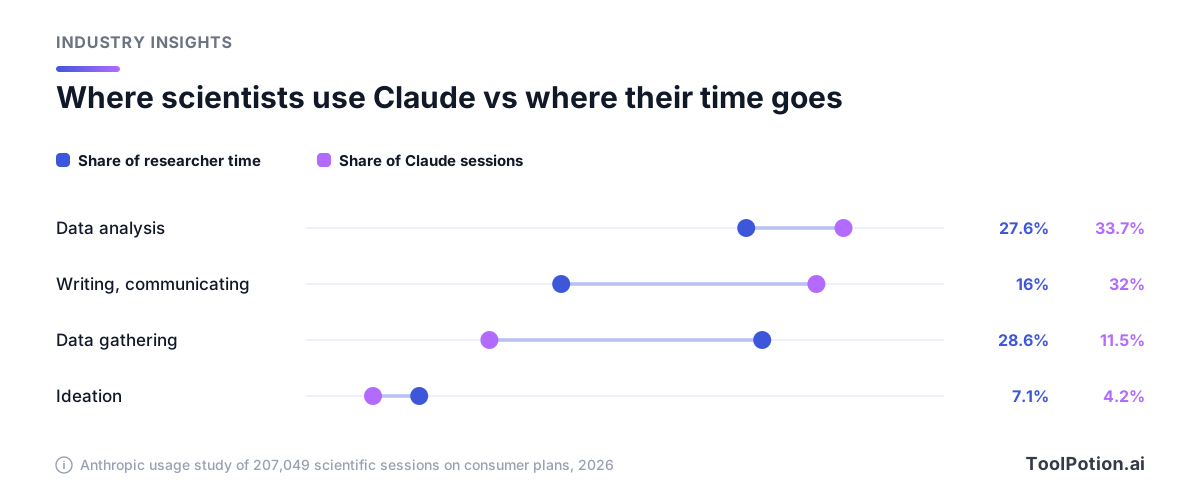
Anthropic 对消费级套餐上 207,049 个科研会话的使用研究,也显示出同样的格局。数据收集占研究者 28.6% 的时间,但只占 Claude 会话的 11.5%,在有物理障碍的地方差距最大,比如采集临床或生化数据(Anthropic)。研究原话是:“物理瓶颈依然强大。”
说法 4:现在人人都能做到
结论:人人都能开始。但要做出经得起检验的东西,得有懂这个领域的人。
玛雅这个故事是最干净的测试。Pietro Miotti 说自己不是考古学家,他让 48 个 agent 去看约 1,200 平方公里的 NASA 公开激光雷达数据,不到 72 小时就找到一处山顶遗址,有广场和金字塔,随后还收到了官方回复(他的文章)。他对方法的描述朴实得令人佩服:“没有用什么特殊模型或分类器:agent 就是真的在看图。”
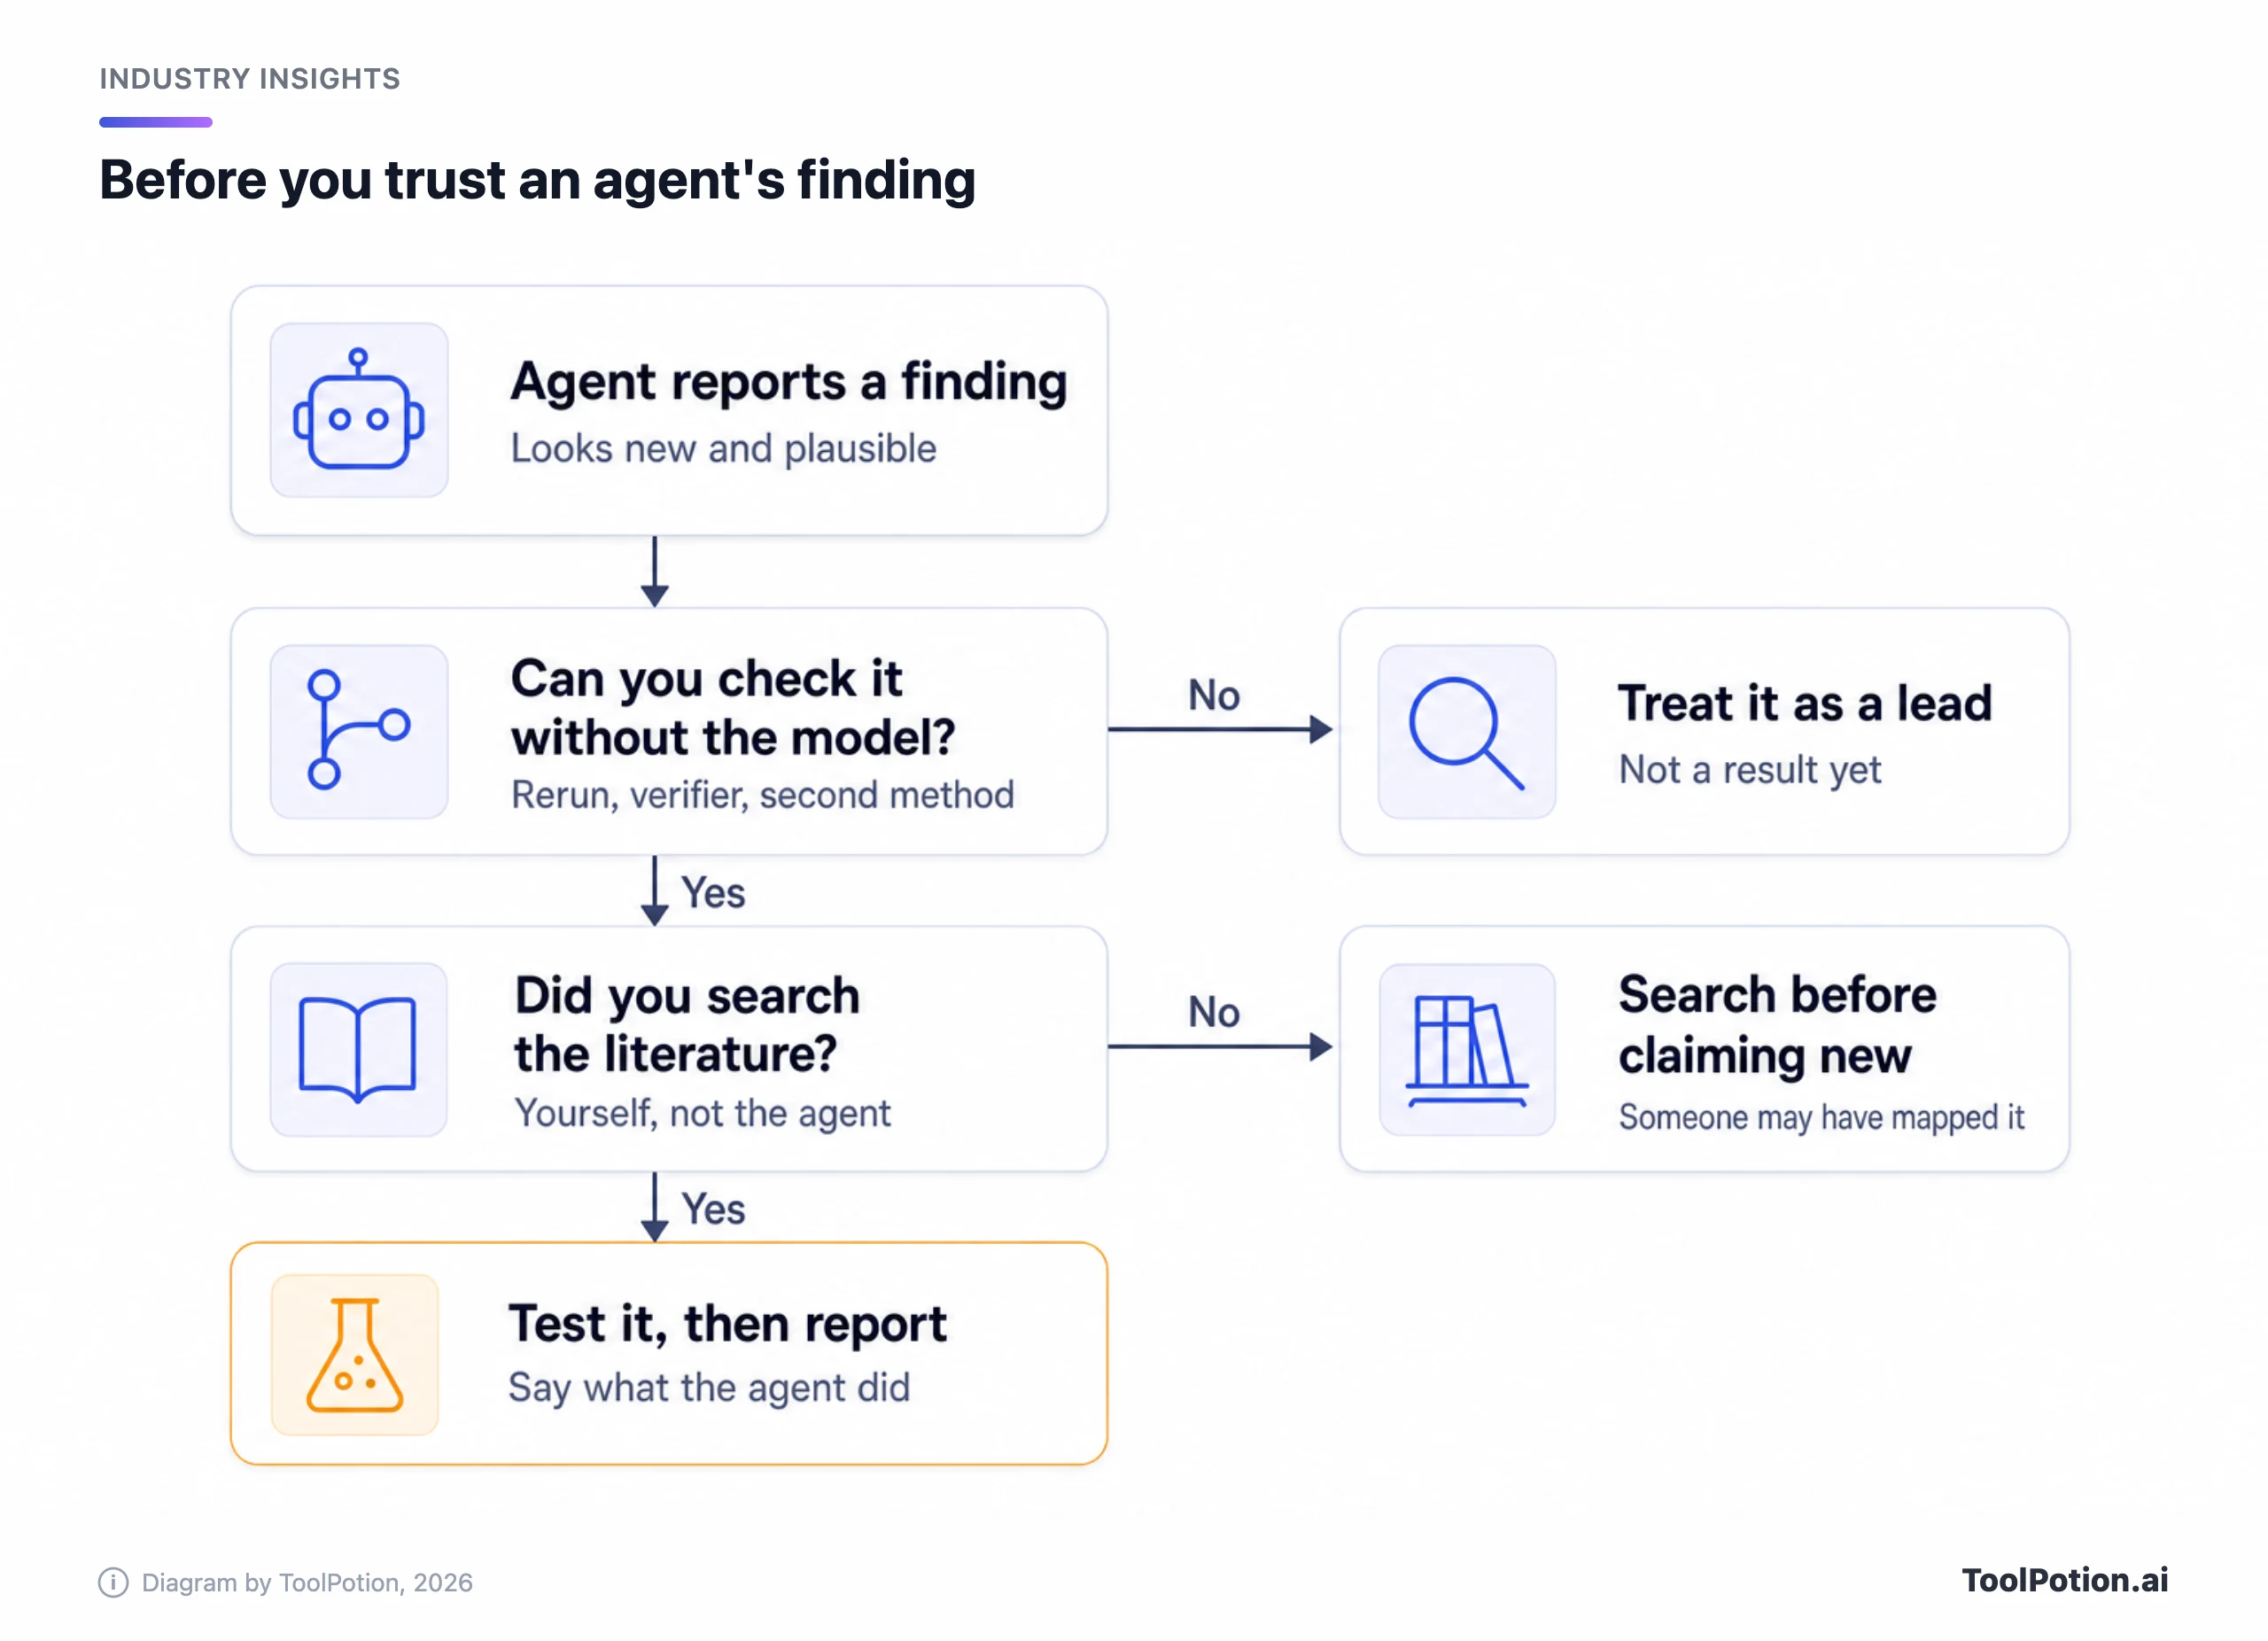
然后是更正,现在放在页面顶部。“agent 在查阅文献时漏掉了它,所以它们是重新发现了,而不是发现了。”这处遗址已经被 Estrada-Belli 等人在 2025 年的一篇论文中测绘过,只是还没进入墨西哥的登记册。Miotti 把这一点放在最前面,值得称赞。他还说自己不会西班牙语,是信任 agent 对报告的翻译;古典期的故事是“和 agent 长聊之后的推测”,复原图是 AI 生成的。文中没有提到实地勘察。
我们的看法:这是对低成本筛查的一次很好的演示,却是对“发现”的一次糟糕演示。如今“看”几乎免费了。而要知道以前有没有人看过,仍然需要专家,或者至少需要一次 agent 没做好的文献检索。PSI 的做法不同,也很有启发:它把结果压着,直到 Anthropic 的模型接近发布,并利用这段时间把成果拿给能解释它的研究者看。为 PSI 提供咨询的东北大学教授 Jim Halverson 对 TechCrunch 说:“最佳实践仍在形成中。”
说法 5:科学家即将被自动化取代
结论:未经证实,而且嗓门最大的说法来自与之有利害关系的人。
Turturean 对 TechCrunch 说:“我完全接受这样的想法:这可能是我发表的最后一篇论文。”Pines 说,六到九个月前向投资人介绍时,要说理论物理很快将主要是机器的领地,他“得有点夸大”,而现在“还没到”。Anthropic 的调查显示,528 位研究者中约 40% 预计到 2030 年 AI 能独立完成完整的研究项目,但他们是从 Anthropic 自己的 AI for Science 资助计划的申请者中招募的,所以很可能比大多数人更重度使用 AI(Anthropic)。
建模得出的数字要小一些。Anthropic 的建模认为,以当前能力广泛应用,可以承担一项新研究所需研究者时间的 27% 到 52%,这意味着产出会提升,从艺术领域的 1.35 倍到统计学的 2.02 倍不等。报告中的假设情景是 AI 自动化所有非物理工作,在统计学和计算机科学中可达约 15 倍,但在生物和化学这类实验科学中只有 3 到 4 倍,因为物理步骤仍是瓶颈。这是情景推演,不是实测。即便是保守情形,对一个领域来说也是巨大的变化。但这不是取代,报告也指出,如今 AI 的工作大多是辅助性或共同完成的。至于功劳归谁,Schwartz 说得比我们好:这个问题“不会靠假装人类的贡献只是打字来解决”。
说法 6:只要 AI 的模型能拟合数据,我们就理解了这个系统
结论:错误,而构建这些系统的作者自己也这么说。
图宾根一个团队(Jakob Macke、Daniel Gedon 和 Stefan Wahl,都是 Anthropic AI for Science 资助对象)写了一篇客座文章,讨论如何教 AI 构建科学模型,论证得很细致。许多模型都能拟合同一份数据,所以有用的产出是一组合理的模型,以及它们一致认同的内容清单(Anthropic)。他们承认,这些系统“大多只在重新发现科学家已知的模型上测试过”,而在没有已知答案的问题上证据很少。他们还写道:“一个只把模型交给你的 AI 系统,也许能给你一个答案,但不能给你理解。”
我们认为最后这句话应该贴在每张实验台和每个学生的书桌上方。拟合只是一个数字。解释则是人可以用来预测接下来会发生什么的东西。
给研究者和学生的一套做法
以上没有一条是在说别用这些工具。Anthropic 的使用数据表明,科学家已经把它们用在最擅长的地方,主要是分析和写作。下面是我们会遵循的做法,依据是上面这些案例里出过的问题。
- 把输出你自己能检查的工作交给 agent:数据分析、在不同语言之间移植代码、筛查论文或图像。Claude Code 和 Claude Cowork 就是为这类任务打造的,我们的终端编程 agent 对比则涵盖了整个领域。
- 开始之前就确定什么算检查、由谁来做。不能是同一个模型。可以是形式化验证器、第二次独立分析、一次实验台实验,或者一位同事。
- 当 agent 说某个东西是新的,你要自己检索文献。用 Elicit、Consensus、SciSpace 或 ResearchRabbit 这类专门工具,几分钟就能搞定,而玛雅案例说明了跳过这一步的代价。我们的 AI 研究助手排名里有更完整的清单。
- 物理步骤要由人来做,并留下记录。如果某个结果依赖测量、样本或实地考察,那就是它接受检验的地方。
- 写报告时,说明 agent 做了什么,以及你检查了什么。Schwartz 说得很直白:人类的贡献不是打字。
- 学生:第一个模型要自己动手建。图宾根的作者写道:“正是构建模型的过程,带来了洞见。”让 agent 来批评你的模型,而不是直接给你一个。
如果你想看 AI 做生物学的更老、也更经得起检验的例子,那仍然是 AlphaFold,它预测结构,再由实验室去验证。在文献工作和 agent 式研究方面,还有 Edison Scientific、用来武装你自己 agent 的 Scientific Agent Skills,以及 250 大研究者 AI 工具榜单。至于通用助手,ChatGPT vs Claude vs Gemini 把 ChatGPT 与它的两大对手做了对比,而 AI 研究助手和 AI agent 榜单则对专业工具做了排名。
我们的结论,以及什么会改变我们的看法
真实的部分:agent 现在已经是有用且不知疲倦的分析师和工程师。电子原型能用,酶的线索很有意思,模型给出、经 Lean 检查的证明是一个真实的成果,不管最终谁先理解它。Schwartz 的 15 个新积分,是一个狭窄领域里的真实成果。
夸大的部分:自主性、被随意使用的“已验证”,以及即将到来的自动化科学家浪潮。上面几乎每一个亮眼的结果,都有人在回路里负责判断它是否为真的那一部分,而且这些人自己也这么说。我们还希望实验室把美元成本印在基准测试分数旁边。积分额度和 token 数字掩盖了一项发现的真实成本,而为一次酶搜索花掉 2.1 亿 token,是实验室预算会在意的数字。
有两件事会改变我们的看法。一是 OpenAI 委员会之外的数学家读了 Yang-Mills 的 Lean 代码,并报告说他们理解了它。二是酶研究出一个经过同行评审的版本,说明这个系统到底做什么。在此之前,我们把这两项都看作有前景但尚未完成。