

Anthropic 的工程师曾让一个主 agent 给子 agent 下达"调研半导体短缺"这样的简短指令。结果子 agent 们理解岔了:一个去查 2021 年的汽车芯片危机,另外两个则重复研究 2025 年的供应链(Anthropic Engineering)。系统没有崩溃,每个 agent 面对一个可以有多种理解的模糊请求,都做了合情合理的事。
我们大多数人把活交给 ChatGPT、Claude、Gemini CLI 或某个终端编程 agent 时,都在重复同样的错误:敲一句任务,就当它是简报。下面会讲简报需要的六个部分、三组可以直接借用的改写、一份模板,以及一张简报失败方式的对照表。我们的几个观点会边讲边论证:先写完成标准那一行;把"拿不准就问我"换成一份明确列出的动作清单;少用满屏的大写字母。文中引用的官方文档,有的支持这些观点,有的没有涉及,我们会逐一说明是哪种情况。
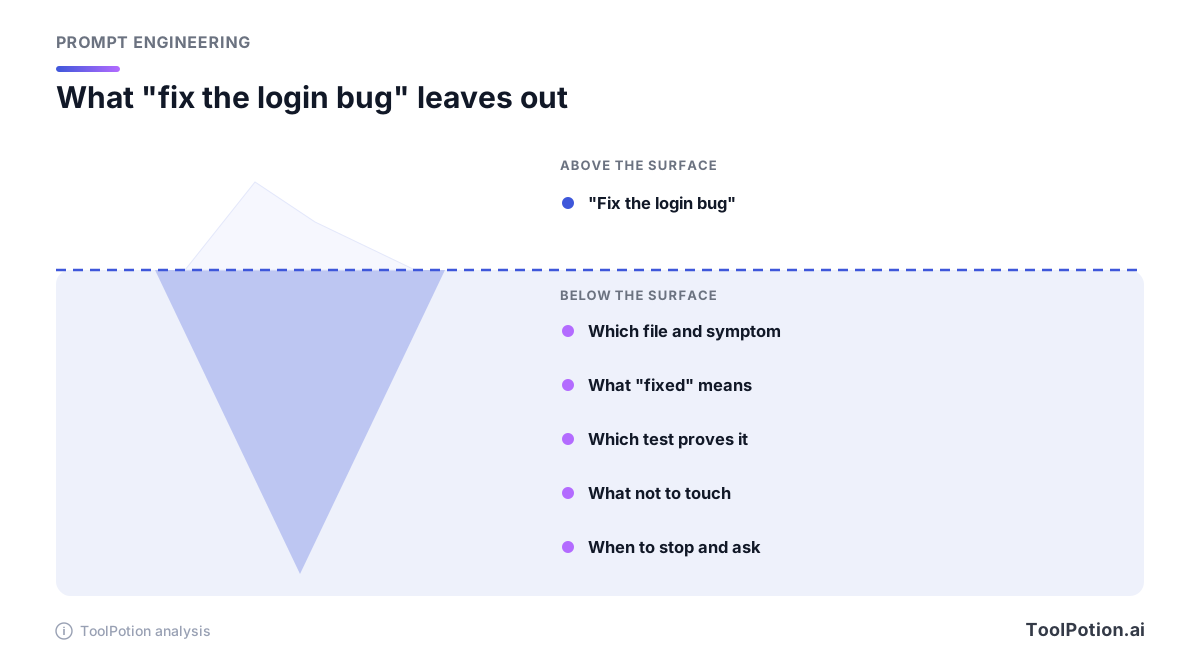
任务不是简报
任务只点出一项活动,简报则把做事的人原本得靠猜的东西全部交代清楚。Anthropic 的提示词指南把它比作新员工:"把 Claude 想象成一位聪明绝顶、但刚入职、不了解你们规范和工作流程的新员工。"(Anthropic docs)OpenAI 则按模型类型划了类似的线:推理模型"像资深同事",你给它一个目标,它自己会把细节想清楚;GPT 模型"像初级同事",需要"明确的指令才能产出特定的结果"(OpenAI docs)。
OpenAI 说推理模型擅长处理高层次的指引,但如果任务要跑几十步、还带副作用,我们不会这么放心。资深同事也无从知道"做完"在你心里是什么样子;初级同事猜错,代价不过是一封邮件。而 agent 一旦理解错了,后面每一步都会照着错的继续做,Anthropic 的主 agent 就是例子。
Anthropic 给了一个我们很喜欢的测试,因为只要两分钟:"把你的提示词拿给一位对任务几乎不了解的同事,请他照着做。如果他会困惑,Claude 也会。"(Anthropic docs)如果一个外包看了你的消息,不发五个问题过来就没法动手,那 agent 也会自己悄悄回答这五个问题,而你只能从结果里才发现。
先写完成标准,再写别的
Claude Code 自己的最佳实践页面说得很直白:"Claude 会在工作看起来做完时停下。"如果没有可运行的东西来判断活到底干完没有,页面接着写道:"实际上这会让你自己变成测试套件,每个错误都会一直留在那里,直到你碰巧发现。"(Claude Code docs)
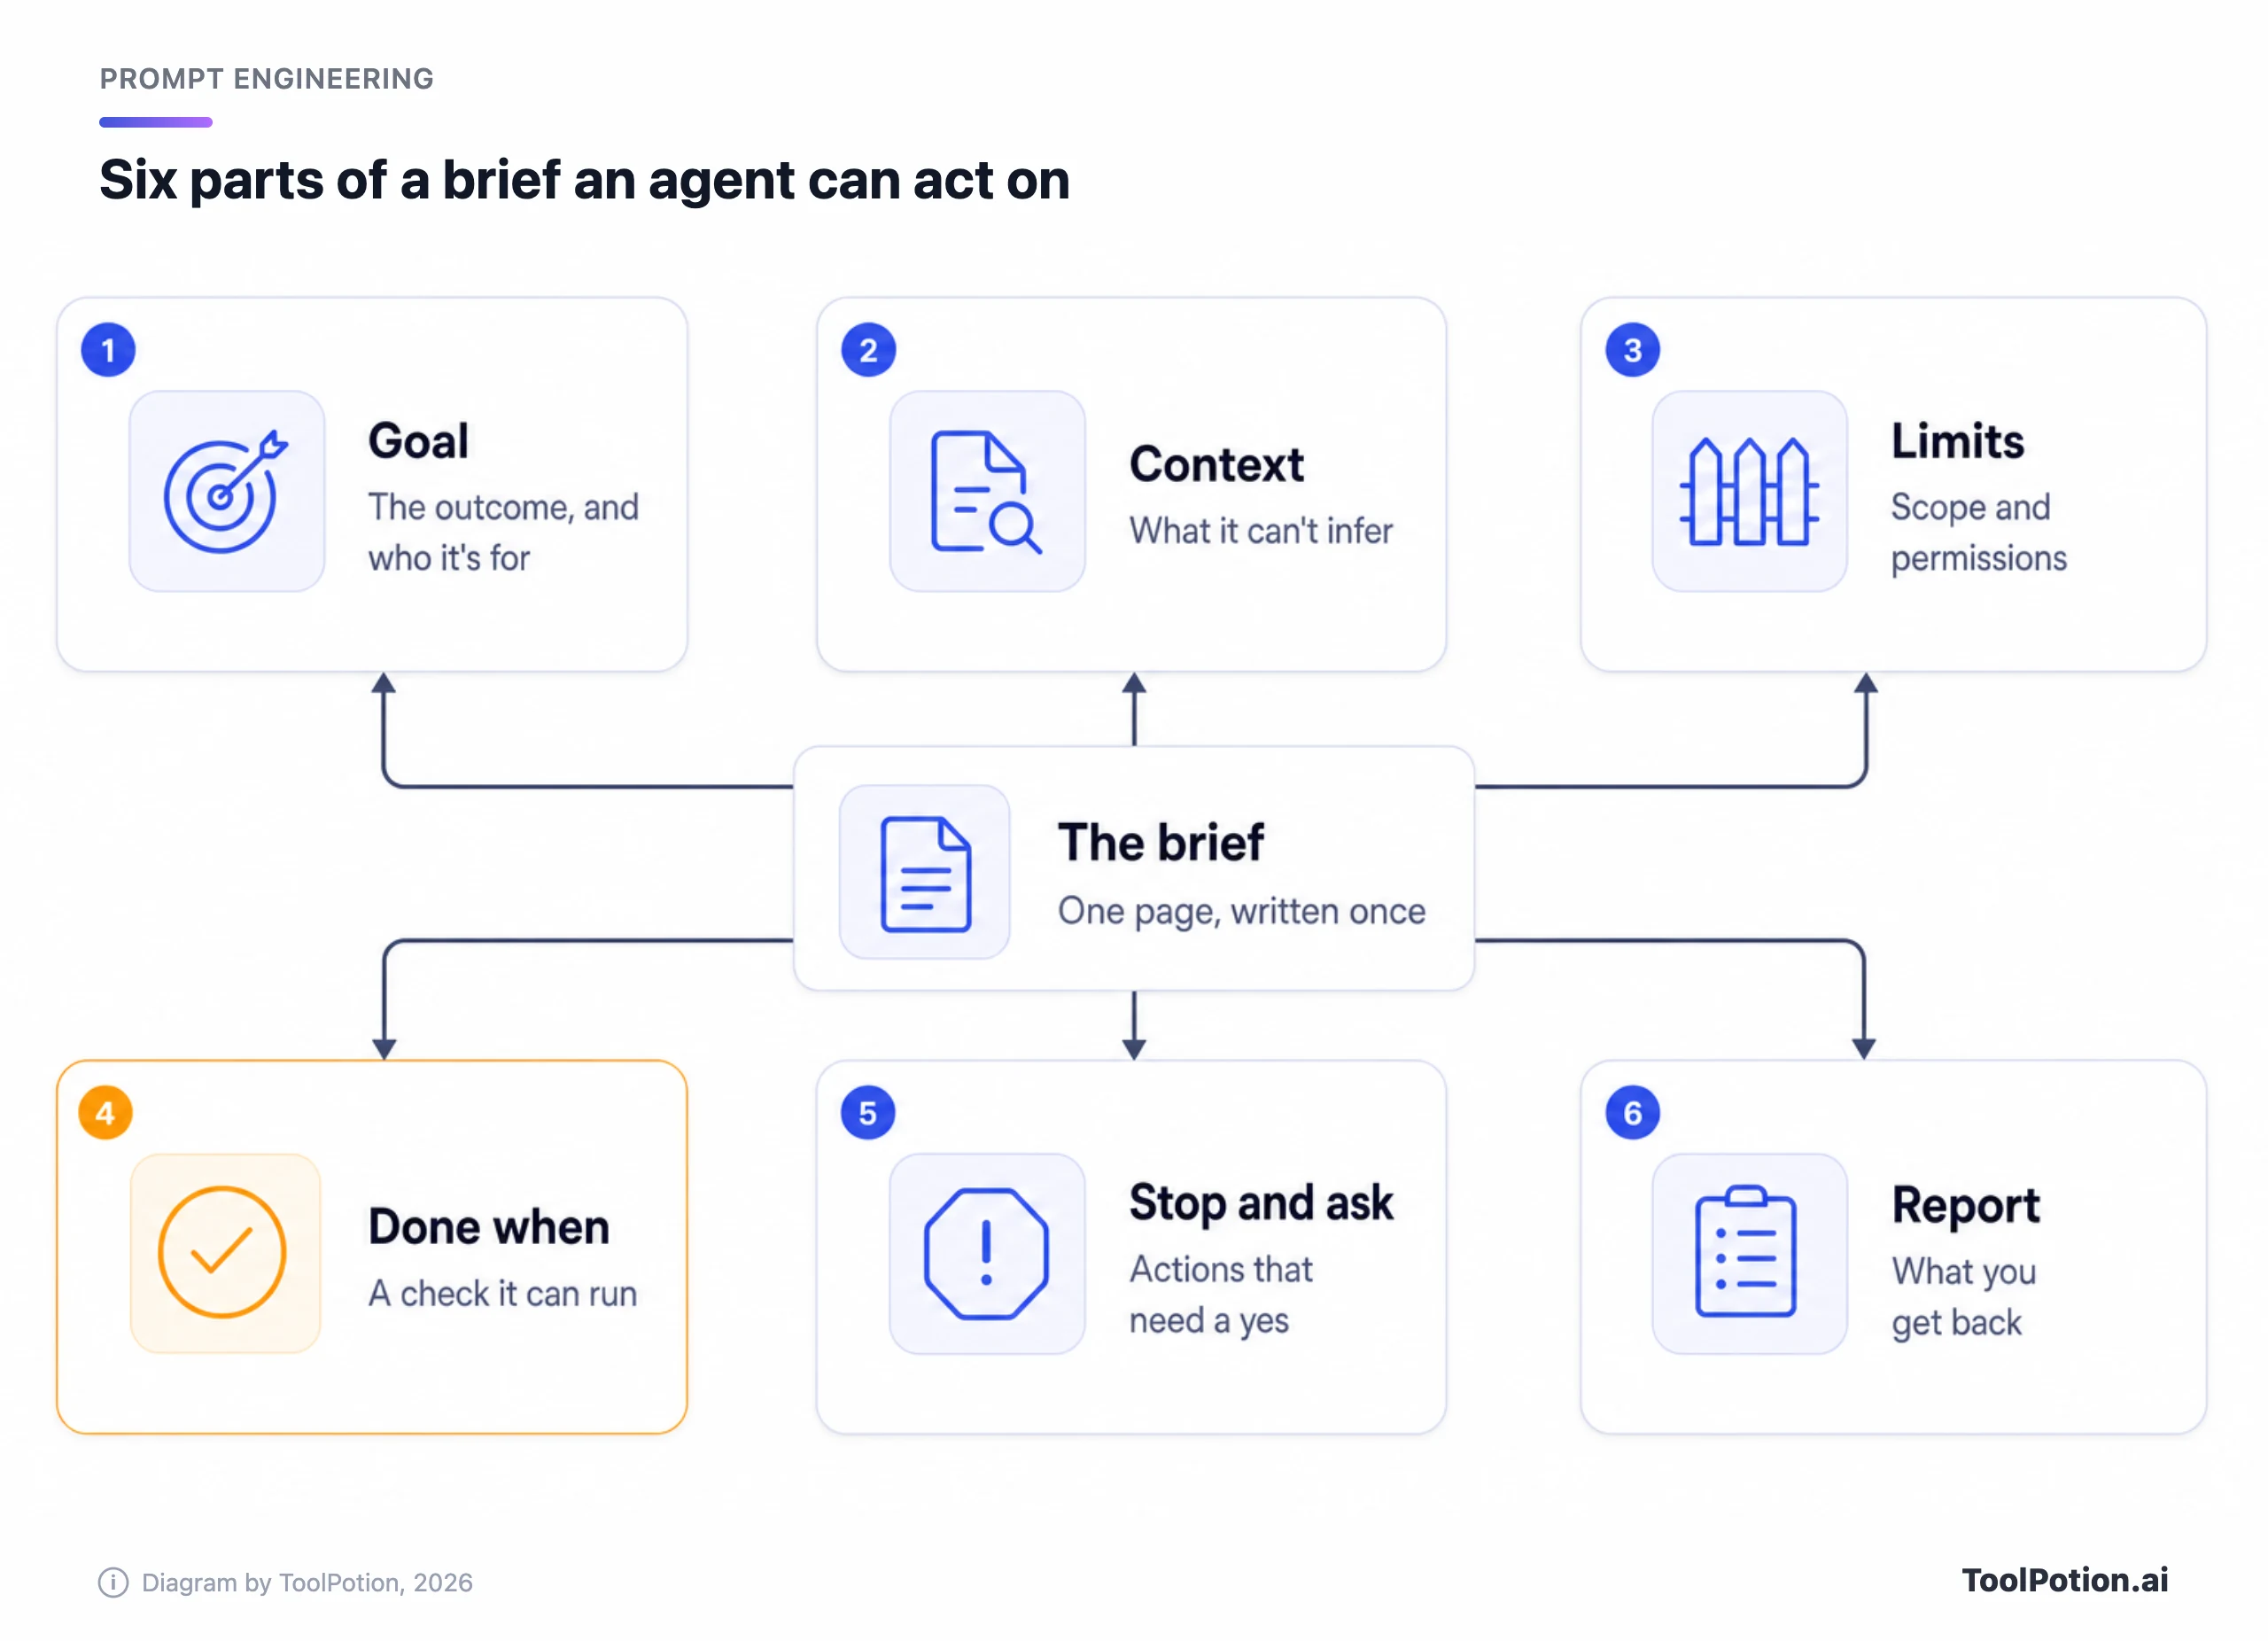
OpenAI 的 Codex 指南从另一个角度说的是同一件事。它建议在 prompt 里写四样东西:目标、背景、约束,以及"Done when"(完成标准),后者被表述为一个问题,问的是任务完成前应当满足什么条件,"比如测试通过、行为发生变化,或者某个 bug 不再复现"(OpenAI Codex docs)。两家厂商、两个产品、同一副骨架。我们另外加了两部分(该停就问、汇报)。而且即便完成标准在成品简报里排第四,我们也会先写它,因为写它的过程会逼你想清楚自己到底要什么。
在代码之外,同样这一行也管用,只是检查方式不同。"一张包含十二家供应商的表格,每个价格旁边附来源链接,非公开价格要标记出来",agent 是可以数得清的;"一份全面的对比",它只能凭感觉。
简报的六个部分,从上到下
目标:写明结果和谁来用
一两句话就够。说清你最终想要什么,以及它会用在哪里:一份两位合伙人五分钟内要读完的建议、一个周五上线的修复、一份采购用的候选清单。去向不同,agent 取舍的内容就不同。"调研一下定价"得到的是一大堆信息;"推荐一款每席位低于 $15 的工具"得到的是一个结论。
背景:它自己找不到的信息
Claude Code 的文档给了一个好用的筛选标准:"它能通过读代码自己找到吗?它真的会去找吗?如果两个答案都是肯定的,就别写。"(Claude Code docs)该留下的是:没有进入代码库的会议决定、agent 应该使用的账号、你已经试过又放弃的工具、读者的水平。
规则背后的原因也要交代。Anthropic 的指南说,指令背后的背景或动机"能让 Claude 更了解你的目标,给出更有针对性的回答",而它给出的较弱写法示例,就是一句干巴巴的"NEVER use ellipses"(Anthropic docs)。
限制:哪些在范围内,哪些碰不得
agent 往往会做得比你要求的更多。Anthropic 的指南说,Claude Opus 4.5 和 4.6 倾向于"创建多余的文件、添加不必要的抽象,或者加入没人要求的灵活性",并给出了一条示例指令,其中包括"Don't add features, refactor code, or make \"improvements\" beyond what was asked."(Anthropic docs)指南把这个习惯归在这两个模型身上,所以请对照你实际用的模型自己验证。不管用哪个,我们都会借用这句话。然后再加上你自己的清单:它可以动哪些文件夹、可以用哪些来源、不能登录哪些账号。
Google 的 Gemini 指南把风险评估列为 agent 提示词可以控制的设置之一,并说可以明确区分低风险的探索性操作(读)和高风险的状态变更(写)(Google AI docs)。有用的就是这个划分:读取和运行测试不需要批准;删除、发送和付款才需要。
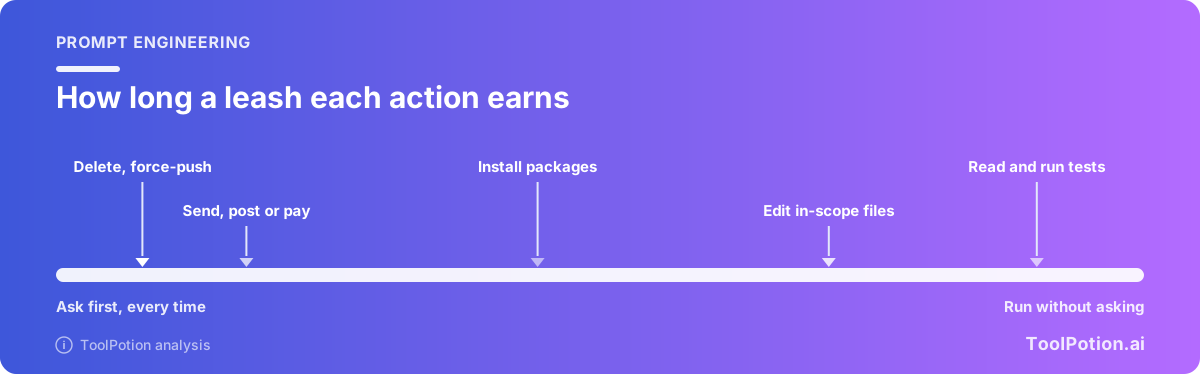
在你依赖这些做法之前,先说一个提醒。简报里的话只是请求,而沙箱、只读 token 或权限规则才是强制约束,两者不能互相替代。我们那篇约束 AI agent的指南讲的是强制约束这一侧;本文只讲你该怎么写。
完成标准:一个它能运行的检查
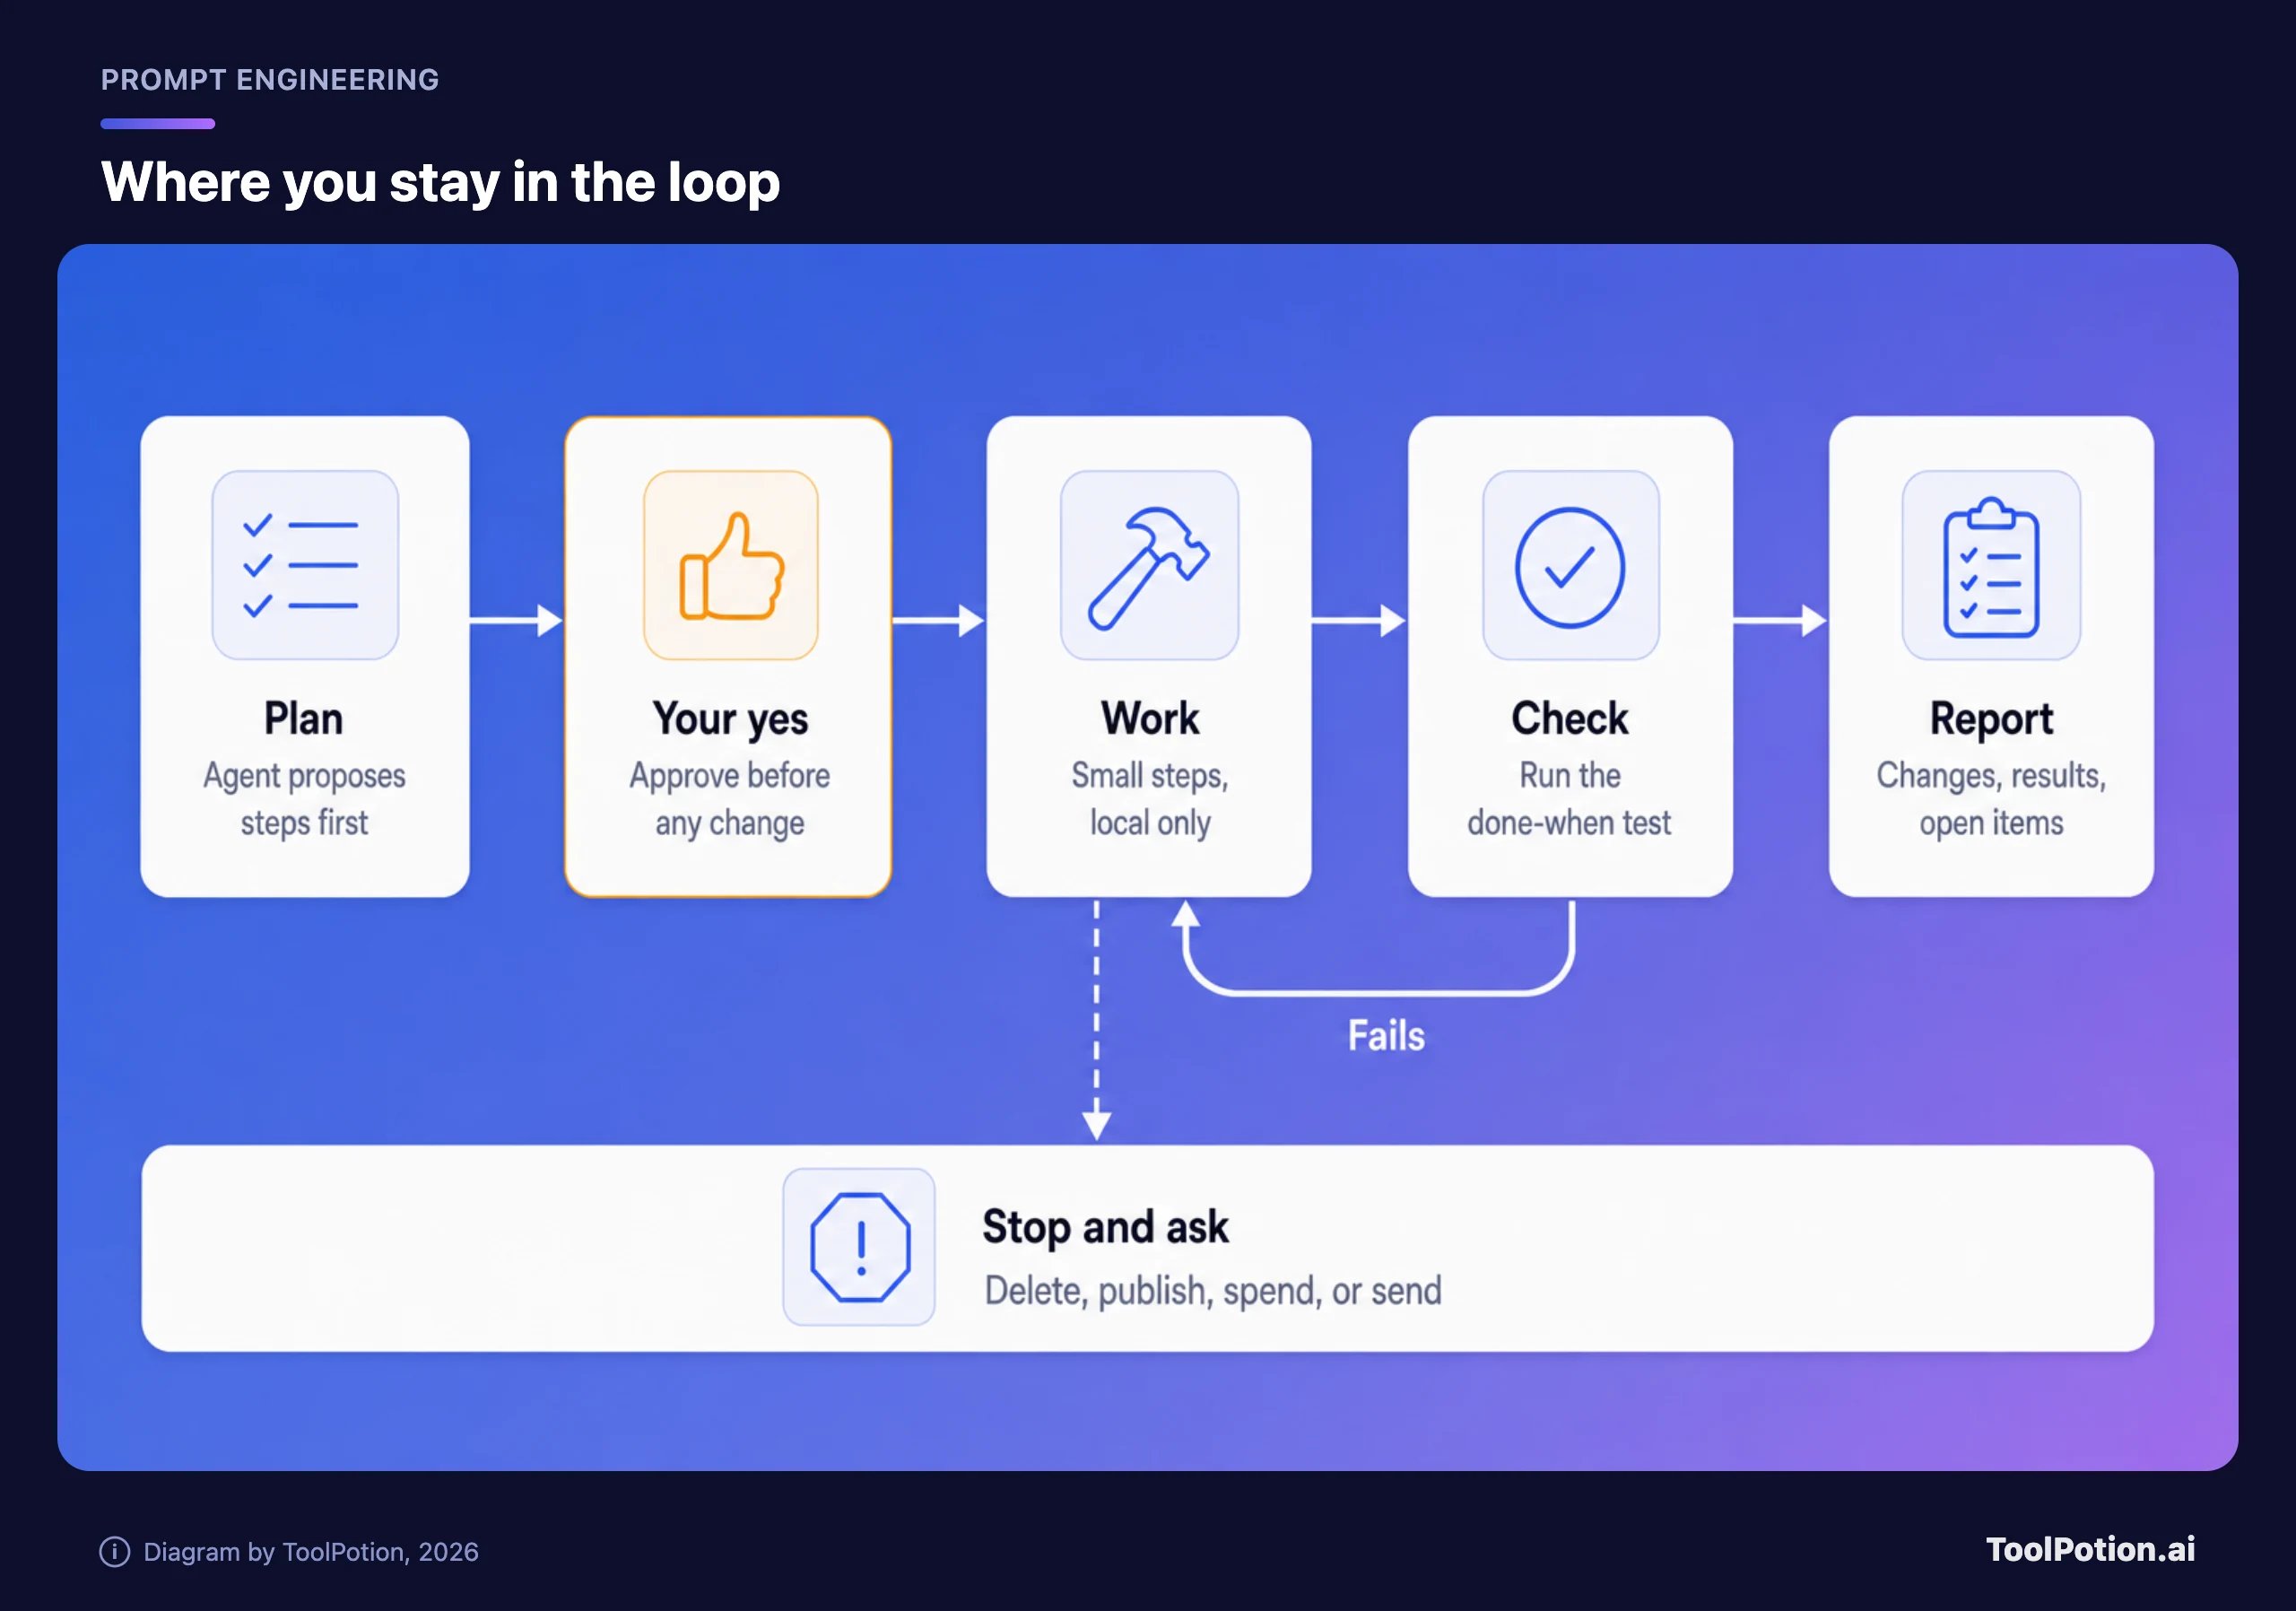
写明命令、数量或文件。"测试通过"只是个开头。"pnpm test 通过,并且新增一个测试,证明一分钟内第 101 个请求会返回 429",这才是一个检查。对于调研类任务,要说清楚要多少条、哪些字段,以及某个字段找不到时该写什么。如果检查不通过,要告诉 agent 接下来怎么办,并且设上限。Google 的指南指出,"高持续性能提高成功率,但可能带来更高的 token 成本或陷入循环",所以"失败的测试重试两次,然后停下来汇报",比什么都不说要好(Google AI docs)。
该停就问:写成动作清单,而不是一种态度
"拿不准就问我",等于让 agent 自己做一个判断,而一个积极的 agent 很少会"拿不准"。不如把动作列出来。Anthropic 的指南里正好有一个示例 prompt,是为 Claude Opus 4.6 写的:对于"难以撤销、影响共享系统或可能具有破坏性的"操作,"先询问用户再继续",示例包括删除文件或分支、git push --force 和发送消息(Anthropic docs)。不管你用什么模型,这份清单都是我们会照抄的部分。
Anthropic 那篇讲 agent 设计的文章描述了这个模式:agent"可以在检查点或遇到阻碍时暂停,等待人类反馈"(Anthropic Engineering)。把第一个检查点设成计划:让它在做任何改动之前先给出步骤,你读完再说"开始"。这只多花一个来回,而我们认为这是最便宜的检查点。
汇报:说明要带回什么
要求它交代:做了哪些改动、跑了哪些检查及结果、它做了哪些假设,以及它选择不做什么。最后一项是大家最容易忘的。agent 就是在这里告诉你,它跳过了迁移,因为你说过不要动 schema。
三份简报,前后对比
下面每份改写大约 120 到 150 字。比一般的 prompt 长,但比大家担心的要短。三份简报都是我们自己编的例子:任务、工具和数字都是为说明而虚构的,没有一个来自厂商或真实项目。
调研 agent(虚构示例)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.编程 agent(虚构示例)
Claude Code 的文档里就有一组前后对比:"add a calendar widget"变成了一条请求,要求参照现有某个 widget 文件里的模式来做,并且"不引入新库"(Claude Code docs)。下面是同样的做法用在一个更大的任务上,适用于 Claude Code 或 Codex。
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.收件箱 agent(虚构示例)
这份适用于任何你准备让它碰邮件的助手,也就是 Manus 和 Claude Cowork 这类 agent 产品主打的活儿。邮件这种地方,"整理一下"很容易悄悄变成"删掉了"。
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.前后两版的目标那一行几乎没变,分量全在最后四行:一个检查、一个停止条件、一份汇报,以及一条写明 agent 绝对不能做什么的限制。
可直接粘贴的模板
不适用的行可以删掉,但要有意识地删。
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
用它给你自己的草稿打分。八个是非题,三十秒。
简报是怎么失败的,我们会怎么改
| 失败原因 | 你会看到什么 | 怎么改 |
|---|---|---|
| 目标只是一项活动 | 输出好几页,却没有结论 | 写明输出的去向 |
| 没有完成标准 | 停在"看起来做完了",或者根本不停 | 加一个它能运行的检查和重试上限 |
| 范围没有说明 | 多出来的文件、重构、没人要的改进 | 列出哪些碰不得 |
| 只有警告,没有原因 | 满屏 NEVER,要么被无视,要么被用过头 | 用一个从句补上原因 |
| 批准只是默认 | 它凭自己的判断删除、推送或发送 | 列出具体动作,并要求先出计划 |
| 纠正越积越多 | 指令之间互相矛盾 | 重写简报,重新开始 |
其中两项值得多说几句。第一是满屏的大写。我们怀疑,加强语气从来没能弥补缺失的原因,Anthropic 的指南也是这个方向:一句干巴巴的"NEVER use ellipses"就是它举的较弱示例。Claude Code 的文档还补充说,"think step by step 或 be thorough 这类短语只是普通的提示词文本,并不是关键词"(Claude Code docs)。基于这一点,我们会删掉"要全面"这类套话。Anthropic 的指南确实建议给 Claude 设定一个角色,哪怕只有一句话,所以我们不会一刀切禁止;但"世界级专家"这种人设我们会省掉,因为这六个部分告诉 agent 的信息,已经比一个头衔多得多。
第二项是反过来的问题。OpenAI 指南里的示例 agent prompt(展示的是它的 gpt-6-astra 模型,只是示例,不是规则)要求模型"keep going until the user's query is completely resolved",并且说"Do not stop after completing only part of the request"(OpenAI docs)。对终点明确的任务,这很合理;对终点不明确的任务,就是个陷阱。目标模糊又很执着的 agent,可能在循环里不停烧 token;Google 的指南对高持续性也是这么说的。Anthropic 的文章则说,通常会加入"停止条件(比如最大迭代次数)"来保持控制(Anthropic Engineering)。
还有一个我们会戒掉的习惯:把简报贴进一个已经堆了十条纠正的对话里。这样 agent 手里有十一套指令,却没法给它们排优先级。
盯住第一分钟,然后重写
Claude Code 的文档建议:"盯住第一分钟,Claude 一跑偏就立刻按 Esc;纠正两次还不行,就运行 /clear,重写一个更好的 prompt,而不是纠正第三次。"(Claude Code docs)我们觉得这适用于任何 agent:第一份计划和最初几个动作,就能看出你的简报是不是被按你的本意读懂了。
如果你一时还写不出简报,可以让 agent 来采访你。Claude Code 的文档建议用类似这样的 prompt:"Interview me until you could write the spec, then write it to SPEC.md",而 Codex 的指南则说,让它先向你提问,并"质疑你的假设"(Claude Code docs,以及 OpenAI Codex docs)。然后基于写好的 spec 开一个新会话。
能用两次以上的简报,值得给它一个固定的归宿。长期有效的规则(怎么跑测试、哪些东西绝不能碰)放进 AGENTS.md 或 CLAUDE.md 文件;OpenAI 说,"一份简短而准确的 AGENTS.md,比一份充满模糊规则的长文件更有用"(OpenAI Codex docs)。你会反复用的流程可以做成 skill,这个话题我们在从 Prompt 到 Skill里讲过。至于一开始该往会话里加载什么,是我们上下文工程那篇的主题;让 prompt 在模型更新后依然有效的习惯,则见经得起模型更新的 Prompt 模式。围绕这类委派打造的工具,可以看我们的 AI agent、构建 agent 的任务和 prompt 工程工具榜单。
常见问题
简报该写多长?
够装下这六个部分就行,大多数任务是 100 到 200 字。长期偏好应该放进规则文件,这样每份简报只需要覆盖当前这个任务。如果简报超过一页,这个任务多半该拆成两个。
ChatGPT、Claude 和 Gemini 需要不同的简报吗?
骨架是一样的。OpenAI Codex 指南里的四个部分、Anthropic 提供背景并在高风险操作前先问的建议,以及 Google 的 agent 维度(处理歧义、风险评估、持续性),用不同的措辞说的是同一组需求。格式上略有差别:Google 的指南推荐使用 XML 风格的标签或 Markdown 标题,并说要"选定一种格式并始终如一地使用"(Google AI docs)。哪个助手更适合哪类任务,是另一个问题,我们在 2026 年的 ChatGPT vs Claude vs Gemini里讨论过。
agent 拿不准时,该让它怎么做?
给它一条能直接套用的规则。"凡是可逆的操作就先假设可以做,并在汇报中列出;不可逆的先问我",比"拿不准就问"管用。Google 的指南把同一个选择表述为:模型什么时候可以做假设,什么时候必须暂停并请求澄清或许可。
一份好简报足以保证 agent 安全吗?
不能。简报能减少错误,但防不住任何一个错误。Anthropic 建议"在沙箱环境中进行大量测试,并配以适当的防护措施"(Anthropic Engineering),我们的约束指南则讲了权限和审计记录。
agent 还是做错了,怎么办?
找到它第一次偏离方向的那一步,看看简报里对这一步是怎么说的。补上那一行本可以避免问题的话,然后在一个全新的会话里重跑。