

一位学生向研究人员讲起一些同学,他们会在同学之间坦然承认:"这整篇文章都是我用 ChatGPT 写的。"这位学生的下一句话让我们印象很深:"然后他们没被抓到,多半还拿了个好成绩,因为第一次成功了,下次作业他们就接着这么干"(OfS 与 Advance HE 报告)。
这句话出自英格兰高等教育监管机构 Office for Students(OfS)与慈善机构 Advance HE 联合发布的一份报告。报告标题很温和,叫 Making AI work for students,但它在评估方面的结论一点也不温和。学生在家无人监督完成的课程作业,只要开着一个 ChatGPT 标签页,往往不怎么投入就能做到很高的水准,有时只要几分钟,而批改的人经常看不出来。
我们读的是报告原文,而不只是媒体报道,因为 Guardian 的标题和监管机构自己的措辞并不一致,报告本身要谨慎得多。最有价值的部分恰恰最不戏剧化:一些大学已经在怎么应对。
监管机构发现了什么,没发现什么
这项研究在今年早些时候进行,基于与 300 多名学生和教职员工的交流。Guardian 称其中涉及 127 所大学和学院(The Guardian);OfS 的摘要页写的是"120 多所机构"(OfS),报告的方法部分则说至少 127 所(报告)。这是访谈和问卷证据,主要来自英格兰的院校。没有人统计过有多少评估是由 AI 完成的,OfS 表示会开展进一步研究,"以确定变化的规模和性质"(OfS 新闻稿)。在那之前,任何关于 2026 年英格兰的百分比数字都只是猜测。
参与者的描述则相当一致。无人监督的评估"用 AI 工具就能在学生投入有限的情况下达到很高的水准",而通过远程提交论文来评估的专业被认为尤其脆弱(报告)。学生告诉研究人员,有同学"有时只花几分钟"就交了作业,拿到的成绩和自己动手做的人差不多。有些同学甚至想不起刚提交的内容里最基本的细节。教职员工则说,他们收到大量看起来一模一样的提交,引用同样的文献,文风也相同。
一位参与问卷的学生用个人感受说出了代价。"我自己构思、自己写完一篇文章,却和用 AI 写的人拿到一模一样的分数,这让我非常不安。"诚实的学生吃了亏,我们认为这一代价应该放在首位。
关于标题要说明一点。"close to impossible"(几乎不可能)是一位教职员工受访者的说法,完整的句子比 Guardian 的标题要窄:普遍使用 AI "可能使我们在某些领域对学生的评估几乎不可能进行"。监管机构自己的总结则说,AI 对"评估的效度和有效性构成重大风险"。我们认为后一种说法更准确,而它本身已经足够令人警惕。
报告还提到了公平问题。参与者担心,付费使用最先进模型的学生,可能比知识水平相当、却用着更便宜模型或根本不用 AI 的同学拿到更高的分数(报告)。
手握工具、并表示会动用的监管机构
OfS 战略与实施总监 Josh Fleming 称,高等教育中的 AI 使用是"对现有体系的一种代际风险,有可能削弱学生的学习,也削弱院校评估学生的能力"。他补充说:"我们需要看到应对这些风险的力度大得多,包括大幅增加免 AI 评估的使用"(OfS 新闻稿)。
真正有分量的是新闻稿里的内容:OfS 表示将要求院校确保评估是对知识和技能有效且可靠的衡量,并称"在很多情况下,这将需要使用安全(免 AI)的评估"。对于做不到的院校,OfS 可动用的手段包括附加具体的注册条件、罚款,或暂停其获得学生资助经费和 OfS 拨款的资格。OfS 在发布报告的同时,还发布了院校如何合规的指引。
英国教育部对 Guardian 表示,期望 OfS"既有效执行现有标准,又加快推进"AI 方面的工作。代表 147 所院校的 Universities UK 回应说:"还有很多事要做,但许多院校已经做出了实质性改变"(The Guardian)。参与者此前也警告过,新增针对 AI 的注册条件可能适得其反,转而希望对现有条件给出明确说明(OfS)。OfS 选择了后者:发布现有条件如何适用于 AI 的指引。
三种解法,以及监管机构更倾向的那一种
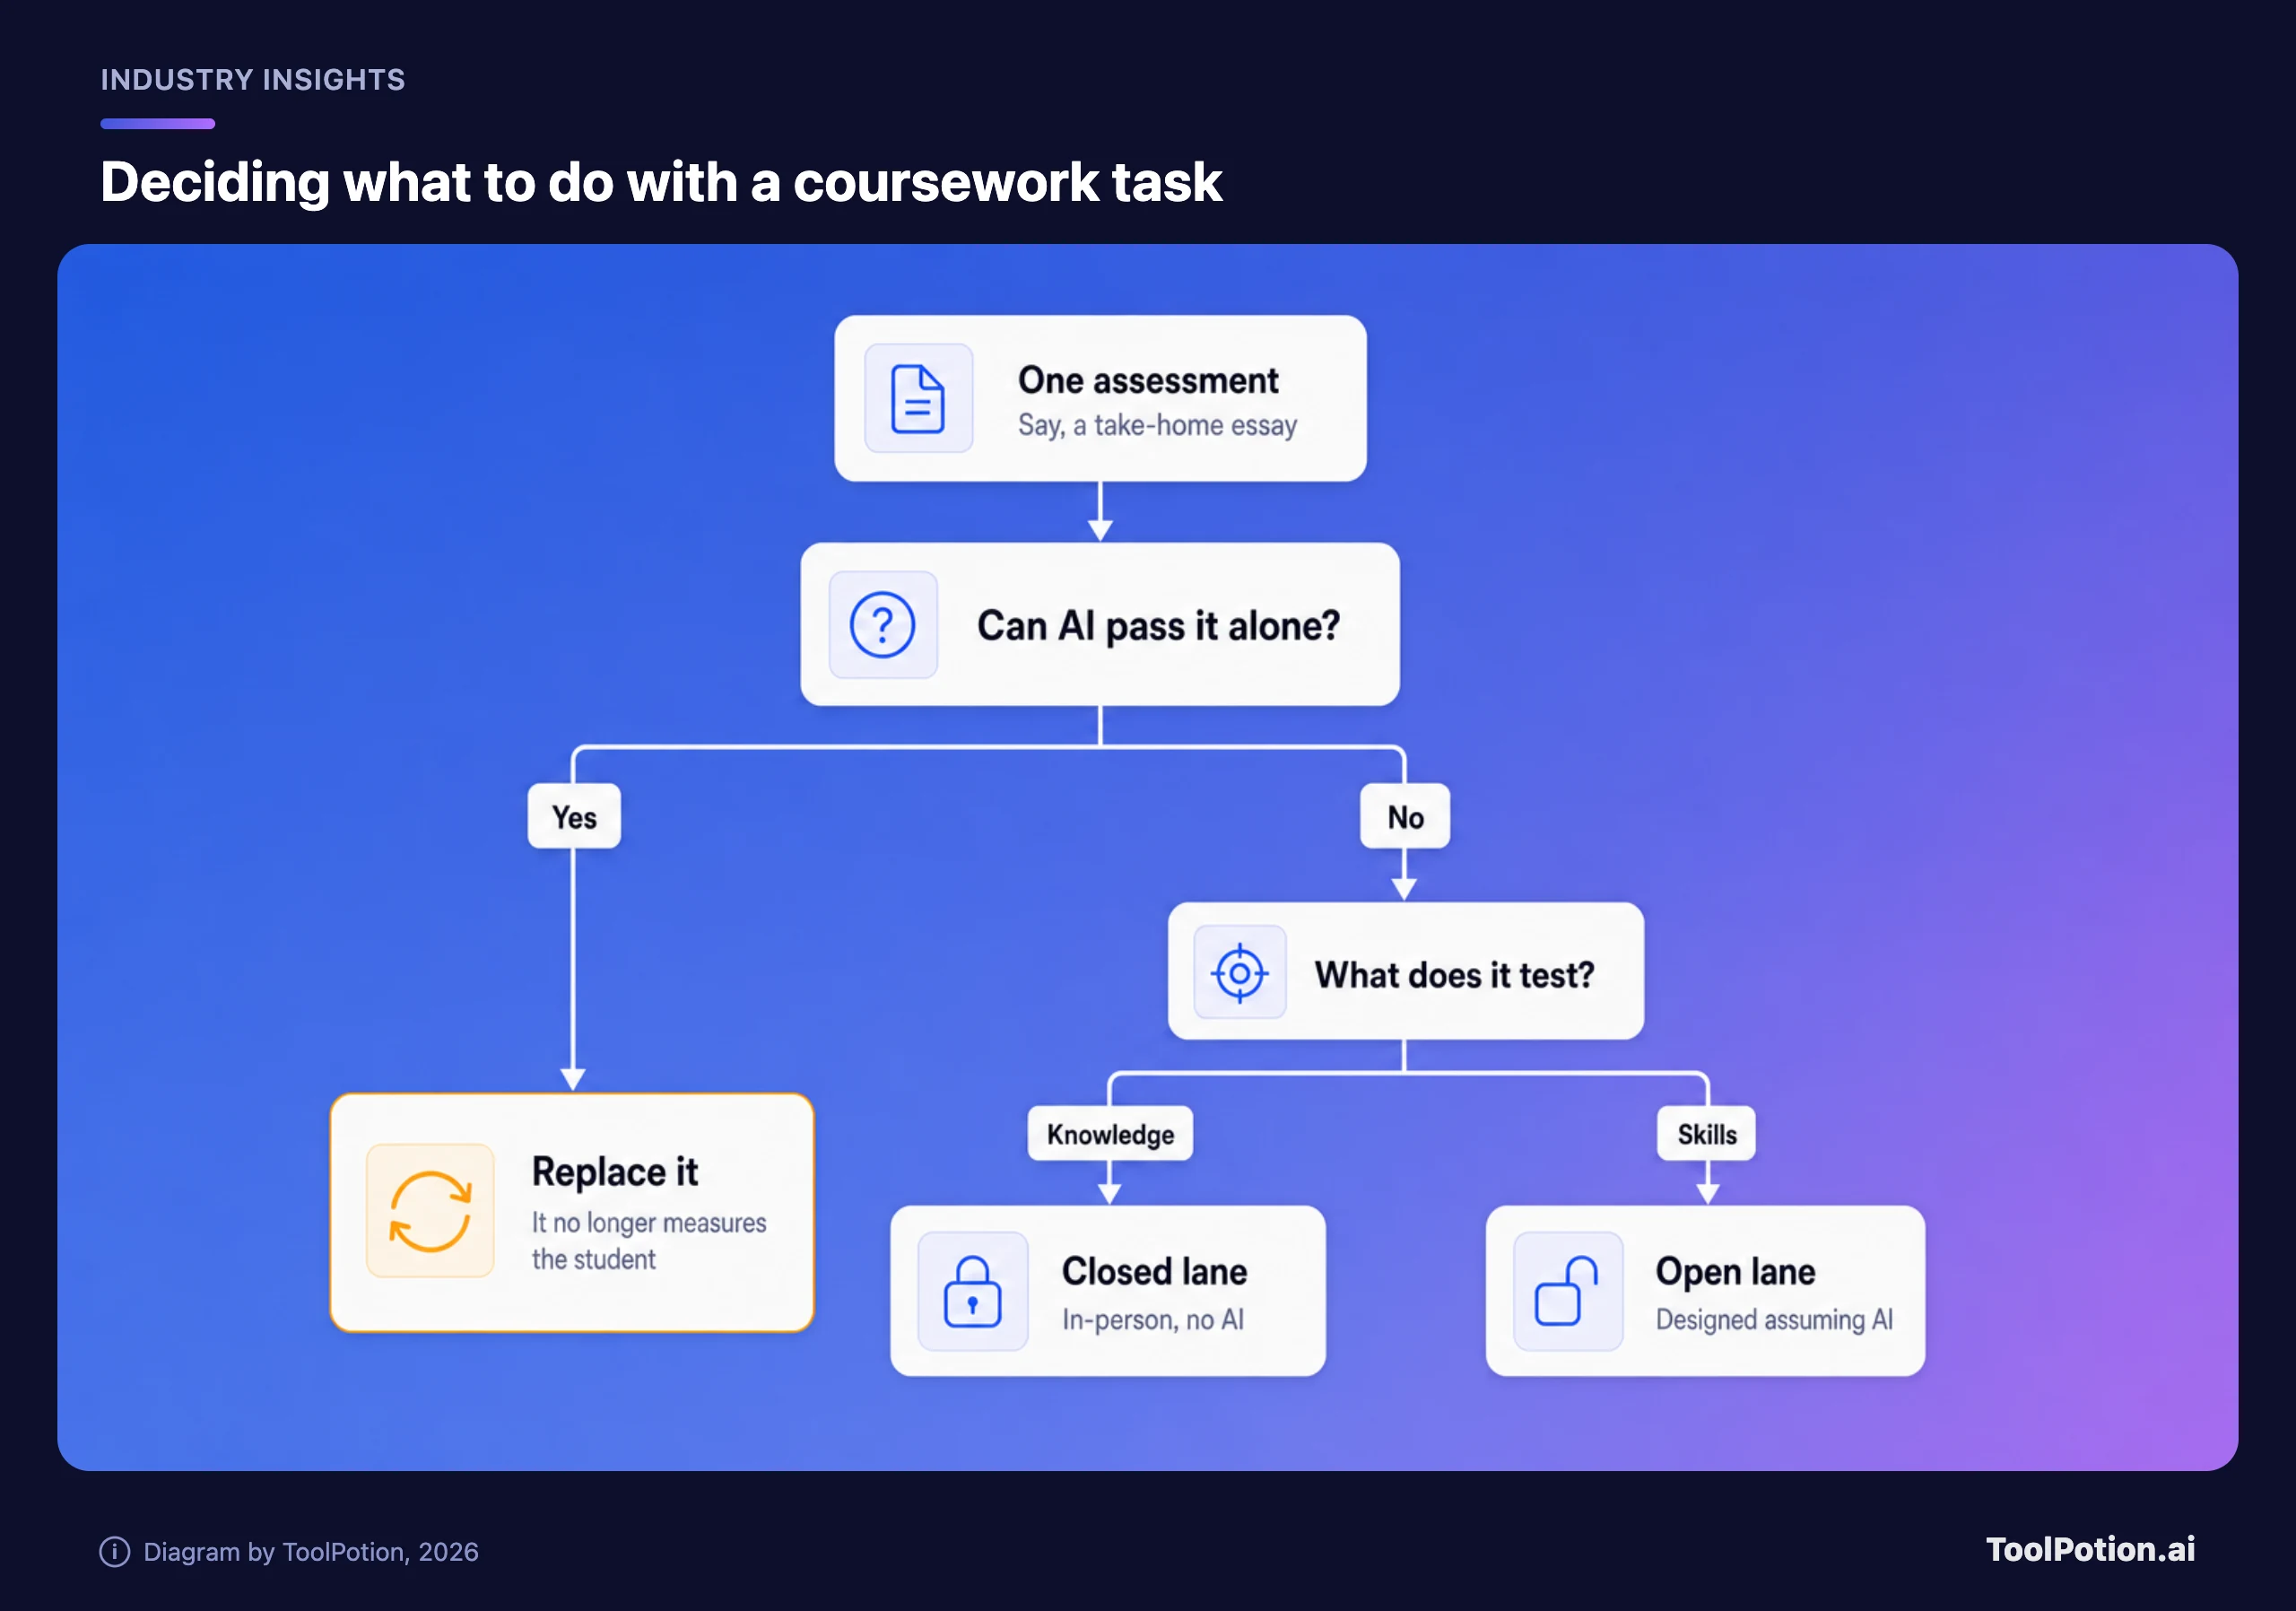
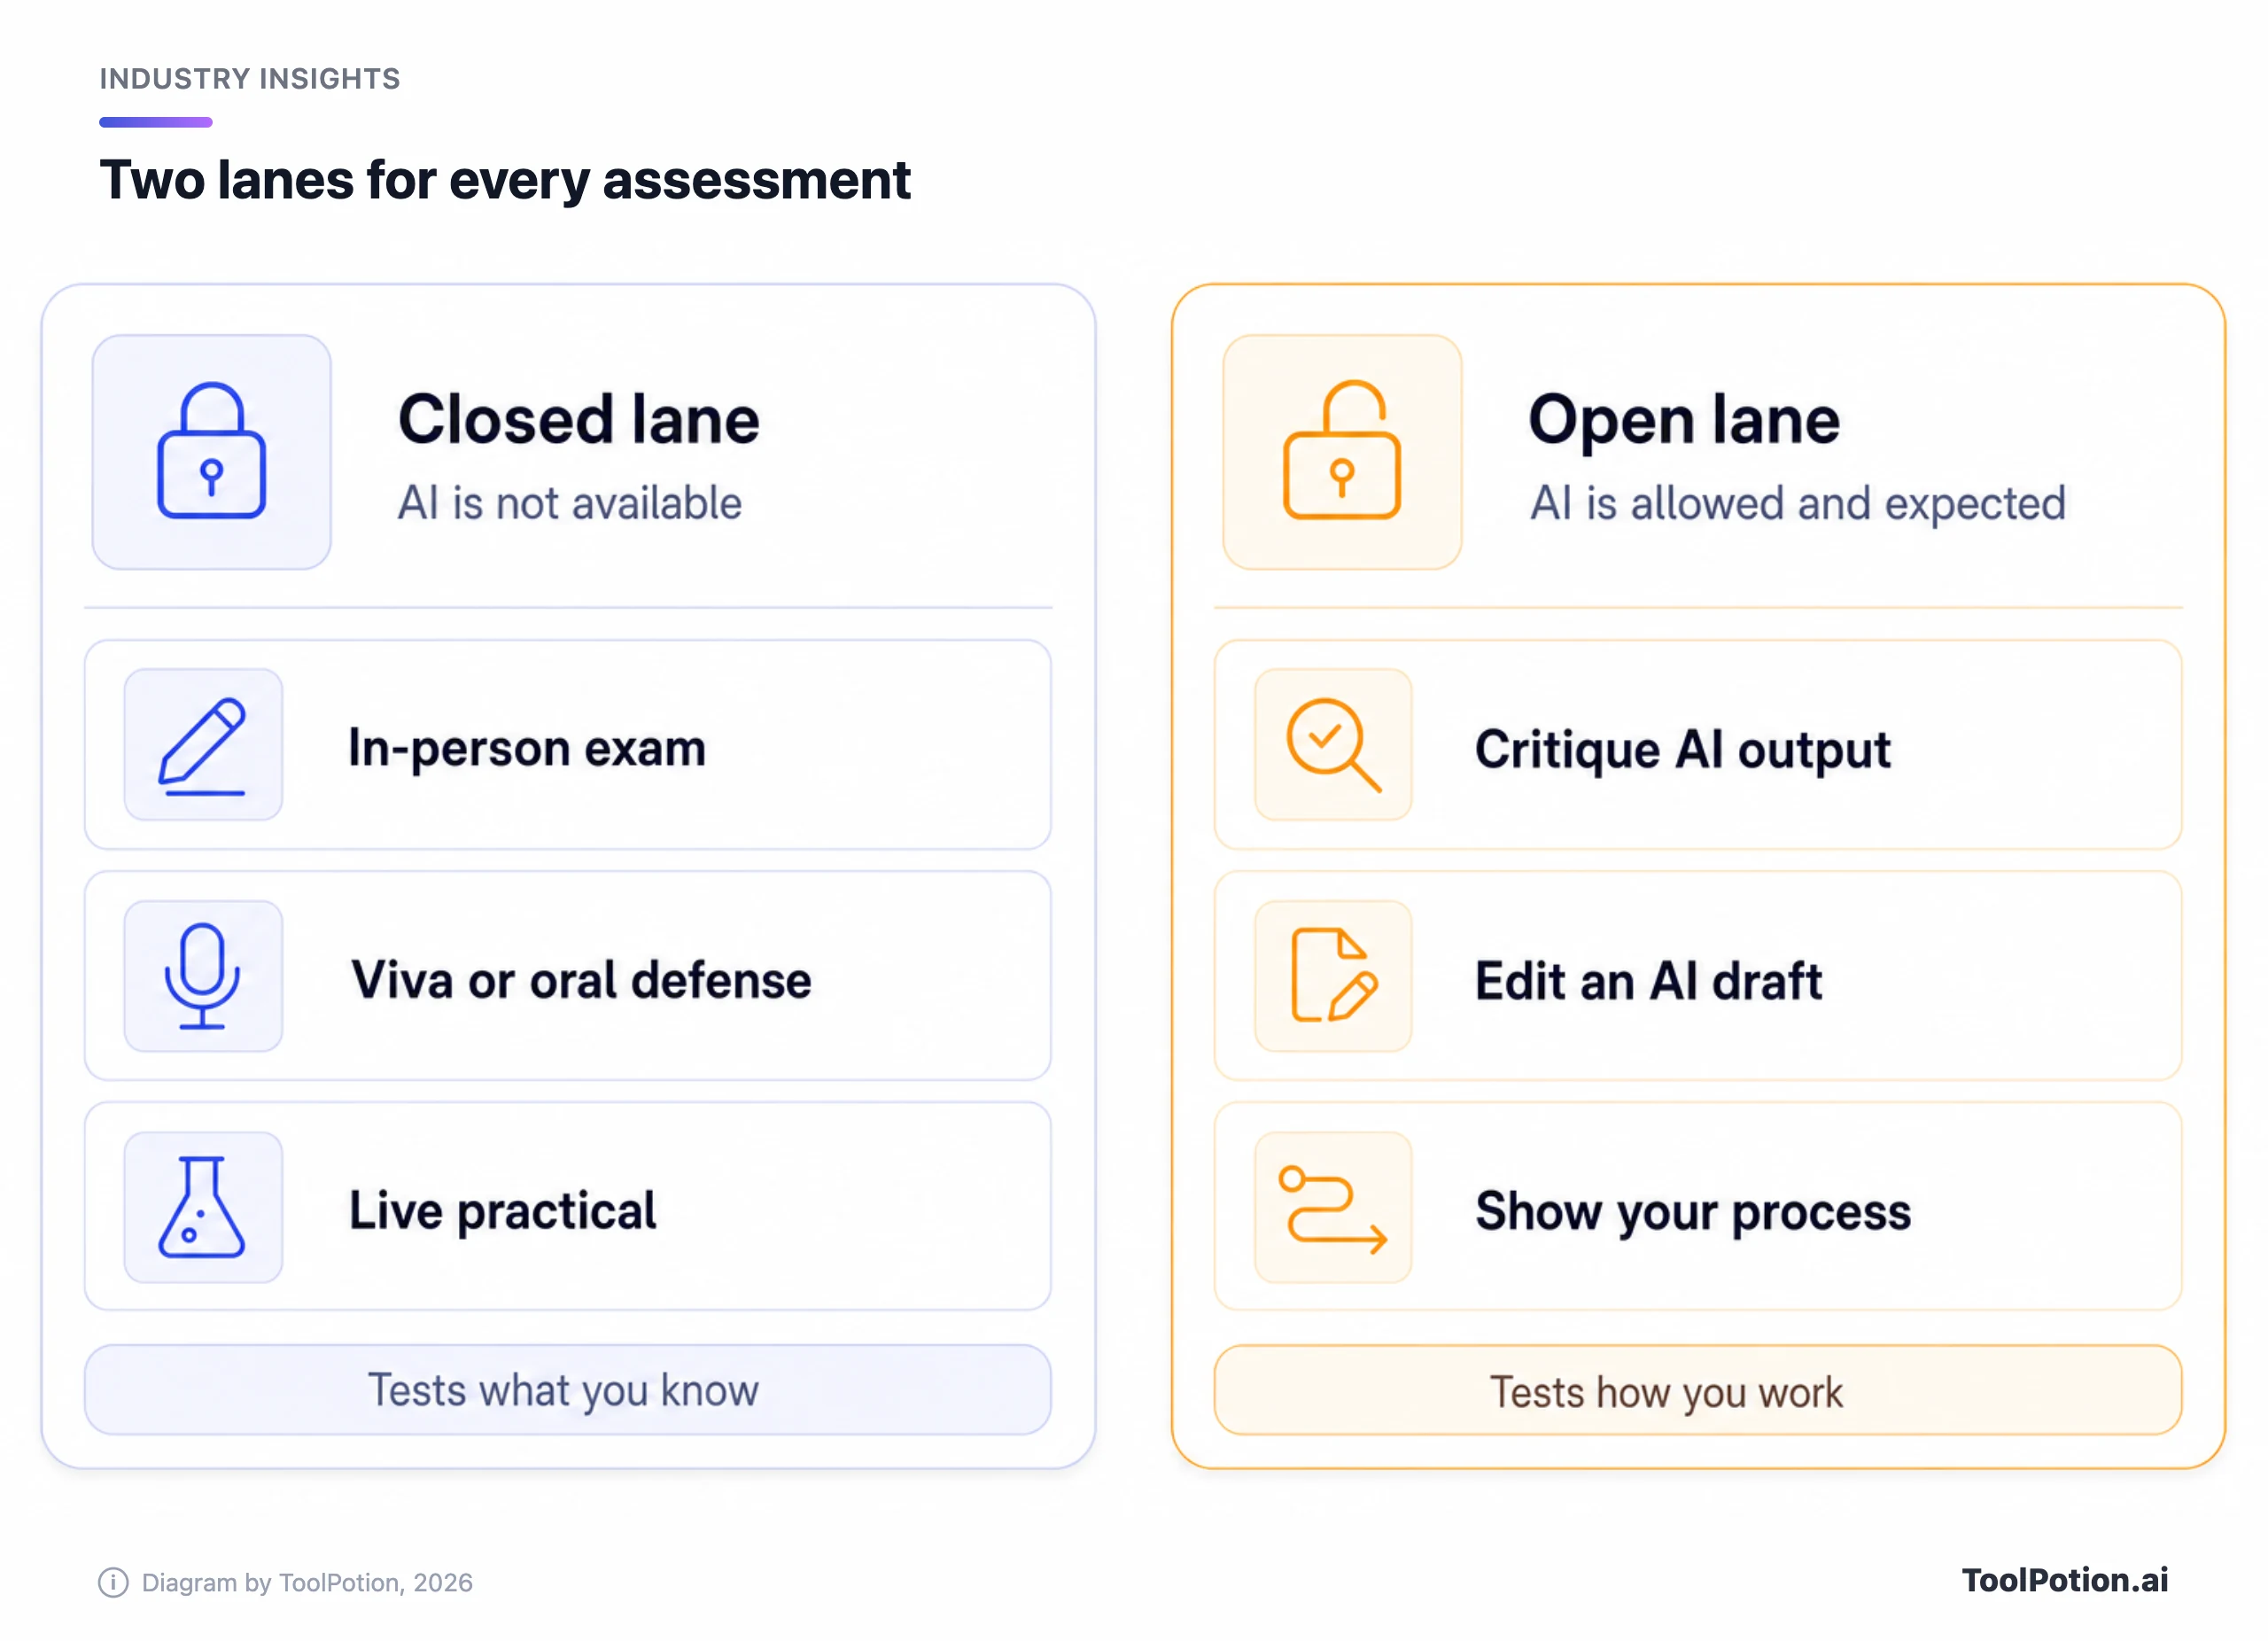
报告把大学的做法分成三类。安全评估的设计让学生在作答时无法使用 AI:现场笔试、演讲展示、vivas(对已提交作品的简短口头讨论)、实操和表演。过程性评估既看结果,也看作品是怎么做出来的,有时会设置多个检查节点,报告称之为 stage gates。开放评估则允许甚至要求使用 AI,例如让学生批判 AI 的输出,或修改 AI 写的初稿(报告)。
监管机构有明显的倾向。安全方式"往往是最有效的评估形式,因为它们能让人高度确信,学生展示的是自己的知识和技能"。另一方面,报告称,如果一项评估能借助 AI 完成,而被测的知识并没有真正被考到,"这项评估就应该被替换"。而评估知识(相对于技能而言)"通常需要评估是安全的"。
我们同意,而且想说得比这种客气的措辞更直接。一篇用来测试阅读书单记忆的带回家论文,作为衡量工具已经寿终正寝。只有监督下的考场、一次谈话,或者重新设计的任务,才能取代它。
报告列出了各种取舍。现场考试和 vivas 很耗资源。闭卷考试可能与职场工作相去甚远,对长期记忆的依赖也可能让一些群体处于不利地位,包括残障学生。专业机构有时会规定特定的形式。可穿戴设备还可能让安全评估中的作弊更容易。监管机构对真实性顾虑的回应是,努力设计既真实又稳健的评估"值得欢迎",这算不上一个方案。
Bath 放弃了红绿灯
报告里的案例研究是最精彩的部分。Bath 大学原本有一套三类方案:禁止 AI、允许某些指定用法,或 AI 是评估的组成部分。中间那一类行不通。教职员工发现,"无法以可靠且公平的方式监管 B 类评估中指定的 AI 用法"。
2026 年,Bath 转向了最早由悉尼大学提出的双通道模式。每项评估都归入封闭通道或开放通道:封闭通道的条件确保学生无法使用 AI 工具;开放通道允许使用 AI,任务设计也以学生会用 AI 为前提。Bath 的教职员工专门开了一次研讨会,来摸索稳健的开放通道任务,学校还强调,即使是封闭通道的评估,也必须围绕预期学习成果来设计(报告)。
我们喜欢它,原因只有一个:它不再假装"可以用 AI 头脑风暴,但不能用来写初稿"这种规定能被检查。报告也持同样看法:如果不做结构性改变,就无法核实学生是否遵守了 AI 政策,也无法真正遏制滥用。
把考试锁死的大学,同时也在发放 AI。Kent 在 2026 年推出了学校统一采购授权的 ChatGPT Edu 平台。学生在使用前要完成 AI 素养、负责任使用、数据保护、prompt 编写和学术诚信方面的培训,使用本身是自愿的。Imperial 为学生和教职员工提供了一个叫 dAIsy 的工作空间,通过一个数据安全的界面接入 ChatGPT、Claude 和 DeepSeek,并即将推出 40 小时的职场 AI 课程。报告还提到,Oxford 和 London School of Economics 也与 AI 服务商达成了协议(报告)。
这并不虚伪:一所大学既希望毕业生善用这些工具,又希望他们知道离开工具自己能做什么,就需要为两种情形各留一个空间。比起任何一个极端,我们更倾向这样的搭配。如果你还在挑选 AI 助手,ChatGPT vs Claude vs Gemini 梳理了三者的差异。
为什么检测工具当不了裁判
不用整体重新设计,最直接的替代办法是事后抓 AI 文本。报告毫不客气地指出,这种办法效果不够好。学术研究表明,人类无法可靠地识别 AI 文本;较新的检测工具可能比旧的好一些,但这些改进"往往是暂时的,随后通常会被 AI 系统的进步追上";而改写文本以骗过检测工具的 humanisers 会进一步拉低准确率(报告)。
许多院校还是在用这些工具。有的把分数作为辅助证据放进学术不端案件;也有教职员工非正式地用它挑出作业,随后被标记或扣分。Turnitin 的 AI 检测工具在英国高等教育中被广泛使用,它告诉研究人员,其输出只应作为一个数据点。有些院校已经完全停用了检测工具。
学生参与者的态度更严厉。他们说检测工具不准,还夸大 AI 的使用;有些人很沮丧,因为一旦被检测工具打出高分,似乎就没有任何途径能证明自己清白。学生们描述了降低分数的做法:删掉破折号之类的 AI 文本特征、使用 humanisers,或者故意加入拼写和语法错误。(我们自己的文风规范就禁用破折号,所以多少感到一丝寒意。)一个逼着诚实的写作者把文章写得更差的工具,测的并不是诚实。
报告对这个分数的立场,也是我们的立场:在全面评估学生是否有不端行为时,它至多只是一项证据,而且"在没有确凿证据的情况下,不应仅凭怀疑使用了 AI 就给学生打更低的分"。报告还补充说,不端行为的处理流程"耗时耗力,让学生倍感压力,也不太可能有效保障评估流程的效度"。
人工批改的人同样会漏掉。在 2024 年的一项研究中,University of Reading 的研究人员在不告知批改人员的情况下,把完全由 AI(GPT-4)写的答卷混进了某心理学学位的五门课程;94% 没被发现,平均得分比真实学生高出约半个等级界限(PLOS One)。想看逐个工具的对比,我们在 top AI content detectors 这篇文章里介绍了 GPTZero、Grammarly 的检测工具和 Copyleaks 扩展,AI 内容检测工具榜单则对这一领域做了排名。我们对检测工具的看法和监管机构一致:当烟雾报警器用,别当法官。
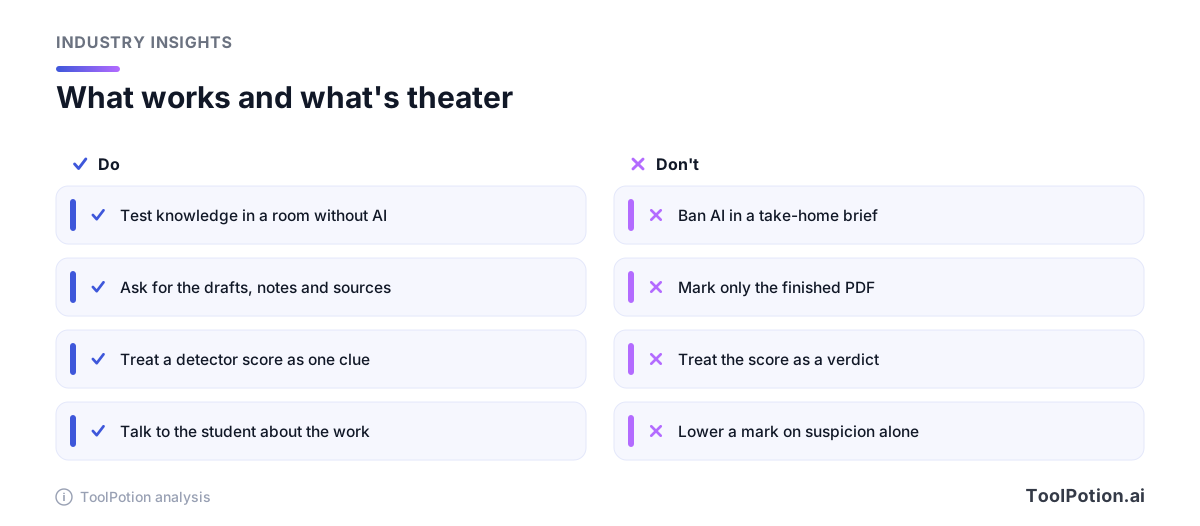
所以我们的看法是这样的。有效的做法:用没有 AI 的考场来评估知识,在项目中收集草稿和参考来源,再和学生就他自己的作业简短谈一谈。做做样子的做法:在带回家的作业说明里禁用 AI 然后听天由命,只批改最终文件,把检测工具给出的百分比当成定论。
学生和家长该有什么预期
这一切并不是对学生的评判。报告本身就说,学生广泛用 AI 来解释难懂的概念、总结长文档、生成练习题和复习,而且它可能对神经多样性或残障学生,以及母语不是英语的学生有帮助。报告还说,许多学生现在把 AI 看作拿高分最有效的途径,不用的话还可能觉得自己吃亏。这是对"分不清差别的评估"做出的理性解读。
OfS 的新闻稿说,许多学生觉得所在院校或院系的政策很难理解。监管机构自己的报告也承认,可接受与不可接受的使用之间的界线很难划,因为 AI"能以模糊学生与机器工作界限的方式产生想法和推理"(报告)。所以,对一年级新生或家长来说,最稳妥的预期是下面这些。
- 预期最终成绩会有更大一部分取决于在考场里完成的事情:笔试、演讲、实操,或者对你已提交作业的简短口头讨论。
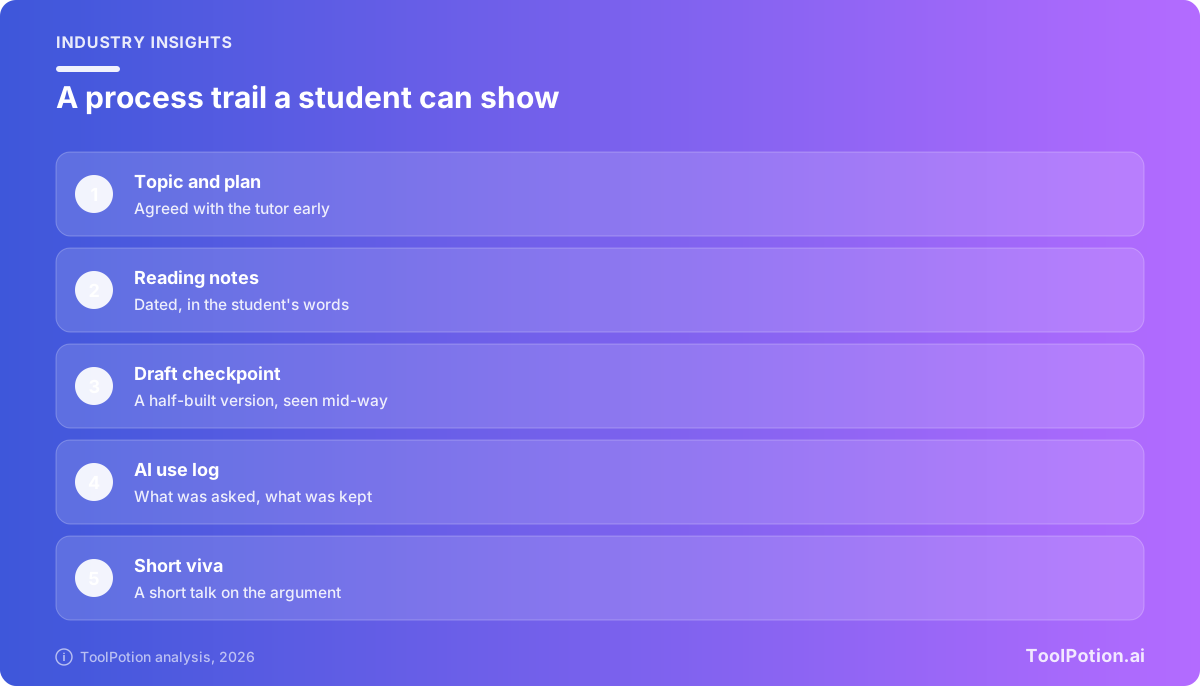
- 预期会被要求出示过程材料。笔记、带日期的草稿和参考来源,正是过程性评估要看的东西,而且有些院校已经要求学生声明自己如何使用了 AI(报告称,许多学生担心声明会让人对自己的作业起疑)。
- 预期规则会因课程模块而异。这次评估可能是封闭的,下一次是开放的,起作用的是每次评估的说明,而不是学校主页上的话。
- 如果你的作业被质疑,问清楚除了检测分数之外还有什么证据,并要求当面解释自己的作业。监管机构表示,不应仅凭分数决定结果。
- 如果你依赖合理便利安排,要确认新的评估形式里有这些安排。报告称,通过包容性的设计和便利安排,每个学生在安全评估和开放评估中都应当能够展示自己的知识和技能。
家长还可以多问一个问题:这门课程在最后几年是怎么评估的,其中有多少是在监督环境下进行的。这个答案比任何 AI 政策声明都更能说明问题。
在规则之内使用 AI
先从针对具体那次评估的书面规则看起。如果不清楚,就问导师,并保留他的回复。你的模块允许什么,我们没法告诉你。在允许使用 AI 的地方,报告描述的学生用法包括:解释难懂的材料、给自己出题测验、规划复习,以及检查自己的理解。NotebookLM 以及我们 NotebookLM vs ChatGPT Projects vs Claude Projects 对比文章里的其他工具,都是为基于你自己的资料学习而设计的。
我们用的检验方法是 viva 测试。你能不看屏幕,大声讲清这篇作业里的每一个论点吗?如果能,AI 多半帮你学到了东西。如果不能,那就是它替你干了活,报告所担心的"认知卸载"(AI 取代了阅读、研究或解决问题)就适用于你,不管规则怎么写。用 Grammarly 这类工具改语法和拼写,感觉上是另一回事,但报告指出,标点和语法工具也可能包含强大的 AI 功能,所以别想当然,先查规则。
上面的清单不是官方工具,只是六个能让你和批改老师顺畅沟通的习惯。
接下来要关注什么
OfS 已经向院校发布了现有条件如何适用于 AI 的指引,所以接下来的证据就是执法:是否有大学被附加具体的注册条件,又是因为什么。Advance HE 计划在 2027 年初为成员院校推出一个以 AI 为主题的 Change Academy 项目(OfS 新闻稿)。
我们还会关注作弊数据。Guardian 2025 年的调查发现,2023-24 学年有近 7,000 起经证实的 AI 作弊案例,即每 1,000 名学生中 5.1 起,而在作出回应的大学中,超过 27% 还没有把 AI 滥用单独列为一类记录(The Guardian)。如果随着考试回归,经证实的案例减少,那可能意味着重新设计奏效了,也可能意味着检测变得更难了。光看数字,没人能分清这两种情况。这正是我们主张采用不依赖抓人的评估方式的理由。