

Project Screen Test 一开始只要几个性格词(“焦虑、害羞、笨拙”)和一段声音,然后你就可以和这个角色对话,直到它有了背景故事、恐惧和动作习惯(The Verge)。它是今年 Adobe Max 大会上最奇怪的演示,也是你打不开的一个。Adobe 自己的页面写的是“coming soon”(即将推出)。
这就是本文拆解的前提。Adobe Labs 列出了 2026 年的十个 Sneak。目前只有两个可以试用,另外八个带有一个“Get notified if this Sneak becomes available as an experiment”(如果这个 Sneak 开放为实验,通知我)按钮。我们用同一个标准逐个过一遍,也是我们看每次发布时用的标准:实验在人们真正能用上之前,只是一种说法。
十个 Sneak,两扇开着的门
Adobe 的 labs 网站把作品分成几个阶段,而这些阶段本身就是重点。每个 Sneak 都从演示视频开始。有些进入通知名单,更少的一部分进入 Playground,任何人都可以在里面打开可用的原型,最后一步是成为付费应用里的功能。八个在通知名单上,两个(Deep Brush 和 Hands On)在 Playground 里,我们没有找到任何一个标为已正式上线。(Playground 里还有第三个实验 Project Custom Filters,它不在这十个 Sneak 之列。)
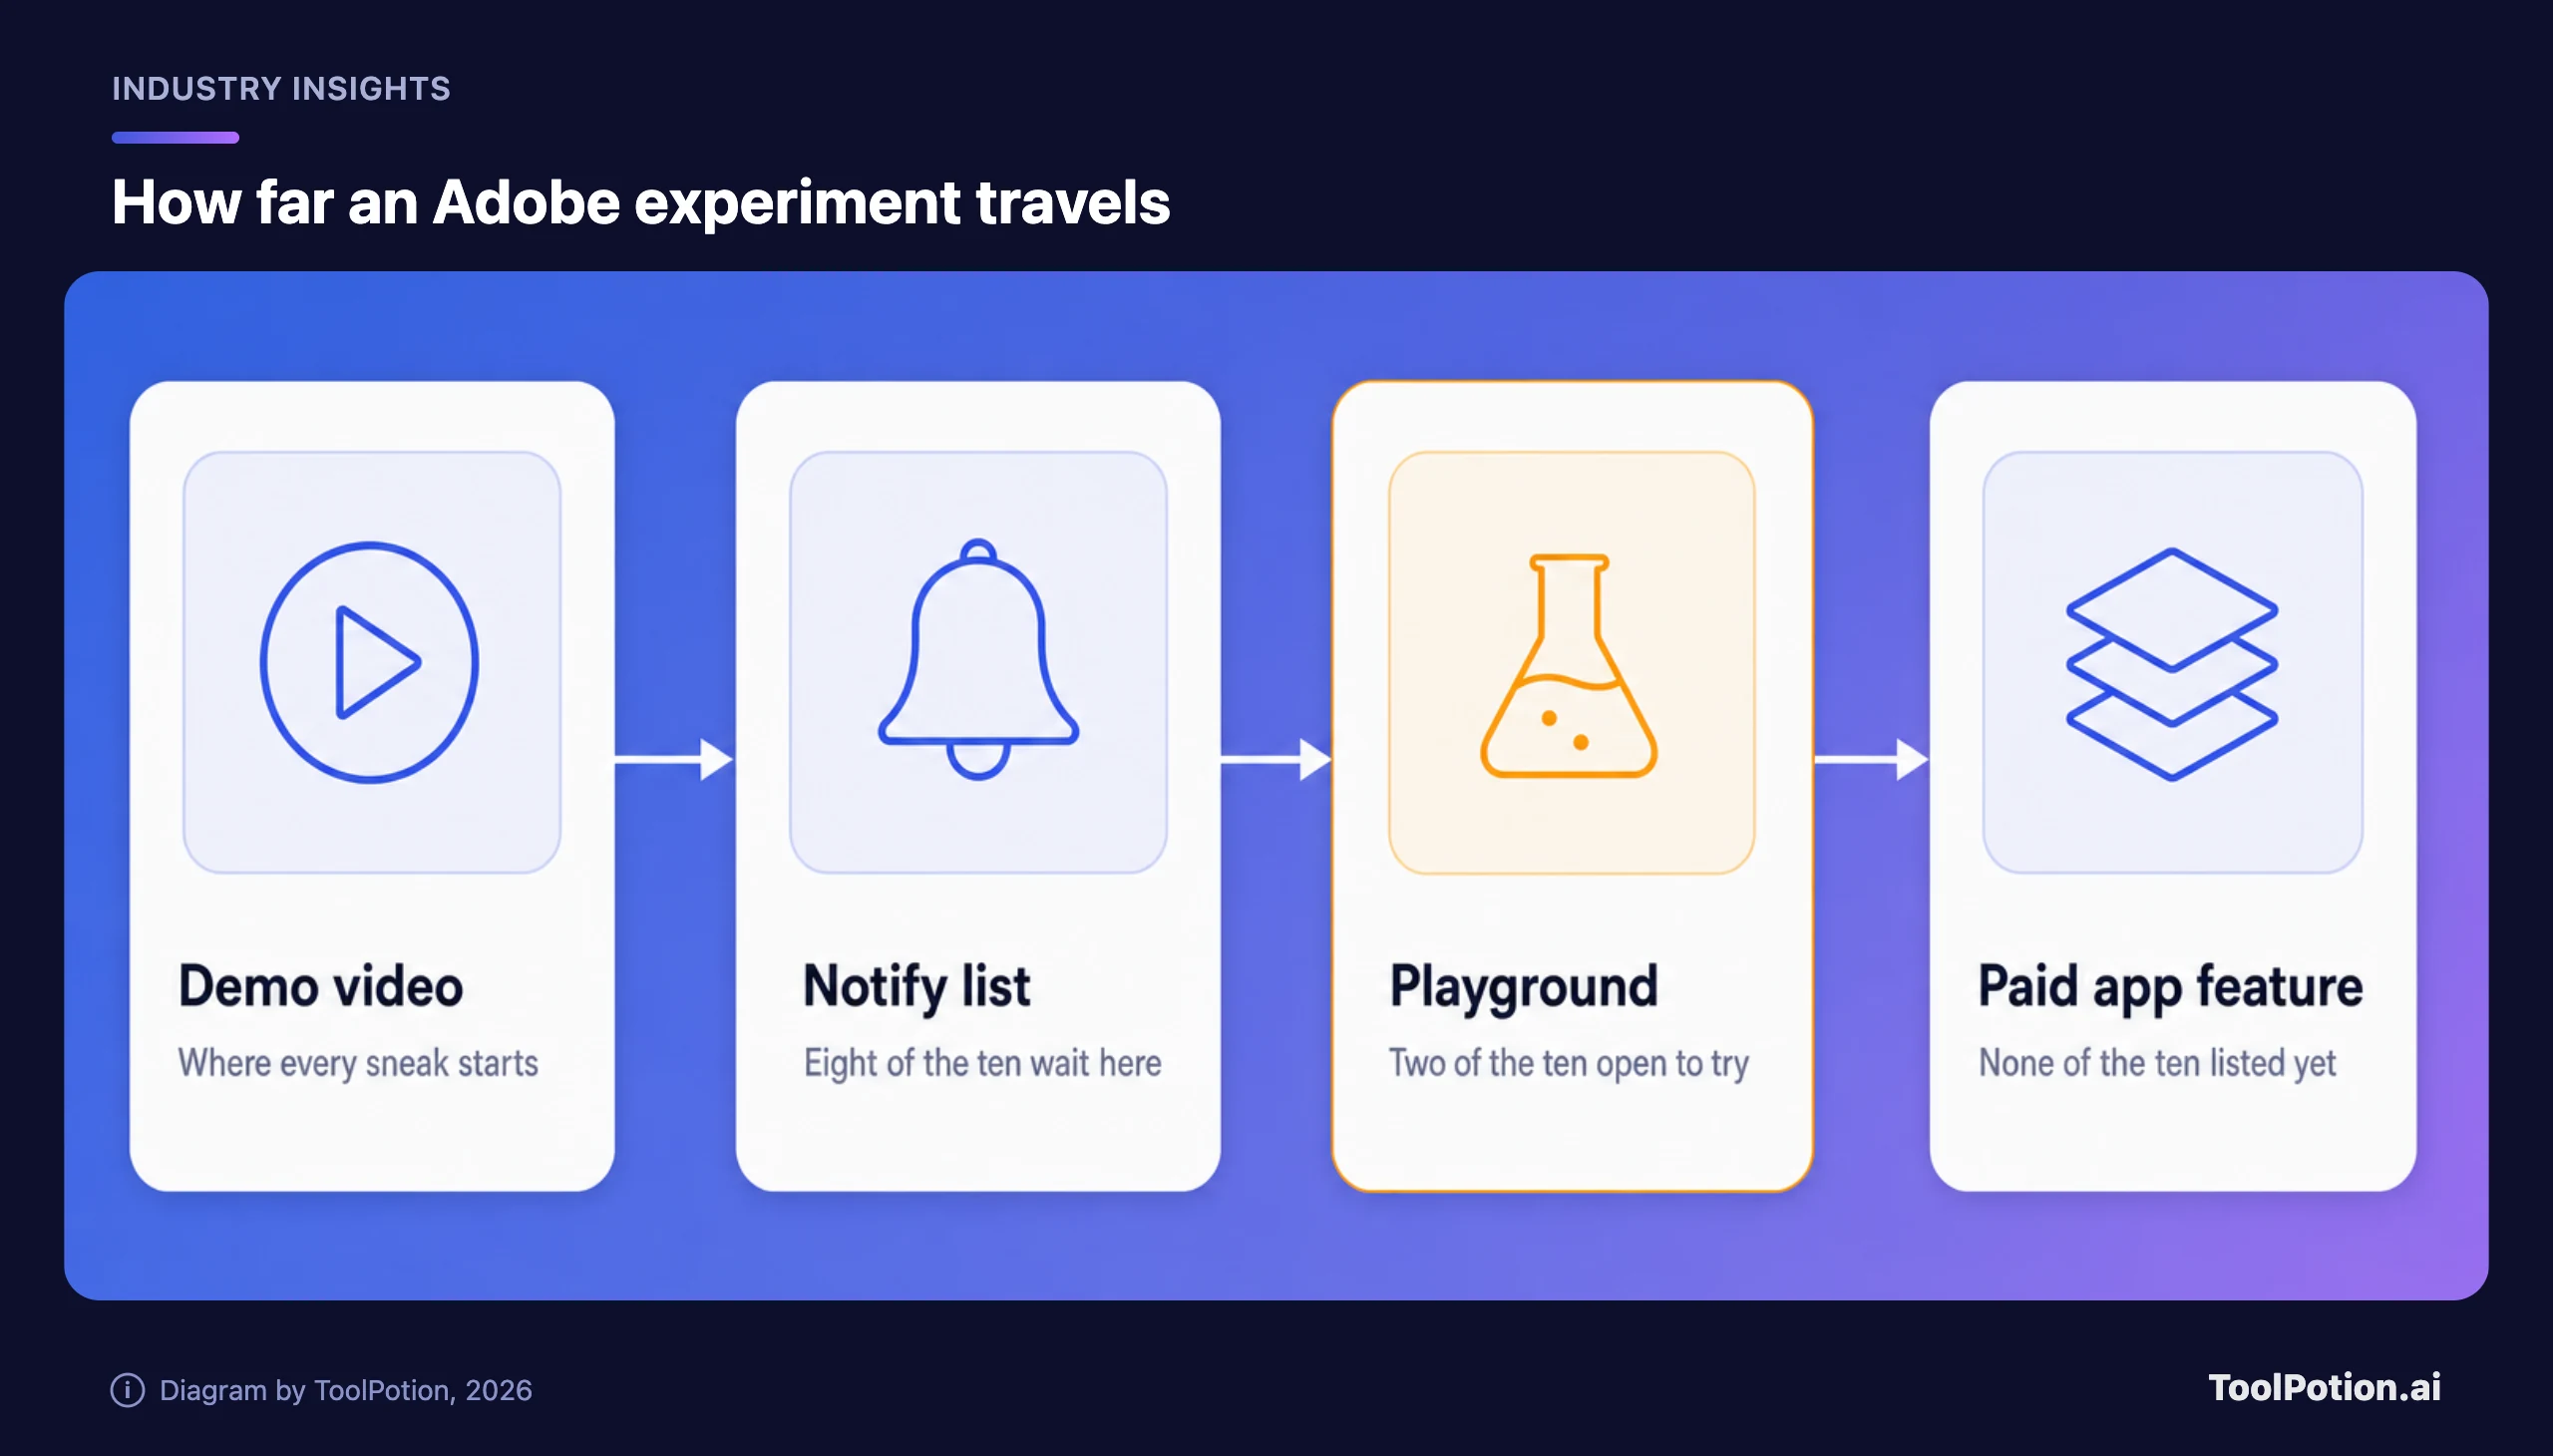
The Verge 自己的提醒很直白:Sneak 只是技术预览,“不保证它们最终会成为可用功能”(The Verge)。同一篇文章也认为,考虑到 AI 在 Adobe 增长计划中的核心地位,至少有一部分会上线。两种说法都说得通,但都算不上计划。
Screen Test 让你在角色诞生之前先试镜
Adobe 说,Screen Test 源于一位前电影人的挫败感:导演无法像和演员沟通那样,与 AI 视频进行关于角色动机的长时间对话。它的页面是这样描述机制的:“对话会生成一份性格档案,这份档案再指导视频生成”(Adobe Labs)。Adobe 还把它推荐用于游戏设计、角色扮演练习,以及在不同配音语言之间保持角色举止的一致。
The Verge 发现,生成的结果比它见过的许多 AI 角色更容易辨认、更前后一致,同时也指出它是一个独立的练习,没有说明如何接入 Adobe 现有的视频工具(The Verge)。
这份性格档案能复用、编辑、导出吗?Adobe 没说。而这恰恰是全部价值所在;带不进项目的档案只是个噱头。我们会再等等。
Sight Span 把一张照片变成可以走进去的房间
Adobe 把 Sight Span 描述为把单张图片变成可导航世界的方式:团队的目标是在大约 10 到 20 秒内生成一个快速的 3D 预览,再通过单独的图像生成步骤,按你选定的视角渲染最终画面(Adobe Labs)。The Verge 看到的预览有像素化、轮廓模糊的问题,选定角度后才变清晰,并表示照片、绘画和插画都适用(The Verge)。
Adobe 建议的用途是分镜、场景设计和产品重新定位:一张棚拍照片,多个机位角度,不用重拍。前两项属于预演(previsualization),虚构的角度没关系,因为没人当它是真的。产品图则不同,每个新角度都是模型对一个只见过一面的物体的猜测。我们会把它用在概念图和提案文档上,但不会用在商品页上。
Sound Bender 和 Rinse Repeat 尊重你手头已有的文件
Sound Bender 接收一段视频和一条文字提示(The Verge 举的例子是“咕嘟冒泡的科幻坩埚声”),生成同步的音效,并把四个声音放在方形画布的四个角上,你可以实时拖动它们(The Verge)。Adobe 补充说,你还可以通过描述从混音中抽出单个声音(Adobe Labs)。它的 Playground 页面把它归在 coming soon 一栏。
Rinse Repeat 是这十个里最朴素的想法:复制一次 Photoshop 编辑,再粘贴到其他对象上,这样给一件产品加的阴影就能同步到其余产品。Adobe 说该系统使用 Photoshop 原生的工具、图层和蒙版,所以结果保持非破坏性且可编辑,创作者也告诉团队,他们希望 AI 帮助自己把活干得更好,而不是替自己干活(Adobe Labs)。它在通知名单上。
十个当中,我们押它最先进入 Adobe Photoshop。它省掉了重复劳动,又不会生成一个没人能修改的合并文件,而这正是我们判断 AI 到底有没有省事的标准。这只是我们的预测,不是 Adobe 的承诺。
现在就能打开的两个
Deep Brush 把照片拆成物理分解的图层,让颜料跟随阴影、几何形状和光照;Adobe 举的例子有墙上的涂鸦、弧形瓶身上的 logo、口红或发色(Adobe Labs)。Hands On 分析图像并在画布上放置控件,比如马克杯把手上的控制点,这样你可以直接拖动,而不用反复改写 prompt(Adobe Labs)。Hands On 还有一个已经上线的“亲戚”:Adobe 说它源自一个项目,该项目现在就在 Adobe Firefly 的 Edit object 工具里。
对于曾经为了把手的弧度和 prompt 框较劲的人来说,这两个都是好消息。不过我们读到的页面都没说 Playground 的产出能否用于客户项目,所以收费前请先确认。
Adobe 的训练数据承诺涵盖 Firefly,而这些 Sneak 没有说明
Adobe 介绍 Firefly 做法的页面说得很具体:“我们只用我们获得许可的内容来训练 Adobe Firefly”,并补充说从未用客户内容训练过 Firefly,且模型被构建为商用安全(Adobe)。这些是 Adobe 对自家模型系列的说法。
同一页面还说,Adobe 可能在其应用内提供合作伙伴的模型,并由创作者自行判断合作伙伴模型是否适合某个项目。Screen Test 的页面把 Firefly Video 列在相关工具中,而 Adobe 称该工具运行 Firefly Video 2 和 Veo 等模型。我们读到的 Sneak 页面都没有说明某个 Sneak 由哪个模型驱动。所以不能默认实验就是“商用安全”;如果客户需要赔偿保障(indemnity),向他推荐之前先问 Adobe。
Bloomberg 同一周的标题是“How Adobe Is Helping Disney with Custom AI Tools”(Bloomberg),我们也只引用到这里。工作室用自己的片库来训练,是基于授权的说法最容易站住脚的场景。但得先看到细节。
Canva 和 Runway 卖的是更朴实的版本
Canva 的 AI 页面在编辑器内提供文字生成图片、文字生成图形和文字生成视频,上面还叠加了它惯常的编辑工具(Canva)。在我们读到的页面里,没有找到类似“走进照片”的功能。做快速的社交媒体图片,这就够了,我们的 Canva 与 Adobe Express 对比讲了各自适合的场景。
对那些野心更大的 Sneak 来说,Runway 是更直接的对手。它的产品页列出了可以在 Premiere Pro 和 After Effects 里生成、编辑和延长素材的插件,并称“used by 60M+ users globally”(全球用户超过 6000 万,这是 Runway 自己的营销数字,并非经审计的数据)(Runway)。它的 GWM Worlds 2 研究预览能实时生成可交互的世界,720p、每秒 24 帧,由文字动作来操控(Runway)。这和 Sight Span 是不同的路线:实时视频生成,而不是 3D 场景加一次渲染。我们的视频模型对比讲的是已经上线的那一侧。
Adobe 的优势是 Photoshop 的图层,以及一个对各阶段坦诚相告的 labs 网站。对手的优势是,它们页面上的东西你今天就能买到。
面对十个演示该怎么办
Adobe 自己的研究给出了做这些实验的理由。在针对 82 位创意专业人士的八项研究中,它发现“聊天是生成式 AI 最常见的界面,但对精确的视觉工作来说并不够用”(Adobe Labs)。高级研究科学家 Gautham Mysore 对 The Verge 说:“让这些交互更直观,也是为了让经验丰富的创作者拥有更精确的控制”(The Verge)。Hands On、Sound Bender、Sight Span 和 Rinse Repeat 都是这个论点在软件上的体现。我们认同这个论点,但怀疑其中大部分今年都不会上线。
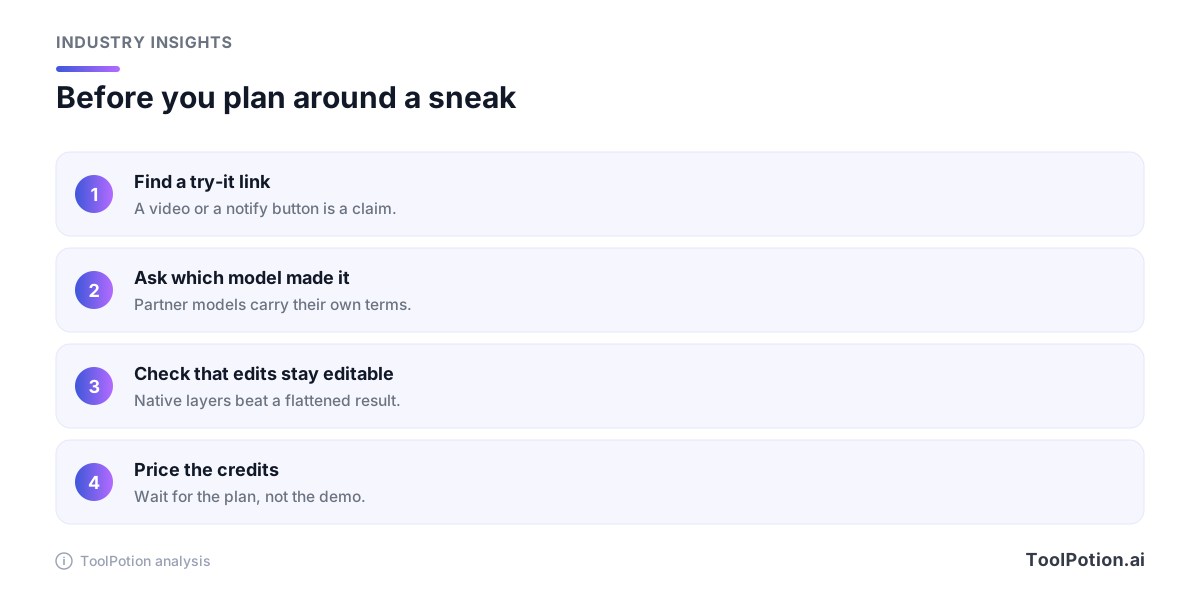
我们的建议很简单。拿一张无关紧要的图,在 Playground 里花一个下午:Deep Brush 做效果图,Hands On 修形状。只有当你整天泡在 Photoshop 里时,才需要把自己加进 Rinse Repeat 的通知名单。至于必须交付的工作,还是用已经上线的:Adobe 的 Firefly 图像生成器扩展、免费图片放大工具、Adobe Express 背景移除工具,或 Canva 的照片编辑器。
如果 Adobe 把某个 Sneak 做成 Firefly 或 Photoshop 的功能,并且页面上写明了套餐、credit 价格和所用模型,我们会再来看一遍。