

想核查 AI 输出又不被淹没,就别再试图验证每一句话。先把论断提取出来,按"错了会出什么事"排出优先级,再对照原始来源去核实文章所依赖的那几条。整齐的引用格式说明不了什么,模型自己说一句"是的,我确定"同样不能当证据。
跳过这一步的代价还在不断上升。一个收录"涉及 AI 幻觉内容的法院裁决"的公开数据库,在写这篇文章时已记录 2,125 起,其中 1,193 起出现在今年(AI Hallucination Cases database)。今年早些时候,KPMG 因疑似 AI 幻觉撤回了一份已发布的报告,报告中提到的多家机构称,其中关于它们使用 AI 的说法"要么不实,要么具有误导性"(TechCrunch)。
幻觉并没有消失,只是更难发现了:周围的文字行文流畅,假参考文献看起来和真的一模一样。下面你会看到最容易出错的论断类型、为什么让模型自查靠不住、一套附带可直接复制 prompt 的风险分级工作流,以及对 Gemini Notebook(原 NotebookLM)、Perplexity 和 Consensus 这类溯源工具的客观评估。
假引用如今成了法庭上的"常见案由"
律师行业最早吃到苦头,而且是当众出丑。Damien Charlotin 的数据库收录的是这样的裁决:法院或仲裁庭认定(或暗示)当事方依赖了幻觉内容,通常是编造的判例。它并不试图统计所有提交过的假引用,只收录法院或仲裁庭在书面文件中处理过的那些。即便过滤得这么窄,曲线依然陡峭。
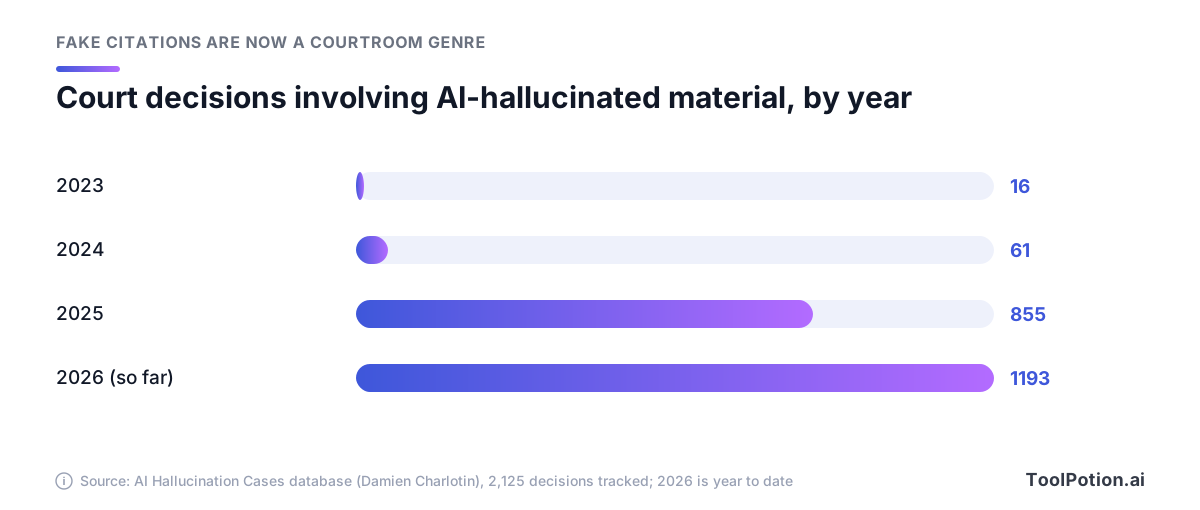
2026 年的柱子只覆盖了部分年份,却已经超过了 2025 年。在已记录的裁决中,自行出庭的当事人占 1,227 起,律师占 840 起,另有 33 起的幻觉内容来自法官。美国以 1,459 起居首,加拿大 223 起,澳大利亚 112 起。
一切的起点仍然是最好的教训。2023 年的 Mata v. Avianca 案中,纽约联邦法院的一名律师问 ChatGPT,它提供给他的某个案例是否真实存在,ChatGPT 说是。再被追问时,它称该案例"确实存在,可以在 Westlaw 和 LexisNexis 等法律检索数据库中找到"(CNN)。这个案例并不存在,法院对律师及其律所罚款 5,000 美元。这位律师在宣誓书中称,他"没有意识到其内容有可能是假的"。
此后罚单越开越大。在 Couvrette v. Wisnovsky 案中,俄勒冈州联邦法院发现原告方的诉状里有 15 处伪造引用和 7 处错误引述,于是驳回诉状,以不得重新起诉的方式驳回其诉讼请求,并判处 110,204 美元的制裁金和费用,是该数据库中美国案件的最高总额。如果你在法律工作中使用 AI,我们的 AI 法律工作指南介绍了更稳妥的做法。
法庭只是最显眼的战场。Deloitte 为一份价值 44 万美元的澳大利亚政府评估报告同意部分退款,报告引用了并不存在的大学教授撰写的研究,还对一项真实的法院判决做了凭空捏造的引用。该公司后来披露,他们用的是基于 Azure OpenAI 的 GPT-4o 搭建的工具链(The Guardian)。据报道 KPMG 的同一篇 TechCrunch 文章称,EY 今年撤回了一份关于会员忠诚度计划的报告,其中似乎含有虚假脚注。2025 年,《芝加哥太阳报》刊登了一份联合供稿的夏季阅读书单,据 NPR 报道,15 本书中有 10 本是虚构的。
AI 输出错在哪里
模型现在很少拼错字了,OpenAI 的研究人员解释了错误为何转移到了别处。拼写有规律可循,大模型能学会;但"像宠物生日这类任意的低频事实,无法仅从规律中预测,因此会导致幻觉"(OpenAI)。他们向一款广泛使用的聊天机器人询问这篇论文某位作者的博士论文题目,它给出了三个不同的答案,没有一个是对的。
这就给了你一张地图:错误集中在少数几类论断上,而最危险的,恰恰是那些包装成"证据"的东西。
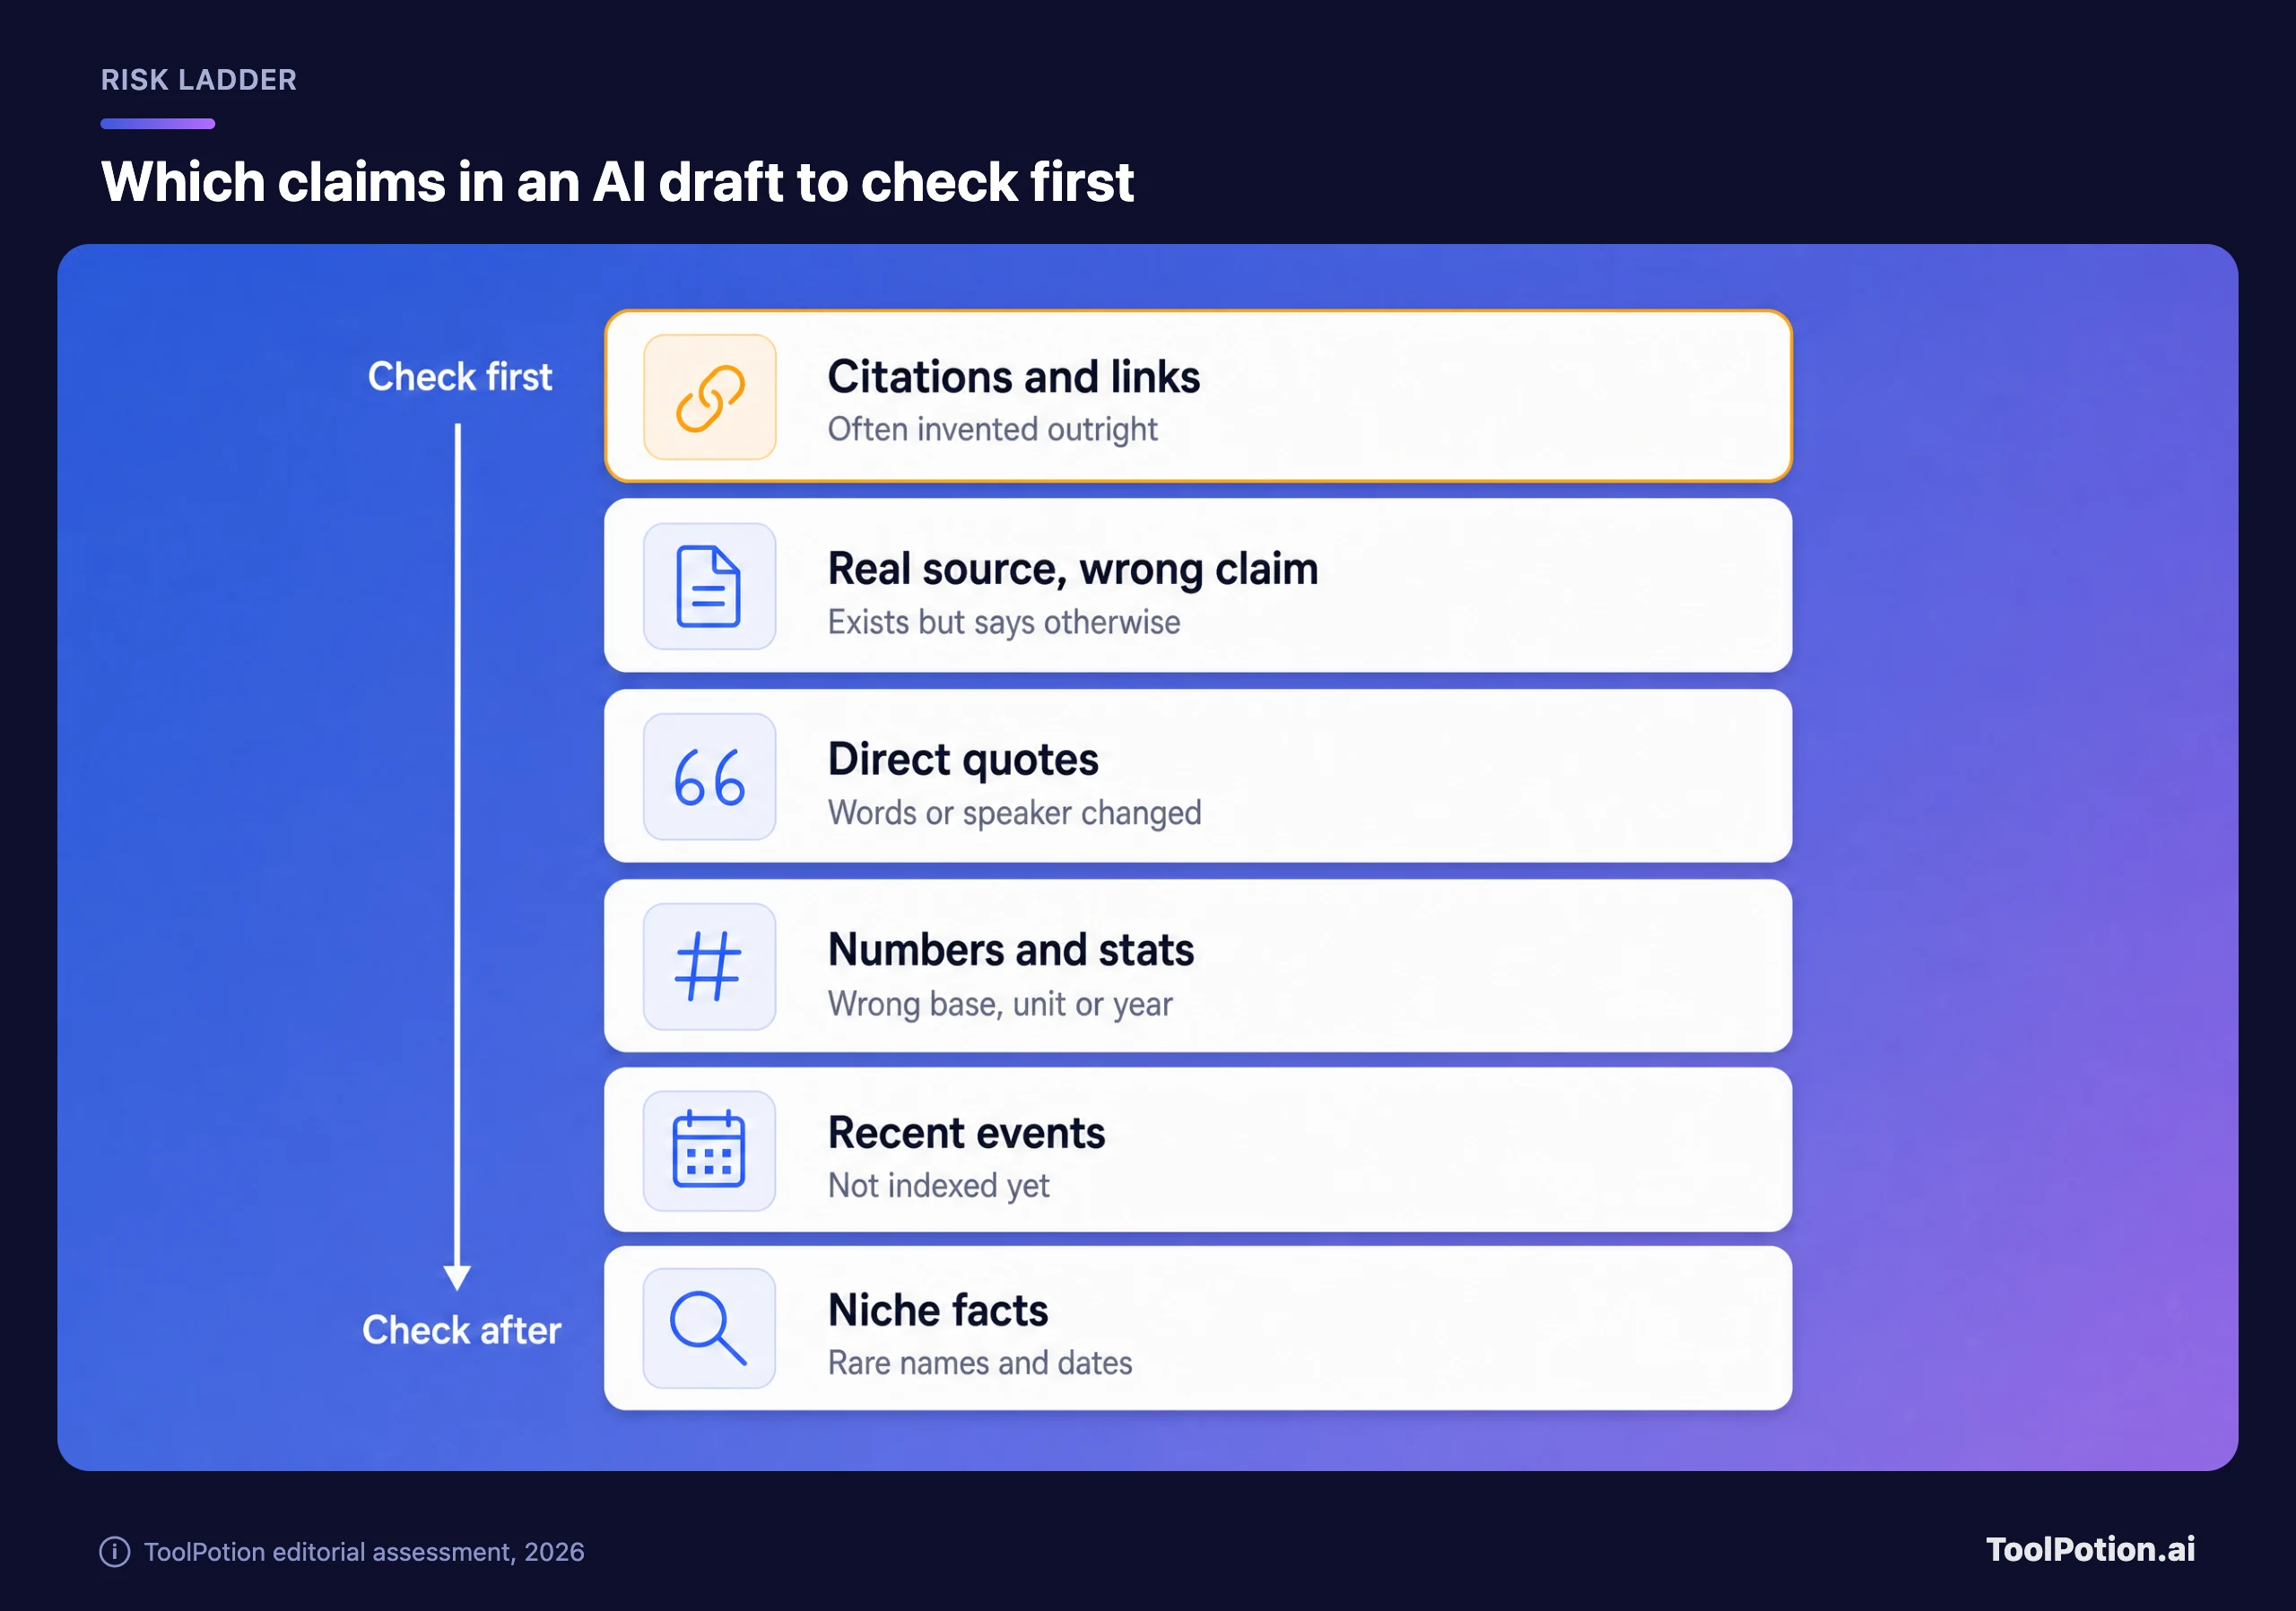
引用排在最前面,因为它有两种出错方式。一种是彻头彻尾的编造:2025 年哥伦比亚大学 Tow Center 用 1,600 条查询测试了八款 AI 搜索工具,让它们找出新闻摘录的出处,这些工具合计答错超过 60%,其中 Grok 3 的 200 条引用里有 154 条指向了错误页面(Tow Center)。另一种是来源真实,但它并没有说那句话。Charlotin 数据库中,涉及歪曲材料的裁决有 894 起,涉及伪造的有 1,752 起。链接能打开,查不出第二种错误。
接下来是引语。数据库列出了 572 起涉及虚假引语的裁决,而 OpenAI 自己的帮助中心也把"编造的引语、研究、引用,或指向不存在来源的参考文献"列为 ChatGPT 已知的失效模式(OpenAI Help)。数字的错误则更隐蔽:数字是真的,但年份不对;把百分比当成百分点;把某个地区的价格说成全球价格。
时效性本身就是一个陷阱。Perplexity 的开发者文档指出,当信息位于登录墙或付费墙之后、搜索返回"相关但不匹配的结果",或者"非常新的信息尚未被索引"时,最容易出现幻觉(Perplexity docs)。2025 年一项由 BBC 牵头的研究分析了 ChatGPT、Microsoft Copilot、Google Gemini 和 Perplexity 的 3,000 多条新闻回答,发现其中 20% 存在严重的准确性问题,包括信息过时。
还有语气问题。在 Tow Center 的那次测试中,ChatGPT 误判了 134 篇文章,却只在 200 条回复中的 15 条里表示不确定;一些工具的付费版本答对的问题更多,但同时给出的"自信的错误答案"也更多。OpenAI 的帮助页面说得很直白:"模型即使在答错时也可能表现出很高的信心。"在 AI 输出里,自信的语气几乎说明不了准确性。
为什么让模型再检查一遍靠不住
最直接的捷径,是把草稿贴回去问它是否准确。Mata v. Avianca 案已经展示了结果,研究也印证了这一点。ICLR 2024 上发表的一篇论文发现,模型"在没有外部反馈的情况下很难自我纠正答案,有时自我纠正之后表现反而变差"(Huang et al.)。
原因出在训练上。OpenAI 的研究人员认为,"标准的训练和评估流程奖励猜测,而不是承认不确定",就像选择题考试会奖励瞎蒙而不是留白。他们也承认,准确率"永远不会达到 100%",因为现实中有些问题本来就无法回答。模型复查自己的草稿,用的还是当初产生错误的那套知识,所以复查往往只是把错误重复一遍。
自查也不是毫无用处。2023 年一篇关于 Chain-of-Verification 的论文表明,结构化的做法是有帮助的:模型先起草答案,再写出验证问题,独立于草稿作答,然后修订。这在多个任务上减少了幻觉。把它当作找出"嫌疑项"的方法,而不是给它们洗清嫌疑的方法。
有依据不等于正确
给模型一份来源让它据此作答,能降低错误率,但不能归零。Vectara 的公开排行榜让模型只用每篇文章中的事实,为 7,700 多篇文章生成摘要,再用 Vectara 自己的检测模型给摘要打分。即便在这么简单的设定下,榜单上的每个模型都会在一定比例的摘要里加入没有依据的内容(Vectara)。
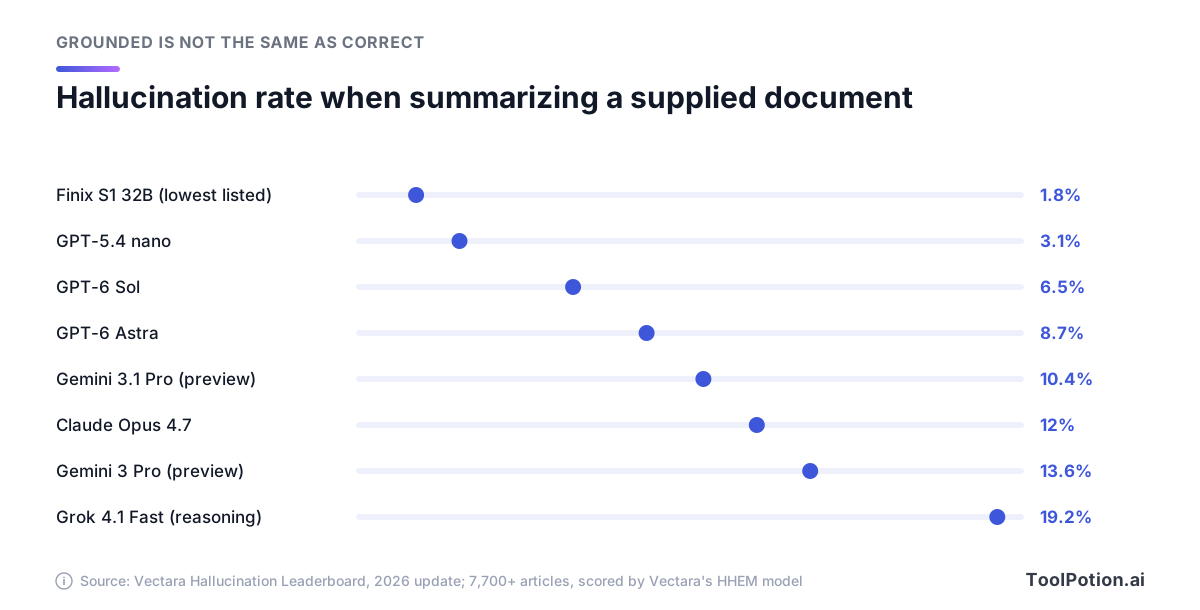
在最新一次更新中,GPT-6 Sol 在 6.5% 的摘要里加入了没有依据的内容,Claude Opus 4.7 是 12%。用一个模型给另一个模型打分并不完美,Vectara 也明确说过这项测试并不涵盖所有类型的幻觉,而且榜单还没有包含所有最新发布的模型。但趋势依然清楚。2024 年一项针对法律检索工具的研究发现,这些工具虽然检索的是真实判例,包括 Lexis+ AI 和 Westlaw 的 AI-Assisted Research,仍有 17% 到 33% 的时候出现幻觉。有了依据,问题就收窄成一个:来源里真的这么说吗?这个问题仍然得你自己去问。
按风险排序的验证工作流
解法是分级。一份草稿的大部分是"结缔组织":铺垫、过渡,以及反正你都会为之辩护的观点。真正撑起文章的只有少数几条论断,出了错造成伤害的也是这几条。先排序,再把核查时间花在最值得的地方。
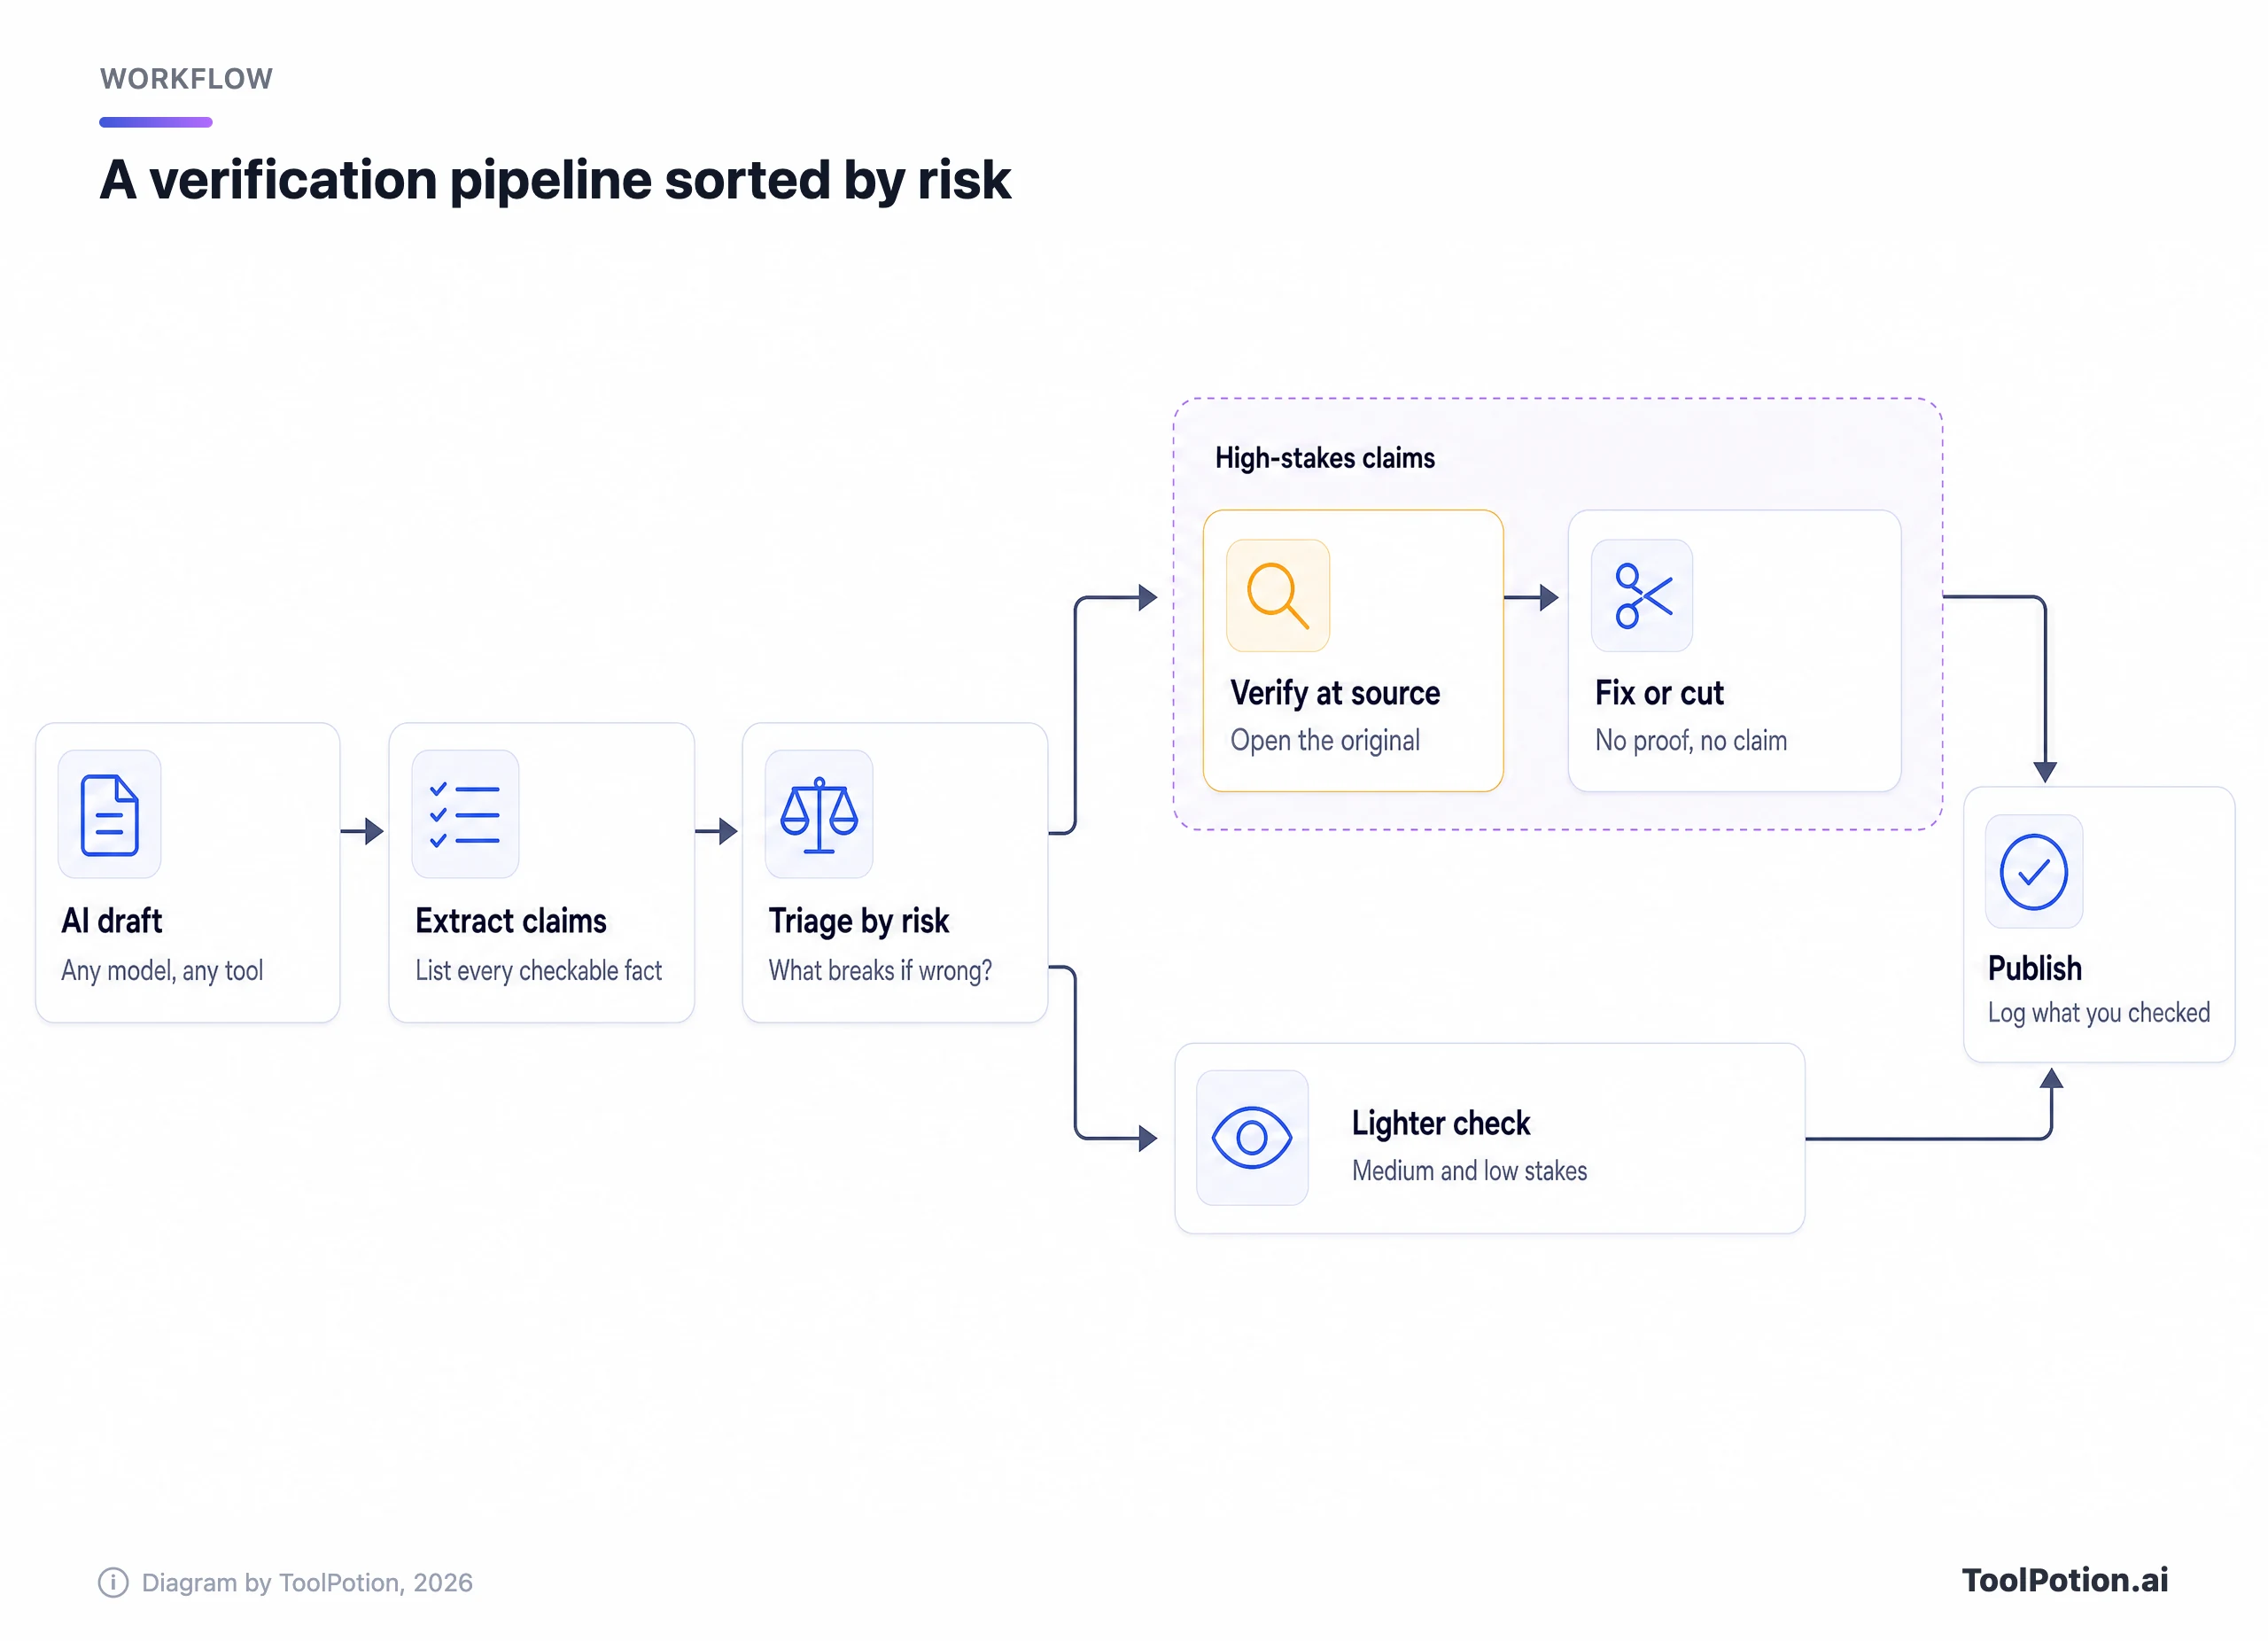
- 提取论断。让模型列出草稿中所有可核查的陈述:人名、数字、日期、引语、引用和因果论断。你会发现一些自己都没意识到写进去的论断。
- 按风险程度分级。问问自己:每条论断如果错了会怎样。任何涉及法律、医疗或财务的内容都是高风险,每一条引用、每一句直接引语、标题或摘要里的任何统计数据,以及任何关于具名个人或公司的论断,也都是。读者可能会转述的辅助背景属于中风险。凭记忆就能为之辩护的铺垫属于低风险。
- 对高风险层,回到原始来源验证:法院判决书、备案文件、数据集、公司自己的页面、论文本身。一篇报道某项研究的新闻,不等于这项研究本身。
- 中风险层用下文介绍的横向阅读做抽查,低风险层则由编辑通读一遍即可。
- 修正、弱化或删除。如果你无法在合理的时间内确认某条论断,就删掉它,或者明确标注出处("厂商称")。永远不要因为一条论断听起来对就留下它。
- 做好记录。每条高风险论断写一行,包括论断内容、来源,以及来源中哪里支持它,只需几分钟,却能回答编辑、客户或法官迟早会问的那个问题。
投入的精力要与输出的传播范围相匹配。头脑风暴只需认真读一遍。交付给客户的成果,则需要把每条高风险论断都追到来源打开确认。如果核查的工作量看起来太大,多半是草稿里的论断太多了,删减往往比验证更快。
不确定某条输出属于哪一级?回答下面最多三个问题。
注意这棵决策树问的是什么:输出去往哪里、包含什么,而不是哪个模型写的。更强的模型会改变出错的概率,但不会改变谁来为错误负责。
如何核查引用、引语和数字
每种论断都有各自的快速检验方法。都不需要特殊软件,只需要有离开聊天机器人、打开原始来源的自律。
引用
先查是否存在。在你自己掌控的数据库或搜索引擎里搜索标题、DOI、案号或 URL,不要在生成它的聊天机器人里查。然后查是否有依据:打开来源,找到支持这句话的段落。如果几分钟内找不到,这条引用就不合格。版本也要留意。Tow Center 发现,AI 搜索工具经常指向转载的副本而不是原始出版方,预印本也可能和正式发表的论文不一样。
引语
挑一段五六个词的独特短语,加引号搜索。如果哪里都搜不到,或者只出现在看起来像机器写的页面上,就把这句引语当作编造的。如果是真的,读一下前后的段落,确认说话人、日期和含义。断章取义的真实引语,误导性不亚于假引语。
数字
能重新计算的都重新算一遍。确认单位(百分比还是百分点、按月还是按年、哪种货币)、年份和分母。如果草稿说某个数字翻了一番,就把前后两个数字都找出来。没有明确出处的统计数据不能放进去,不管它看起来多合理。
近期事件和病毒式传播的说法
核对每个来源的日期,优先选用事件发生之后发布的报道。对于已经在网上流传的说法,Google 的 Fact Check Explorer 可以搜索已发布的事实核查,并显示是哪家机构、如何评定这条说法的。你也可以上传图片,看它以前是否被核查过。
发布之前,用下面这份清单把草稿过一遍。前四项的权重是双倍。
权重的依据来自法院数据:伪造的引用、被歪曲的来源和虚假引语占了该数据库的大部分。如果这四个框没有勾上,清单上的其他项再齐全,也不能保证草稿可以放心发出去。
没有出处可查的论断,用横向阅读
有些论断没有附带可打开的引用。对这类论断,借用专业事实核查员的习惯。斯坦福的 Civic Online Reasoning 小组在观察事实核查员的工作方式后得出结论:"了解一个网站的最佳方式是横向阅读":离开这个页面,看看其他来源怎么说它,而不是盯着页面本身研究。
Mike Caulfield 把这个习惯整理成了一套四步流程,叫 SIFT(Caulfield)。它很适合用在 AI 的回答上,只需调整一点:你要调查的来源,是聊天机器人加上它挑选的那个链接。
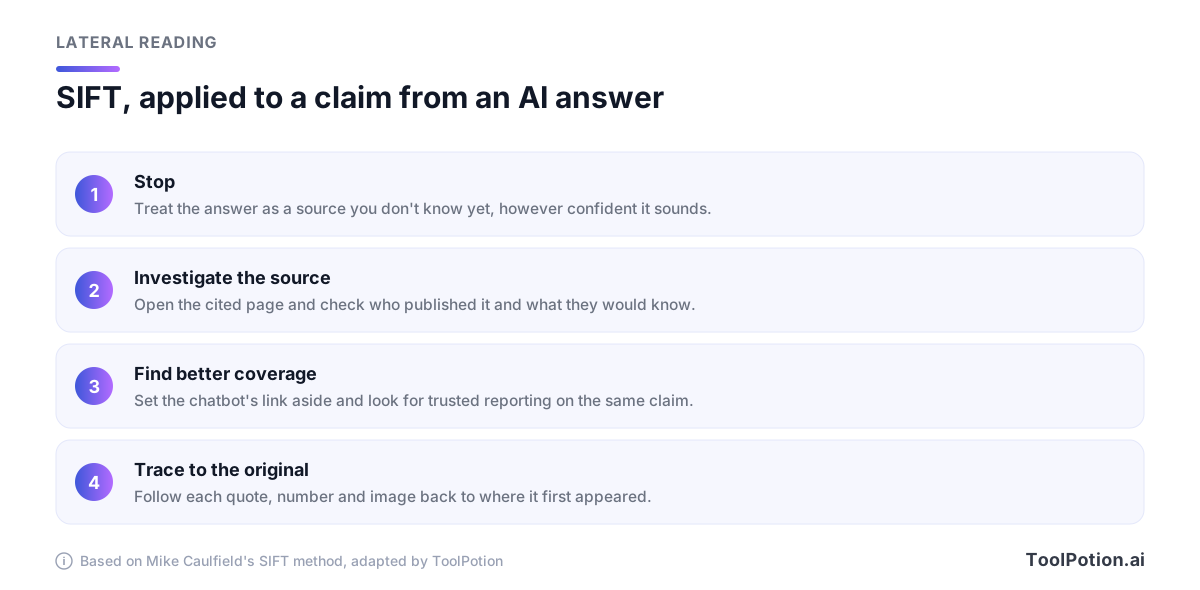
第三步对聊天机器人最管用。当论断本身比承载它的那篇文章更重要时,Caulfield 的建议是"忽略传到你手上的那个来源,转而去找关于这条论断的可信报道或分析"。所以,用你自己的话重新搜索这条论断。如果一件本该被广泛报道的事情没有任何独立报道,你就得到答案了。
横向阅读也能用来判断模型自己找到的来源。一个出自你从未听说过的网站的真实 URL,仍然是薄弱的来源,不管 AI 把参考文献排版得多整齐。
让输出更容易验证的 prompt
你没法靠 prompt 彻底消除幻觉,但可以调整输出的形式,让错误更容易被发现。各家厂商自己的文档是最好的指南。Anthropic 表示,其推荐的技巧"能显著减少幻觉",但"不能完全消除"(Anthropic docs)。想了解更通用的 prompt 习惯,可以看我们的实用 prompt 工程指南。
允许它说"我不知道"
Anthropic 和 Perplexity 都建议开发者明确允许模型承认不确定,或者说明自己没找到。OpenAI 的研究说明了这为什么重要。在 SimpleQA 基准的对比中,一个在 52% 的问题上选择弃答的模型,答错了 26%;而另一个只在 1% 的问题上弃答的模型,答错了 75%,两者的准确率几乎相同。把下面这段作为固定指令:
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
先要引语,再要结论
Anthropic 的文档建议,处理长文档时先逐字提取引语,再做任务;事后让模型为每条论断找到支撑它的引语,并撤回任何找不到支撑的论断。实际操作起来是这样的:
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
让它标出"差一点就对"的情况,也不要强求简短
Perplexity 的指南里有一条值得借鉴的规则:"如果你发现相关但不匹配的结果(例如年份不同、母公司或子公司),请在回答之前明确说明这种不一致。"这能抓住"事实是对的,但安在了错误的主体上"这类最难靠肉眼发现的错误。它的示例规则还要求模型按域名引用来源,并且"不要写完整的 URL"。
长度也有影响。总部在巴黎的 AI 测试公司 Giskard 发现,要求 GPT-4o、Mistral Large 和 Claude 3.7 Sonnet 简洁作答,会让它们变得不那么准确,因为"被迫简短时,模型总是选择简洁而不是准确"。同一项研究还发现,当用户信心十足地陈述一个有争议的说法时,模型更不愿意反驳。提问要保持中立,比如"X 是真的吗?",而不是预设论断成立,比如"解释一下为什么 X。"
提取论断,然后运行两次
这个 prompt 为工作流的第一步提供输入。任何草稿都可以跑一遍,包括你自己写的。
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic 还建议做 best-of-N 检查:用同一个 prompt 运行多次并比较,因为前后不一致的回答往往指向幻觉。这与 OpenAI 看到的三个不同博士论文题目是同一个症状。多次运行的结果不一致,告诉你该往哪里查;结果一致,则什么也证明不了。
基于来源的工具有帮助,但有限度
另一类工具会缩小模型可以调用的范围。这样一来,"这是真的吗?"变成了"来源里是这么说的吗?",后者核查起来更快,但核查这一步依然省不掉。
Google 今年早些时候把 NotebookLM 更名为 Gemini Notebook,并保留为独立的研究工具,Google 称使用者超过 3,000 万人(Google)。在对话中,它基于你添加的来源作答,并"使用来源中的直接引语、文字和图片作为引用"。把鼠标悬停在引用上可以看到引用的原文,点击则可以跳转到上下文中的位置(Gemini Notebook Help)。这让核对依据变得很快。不过也要知道它的短板:Google 的帮助页面说明,不支持有付费墙的网页,Google 文件中的脚注和评论也不会被导入。较新的智能体式对话功能可以搜索网页和运行代码,被标注为实验性功能,并提示"务必再次核对"。
Perplexity 这类答案引擎会在每个回答里附上链接,比没有来源的聊天机器人确实进了一步。但链接仍然需要你打开看。在 Tow Center 2025 年的测试中,Perplexity 有 37% 的查询答错了(这些工具后来已经有变化),而 Google 自己的 Gemini 帮助页也提到"并非所有回复都包含相关链接或来源"。
对于研究类的论断,学术搜索工具把答案建立在论文上,而不是开放网络。Consensus 检索同行评审文献,并表示如果"找不到足够的相关证据,它会告诉你",而不是自己填补空白。Elicit 称,它为每条 AI 生成的论断提供句子级引用。Scite 会显示后续研究是支持还是反驳了某篇论文的发现,这能抓住其他工具漏掉的一种失误:一项真实存在、但后来已被质疑的研究。
如果你自己搭建流水线,Anthropic 的 Citations API 会返回每条论断背后的确切段落,Anthropic 的文档说这些引用"保证包含指向所提供文档的有效指针"。这排除了编造来源,但并不能确认这段文字真的支持它所附着的那句话。参考文献检查工具位于流程的末端。GPTZero 提供一个会扫描参考文献列表的幻觉检测器,据 TechCrunch 报道,其团队标出了 KPMG 的那份报告,并在今年早些时候,在顶级 AI 会议 NeurIPS 收录的 51 篇论文中发现了 100 条幻觉引用。
| 工具类型 | 答案依据 | 你仍需核查的内容 |
|---|---|---|
| 笔记类工具(Gemini Notebook) | 你上传的来源 | 每段引用的文字是否真的支持论断,以及你的来源本身是否正确 |
| 答案引擎(Perplexity、带搜索的 ChatGPT) | 实时网页结果 | 打开每个链接,核对日期,找到原始出版方 |
| 研究搜索(Consensus、Elicit、Scite) | 学术论文 | 论文的实际发现、局限,以及后来是否有相反的研究 |
| 引用 API(Claude Citations) | 你提供的文档 | 论断是否真有依据,而不只是指针有效 |
| 参考文献检查工具(GPTZero) | 文献书目记录 | 一条真实的参考文献是否真的支持草稿中的说法 |
想对比各种选择,可以浏览 AI 研究助手榜单、AI 搜索引擎榜单和学术文献检索榜单。我们的 AI 研究助手盘点和 AI 搜索引擎盘点对功能和价格有更深入的介绍。
常见问题
可以用一个 AI 模型去核查另一个吗?
作为第一轮筛查,可以。第二个模型,尤其是带搜索功能的,会标出第一个模型漏掉的一些错误,两者的分歧也会告诉你该往哪里查。但它无法确认任何事情,因为两个模型可能有同样的盲区。把它标出的问题当作待办清单,逐条回到来源去解决。如果你在挑选第二个助手,我们的 ChatGPT 替代方案指南对比了主要的选择。
AI 检测器能核查事实吗?
不能。Originality.ai detector 这类工具估计的是文本是否由机器写成。这与论断是否属实毫无关系,人写的草稿同样可能出错。事实核查需要原始来源。
核查一份 AI 草稿应该花多长时间?
这取决于草稿里有多少条高风险论断,而不是它有多长。分级之后数一数。一篇 2,000 字、含四个统计数据和两句引语的说明文,是个很短的活;而一页满是引用的备忘录就不是了。
可以把 ChatGPT 或其他聊天机器人当作来源引用吗?
事实类内容不行。OpenAI 自己的建议是"把 ChatGPT 当作初稿,而不是最终来源"。引用你验证过的底层文档。如果 AI 的输出本身就是研究对象,比如对某个模型做测试,那就注明你用的是哪个模型、什么时候用的。
深度研究智能体能让核查变得不必要吗?
不能。像 OpenAI 的 deep research 这样的智能体会从大量网络来源汇编带引用的研究报告,这意味着你要打开的引用更多了,而要核查的论断并没有减少。"来源被歪曲"的问题适用于每一句带引用的话,所以报告越长,分级这一步就越重要。