

GitHub 称,在 Artificial Analysis Coding Agent Index 中,Copilot Fusion Max“得分 60,与搭载 Opus 5.5 Max 的 Claude Code 相差不到两分”(GitHub changelog)。The New Stack 的标题却把它写成了一个“以一半的 API 成本击败 Claude Code”的系统(The New Stack)。这是两种完全不同的说法,团队真正该动脑子的,就是这两者之间的差距。
Fusion 已在 GitHub Copilot 中正式发布,是模型选择器里的一个新选项。你不用选模型,只需选一个投入级别(effort level),由 Copilot 针对每条 prompt 决定运行哪些模型、按什么顺序运行。这个想法不错,但证据基础薄弱,我们会先把它当作成本控制功能,再把它当作质量上的宣称。
60 不等于 62
再仔细读一遍 GitHub 自己的措辞:Fusion Max 与搭载 Opus 5.5 Max 的 Claude Code 相差不到两分,每个任务的平均 API 成本约为一半,token 用量约为一半,耗时少约 40%(changelog)。这个结果值得尊重,作为卖点也站得住脚。但它不是“胜出”,连 The New Stack 自己的正文用的也是“comparable(相当)”,标题却写着“beats(击败)”。GitHub 在 Universe 回顾中又重复了这一说法,而传得最广的正是“成本减半”这个版本。
GitHub 引用的这个指数由 Artificial Analysis 发布,它把 FrontierCode、Terminal-Bench 4.0 和 SWE-Atlas-QnA-AA 三个基准等权合并(Artificial Analysis)。该页面默认视图里,搭载 Opus 5.5 Max 的 Claude Code 是 62 分,没有 Fusion 的条目。打开“Router models”开关后,GitHub Copilot - Copilot Fusion (Max) 就会出现,得分 60,所以这个数字是真的,和 GitHub 说的一致。同一个开关下还能看到 Cognition 的 Devin Fusion CLI,它把 Opus 5.5 Max 和 GPT-6 Luna 搭配使用,与 Claude Code 并列 62 分。这说明路由器这一类产品整体正在追上来,而不是说 GitHub 的这个就是要超越的对象。我们没有拿该页面的成本列去核对 GitHub 的“成本减半”数字,所以这一部分仍然只是 GitHub 的一面之词。
一个菜单入口背后的三条路径
文档把 Fusion 称为“智能的运行时模型路由器和编排器”(GitHub Docs)。对每条 prompt,它会从三种执行模式中选一种,同一个会话里不同的 prompt 可能走不同的路径。
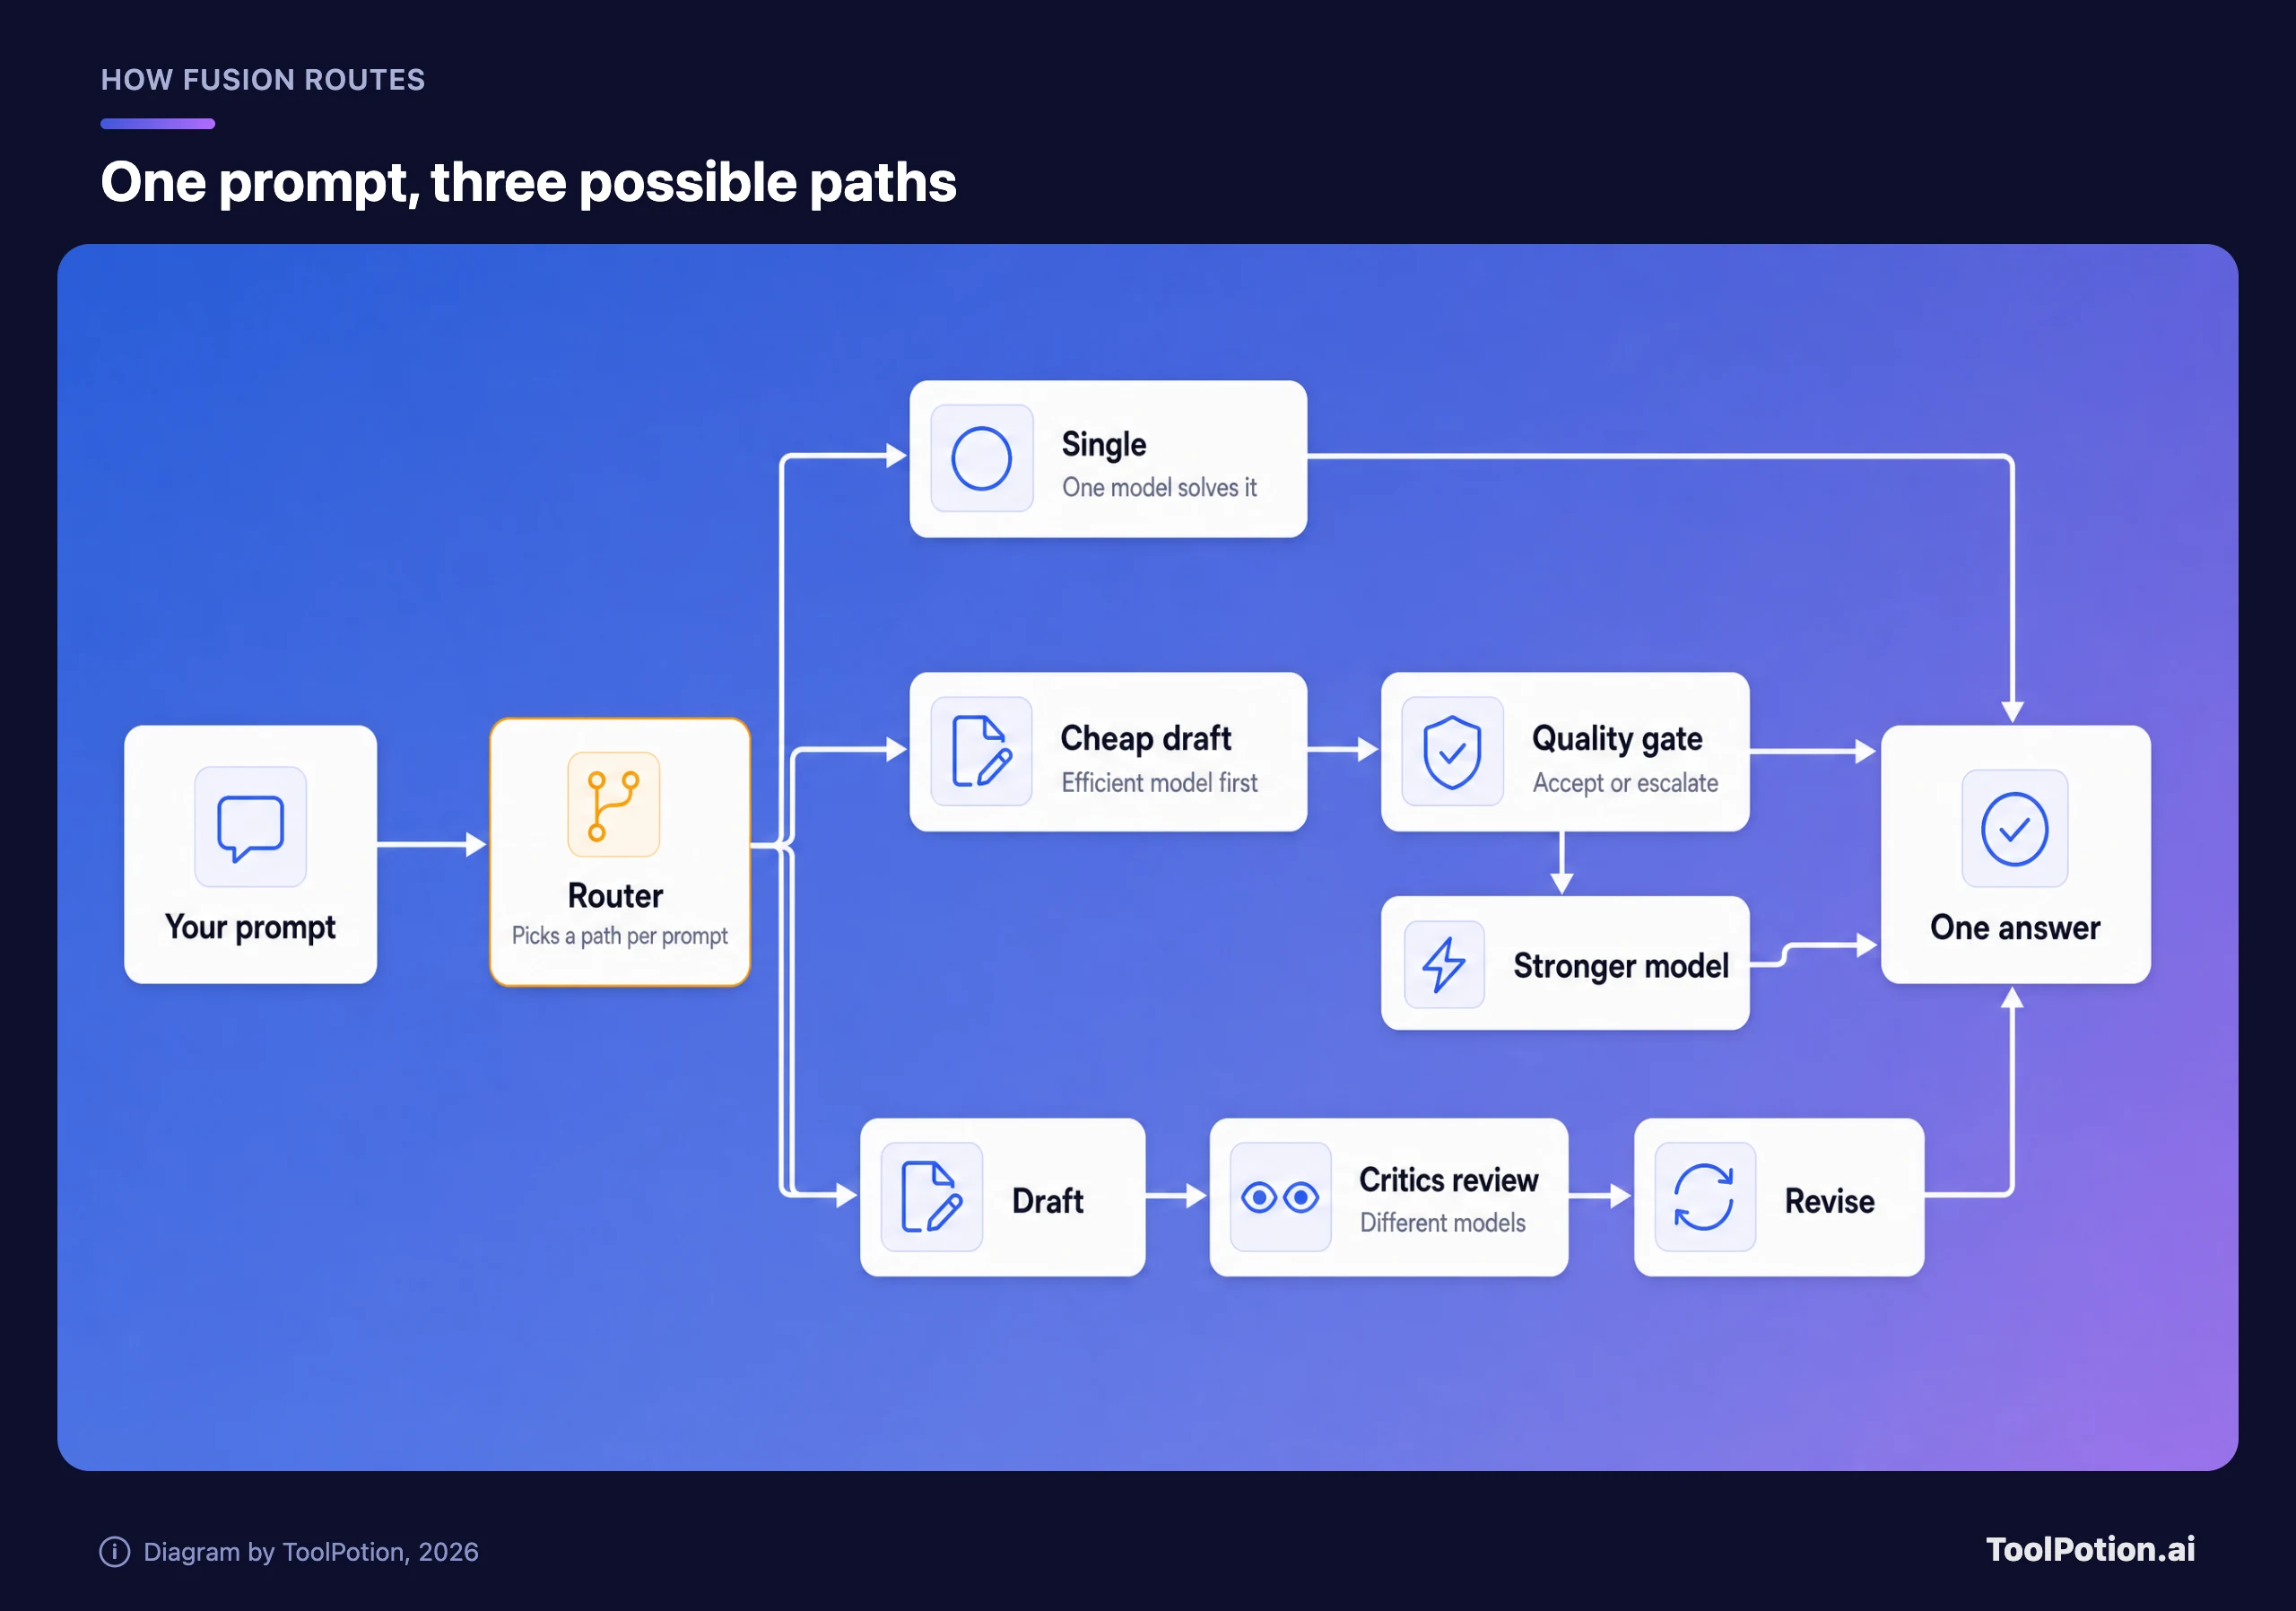
Single 是由一个模型直接作答。Cascade 先让一个高效模型起草,再由评判模型决定是接受草稿,还是升级交给更强的模型。Critique 是一个模型起草,其他模型审阅,起草者再据此修订。投入级别决定路由的激进程度:Standard 用于日常工作,High 用于较大的任务,Max 用于最难的推理。
从预览版到正式发布,有一处细节变了。GitHub 早先的研究预览文章描述的是“来自不同模型家族的、独立的只读评审者”(GitHub blog)。发布时的 changelog 写的是“另一个模型来审阅”,而文档则说多个模型并行评审,再把反馈汇总。我们的理解是,评审环节从一个评审者变成了多个,但 GitHub 没有明说,changelog 也没有标出这个差异。
所有套餐都能用,按模型分别计费
changelog 说,Fusion 在所有 Copilot 套餐中都可用,支持 VS Code、Copilot 应用、Copilot CLI 和 JetBrains IDE,更多客户端后续跟进。它用到的每个模型都按该模型的标准费率计费,Fusion 本身不另外收费。付费套餐在限定时间内可享模型费用 7 折优惠,文档写明该优惠将在今年晚些时候结束(文档)。
还有两处没对上。Fusion 文档说它“适用于所有 GitHub Copilot 套餐”,但套餐页面说,Free 和 Student 套餐只能通过自动模型选择来使用模型。GitHub 没有解释这两者如何统一。文档里按套餐列出投入级别的表格用图标表示是否可用,我们读取时这些图标变成了空单元格,所以没法告诉你 Free 和 Student 席位能用哪些级别,请直接看你自己的选择器。另外,由于 High 和 Max 可能调用多个模型,文档自己就提醒:同一个任务消耗的 AI credits 可能比 Standard 更多。“每个任务成本减半”说的是 Max 对比 Claude Code,并不是对你的 credit 余额的承诺。
这份基准是 GitHub 自己给自己打分
早先的 HydraFusion 文章比发布稿坦率得多。测试中每个模型都用同样的中等推理级别,成本是在统一定价假设下估算的,对比对象是 Opus 5 和 GPT-5.6 Sol。GitHub 还说,路由策略是用 beam search 在它所报告的同样三个基准上调出来的(GitHub blog)。
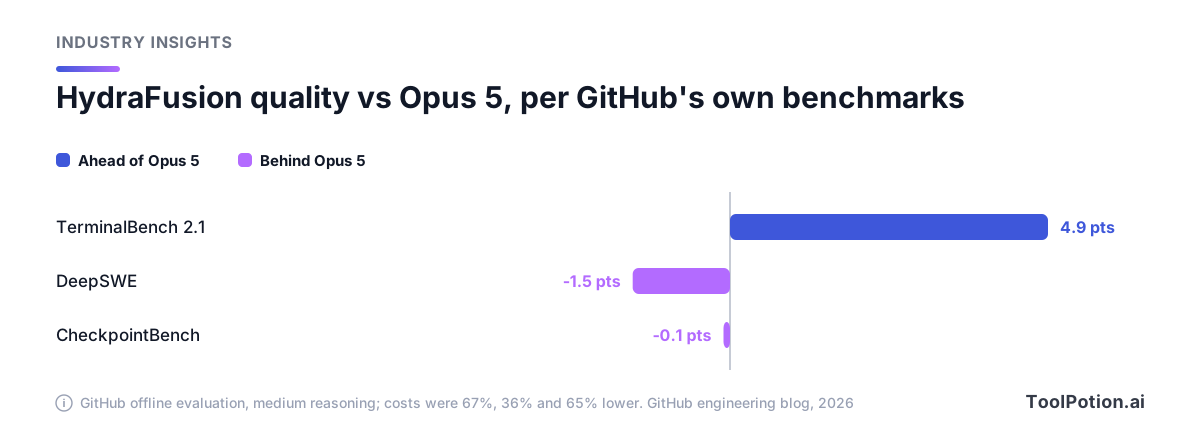
看看这个形状:一个基准提升了 4.9 分,另外两个有小幅下降,成本低 36% 到 67%。这是一个在质量大致持平的前提下省成本的故事,发布稿最后说的其实也是这个。
Hacker News 上的开发者主要质疑基线。一位评论者写道,“Opus 5(实际使用中)不是一个好的对比基线”(HN)。另一位对结果表示怀疑:“只要在模型和 harness 之间多加一层软件,要在单项基准上超过前沿模型并不难”(HN)。同一个帖子里,一位 Copilot CLI 用户说自动模式“只会在会话开始时或压缩之后切换模型”(HN),另一位则称自动选择对他们来说“基本没法用”(HN)。这些只是个别评论者的说法,不是研究,但确实能看出质疑集中在哪里。
还要留意计费口径不一致的问题。该指数和 GitHub 的对比用的是按 token 付费的 API 成本。而使用 Claude Code 包月订阅的开发者根本看不到这个数字,所以“成本减半”对个人用户和按 API 花费计量的团队来说意义不同。Artificial Analysis 自己也指出,很多用户是通过订阅而不是按 token 付费来使用这些工具的。这个结论是我们的推断,不是 GitHub 的说法,但它改变了这条标题到底是说给谁听的。
GitHub 提供的唯一一段客户心声来自 AT&T 的 Hari Pokhrel,引自 GitHub 自己的 changelog:“以前,开发者处理复杂任务时往往会选更强大的模型,然后在日常工作中忘了切换回来。”这才是 Fusion 最实在的价值:它能防止大家在日常琐事上一直开着昂贵的模型。
你的策略决定谁能看到你的 diff
这部分我们建议比基准测试更先读。Fusion 只会使用在你的企业和组织策略中已启用的模型。管理员可以只对 Fusion 禁用某些模型,而不必在所有地方都禁用,受数据驻留或 FedRAMP 策略限制的模型也会被排除在外(文档)。
由第二个模型来评审是这个设计押的宝,预览文章说这个评审者来自不同的模型家族。如果这意味着另一家厂商,那它就会看到你的 diff,这是一个数据处理上的决定,团队里应该有人有意识地去做。得到响应后,你可以把鼠标悬停在投入级别标签上,查看实际运行了哪些模型。
限制说明部分同样重要。如果 Fusion 丢弃了某份草稿,该草稿已经做过的文件修改不会被自动撤销,所以提交前要检查 diff。Fusion 也没有自己的上下文窗口:界面上显示的数值是它所含模型中最小的那个。
团队试用时我们会怎么放
对一个 Copilot 团队,我们会把 Fusion Standard 设为默认,不会把 Max 设为默认。它在独立指数上的 60 分不错,但 Max 是调用模型最多、消耗 credit 最多的级别。AT&T 那个故事发生在 Standard 上,路由省钱最多的也是 Standard。对于已经在用 Claude Code 或 Codex 的团队,锁定问题要反过来看:这些工具绑定的是某一家厂商的模型,而 Fusion 是 GitHub 控制的路由器,GitHub 可以随时调整。两边都不是没有依赖。
我们已有的对比文章覆盖了这些工具本身:终端编程 agent、Cursor 对比 Copilot 和 Windsurf、按任务匹配模型档位,以及更全面的编程工具清单。Fusion 改变的是这些对比里的成本一栏,不会改变你会选哪个工具。Cursor 用户目前还没有对应的结论,想看当前行业的排序,可以去 ToolRank 编程助手榜单。
真正能下结论的测试成本很低:拿十个真实的工单,分别用 Fusion Standard 和你现在的配置跑一遍,统计被接受的改动数和消耗的 credit。GitHub 的折扣今年晚些时候就到期了,所以要赶在这之前测。然后再回头看一下 Artificial Analysis 上的 Router models 视图,那里的路由器条目是最可能变动的。