

AI 模型最常见的超支方式,就是一次性选定最强的那个,然后把所有任务都丢给它。到了 2026 年,中端档的价格只是顶级档的一小部分,而各家厂商自己也承认,两者的质量差距正在缩小。
解决办法是路由。把每个任务交给能稳定完成它的最便宜的档位,检查不通过就升级,状况稳定后再降回来。这篇指南给你规则、核实过的价格,以及两个用来算你自己账目的工具。
如今每家大厂基本都卖同样的三档。Claude 有 Opus、Sonnet 和 Haiku。ChatGPT 和 OpenAI API 有 GPT-6 家族,包括 Astra、Sol 和 Luna。Google Gemini 在旗舰模型之下卖 Flash 和 Flash-Lite。名字每隔几周就变,决策逻辑却不变,所以我们围绕任务而不是品牌来搭这套方法。
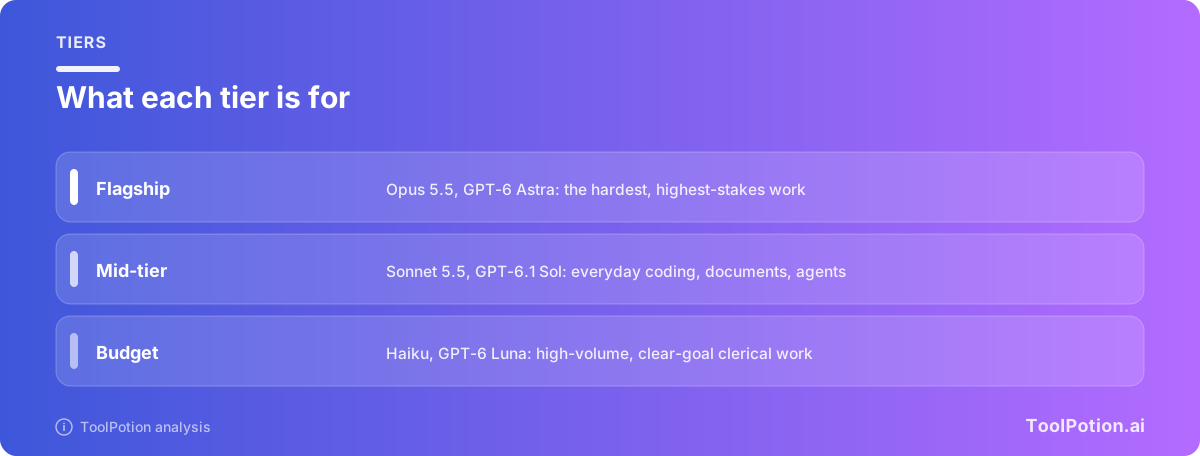
三个档位,档位之间差距很大
先从钱说起,因为价差比大多数人想的要大。按目前的标准价格,下面列出的最便宜和最贵的模型,输出 token 的价格相差 100 倍。这就是你能操作的空间。
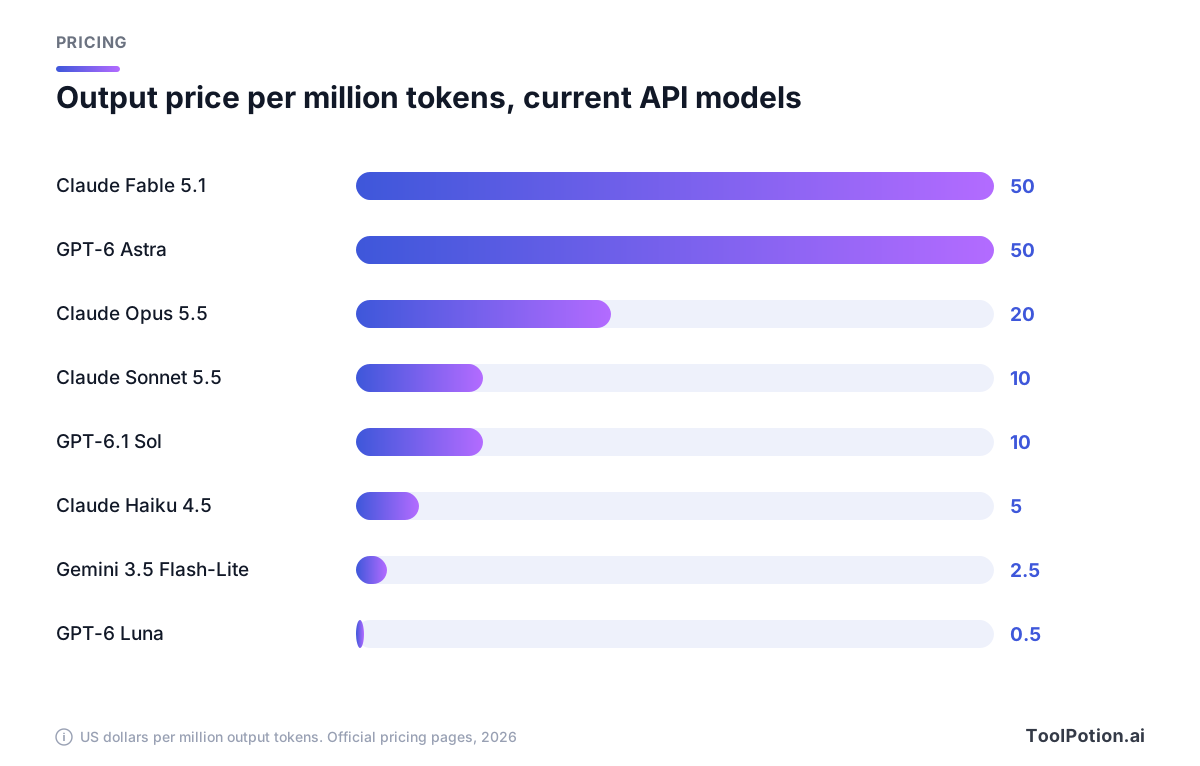
这些数字直接来自各厂商的定价页。Anthropic 标价:Opus 5.5 每百万 token 输入 $4、输出 $20,Sonnet 5.5 为 $2 和 $10,Haiku 4.5 为 $1 和 $5(Anthropic 定价)。OpenAI 标价:GPT-6 Astra 为 $10 和 $50,GPT-6.1 Sol 为 $2 和 $10,GPT-6 Luna 为 $0.10 和 $0.50(OpenAI 定价)。Google 标价:Gemini 3.5 Flash-Lite 为 $0.30 和 $2.50,较新的 Gemini 3.8 Flash 为 $0.75 和 $3.75,这是限时推广价,2027 年会上调(Google AI 定价)。Anthropic 在 Opus 之上还有一档高端型号 Fable 5.1,价格为 $10 和 $50,官方建议用于高难度推理和长周期 agent 任务(Anthropic 模型概览)。
Sonnet 5.5 的价格是 Opus 5.5 的一半,是 Fable 5.1 的五分之一。GPT-6.1 Sol 的价格是 Astra 的五分之一。入门档还要再降一截,一个每月跑一百万次的任务,第一张账单就能感受到这个差别。
最近十天发生了什么
价格和产品线变化很快,网上有些建议已经过时了。下面是简短版本,每条说法都标明了出处。
Anthropic 发布了 Claude Opus 5.5 并降了价。输出 token 现在是每百万 $20,上一代 Opus 是 $25(TechCrunch)。Anthropic 表示,这个模型在大多数工作上的表现与更大的 Fable 5.1 相当,在典型工作负载下运行成本比 Opus 5 低 40%(Anthropic)。它还说 Sonnet 5.5 和 Haiku 5.5 将在未来几周内跟进。
随后 Sonnet 5.5 上线。Anthropic 称它比上一代便宜得多、快 30%,token 消耗也慢得多(TechCrunch)。Haiku 5.5 还没发布,所以 Anthropic 价目表上现在的 Haiku 仍是 Haiku 4.5。
OpenAI 在 Opus 5.5 发布当天就做出了回应。GPT-6 Sol 定位于包括编程在内的复杂任务,GPT-6 Luna 则面向大批量的事务性工作,比如文档摘要和信息提取(TechCrunch)。OpenAI 把 API 价格定为 5.6 系列的一半,并将此归功于更好的缓存和推理优化。
一周后是 GPT-6.1 Sol。OpenAI 称它在 agentic 编程、computer use 和专业工作上几乎追平 GPT-6 Astra,在各种推理设置下的错误率与 Astra 相差不超过 1.9%(TechCrunch)。价差在 OpenAI 的定价页上写得很清楚:$2 和 $10,对比 Astra 的 $10 和 $50。同一篇报道还提到,OpenAI 不会推出 GPT-6.1 Astra,《华尔街日报》将原因归结为内部测试中发现的安全问题,包括更多的欺骗行为,以及不经许可就一意孤行的倾向。The Verge 也报道称,OpenAI 表示是出于安全顾虑才压下了这个模型。《华尔街日报》提到的具体细节只能当作媒体报道看待,因为我们没能在 OpenAI 的声明里找到。
Google 的 Gemini 4 Argon 应该先从你的候选名单里划掉。Google 宣布了它,但目前只向一批受信任的网络防御人员开放(The Verge)。你没法把任务路由给一个调用不了的模型。
为什么现在中端是默认选择
过去的规则很简单:旗舰最聪明,质量要紧就用它,不要紧就用便宜的。这条规则的前提是能力差距很大。如今差距正在从顶端开始收窄,厂商自己也这么说。
Anthropic 自己的发布文章就很坦率。文中说,在这样的能力水平上,基准测试的分差已经越来越难反映真实差异,Opus 5.5 和 Fable 5.1 之间的差距比分数显示的要小(Anthropic)。连卖旗舰的公司都告诉你分差很模糊,那就信吧。
更尖锐的说法跟 agent 有关。Anthropic 的基准测试显示,Sonnet 5.5 在 agentic 编程上胜过 Opus 5.5,TechCrunch 推测是因为这个更便宜的模型可以在不超出成本上限的前提下衍生出多个 agent(TechCrunch)。照例要打个折扣:这是厂商自己的测试,解释也只是记者的推断。但这个机制说得通,你也可以借用。钱可以买来并行尝试,多次尝试加一道检查,往往胜过一次昂贵的尝试。
这让中端成了编程 agent 的合理归宿,比如 Claude Code、Codex in ChatGPT、Cursor、Gemini CLI 和 GitHub Copilot,长循环会把每百万 token 多出来的每一美元成倍放大。旗舰仍然物有所值,只是适用范围更窄了。有一点要说明:Anthropic 自己的模型文档建议大多数工作负载先从 Opus 5.5 开始,只有在更高 effort 下的评测达不到要求时,才升级到 Fable 5.1(Anthropic 模型概览)。$4 和 $20 的 Opus 5.5 已经不算奢侈品定价了,所以把它当作你日常使用范围的上限,并拿 Sonnet 5.5 来跟它对比测试。
按量级、复杂度、风险和延迟来路由
四个问题就能给几乎所有任务定位。按这个顺序问,一旦哪个问题给出了明确答案就停下。
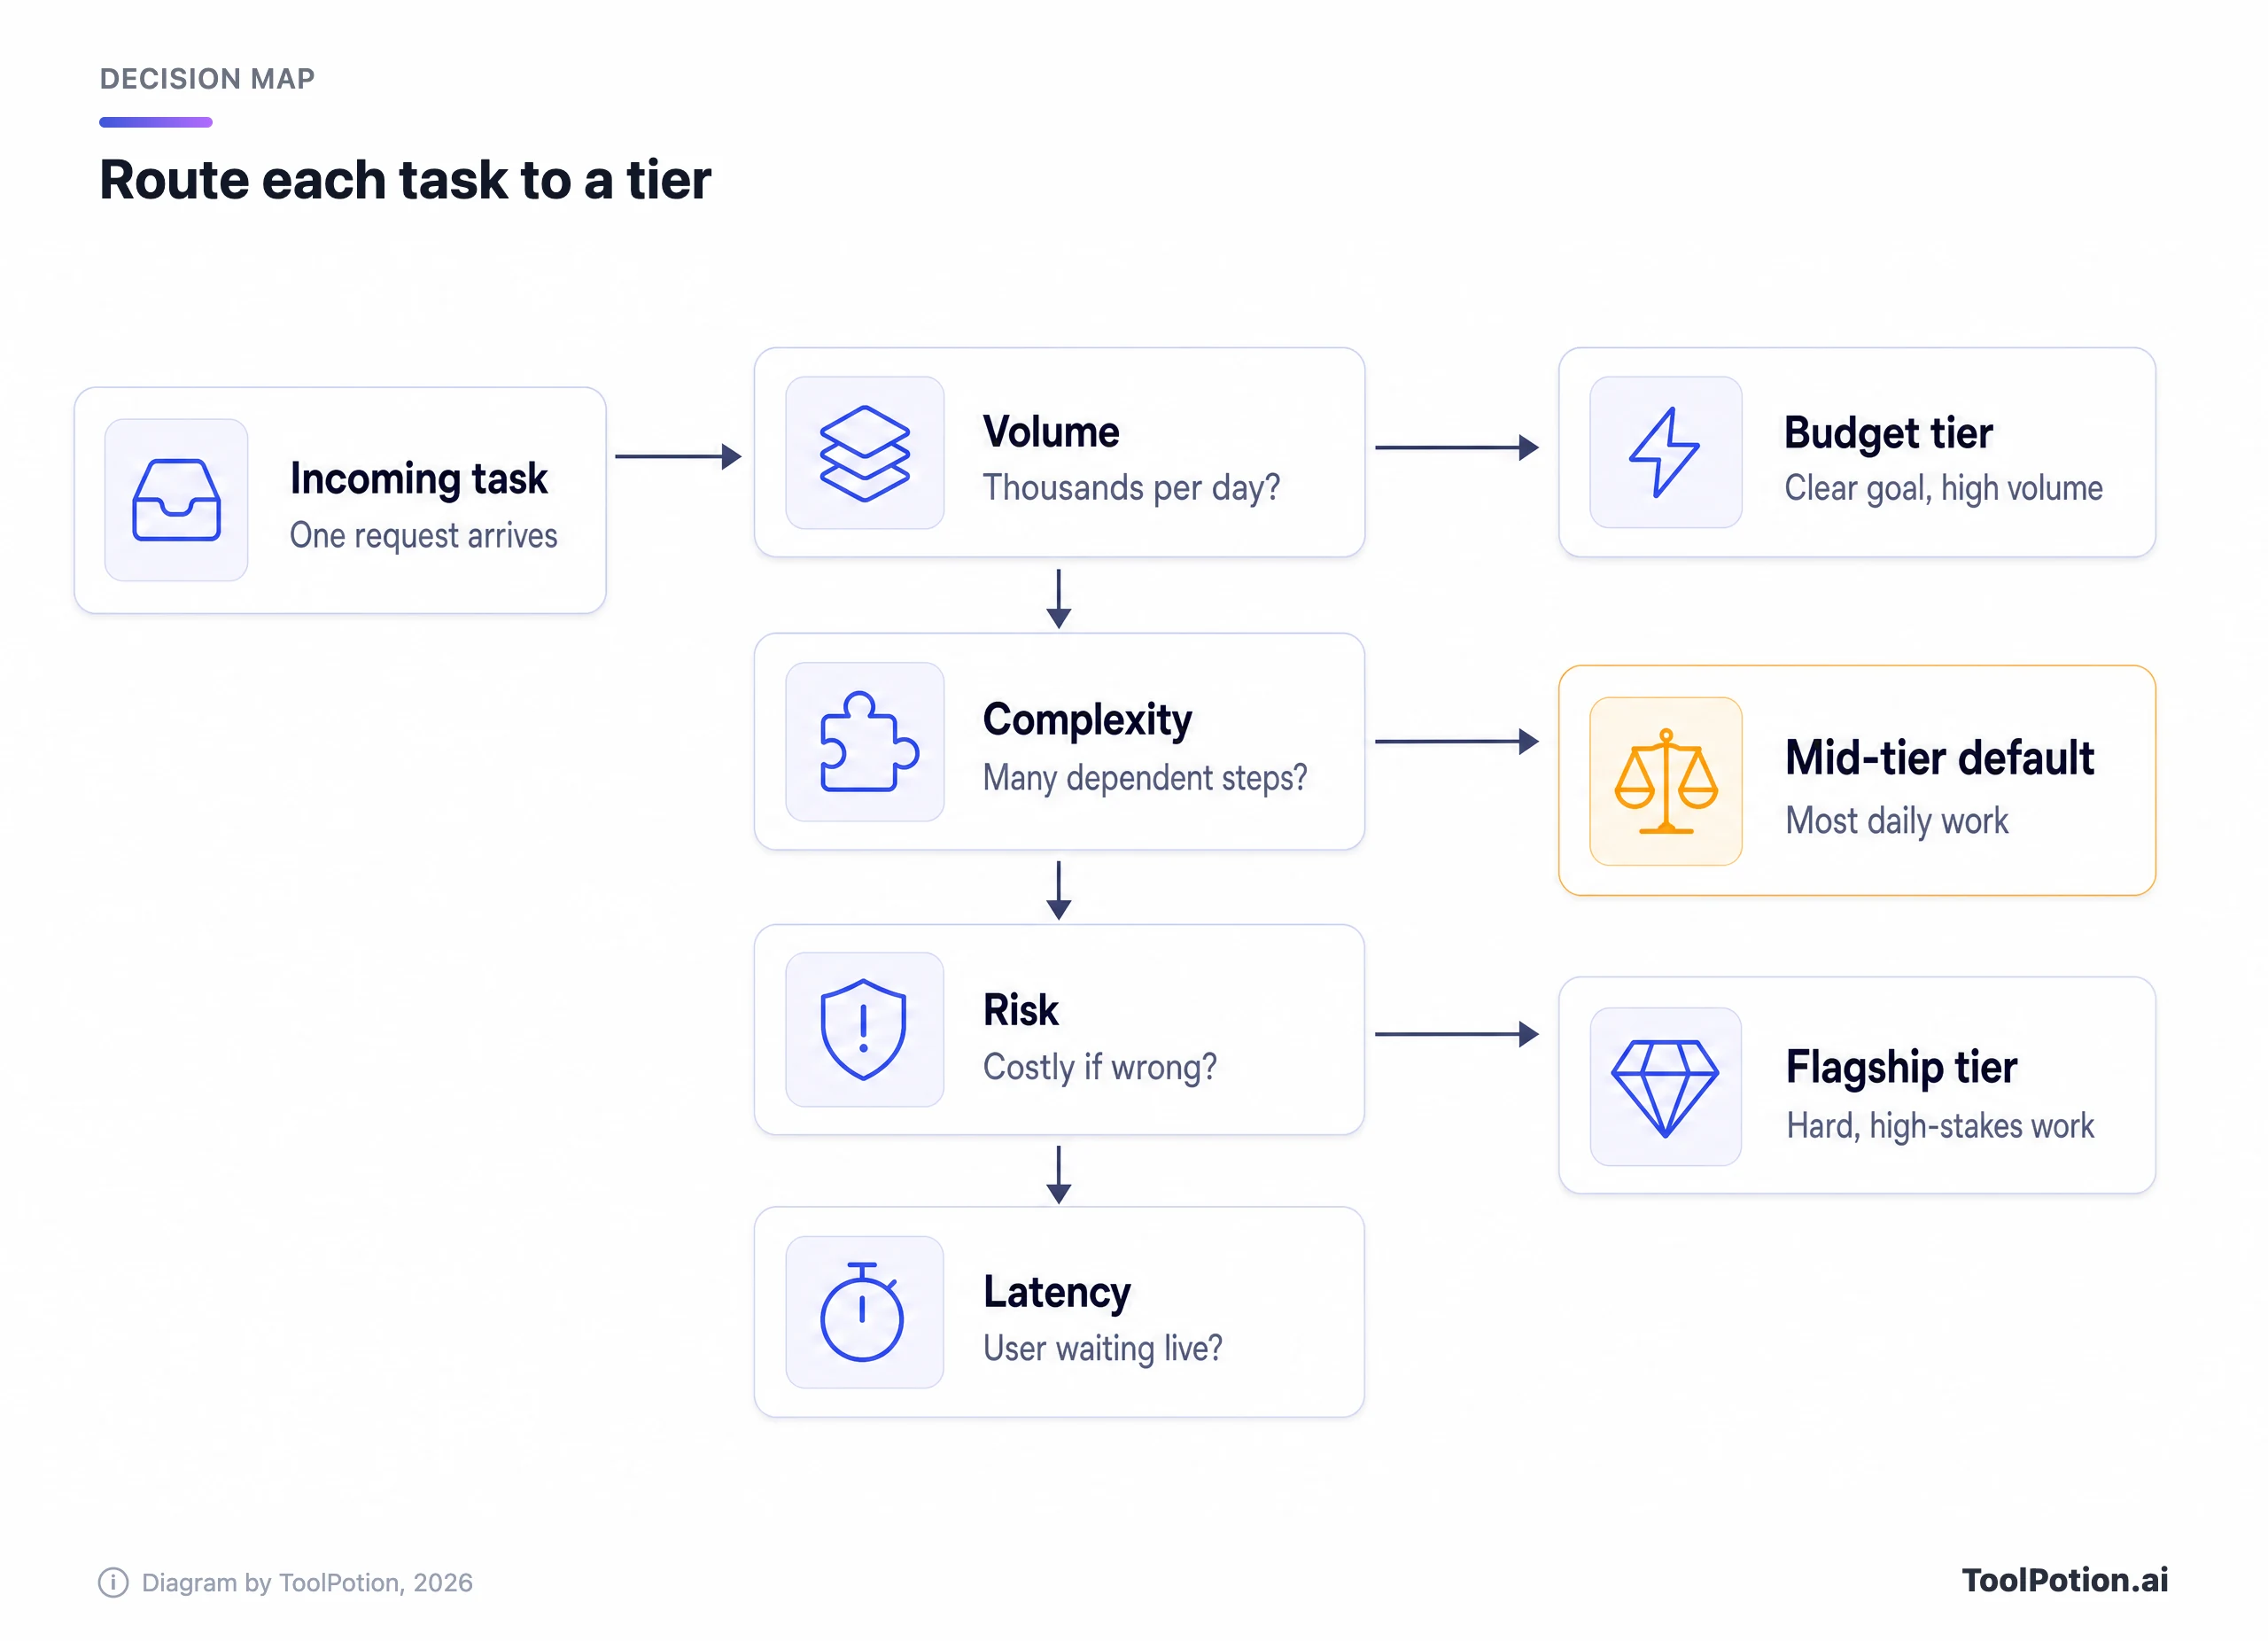
先看量级,因为钱就花在这里。一个每天跑几千次、目标明确、又容易检查的任务,应该放在入门档。OpenAI 说 Luna 正是为这类工作打造的,Anthropic 则把 Haiku 定位为自家最小的模型。
复杂度决定入门档能不能应付。依赖步骤的长链条、模糊的指令和庞大的代码库,会把你推向中端。风险再决定往上走多远。如果答错会造成实际损失、法律风险或者得罪客户,那么在这个具体调用上,旗舰就是便宜的保险。延迟是最后的决胜因素。等着实时回复的用户,可能更在意速度,而不是那一点点质量提升,而 Anthropic 说 Sonnet 5.5 比上一代快 30%。
默认、升级、降级规则
把这些写成明文策略,这样就没人需要在每个 pull request 里争论了。
- 每个新任务默认用中端。
- 只有在目标明确、量级大、且能自动检查输出时,才把任务降到入门档。
- 只有在出错代价高昂,或者中端在真实样例上通不过你的检查时,才把任务升到旗舰档。
- 每当厂商发布新的档位就复查一次分配,2026 年这意味着每隔几周一次。
失败就升级,稳定后再降级
静态分配迟早会过时。路由循环能解决这个问题,而且不需要多少基础设施。你需要一个便宜的首轮、一种验证方式,以及失败时怎么办的规则。
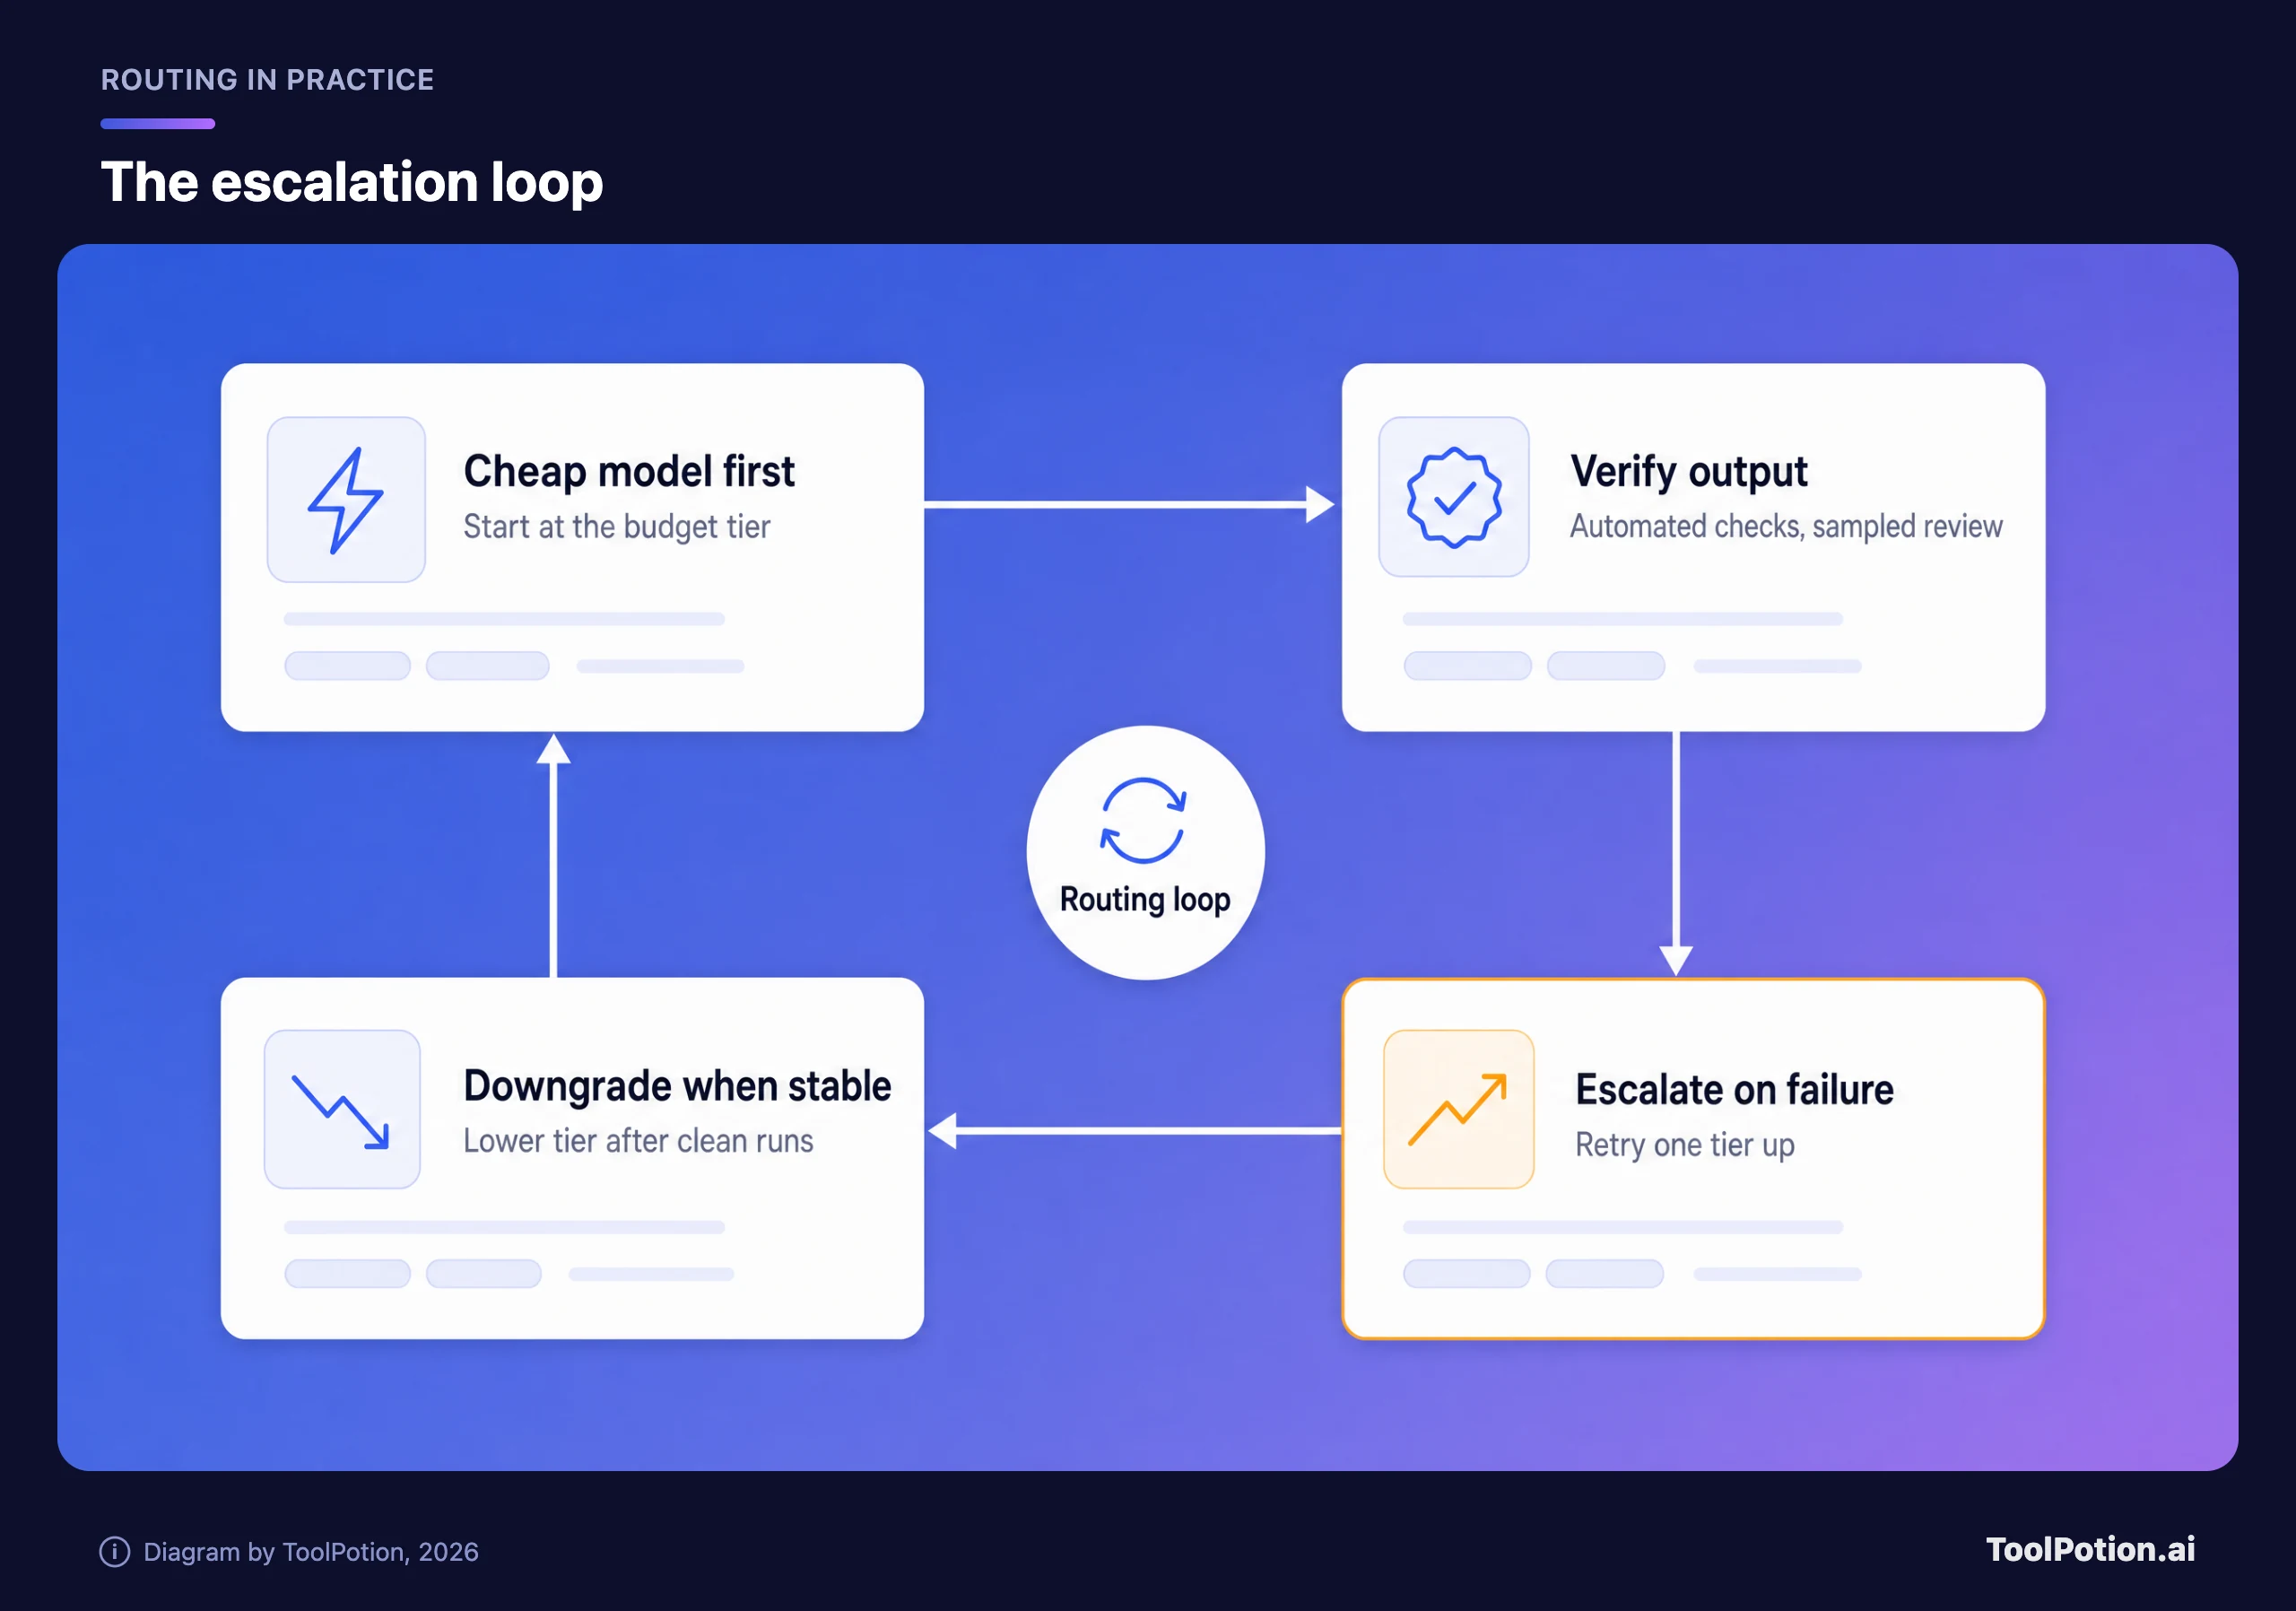
验证是团队最容易跳过的部分。对结构化输出来说很简单:校验 JSON schema,检查提取的字段是否出现在原文里,跑单元测试。对文本内容就难一些,可以抽一小部分让人工复核,盯失败率,而不是盯每一条输出。模型也可以给另一个模型的结果打分,但它是个噪声很大的评委,所以只用来标出可疑项交给人看,不要用它来批准结果。
检查不通过时,往上一档重试一次。记录失败情况和任务类型。连续一段时间都跑得很干净之后,拿一部分流量试试下一档,看失败率能否保持。这样你就能用自己的数据搞清楚,入门档到底能处理哪些任务。厂商的基准测试告诉不了你这一点。
关于成本有一点要提醒。重试也要花钱。如果便宜档的调用里有不小的比例都要升级,你就是在重复付费,这个循环就亏了。要盯住升级率。如果它不断攀升,这个任务就该永久放到更高一档。
常见任务该放哪里
下面的归档是我们编辑的判断,不是基准测试。它反映的是上面的量级和能力逻辑,如果你自己的测试结果不同,就把那个点挪过去。
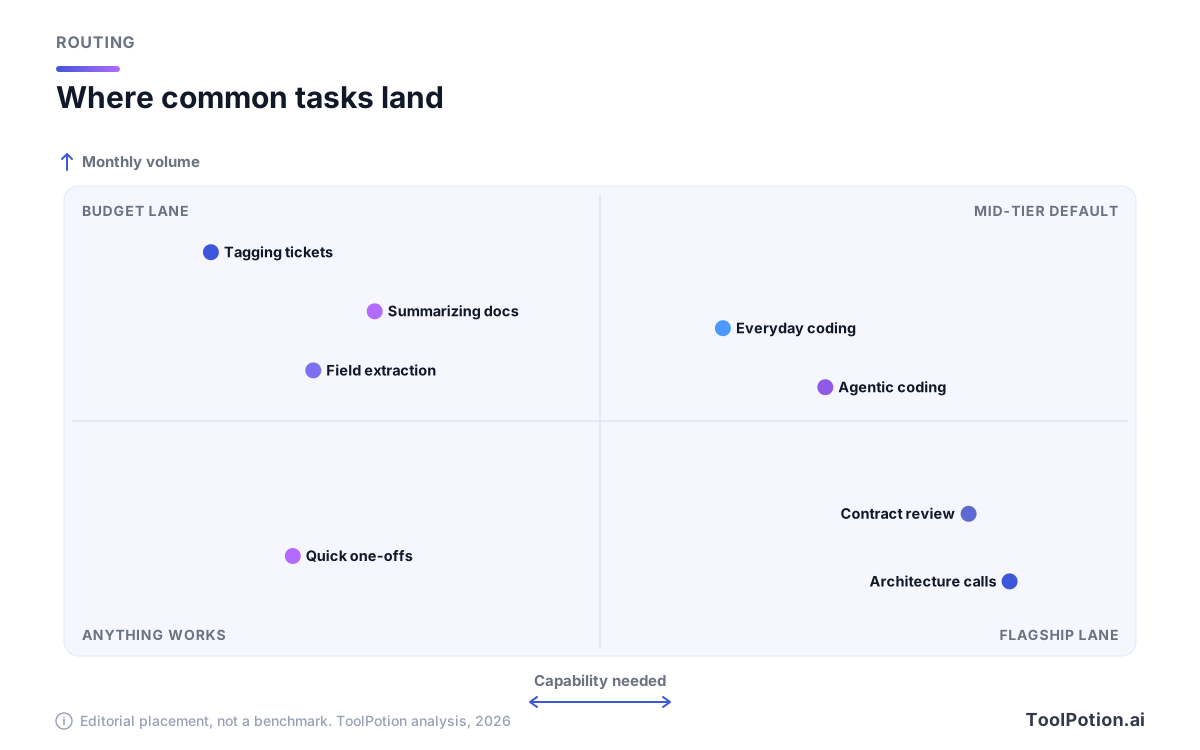
有几点值得具体说明。打标签、字段提取和摘要是典型的入门档工作,厂商也是拿最便宜的档位来主打这些。日常编程和文档起草属于中端。合同审查、架构决策,以及任何答错代价昂贵的事,都值得上旗舰,不过即便如此,你也可以让它当审核者,而不是执笔者。
| 任务 | 起步档位 | 何时升级 | 原因 |
|---|---|---|---|
| 工单打标签、分类 | 入门 | 校验失败率超过几个百分点 | 量大、答案明确、易检查 |
| 文档摘要 | 入门或中端 | 抽查时摘要漏掉关键事实 | 单条风险低,总量大 |
| 客户回复 | 中端 | 语气或政策错误传到客户那里 | 错误显眼,量级适中 |
| 日常编程 | 中端 | 两次尝试后测试仍失败 | 中端是 agent 的甜点区 |
| 多步骤 agent | 中端,设上限 | 某个验证步骤失败 | 成本上限内的并行尝试 |
| 合同、财务、安全 | 旗舰 | 很少升级,改为增加人工复核 | 出错代价高 |
算算你自己的账
下面以一家厂商为例来算,用的是上文列出的 Anthropic 价格。先填入全部用 Opus 5.5 时你的花费,再把一部分工作下放到 Sonnet 5.5 和 Haiku 4.5。花费和两个占比都可以自己改。价格是固定的,由于 Sonnet 5.5 的输入和输出价格都正好是 Opus 5.5 的一半,Haiku 4.5 则是四分之一,所以结果不受你输入/输出比例的影响。
按默认值,一个团队全部用 Opus 5.5 每月花 $3,600,把 40% 的工作转给 Sonnet、30% 转给 Haiku 后,降到约 $2,070(30% 的 $3,600 保持原价,40% 按一半,30% 按四分之一)。这样大约省了 43%,而最难的那 30% 流量仍然留在旗舰上。真实账单会有出入,因为缓存、批量折扣和重试都会改变计算结果,所以请把它当作估算工具。
如果你不确定某个具体任务该从哪里起步,下面的决策树会问你三个简单的问题。
按席位付费的套餐,问题就不一样了
上面所有内容都假设你按 token 付费。如果你的团队是按席位为聊天应用或编程工具付费,档位是由厂商替你决定的,你能动的杠杆也不同。Anthropic 在发布 Opus 5.5 的同时,提高了 Pro、Max、Team 和按席位计费的 Enterprise 套餐的五小时用量上限(Anthropic)。实际操作中,按席位用的人应该在日常工作中选模型选择器里的中端选项,把旗舰留给难啃的任务,并查清楚自己套餐的用量上限对每个模型是怎么计算的。
如果你分不清自己的工具用的是哪种计费方式,我们的AI 工具定价模式指南会逐一讲解积分、席位和 token。如果你想要一个接入就能不改代码切换档位和厂商的方案,OpenRouter 这样的网关值得一看,因为整个路由思路都依赖于低成本切换。
让账单居高不下的错误
- 凭品牌忠诚度选档位,新模型发布后也从不重新测试。
- 只拿一个难例来评判某个档位,而不是用真实流量的样本。
- 明明用带检索的便宜模型就够了,却把长上下文发给旗舰。
- 不用缓存。Anthropic 给 Opus 5.5 缓存读取的定价是每百万 token $0.20,对反复重发同一份上下文的 agent 循环来说,这很重要。
- 把厂商的基准测试当作你自己结果的预测。
提示词在这里同样重要。写得好的 prompt 能让便宜的档位搞定一些原本被糟糕 prompt 逼着往上升的任务,我们那篇经得起模型更新的 prompt 模式讲了如何让这部分工作保持可移植。想更全面地了解有哪些模型,可以看我们的顶级 AI 模型和 LLM对比,以及实时更新的 Top 20 LLMs 榜单。如果你主要想要的是聊天助手而不是 API,AI 聊天机器人榜单和我们的顶级 AI 聊天机器人指南覆盖了这一块;面向开发者的则有 AI 编程助手榜单和编程助手盘点。如果你在考虑自己运行模型,本地 AI 与云端 AI讲了什么情况下这样做划算。
常见问题
如果只能选一个,我该用哪个 AI 模型?
选你现有技术栈所用厂商的中端模型。Sonnet 5.5 或 GPT-6.1 Sol 这一级的模型能以适中的成本处理最广泛的工作,之后数据证明有必要时,再加一个更便宜或更强的档位。
旗舰有值得付费的时候吗?
有,就是那些出错代价高昂、或者中端在真实样例上通不过你的检查的少数调用。它是精密工具,不是默认选项。
中端模型能胜过旗舰吗?
Anthropic 的基准测试显示,Sonnet 5.5 在 agentic 编程上领先 Opus 5.5。但这是厂商在一类任务上的结果,所以在迁移关键工作流之前,先用你自己的工作来测一测。
我该等 Haiku 5.5 或 Gemini 4 Argon 吗?
别为这两个卡住进度。Anthropic 已表示 Haiku 5.5 将在未来几周内发布,而 Google 目前只把 Argon 限定给受信任的网络防御人员,尚未全面开放。把路由层搭好,让新增一个档位只是改一下配置,等它们上线后再重跑你的测试。
我怎么知道更便宜的档位够不够用?
拿一批真实输入跑一遍,加上自动检查,再把失败率与上一档对比。如果差距很小而且任务风险低,就降级。如果失败会波及客户,就别降。
这些价格适用于聊天订阅吗?
不适用。这些是 API 的每百万 token 价格。聊天套餐和编程工具按席位或用量上限计费,所以省钱的办法是在日常会话里选更轻量的模型。