

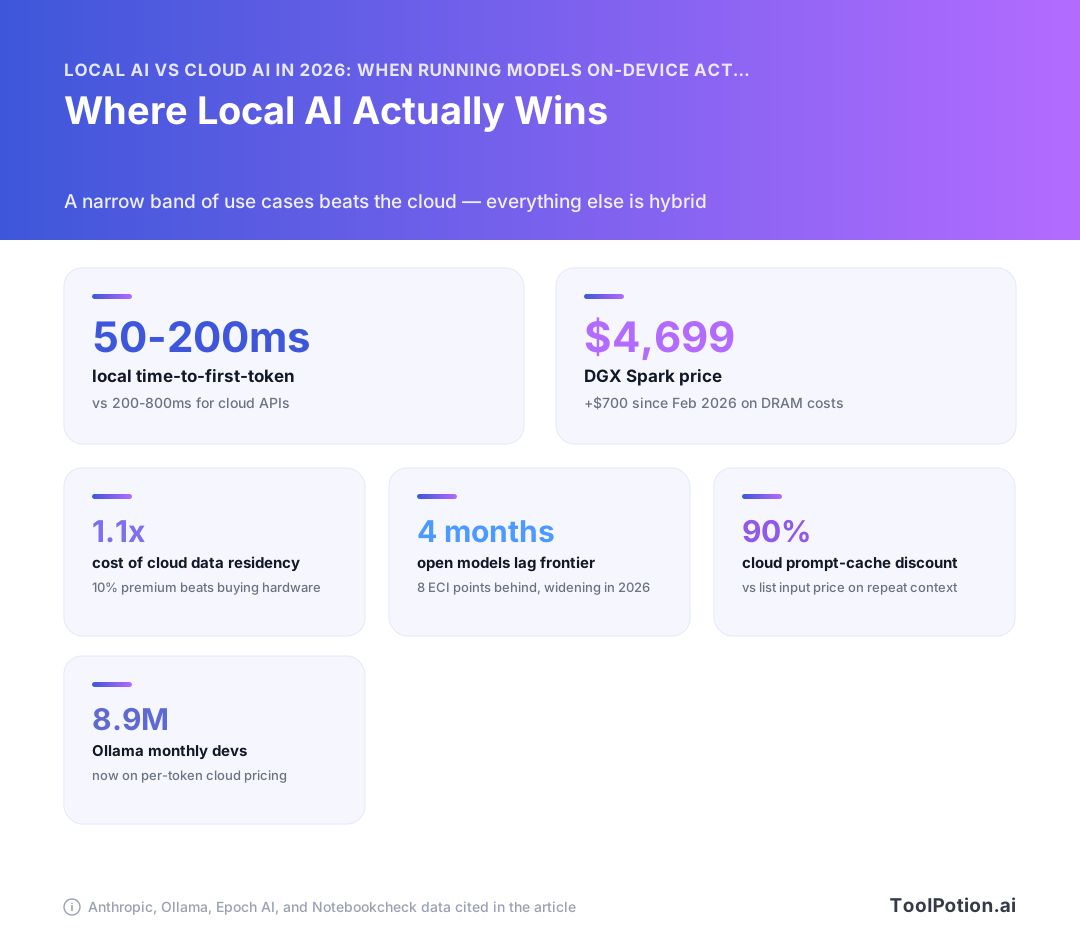
只有在显卡持续处于高负荷时才值得购买。这是2026年本地AI与云端AI之战的简短答案:每天持续使用率超过约26%时,本地设备的成本优于按Token付费;低于这个阈值,你只是在用2026年的内存价格为闲置的硅片融资,而这些价格相当难看:NVIDIA在2026年2月将DGX Spark从3999美元提价至4699美元,将原因归咎于DRAM和存储成本上涨(Notebookcheck)。
与此同时,云端侧的降价方式大多数对比分析都忽略了。提示词缓存读取费用仅为输入价格的0.1倍,且50%的批量折扣可叠加使用,使Claude Haiku 4.5降至每百万Token输入0.50美元、输出2.50美元(Anthropic)。
下面来看具体的成本计算、24GB显存能跑什么,以及边界线对你意味着什么。
本地AI与云端AI:2026年的行业规律在四处出现了裂缝
你读过的收支平衡计算是错的,而且错得不止是四舍五入的问题。之所以出错,是因为硬件变贵了、能力数据被误读了、工具链换了阵营,而云端价格表也悄悄降到了所有人电子表格的下方。
几乎所有对比文章都在沿用的三个假设
几乎每一篇搜索结果首页的本地vs云端指南都建立在相同的三个论点上,而且全都是2024年的数据。其一:硬件是固定的且不断下降的成本,因此将1999美元的GPU摊销18个月后与按Token消费对比。其二:开源权重模型落后于闭源前沿模型三到六个月,所以你在家里跑的模型相差大约几个季度。其三:"本地"意味着你机器上的Ollama,"云端"意味着前沿API,是一场泾渭分明的双方较量。
这三点在2024年都是合理的,但没有一条能经得住2026年现实的检验。
2024年到现在发生了什么变化
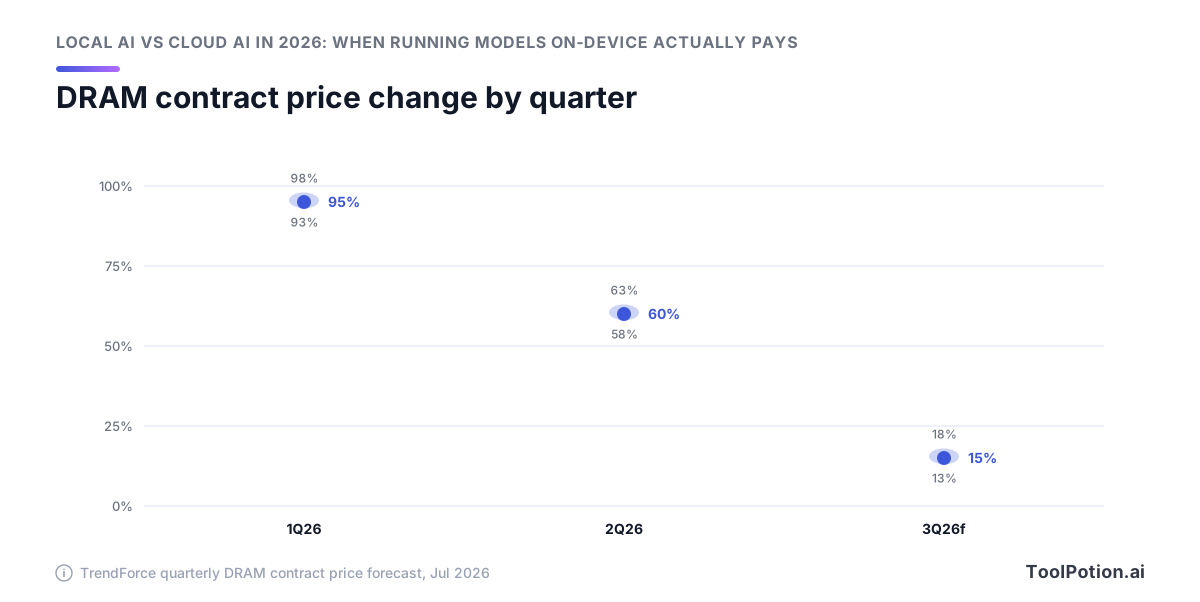
先看硬件成本底线,因为它朝着错误的方向移动了。NVIDIA在2026年2月将DGX Spark从3999美元提价至4699美元,700美元的涨幅被归咎于DRAM和存储成本的急剧上涨。传统DRAM合同价格在2026年第一季度环比上涨约93-98%,目前仍在2026年第三季度继续上涨13-18%。任何以官方建议零售价为基础的计算器都低估了你的资本支出,差距达到四位数。
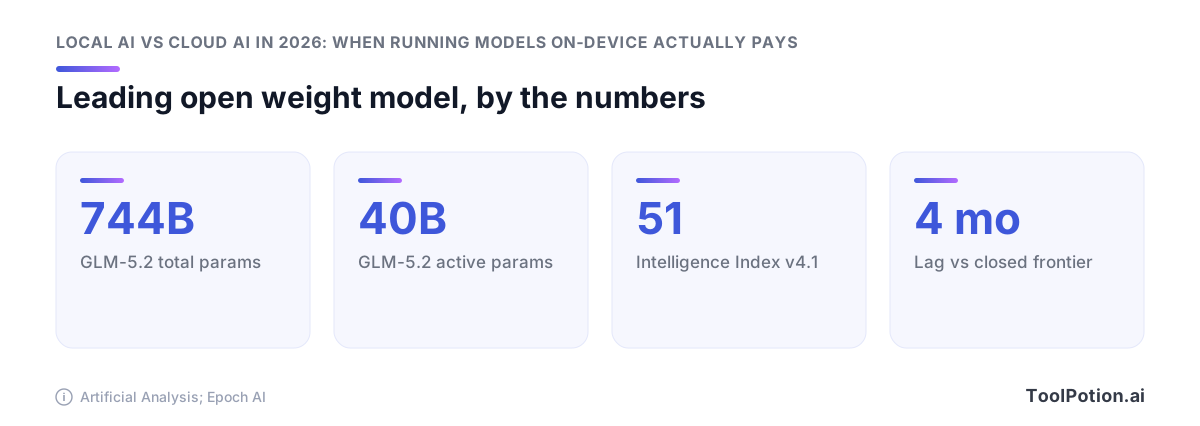
再看能力差距。Epoch AI将差距定为自2026年1月起约4个月,即8个ECI分,比其在2023年1月至2025年10月测得的3个月平均水平还要大。没人引用的那部分是:承载这一说法的模型GLM-5.2,总参数744B,激活参数40B。那是机架式服务器,不是笔记本电脑。
第三个裂缝最为奇特。2026年8月31日,Ollama将Pro、Max和Team计划迁移至按Token计费的云端定价,分别为每月20美元、100美元和500美元。这个默认的"本地运行"工具现在开始向你售卖Token,从而将这场比较变成了你的GPU、廉价的托管开源权重,以及前沿API之间的三方竞争。如果你正在评估我们追踪的AI模型中的选项,中间那条路才是最值得先定价的。
云端侧的降价方式没有任何已发布的计算器覆盖到:提示词缓存读取按基础输入价格的0.1倍计费,Batch API享有50%折扣且可叠加,以及仅限美国的推理固定,附加1.1倍费率。最后这个选项让你以10%的溢价买到了人们花4699美元买硬件才能实现的数据驻留属性。
2026年本地模型真正能胜任的任务
2026年,一块24GB显卡可以运行不错的20-30B混合专家模型,该模型在起草、摘要、分类和结构化问题推理方面达到大多数团队认为可接受的质量水平。它也会对训练数据之外的任何内容自信地捏造事实。这两句话就是能力全图,而大多数收支平衡指南都跳过了第二句。
消费级硬件的天花板是20-30B MoE模型类别
gpt-oss-20b和Qwen3-30B-A3B是单张消费级GPU的实际天花板。两者都是稀疏MoE架构,因此激活参数数量足够小,24GB显卡能容纳权重并留有上下文空间。低于这个档次的是7-14B的稠密Llama、Mistral和Phi系列模型,运行更流畅但以能力为代价。我们的开源权重LLM列表在这个范围内高度集中,因为这是人们在家能跑的。
推理能力强,世界知识弱
给本地30B模型一份文档,让它提取字段、遵循模式或按步骤推进,它表现良好。问它2024年谁收购了谁,你会得到合理的虚构内容。
参数量决定了记忆事实的能力,消费级模型已经丢弃了大部分这类参数。检索能弥合这一差距:把事实放进上下文,让本地模型处理结构化部分。任何需要广泛事实回忆且没有检索层支撑的任务,都应该交给前沿API。
为什么"开源模型正在追赶"的标题说的是你不拥有的硬件
Epoch AI将差距定为自2026年1月起约4个月,即8个ECI分,略大于其测量的2023年1月至2025年10月间3个月的平均值(Epoch AI)。这个数字本身无误,但它与你的笔记本电脑毫无关系。开源权重桂冠的持有者GLM-5.2在Artificial Analysis智能指数v4.1上以744B总参数、40B激活参数得分51(Artificial Analysis)。那是数据中心级硬件。同一测量显示GLM-5.2每个任务消耗43,000个输出Token,其中37,000个是推理Token,每任务成本约0.46美元,而MiniMax-M3为0.18美元。
量化会损失什么
Q4_K_M是默认选择,原因充分。在Apple M1 Pro上用llama.cpp对Mistral-7B-Instruct-v0.2进行测试,它将模型从7.2GB压缩到4.1GB,体积缩小43.1%,困惑度损失仅0.51%(dasroot)。Q2_K是曲线断裂的地方,困惑度损失7.94%,在你从基准测试看出问题之前,你就已经在指令遵循上感受到了。量化到4位就停手,把节省的显存用于增加上下文长度。
硬件成本底线移动了,而且朝着错误的方向
你能找到的每一个收支平衡计算器都假设你能以标价买到设备。2026年你大多数情况下做不到,而且标价本身也涨了。
内存危机,以可查证的价格呈现
传统DRAM合同价格在2026年第一季度环比上涨约93-98%,第二季度再涨58-63%,TrendForce预测第三季度进一步上涨13-18%(TrendForce)。这是减速,不是下降。价格仍在一个已经翻倍的基数上继续攀升。需求并非来自你:2026年数据中心吸收了全球高达70%的内存产出,而2022年这一比例约为20-30%;仅HBM就占今年DRAM晶圆的23%,而2024年这一数字为8%(IDC)。本地推理本质上是在与建设你想避开的云端的人们竞争内存容量的采购权。
DGX Spark、RTX 5090,以及建议零售价与实际市场价之间的差距
NVIDIA在2026年2月将DGX Spark从3999美元提价至4699美元,公司将700美元的涨价归因于DRAM和存储成本的急剧上涨(Notebookcheck)。其128GB LPDDR5X内存是它对本地模型有吸引力的全部原因,也是其价格随一个你无法控制的大宗商品市场波动的原因。
把你在对比文章中看到的任何2025年建议零售价都当作虚构数字对待。查清楚该硬件本周的实际售价,然后用那个数字来计算。
电费是大家都忽略的那一项支出
GPU是一次性购买,但每个月都在向你开账单。2026年6月美国住宅用电均价为18.34美分/千瓦时,同比上涨5.0%,各州差异从新墨西哥州的8.96美分到加利福尼亚州的28.50美分不等(EIA)。同一套设备的运营成本因插电地点不同而相差逾3倍。如果你在加州,单是电费就可能媲美同等托管Token的成本。在新墨西哥州,结论又是另一回事。
2026年一套站得住脚的本地设备要花多少钱
按当前市价预算硬件,加上你实际电费单价下的能耗成本,再加上你花在本地推理框架和量化调优上的时间——而托管端点不要求你做这些。诚实的起点是四位数的资本支出加上三位数的年度运营支出尾巴,而且今年两项都因为与模型质量无关的原因变得更糟了。
Ollama与云端API的成本对比:现在是三方竞争
现在有三个价格需要考量:你购买的GPU、托管开源权重,以及前沿API。对大多数工作负载来说,中间选项胜出,而这几乎是所有已发布的收支平衡公式都不包含的选项。
Ollama自身于2026年8月31日成为了一个云端API
那个教会一代开发者在自己机器上运行模型的工具,现在开始售卖Token了。2026年8月31日,Ollama将Pro、Max和Team迁移至按Token计费的云端定价:每月20美元含60美元用量、每月100美元含300美元用量、每月500美元含1000美元用量(供无限用户共享),数据零留存,托管于美国和欧洲(Ollama)。所以"Ollama vs 云端"这一说法已不再描述真实的选择。
托管开源权重:没人建模的中间选项
| 模型 | 每百万Token输入/输出价格 | 来源 |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
在用这些数字建立预测之前,请阅读细则。大多数Ollama Cloud费率在工作日UTC 12:00至18:00期间翻倍(Ollama),这使你的账单变成了一个调度问题。将批量任务推到夜间和周末,你就能保持标题费率。为欧洲下午用户运行交互式产品,你每个工作日都要支付翻倍的费率。这个时间变量值得比选择两家价格相近的托管服务商更多的关注。
前沿API比标价更便宜
缓存读取按基础输入价格的0.1倍计费,Batch API对输入和输出各打五折,两项折扣可叠加(Anthropic)。批量Haiku 4.5的价格降至每百万Token输入0.50美元、输出2.50美元,而Sonnet 5维持了2美元/10美元的首发价,没有在2026年9月1日调整至预定的3美元/15美元(Anthropic)。异步批量处理恰恰是本地设备被推销的那类工作负载,而这也正是云端折扣力度最大的场景。
反向影响的分词器注脚
Claude 4.7及更新版本使用了新的分词器,对相同文本产生的Token数量多约30%(Anthropic)。在固定语料库上,你的实际Sonnet 5账单比2美元/10美元的标价高出约30%,前提是与使用旧版分词器的本地模型进行比较。在决定之前,用自己的文本在两者上都数一数Token。
计算盈亏平衡点:你的GPU在多大用量下才能胜出?
自有硬件在每日持续GPU使用率约26%时开始优于托管开源权重,大约相当于每天真正工作约六小时、每天如此,按2026年硬件价格和当地电费摊销计算。低于这条线,显卡在闲置中折旧。在购买前,先用托管费率对你自己的用量进行定价:deepseek-v4-flash在Ollama Cloud上的输入价格为0.22美元、输出0.66美元每百万Token(Ollama)。
本地胜出的场景(一份简短、具体的清单)
经得起推敲的场景有四个。其他所有情况都是混合方案:将简单查询路由到本地模型,其余的升级处理。
持续高量批处理工作,让显卡保持忙碌
如果你的GPU每天有90%的时间处于闲置状态,你买的是一台暖气片。买入的逻辑需要显卡每天工作超过四分之一的时间、每天如此,还需要经受与Claude Batch API的比较——后者对输入和输出各打五折,并与提示词缓存叠加(Anthropic)。这使Haiku 4.5批量处理的输入价格降至每百万Token 0.50美元、输出2.50美元。你的本地设备必须在摊销后的硬件成本加电费的情况下胜过这个价格,而2026年6月美国住宅用电均价为18.34美分/千瓦时(EIA)——满负荷运行的显卡也不是免费的。在用规格表计算之前,先用你实际的Token用量来跑一遍数字。
硬性数据主权要求,包括CLOUD Act,不仅仅是GDPR
这是一个真实存在的需求类别,但它比大多数人声称的要窄得多。GDPR合规是合同问题。要求没有美国司法管辖实体能被强制提交你的数据,这是物理问题,而物理问题需要用你掌控的硬件来解决。
交互式循环,首Token时延就是产品体验
本地推理实现50-200毫秒的首Token时延,而云端为200-800毫秒,Claude Haiku 4.5实测为597毫秒,GPT-4.1 Mini约为2400毫秒(Eden AI)。对于聊天窗口,没人会注意到。但对于内联代码补全,或一个串联八次调用的多步骤Agent,这个差距会累积成用户能明显感受到的体验差异。如果你正在构建这类形态的产品,浏览一下我们目录中的AI Agent,看看其中有多少每次按键都要进行一次往返请求。
离线和气隙操作
没什么好论证的。网络要么在,要么不在。
云端正在反向销售的隐私论点
对第二个场景最有力的反驳是Anthropic可以直接向你出售这种保障。在Claude 4.6及更新版本上,通过inference_geo: "us"将推理固定在仅限美国,所有Token类别附加1.1倍费率(Anthropic)。这是10%的溢价,而不是4699美元的DGX Spark。与此同时,Ollama的付费计划自2026年8月31日起宣传在美国和欧洲提供零数据留存托管(Ollama)。如果你的隐私要求通过合同保障和地理固定就能得到满足,你就没有硬件需求。
大多数从业者最终采用的混合方案
按难度路由,而不是按原则路由。自有显卡上的20-30B MoE模型可以处理典型助手或文档处理工作负载中约十分之七的查询,剩余三成交给前沿API。这个分流就是架构,其他一切都是调优。
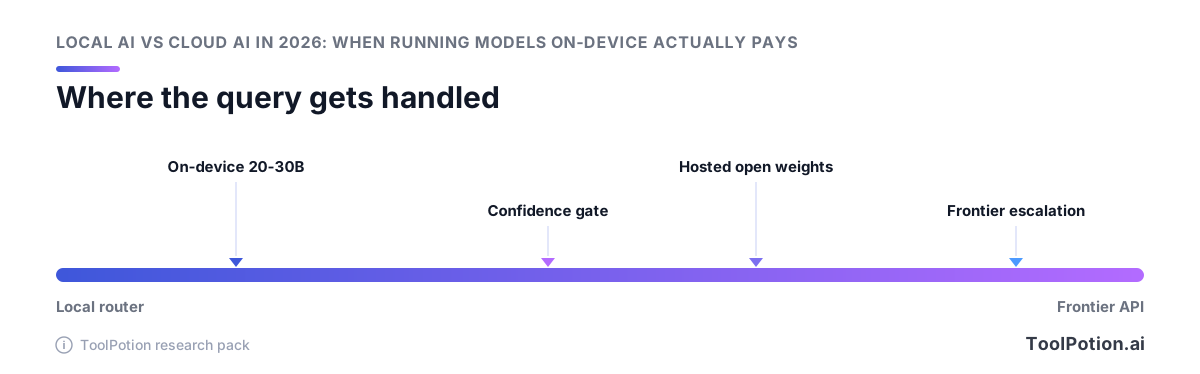
三个信号决定是否升级处理,而且你可以在本地模型完成之前计算出所有信号:模型自身的置信度(对数概率差值或简单的自检)、查询是否需要本地权重所没有的世界知识,以及上下文长度。知识那一条能捕捉到你的大多数失败案例。24GB级别的模型推理良好但记忆糟糕,因此任何读起来像"2025年谁收购了谁"的问题都应该直接跳过本地处理。
一个实际可用的技术栈
前端用Ollama或LM Studio,后端接一个前沿API,中间用一个记录所有决策的轻量路由器。
将升级的流量首先发送给Claude Haiku 4.5(输入1美元/百万Token,输出5美元/百万Token),只有在Haiku的回答未通过检验时才调用Sonnet 5(2美元/10美元)(Anthropic定价)。如果升级的工作是异步的,就批量处理:Batch API两侧各打五折,Haiku降至0.50美元/2.50美元。大多数团队跳过这一步,按标价支付原本可以等二十分钟再处理的工作。
监控升级率,否则你是在盲飞
每次请求记录四个数字:哪个层级处理了它、本地模型的置信度、Token数量,以及是否有人工重试了答案。重试率是你真正的质量信号。如果升级率低于约20%,你的本地模型在回答它不该回答的问题,你会从重试中看到这一点。高于45%时,GPU就赚不回它的折旧成本。
为什么这条边界每个季度都在移动
两侧的价格变化速度都快过你的架构迭代速度。Ollama在2026年8月31日将Pro、Max和Team重定价为按Token计费的云端收费(Ollama),Ollama Cloud费率在工作日UTC 12:00至18:00期间翻倍(Ollama定价),开源权重能力自2026年1月以来平均落后闭源前沿模型约4个月(Epoch AI)。每季度用最新数据重新核算你的路由阈值,把它写进日历。
工具层已足够稳定,可以作为构建基础
Ollama每月活跃开发者达890万,由14人团队运营,渗透了85%的财富500强企业,并于2026年7月由Theory Ventures领投融资6500万美元(TechCrunch)。这不是一个明年就会消失的项目。围绕它的路由胶水是你自己维护的部分,而你可以从已经发布这种模式的开源AI代码库中借用大部分实现。
五个问题做决定
按顺序回答这些问题。第一个给出明确"是"的问题决定了你的方案,到那里就可以停了。
你有硬性主权要求吗?
硬性是指气隙隔离、法务部门已书面确认的CLOUD Act风险敞口,或合同中明确指定机器的条款。如果是这种情况,购买硬件,不用再看成本部分。如果你的要求没那么严格,Anthropic可以在Claude 4.6及更新版本上通过inference_geo: "us"将推理固定在仅限美国,对所有Token类别附加1.1倍费率(Anthropic定价文档),而Ollama的付费计划在美国和欧洲提供零数据留存运行(Ollama)。对几乎所有人来说,10%的溢价都优于4699美元的硬件投入。
你的工作受延迟约束还是受吞吐量约束?
用户需要等待每个Token的交互式循环倾向于本地:首Token时延50-200毫秒,而云端为200-800毫秒,Claude Haiku 4.5实测为597毫秒(Eden AI)。吞吐量工作则反过来。批量处理并享受50%折扣,Haiku 4.5可降至每百万Token输入0.50美元、输出2.50美元(Anthropic)。
GPU每天会保持超过四分之一时间的忙碌吗?
低于这条线,你的显卡在闲置中折旧,托管开源权重在成本上更占优势。高于它,本地的经济账才开始成立。对分母要诚实,因为夜间和周末也计入其中。
你的任务需要世界知识还是仅需推理能力?
对你提供的文本进行推理,在20-30B MoE模型上运行良好。依赖模型已有知识的问题属于前沿API,或者托管的GLM-5.2——后者总参数744B,永远装不进你的笔记本电脑(Artificial Analysis)。
你能接受每季度重新调优吗?
开源与闭源的差距维持在4个月,从3个月的平均值移动而来(Epoch AI),因此你的路由阈值有保质期。不愿重新审视的团队应该默认开启缓存的前沿API,不路由任何东西。愿意的团队可以查看真实部署案例研究,了解其他人的阈值最终定在哪里。
哪些变化会在2027年改变这个判断
这条建议有失效日期,有三个具体的数字决定了它的有效期。
内存价格在减速,但并非在下降
传统DRAM合同价格在2026年第一季度环比上涨约93-98%,第二季度再涨58-63%,第三季度预测上涨13-18%。这条曲线正在趋平,但仍然向上。增速放缓并不能还给你NVIDIA在2026年2月给DGX Spark加的700美元,而预测中也没有任何内容表明明年市场价会下降。除非数据中心需求缓解,否则预计硬件端的劣势将持续到2027年。
关注开源/闭源差距,而不是标题基准分数
两个信号比任何排行榜位置都更重要。第一个是Epoch AI的ECI差距,自2026年1月起为4个月,即8分。第二个是激活参数量:GLM-5.2以744B总参数中40B激活领跑开源权重,因此一旦某个激活参数低于30B的模型在ECI分数上接近前沿水平,24GB显卡就会再次变得有吸引力。同时关注Ollama的峰时翻倍(UTC工作日12:00-18:00)是否延续还是趋于正常。我们的AI趋势报告追踪可能影响上述任何指标的模型发布动态。
常见问题
2026年,在本地运行LLM比使用云端API更便宜吗?
对大多数人来说,云端更便宜,而且2026年这个差距扩大了。Claude Haiku 4.5标价每百万Token输入1美元、输出5美元,通过Batch API降至0.50美元/2.50美元,提示词缓存命中按基础输入价格的0.1倍计费(Anthropic定价)。另一方面,NVIDIA DGX Spark因DRAM和存储成本在2026年2月从3999美元涨至4699美元(Notebookcheck),而2026年6月美国住宅用电均价为18.34美分/千瓦时(EIA),你还要持续承担电费。本地部署在每天大部分时间都保持高量批处理负载的情况下、气隙操作以及延迟敏感的循环场景中才能盈亏平衡。
2026年在本地运行LLM需要什么硬件?
24GB GPU是消费级实用门槛,这将你限制在20-30B混合专家模型类别,而非任何接近开源权重前沿的水平。超出这个范围,你就在购买像DGX Spark这样的128GB LPDDR5X设备,目前售价4699美元(Notebookcheck)。请为持续攀升的内存价格做好预算:传统DRAM合同价格在2026年第一季度环比上涨约93-98%,第二季度再涨58-63%,第三季度预测再涨13-18%(TrendForce)。量化可以拉伸可容纳的模型大小,而4位量化几乎是免费午餐:Q4_K_M将Mistral-7B-Instruct-v0.2从7.2GB压缩到4.1GB,困惑度损失仅0.51%,而Q2_K在7.94%的损失处严重劣化(量化权衡)。
本地模型与Claude或GPT相比水平如何?
被广泛引用的差距是真实存在的,但它描述的是你可能并不拥有的硬件。Epoch AI测量显示,自2026年1月起,开源权重模型平均落后闭源前沿模型4个月(即8个ECI分),略大于2023年1月至2025年10月间3个月的平均值(Epoch AI)。承载这一说法的模型GLM-5.2在Artificial Analysis智能指数v4.1上以744B总参数、40B激活参数得分51,这是数据中心级硬件(Artificial Analysis)。实际上能装进笔记本电脑或单张GPU的模型,在结构化推理上表现强劲,但在世界知识上较弱,因此请将4个月这个数字视为你在家里无法企及的上限。
Ollama还免费吗?Ollama Cloud定价与前沿API相比如何?
本地与Ollama的对比框架在2026年8月31日就失去意义了,当时Ollama将其Pro、Max和Team计划迁移至按Token计费的云端定价:每月20美元含60美元用量、每月100美元含300美元用量、每月500美元含1000美元用量(供无限用户共享),在美国和欧洲提供零数据留存托管(Ollama博客)。托管的开源权重在那里价格便宜:deepseek-v4-flash每百万Token输入0.22美元、输出0.66美元,nemotron-3-super为0.015美元/0.60美元,qwen3.5:397b为0.60美元/3.60美元,但大多数费率在工作日UTC 12:00至18:00的峰时翻倍(Ollama定价)。与Claude Haiku 4.5的1美元/5美元相比(Anthropic定价),真正的决策是三方博弈,而托管开源权重在成本上对大多数工作负载胜过你自己的GPU。Ollama在这场博弈中有足够的分量,拥有890万月活跃开发者和85%的财富500强渗透率(TechCrunch)。
在本地运行模型真的比云端API让我的数据更隐私吗?
它给你提供了一个其他任何方式都做不到的属性:字节永远不会离开你的机器,这对气隙工作和像CLOUD Act这样的硬性数据主权要求很重要。对于比这更软性的需求,提供商现在可以廉价地出售相同的保障。在Claude 4.6及更新版本上,通过inference_geo: "us"将推理固定在仅限美国,对所有Token类别附加1.1倍费率(Anthropic定价),而Ollama的付费计划在美国和欧洲提供零数据留存运行(Ollama博客)。10%的溢价比4699美元的硬件承诺小得多(Notebookcheck)。
24GB GPU上应该从哪个本地模型入手?
从20-30B混合专家模型入手,如Qwen3-30B-A3B或gpt-oss-20b,量化至Q4_K_M。该类别在单张RTX 5090上的AIME 2024得分为73-87%,推理能力表现良好,而对世界事实的回忆是其短板。Q4_K_M是正确的量化终点:它将一个7.2GB的模型压缩到4.1GB,困惑度损失仅0.51%,而Q2_K在7.94%的损失处急剧劣化(量化权衡)。将其作为第一跳运行,并将知识密集型查询升级到云端模型处理。