

搜索正在从一列链接变成一个答案,而横在你和受众之间的平台,也在改写谁拿到报酬、谁获得访问的规则。真正经得起时间的应对办法既朴素又有效:拥有一个读者无需经过任何算法就能找到你的渠道,有意识地决定哪些 AI 爬虫可以使用你的作品,并发布答案引擎能干净引用的页面。
这件事现在就要做,因为 2026 年的相关消息几乎在几天之内接连而至。Google 正在为部分出版者的 AI 贡献付费,Reddit 正在关闭开放的订阅源,Instagram、YouTube 和 Spotify 则把 AI 控制权交给创作者和听众,决定什么内容会被看到。这份指南把这些新闻变成一个你本周就能执行的计划,不管你做的是 newsletter、频道、店铺博客还是播客。
这是一份实操手册,不是预测。数字出自某份报告时,我们会说明是谁的报告。Google、OpenAI 或 Perplexity 有文档说明某项控制功能时,我们会附上文档链接。至于 SEO 工具层面,我们的 best AI SEO tools 合集介绍了相关软件,本文讲的则是这些工具所服务的策略。
h2 搜索曾经止步于你的网站
在传统搜索里,人们输入查询,浏览十条链接,点开其中一条。点击本身就是产品。你的分析数据、广告位、邮件订阅框,全都在点击之后的那一边。
AI 答案改变了这条路径的中段。读者拿到的是一份综合性回答,附带几个引用来源,点击变成了可选项。仍有一些读者会点进去,而且 Google 表示,在 AI Overviews 和 AI Mode 中作为支持链接展示的页面,会计入你 Search Console 里常规的 Web 流量。但会点击的读者往往已经了解了大意,所以访问量更少,意图却更强。
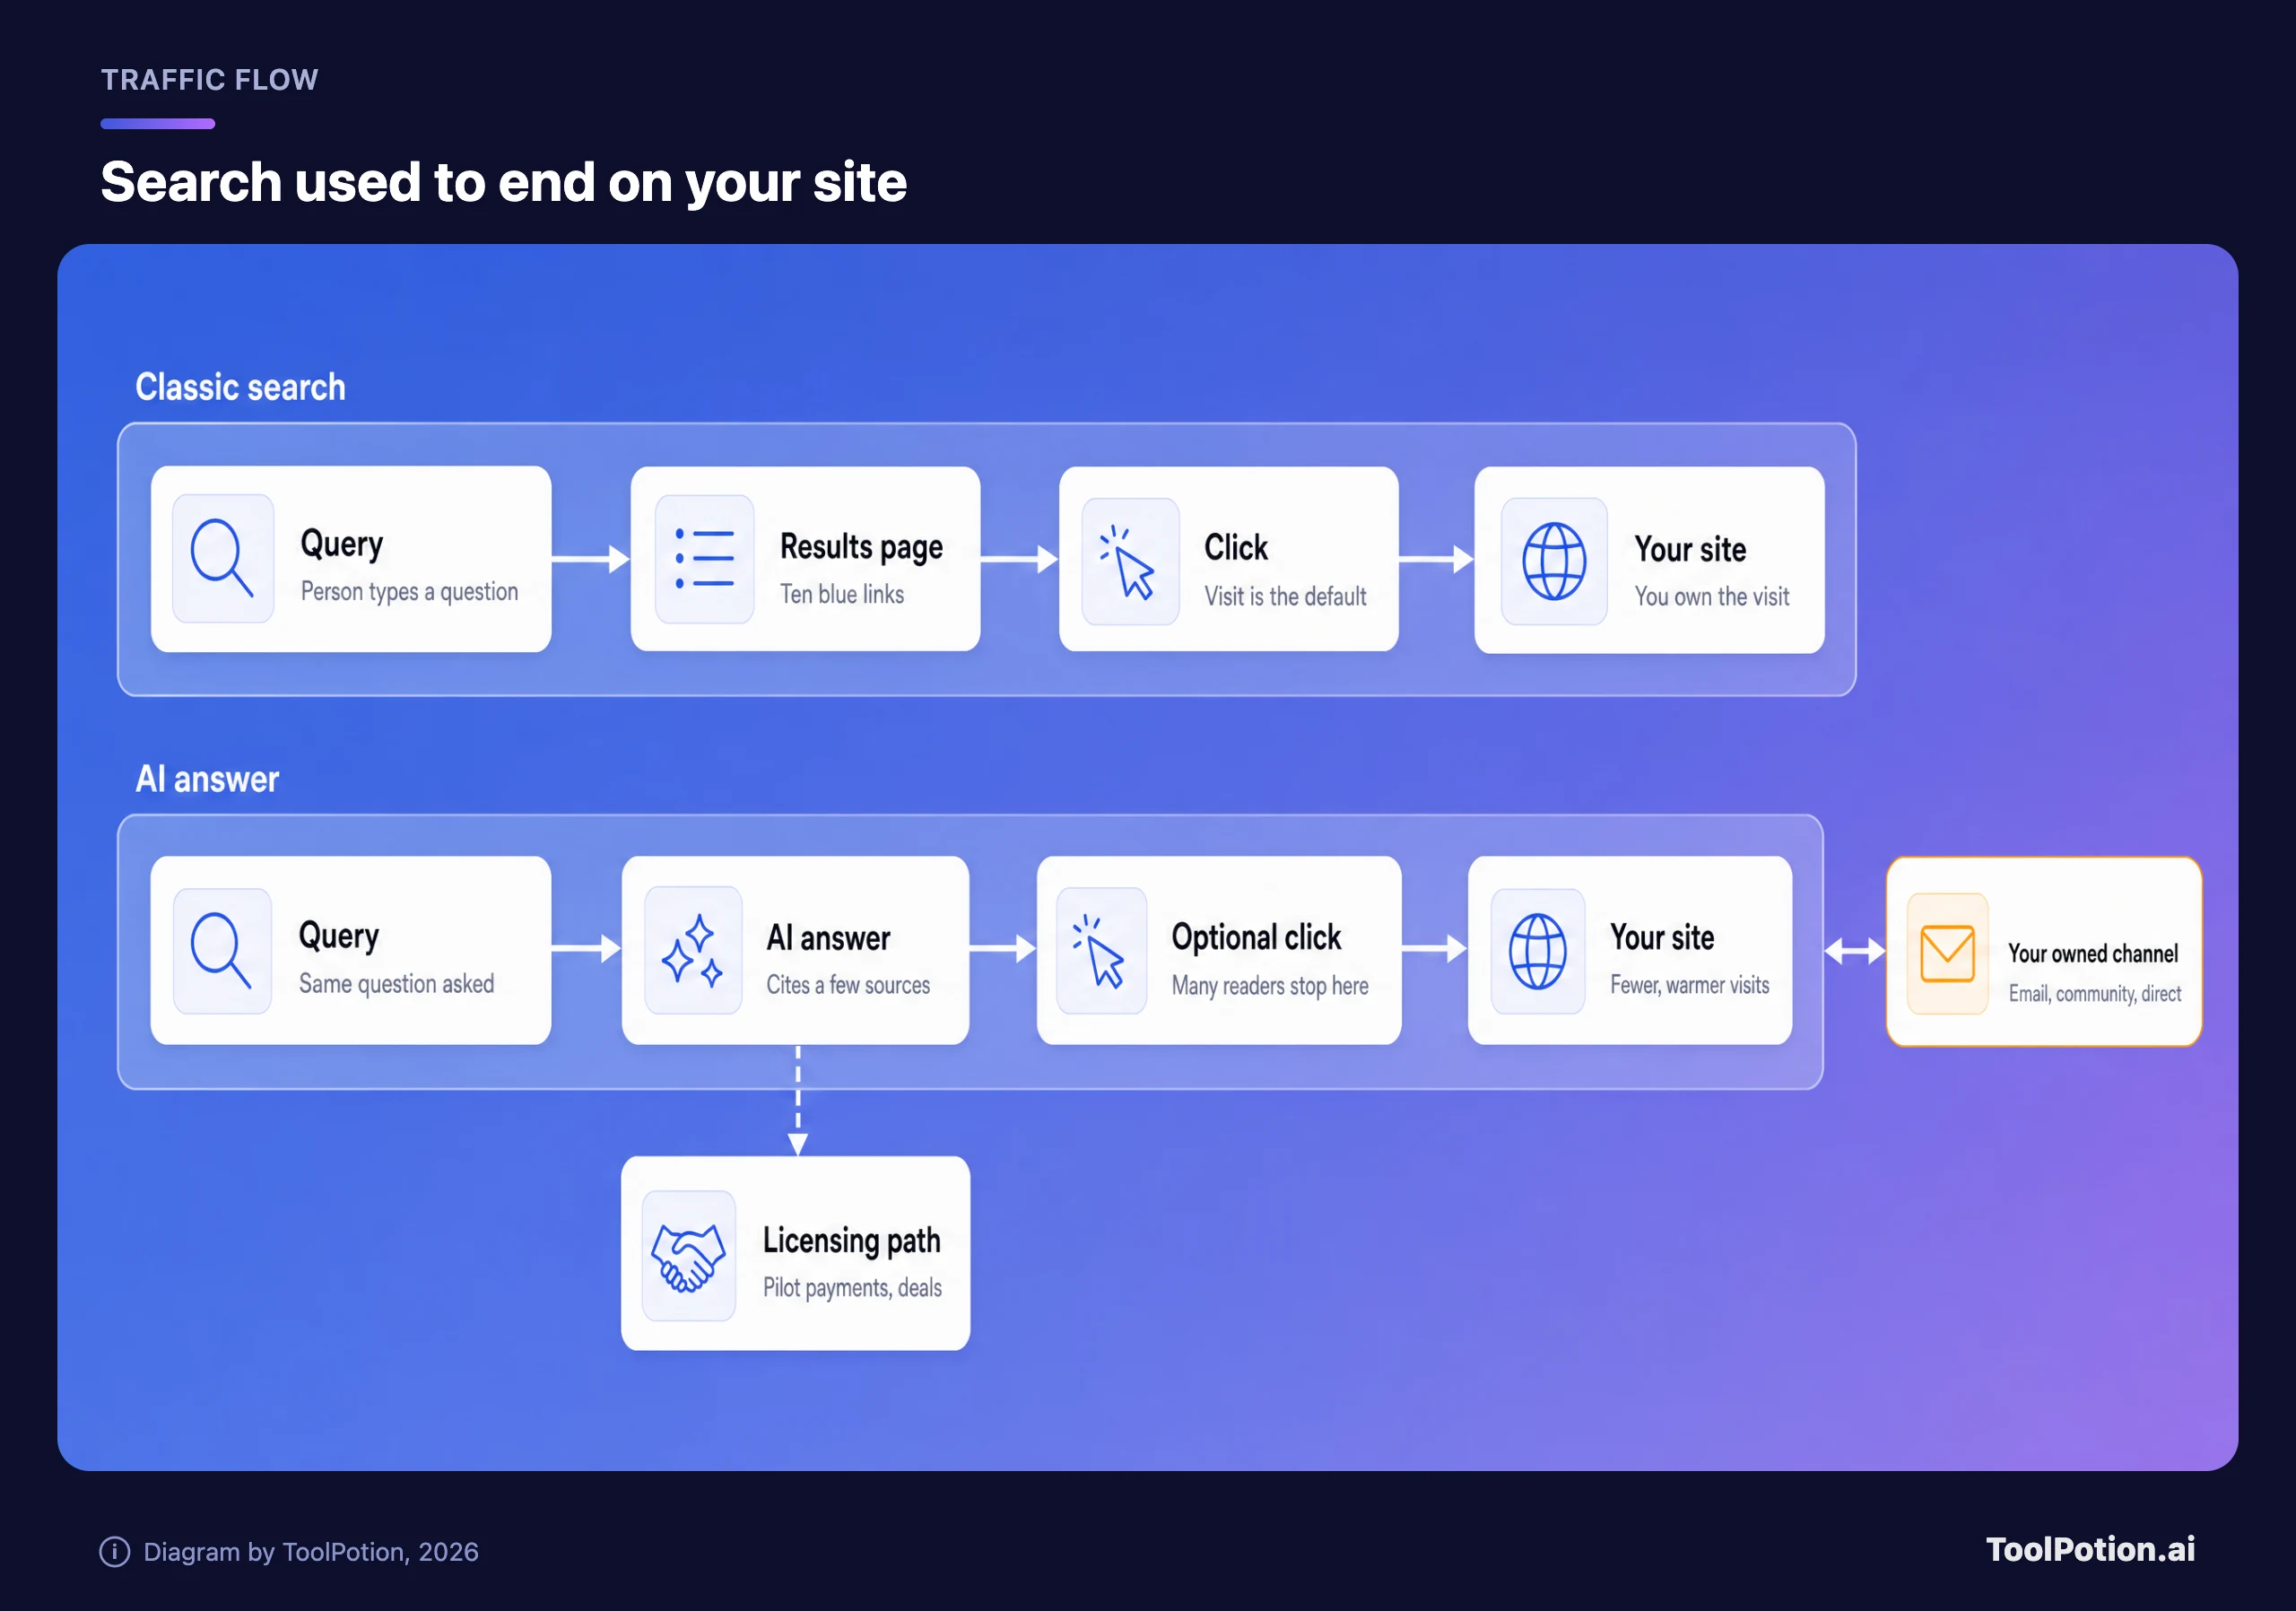
图中还画出了今年新出现的旁路:授权许可。如果你的内容为答案提供了素材,就可能有人为此付费。至于对方付得够不够多,是下一个问题。
各平台在付什么钱,又在关什么门
Google 的试点项目是最清晰的数据点。据 The Information 报道,并经 The Verge 转述,约有 100 家出版者加入了一个计划,按其内容对 AI Overviews、AI Mode 和 Gemini 聊天机器人的贡献程度付费。据称,一家最早加入的出版者一年收入超过 100 万美元;一家几个月前加入的,则赚到了大约 5 万到 6 万美元,同样出自该报道。就我们所能查到的,Google 本身并没有公布这些数字。
这些是令人鼓舞的数字,但它们只依赖一份报道。早期加入者和后来者拿到的支票差别很大,试点之外的人也无法估算你自己能拿多少。
The Verge 还提到,英国裁定 Google 必须允许出版者选择不出现在 AI 搜索功能中,欧盟也已就其对网站流量的影响展开调查。如果这些措施落地,选择退出就会从纸面上的选项变成真正的筹码。
Reddit 展示的是另一种姿态。TechCrunch 报道称,它将在今年晚些时候终止 RSS 订阅源,并在 2027 年初终止公共 API 访问,理由是大规模抓取和自动化滥用。同一篇报道还说,Reddit 包含 AI 授权在内的“其他收入”同比增长 24%,达到 4300 万美元,而依靠 Reddit 内容回答问题的 AI 助手,在这扇开放的门关上之后将需要商业协议。不管动机是什么,对所有基于 Reddit 订阅源搭建产品的人来说,结果都一样:开放网络在收缩,访问权正在变成付费产品。
这对小型出版者来说不太好受。你今天多半没法跟 Google 或 OpenAI 谈判。但你可以决定自己的网站允许什么,也可以不再依赖一条别人即将计量收费的管道。
AI 助手引导你去迎合各个平台自己的目标
在访问权收紧的同时,各平台正在给创作者提供 AI 帮助。Instagram 的 Edits 应用现在有了一个创意助手,可以调取你的账号数据,The Verge 列出的包括点赞、观看、留存和分享。你可以问它为什么这条视频火了、那条没火,或者该用什么开头钩子。YouTube 刚更新了自己的 AI 创作者面板,同一篇文章称它会告诉创作者如何最大化互动。
这很有用,但同时也是一个闭环。两个助手优化的都是该平台上的互动。The Verge 提出了一个显而易见的担忧:当所有人都朝着同样的指标优化,内容会趋同,照着建议做的优势也会随之缩小。
受众这一侧也在变。YouTube 将允许观众借助 Gemini,通过文字提示词打造自己的定制推荐流,固定在首页的一个标签页上,与常规推荐并列。Spotify 的 Taste Profile 让 18 岁及以上的美国 Premium 听众用自然语言编辑自己的推荐,首页会在几小时内随之变化。ChatGPT 现在还会在对话过程中推荐第三方应用,首批有 16 个合作伙伴,包括 Notion 和 Vercel,另有一个拥有 30 多家合作伙伴的企业级市场。
综合来看,内容发现正在分化。你的受众会越来越多地直接告诉助手自己想要什么,再由助手决定呈现哪些内容。下面是这些功能的对比。
最后一列体现的规律才是重点:几乎所有控制权都在平台或观众手里,几乎没有一项在你手里。这就是为什么下面的策略要从你手里已有的东西讲起。
把渠道分成自有、租用和授权三类
如果你明天不用征得任何人的许可就能触达某个人,那这个渠道就是自有的。邮件列表算,有直接访客的网站算,你在自己掌控的基础设施上运营的社区也算。如果由平台决定谁能看到你的帖子,那就是租用渠道:社交信息流、视频平台和电商市场都属于此类。授权是最新的一层:AI 公司或搜索引擎付费,换取复用你作品的权利。
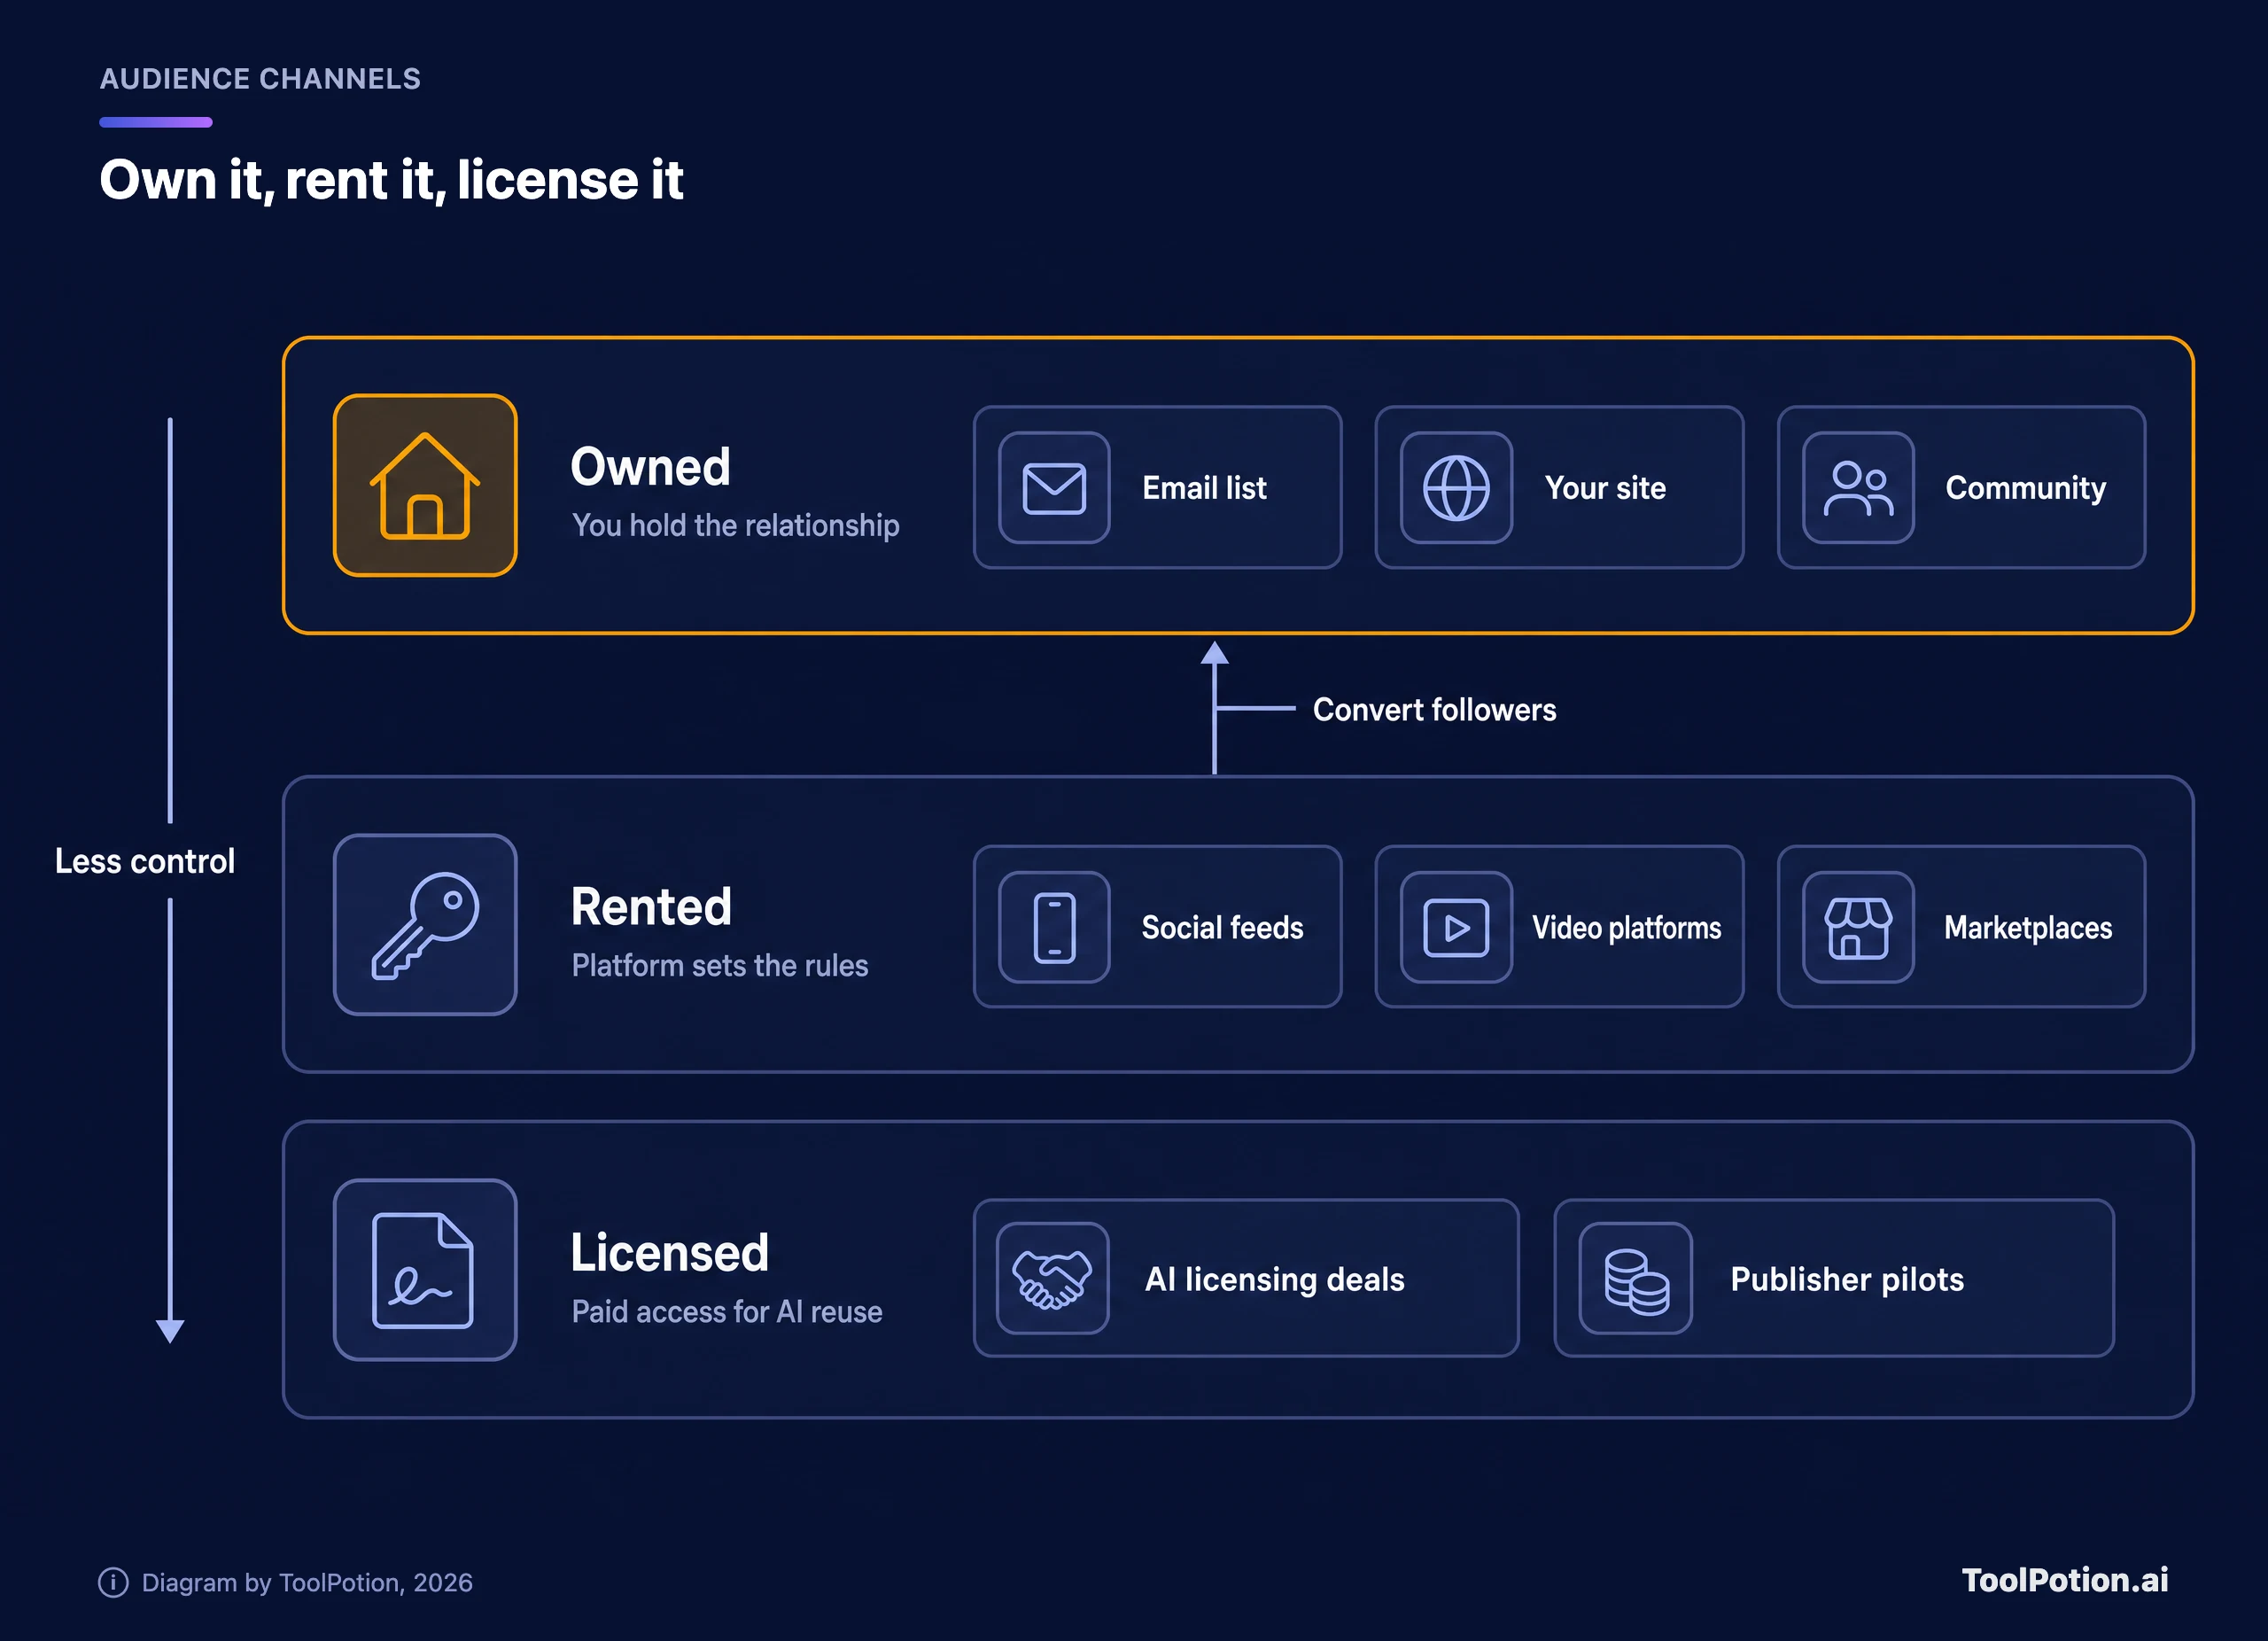
租用渠道依然值得用。发现新受众恰恰发生在那里。错误在于把粉丝数当成资产,而平台一夜之间就能重新排序。每一条发在租用渠道上的内容都该有它的任务,而这个任务通常是把人引到你的自有渠道。
做邮件的话,beehiiv 或 Mailchimp 这样的平台是常见的起点,你也可以在我们的目录里看看 Superhuman AI 和 Axios AI+ 这类成熟的 AI newsletter 是如何留住受众的。至于社区,像 Midjourney 的 Discord 服务器,就展示了创作者自建空间能长成什么样子。
用你自己的分析数据拆分,试试下面的计算器。它是个经验估算,不是预测:它把搜索和社交的占比相加,得出你有多少流量落在租用渠道上,再套用一个由你自己设定的搜索点击下降假设。
如果租用流量超过大约 70%,某个平台的一次政策变动就可能重创你。在 40% 到 70% 之间,你有风险但不算脆弱。低于 40%,说明你已经有了基本盘。这几个区间是我们的经验法则,请按你的风险承受能力调整。
有意识地制定爬虫访问策略
大多数网站没有针对 AI 爬虫的书面决定。要么因为觉得稳妥而全部屏蔽,要么因为从没看过而全部放行。这两种都是默认状态下做出的选择。更好的做法是针对每个爬虫各做一个决定,依据是它实际在做什么。
OpenAI 运行着三个爬虫。它的爬虫文档说明,OAI-SearchBot 负责让网站出现在 ChatGPT 的搜索功能中,选择退出的网站不会在 ChatGPT 的搜索答案中展示。GPTBot 为训练生成式模型收集内容。ChatGPT-User 处理由用户触发的操作,robots.txt 规则可能不适用于它。每项设置相互独立,OpenAI 表示 robots.txt 更新后,其搜索系统大约需要 24 小时才能完成调整。
Google 的 Google-Extended 令牌控制已抓取的内容能否用于训练未来的 Gemini 模型,以及用于 Gemini 应用中的 grounding。Google 表示它不影响内容被 Google 搜索收录,也与搜索排名无关。AI Overviews 则由常规的搜索控制项管理:AI 功能指南指向的是 nosnippet、data-nosnippet、max-snippet 和 noindex。
Perplexity 的文档把它的爬虫分成两类。PerplexityBot 负责在 Perplexity 的结果中展示并链接网站,据该公司称,它不会被用于抓取内容来训练基础模型。Perplexity-User 在用户提问时抓取页面,Perplexity 表示,由于这类请求是用户发起的,它通常会忽略 robots.txt。
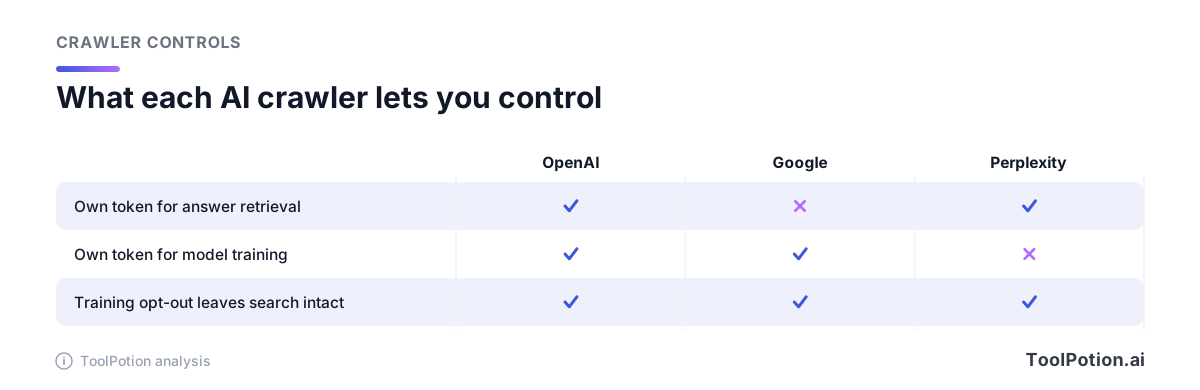
如果你想要被引用,但不想白送训练数据,下面是一个合理的默认设置:允许搜索类爬虫(OAI-SearchBot 和 PerplexityBot),禁止训练令牌(GPTBot)和 Google-Extended(Gemini 训练与 grounding),Googlebot 则保持不动。对应的 robots.txt 如下所示。
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# OpenAI model training
User-agent: GPTBot
Disallow: /

# Gemini training and grounding only. Does not affect Search or AI Overviews.
User-agent: Google-Extended
Disallow: /
注意这个文件没有做到什么。禁止 Google-Extended 并不会让你退出 AI Overviews 或 AI Mode,因为它们遵循的是 Googlebot 和搜索控制项。想限制 Google 展示某个页面的哪些内容,请改用 nosnippet、data-nosnippet、max-snippet 或 noindex,并且要清楚,每一种都会让你损失曝光。
店铺或服务型企业可能想要相反的重点,全部放行,因为在答案中被点名就是目的所在。有付费墙并打算谈授权的出版者,则可能屏蔽得更多。如果你确实打算谈判,一份书面策略加上干净的服务器日志,就是你证明自己能控制什么的证据。
发布 AI 答案能够引用的页面
Google 说得很直白:没有什么特殊窍门。它的指南称,要出现在 AI Overviews 或 AI Mode 中,没有额外的要求,也不需要新的机器可读文件或 AI 专用标记。页面只需被收录,并且有资格以摘要形式展示。所以第一步审查很无聊:确保任何你希望被引用的页面上,都没有误留的 noindex 或 nosnippet。
之后的工作就是编辑层面的了。答案引擎引用的是那些把事情说清楚、注明出处、写明作者的页面。每一节都先给答案,把数字和来源放在同一句话里,并给你的论断标注日期。原创数据胜过转述,因为没有别的东西可引。
结构化数据能帮助机器读懂页面上的内容,但有局限。Google 推荐使用 JSON-LD,并表示这不保证出现富媒体搜索结果,也不要标记读者看不到的信息。Schema.org 的 Article 类型提供 author、datePublished、dateModified 和 publisher,这些属性值得在每篇文章上都填对。完整准确,胜过面面俱到。
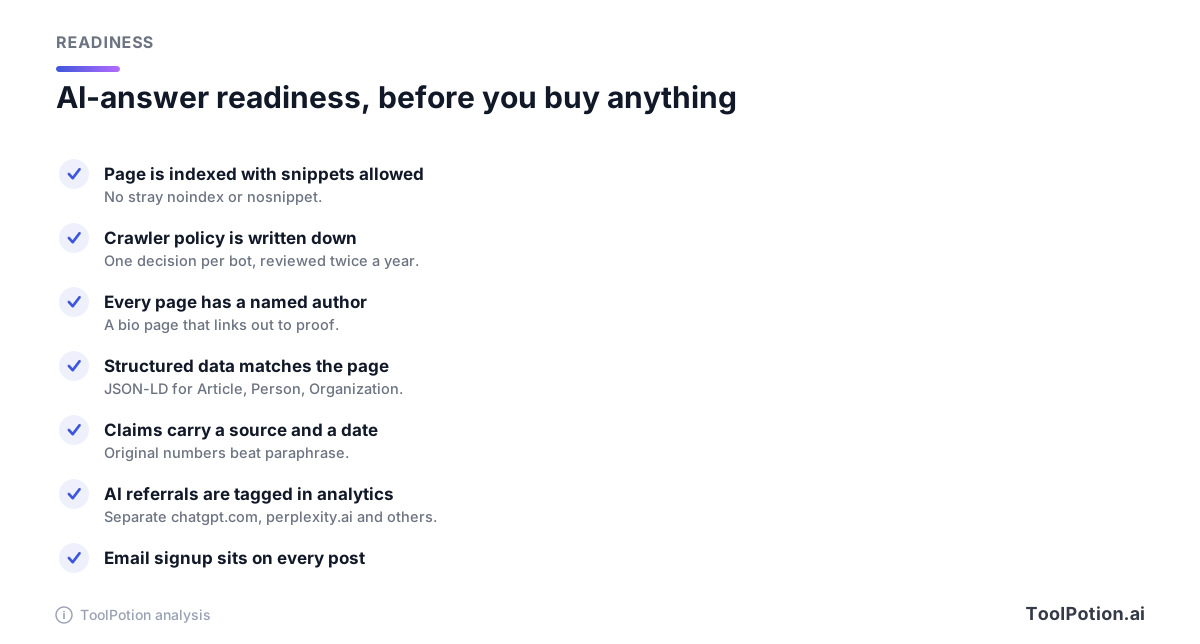
作者页的分量比以前更重了。署名的作者加上一份链接到作品证明的简介,是读者可以核实的东西,模型在几乎一样的页面之间做选择时,看重的也是同样的品质。如果你想要批量起草和检查方面的帮助,AI SEO tools 榜单对各种选项做了排名,Semrush、Ahrefs 和 Frase 是值得对比的知名产品。
先衡量 AI 引荐流量,再谈优化
你的分析工具把一切归入“直接访问”,你就没法管理。先把能看到的引荐来源拆出来。聊天助手和答案引擎会从自己的域名发送流量,比如 chatgpt.com 和 perplexity.ai,所以只要按这些主机名建一个分群,一周内你就有了基线。至于 Search Console,据 Google 说,AI Overviews 和 AI Mode 与其他内容一起归在 Web 搜索类型之下,所以别指望有单独的报告。
每月追踪三个数字:来自 AI 引荐来源的访问量,其中有多少落到了你的邮件订阅入口,以及你搜索自己领域的问题时,有多少目标页面被引用。第三项需要手动完成。打开 Perplexity 和 ChatGPT,问一遍你的客户会问的十个问题,记下你的哪些页面出现了。这只要一小时,却比任何仪表盘告诉你的都多。
也要留意服务器日志。如果你已禁止的爬虫仍在抓取,这就是一个需要提出来的策略问题。如果用户触发的抓取器不顾 robots.txt 照样出现,那按上述厂商文档来看是预期行为,需要的话你得用防火墙规则而不是 robots.txt 来处理。
按业务类型选择方案
同一套策略,落到不同的赚钱方式上,效果各不相同。
- 在 YouTube、Instagram 或 Spotify 上的独立创作者,应该把平台助手仅仅当作免费的分析工具。用它来了解什么样的开头钩子有效,然后在每个视频简介和个人简介里都放上订阅链接。
- 靠广告收入的出版者应当先写好爬虫策略,再观察 Google 的试点以及英国和欧盟的行动,然后决定是否退出 AI 功能。退出会损失曝光,而目前的付费金额差距悬殊。
- 电商和服务型企业希望在答案中被点名。放行搜索类爬虫,把产品和价格信息放在可收录的页面上,并配上一致的结构化数据,再测试一下 ChatGPT 的应用推荐是否适合你的品类。
- Newsletter 运营者已经拥有最好的渠道。把精力花在用平实语言回答问题的归档页上,因为被引用的就是这类页面,它们也会把新读者带回订阅表单。
- 社区建设者最直接地遇到了 Reddit 式的问题。如果你的受众聚集在别人的论坛上,就把最好的帖子镜像到你自己运营的空间里。
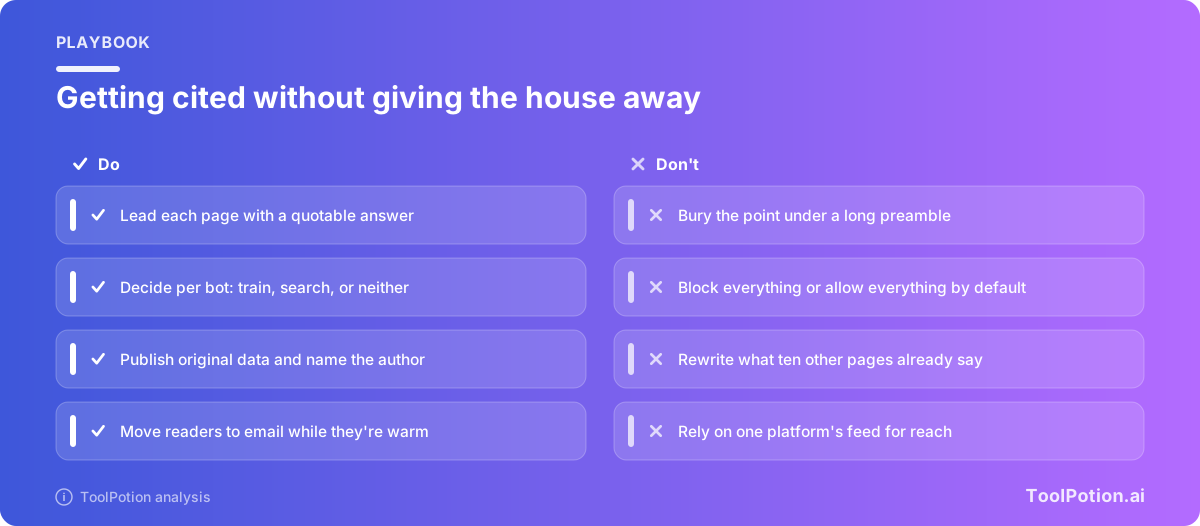
如果你不确定从哪里开始,就从邮件开始。在表现最好的五个页面上加订阅入口,每周发一封有用的邮件,然后观察自行回访的流量占比。我们的内容创作者榜单和面向内容创作者的最佳 AI 工具指南涵盖了制作环节的工具,AI 新闻阅读器则展示了别人如何培养受众的阅读习惯。我们的 top AI YouTube channels 清单展示了租用渠道在大规模下是什么样子。
常见问题
我需要特殊标记才能出现在 Google 的 AI Overviews 里吗?
不需要。Google 的指南说明没有额外要求或特殊优化。你的页面只需被收录,并有资格以摘要形式展示,所以先检查 noindex 和 nosnippet。
屏蔽 Google-Extended 会让我从 Google 搜索中消失吗?
不会。Google 表示 Google-Extended 不影响搜索收录,也与排名无关。它控制的是 Gemini 训练和 grounding 的使用,不会让你退出 AI Overviews 或 AI Mode,后两者遵循的是搜索控制项。
我应该屏蔽 GPTBot 吗?
这取决于你是否介意内容被用于训练。屏蔽 GPTBot 与 OAI-SearchBot 相互独立,所以你可以禁止训练,同时仍允许 ChatGPT 的搜索功能引用你。
我的内容被 AI 使用,能拿到报酬吗?
有可能,但并不稳定。据报道,Google 的试点覆盖约 100 家出版者,付费高低差距很大;据 TechCrunch 报道,Reddit 的 AI 授权收入包含在一条 4300 万美元的收入项里。小型出版者目前应当假设没有报酬,同时备好一份书面的爬虫策略。
我怎么知道 AI 答案有没有给我带来流量?
在你的分析工具里,把来自 chatgpt.com、perplexity.ai 及类似主机名的引荐来源拆分出来。Google 的 AI 功能在 Search Console 中计入你常规的 Web 搜索流量,所以不会单独显示为一行。
这个流量计算器是预测吗?
不是,它只是个粗略的经验估算。它把你的搜索和社交占比相加,得出租用渠道的风险敞口,再套用你自选的搜索点击下降幅度,所以结果的可靠程度取决于你的假设。