

GPT-6.1 Terra 是 OpenAI 新推出的中间价位模型。如果你在 ChatGPT 里只是聊天,大概暂时还看不到它。它面向屏幕、文档和图像:填表、看技术图纸、起草文本、在各种应用里点点点。它的定位在 GPT-6 Luna 和 GPT-6.1 Sol 之间,取代了之前的 GPT-5.6 Terra。
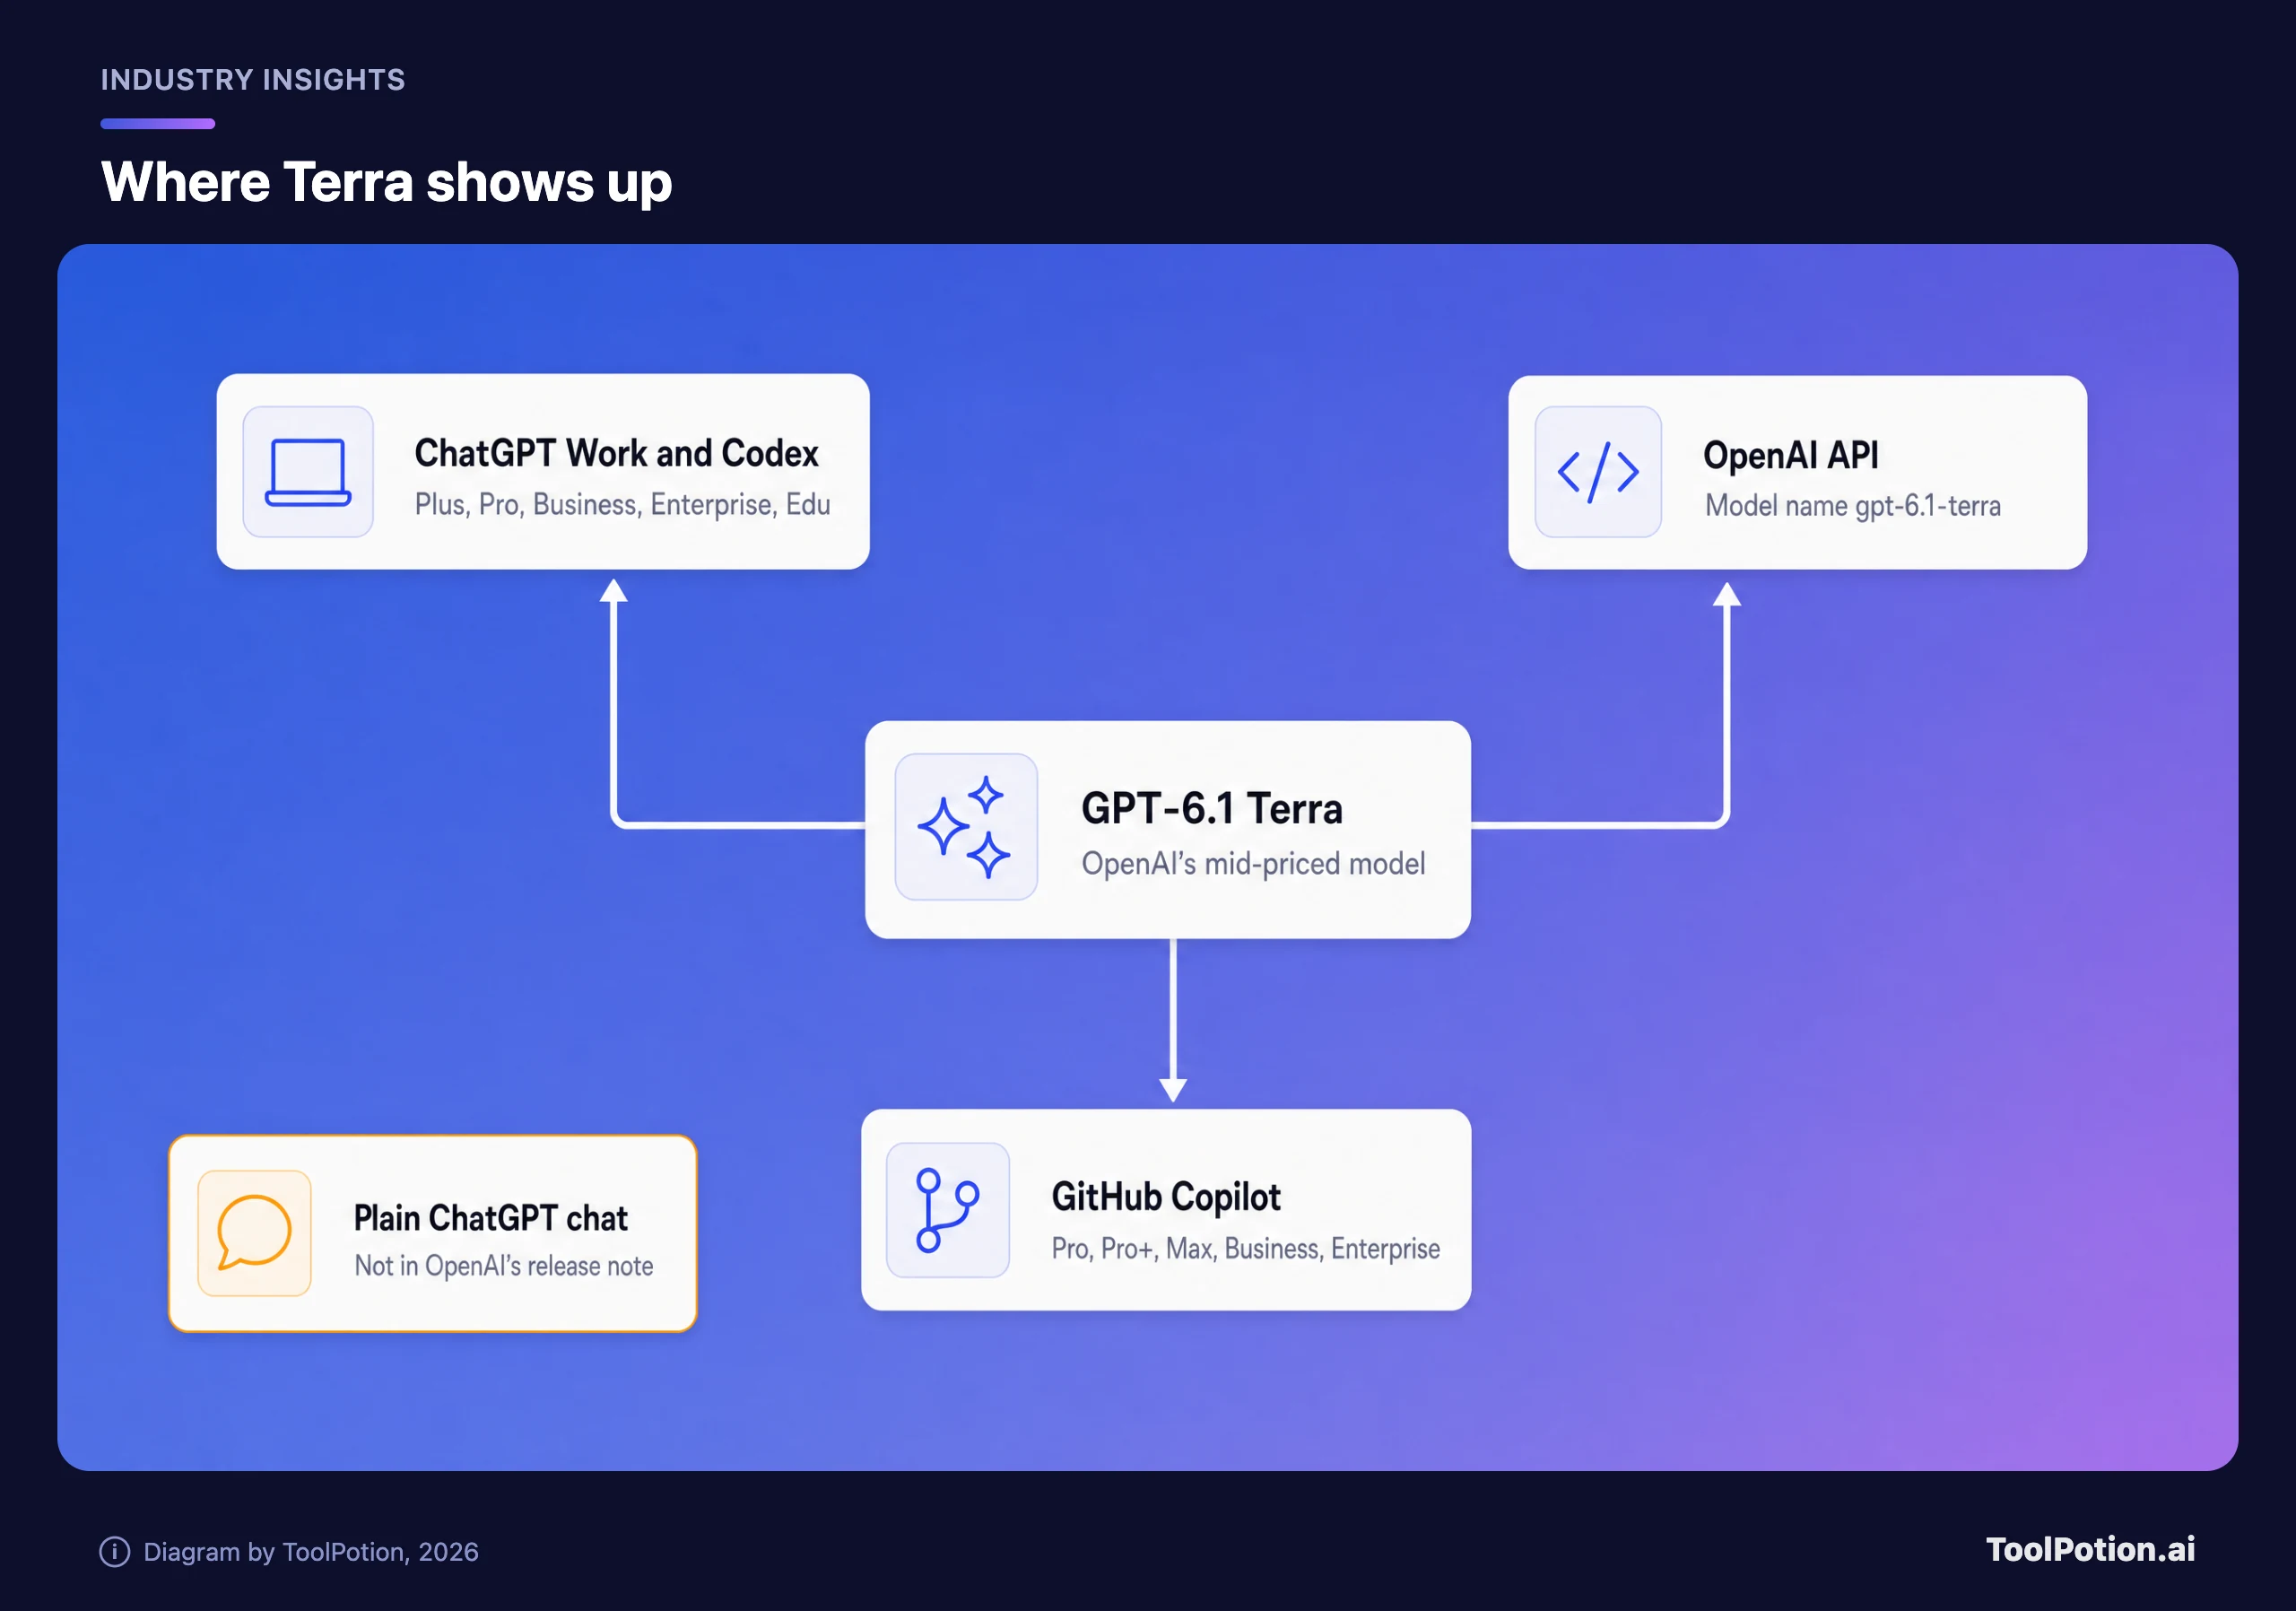
你该不该关注它,取决于你在哪儿干活。OpenAI 的发布说明把 Terra 列在 ChatGPT Work 和 Codex 里,没有提到普通聊天。API 和 GitHub Copilot 里也有它。我们读了 OpenAI 的发布说明、模型文档、定价页和安全附录,GitHub 的更新日志和定价表,以及能找到的外部报道。这些报道大多只是在复述 OpenAI 自己的数字,所以我们会在文中指出少数独立数据。如果你还没跟上这个系列,我们的 GPT-6 Astra 解读讲了最高档,OpenAI 为什么搁置 GPT-6.1 Astra讲了 6.1 里唯一没有发布的那个模型。
GPT-6.1 Terra 是新模型,还是新档位?
两者都沾一点。Terra 在 5.6 代就已经是一个档位,GitHub 的模型表里标价为每百万输入 token $2、每百万输出 token $12。据 InfoWorld 报道,新 Terra 取代了它,价格只有一半。OpenAI 的模型页面把它描述为“用于视觉推理、精准电脑操作和清晰自然写作的快速高效模型”。
规格和 GPT-6 系列其他模型一致:输入文本和图像,输出文本。上下文窗口 105 万 token,输出上限 12.8 万 token,推理强度有六档,从 none 到 max,默认是 medium。训练数据截止到 2026 年。不支持微调。OpenAI 建议的用途包括:把商品照片与目录条目对应起来、解读技术图纸、在应用界面上执行操作、起草和修改文本。这基本就是整个卖点:在屏幕上完成、又用不着研究级大脑的活儿。
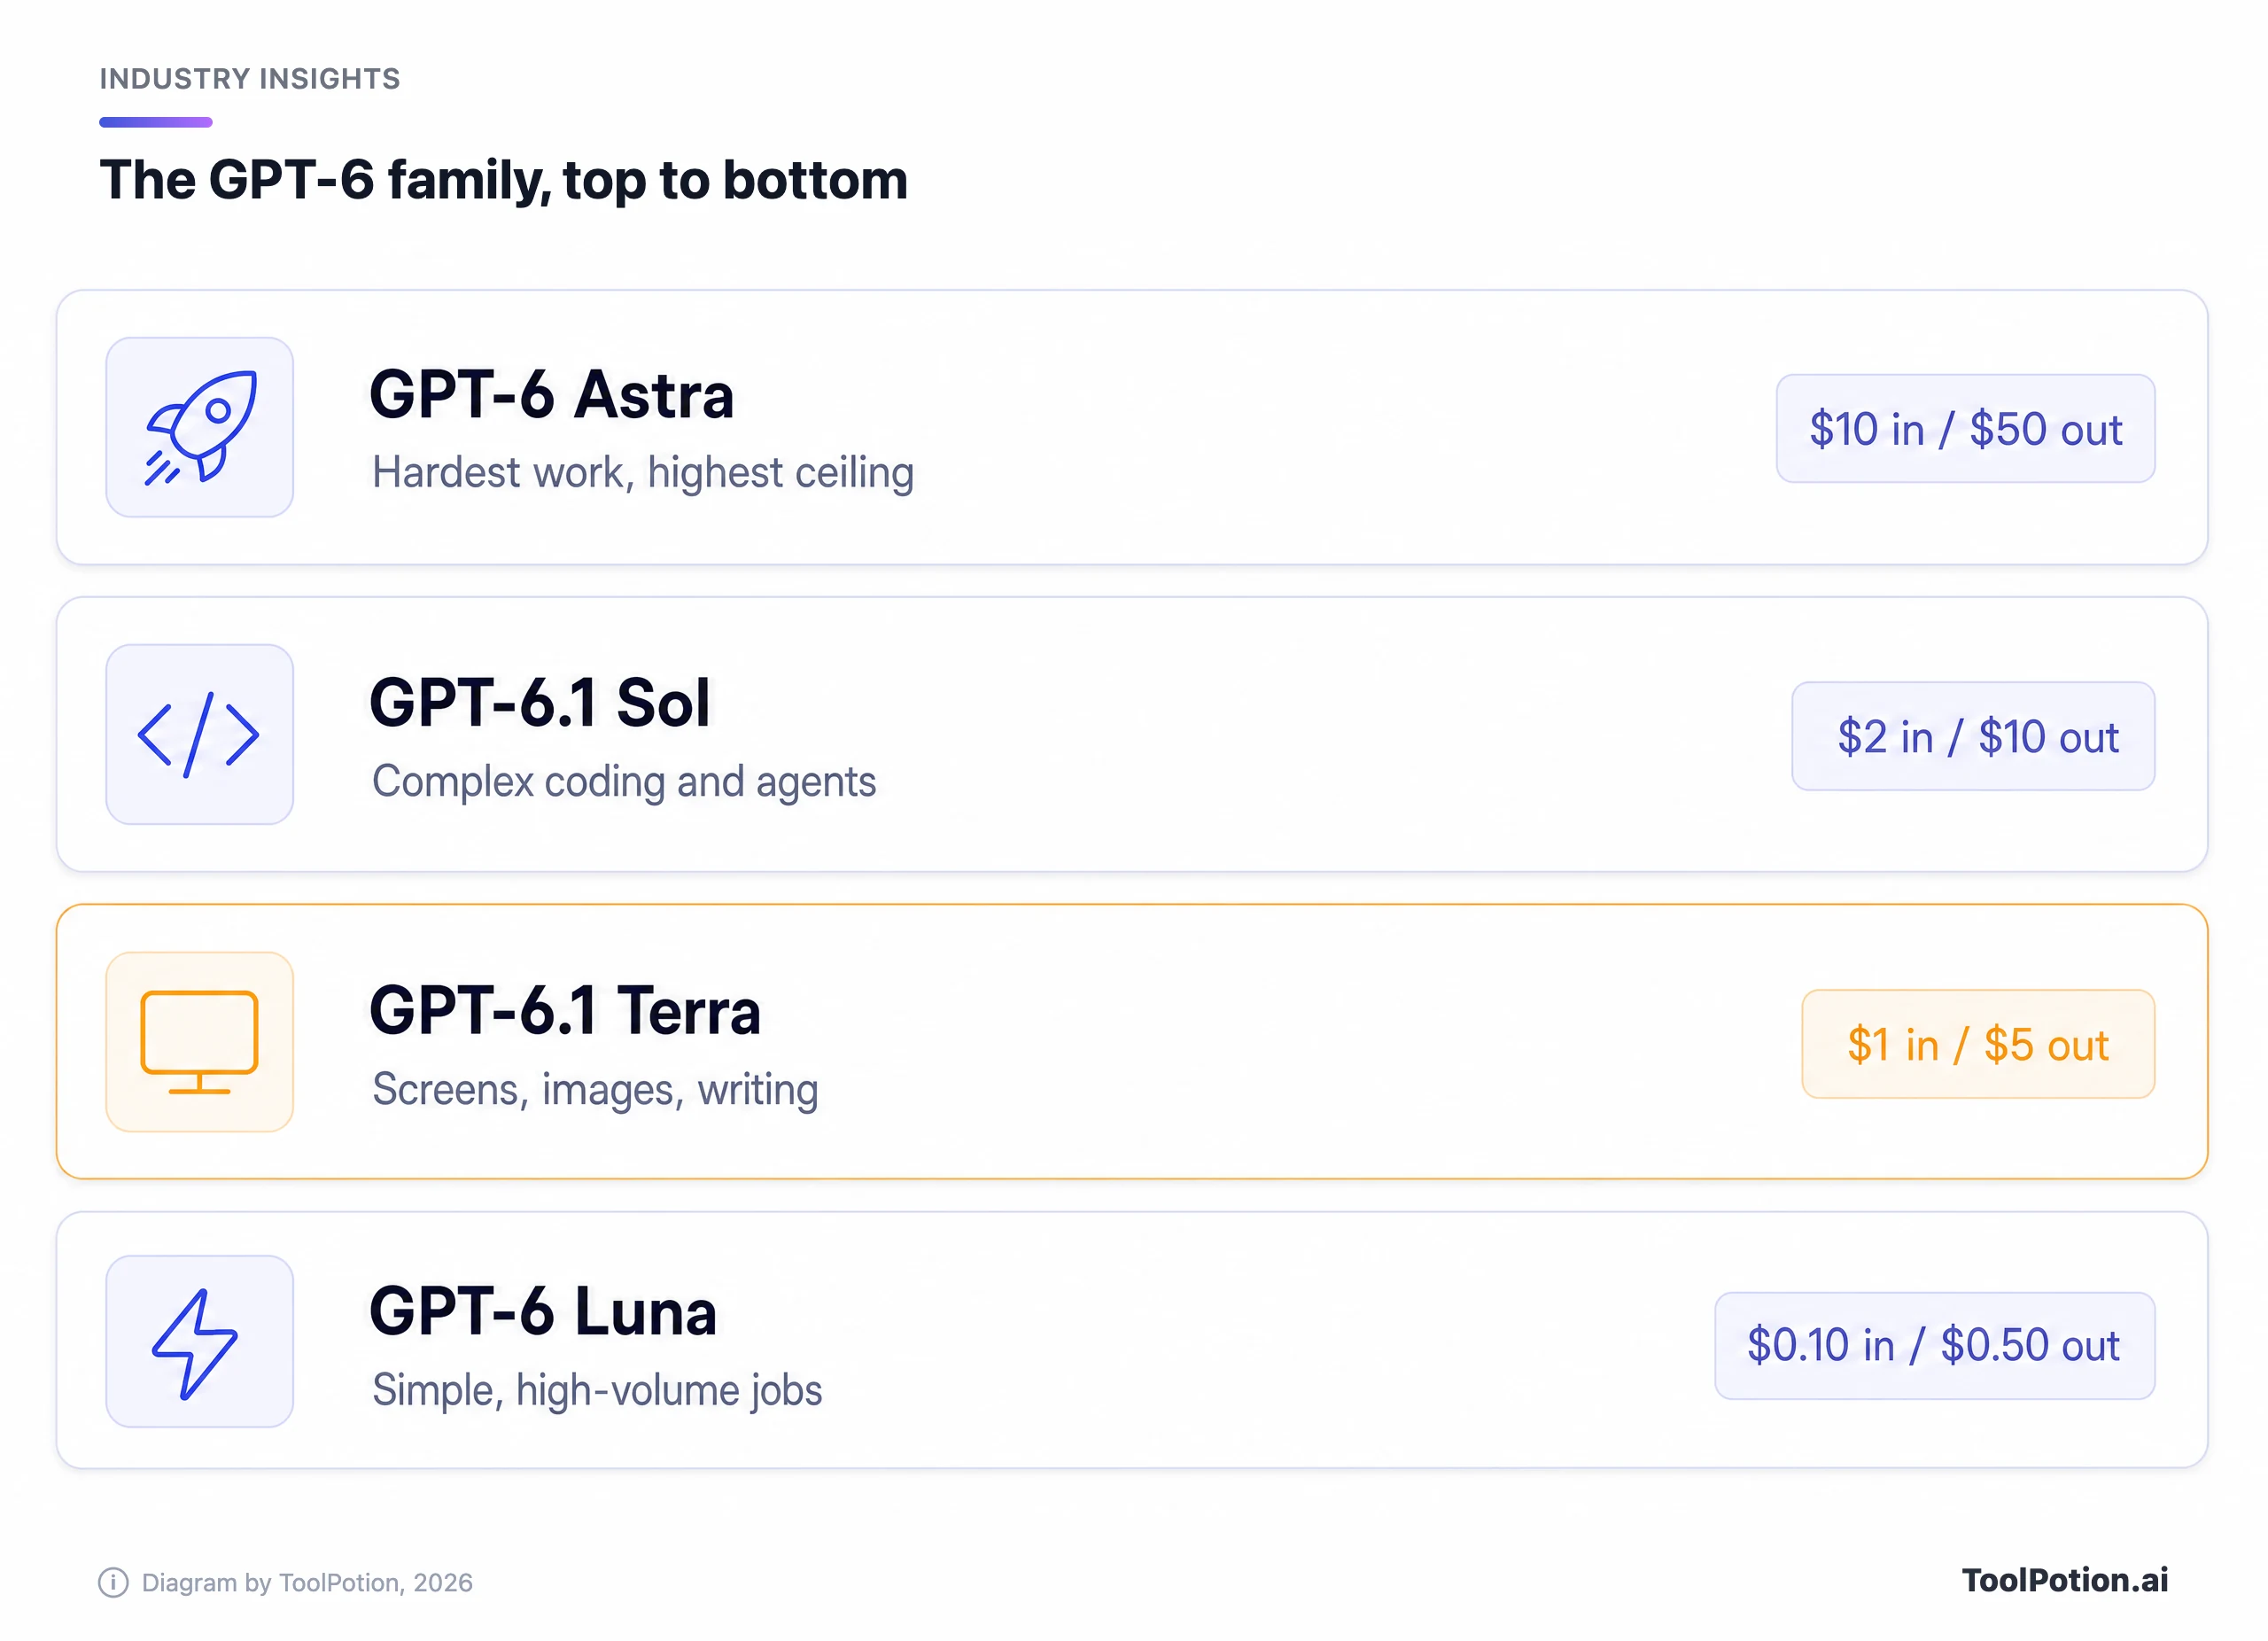
据 DataCamp 转述发布文章,OpenAI 自己的说法是:对于最复杂的编码任务,Sol 和 Astra 仍是更好的选择。Terra 负责量大的活儿。这种分工比基准测试图表更能说明 OpenAI 的意图。
ChatGPT 里谁能用 Terra,哪些套餐有?
OpenAI 的 ChatGPT 发布说明称,Terra 正在 ChatGPT Work 和 Codex 中向 Plus、Pro、Business、Enterprise 和 Edu 套餐推出,具体取决于你所在的地区和工作区设置。你可以在模型列表里选它,套餐的整体用量上限不变。InfoWorld 和 DataCamp 列出的套餐里没有 Business,但 OpenAI 自己的说明里有。
Free 和 Go 没有被提到,普通的 ChatGPT 聊天也没有。OpenAI 没说 Terra 会不会进入这两者,唯一的线索是它对 Sol 的处理:发布文章写的是 Sol“暂未在 Chat 中提供”(OpenAI)。我们的判断是 Terra 会走同样的路,但这只是推测,不是承诺。
说明里有两个古怪的细节值得知道。一些 Plus 和 Pro 用户可能会发现,Work 里原本默认的 Power 预设给的是 Light 强度的 Sol,现在变成了 Medium 强度的 Terra,也就是说你什么都没选,默认值就变了。另外 Terra 不支持阿联酋推理驻留,OpenAI 把这个限制归因于推理运行的位置,而不是你所在的位置。
我们阅读时,OpenAI ChatGPT 定价页上的套餐对比表还没更新:上面仍列着 GPT-5.6 Terra,没有新的这个,Pro 档也仍写着运行在 GPT-6 Astra 上。以你自己账号里的模型列表为准,别信任何表格。DataCamp 还补充说,OpenAI 称同样的套餐额度用 Terra 能完成的任务比用 Sol 或 Astra 多得多。如果你在 ChatGPT 或 Codex 里老是撞上限额,这才是切换的真正理由。
API 里能用 Terra 吗?价格多少?
能。模型名是 gpt-6.1-terra,OpenAI Platform 标价为每百万输入 token $1、每百万输出 token $5。下面是 OpenAI 定价页上整个系列的价格,标准处理,提示词不超过 27.2 万 token。
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
| GPT-6.1 Terra | $1.00 | $0.05 | $5.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
所有价格均为每百万 token。模型页上的细则:输入超过 27.2 万 token 的提示词,整个请求的输入和缓存按两倍计费,输出按 1.5 倍计费。Batch 和 Flex 便宜 50%,Fast 模式是两倍,区域处理加收 10%。缓存写入每百万 token $1.25,保留 30 分钟。工具调用需要使用 Responses API,其中支持电脑操作、网页搜索、文件搜索、代码执行和 MCP。API 的 Free 档无法使用,最低的付费档限制为每分钟 5,000 次请求和 100 万 token。
Terra 还出现在别的地方吗?
GitHub Copilot,首日上线。GitHub 的更新日志称,Terra 已向 Copilot Pro、Pro+、Max、Business 和 Enterprise 用户正式开放,可在 VS Code、Visual Studio、JetBrains、Xcode、Eclipse、Copilot CLI、云端 agent、Copilot 应用、github.com 和移动端应用的模型选择器中选用。GitHub 称它面向日常的 agentic 编码和终端工作,成本比 Sol 低。在早期测试中,它解决的终端和 C# 任务明显多于 GPT-5.6 Terra,不过这是和上一代比,不是和 Sol 比。
它在按用量计费的模式下按提供方的官方标价收费,GitHub 的表格与 OpenAI 的 $1 和 $5 一致。Business 和 Enterprise 的管理员通过模型策略来控制它,新模型默认开启,除非管理员关闭了这个默认设置。如果你为团队管理 GitHub Copilot,在开发者自己发现这个模型之前,先去检查这项默认设置。
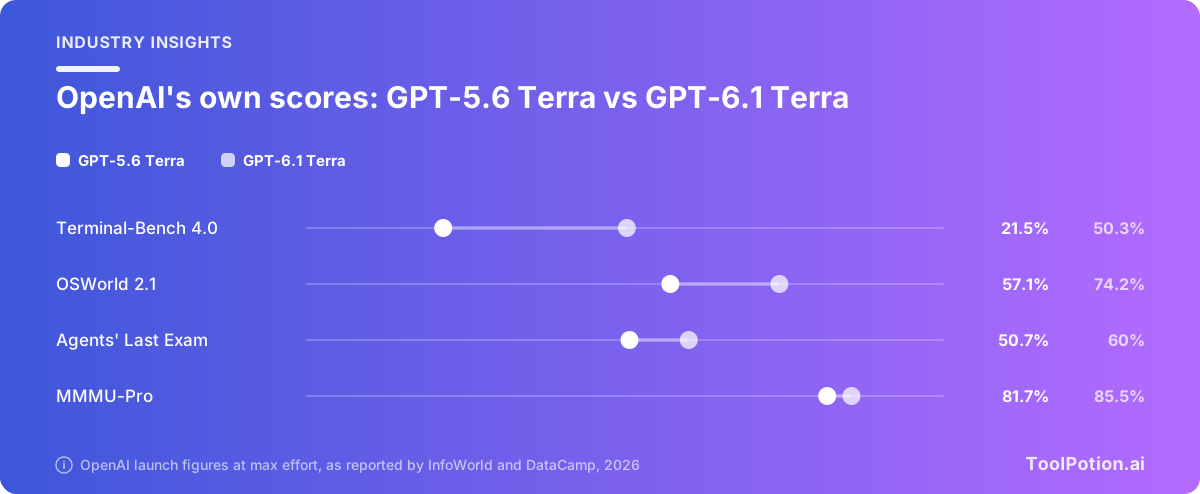
OpenAI 的数字只能看趋势,不是计分板
发布时的对比都拿 OpenAI 之前的 Terra 做参照,相比之下提升很大。以下是 InfoWorld 和 DataCamp 转述发布文章的 max 强度得分。
更有意思的是和更大模型的对比。在测试专业任务的 Agents' Last Exam 上,InfoWorld 报道 Terra 得分 60.0%,每个任务 $1.01;Astra 是 59.3%,每任务 $7.24;Sol 是 58.6%,每任务 $2.00。也就是说得分持平,价格只是零头。报道还提到 Claude Opus 5.5 以 63.2% 领先;在 OSWorld 2.1 上,Anthropic 的 Claude Sonnet 5.5 拿到 83.9%,Terra 是 74.2%。在这个对比里,Terra 不是最强的电脑操作模型,而是接近最强里最便宜的那个。
对于 OpenAI 的标题宣称:在 max 强度下,每任务成本比 Opus 5.5 低约九倍,DataCamp 的作者就直白得多:“我觉得这个对比有点刻意,或者说有选择性。”Opus 属于高端档,所以很容易得出一个很大的比值。OpenAI 的错误率说法也要同样谨慎对待。低强度下错误率从 53.6% 降到 16.7%,来自 OpenAI 内部专门设计来诱发错误的提示词集,而 OpenAI 的安全附录也说,这些案例并不代表真实的错误率。
独立数据是有的,只是没那么光鲜。Artificial Analysis 给 Terra 在 max 强度下的 Intelligence Index 打了 51 分,在它的模型页面上 52 个模型中排第 12。同一指数里,Sol 是 55,Astra 是 57。真正该改变你用法的是:调低强度设置后,分数掉得有多快。
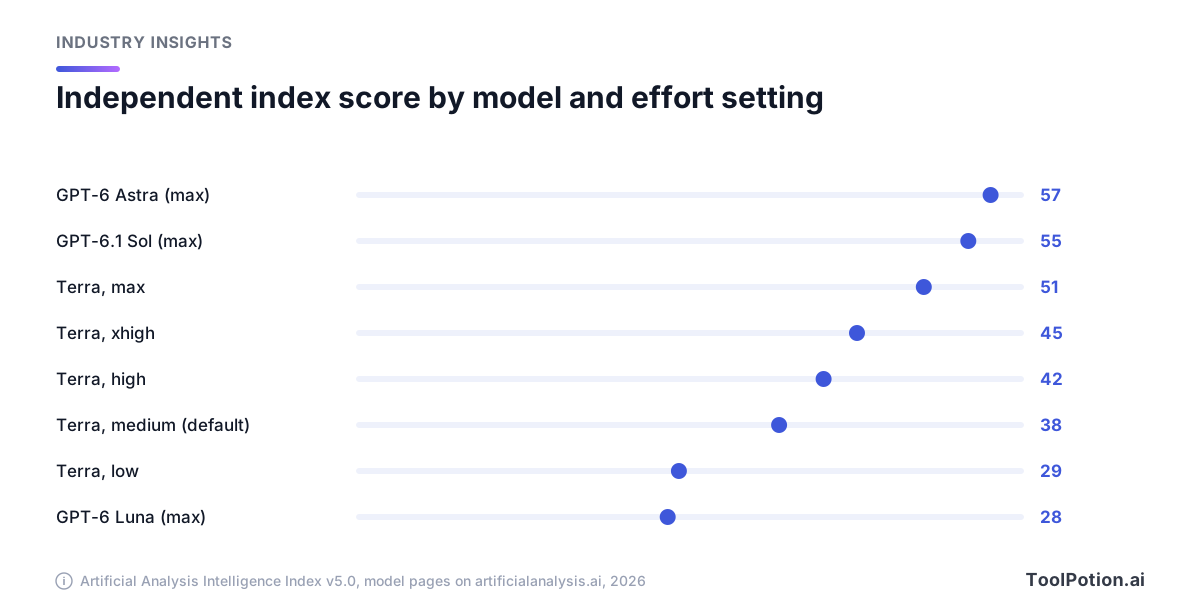
API 默认是 medium。在 Artificial Analysis 的 medium 强度页面上是 38 分,开箱即用的 Terra 离 28 分的 Luna 比离 55 分的 Sol 更近。在它的编码 agent 指数上,Terra 在 Codex 里用 xhigh 得 48 分,Sol 用 max 得 54 分,这和 OpenAI 自己关于难题编码的建议是吻合的。
更便宜的价格成立,但有限度
按 token 算,是的。InfoWorld 列出它点名的对手 Anthropic 的 Claude Sonnet 5.5 为 $2 和 $10,所以 Terra 便宜一半。按完成一个任务算,就要看强度设置了。Artificial Analysis 的页面显示,Terra 在 max 强度下跑完整个测试集写了 9,900 万输出 token,同类模型的中位数是 6,400 万,它还说这个模型偏啰嗦。结果是 Terra 在 max 下每任务 $0.96,比 Sol 的 $1.27 低约 24%。
降一档,情况就变了。Artificial Analysis 列出 xhigh 为 45 分、每任务 $0.40,medium 为 38 分、每任务 $0.17,和 GPT-6 Luna 在 max 强度下的成本($0.15)差不多,但高出十分。我们的看法是,xhigh 或 high 才是 Terra 物有所值的位置,到了 max 就不划算了。这是基于别人的测量得出的论点,不是我们自己测的。
token 便宜了,人的成本并不会因此减少。Greyhound Research 的 Sanchit Vir Gogia 对 InfoWorld 说,在一个示例性的编码工作负载里,“多出来的 5.4 秒审查时间就把推理节省的成本抵消了”。EIIRTrend & Pareekh Consulting 的 CEO Pareekh Jain 则乐观一些:“企业需要在智能、速度和成本之间取得平衡的 AI 模型。”他认为 Terra 瞄准的是发票处理、文档分析和日常编码。两种说法可以都对。
安全层面几乎没有变化
OpenAI 的附录称,它把 Terra 在网络安全方面按 Critical 级别对待,在生物和化学能力方面按 High 级别对待,并采用与 Sol 和 Astra 相同的一整套防护措施。在 OpenAI 的生产环境安全基准上,Terra 的表现与旧 Terra 相当,在极端主义、仇恨和涉及未成年人的性内容几个类别上略有下降,OpenAI 称这些下降在统计上不显著。和 Astra 以及两个 Sol 一样,它没有试图绕过 Codex 的 Auto-review 监控。附录里还有一条提醒:在图像输入测试中,Terra 在仇恨和极端主义方面相比旧 Terra 出现了统计上显著的退步,OpenAI 说这与以往发布的情况一致。
所以这个便宜的模型背着贵模型的风险等级。如果让 GPT-6.1 Astra 折戟的那些安全问题让你对 6.1 系列有所顾虑,请注意 Terra 和 Sol 都是已经发布的 6.1 模型。没人说过这两件事有关联,而且这些结果全部来自 OpenAI 自己。我们读到的报道里,目前还没有一份针对 Terra 的外部安全评估。
我们的建议:量大的活儿交给 Terra,难的代码交给 Sol
如果你只用普通的 ChatGPT 聊天,就没什么可切换的。如果你常驻 Work 或 Codex,涉及难代码或研究的任务我们会继续用 Sol,把重复性的屏幕、文档和起草工作交给 Terra,并用 xhigh 而不是 max。这也大致是我们那篇哪种 AI 模型档位适合哪类任务的指南所主张的分工,Top 50 LLM 榜单则能看到各竞品的位置。对于做产品的开发者来说,Terra 是这个系列里第一个我们愿意拿来测试、作为大批量电脑操作场景默认模型的,简单的活儿则交给下面的 Luna。
一个公平的测试只要一个下午,而且只有它能为你的工作给出定论。
- 挑三件你每周都重复做的事,比如根据 PDF 填表、总结截图、起草回复。
- 每件事分别用 Sol 和 Terra 在相同强度下跑一遍,再让 Terra 高一档强度跑一遍。
- 数一数你修改了多少处,别去数花了多少秒。
- 检查你账号里的模型列表,因为 Work 里的 Power 预设可能已经把你切到 Terra 了。
和 ChatGPT、Claude、Gemini 相比,Terra 的卖点比它们任何一个都更窄。它是干活的模型,不是聊天产品。专门就编码 agent 而言,我们的终端编码 agent 对比表明,harness 和模型一样重要。
目前还没有定论的是:OpenAI 会不会把 Terra 带到普通聊天和 Free 套餐,以及它的套餐表什么时候才不再列出旧的 Terra。留意那张表,也留意第一份在 max 以下强度测试 Terra 的独立编码评测。