

GPT-6 Astra 是 OpenAI 今年的顶级模型,专为在电脑上完成冗长的多步骤工作而设计:浏览网页、填写表单、写代码、生成文档。它是真实存在的,已经上线,但对大多数人来说,它并不是你应该首先选的模型。它有一个更便宜的兄弟模型 GPT-6.1 Sol,能以五分之一的价格完成 Astra 的大部分工作。
OpenAI 大约五周前推出了 Astra,先向一小部分组织开放,随后扩展到付费 ChatGPT 套餐和 API。家族里的其他模型陆续跟上:大约三周后是 GPT-6 Sol 和 GPT-6 Luna,再过一周是 GPT-6.1 Sol。命名让人一头雾水,基准测试的宣传声势很大,安全说明却出奇地直白。这篇指南会帮你理清每个模型是什么、谁能用、多少钱,以及谁可以放心无视它。
下面的内容均来自 OpenAI 自己的文档和定价页面,外加外部报道和评测,出处都已在文中注明。当 OpenAI 的说法与独立数据不一致时,两边的数字我们都会列出来。
GPT-6 Astra 是什么
OpenAI 的模型文档把 Astra 描述为“最适合最高难度工作的最强模型”,称它在复杂推理、编码、电脑操作、研究和文档创作方面表现最好(OpenAI API 文档)。它接收文本和图像输入,输出文本。上下文窗口为 105 万 token,最大输出为 12.8 万 token,推理强度可以在从低到最高的五个档位中设置。
它支持 Chat Completions 和 Responses 接口,也支持 Batch API。不支持实时对话、微调和音频。在 Responses API 中,它可以使用网页搜索、文件搜索、代码执行和电脑操作,所以它可以作为 agent 的引擎,而不只是一个聊天机器人。
Astra 位于一个小家族的顶端。OpenAI 模型页面上的三款 GPT-6 模型共享同样的 105 万 token 窗口和 12.8 万 token 输出上限(OpenAI API 文档)。区别在于你买到的“脑力”有多少。
| 模型 | OpenAI 的描述 | 每百万 token 输入 / 输出价格 |
|---|---|---|
| GPT-6 Astra | 能力最强,适合最高难度的工作 | $10 / $50 |
| GPT-6.1 Sol | 接近 Astra 的表现,成本更低 | $2 / $10 |
| GPT-6 Luna | 效率最高,适合专注的大批量任务 | $0.10 / $0.50 |
价格为OpenAI 定价页面上的标准模式标价。GPT-6.1 Sol 是此前发布的 GPT-6 Sol 的升级版,所以有些地方你可能还会看到旧名称。
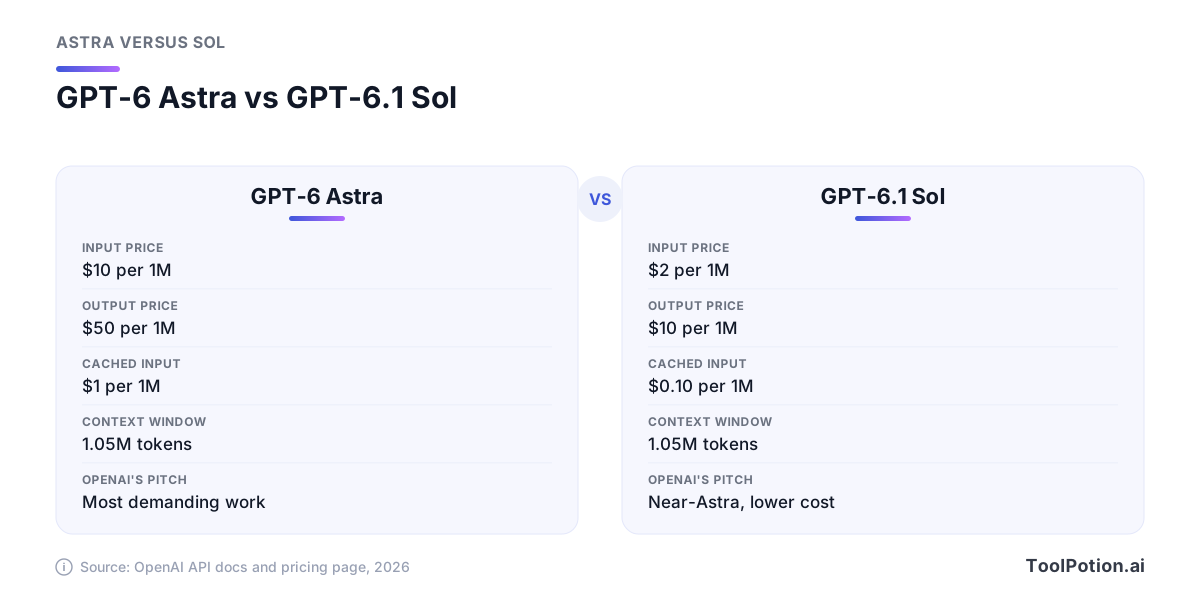
上面的卡片把你最可能二选一的两个模型放在了一起。上下文窗口完全相同,不同的只有价格和能力上限。
哪些 ChatGPT 套餐能用 Astra
OpenAI 的套餐对比划分得很清楚。Free 和 Go 完全没有列出 Astra。Plus 包含它,Pro 获得扩展访问,Pro 套餐的宣传语是“由 GPT-6 Astra 驱动的 Pro 推理”。Free 套餐的无限文本聊天跑的是 GPT-5.6 Luna,不是 GPT-6 家族。
| 套餐 | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| Free | 否 | 否 | 否 |
| Go | 否 | 否 | 否 |
| Plus | 是 | 是 | 是 |
| Pro | 扩展 | 扩展 | 扩展 |
| Business | 灵活 | 灵活 | 灵活 |
| Enterprise | 灵活 | 灵活 | 灵活 |
“灵活”是 OpenAI 对 Business 和 Enterprise 的说法:可以使用这些模型,组织还可以购买额度来获得更多用量。标准 Business 席位标价为每月 $20(按年付费)或 $25(按月付费),Premium 席位为 $100 或 $125(OpenAI 商业定价)。
OpenAI 的发布文章称,Astra 先向一小部分组织推出,随后几天内陆续开放给 Plus、Pro、Business 和 Enterprise 用户、API、Microsoft Azure 和 AWS Bedrock(OpenAI)。如果你是付费套餐用户但还没看到它,过段时间再查看一下。
关于 Sol 有个小插曲。套餐表里 Plus 及以上都列有 GPT-6.1 Sol,但 OpenAI 在发布时说它可用于 ChatGPT Work 和 Codex,普通 Chat 里还没有(OpenAI)。各个模型在 ChatGPT 里出现在哪里,可能每周都在变,所以请以模型选择器为准,别轻信任何表格,包括这一张。
OpenAI 说新在哪里
OpenAI 的主打卖点是 agent 式工作:跨软件、浏览器、文档和代码的更长任务,需要的人工干预更少。发布文章称,在桌面控制测试 OSWorld 2.0 上,Astra 得分 72.6%,每个任务耗时比 GPT-5.6 Sol 少约 47%,后者得分 65.7%,耗时约 75 分钟。在 Agents' Last Exam(真实软件中的专业任务测试)上,它报告的得分为 59.3%,Claude Opus 5 为 55.5%,而输出 token 比 Opus 少约 65%(OpenAI)。
同一张表也显示了 Astra 不占优的地方。在 BenchCAD 上,它得分 95.9%,Claude Fable 5.1 为 84.3%;但在 Artificial Analysis 的 Intelligence Index(4.1.1 版)上,它是 61.2,Fable 5.1 是 65.7。这些都是厂商自己跑的数据,由厂商挑选,不过 OpenAI 确实也把自己输的项目列了出来。
成本也是故事的一部分。Astra 的输入 $10、输出 $50,是 GPT-5.6 Sol 当前标价($4 和 $20)的两倍半,不过 OpenAI 把 Sol 的价格标为促销价(OpenAI 定价)。对大多数升级用户来说,要对比的是更早的 GPT-5.6。
电脑操作如何运作
电脑操作是一个循环,OpenAI 的指南把它分成三步:截取屏幕截图、让模型行动、重复直到任务完成(OpenAI 文档)。模型可以点击、双击、拖动、滚动、输入和等待。OpenAI 推荐的方式是让模型编写简短的 Python 或 JavaScript,通过 Playwright 之类的工具来驱动屏幕,同时仍然支持原生的 computer 工具作为替代方案。指南建议代码路线用 Astra,而 gpt-6.1-sol 搭配 computer 工具使用。
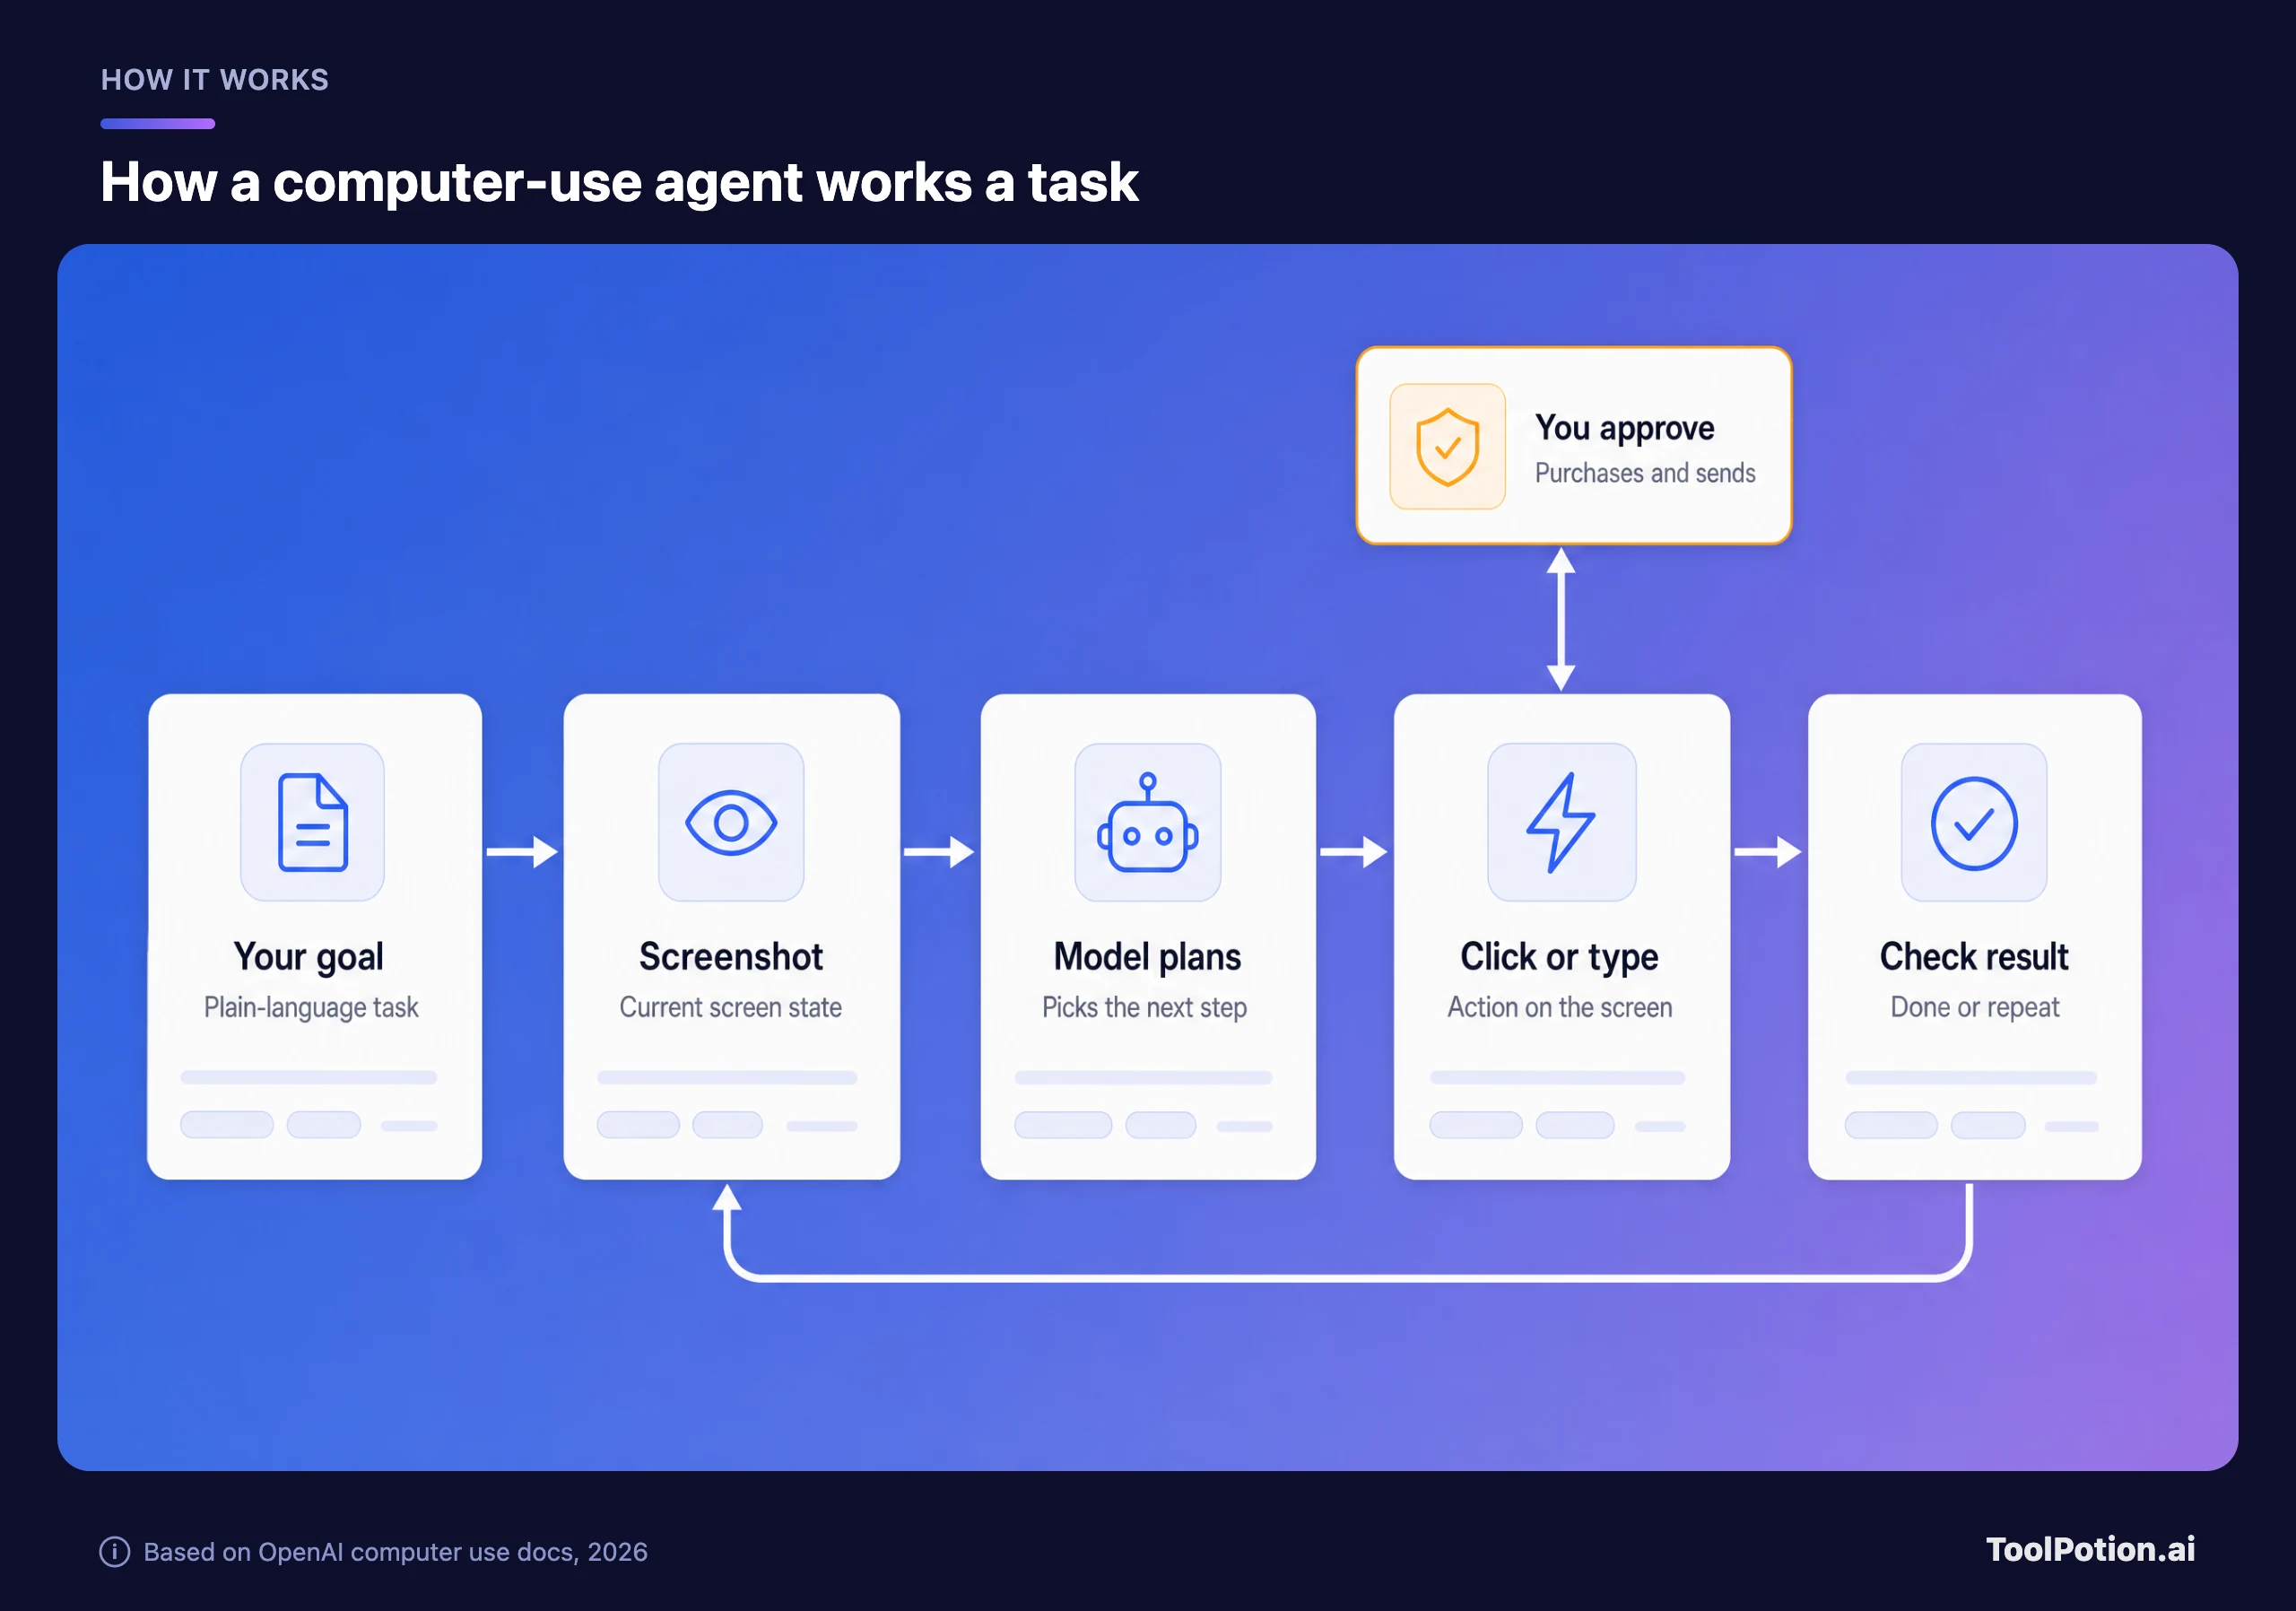
琥珀色的那张卡片最关键。同一份指南告诉开发者:要把环境隔离在沙盒浏览器或虚拟机里;购买等高风险操作在执行前要确认;屏幕上的任何内容都要当作不可信,因为网页上的文字可能试图操控 agent。它甚至说,在表单里输入敏感信息就等同于把它发送出去。
从消费者角度看,这就是 ChatGPT Atlas、Perplexity Computer 和 Claude for Chrome 这类浏览器 agent 背后的机制,也是通用的 Computer Use 概念的基础。Astra 是这个循环里更强的引擎,但并不是另一种东西。
独立评测发现了什么
外部测试者给出的图景比发布文章更复杂。在 Artificial Analysis 的 Intelligence Index 4.2 版、最高推理强度下,DeepLearning.AI 的 The Batch 报告 Claude Fable 5.1 为 57,Astra 为 55,Claude Opus 5 为 54,GPT-5.6 Sol 为 51(The Batch)。
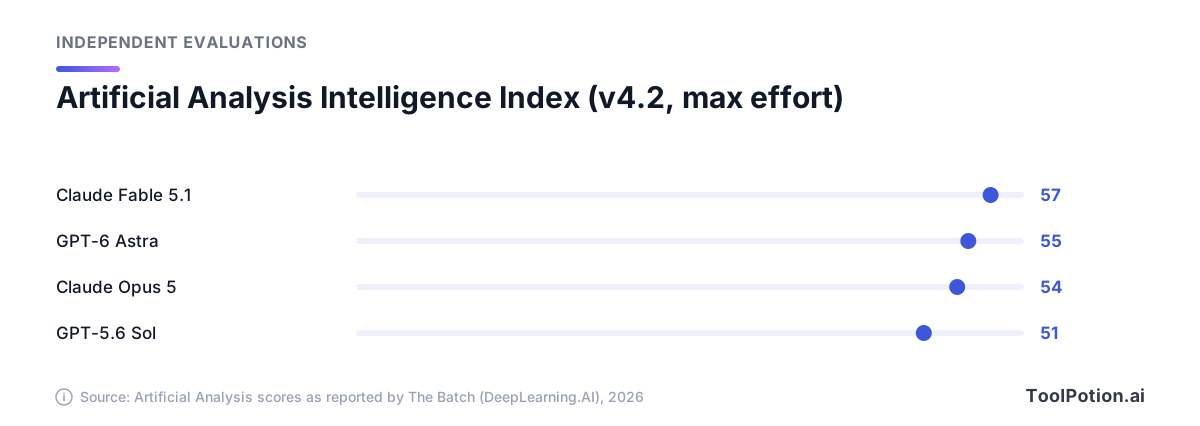
所以 Astra 相比前代明显进步,在这一版指数中排第二。不过排名并不稳定。在更新的 v4.3 版本上,The Batch 称 Astra 与 Fable 5.1 并列第一,均为 53,这得益于两个被替换的测试组件。当两个指数版本对谁领先说法不一时,谁也别急着下结论。
The Batch 还给出了另外两个独立数据点。在 Vals Index 上(它按各领域占美国经济的比重给测试加权),Astra 得分 66.61,Fable 5.1 为 68.83,但 Astra 每个任务耗时 25 分钟,Fable 要 76 分钟。而在 Artificial Analysis 的 agentic 编码任务上,尽管 token 单价是 GPT-5.6 Sol 的 2.5 倍,Astra 每个任务的成本却和它差不多,因为它用的 token 只有三分之一。
还有一个需要加脚注的头条分数。OpenAI 报告在 ARC-AGI-3 上得到 99.9%。运营该基准的 ARC Prize 确认了这个数字,但仅限于它的 Provider Adapter 设置,该设置会在请求之间保留模型的推理状态。在标准设置下,Astra 得分 62.7%(ARC Prize)。两个都是业界最高水平的分数,但衡量的是不同的设置。
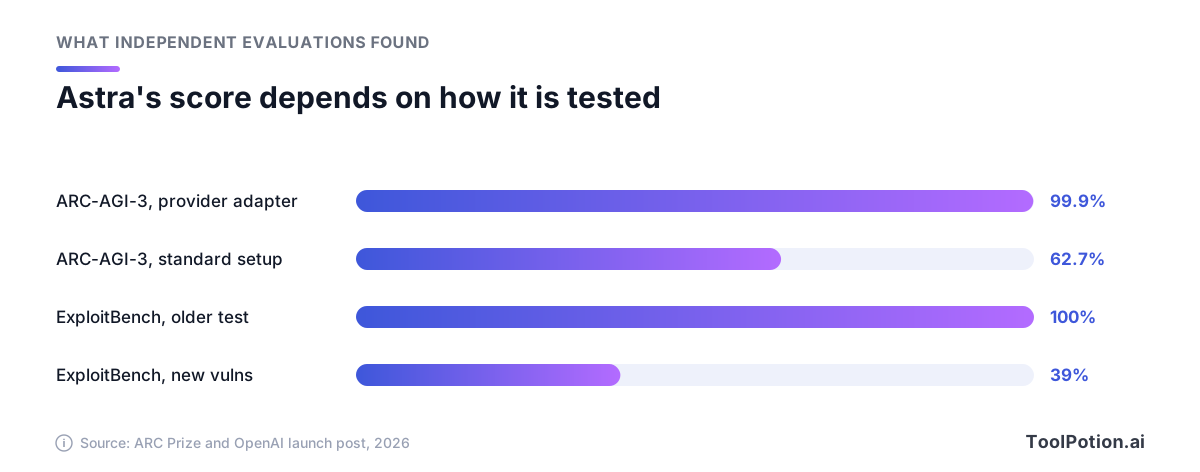
第二组柱子展示的是另一种需要留意的情况。Astra 在安全测试 ExploitBench 上得分 100%。OpenAI 自己做的新版本使用了过去三个月发现的漏洞,模型不可能见过,得分是 39%,但仍远高于 GPT-5.6 Sol 的 5.5(OpenAI)。旧基准会饱和。看任何单个发布时的数字,都要像看餐厅自己贴的好评那样。
价格
Astra 的 API 标价是每百万输入 token $10、每百万输出 token $50,缓存输入为 $1(OpenAI 定价)。输入超过 27.2 万 token 的请求更贵:OpenAI 的模型页面写明整个请求的输入和缓存费率为 2 倍、输出费率为 1.5 倍,这与定价页面上的输入 $20、输出 $75 一致。Fast 模式价格翻倍,速度约为两倍。Batch 和 Flex 则减半。
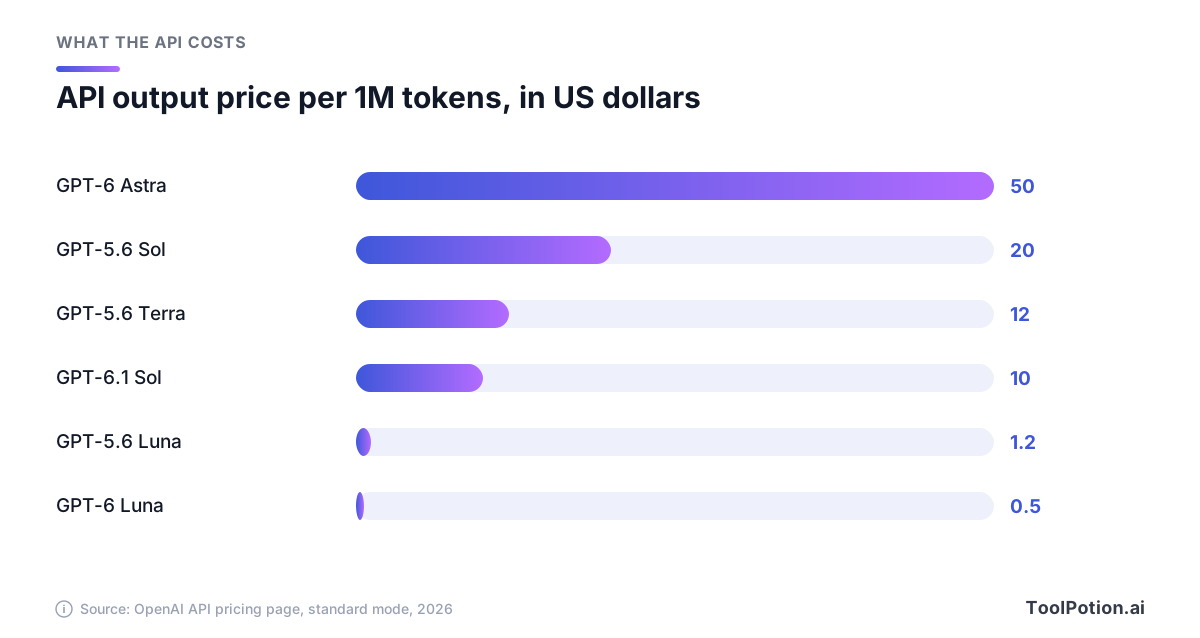
Astra 是页面上最贵的模型,而且遥遥领先。GPT-6.1 Sol 的输出价格是 $10,和 Astra 的输入价格相同,Luna 的 $0.50 只有 Astra 的百分之一。不过每 token 的价格不是账单的全部。OpenAI 自己公布的 Terminal-Bench Science 数据展示了每个任务的差距:最高推理强度下,Astra 约 $23.80,GPT-6.1 Sol 约 $5.47。
推理 token 算作输出,而输出是贵的那一边。一次最高推理强度的长时间 agent 运行可能会烧掉大量 token。下面的估算器使用标价,你可以代入自己的工作负载;默认值对应每月 5,000 个任务,每个任务 2 万 token 输入、4,000 token 输出。
按这些默认值,Astra 每月 $2,000,Sol $400,Luna $20。估算器没有考虑缓存、批处理折扣和长上下文费率,所以重复提示词的实际账单会更低。不变的是比例。如果更便宜的模型能通过你的测试,省下的钱就等于你为质量差距所要付出的钱。
安全限制与 Astra 拒绝做什么
OpenAI 表示,Astra 是它首个达到 Preparedness Framework 网络安全“Critical”阈值的模型:它能发现未知的软件漏洞并开发出可用的利用代码,测试期间还发现了两个此前未知的零日漏洞(OpenAI)。
公开版本被刻意削弱了。OpenAI 称它会拒绝高级安全任务,比如构建概念验证利用代码,并且有一套分类器系统检查它的推理和操作,自动阻止可能未经授权的活动。OpenAI 计划通过 Daybreak 计划向经过审核的防御者提供更广泛的访问,并承诺在未来几周内放宽安全限制。
最不寻常的一条是关于监督。OpenAI 报告称,根据明确要求模型规避监控的测试,Astra 的书面推理比 GPT-5.6 Sol 更难监控,并将其归因于它对自身推理的控制力更强。OpenAI 还说,Astra 对自身能力的误导性说法更少。这两点都是 OpenAI 在描述自己的模型,也都是让你在任何重要事务上保持人工介入的理由。
Astra、Sol 还是 Luna:选择原则
从任务出发,而不是从排行榜出发。OpenAI 称,GPT-6.1 Sol 在 DeepSWE v1.1(真实软件工程任务测试)上与 Astra 持平,成本约为五分之一;在 OSWorld 2.0 上只差 2.1 分,每个任务成本约为七分之一。Astra 仍然保持 Terminal-Bench Science 的最高分 68.1%,OpenAI 建议最困难的科学研究用它(OpenAI)。这些都是 OpenAI 自己做的对比,所以把它们当作值得去测试的有力提示,而不是定论。
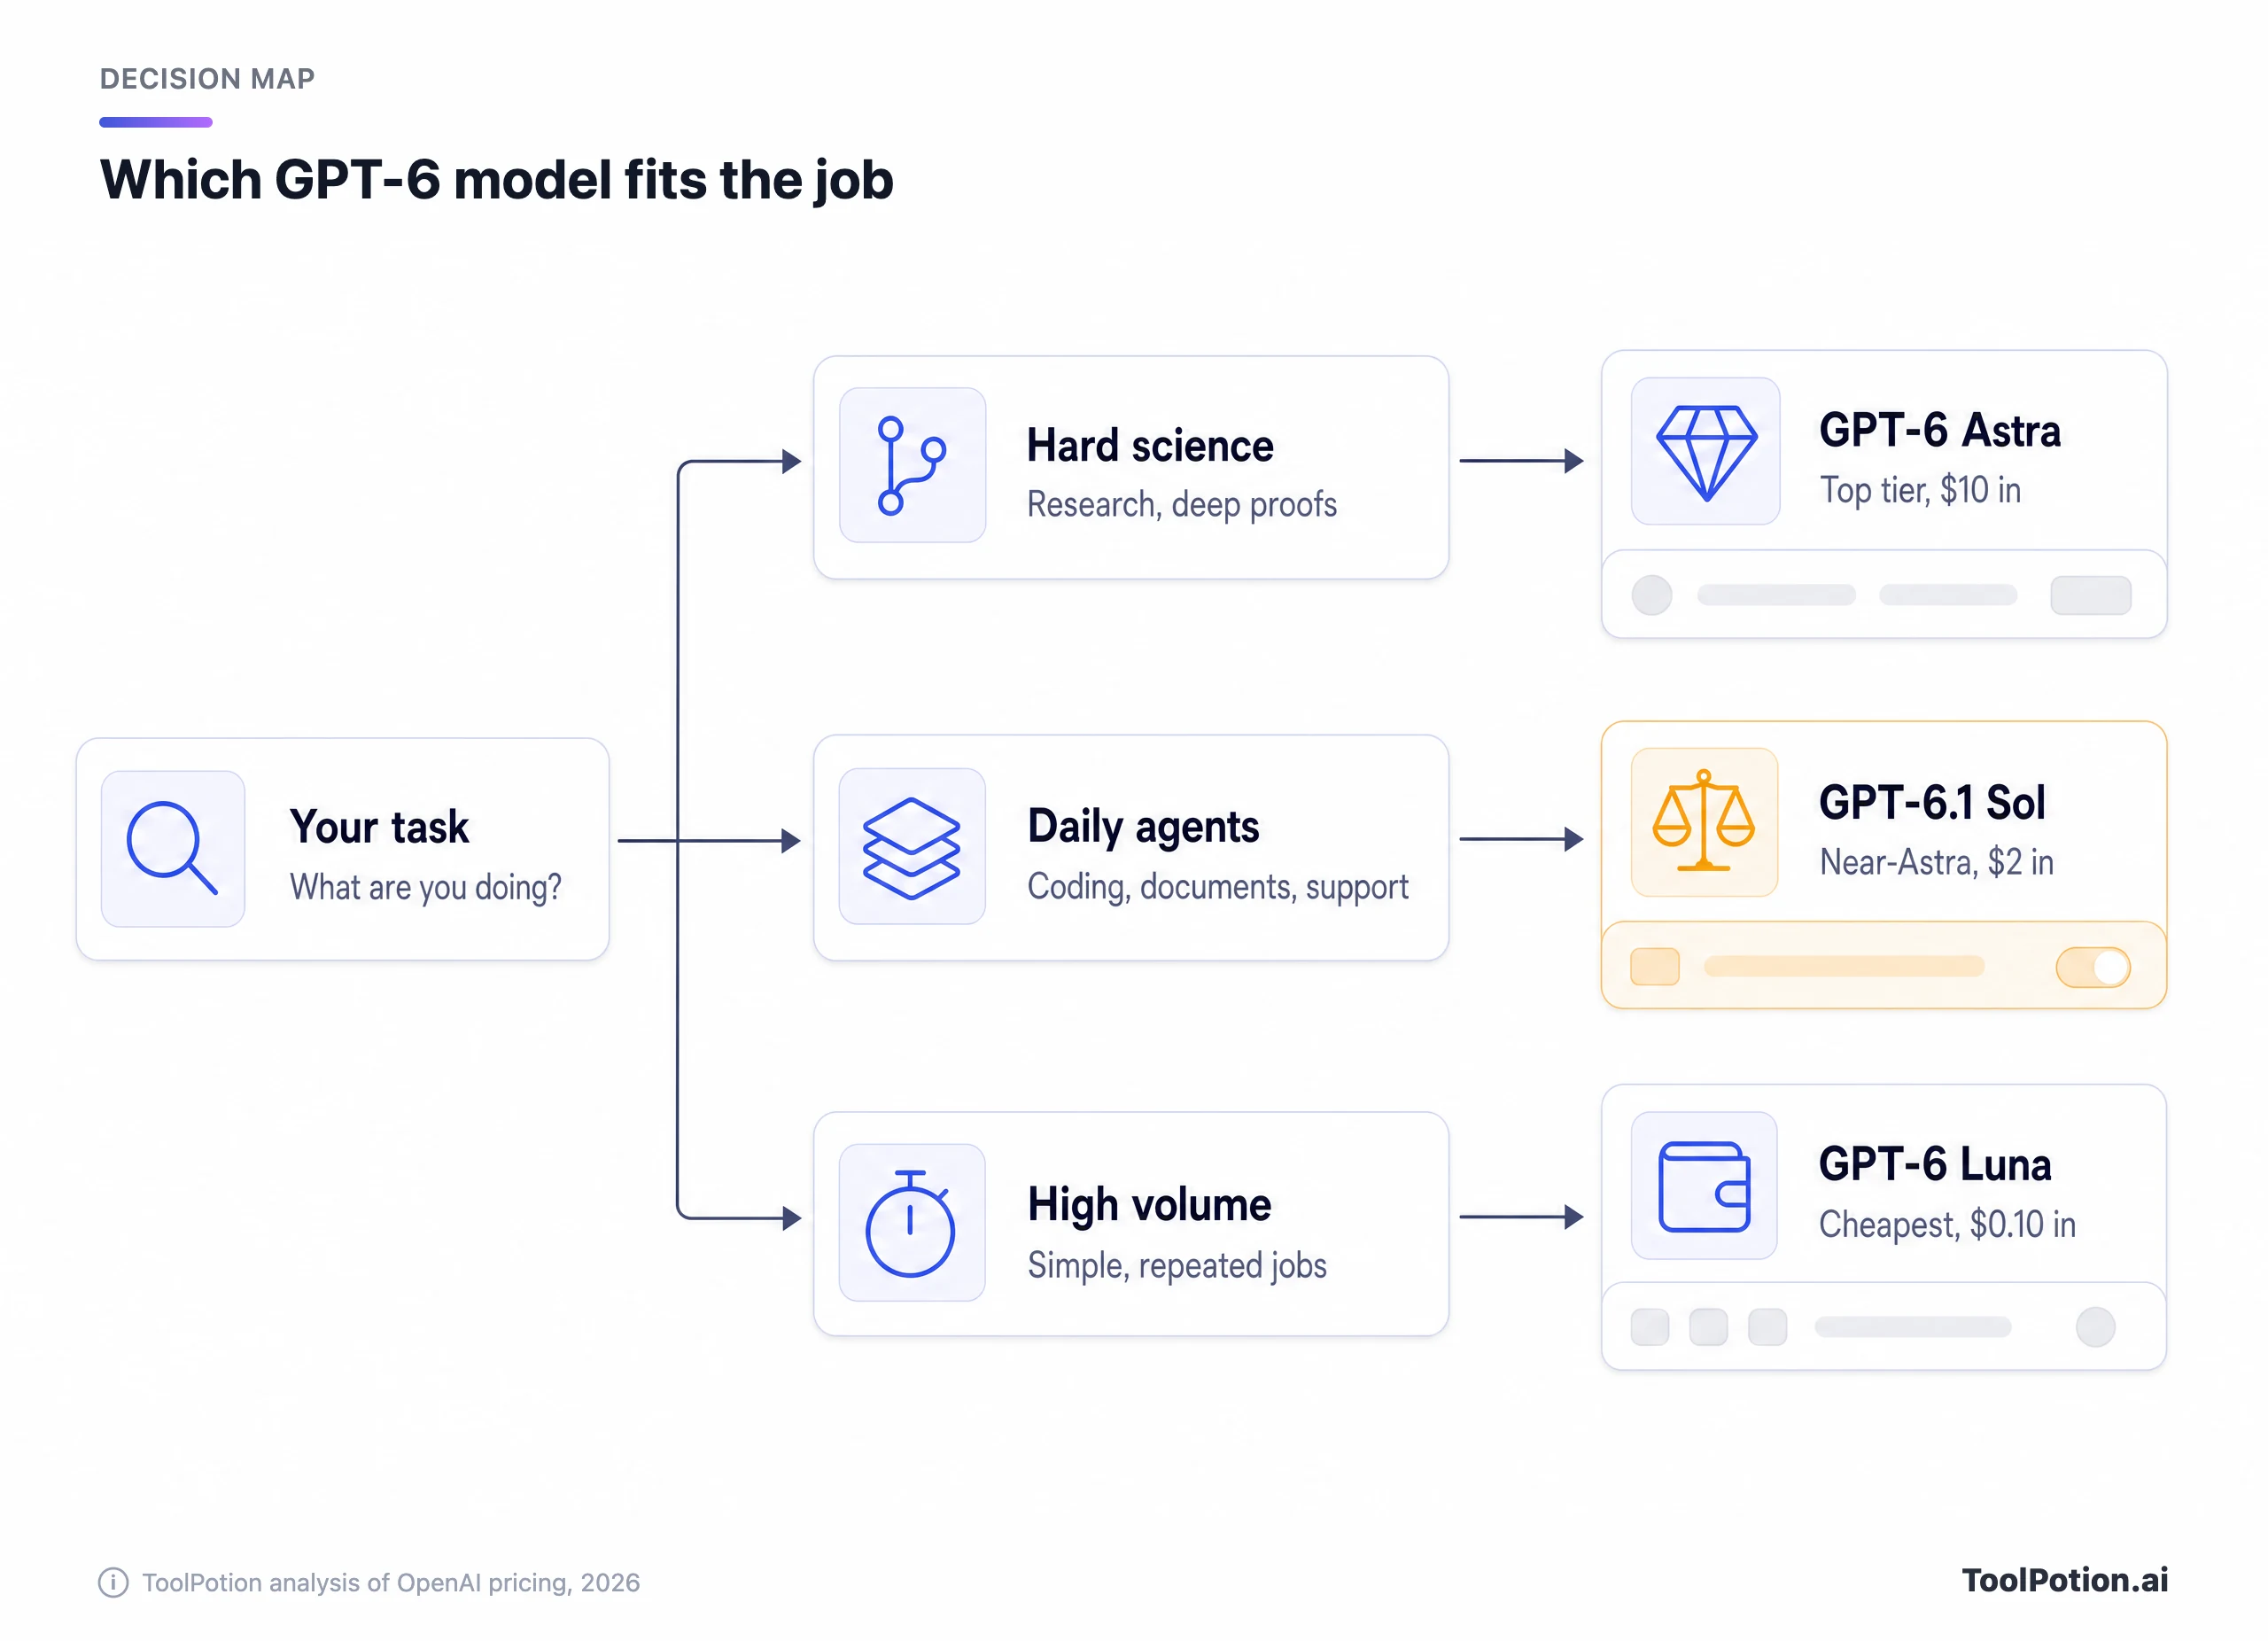
根据这些证据,一个合理的经验法则是:日常 agent 工作默认用 Sol,打标签、路由、信息提取这类简单重复的任务降到 Luna,只有在用你自己的样例做正面对比、发现差距值得付费时,才换到 Astra。用下面的小工具快速检查一下。
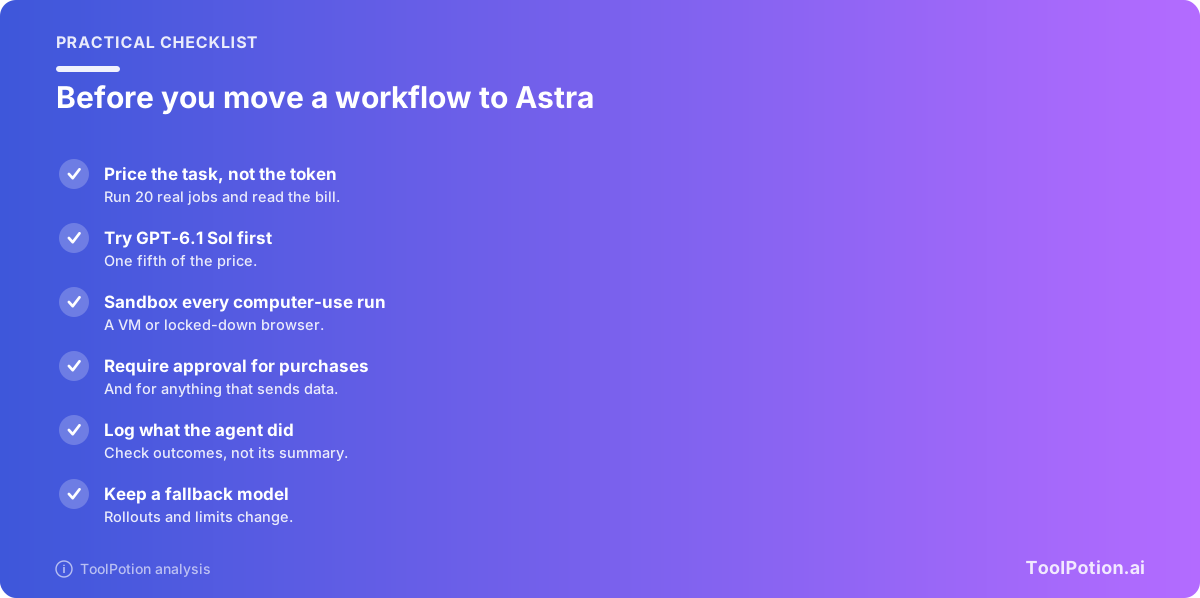
如果你在做产品,成本最低的实验是拿二十个真实任务分别跑 Sol 和 Astra,然后比较成功率和实际账单。二十个任务只花几美元,比任何图表都更能说明问题。
对 Plus 及以上的 ChatGPT 用户来说,实际问题要小得多。你的套餐里已经包含 GPT-6 家族。日常聊天用默认模型,遇到默认模型总是做不好的那个任务时再试试 Astra。如果你在用其他生态,Claude 和 Google Gemini 与它处于同一档次,我们的 Top 25 LLMs 榜单也在持续追踪它们。
谁现在可以不用管它
Free 和 Go 用户完全可以忽略 Astra,因为这些套餐里没有它。用 ChatGPT 写邮件、做摘要、头脑风暴和辅导作业的人,不会看到值得追逐的差别。收益体现在长时间、重度使用工具的工作上。
已经深度使用其他技术栈的团队没什么理由迁移。Anthropic 的 Claude Fable 5.1 在某些版本的 Artificial Analysis 指数上得分高于 Astra,编码团队也会在自己的代码库上对比 Codex in ChatGPT 和 Claude Code,而不是看发布时的图表。处理受监管数据的公司,在放手让 agent 操作线上系统之前,应该先读一读上面的安全限制。
现在值得试的人:正在运行多步骤 agent 但总是中途失败的开发者、整天泡在表格和文档里的分析师,以及电脑操作试点因为可靠性问题夭折的人。对他们来说,重新测试 Astra 或 Sol 很合理。想看更广泛的选择,请参阅 Top 20 AI 模型与 LLM 榜单和我们的 2026 年 AI 模型与 LLM 指南。如果需要对比参照,GPT-5.5 等更早的 OpenAI 模型仍然在列,其余选择见我们的 ChatGPT 替代品文章。
还有一个客户案例可以看。我们的目录里有一篇 Perplexity x GPT-6 Astra 案例研究,讲的是一家搜索公司如何描述自己使用这个模型的情况。
常见问题
GPT-6 Astra 在 ChatGPT 里免费吗?
不免费。OpenAI 的套餐表把 Astra 列在 Plus、Pro、Business 和 Enterprise 下,Free 和 Go 不包含。Free 用户的文本聊天用的是 GPT-5.6 Luna。
GPT-6 Astra 和 GPT-6.1 Sol 有什么区别?
Astra 是顶级档,每百万 token 输入 $10、输出 $50。Sol 的价格是 $2 和 $10,据 OpenAI 称,表现接近 Astra。两者的上下文窗口都是 105 万 token。Sol 更适合作为默认选择,Astra 留给最难的工作。
我能在 API 里用 Astra 吗?价格是多少?
可以。标价是每百万输入 token $10、每百万输出 token $50,缓存输入 $1。Batch 减半,Fast 模式加倍。输入超过 27.2 万 token 会更贵,为输入 $20、输出 $75。
Astra 比 Claude 强吗?
看测试。在 Artificial Analysis 指数 v4.2 上,Claude Fable 5.1 得分更高;在更新的 v4.3 上,两者并列第一。在 OpenAI 报告的 agent 和电脑操作基准上,Astra 领先 Claude Opus 5。厂商图表和独立指数并不总是一致,所以请在你自己的工作上测试。
让 Astra 控制我的电脑安全吗?
只有在有防护措施的前提下。OpenAI 自己的指南说要在沙盒里运行,购买和发送数据需要批准,并把屏幕上的文字当作不可信内容。OpenAI 还报告称,Astra 的推理比 GPT-5.6 Sol 更难监控。
为什么不同来源的 ARC-AGI-3 分数差这么多?
测试设置不同。OpenAI 的 99.9% 来自 ARC Prize 的 Provider Adapter 设置,它会在请求之间保留推理状态。ARC Prize 的标准设置得分是 62.7%。模型是同一个,只是外面的脚手架不一样。