

2026 年,对大多数开发者来说,真正的选择是在 Claude Code 和 Codex 之间,而在终端任务最难的公开基准上,两者的差距还在误差范围之内。Gemini CLI 是去年每篇对比里的第三号选手,如今免费用户和个人用户已经用不上了:今年早些时候,Google 用一款闭源工具 Antigravity CLI 取代了它。
这让选择的逻辑变了。前两名每次发版都在轮流领先,所以模型质量很难作为决胜因素。如今真正拉开差距的,是 agent 在你机器上不经询问能做什么、你怎么付费,以及团队负责人能不能同时管住这两件事。Codex 的默认设置最安全,客户端也是开源的。Claude Code 的工具链最深,适合想自己写脚本、做扩展的团队。GitHub Copilot 的 CLI 适合已经深度使用 GitHub、想把多家实验室的模型放在一张账单上的组织;如果你想要开源,并且想用任意模型,选 OpenCode。
下面的价格和功能均来自厂商文档与定价页,每个基准数据都会标明来源。
今年终端 Agent 发生了什么变化
如果你上次关注这个品类是一年前,有四个变化值得知道。
Google 对大多数人停用了 Gemini CLI。在 Google I/O 上,Google 宣布 Gemini CLI 将停止为免费用户以及 Google AI Pro 和 Ultra 订阅用户提供服务,其 IDE 扩展也在同一天关闭(Google Developers Blog)。接替它的 Antigravity CLI 用 Go 编写,与 Google 新推出的 Antigravity 2.0 桌面应用运行在同一套 agent 底座上。使用 Gemini Code Assist Standard 或 Enterprise 的组织,以及通过 Gemini API key 付费的开发者,仍可继续使用 Gemini CLI。
GitHub 让 Copilot CLI 正式发布(GA),随后把所有 Copilot 套餐都改成了按用量计费的 AI credits,因此终端会话现在要消耗一份计量额度,每个 credit 价值 $0.01(GitHub Docs)。
Anthropic 改变了你打开会话时的行为。从 Claude Code v2.1.283 起,交互式终端会话默认进入 auto 模式:由第二个模型(Anthropic 称之为 classifier)来审查各项操作,而不是每一步都问你(Claude Code docs)。
OpenAI 本周更新了 Codex CLI,新增语音控制、用于跟踪并行任务的 /agents 视图,以及可复用的云环境,团队可以用经过批准的设置和权限共享这些环境(TechCrunch)。与此同时,老牌开源选手 Aider 自今年年初的一次小补丁版本之后就再没发过新版,上一次功能更新还是去年的事(PyPI)。
所有终端 Agent 都在跑的同一个循环
撇开品牌包装,这些工具干的是同一件事。你用自然语言描述一个任务,agent 读取相关文件、起草方案、按需修改多个文件、运行构建和测试,遇到失败就反复迭代,直到能给你看一份 diff。
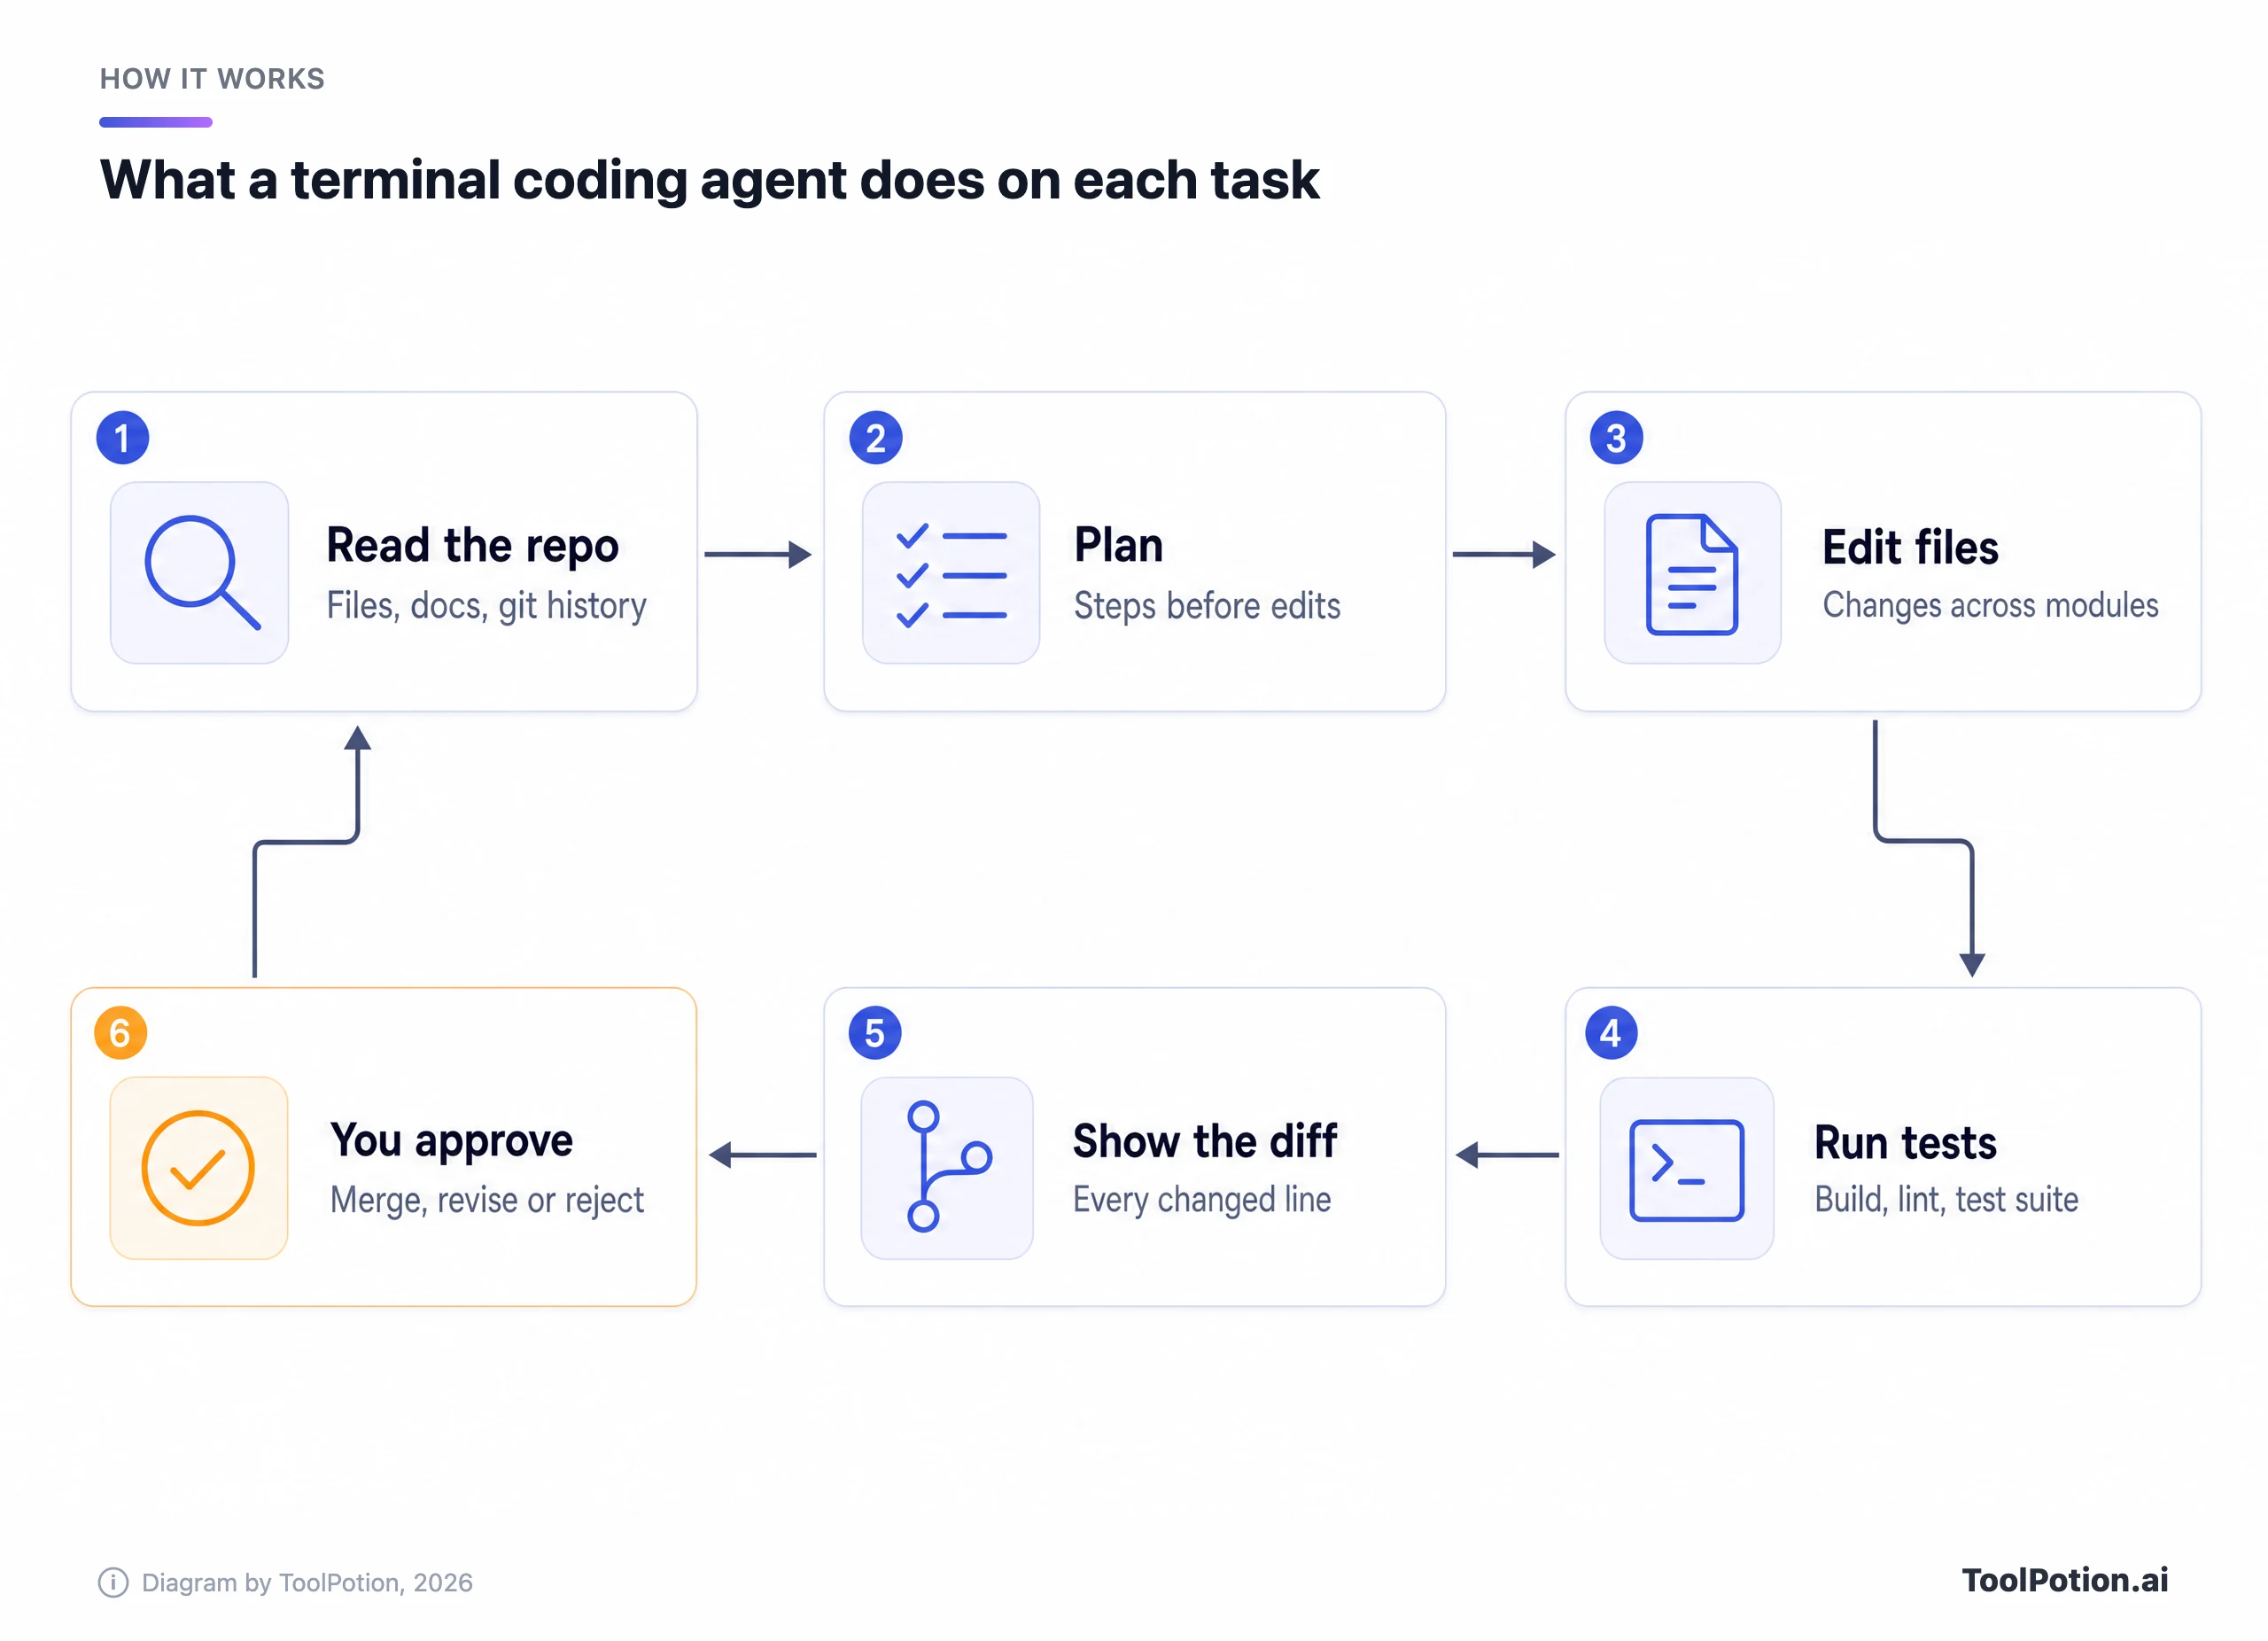
高亮的那一步是你要围绕它来设计流程的地方,因为审批环节承载着你的判断和安全策略。这些工具在循环周围有三处不同:由哪些模型驱动、批准之前 agent 能做什么,以及它跑在哪里(你的笔记本、操作系统沙箱,还是厂商的云端)。模型占据了大部分头条,但真正决定整个团队能不能用起来的是另外两点。
Claude Code vs Codex 正面对比
这两个成为默认选择是有道理的。它们都支持 macOS、Linux 和 Windows,都会读取 AGENTS.md 文件,都支持 MCP 服务器、skills、hooks、plugins 和 subagents,都能把任务推到云端,也都有每月 $20 的套餐。区别在细节里。
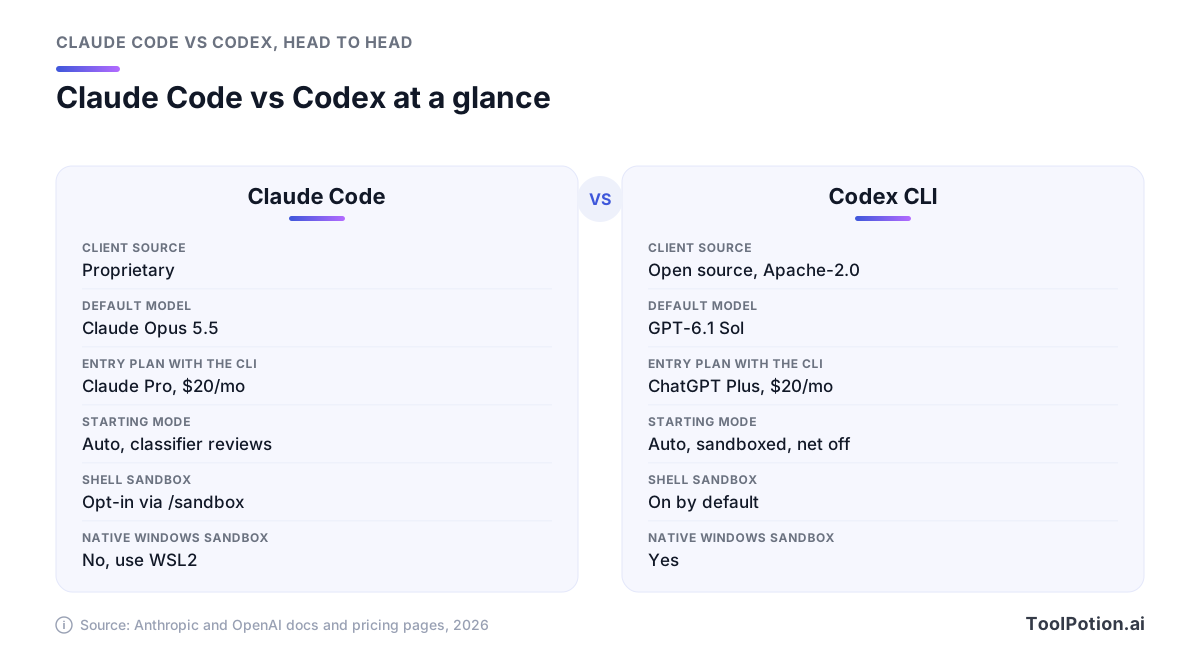
先看模型。Claude Code 只运行 Anthropic 自家的模型,所有套餐默认使用 Claude Opus 5.5,Sonnet 5.5 和 Haiku 是更便宜的选项,而 Claude Code 里能力最强的 Fable 5.1 需要你主动选择,部分套餐还会把它计入额外用量 credits。Codex 默认使用 GPT-6.1 Sol,OpenAI 称它在 agentic 编程上几乎追平旗舰 GPT-6 Astra,而 API 价格只有后者的五分之一。Codex 客户端以 Apache-2.0 协议开源(openai/codex 仓库用 Rust 编写),而 Claude Code 的许可是保留所有权利。
安全默认值的差异更明显。在 git 仓库里,Codex 会以一个叫 Auto 的预设启动:它可以在工作区内读取、编辑文件和运行命令,但操作系统沙箱(macOS 用 Seatbelt,Linux 用 bubblewrap 加 seccomp,Windows 用原生沙箱)会阻止网络访问和项目之外的一切操作,直到你批准(OpenAI docs)。在 git 仓库之外,它会退回到只读模式。
Claude Code 走的是另一条路。它的 shell 沙箱默认关闭,第一道防线是 auto 模式的 classifier 加上 deny 规则,后者在所有模式下都会拦截。就算你把沙箱打开,它也只包裹 shell 命令,而且在你添加 deny 规则之前,沙箱内的命令仍然可以读取机器上的大部分内容,包括 ~/.ssh 和 ~/.aws/credentials(Claude Code docs)。在原生 Windows 上完全没有沙箱,Anthropic 建议你用 WSL2。
Claude Code 胜在深度。Plugins 把 skills、subagents、hooks 和 MCP 服务器打包在一起,可以从管理员能设置白名单或黑名单的市场安装。Routines 在 Anthropic 的云端运行定时任务,GitHub Actions 和 GitLab CI/CD 集成负责代码审查和分流,Agent SDK 则让你基于同一套工具构建自己的 agent。Codex 用更少的繁文缛节覆盖了大部分相同的能力(hooks、skills、plugins、用于脚本的 codex exec、一个 GitHub Action),它的自动代码审查覆盖 GitHub 的 pull request 和 GitLab 的 merge request。
那么各自最弱的地方在哪?Claude Code 把你绑在一家实验室上,而且在你修改设置之前,依赖的是模型的判断,而不是操作系统层面的边界,有些安全团队不会接受这一点。Codex 同样绑定一家实验室,而且 $20 套餐上的旗舰模型被限制得很紧:OpenAI 估计 Plus 用户每五小时使用 GPT-6 Astra 只有 5 到 45 条本地消息,而使用 GPT-6.1 Sol 则是 15 到 160 条(OpenAI pricing)。
对大多数人来说,Antigravity CLI 取代了 Gemini CLI
现在搜索 Gemini CLI,你仍能找到那个 Apache-2.0 仓库,它还在持续发版(v0.62.0 就在本周发布)。不过它的文档现在顶部挂着一条横幅,告诉免费用户和 Google One 用户 Gemini CLI 已被取代。还能继续用的是持有 Gemini Code Assist Standard 或 Enterprise 许可的组织,以及使用付费 Gemini 或 Gemini Enterprise Agent Platform API key 的开发者。
在 Google Antigravity 里接替它的那个 CLI,是另一种产品。它是闭源的,Tech Times 报道称其公开仓库里根本没有源代码,对一个按 Google 自己的说法合并过 6,000 个 pull request 的项目来说,这是个痛点。Google 承认目前还没有做到功能 1:1 对等,不过 skills、hooks、subagents 和扩展(现在叫 plugins)都已迁移过来。
它也有实实在在的好处。Antigravity 的模型菜单里,Gemini 3.8 Flash 和 Gemini 3.1 Pro 与 Claude Sonnet 5.5、Claude Opus 5.5 以及开放权重的 GPT-OSS-120b 并列,所以一份 Google 订阅就能用到两家实验室的模型,不过具体可用情况因套餐档位而异。它在 macOS 和 Linux 上的默认预设,纸面上至少和 Codex 一样严格:终端命令在无网络的沙箱里运行,文件访问止于工作区和临时目录,~/.ssh 和 .env 文件被屏蔽,MCP 和网页操作要先询问(Antigravity docs)。在 Windows 上,这个沙箱默认是关闭的。
额度是个坑。免费的 Individual 档只列出了基础的每周速率限制,和 Gemini CLI 过去给个人账号的每天 1,000 次免费请求相差甚远。付费额度挂在 Google AI Pro 和 Ultra 套餐上,而 Google 在 Antigravity 上线时重新调整了这些档位,所以下单前请到 Google 自己的套餐页确认最新限制。如果你常驻 Google Cloud、想用 Claude 模型又不想单独签 Anthropic 合同,或者想要开箱即用的严格沙箱默认值,就选 Antigravity CLI。如果你在意客户端开源,就跳过它。
Copilot CLI、Cursor、OpenCode 及其他
对企业来说,Copilot CLI 是最被低估的选项。它在一张账单下运行 Anthropic、OpenAI 和 Google 的模型,而且具备现代化的整套功能:plan 模式、autopilot 模式、用于探索和审查代码的内置 agent、MCP、plugins、skills、hooks,以及一个 & 前缀,可以把任务交给 GitHub 的云端编程 agent(GitHub Changelog)。每个套餐都包含它:Free、每月 $10 的 Pro、$39 的 Pro+ 和 $100 的 Max,另有每席位 $19 的 Business 和 $39 的 Enterprise(GitHub Docs)。
它的弱点在权限。Copilot 会先让你信任一个文件夹,然后逐个工具批准,或对整个会话批准,GitHub 自己的文档就警告说,为某个会话批准 rm 后,它可以不经询问删除该目录树下的任何文件。本地沙箱需要通过 /sandbox enable 手动开启,而 --yolo 参数会把所有检查全部关掉。
下面是四个最大的名字的对比,用的是你能在文档和许可证里核实的属性,而不是它们的营销话术。
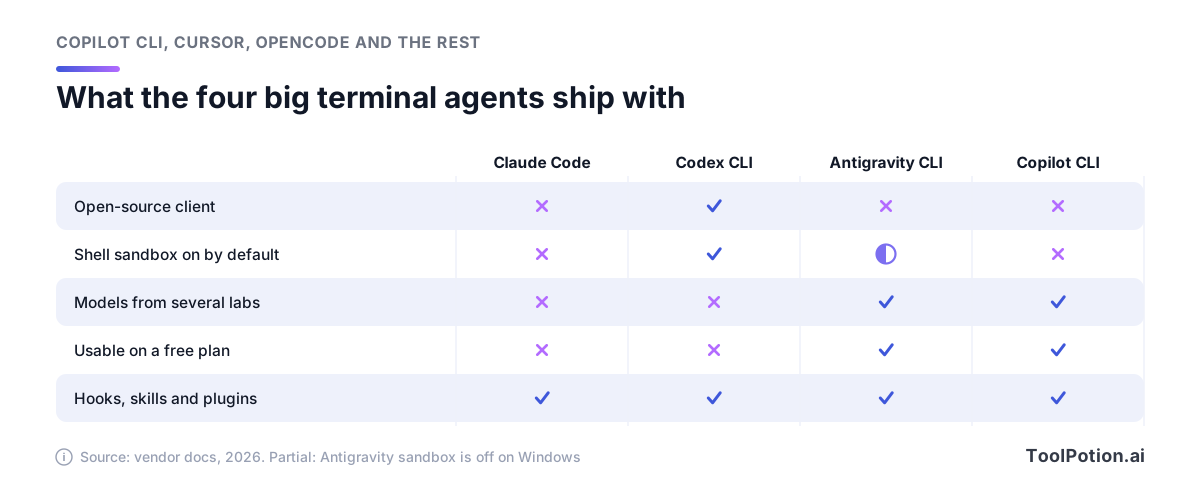
只有 Codex 把开源客户端和处处默认开启的沙箱结合在了一起。Antigravity 和 Copilot 是两个无需额外折腾就能混用各家实验室模型的工具。扩展性已经趋同,四者都支持 hooks、skills 和 plugins。
Cursor 把它的编辑器 agent 带到了终端,提供 agent、plan 和 ask 模式,有适用于脚本和 CI 的 print 模式,以及同样的 & 云端 agent 交接。如果你的团队已经在为 Cursor 付费(Individual 每月 $20 起,Teams 每用户 $40),它是顺理成章的补充;如果没有,就很难说服人。
OpenCode 是开源阵营里的佼佼者:MIT 许可,GitHub star 超过 211,000,接入了 75 个以上的模型提供商,包括本地模型。你可以直接用 GitHub Copilot 或 ChatGPT Plus、Pro 账号登录,不必重复付费。不过要留意它的默认设置。除非你自己写规则,OpenCode 会让 agent 不经询问就编辑文件、运行 shell 命令,它没有操作系统沙箱,内置的防护只覆盖 .env 文件、项目之外的路径,以及 agent 陷入重复循环的情况(OpenCode docs)。
还有三个值得各写一句。Amp 按提供商的价格透传模型成本,对个人用户不加价,底层混用 GPT-5.6 和 Claude Fable 5.1,有免费档和 $20 的套餐。Warp 现在是一个 AGPL 许可的 agentic 终端,带有自己的 agent,价格从免费到 $20 的 Build 和 $200 的 Max,并称它可以配合任何支持 MCP 的编程 agent 使用。Aider 的 git 体验依然最干净,每次改动都会提交,提交信息清楚,可以 diff 也可以撤销,但它的发版节奏已经停滞,所以在选用之前先确认它是否支持你想用的模型。想了解更广泛的选择,我们的 AI 编程助手榜单和 AI agent 榜单会随排名变化持续更新。
基准测试里,Claude Code 和 Codex 打成平手
这个品类里最有用的公开衡量标准是 Terminal-Bench,由 Stanford、Harbor 和 Laude Institute 主办,它在真实终端里用高难度任务给 agent 与模型的组合打分。在当前的 4.0 排行榜上,Codex 搭配 GPT-6 Astra、最高推理强度(max)以 58.2% 领先,Claude Code 搭配 Fable 5.1、max 强度为 57.9%(Terminal-Bench)。每个条目跑了 330 次试验,置信区间上下大约三个百分点,所以可以算平手。
更值得关注的是强度这个旋钮。把每一组在最低和最高推理设置下的成绩对比一下。
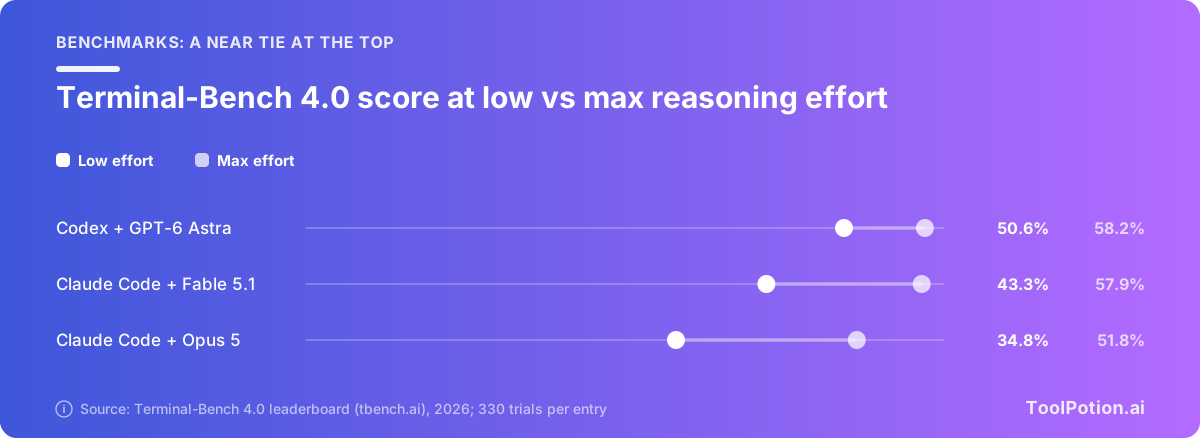
从 max 降到 low 强度,Codex 搭配 Astra 损失不到 8 个百分点,Claude Code 搭配 Fable 5.1 则损失近 15 个百分点。搭配较老的 Opus 5 的 Claude Code 掉了 17 个百分点。你留在默认值的那个设置,影响可能不亚于盒子上印的品牌。
成本讲的是另一个故事。排行榜记录了每次运行的花费:Codex 搭配 Astra 在 max 强度下是 $3,267,而 Claude Code 搭配 Fable 5.1 是 $6,244,分数相同,每个任务大约是 $9.90 对 $18.90。这些是长时间高难度任务按 API 费率计算的成本,不是订阅用户实际付的钱。榜单上根本没有 Google 的 agent,所以运行 Gemini 模型的最佳条目是一个第三方 agent 搭配 Gemini 3.8 Flash,得分 19.1%。至于厂商的说法,比如 Anthropic 称 Sonnet 5.5 在 agentic 编程上胜过 Opus 5.5,都来自厂商自己的测试。
权限模式:从只读到全自动
如今每个工具都提供了同一套自主程度的阶梯,只是叫法不同。你选哪一级,决定了你被打断的频率,也决定了一条糟糕的指令(或藏在 README 里的 prompt injection)能造成多大破坏。
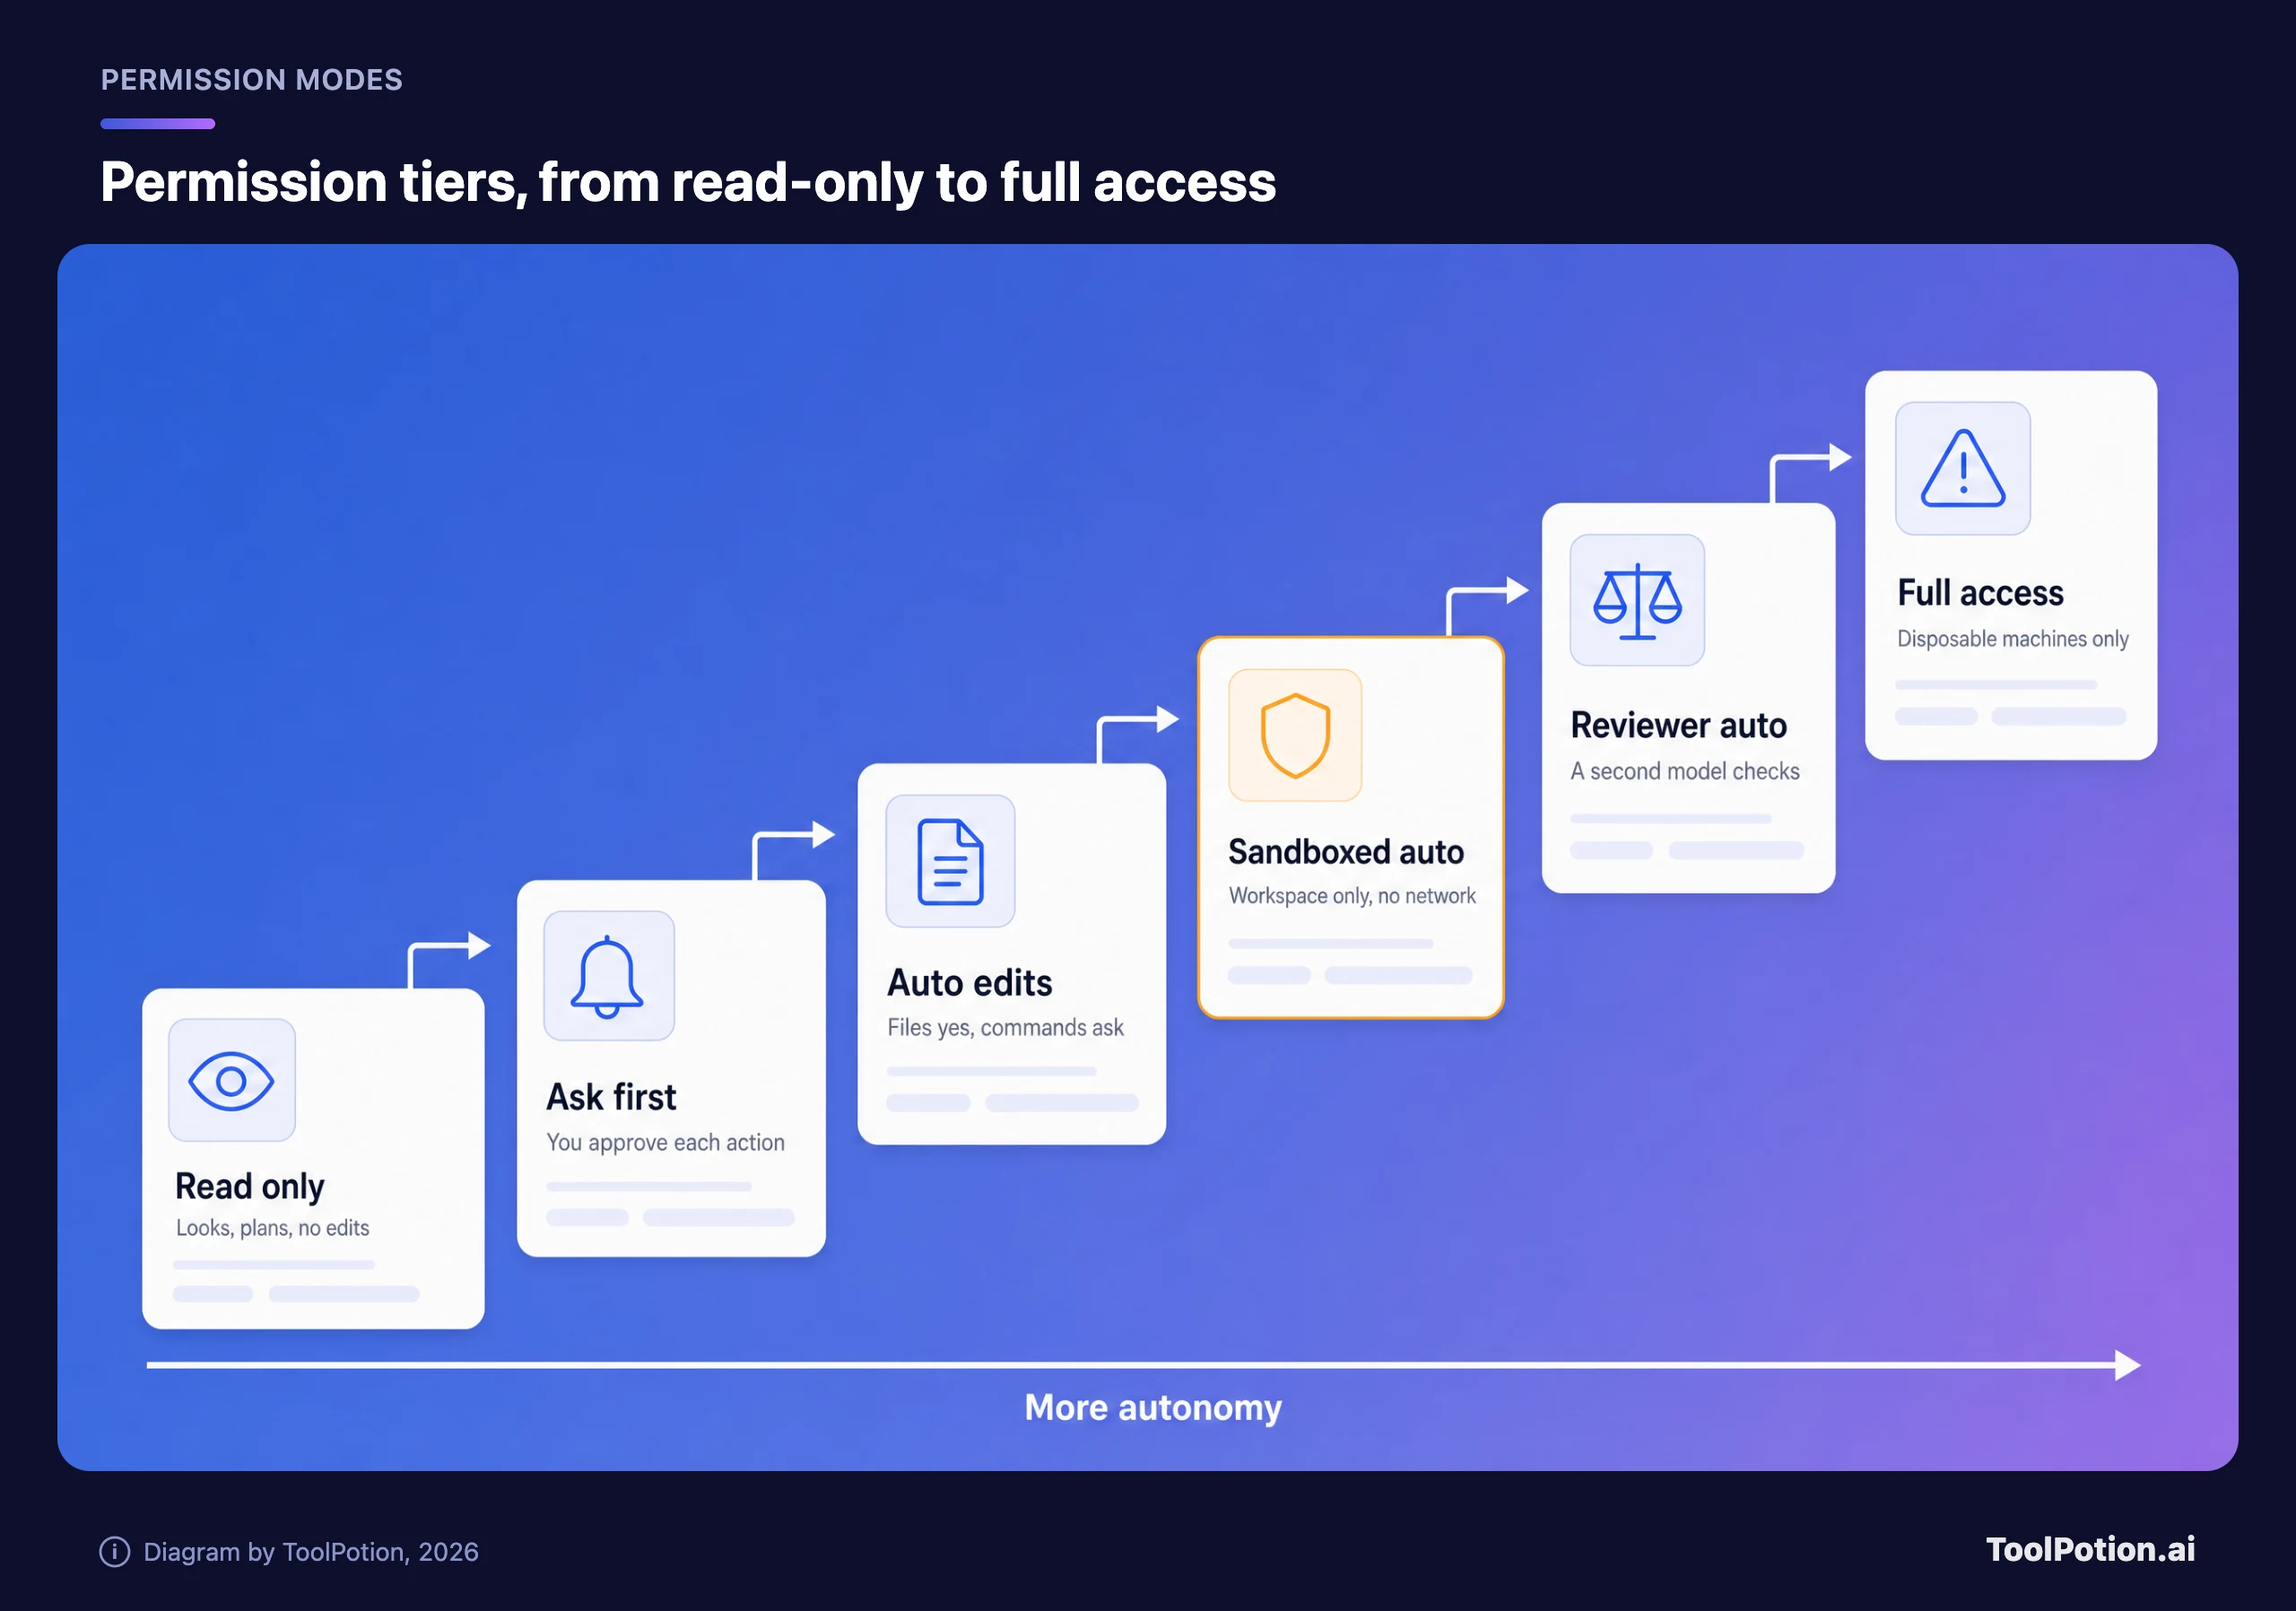
沙箱 auto 才是合适的日常默认值。agent 可以在项目内自由编辑和运行命令,没有网络,也碰不到你的主目录。Reviewer auto 进一步减少了提示,但把判断交给了模型。完全访问应该只用在用后即弃的容器和虚拟机里,Anthropic 文档对 bypassPermissions 的说法也是如此。下面是这四个主要工具里各级的叫法。
| 级别 | Claude Code | Codex CLI | Antigravity CLI | Copilot CLI |
|---|---|---|---|---|
| 只读 | plan | read-only | Plan mode | Plan mode |
| 先询问 | default(Manual) | Granular approvals | Request Review | 逐工具提示 |
| 自动编辑 | acceptEdits | 无 | Accept-Edits | 对会话批准工具 |
| 沙箱 auto | /sandbox auto-allow | Auto(git 仓库中默认) | 默认预设 | /sandbox enable |
| Reviewer auto | auto(默认) | Auto-review(需手动开启) | 无 | 无 |
| 完全访问 | bypassPermissions | danger-full-access | Turbo | --yolo |
有两个默认值很突出。Codex 和 Antigravity 一上来就把你放进沙箱里,而 Claude Code 和 Copilot 一上来用的是依赖提示或模型审查的模式。如果你用 Claude Code,打开沙箱是你能做的最有用的一项设置改动。
套餐 vs API key:你要付多少钱
每家厂商都有两种入口。固定月费的套餐能给账单封顶,但会用五小时和每周限额来计量你的用量,厂商用倍数而不是 token 数来描述这些限额。API key 则按标价对每个 token 计费,没有上限。
| Agent | 入门套餐 | 更高档位 | 团队 |
|---|---|---|---|
| Claude Code | Claude Pro,$20/月(按年付费 $17) | Max 5x $100,Max 20x $200 | Team 席位 $25 或 $125/月;Enterprise $20 席位加 API 费率用量 |
| Codex | ChatGPT Plus,$20/月(Free 和 Go 不含 CLI) | Pro $100、$200 或 $500 | Business $20/用户(按年) |
| Copilot CLI | Pro $10/月(Free 有少量额度) | Pro+ $39,Max $100 | Business $19,Enterprise $39 每席位 |
| Antigravity CLI | 免费 Individual 档 | Google AI Pro 和 Ultra | Business 经 Google Cloud 购买,$30/席位起 |
| Cursor CLI | Individual $20/月 | 更高的个人档位 | Teams $40/用户 |
价格来自各厂商的定价页,包括 Anthropic 的定价页。如果套餐的账算不明白,可以看我们的 AI 工具定价模式指南,里面讲了 credits、席位和 token。
对重度用户和 CI 来说,API 路线最重要。Anthropic 对 Opus 5.5 每百万输入 token 收 $4、每百万输出 token 收 $20,Sonnet 5.5 是 $2 和 $10。OpenAI 对 GPT-6.1 Sol 收 $2 和 $10,GPT-6 Astra 收 $10 和 $50(OpenAI pricing)。缓存对账单的影响比标价更大,因为 agent 循环会不断重复发送相同的上下文。在上面的 Terminal-Bench 运行中,Codex 大约 96% 的输入 token 是缓存读取,OpenAI 对这部分按 Astra 输入价的十分之一计费。
在下面填入你自己的数字。默认值照搬了其中一个基准任务的 token 构成(在 Astra 上每个任务约 $10),而基准测试的任务又长又难,所以做预算之前,请换成你自己用量面板里的数据。
按默认值算,开发者每月用 Opus 5.5 跑 40 个这样的任务,通过 API key 大约花 $126,所以只要限额够用,Claude Pro 和 Max 5x 都更便宜。把模型换成 GPT-6 Astra,同样的工作量大约要 $401。这个差距就是为什么 Codex 用户应该把旗舰模型留给真正需要它的问题,其余的交给 GPT-6.1 Sol。
怎么选,怎么安全地落地
先看你的代码和合同已经在哪里,再用安全默认值来打破平局。
- 如果你的团队已经在为 ChatGPT 付费,或者想要默认开启沙箱的开源客户端,从 Codex 开始。
- 如果你想要最深的定制能力,而且用 Claude 模型用得顺手,选 Claude Code,并且先把它的沙箱打开。
- 如果你的组织基于 GitHub,想把 Claude、GPT 和 Gemini 模型放在同一份预算下并为每个用户设上限,Copilot CLI 的阻力最小。
- Google Cloud 用户应该试试 Antigravity CLI。
- 需要端到端开源或本地模型时选 OpenCode,同时接受护栏要自己写的事实。
还在犹豫?在下面按你看重的方面调整权重。这些分数是我们对各厂商文档和定价的编辑判断,不是测试结果。
把安全权重调到最高时,Codex 领先,Copilot CLI 排第二。把团队管理和支出上限提到最前,Copilot 会略微领先;把模型选择和开源拉满,则 OpenCode 排第一。只要扩展性比安全默认值更重要,Claude Code 的排名就会上升。
安全的团队落地方式
- 让少数几位开发者在同一个仓库上试点一个 agent,这样你比较的是结果,而不是工具。
- 集中设置权限默认值。在 Claude Code 里,这意味着用托管设置打开沙箱,并为 push 和部署设置 deny 规则,管理员还可以在整个组织范围内关闭 auto 模式。在 Codex 里,保持 workspace-write 并关闭网络,把 danger-full-access 留给一次性的 CI runner。
- 让密钥远离 agent。不要在持有生产凭证的 shell 里运行 agent,禁止读取 ~/.ssh、云凭证文件和 .env,并且记住 Claude Code 的 hooks 和本地 MCP 服务器是在沙箱之外、以你的完整权限运行的。
- 像审查新人的 pull request 一样审查 agent 的 diff。agent 可以开分支、提 PR,但合并要由人来做。像 Claude Code Security Review 或 Codex 的代码审查这样的自动审查工具是第二道检查,永远不能取代人工。
- 扩大规模之前先给支出封顶。Copilot 支持按用户和成本中心设置预算,而且它的额外用量默认是开启的,所以要么设上限,要么关掉。Anthropic 的 Enterprise 套餐在席位费之外按 API 费率计用量,Antigravity 的商业套餐则提供覆盖 API 和订阅用量的支出上限。
- 像审查依赖一样审查 plugins 和 MCP 服务器。Anthropic 的文档说,你安装的 plugin 会以你的用户权限运行代码,所以应该对市场设置白名单,而不是让每个人随便添加。
- 给 CI 一份精确的白名单。Claude Code 的 dontAsk 模式配合指定工具,或者 Codex 使用 read-only 或 workspace-write 沙箱,都能让无人值守的运行保持可预期。
如果你们已经在业务的其他部分运行 agent,会发现其中大部分内容在我们那篇 生产环境中的 AI agent 里似曾相识。想更全面地了解以编辑器为主的工具,请看我们的 AI 编程助手盘点。
常见问题
Gemini CLI 还能用吗?
能,前提是你所在的组织使用 Gemini Code Assist Standard 或 Enterprise,或者你用的是付费 Gemini API key。免费用户以及 Google AI Pro 和 Ultra 用户已被迁移到 Antigravity CLI。Apache-2.0 的代码仍留在 GitHub 上,所以任何人仍然可以 fork。
我能用 ChatGPT 订阅来跑 Claude Code,或者用 Claude 套餐来跑 Codex 吗?
不能。每个套餐只覆盖自家厂商的 agent。如果你想要一个跨厂商的客户端,OpenCode 可以用 ChatGPT Plus 或 Pro 以及 GitHub Copilot 账号登录,而 Copilot CLI 和 Antigravity CLI 则把多家实验室的模型打包进一份订阅。
独立开发者用哪款终端 agent 最便宜?
每月 $10 的 Copilot Pro 是最便宜的付费入口。$8 的 ChatGPT Go 不含 Codex CLI,要 Plus 才有。Copilot Free 和 Antigravity 的免费档不花钱,但额度很小。如果用量更大,把 $20 的 Claude Pro 和 ChatGPT Plus 与你预估的 API 账单比一比。
如果我每个 diff 都审查,还需要沙箱吗?
需要。审查 diff 能发现糟糕的代码,但那是在 agent 已经运行过命令之后。沙箱则是在这些命令运行时限制它们能碰什么,包括可能把密钥发到不该去的地方的网络调用。
Terminal-Bench 是选择工具的可靠依据吗?
它是衡量终端工作最好的公开标准,但它衡量的是 agent 与模型的组合在固定强度设置下处理高难度任务的表现。几个百分点的差距落在置信区间之内,所以应当视为平手,并在你自己的仓库上做一次简短的试点。