

存在某个平台里的 prompt 是一种隐患。它只活在一家厂商的界面里,别人看不到,产品一改名,它可能就消失了。skill 是同样的指令,外加触发条件、示例和负责人,存放在你自己掌控的文件夹里,这样的版本才留得住。
时间点很关键。Google 正在停用个人账号上的 Gemini Gems,并按计划在 2026 年晚些时候把它们转换成"skills",用户在任务对话里输入"/"就能调用(TechCrunch)。一天后,OpenAI 扩展了 ChatGPT 的 plugins,新增侧边栏入口、交互式面板和 Plugin Creator(TechCrunch)。自定义 GPT、Gems、plugins、apps 和 skills,说到底都是同一个念头:别再一遍遍重新输入指令了。
如果你已经建了几十个这样的助手,现在就有两件事要做:把已有的成果留住,并让它们足够可移植,这样下次改名只需要花一个下午,而不是一个季度。这篇指南会带你完成这两件事,包括模板、测试流程、迁移清单,以及一个直截了当的答案:什么时候不值得做。
为什么你保存的助手总在被改名
Gems 在 2024 年推出,定位是针对特定任务的助手,不用重复输入指令就能用,还可以分享。Google 自己的帮助页面现在写明,个人账号上的 Gems 将会下线,并自动过渡为 skills(Google Gemini Help)。TechCrunch 指出,自动迁移意味着用户无需任何操作;另外 skills 要用斜杠命令唤起,TechCrunch 称这是工程师更偏爱的交互方式。
自动迁移听起来很安全,就指令文本而言,基本确实如此。Google 说受支持的知识文件也会一并迁移,但 skill 上传只接受纯文本、PDF 和图片,不支持 Word 或 Excel 文件,而且它的过渡页面写明,共享功能和 Drive 关联文件要在未来几周才会到位(Gemini Help、上传规则)。迁移搬走的是内容,搬不走你只存在脑子里的示例,也搬不走团队里那个知道什么时候该用哪个 Gem 的人。
各家厂商都在重复这个套路。OpenAI 早先的分享形式是自定义 GPT,而它现在的开发者文档描述的是把 skills 和 MCP server 打包在一起的 plugins(OpenAI Developers)。Anthropic 的 skills 甚至在自家产品之间都不同步。按 Anthropic 的文档,上传到 claude.ai 的 skill 在 API 里用不了,Claude Code 的 skills 基于文件系统,与前两者也彼此独立(Claude docs)。要做好准备:任何平台都会把你存在那里的东西改名、合并或拆分。
skill 到底是什么,去掉营销话术
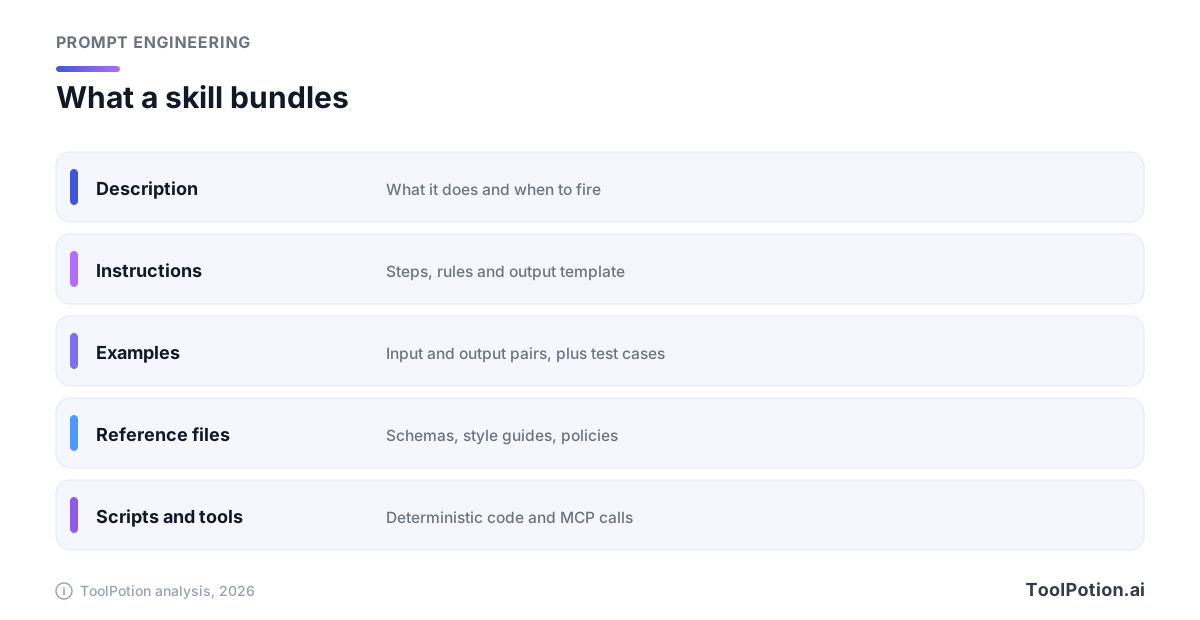
skill 就是一个文件夹。按 Anthropic 的定义,里面装着指令、脚本和资源,agent 可以针对具体任务发现并动态加载它们(Anthropic Engineering)。唯一必需的文件是 SKILL.md,开头是名称和描述,后面接着正文指令。
其中 description 最关键。启动时,助手只加载每个 skill 的名称和描述(据 Anthropic 说,每个大约 100 个 token),然后拿你的请求去匹配这段文字,决定要不要打开其余内容。描述太含糊,skill 永远不会触发;描述太贪心,什么请求都会触发。Anthropic 的建议是,既要写清 skill 做什么,也要写清什么时候用,并且用第三人称来写。
这正是保存下来的 prompt 缺少的第一样东西。prompt 要等你去粘贴,skill 有触发条件,助手不用你开口就能调用它。一个好 skill 的其他部分,都是从认真对待触发条件这一点延伸出来的。
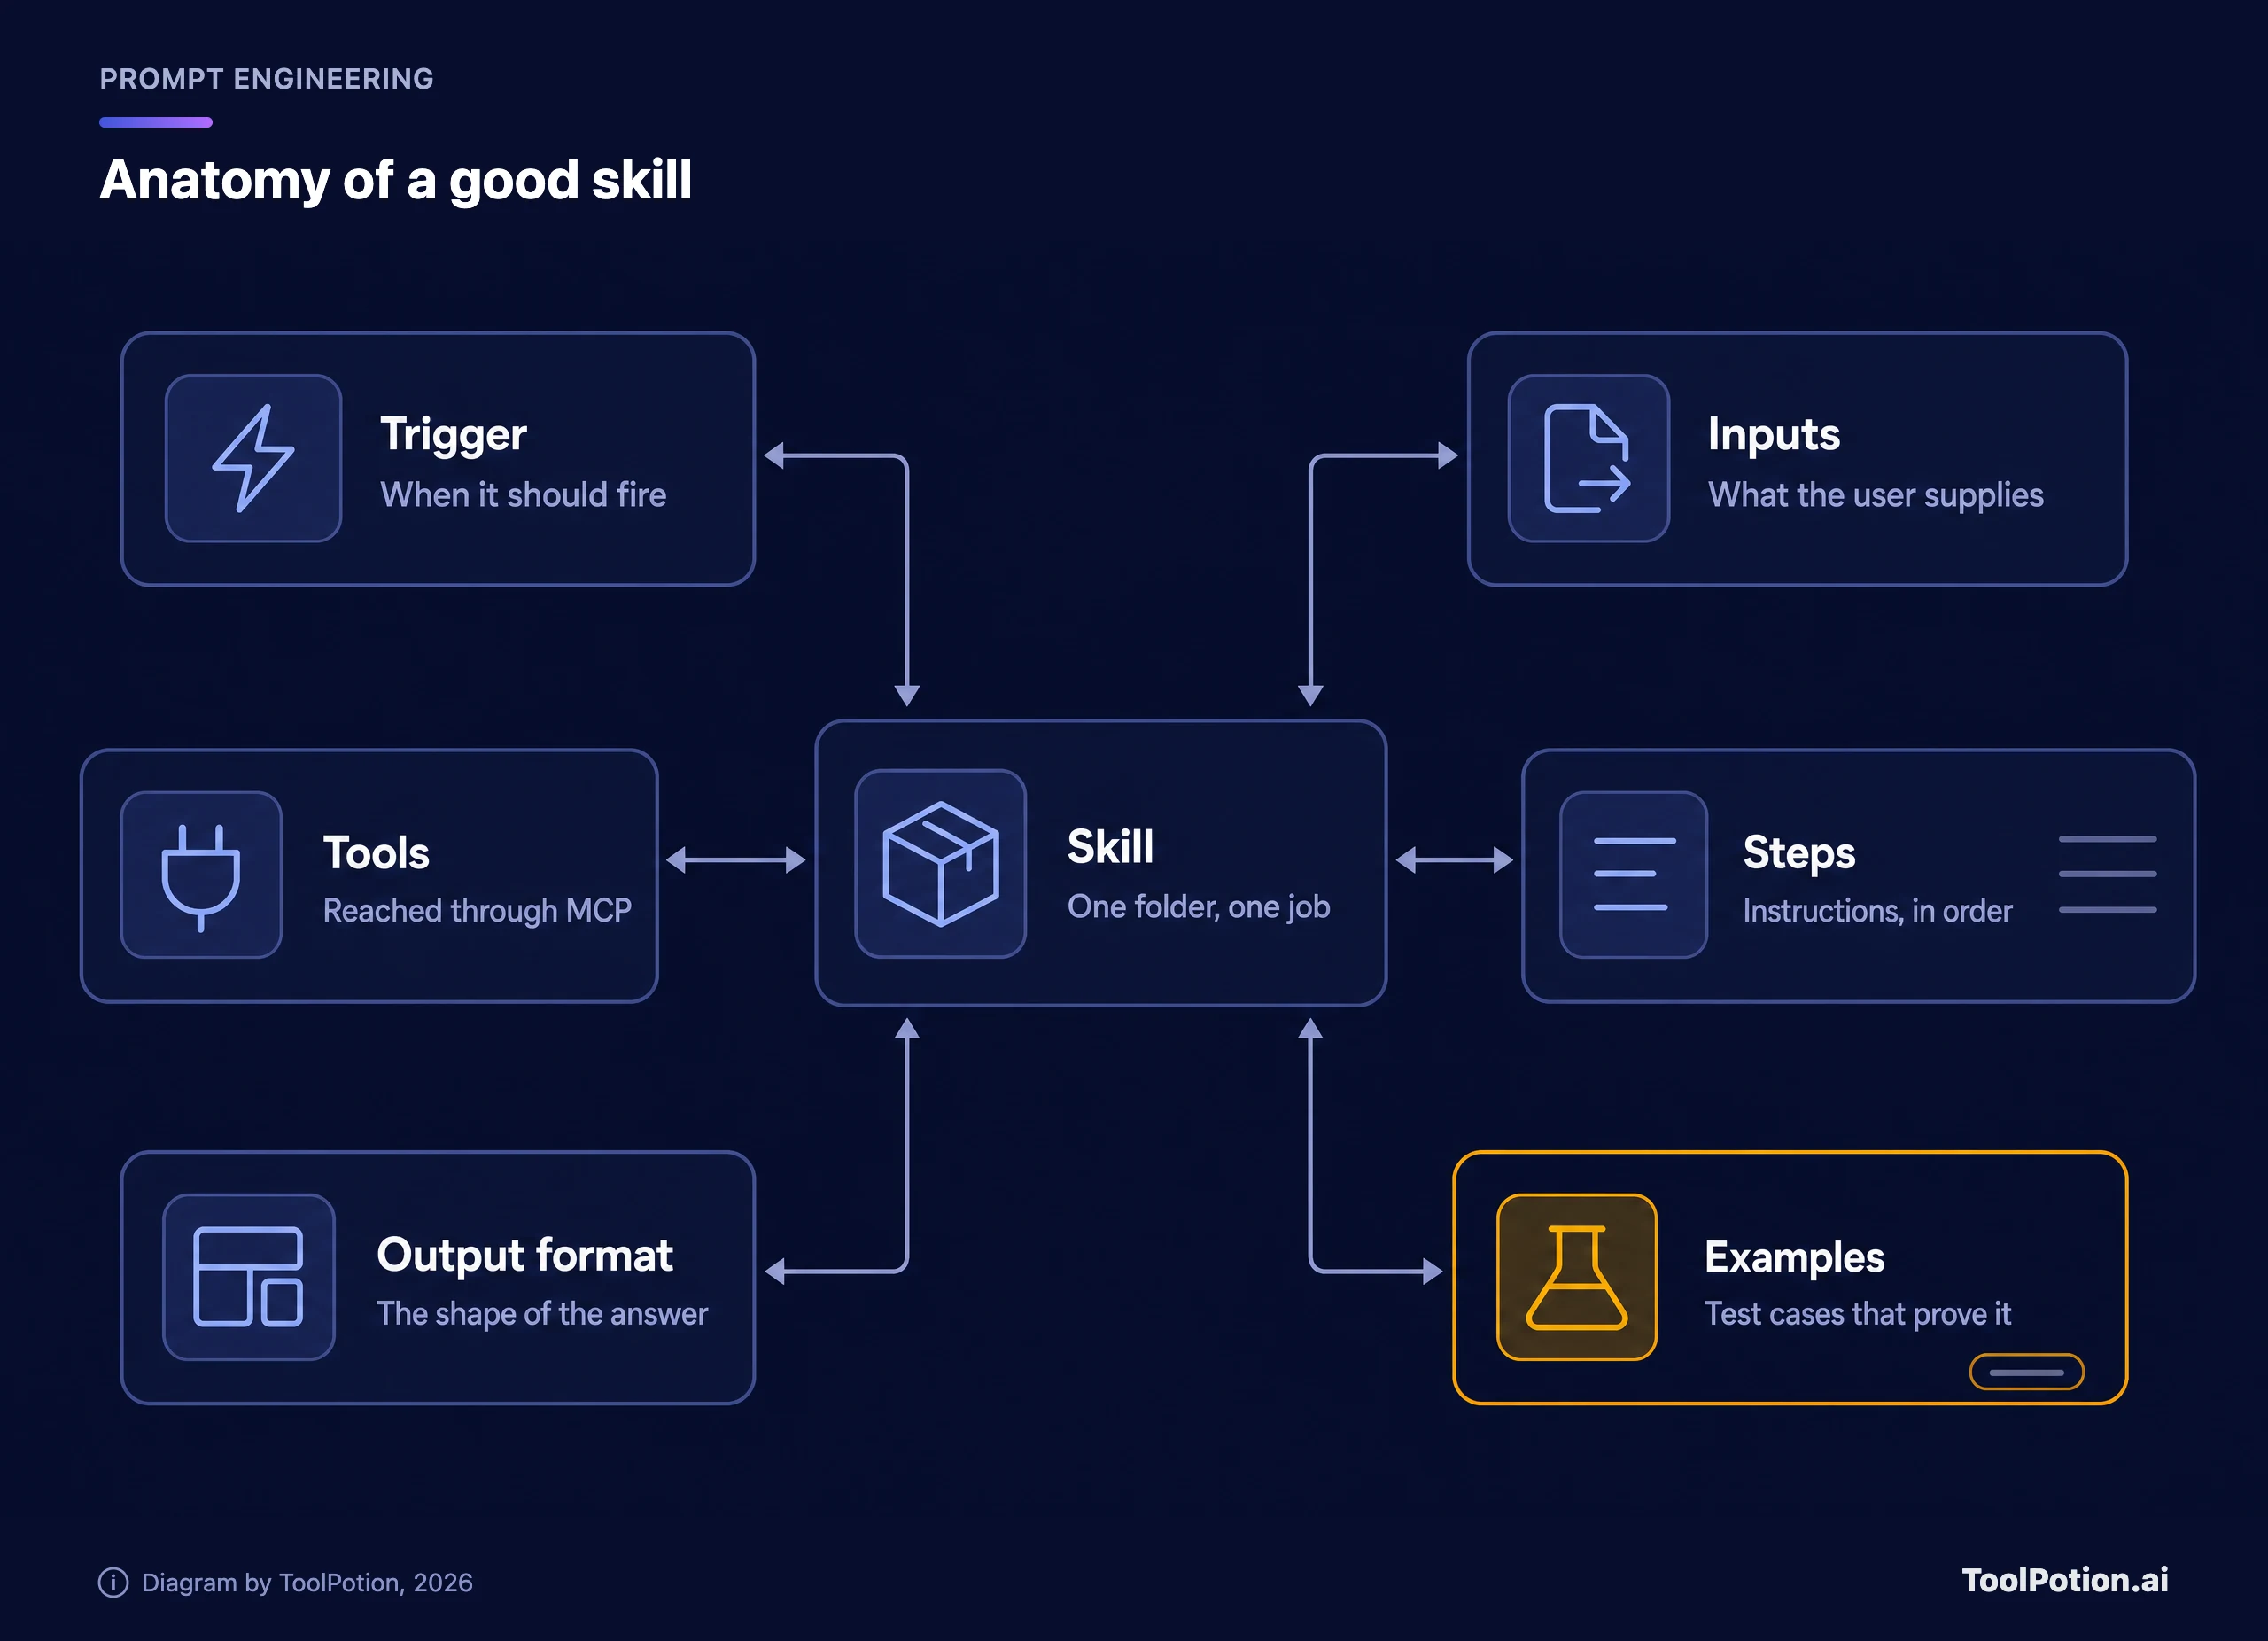
结构由六部分组成。触发条件说明何时触发。输入说明用户必须提供什么、哪些是可选的。步骤是按顺序写的指令。工具列出 skill 需要在对话之外调用的所有东西。示例把真实输入和被认可的输出并排展示。输出格式则固定答案的形态,这样多次运行的结果才有可比性。
示例最值得花功夫。它们一物两用:同样的输入输出对,既教助手理解你想要什么,也是告诉你某次修改有没有改坏东西的测试用例。省掉示例,你写出来的不过是放进文件夹里的 prompt。
Skills 正在收敛到同一种文件格式
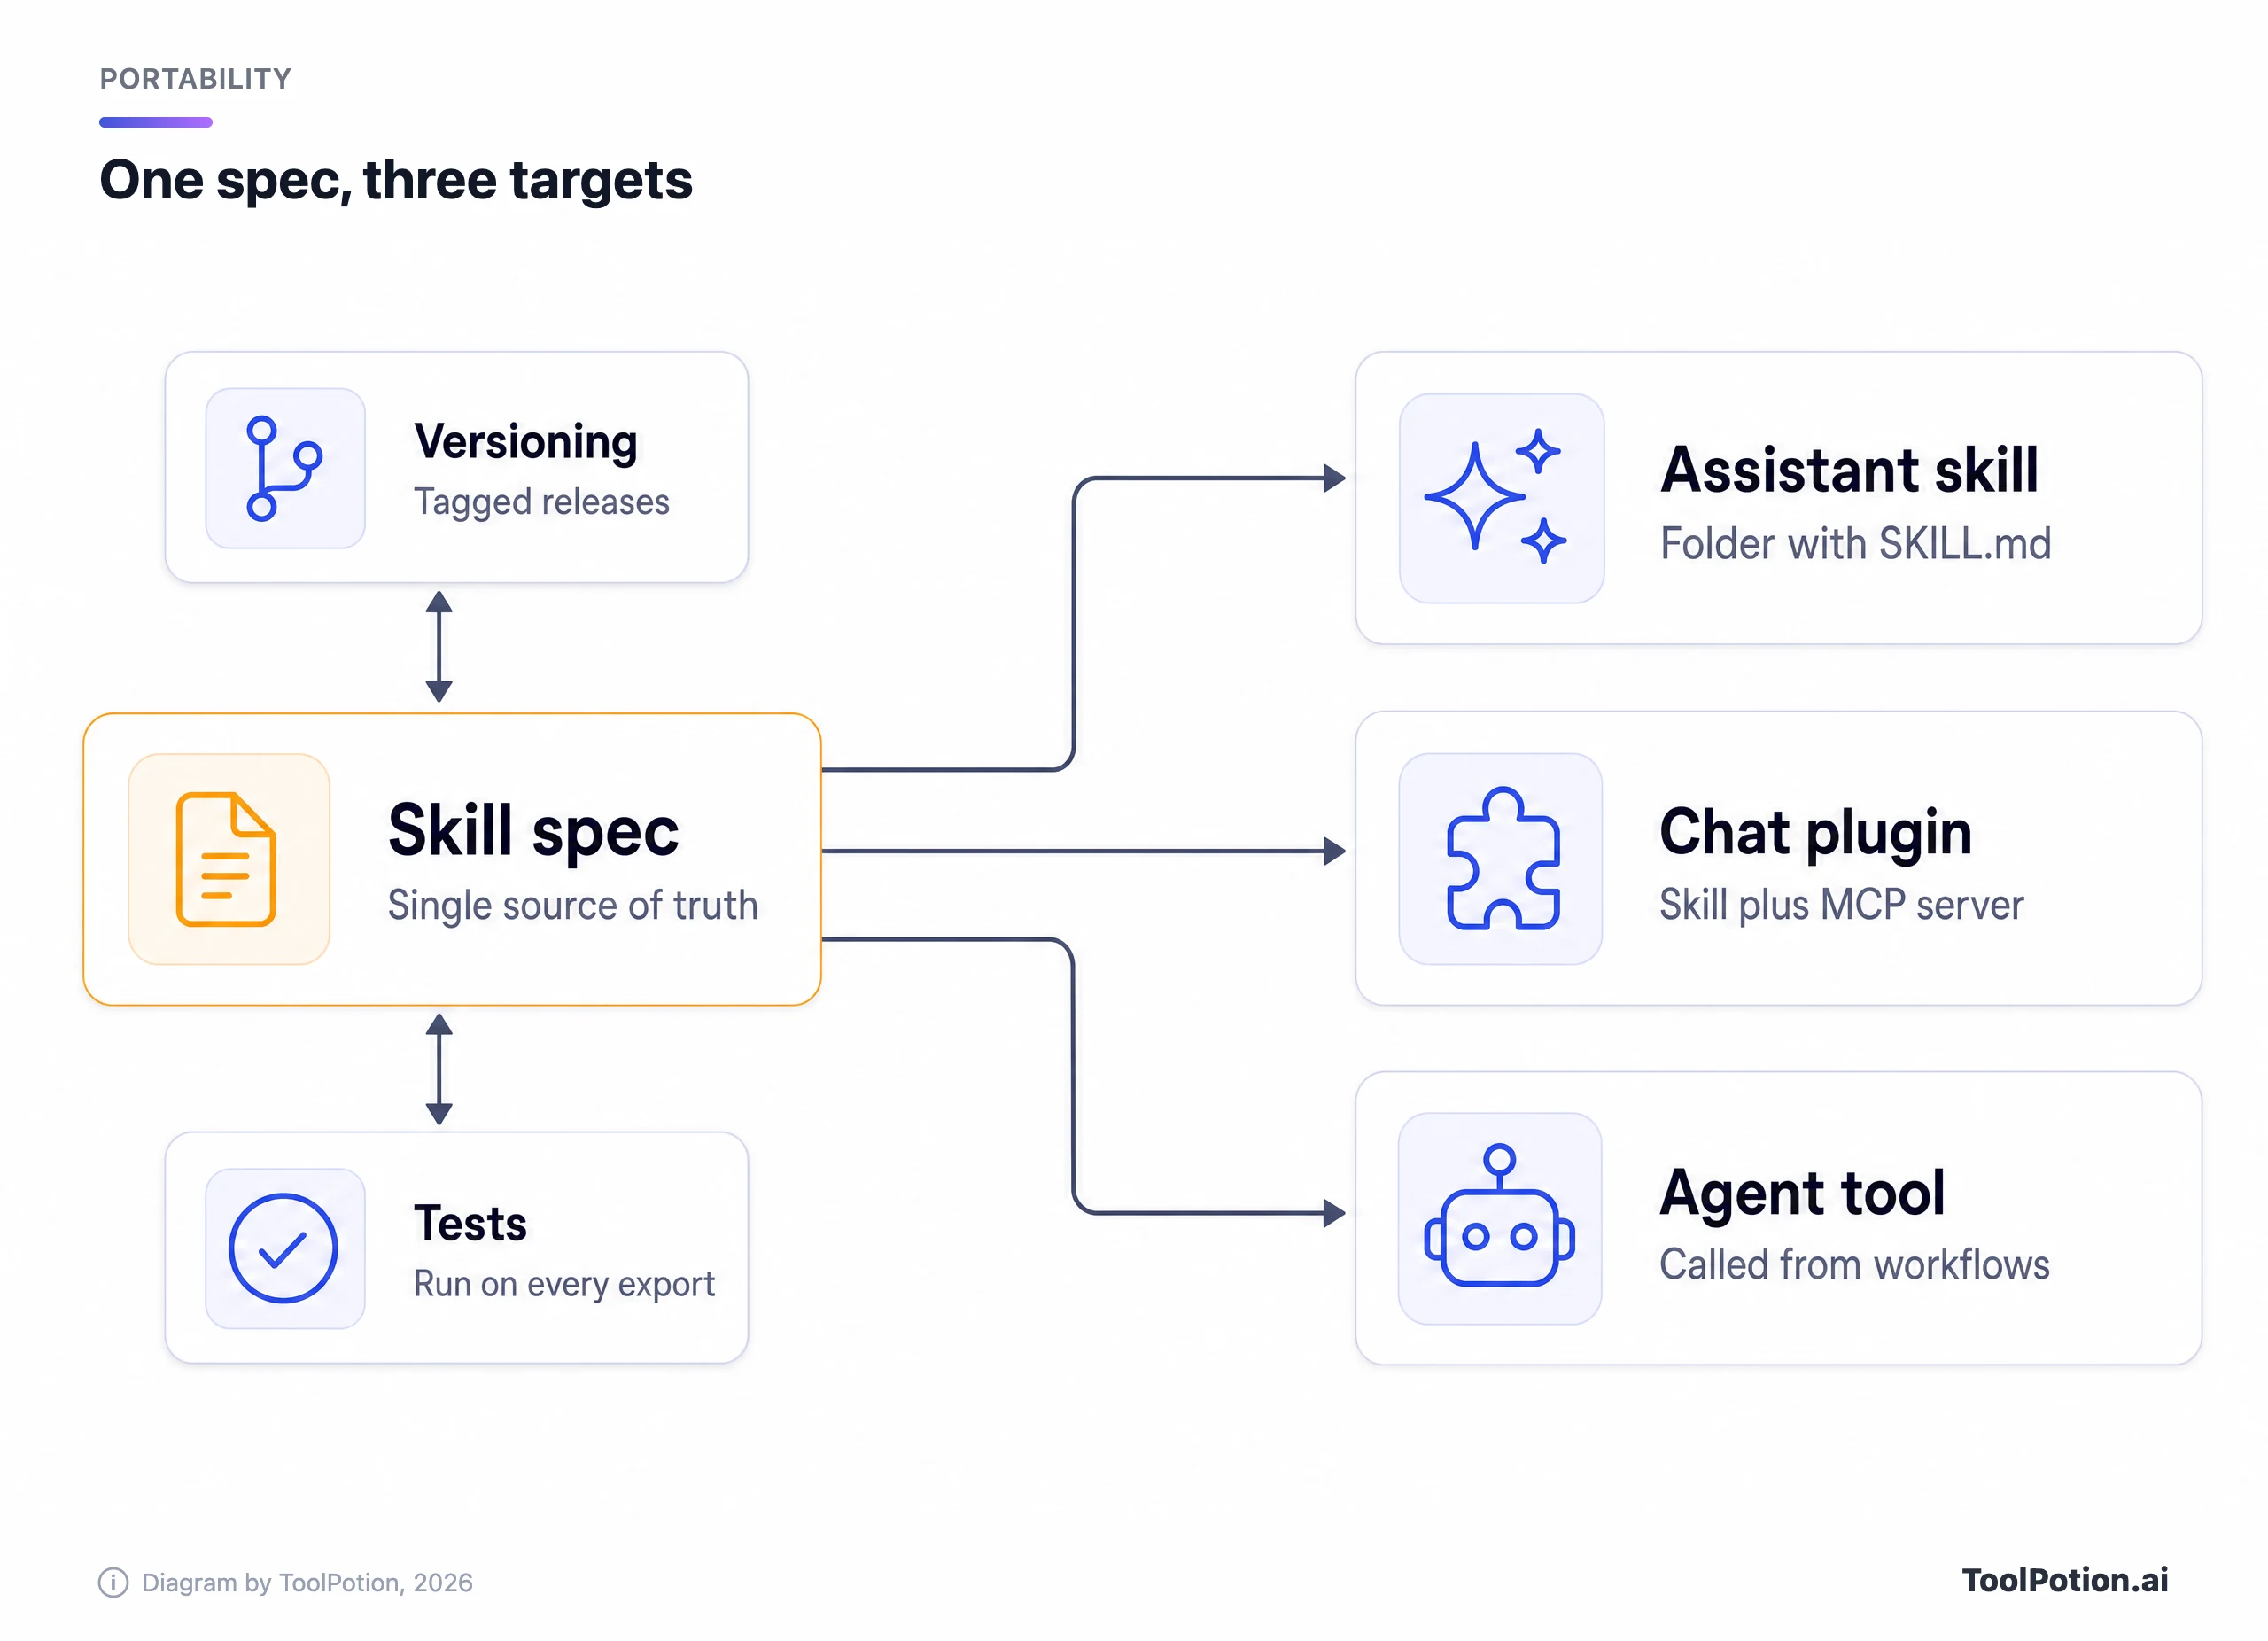
担心被厂商锁定的人有个好消息:格式正在趋于统一。Anthropic 在 2025 年把 Agent Skills 作为开放标准发布,用于跨平台移植,公开规范在 agentskills.io。一个 skill 就是一个目录,必须有 SKILL.md,可选的有 scripts/、references/ 和 assets/ 文件夹;name 最多 64 个字符,只能用小写字母、数字和连字符;description 最多 1,024 个字符(Agent Skills spec)。
OpenAI 的文档说,它的 skills 建立在同一个开放标准之上。每个 skill 是一个目录,必须有带 name 和 description frontmatter 的 SKILL.md;你可以在 ChatGPT 里用 @、在 Codex 里用 $ 显式调用,也可以让模型根据描述自己挑选(OpenAI)。Google 的 Gemini CLI 文档说它的 skills 基于同一标准(Gemini CLI docs),Gemini 应用的帮助页面则说,你可以上传 SKILL.md 文件来导入在其他平台创建的 skills(Gemini Help)。我们没有找到 Google 声明该应用完整实现了开放规范的说法,所以依赖上传之前,先自己测一遍。
这样看,可移植的核心已经覆盖三家厂商。Claude 和 Claude Code 能读它,ChatGPT 和 Codex 按 OpenAI 的说法也能,Google Gemini 则接受它的上传。把同一个文件夹作为唯一的事实来源,每次上传后重跑你的示例。Gemini 的上传会拒绝 .docx 之类的二进制格式,也会拦截调用外部站点的脚本(Gemini Help)。
把 skill 写成能经得起迁移的样子
可移植性主要靠自律。四个习惯就能覆盖大部分情况。
- 把事实来源放在受版本控制的普通文件夹里,别只存在某个厂商的编辑器中。厂商那份只是一次部署。
- 指令里写结果和格式,别写产品功能。"返回一个三列的表格"到哪都能用,"使用 canvas 面板"就不行。
- 篇幅长的内容(风格指南、schema、政策)单独放进参考文件,并从
SKILL.md链接,只链一层。Anthropic 提醒过,嵌套更深的引用链只会被读到一部分。 - 保持简短。Anthropic 建议正文控制在 500 行以内,开放规范则建议指令部分不超过约 5,000 个 token。
下面以大多数团队都会重复做的一件事为例:每周客户进展更新。
---
name: drafting-client-updates
description: Drafts a weekly client status update from raw project notes. Use when the user pastes notes, a ticket export or a standup log and asks for a client-ready update.
metadata:
  owner: ops-team
  version: "1.2"
---

# Drafting client updates

## Inputs
- Required: raw notes for the week
- Optional: client name, tone (default: plain and direct)

## Steps
1. Group items into Done, In progress and Blocked.
2. Drop internal ticket IDs and jargon.
3. Lead with the one thing the client must decide, if any.

## Output
Use the template in references/update-template.md.

## Examples
See examples/ for three accepted drafts.
注意少了什么:没有奉承,没有"你是一位世界级的客户经理",也没有解释什么是进展更新。助手本来就懂。Anthropic 自己的建议是,对每一段都问一句它值不值这笔 token 开销,并且只补充模型本身不具备的上下文。
还要注意 metadata 块。开放规范把它定义为自由格式的键值映射,很适合用来放负责人和版本号。导入时记得确认你的平台是否保留了它。
像对待软件一样测试它,因为它就是软件
Anthropic 编写指南里最有用的一句话是:先建评估,再写大量文档。流程很短。先在没有 skill 的情况下,让助手跑一批有代表性的任务,记下哪里出了问题。写三个能暴露这些缺口的场景。只加刚好够通过它们的指令。然后和基线做对比。
三个是 Anthropic 在分享前检查清单里列的最低数量,这只是底线。从你自己的工作中取五到十个真实输入,把你实际接受过的输出留下来,这个文件夹就是你的回归测试集。每次修改之后、每次平台变动之后,都重跑这些输入并看差异。成本很低,而且这是唯一能抓住悄悄发生的漂移的办法。
也要跨模型测试。Anthropic 的指南说,在最强模型上完美运行的 skill,换到小模型上可能需要更多细节,所以每个你打算用的模型都要跑一遍。换厂商时也一样。在一个助手里调好的 skill,没在另一个助手里跑过示例,就不算测过。
如果需要工具,Promptfoo 可以在 CI 里针对 prompt 跑保存的用例,PromptLayer 可以追踪 prompt 版本和运行记录。我们的 prompt 工程工具榜单还有更多排名。这些都不是必需的。一个示例文件夹加一份检查清单就能解决大部分问题;我们的耐用 prompt 写法手册则讲了底层模型更换后依然有效的写法。
MCP 在哪里发挥作用
skill 告诉助手怎么做一件事,但不会让助手获得任何访问权限。要访问东西得靠工具,而可移植的提供方式是 Model Context Protocol,这是一个把 AI 应用连接到外部系统的开放标准,其文档把它比作 USB-C 接口(MCP docs)。Claude、ChatGPT、Cursor 和 VS Code 都在它列出的客户端之列。想看可运行的例子,可以去 Model Context Protocol servers 仓库。
OpenAI 的 plugin 文档把界线划得很清楚:工作流指令交给 skill,实时数据、授权和受控操作交给 server。如果 skill 依赖某个 MCP server,就在 agents/openai.yaml 里声明这个依赖。提交过程中从 plugin 的 MCP server 导入的 skills,会在草稿里变成一份快照,ChatGPT 和 Codex 在运行时不会从你的 server 上去拉取(OpenAI Developers)。实际后果是:改了 skill 之后,要先重新部署 server 并再次扫描,才能提交新版本的 plugin。
Anthropic 还补充了一条写作规则,能省下不少调试时间:引用 MCP 工具时用完整限定名 ServerName:tool_name,因为连接了多个 server 时,只写裸名称可能解析失败。
Shopify 展示了这件事的走向。它提供面向 server 对 server agent 的托管 MCP server,以及面向浏览器 agent 的 WebMCP 标准提案,还刚刚增加了获取、更新和完成结账的工具,agent 可以读取结账页面,并在买家授权下提交订单,而不用去抓取网页(TechCrunch)。如果你经营 Shopify 店铺,工具层正在变成平台自带的东西,而你的 skill 要负责的是围绕它的判断。
OpenAI 自己的发布也指向同一个方向。ChatGPT 现在会在对话中途推荐 apps,公司称周活跃用户达 12 亿(TechCrunch),OpenAI 还说它的 plugin 更新支持了 MCP Events 规范提案,让已连接应用的事件可以触发自动化(TechCrunch)。你的工具越多放在 MCP 后面,任何一家助手的 plugin 格式就越不重要。
和团队共享,又不制造第二个烂摊子
skill 放在哪里,决定了谁能用,而且各产品规则不同。在 Claude 的文档里,claude.ai 中的自定义 skills 归个人用户所有,所以每个队友要各自上传,管理员无法集中分发。在 API 上,它们是工作区范围的。在 Claude Code 里,它们放在个人文件夹或项目的 .claude/skills/ 目录下,也就是说会跟着代码仓库走。
对大多数团队来说,用代码仓库是最好的答案。把 skills 放进 git,像审查代码一样审查改动,给版本打 tag,让大家自己拉取。靠在笔记本之间拷 zip 文件,最后只会得到七个版本的客户更新 skill,还没人知道哪个是对的。
每个共享的 skill 都需要一个明确的负责人、一个版本号,以及每次修改对应的一行更新日志。它还需要做安全审查。Anthropic 的文档说,要把 skills 当作已安装的软件对待,审计其中捆绑的脚本,对任何会抓取外部 URL 的 skill 保持警惕,因为抓回来的内容可能带有恶意指令。这既适用于同事写的 skills,也适用于来自公共合集的 skills,比如 SkillsMP,它索引的是公开 GitHub 仓库里的 skills。
拿下面的评分器给你手头已有的某个 skill 打分。这是我们自己的检查清单,不是行业标准,而且故意写得很直白。触发条件、示例、测试集和平台之外的副本权重翻倍,因为前面的章节已经论证过,它们决定了 skill 能否被测试和迁移。
每个已保存助手的迁移清单
每个助手做一遍,趁厂商还没逼你动手。大部分时间会花在找回最初的知识文件上。
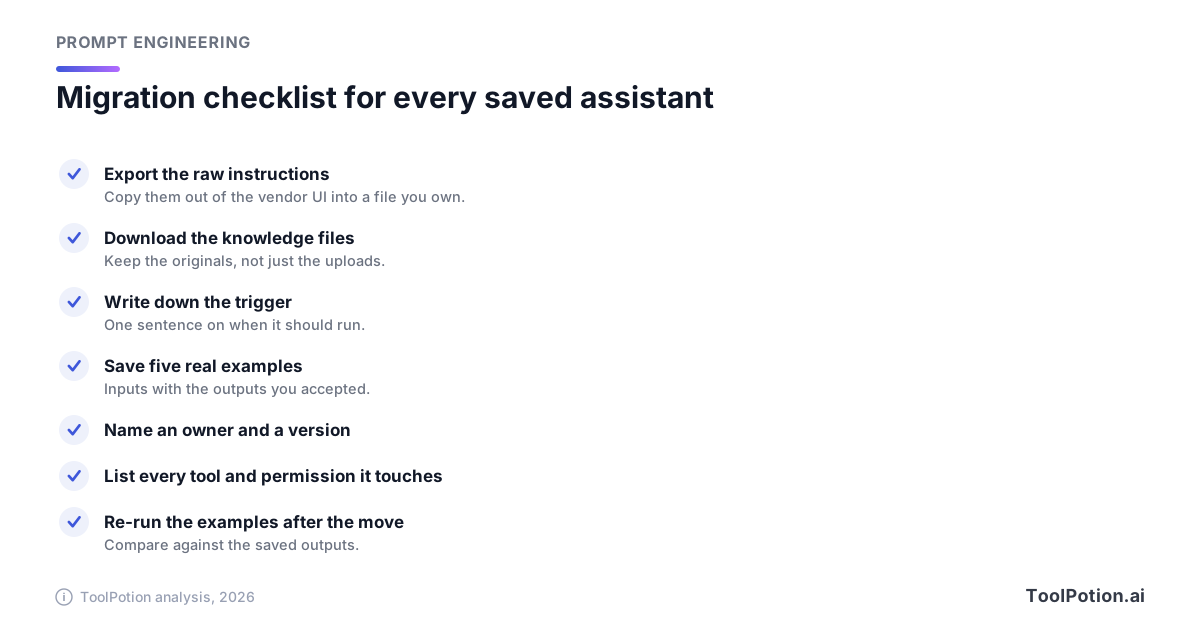
重跑这一步最重要,也最容易被跳过。一个转换后读起来没问题、却悄悄改了输出格式的 Gem,比明显坏掉的更糟,因为一个月内都没人会发现。如果保存的输出对不上,改 skill,别降低你的预期。
即使是你手动调用的助手,也要把触发条件那句话写出来。这个练习逼你想清楚它到底是干什么的,有些保存的助手其实是两件事披着同一个名字,那就把它们拆开。
什么时候不该建 skill
大多数 prompt 都不该变成 skill。只会跑两次的任务,用 prompt 就够了。打包的成本比省下的还多,而且一个没人维护、还在错误时机触发的 skill,比没有更糟,因为它会弄乱助手用来挑选的候选池。
步骤固定、不需要判断的任务,通常更适合做成普通自动化。如果每次运行都是同样的触发、同样的 API 调用、同样的输出,那么 n8n 或 Zapier 这类工作流工具,比让模型照着菜谱做更便宜,也更可预测(我们的 agent 与自动化工具对比指南讲了两者怎么划分)。只有当工作涉及语言、判断或杂乱的输入时,才用 skill。
而当路径本身会随每次输入变化时,你要的是 agent,把 skills 和工具当作它可以取用的部件。我们的顶级 AI agent 榜单列出了各个选项。下面的对比是我们自己的编辑分组,不是厂商规格,也不是实测数据。打勾表示前面章节能支持这一点,比如 skills 按描述匹配加载,或 plugins 增加实时工具 server。半圆表示取决于厂商或配置,比如各助手的 plugin 格式各不相同。
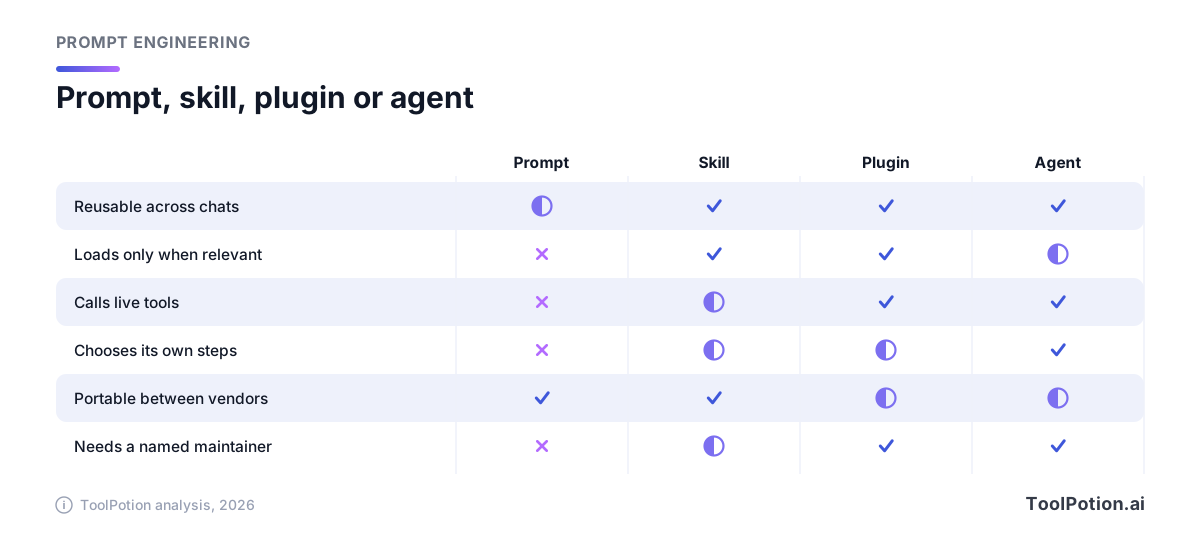
如果你还拿不准,下面的决策树用三个问题就能分清大多数情况。想了解挑选工具和养成耐用习惯的更多背景,请看我们的实用 prompt 工程指南,以及Prompt 工程师必备 AI 工具榜单。
最后再补一个关于时间点的数据。OpenAI 说它改进了 plugin 目录的排序和推荐方式(TechCrunch),其企业市场上线时有 30 多家合作伙伴,包括 Adobe、Figma 和 Salesforce(TechCrunch)。写好文档并测试过的 skill,你可以按自己的节奏提交、分享或下线。而保存下来的 prompt,你只能指望厂商继续替你留着。
常见问题
Gems、自定义 GPT 和 skills 是一回事吗?
有重叠,但不完全一样。三者都是保存指令以便复用。skills 多了基于描述的触发机制,在开放格式下还有只在需要时才加载的脚本和参考文件。Gems 和自定义 GPT 则主要是在某一家厂商的编辑器里写指令,再加上传的知识文件。
我的 Gems 会不用费力就转换成 skills 吗?
Google 说迁移是自动的,用户无需任何操作,受支持的文件会随 Gem 一起过渡。你的指令文本应该能顺利带过去。至于附加文件、共享权限和你依赖的输出格式,是否表现如初,跑一遍你保存的示例就知道了。
同一个 skill 能在 Claude、ChatGPT 和 Gemini 里都跑吗?
SKILL.md 格式是开放标准,Anthropic 和 OpenAI 的文档都有描述。Google 的 Gemini 应用也接受 SKILL.md 上传,只是对脚本和文件类型有限制。无论用哪一家,都把一个文件夹作为事实来源,每次上传后重跑你的示例。
一个 skill 应该写多长?
越短越好。Anthropic 建议主文件不超过 500 行,开放规范则建议指令部分控制在约 5,000 个 token 以内。把冗长的参考内容拆到单独的文件里,需要时才加载。
做 skill 一定要用 MCP 吗?
不用。一个只有指令、示例和模板的 skill,完全不需要工具。只有当 skill 必须读取实时数据或执行操作时,才加上 MCP,并且把权限放在 server 里,而不是写在指令里。
团队的 skills 该由谁负责?
每个 skill 指定一位负责人,再配一个共享仓库。负责的意思是:回答疑问、审查修改,并在平台变动后重跑示例。没有人负责,skills 的衰败速度就和它们本来要取代的那些 wiki 一样快。