

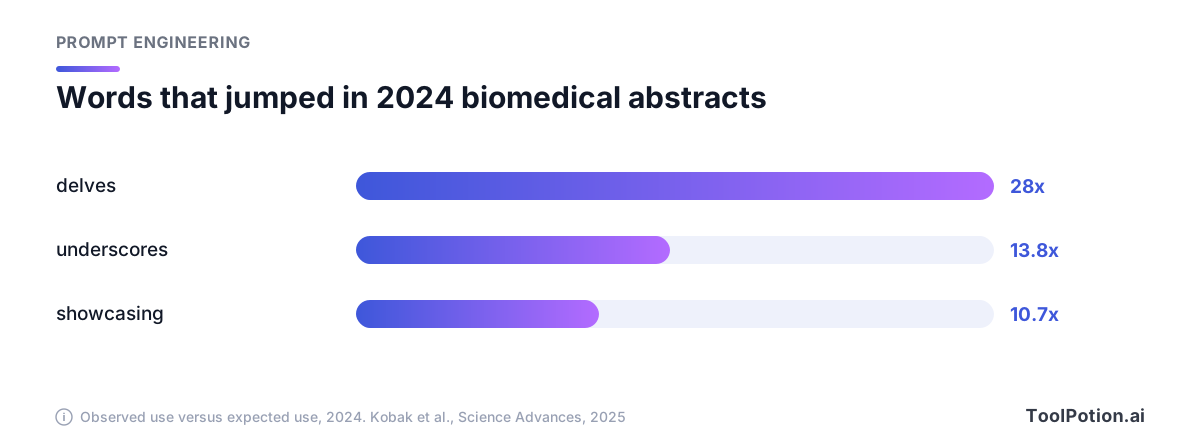
研究人员梳理了 PubMed 上超过 1500 万篇生物医学论文摘要,找出 ChatGPT 问世后使用频率暴涨的词。其中一个动词(正是那篇论文标题里的核心词)在 2024 年摘要中的出现频率,是此前趋势预测值的 28 倍;另外两个词分别是 13.8 倍和 10.7 倍。Dmitry Kobak 和他的合著者仅凭这种用词变化就估算出:2024 年至少有 13.5% 的摘要经过了 LLM 处理,在部分领域甚至高达 40%(Science Advances,开放获取版本见 PubMed Central)。
这些词并不能说明那些科学家有没有话要说。它们只说明:有台机器碰过这些句子,而且没人回头检查。
本文要讲的是怎么让草稿听起来像你,更重要的是让它说出你真正想说的话。这篇文章不是教你绕过 AI 检测器。如果你所在的学校、期刊或公司禁止使用 AI 辅助,或要求披露,就照规定办。我们不会帮任何人在不允许的场合把机器写的东西冒充成自己的,下面的内容也不是绕开规定的办法。除此之外的场景(邮件、帖子、报告、方案),这就是我们自己会用的工作流,依据来自 Wikipedia 编辑整理的 AI 写作特征清单、相关的用词研究,以及各家厂商的帮助页面。
为什么默认草稿读起来都像同一个人写的
Wikipedia 的志愿编辑干的就是清理聊天机器人文本的活,他们的指南把原因讲得很清楚。他们写道,语言模型会"回归均值":输出会趋向在最广泛的情形下统计上最可能出现的内容。再经过一轮训练调校,就变成"最容易被大多数人接受的文字"。
后果很具体:罕见的事实被常见的描述取代。编辑们举了个例子:非常具体的"第一种列车连接装置的发明者",变成了"一位革命性的工业巨擘"。照他们的说法,主角从一张清晰的照片褪成了一幅模糊的素描,赞美之声却越来越响。
你的声音恰恰就藏在被平均掉的那些东西里:一个古怪的数字、一个专有名词、一个你自己都有点不好意思承认的观点、长句后面跟着的那个短句。
不要围绕一份词表来做修正,还有第二个原因:这些词会变。同一页 Wikipedia 说,那个动词在 2023 和 2024 年被 ChatGPT 滥用得出了名,到 2025 年却急剧回落,而且每一代模型都有一套不同的偏爱词。至于人人都怪罪的破折号,该页的说法是,这个符号与其他特征组合起来才最有用,而且一些较新的聊天机器人已被设计成尽量不用它。要抓的是句子的"形状",不是词汇。
人类在识别这件事上相当不行。该页引用了一项 2025 年的研究,参与者的表现不比瞎猜好;另一项针对德语毕业论文的研究中,读者判断正确的比例,AI 文本为 57%,人类文本为 64%。它还引用了一篇 2025 年的预印本,其中一组专家标注者挑出了 90% 的 AI 文本。
从你自己写的五篇东西开始
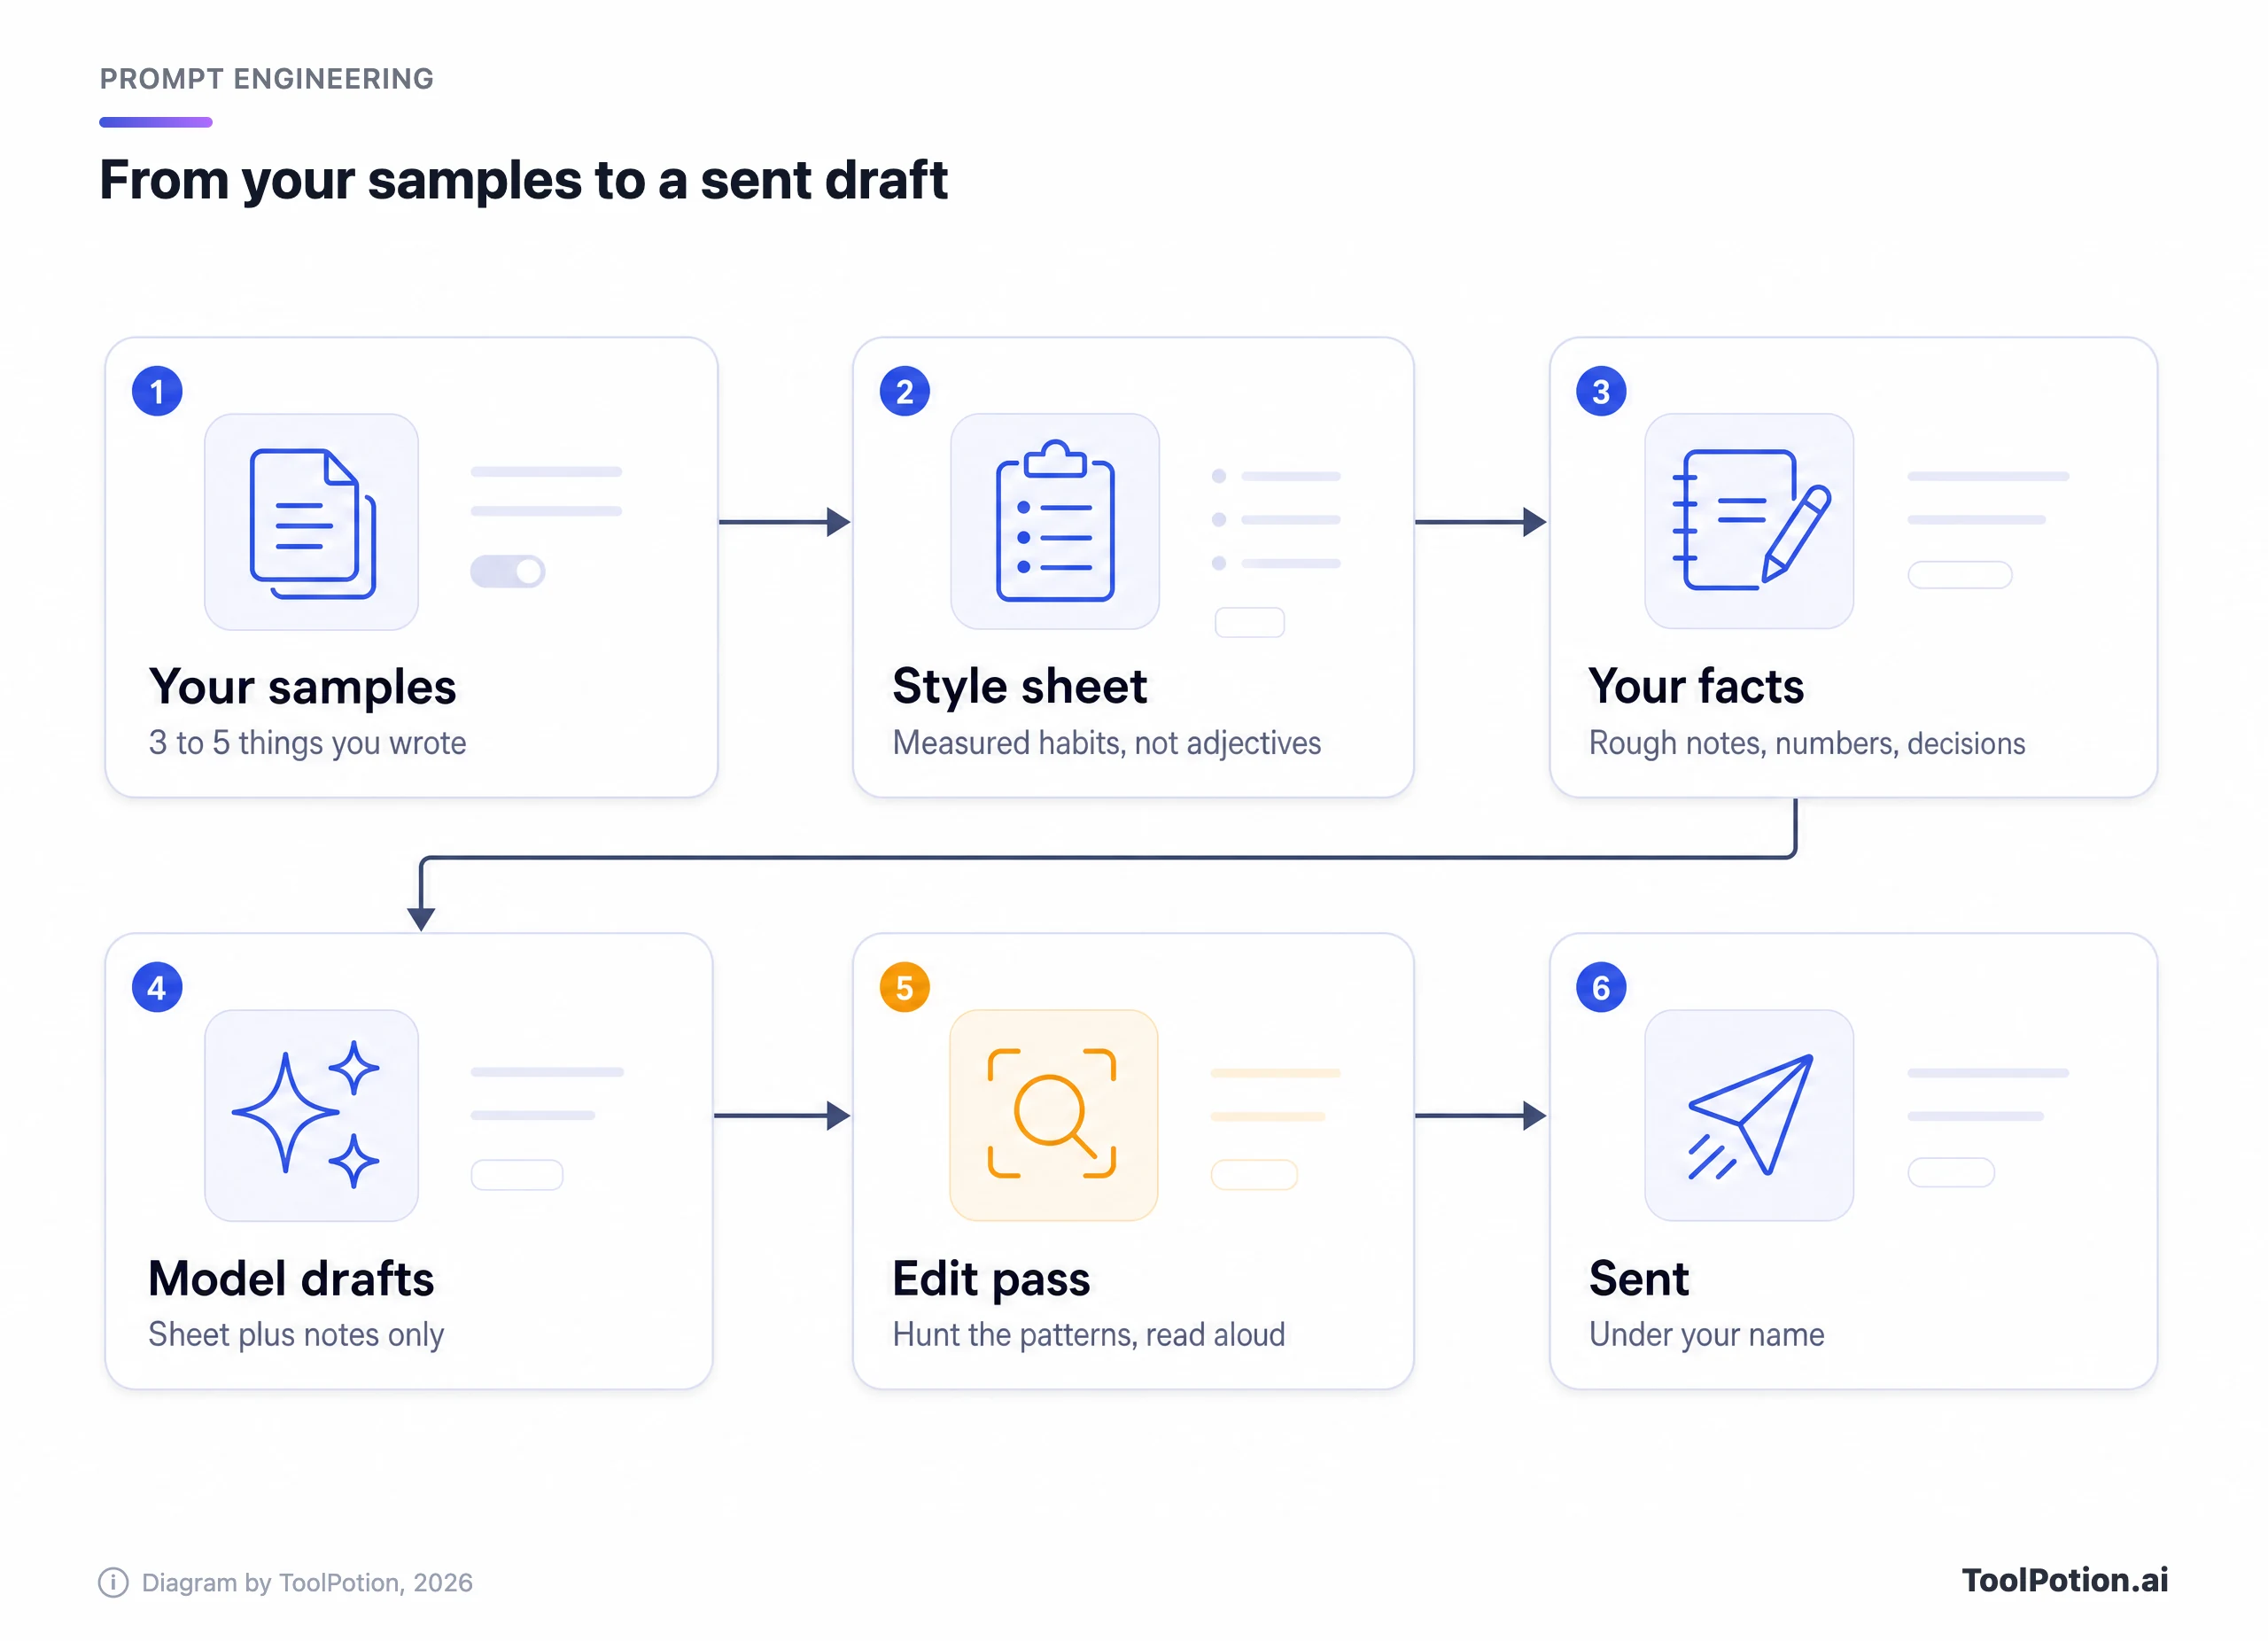
挑三到五篇你自己写的东西:面向真实读者,写作时没有模型参与。比如发给同事的邮件、一条你满意的帖子、你向新人解释某件事的 Slack 消息,每篇 300 到 600 字(词)。我们读过的帮助页面里,没有一个说多少样本才够。我们的经验法则是:够让某个习惯出现两次就行。
选那些写得快、没怎么打磨的。随手发给熟同事的一条消息,比你为客户字斟句酌的那段话更好。凡是最初由 AI 起草、你只是润色过的东西,一律别放进来,否则等于把模型自己的习惯又教了它一遍。
粘贴之前先去掉人名和任何机密信息,然后像陌生人一样把这一堆读一遍。找找看:哪些做法是你有、而默认草稿从来没有的。
风格手册记录的是习惯,不是形容词
风格手册就是一页关于你写作的观察记录,具体到别人照着它就能模仿你。形容词不算数。"温暖但专业"能形容上百万人。能描述你的,是可测量的数据和习惯。值得写下来的有六项:
- 句子长度。数几段话。如果你平均约 14 个词,范围从 3 到 35,就写下来,并注明长句后面常跟短句。
- 你从不使用的词和短语。浏览样本,找出你绝不会打出来的套话,再把你在被你否掉的草稿里发现的也加进去。
- 你怎么开头。你是先给答案、先抛数字、先提问,还是先道歉?引用两个真实的开头。
- 你怎么结尾。很多人就是写完即止,或者以下一步行动加一个名字收尾。写下你的做法,并注明不要总结回顾。
- 模型会抹平的习惯。比如句子片段、括号、用 And 开头的句子、第一人称、冷幽默的插话、习惯点出精确数字。
- 格式。你用不用项目符号,段落通常多长,标题怎么写,用不用缩略形式(多数人会用)。
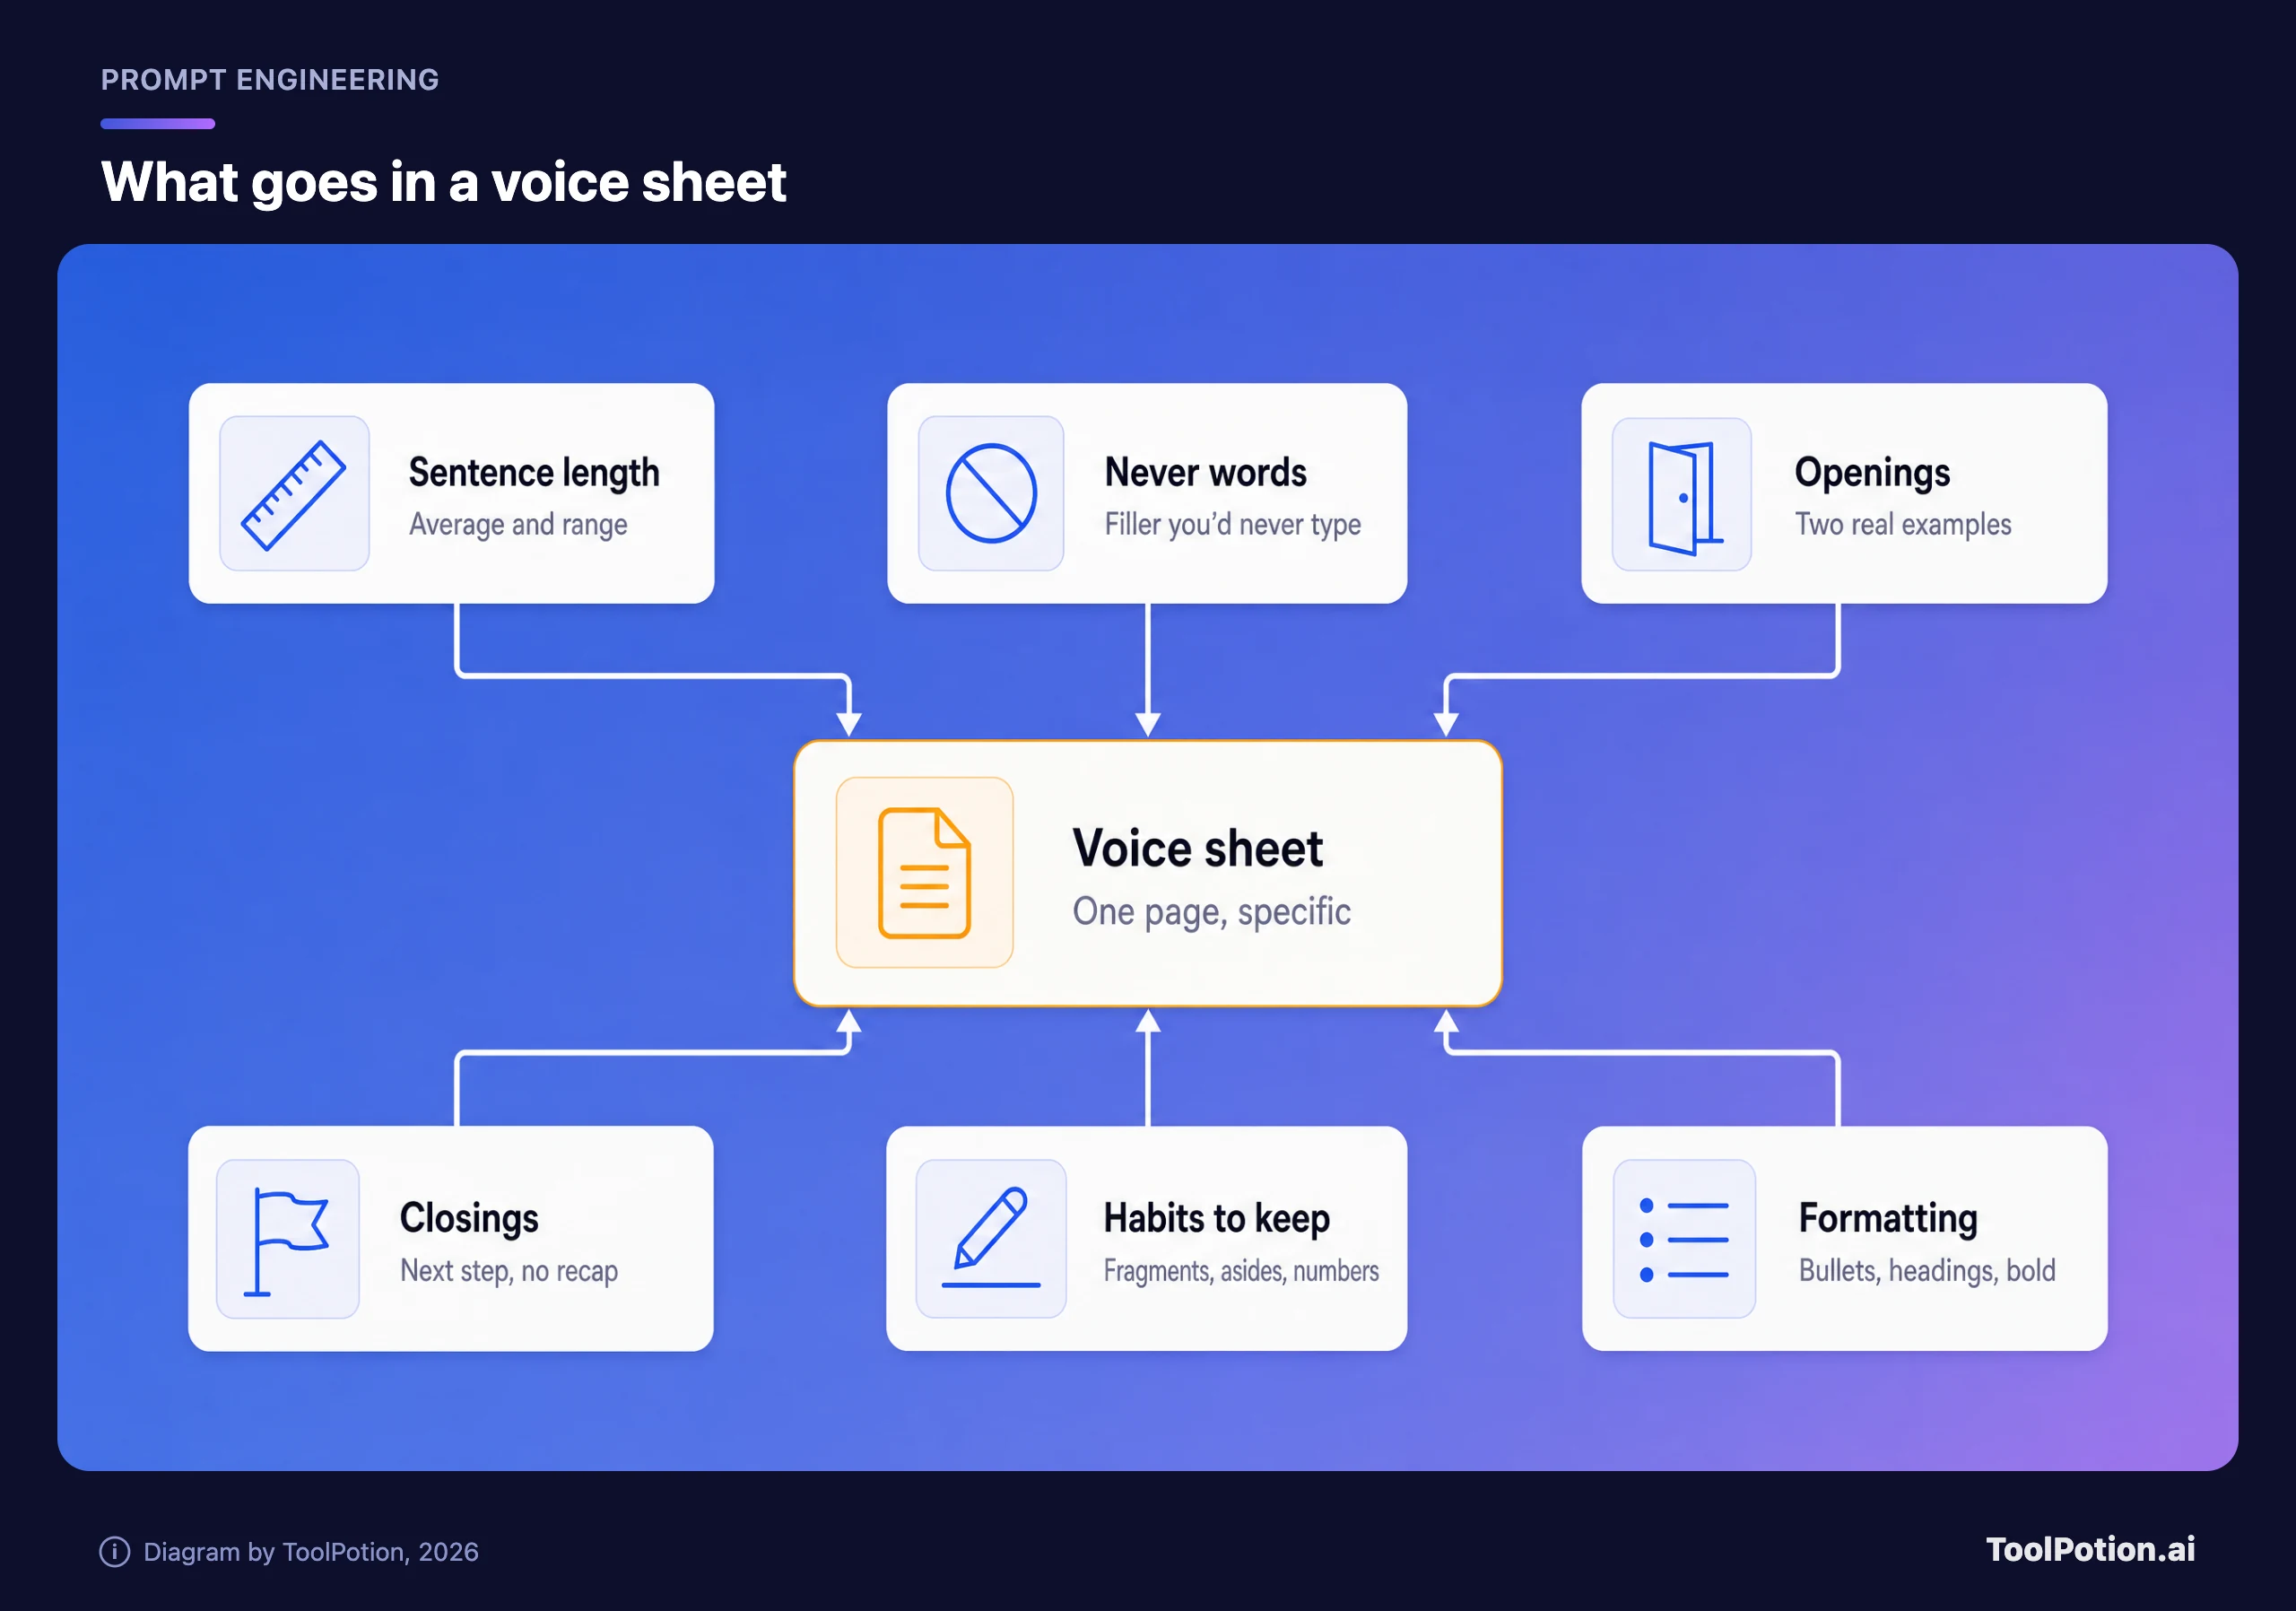
再加上两三句你真实写过的句子作为示例。模型模仿示例比理解描述强得多。
下面是我们为一位虚构的运营经理 Dana 写的精简版手册,用来演示格式。别照抄,你的应该和它不一样。
VOICE SHEET: Dana
Sentences: average 14 words, range 3 to 35. A short one after every long one.
Openings: the answer first, or the number. Never a greeting line, never "I wanted to".
Closings: the next step and who does it. No recap, no offer to help further.
Contractions always. First person plural for the team, "I" for opinions.
Parentheses for asides, maybe one per email. Fragments are fine.
Never writes: "touch base", "circle back", "moving forward", "going forward", "leverage", "stakeholders", "ensure".
Numbers as digits, with units. Dates as "Thursday the 12th".
No bullets in emails under 200 words. No bold. No headings.
Examples of my sentences:
- "The vendor took nine days, not two."
- "We can cut invoices from this release. Nothing else can slip safely."
- "Not great, but fixable."
你可以让模型根据样本起草这份手册,但每一条都要对照你自己写过的真实句子核实。模型描述一个写作者时,描述的是平均水平。如果你没有任何一句话遵守某条规则,就把这条删掉。
手册在各个工具里放哪儿
每个主流助手都有放长期指令的地方。它们能容纳的文字量不同,而一份带示例的完整手册,长度会超过其中一些的上限。
| 工具 | 你的风格放在哪 | 厂商页面怎么说 | 注意点 |
|---|---|---|---|
| ChatGPT | 设置 → 个性化 → 自定义指令 | 立即应用于所有对话。Free 和 Go 上限为 1,500 个字符,Plus、Pro、Business、Enterprise 和 Education 为 5,000 个字符 | 把精简版手册放进去,示例贴在对话开头 |
| Claude | 设置 → Your Claude → 指令;或项目的指令 | 账户级指令、项目级指令,以及可基于你自己的文字生成"沟通模式"的 skills | Anthropic 的个性化页面列出了指令、项目指令和 skills,没有单独的风格功能 |
| Google Gemini | Gem:名称、指令和可选的知识文件 | Gemini 可以帮你改写 Gem 的指令 | Google 表示个人账户的 Gems 即将转为 skills |
| Grammarly Humanizer | 粘贴一段写作样本来创建自定义风格 | 四种预设风格,外加从你的样本中学到的自定义风格,用于之后的改写 | 它只改写你已有的文字,补不上你漏掉的事实 |
来源:OpenAI、Anthropic、Google 和 Grammarly。
我们的建议很朴素:主文件放在你自己掌控的纯文本文件里,哪里要用就粘贴到哪里。厂商会改名、会下线这些功能(Google 就说个人账户的 Gems 会转为 skills),而一份哪都能粘贴的手册不怕这些变动。想把一条 prompt 变成可复用的东西,参见可复用的 AI 指令;想了解为什么上下文比巧妙的措辞更重要,参见 context engineering。
Grammarly 这种基于样本的自定义风格思路是对的,只不过它是作为"AI humanizer"卖的。Grammarly 自己的 FAQ 写明该工具"并非用于绕过 AI 检测器",并鼓励在学术或职场写作中注明使用了 AI 辅助。我们也是这样用它的:当作一个会学习你习惯的文字编辑。AI humanizers 分类里的其他产品可能有不同的宣传,请逐一阅读它们的条款。更广泛的工具请看我们的写作助手盘点和 Grammarly 与 QuillBot 对比。
先给它你的事实,再让它起草
手册管的是表层,内容得由你来出。在让模型起草之前,先用你自己那种乱糟糟的方式把原材料写出来:发生了什么、数字、决定、你希望读者做什么。粗略十行就够。然后告诉模型:只能用这些材料,缺事实时要来问你而不是自己填空,并且遵循手册。
"来问我"这条指令最关键。允许模型猜,它就会猜,而它猜出来的都是那种笼统、讨好、似是而非的东西。这类指令的写法细节见我们的 prompt 工程指南,把它用到邮件上则见邮件指南。
一次更新通知的前后对比
下面两个版本都是我们自己写的,用来说明差别。第一个是你让聊天机器人"给客户写一封关于延期的项目更新"时,典型默认草稿的样子。第二个是 Dana 把她的十行材料和手册交给模型、再经过编辑之后会发出去的版本。
| 典型 AI 草稿(我们编写的示例) | 套用风格手册并编辑后的草稿(同样是我们虚构的示例) |
|---|---|
| Subject: Project Update. I hope this message finds you well. I wanted to take a moment to provide an update on the project timeline. Our team has been working diligently to ensure we deliver a high-quality product, and we remain committed to transparency. Unfortunately, we have encountered some unforeseen challenges that have impacted our schedule. Moving forward, we will continue to prioritize clear communication and collaboration. Please don't hesitate to reach out if you have any questions. | Subject: We're a week late. The payment provider took nine days to approve our test account, not the two they quoted, so we couldn't test checkout until Monday. It works now. New date is Thursday the 12th. If that breaks your press embargo, call me and we'll cut invoices from this release, which is the only piece that can slip without breaking anything else. Dana |
数一数改了什么。第二个版本更短,但重点不在这儿:它有一个 9、一个 2、一个周一、一个周四,还有一个客户可以据此行动的决定。这些都不是模型给的,模型也给不出来。大部分改进来自事实,声音只是在上面做的功夫。第一版里没有一句是假的,但它可以是任何人写的、关于任何事的。
编辑时要揪出的八种特征
把这部分打印出来。这些特征来自 Wikipedia 的清单,而那份清单是基于文章、草稿和讨论页里的真实例子建立的。中间一列描述每种特征,并附上该页自己展示的几个短语。
| 特征 | 表现 | 怎么办 |
|---|---|---|
| 夸大意义 | 把普通事实说成转折点、传承、与更大趋势的关联("marking a pivotal moment"、"reflects broader") | 删掉这句,或换成它原本在夸大的那个朴素事实 |
| 分词结尾 | 句子以"-ing"点评收尾,告诉读者这个事实意味着什么 | 拆开。把论断单独写成一句,如果撑不住就删掉 |
| 否定式排比 | "It's not just X, it's Y",以及近亲"not X, but Y" | 直接说 Y |
| 含糊的出处 | 引用无名的专家、报告或观察者来支撑一个没人查得到的说法 | 说明是谁说的并附上链接,否则删掉 |
| 三段式 | 下意识地堆三个形容词或三个并列分句 | 只留下真实的一两个 |
| 把格式当成思考 | 每个要点开头都加粗标签、标题每个词首字母大写、用 emoji 当项目符号 | 写普通的句子。只有各项确实彼此独立时才用列表 |
| 整齐的展望段落 | 结尾加一节"挑战与未来展望",把全文又复述一遍 | 以最后一个具体观点或下一步行动收尾 |
| 助手的残留 | 开头的客套话、结尾的"需要我修改吗"、留在正文里的方括号占位符 | 全部删掉,然后搜索一遍方括号 |
使用这份清单有两点提醒。第一,它的用途是帮 Wikipedia 编辑发现未披露的 AI 文本,而他们警告不要把这些特征本身当成问题。原话是:"Please do not merely treat these signs as the problems to be fixed; that could just make detection harder."(请不要仅仅把这些特征当作需要修正的问题,那只会让检测更困难。)我们把这份清单当作编辑工具,用来找出里面空无一物的句子。浮夸通常意味着本来就没什么可说,所以解决办法是补一个事实,而不是换个更好的词。
第二,该页还列了一份"无效指标":语法完美、正式与随意语体混用、内容没有出处,这些在人类写作中也都会出现。只修正你的手册里写明你与它不同的地方,你自己的习惯就留着。
把草稿大声读一遍,标出每个卡壳的地方。然后对照上面的表格过一遍。最后问问剩下的每个句子带了什么事实、名字或数字。一个都没有,就删。
模型拿不到的三样东西
风格手册管的是措辞,但很容易让模型闯进它一无所知的领域。我们在三件事上划死线。
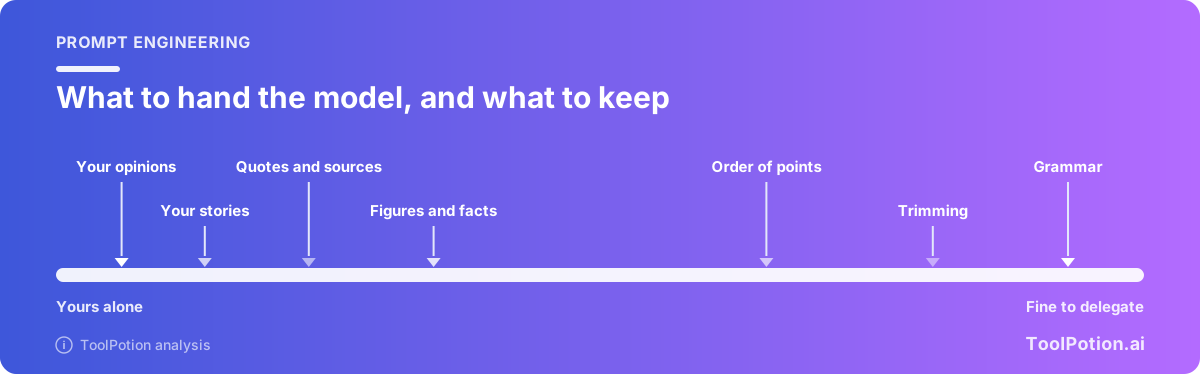
你并不持有的观点。让模型给一个强硬的观点,它会用你的口吻写得信心十足,这比平淡无奇更糟。如果你还没拿定主意,就写"我还没想好"。
没发生过的轶事。"最近有位客户跟我说"是对现实世界的一个断言。如果是编的,你就是用第一人称撒了谎,而模型写这种句子再轻松不过。
没人说过的引语,以及不存在的来源。Wikipedia 那页记录了一些看起来很像样、却无处可查的参考文献,其中一次编辑里,"为这句话添加的参考文献并不存在"。草稿里的每个数字、引语和链接,不管是谁敲上去的,都得由你来核实。
其余的事交给模型就行:质疑你的笔记、理顺顺序、精简,以及给出几种段落开头的写法,好让你偷走那个你本来就会写的。
常见问题
这样能让我的文字通过 AI 检测器吗?
它不是为这个设计的,我们也不会做这种承诺。Wikipedia 的编辑说,GPTZero 和 Pangram 这类检测器"表现优于随机猜测",但"错误率不容忽视",单凭高分并不能证明什么。同样,分数干净也证明不了什么。如果学校或雇主禁止使用 AI 辅助,答案就是遵守规定。
我应该告诉别人我用了 AI 吗?
遵守文字最终要去的地方的规则。许多职场并不介意一封有 AI 辅助的邮件,但期刊、课程和一些客户会介意。拿不准就问。
换了模型之后,手册还管用吗?
针对句子形态的规则通常能留下来,针对具体用词的规则很快就过时。Wikipedia 那页给每一代模型列了一套不同的偏爱词,所以每隔几个月就重读一遍你的"从不使用"那一行,并拿一份全新的默认草稿对照一下。
可以把客户的工作内容粘贴进风格工具吗?
先看厂商的数据条款。比如 OpenAI 的页面写明,除非你选择退出,否则你使用自定义指令产生的信息可能被用于改进模型表现。无论如何,样本里都要去掉人名和机密细节。