

对大多数人来说,Perplexity 是 2026 年最好的 AI 研究助手;而当答案必须来自你自己的文件时,选 NotebookLM。除了这两个,该怎么选取决于你研究的是什么:论文、临床问题、一堆 PDF,还是开放网络。下面的排行榜列出了前 25 名,本文会重点讲其中值得你花时间的几款。
这个品类看起来很拥挤,其实分得很清楚。有的工具搜索网页,有的只读你给它的内容,有的搜索学术文献,还有一个大牌是专为临床医生打造的。好选择和高风险选择的区别,在哪儿都一样:你得看得到每条结论出自哪里,而且能自己核实。
这个问题贯穿全文。引用就是这类产品的核心,而引用也可能出错。
当前 Top 25
- # 2亚军NotebookLM移动应用NotebookLM 是一个个性化的 AI 研究助手,帮助用户理解任何主题。它提供用户友好的界面和强大的功能,以提高生产力并简化研究过程。74ToolRank强劲
- # 3季军OpenEvidenceAI 应用OpenEvidence是美国官方的医学知识平台,旨在为医疗专业人员提供服务。它提供基于证据的答案,基于来自领先医学期刊的同行评审研究,增强临床决策能力。73ToolRank强劲
- 4OpenAI PrismAI 应用OpenAI Prism 是一个免费的 LaTeX 编辑器和 AI 原生工作空间,专为科学家设计。它集成了 ChatGPT 和 Codex,以增强科学写作和协作,提供 AI 辅助的校对、引用和格式化功能。64ToolRank强劲
- 5SciSpace AI for ResearchAI 应用SciSpace 是一款为学术界设计的 AI 研究助手,能够对超过 2.8 亿篇论文进行系统性文献综述,并协助撰写引用来源的论文。受到全球数百万学生、博士和研究人员的信赖。62ToolRank强劲
- 7ConsensusAI 应用Consensus 是一款 AI 驱动的学术搜索引擎,通过分析同行评审文献来加快研究进程。它能帮助用户以 10 倍速度查找、整理和分析科学论文,把需要数天的文献综述缩短到几分钟。平台提供高级筛选和摘要功能,支持严谨的学术研究。61ToolRank强劲
- 8Westlaw Precision AIAI 应用Westlaw Precision AI 是一款先进的法律研究工具,利用人工智能和可信内容快速提供专家级见解。它帮助法律专业人士自信地从研究转向战略,确保全面且可验证的结果。60ToolRank强劲
- 9ElicitAI 应用Elicit 是一款人工智能驱动的研究助手,可帮助科学家和研究人员从超过 1.38 亿篇学术论文中查找、总结和提取数据。它可自动执行系统性文献综述,生成研究报告,并提供句子级引文以确保准确性,从而在各个行业实现更快的发现和循证决策。60ToolRank强劲
- 11PatSnap AI创新平台AI 应用PatSnap是一个由人工智能驱动的平台,提供专利搜索、撰写、监控和知识产权分析。它利用超过20亿个专家数据点,将研发生产力提升75%,受到全球超过15,000名创新者的信赖。58ToolRank稳健
- 12Semantic ScholarAI 应用Semantic Scholar 是一款免费的、由人工智能驱动的研究工具,旨在帮助学者发现相关的科学文献。它利用先进的人工智能和工程技术来理解研究论文的语义,从而更容易地查找和参与所有科学领域的学术内容。该平台旨在提高研究的可访问性和上下文理解。57ToolRank稳健
- 13Rayyan AI 审阅平台AI 应用Rayyan 是一个由 AI 驱动的平台,旨在加速研究人员的系统性文献回顾和文献综述。它自动化了筛选、去重和数据提取等关键任务,使团队能够更快、更高效地综合证据。Rayyan 获得全球超过一百万研究人员的信赖,简化了整个审阅工作流程。56ToolRank稳健
- 14Readwise ReaderAI 应用Readwise Reader 是一款为重度阅读者设计的全面的稍后阅读应用程序。它将文章、PDF 等内容整合到一个地方,提供强大的搜索和高亮功能。55ToolRank稳健
- 15ResearchRabbitAI 应用ResearchRabbit 简化了文献综述,帮助研究人员发现相关论文、构建引文图谱并跟踪研究趋势。它将学术文献的探索从一项繁琐的任务转变为一个由好奇心驱动的发现过程,为学者和学生节省宝贵时间。55ToolRank稳健
- 17HebbiaAI 应用Hebbia 是一个专为金融专业人士设计的 AI 平台,提供机构智能,以支持高风险决策。它连接到金融数据源,使用户能够分析文档、发现见解并自动化工作流程。Hebbia 受到领先金融机构的信赖,旨在提高速度并影响投资流程。53ToolRank稳健
- 18LinerAI 应用Liner 是一款由 AI 驱动的工具,旨在增强网页浏览和研究体验。它允许用户高亮、整理和保存网页内容,从而创建一个个性化的知识库。该平台旨在为需要高效管理在线数据的学生、研究人员和专业人士简化信息发现和记忆过程。53ToolRank稳健
- 19Scopus 数据库AI 应用Scopus 是一个全面的摘要和引用数据库,提供科学、技术、医学和社会科学文献的访问。它为研究人员提供先进的搜索工具和指标,以识别趋势、寻找合作者并衡量研究影响。53ToolRank稳健
- 21Dimensions AIAI 应用Dimensions AI 是一个综合研究数据库,连接资助、出版物、数据集、临床试验、专利和政策文件。它提供研究分析工具,使用户能够快速浏览和解读全球研究数据,以获取战略洞察。52ToolRank稳健
- 22InstrumentlAI 应用Instrumentl 是一个由人工智能驱动的资助管理平台,帮助非营利组织高效地寻找、赢得和管理资助。它提供了一个全面的数据库、基于人工智能的匹配以及提案撰写和后期管理工具,所有功能都在一个工作空间中。51ToolRank稳健
- 23GPT ResearcherGitHub 仓库GPT Researcher 是一款自主智能体,旨在对任何主题进行深度研究,生成带有引用的详细、客观和公正的报告。它利用规划器和执行智能体来生成研究问题并收集信息。该工具提供自定义选项,并支持各种文件格式以进行本地研究。51ToolRank稳健
- 24Connected PapersAI 应用Connected Papers 是一款为研究人员和应用科学家设计的可视化工具,用于发现和探索与其工作相关的学术论文。它生成相似论文的交互式图谱,帮助用户直观地理解某一领域的趋势、热门文献和动态,确保不错过任何重要的研究。51ToolRank稳健
- 25Atlas.tiAI 应用Atlas.ti 是一款领先的定性数据分析软件,为研究人员、学生和企业提供 AI 驱动的工具。它支持多种数据格式,并提供直观的功能以实现高效分析和协作。50ToolRank稳健





ToolRank 如何运作
ToolRank 是 ToolPotion 自主研发的排名引擎。
它持续评估来自开放网络的数百项信号——真实流量与热度、受众与社区实力、权威性与持久度、采用率与参与度——处理数以百万计的数据点,让每个工具都排在它应得的位置。
每一类 AI 都有专属的衡量模型:证明一款 SaaS 应用有吸引力的依据,并不适用于开源框架或创作者频道。缺少某个平台的数据从不会让工具吃亏——ToolRank 只评估现有的证据。
没有付费排名,没有自报数据。
快速推荐
- 综合最佳是 Perplexity,它在 2026 年榜单上位居第 1,ToolRank 为 91,属于顶级梯队,领先第二名 18 分。
- 最适合处理自己文档的是 NotebookLM(现已更名为 Gemini Notebook),因为它只根据你上传的资料作答,不会去别处找内容。
- 学术文献方面,想快速了解研究怎么说,用 Consensus;想从论文里提取数据,用 Elicit。
- Semantic Scholar 是最好的免费学术工具,背后是一家非营利研究机构。
- 临床医生可以看看 OpenEvidence,它专为医学问题打造。
- 做系统综述的人应该先从 Rayyan 开始,它能搞定繁琐的文献筛选。
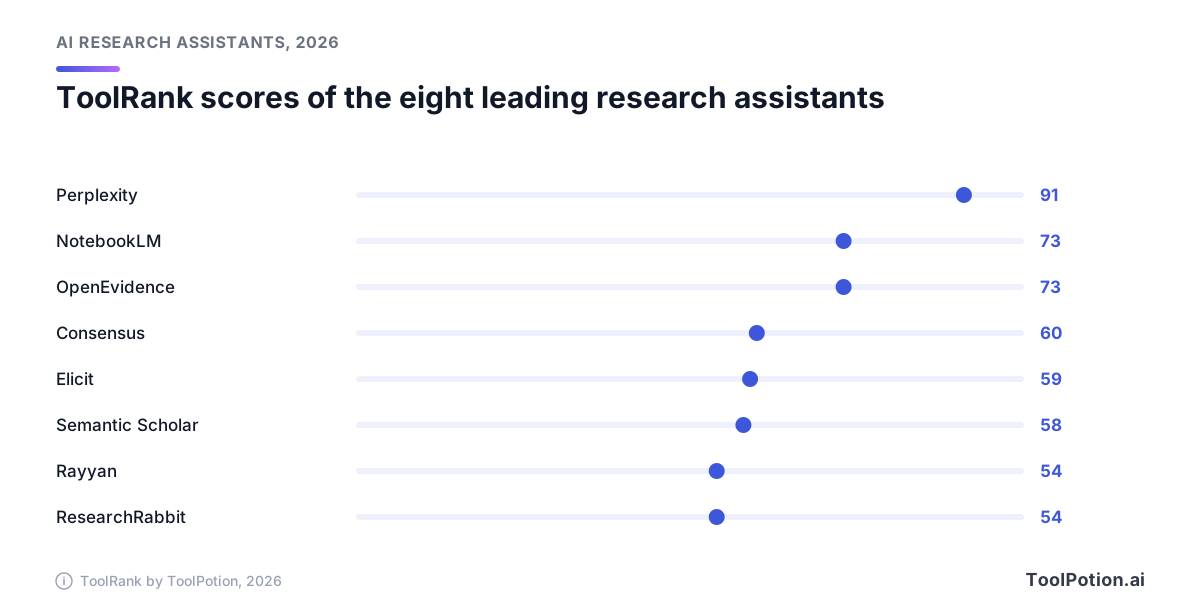
以上是 AI 研究助手 Top 100 榜单上的领先者。下图可以看出中间梯队有多挤,以及 Perplexity 领先它们多远。
2026 年有什么变化
Google 在 2026 年把 NotebookLM 更名为 Gemini Notebook。官方称它仍是同一个独立产品,现在多了一台安全的云端计算机,可以针对你的资料运行代码,并称用户已超过 3000 万(Google)。我们的榜单仍沿用 NotebookLM 这个名字。NotebookLM 也是领先者中上升幅度最大的,在 2026 年榜单上从第 10 名升到了第 2 名。
OpenEvidence 对医疗专业人士仍然免费,资金来自制药公司等方面的广告。它的 CEO 表示希望改变这一模式(NBC News)。至于改由谁来付费,目前还没人说。
没那么让人高兴的变化出在论文这边。今年早些时候,arXiv 开始对论文中存在未经核查的 AI 产出(包括幻觉出来的参考文献)的作者处以一年的投稿禁令(SMU Libraries)。你引用了,就得负责。这是现在的新底线。
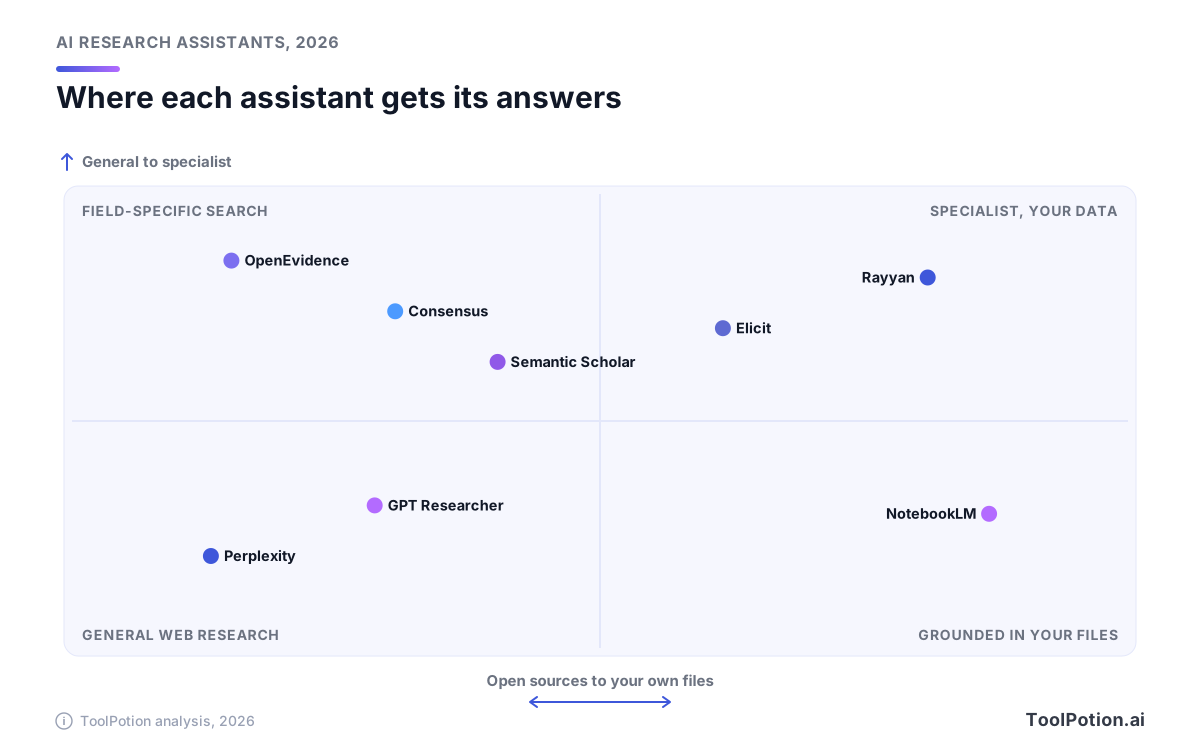
下面这张图按答案来源和专业程度对这个领域做了分类。
信任问题就是引用问题
一个有依据的答案要经过五个步骤才能生成,每一步都可能混入错误。
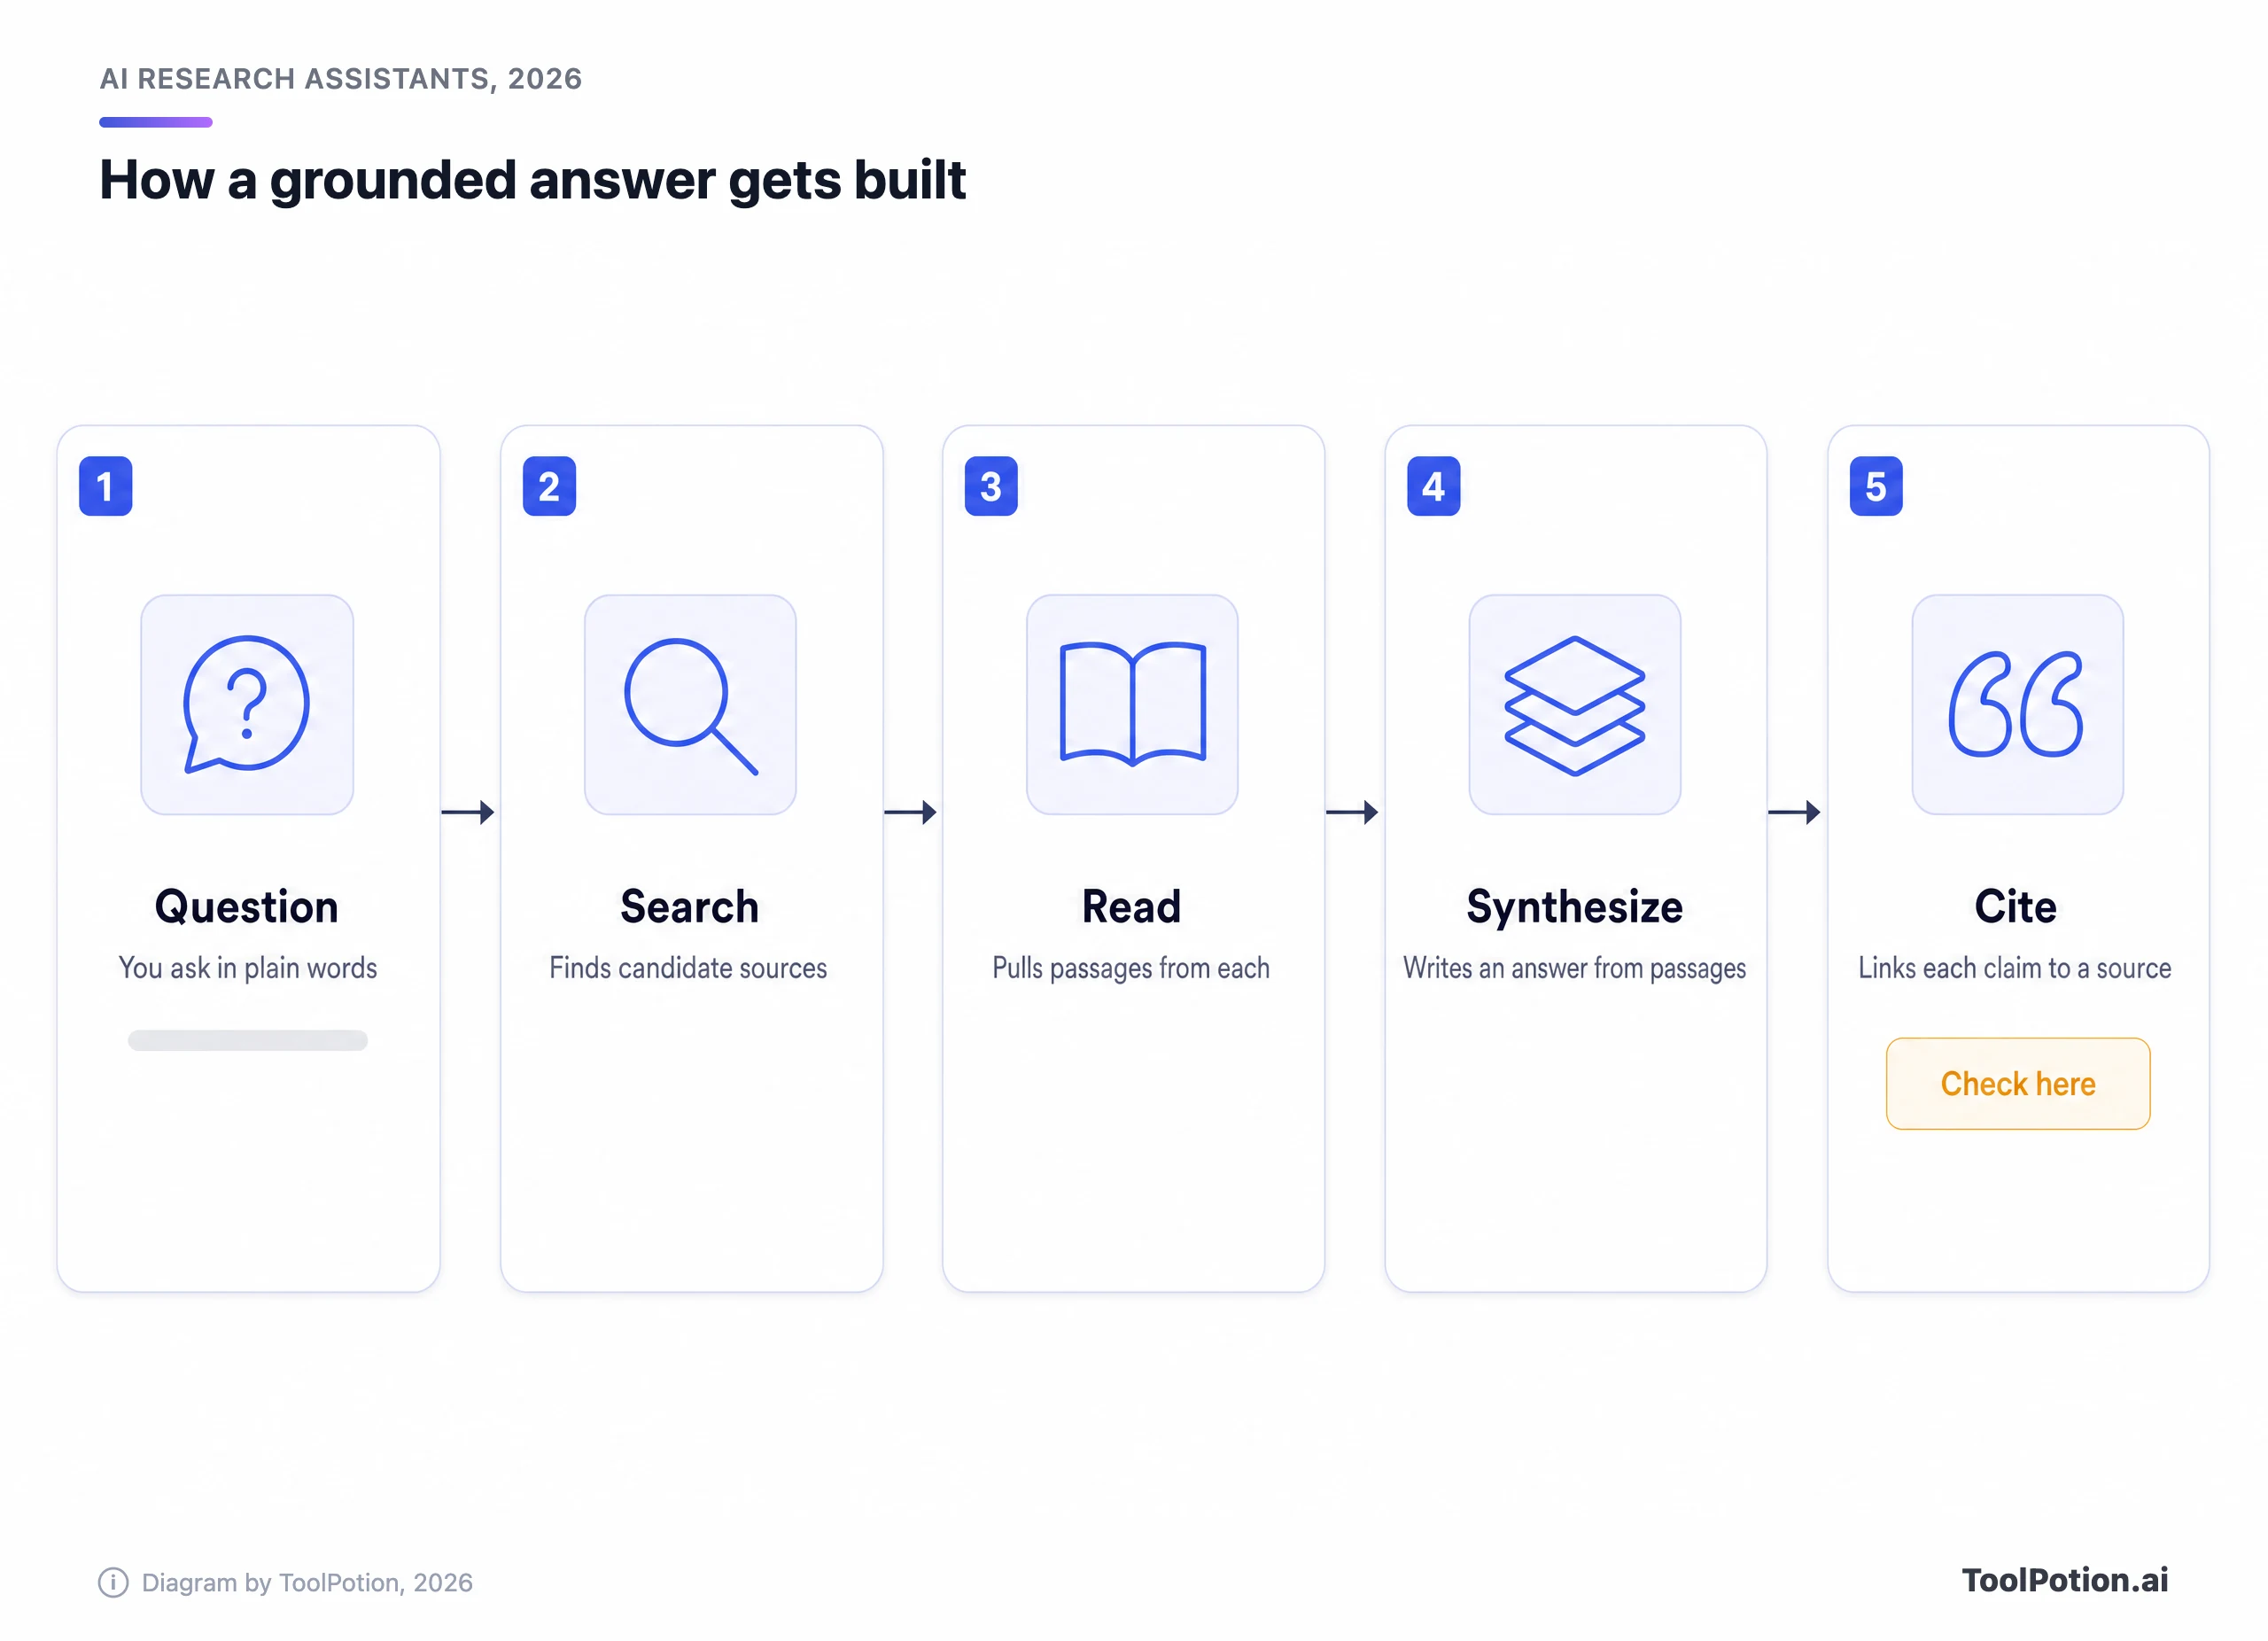
搜索可能漏掉关键论文。阅读可能只停留在摘要。写作环节可能偏离原文内容。最后一步还可能给一条并不支持的结论配上一个真实的链接。香港科技大学图书馆员的一项测试发现,Scite 能获取全文,而其他工具大多只给出摘要(HKUST Library)。
最广为人知的审计来自哥伦比亚大学的 Tow Center。他们给八个 AI 搜索引擎提供新闻文章的节选,要求每个引擎指出标题、发布机构、日期和 URL。总体上,它们答错了超过 60% 的查询。Perplexity 表现最好,错误率为 37%,但 Perplexity 和 Grok 的付费版比免费版错得更自信,还有几款工具引用了编造的或失效的链接(Columbia Journalism Review)。这项测试衡量的是引擎对新闻节选的溯源能力,而不是对学术论文的引用能力。把它当作对"过度自信"的警示,不要当成对某个工具的定论。
就论文而言,最有力的证据其实来自普通聊天机器人,这恰恰说明了"有依据"为什么重要。Deakin University 的研究者让 GPT-4o 写了六篇心理健康主题的文献综述。它给出的引用中,19.9% 是编造的,而真实引用里有 45.4% 存在错误,比如 DOI 不对(EurekAlert)。有价值的是其中的规律:在研究充分的抑郁症主题上,编造率为 6%;在两个研究较少的主题上,则是 28% 到 29%。
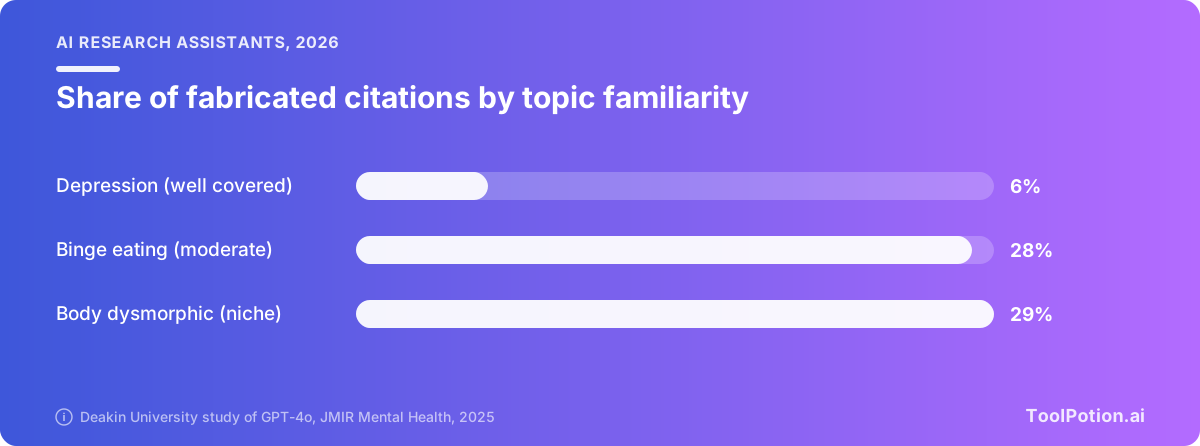
专用的研究助手表现更好,但并不完美。在 HKUST 的测试中,Scite、Elicit、Consensus 和 Scopus AI 针对一个关于睡眠与体重增加的问题,都返回了真实的引用。但要把每个论点和对应的来源匹配起来,就是另一回事了,Scopus AI 最弱,它的论点得不到来源的支持。图书馆员认为这些输出只能作为起点,不能取代文献综述。这只是一个研究充分的主题上的一个问题,所以在冷门主题上,预计结果会更差。
所以工作原则很简单:用一条结论之前,先打开来源。重要的内容再跑一遍。新工具先拿你已经非常熟悉的主题来测试。
主要产品评测
Perplexity:最适合在开放网络上快速获得带引用的答案
Perplexity 在 2026 年榜单上排第 1,ToolRank 为 91,是榜上唯一的顶级得分。它搜索网页,并把来源放在答案旁边,所以第一轮很快,第二轮核查也方便。问题就是 Tow Center 发现的那个:在八个引擎里它错得最少,但在要求溯源新闻节选时仍有 37% 的错误率,不过这与引用论文是不同的任务。Pro 增加了模型切换和更深入的研究功能,价格为每月 $20,Max 是 $200,数据来自 CloudZero 的 2026 年定价指南,另外还有免费版。
NotebookLM:最适合答案必须来自你自己文件的场景
NotebookLM 排第 2,得分 73,属于强力梯队。你上传论文、笔记或访谈转录,它只根据这些内容回答,编造事实的空间就小了。反过来说,你忘了加进去的东西它也无从知道。免费版允许 100 个笔记本、每个笔记本 50 个来源、每天 50 次对话,付费的 Google AI 套餐会提高这些上限(Google Help)。对于一个论文资料夹或一堆报告来说,它是榜上最合适的选择。
OpenEvidence:最适合临床医生核查文献
OpenEvidence 排第 3,同样是 73 分、强力梯队,也是榜首附近唯一的医学专用工具。它根据同行评审期刊回答临床问题,对医疗专业人士免费。关于准确性的证据仍然不足。一篇预印本用 MedXpertQA 执业考试数据集中的 100 个亚专科场景做了测试,发现其快速搜索的准确率最高 34%,Deep Consult 为 41%,作者认为专家监督仍然不可或缺(medRxiv)。这只是预印本,而且题目很难。不过话说回来,这类工具不能取代临床医生,也没有人应该用它代替医生。
Consensus:最适合快速了解研究怎么说
Consensus 排第 4,得分 60,强力梯队,在 2026 年榜单上从第 6 名上升。它搜索学术论文,所以一个是非题得到的是一份研究摘要,而不是一堆网页。在 HKUST 的测试中,它给出了长而有条理的摘要,每份约有十条引用。下单前请先看它的官方定价页了解当前套餐。
Elicit:最适合从大量论文中提取数据
Elicit 排第 5,从第 8 名上升,得分 59,属于稳健梯队。它的强项是提取:你建一张论文表格,让它从每篇论文里提取同样的信息,比如样本量或结果指标。免费的 Basic 方案可检索 1.38 亿篇论文。Pro 为每月 $49(每年 $588),增加了可筛选 5,000 篇论文的系统综述工作流,Scale 是 $169(Elicit pricing)。从免费升到 $49 的跨度很大,而真正重要的功能都在后面。
Semantic Scholar:最好的免费学术搜索
Semantic Scholar 排第 6,得分 58,在 2026 年榜单上从第 4 名下滑。它首先是搜索引擎,其次才是助手,由非营利机构 Allen Institute for AI 打造。它收录超过 2 亿篇论文,完全免费(Semantic Scholar)。没有聊天窗口替你思考。对很多学生来说,这反而是优点。
Rayyan:最适合系统综述的文献筛选
Rayyan 排第 8,得分 54。团队用它按纳入标准筛选成千上万条标题和摘要,由 AI 提示哪些可能相关。免费版包含 3 个进行中的综述和 2 名免费评审员,Essential 按年付费起价为每月 $4.99(Rayyan)。它是一个工作流工具,别指望有个输入框能直接给你写答案。
ResearchRabbit:最适合从几篇种子论文出发梳理一个领域
ResearchRabbit 从第 16 名升到第 9 名,得分 54。你从信得过的论文出发,它会生成相关研究的集合和引用图谱。它负责找论文,不负责总结。搭配一个阅读工具使用,它在项目早期、你还不了解这个领域长什么样的时候最有价值。
Scite:最适合查看后续论文是否支持某个结论
Scite 排第 10,得分 54。它的 Smart Citations 会显示后续研究是支持还是反驳某篇论文,这正是单纯的引用次数所掩盖的背景信息。在 HKUST 的对比中,它的摘要是四款里最全面的,也是唯一抓取了全文的。搜索和助手功能需要付费方案,按年付费起价为每月 $20(Scite pricing)。当某个结论重要到你想知道谁反驳过它时,可以试试。
GPT Researcher:最适合做深度网络研究的开源选择
GPT Researcher 排第 17,得分 50,是前 25 名中唯一的开源项目。由一个规划 agent 撰写研究问题,其他 agent 收集材料,再由发布 agent 汇编成带引用的报告。项目采用 Apache-2.0 许可证,GitHub 上约有 29,900 颗星(GitHub)。你需要自己运行并提供模型,所以更适合开发者和爱折腾的人,而不是赶截止日期的学生。
另外还有三款上榜但尚未打分。Scopus Database(第 7 名)是引文数据库,Readwise Reader(第 11 名)是稍后阅读应用,Atlas.ti(第 15 名)用于定性分析。它们都有用,但和其他工具不是同一类,所以没有放进上面的图表。
如何选择
先看你做的是哪种研究,因为这基本决定了大部分选择。价格其次,产品是否好看放最后。
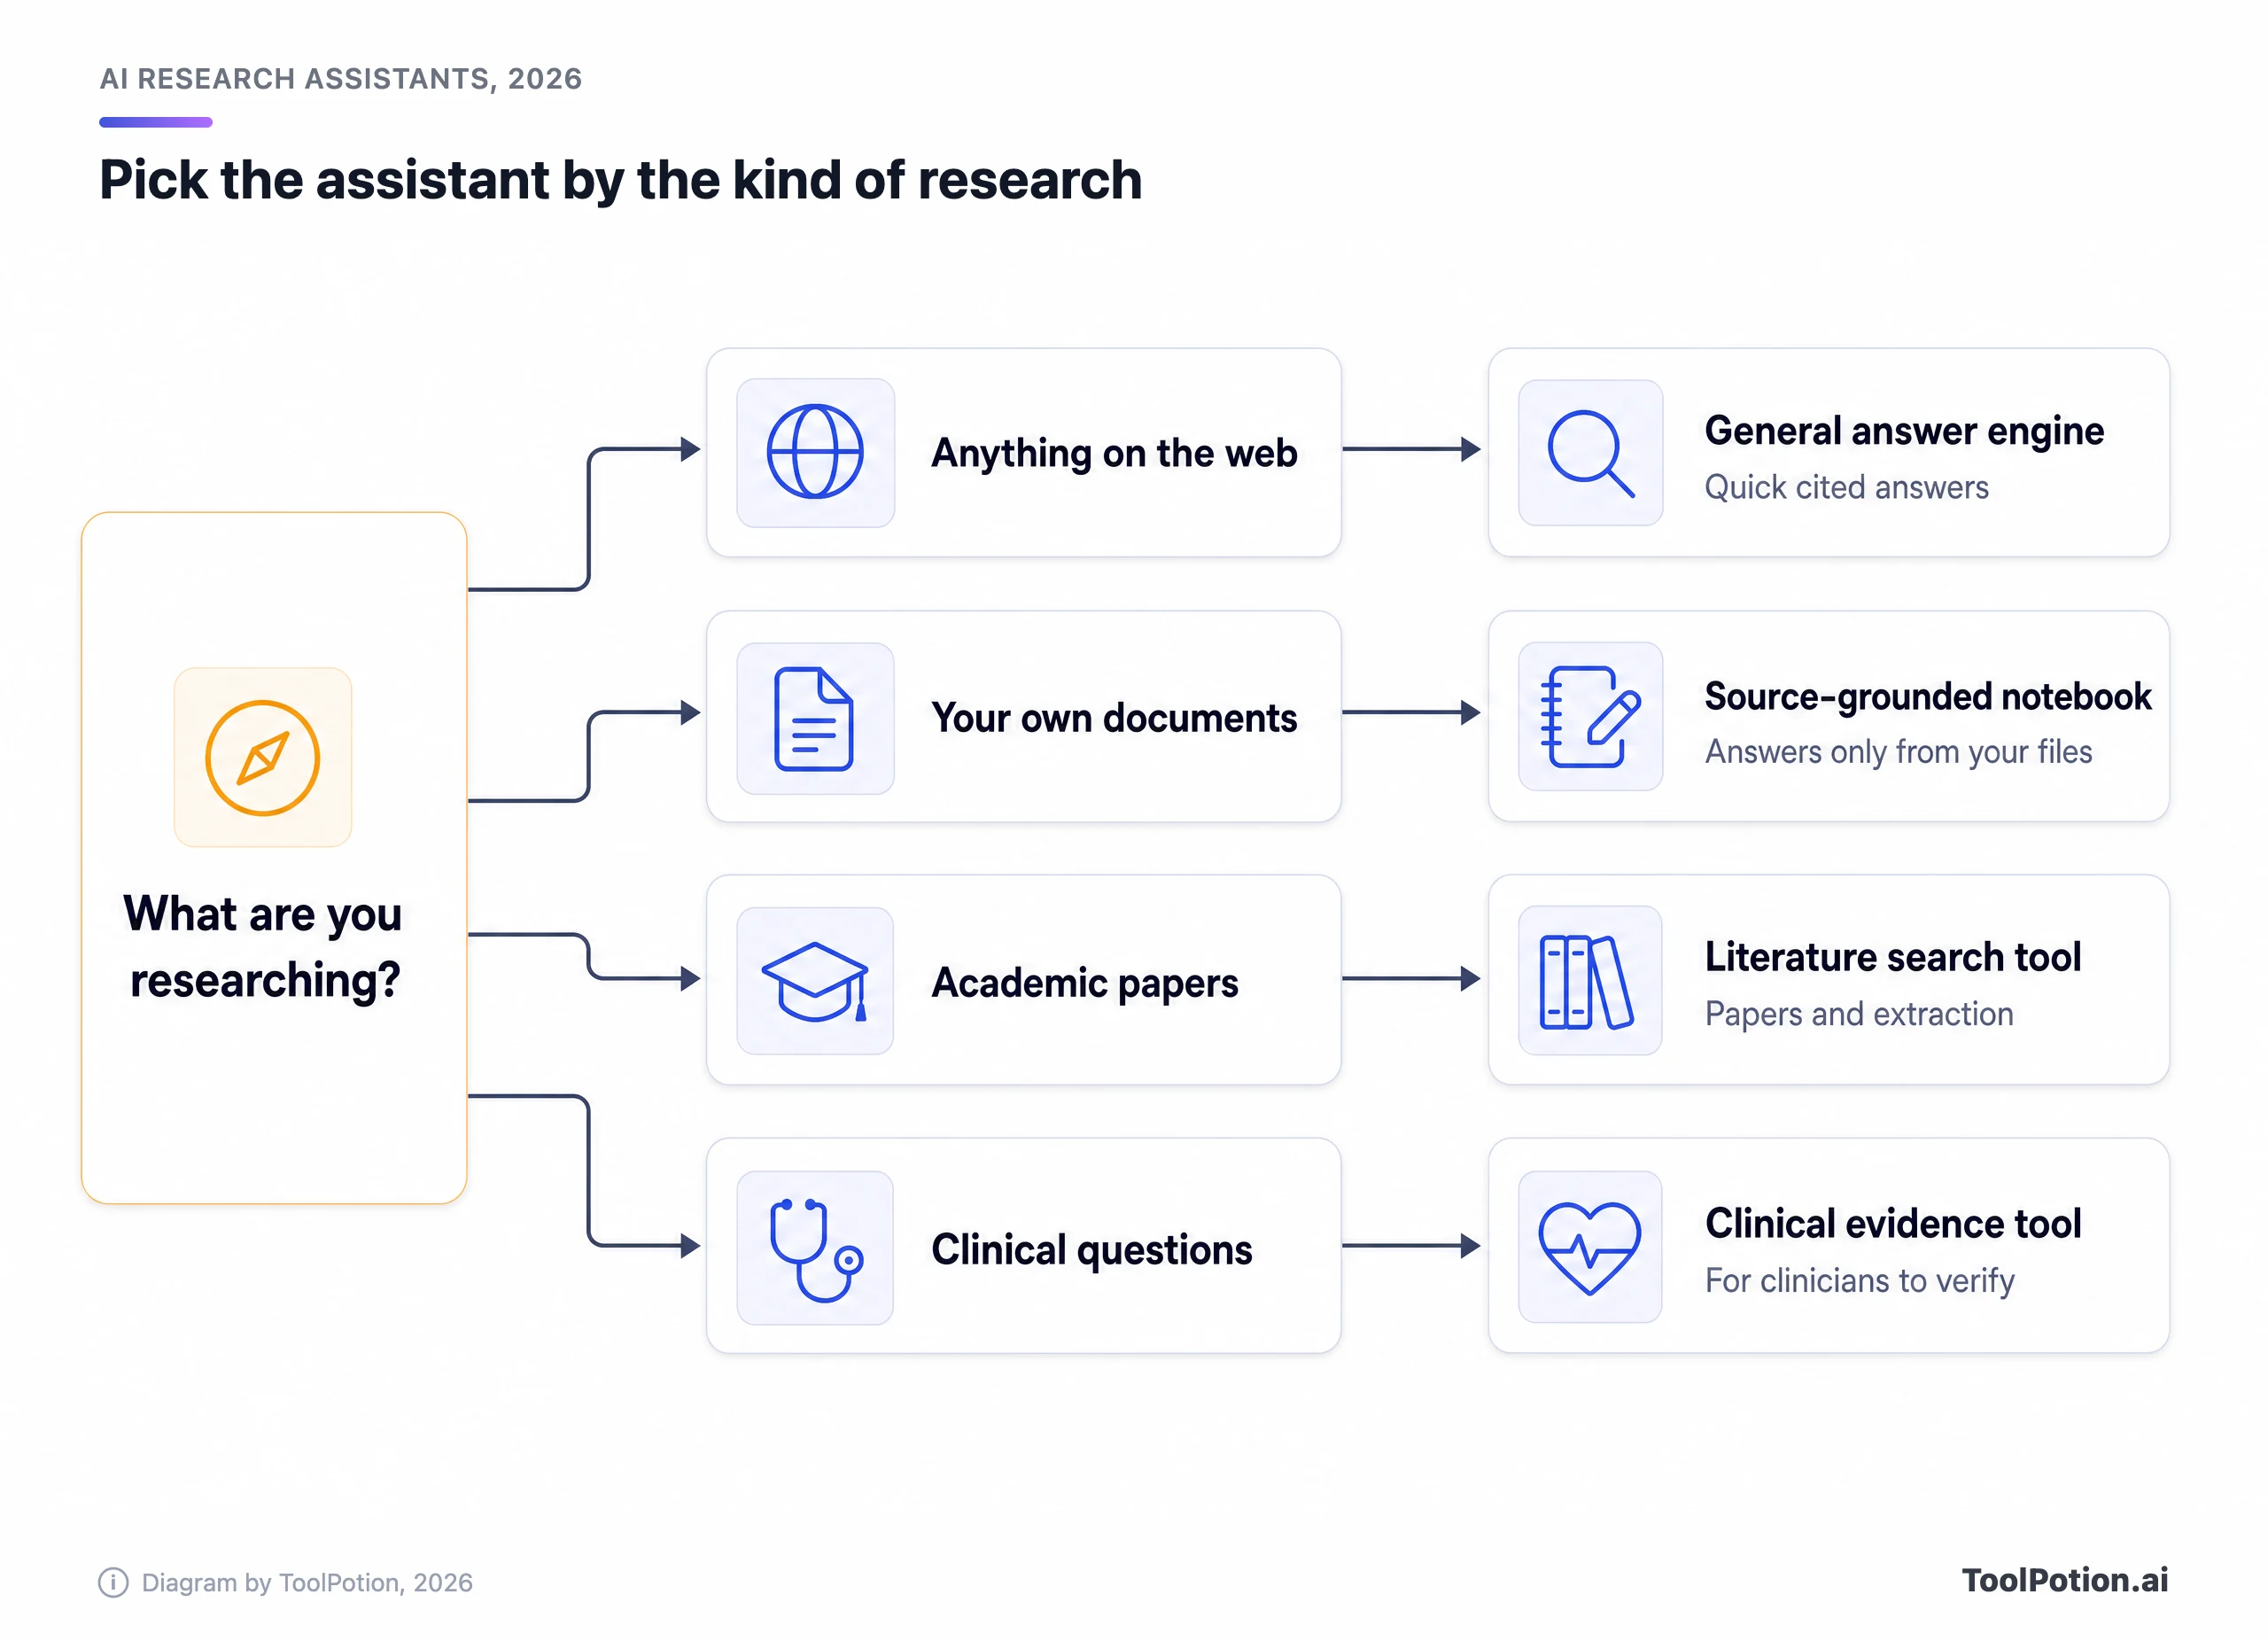
写文献综述是最常见的难题。用 Consensus 或 Semantic Scholar 找现有研究,用 ResearchRabbit 顺着引用线索往下追,用 Elicit 提取数据,如果综述需要走正式流程,再加上 Rayyan。如果你面对的是一组固定的报告或访谈,NotebookLM 胜过以上所有工具。如果只是想快速得到一个你能自己验证的主题的答案,Perplexity 就够了。
有两种情况要格外小心。凡是医学问题都应该交给专业人士,OpenEvidence 是给临床医生用的,不是给患者的。还有冷门主题,Deakin 的数据就是在这里飙升的,每一条参考文献都要打开看。
价格没有免费版重要,所以先试免费版。下表按搜索范围和收费对九款领先产品做了分类。有些数字我们无法确认,表中会注明。
关于 ToolRank
ToolRank 是 ToolPotion 对 AI 工具的独立排名,排名无法用钱买到。每个榜单都会为每个已打分的条目显示分数和梯队。你可以在 ToolRank 排行榜页面浏览所有榜单。
让研究者白白浪费时间的错误
最常见的是用通用聊天机器人来生成参考文献。Deakin 的数据说明了为什么行不通,arXiv 的禁令则说明了后果。会展示检索过程的研究助手是更安全的起点,只读你自己文档的则更安全。
第二个是第一天就买最高档套餐。Perplexity 的 Max 档是每月 $200,Elicit 的 Scale 档是 $169,两者都是为重度使用设计的。大多数学生和分析师根本用不到那个上限。先从免费版开始,碰到瓶颈,再为你真正碰到的瓶颈付费。
第三个是把摘要当成文献综述。工具能告诉你十篇摘要说了什么,但它没法告诉你哪些研究薄弱、哪些已经过时,或者这组文献里缺了什么。这部分仍然是你的工作,也是人类读者真正体现价值的地方。
最后一个是向非医学工具提医学问题,还因为答案看起来很专业就信了。别这样。
值得关注的上升新秀
Connected Papers 从第 15 名升到第 13 名,用可视化图谱展示论文之间的关系。还有几款较新的工具紧随 Top 25 之后。Ai2 Asta(第 27 名)来自开发 Semantic Scholar 的同一家机构,把文献理解和数据驱动的发现结合在一起。Keenious(第 34 名)根据你正在写的内容推荐论文,并能接入 Word。PapersFlow(第 32 名)在 AI 工作空间里提供文献综述功能,AnswerThis(第 40 名)则给出带直接引用的回答。STORM(第 33 名)是斯坦福的研究原型,可以起草带来源的维基百科风格文章。
AI 研究助手完整目录里有其余的工具。如果你的工作更细分,相关榜单是更好的起点,比如用于搜索学术文献的 AI 工具、面向研究人员的 AI 工具、学术写作与引用以及与 PDF 文档对话的工具。或者回到上面的实时研究助手排行榜,看看所有工具的位置。
常见问题
最好的免费 AI 研究助手是什么?
Semantic Scholar 完全免费。Perplexity、NotebookLM 和 Elicit 也有免费版,NotebookLM 的免费版每个笔记本允许 50 个来源。在花钱之前,先从这些开始。
AI 研究助手会编造引用吗?
会。普通聊天机器人最容易这样,正如 Deakin 的研究所示,有依据的工具则少一些。即使引用是真的,也可能被配到论文根本没提出的结论上,所以每次都要打开来源看。
NotebookLM 和 Gemini Notebook 是同一个东西吗?
是的。Google 在 2026 年将其更名,并称它仍是一个独立产品。
OpenEvidence 免费吗?
对医疗专业人士免费,由广告买单。它是为医疗专业人士打造的,不能取代临床医生的判断。
做文献综述哪个工具最好?
没有哪一个能全包。把 Consensus 或 Semantic Scholar 这样的搜索工具,和用于梳理的 ResearchRabbit、用于提取的 Elicit 组合起来,要做正式的系统综述就再加上 Rayyan。
怎么核查 AI 生成的参考文献?
点进去确认这篇论文确实存在。然后确认它说的和答案声称的一致,并到出版商网站核对 DOI。花十分钟做这些,比之后一个被撤回的结论强得多。