

在 2025 年那项 workslop 调查里,有位项目经理收到了上司交来的成果,用她的话说是"质量很差的工作"。她写道,这"浪费了大量时间,也带来很多麻烦",而且因为是老板交来的,她"不好意思当面指出质量问题,更不好意思要求对方重做"。于是她自己把活干了,其他项目只能往后让(BetterUp Labs)。
这个小故事把问题讲透了:无论草稿是谁做的,买单的都是她,搭进去的有她自己的项目,还有"到底能不能开口说"这层顾虑。本文会讲研究发现了什么、怎样在不指责任何人的情况下提出来,以及避免问题反复出现的团队习惯。
调查统计了什么
这个词来自 BetterUp Labs 和 Stanford Social Media Lab 的研究人员,他们把 workslop 定义为"AI 生成的工作内容,看上去像好成果,实则缺乏实质内容,无法真正推进任务"(Fortune)。他们的文章于 2025 年刊发在 Harvard Business Review 上,另有一篇配套文章探讨人们为什么会产出这类内容。调查覆盖了 1,150 名美国全职坐班员工。
约 40% 的人表示,上个月收到过同事发来的 workslop。受访者估计,他们在工作中收到的内容里,约 15% 符合这一描述。每起事件平均需要 1 小时 56 分钟来处理(BetterUp 自己的页面四舍五入为 2 小时),研究人员据此折算为每名员工每月 $186,对一家 10,000 人的公司来说,一年约 $900 万(CNBC)。
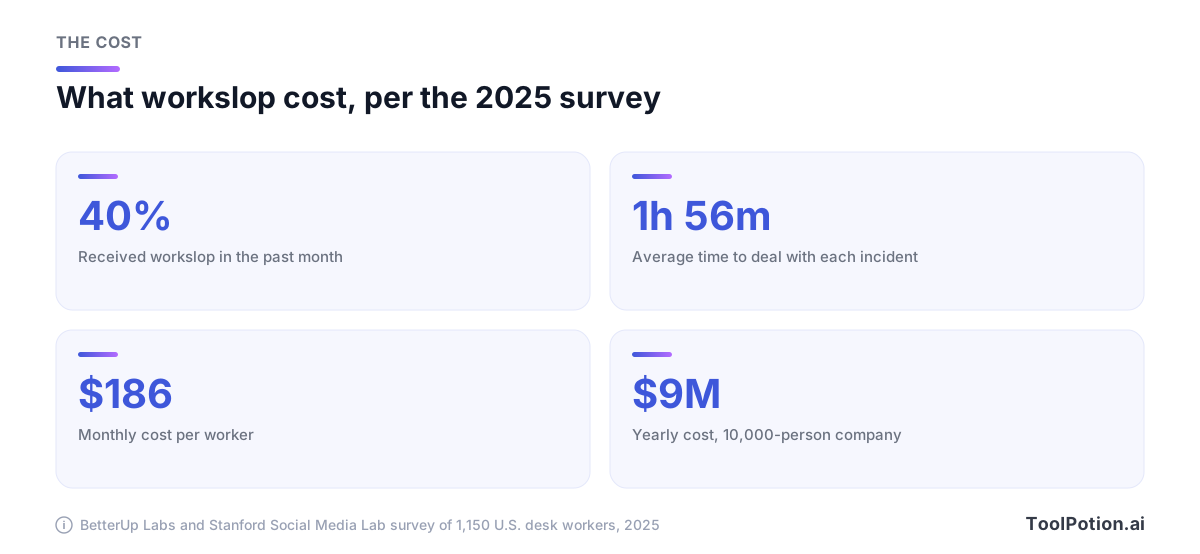
在预算会上引用这些数字之前,有两点要提醒。它们来自一项基于自我报告的调查,美元金额也是用受访者自己报告的薪资推算出来的(Entrepreneur)。我们认为大方向靠得住,小数点后的部分则不必当真。目前还没有人发布过团队解决问题前后的对比研究,我们很想看到一份。
如果要先给一位持怀疑态度的经理看一个数字,我们会选社交层面的成本。据 CNBC 报道,约一半的接收者表示,事后觉得发送者没那么有创造力、能力或可靠性,约三分之一的人还会告诉同事或上司。BetterUp Labs 的 Kate Niederhoffer 谈到自己收到这类内容时的反应:"他们自己完成不了这份工作吗?我不信任他们,也不想再和他们合作。"
不靠猜测来识别
Stanford Social Media Lab 的创始人 Jeff Hancock 对 CNBC 表示,AI 消除了过去限制一个人能产出多少废话的那份成本:"我可以非常轻易地生成大量无用、没有产出的内容。"他点出的迹象是"华丽辞藻堆砌":一个要点就能说清的事,写成三段。CNBC 举的例子包括有问题的代码、信息不完整的演示文稿,以及措辞怪异的邮件。
注意这份清单里有什么:没有一条需要你证明东西是模型写的。报告里的数字是编的,不管是人编的还是聊天机器人编的,都是问题,而这正是你能在会上拿出来说的版本。我们建议在职场沟通中别拿 AI 检测器的分数当证据:百分比只是在猜谁写了这段文字,而缺失的来源、错误的数字、没有给出的决定,任何人都能核实(检测器声称衡量的是什么,可参见 AI 内容检测器榜单和我们的盘点)。
如何一步步向同事提出
CNBC Make It 刊登过一份专门讲这件事的行动指南,作者是高管教练、《Managing Up》一书的作者 Melody Wilding。她的建议我们几乎原样照搬,归结起来是四步(CNBC)。
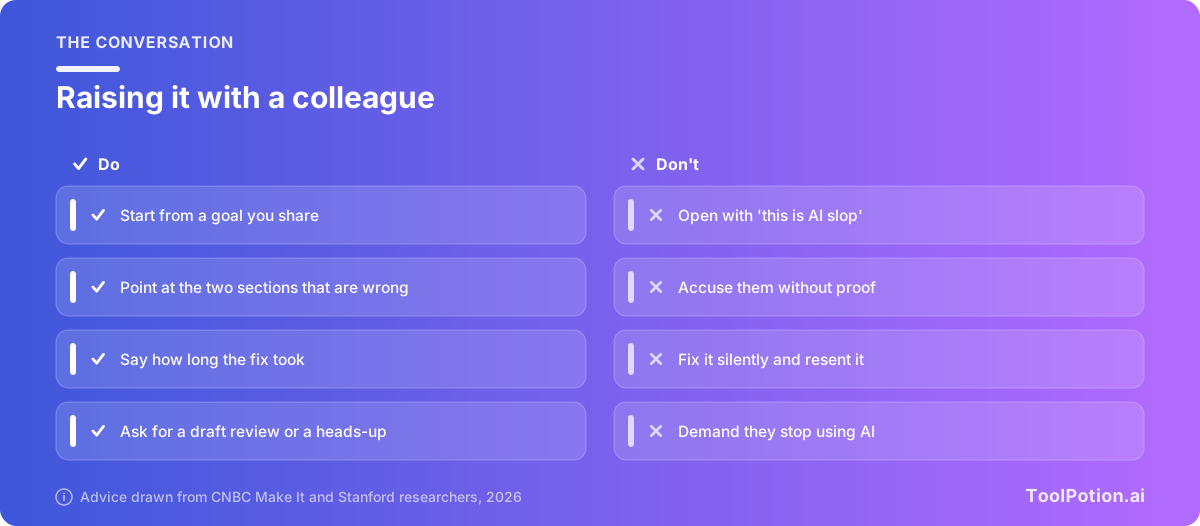
- 以共同目标开场。Wilding 给的示例说法:"我们都希望高管团队对这份东西满意",或者"既然这上面有我们两个人的名字,我想你也会同意,它得经得起客户的审视。"
- 指出具体问题,不要一棍子打死。比如两个章节的数据和你们讨论的对不上,格式在中途变了,某个数字没有来源。
- 说清它的代价。Wilding 的示例:"我花时间重做了这部分,结果不得不把老板的一个项目往后推。"能说出口的代价,很难被反驳。
- 请对方下次做一个改变:AI 草稿发给你之前先快速过一遍,或者用了 AI 就提前打个招呼。Wilding 的说法是:"如果能知道什么时候用了 AI,对我会很有帮助。"
Wilding 提醒不要笼统地说"这整份东西看起来都是 AI 生成的",尤其是在你无法证明的时候:这会让对方陷入防御,也会让焦点偏离真正需要改变的地方。确实要提到 AI 时,她建议先留有余地,并坦承自己也在用:"我可能说错了,但有些部分读起来像是用了 AI。我自己也用,所以这不是问题所在。"我们仍然建议先说缺陷,AI 放在第二位提,甚至不提也行。
当发送者是你的上司
向上沟通更难,调查也说明了原因:上面那位项目经理之所以沉默,就是因为草稿来自她的上司。Wilding 的建议是先承认自己也在用 AI,这等于告诉老板你并不反对这些工具,也能让讨论集中在质量和时间上。然后给出一个具体数字,把成本和他们在意的事挂钩,比如你被迫推迟的那个项目。
在这种场合,真正撑起对话的是你的诉求,而不是抱怨。别要求上司不要用 AI。提出一个他们不丢面子就能答应的小流程调整:转发之前自己先过一遍草稿,或者加一句话说明哪些部分是模型写的。我们不信,当另一种结果是同样的抱怨从三个人嘴里说出来时,经理还会拒绝一个审核环节。
活没有消失,只是转移了
我们一贯的立场是:AI 应该减少工作,而不是把工作转嫁给别人。Workslop 就是后者最典型的例子。发送者的任务缩水成写个 prompt 再粘贴,接收者却要接手核实、重写,还得开个尴尬的会去问对方到底想说什么。
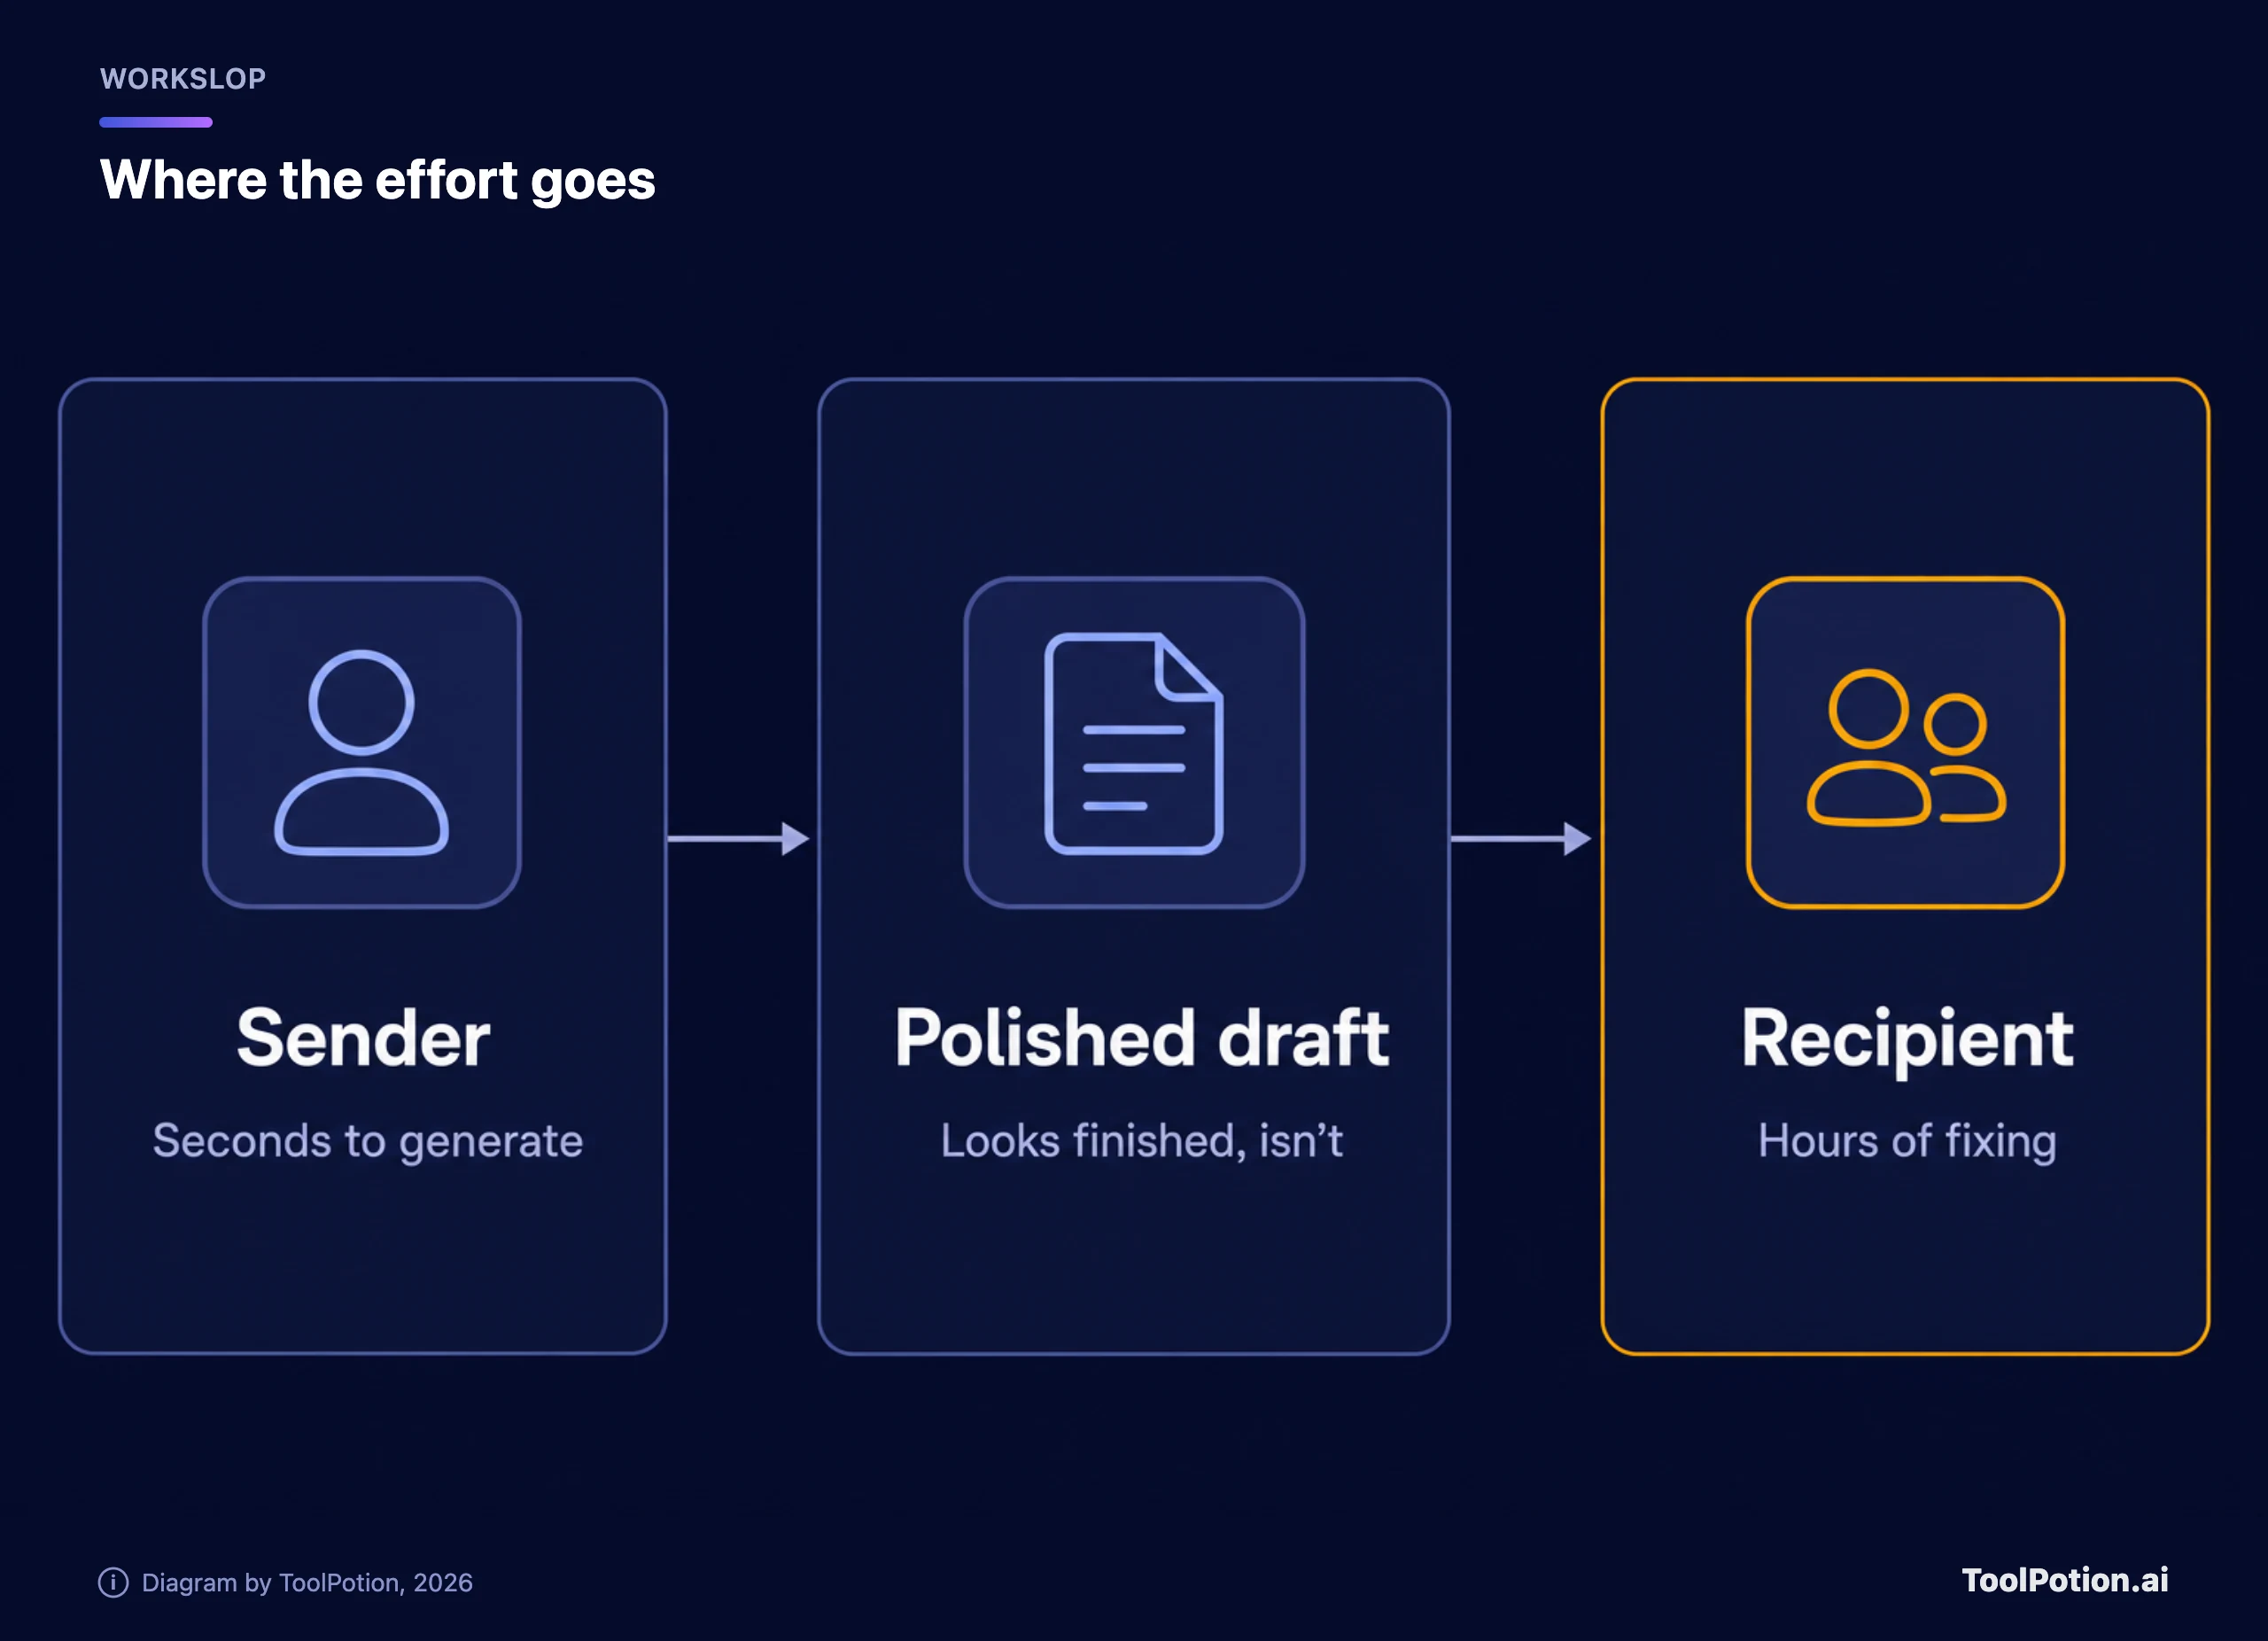
更新的数据也指向同一个方向。Workday 自己的研究是一项覆盖 3,200 名全职员工的全球调查,受访者全都是活跃的 AI 用户。结果显示,85% 的人表示 AI 每周为他们节省了一到七小时,但节省下来的时间里,近 40% 又耗在了返工上:纠正错误、重写内容、核实输出(Workday,2026 年发布;另见 CNBC)。只有 14% 的人持续获得了明确、正面的净收益。这就是收到一份糟糕草稿的人所感受到的情形,放大到了整个公司层面。如果一个团队的"节省时间"只按发送方来算,那它就被高估了,高估的部分正是接收方付出的代价。
这也回答了工具之争。ChatGPT、Claude、Microsoft 365 Copilot 和 Gemini 都能应要求产出光鲜却空洞的东西,也都能产出一份不错的初稿,再由认真的人去修改。Grammarly 在界线的另一边:它处理的是你已经写好的文字。我们不会把 workslop 怪到产品头上,真正改变结果的是习惯。如果你想比较各种写作工具,可以从 ToolRank 的 AI 写作助手榜单和我们的写作助手盘点开始。
真正站得住的团队规范
据 Fortune 报道,Hancock 的建议是团队保持高标准,并公开互相批评:那些关注任务质量的团队会"互相批评,也接受批评",workslop 也更少。研究人员建议,对人和 AI 完成的工作,应当适用与两位同事之间相同的期望(Fortune)。结合这些以及 CNBC 的两篇文章,可以得出三条规范。
用了 AI 就说一声
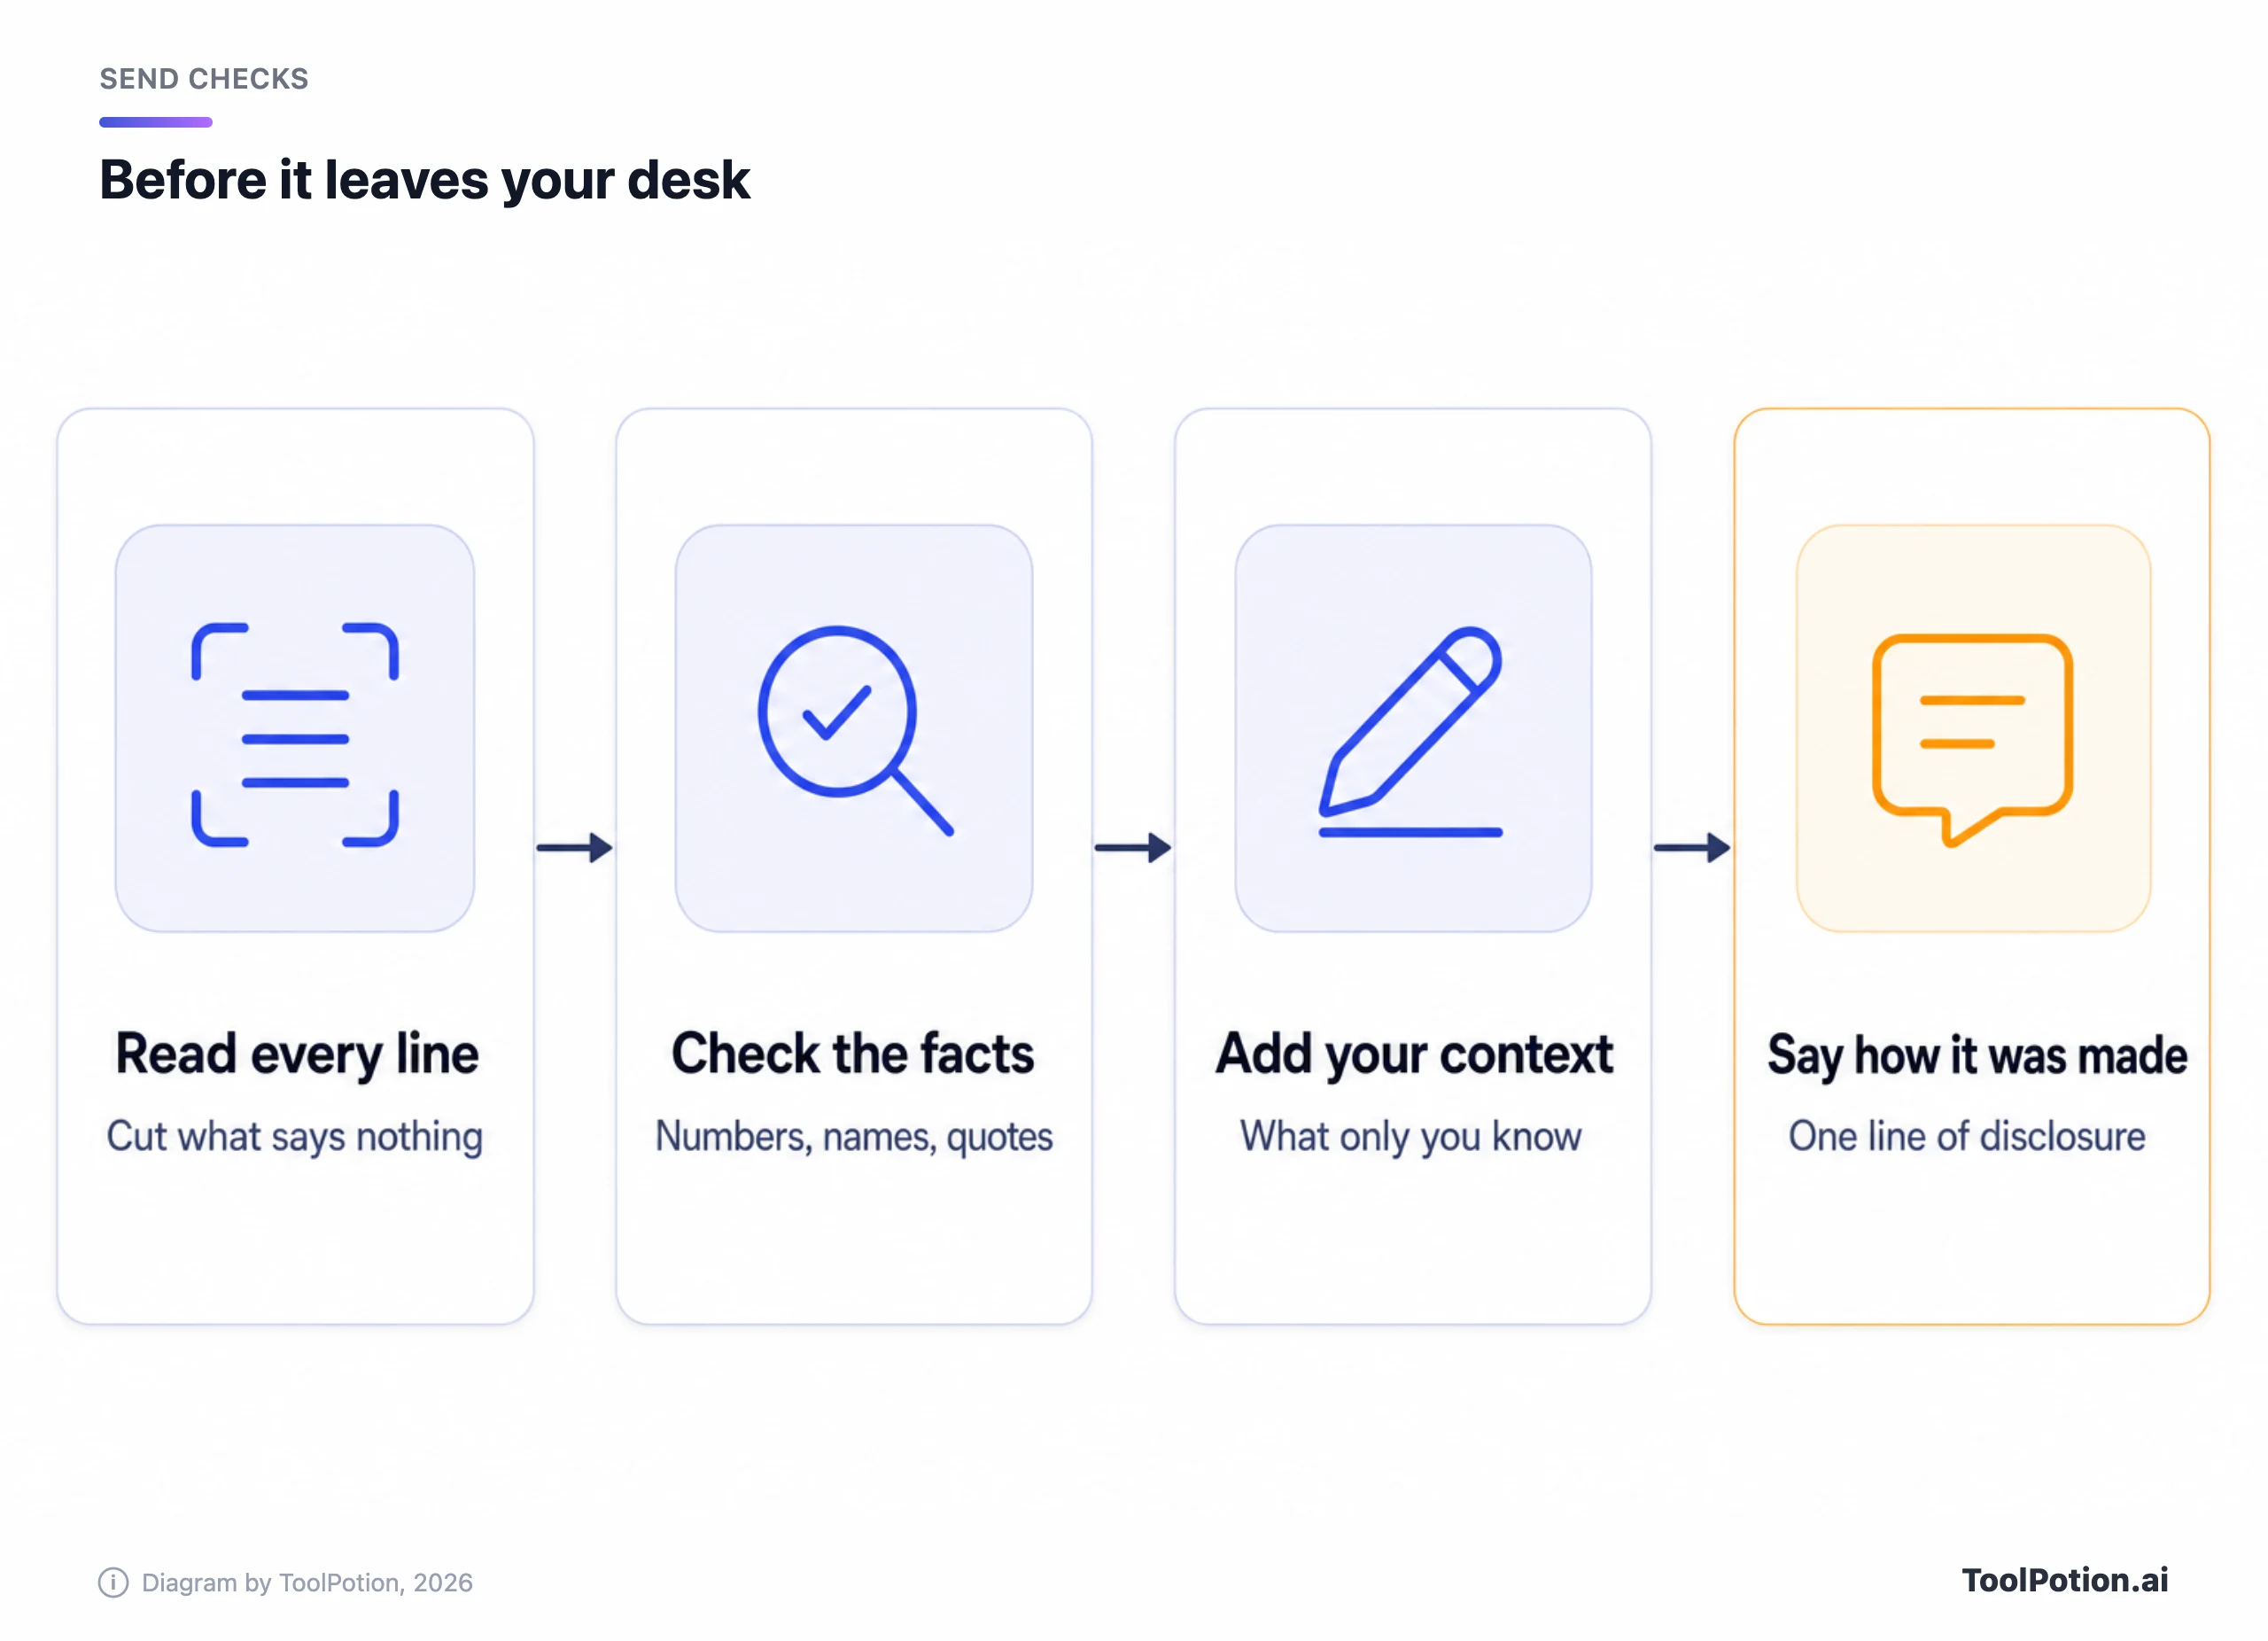
Hancock 对 CNBC 说,披露 AI 的使用,能让同事理解你的 prompt 和目标,并补上缺失的部分。实际做起来就是一句话:"初稿由 Claude 起草,数字已对照财务导出数据核对。"这只需十秒,却能告诉读者该看得多仔细,还省去了让那场沟通变得尴尬的猜谜游戏。把它写进状态更新和报告的模板里,这样谁都不用主动说。
发出之前先自查
第一遍通读是发送者的责任。也就是每一行、每个数字、每处引用、每个链接,都由署名的那个人核对过。我们的AI 输出事实核查指南给出了一套可扩展的核查流程,对团队来说,简短的版本就是:凡是读者可能据此行动的内容,都要核查。
写一份"完成的定义"
大多数 workslop 能蒙混过关,是因为从来没人说过"完成"到底意味着什么。"完成的定义"四行就够:读者是谁,这份文档支持什么决策,每个数字出自哪里,除作者外还有谁读过。答不上这些问题的草稿就没有完成,不管是谁或什么写的。如果你的团队已经有 AI 政策,就把这几行加进去;我们的 AI 使用政策模板里有一个大家比较愿意遵守的版本。
我们建议的第一步是披露,因为它不需要任何工具,也不需要审批。"完成的定义"排第二,因为要开个会才能达成一致。然后用下面的清单看看你的团队已经具备哪些习惯。
哪里会出问题
这类沟通可能以几种可预见的方式适得其反。有些人只是不知道自己的草稿很单薄,他们看到一份听上去很自信的文档就转发了。另一些人会变得防御,通常是因为反馈听起来像是在给他们的能力下判决,而以共同目标开场就是为他们准备的。还有少数人无论你怎么说都会继续发垃圾内容,这种情况下,你该拿去找经理的就是有据可查的时间成本。
还有一种更隐蔽的失败:沦为团队里的固定"修理工"。如果你默默修好每一份草稿,发送者永远学不到教训,而你每次都要自己消化那两个小时。一次坦诚的沟通,成本比一年的收拾烂摊子低得多。它还能给发送者一样模型给不了的东西,那就是同事看到成品后的真实反应,而大多数人宁愿私下从你这里听到,也不想在公开场合从客户那里听到。
没人能确定的是,这类规范能否减少 workslop 的数量。研究人员建议设置护栏并保持"试点"心态,Hancock 自己的发现也是关于高标准团队的,但我们还没见过采用披露规则的团队给出的实测结果。如果你试了,请记录前后你花在返工上的时间。这个数字比任何调查都更能说服你的经理。
常见问题
什么是 AI workslop?
它指的是 AI 生成、看起来精致但缺乏实质内容、无法推进任务的工作成果,收到的同事只能自己动脑、自己收拾。这个词出自 BetterUp Labs 和 Stanford Social Media Lab 2025 年的研究,并刊发在 Harvard Business Review 上。
workslop 会造成多大成本?
在 BetterUp 和 Stanford 对 1,150 名美国坐班员工的调查中,每起事件平均需要约 1 小时 56 分钟处理,研究人员估算为每名员工每月 $186,并推算 10,000 人的公司每年约 $900 万。这些数字是基于一项调查的自我报告估算。
怎样告诉同事他的工作需要修改,又不指责他用了 AI?
指出具体问题(缺失的来源、对不上的数据、中途变化的格式),并把它们和你们共同的目标联系起来。不要猜测这份工作是怎么做出来的。Wilding 的建议是请对方改变流程,比如发送前先审一遍,或者用了 AI 时留个说明。
我该把他们的工作拿去过一遍 AI 检测器吗?
我们不建议。检测器分数只是对作者身份的猜测,发送者完全可以质疑,还会把话题从真正的缺陷上引开。一个错误的数字或一处缺失的来源,要好解决得多。
在工作中用 ChatGPT、Claude、Copilot 或 Gemini 可以吗?
可以,而且很多人已经在用了:Gallup 发现,在 2023 年到 2025 年间,每年至少用几次 AI 来完成本职工作的美国员工比例几乎翻了一番,从 21% 升到 40%(Gallup)。标准和任何其他草稿一样:你读过、核查过,并且愿意署上自己的名字。文档若是从模型起步的,请告诉同事。