

"排行榜第一"这句话,只说明某个模型在某一项测试、某一种跑法、某一天的结果领先。至于它是不是最适合你工作的模型,这句话能告诉你的少得多。因为一个排名就换工具,或者升级到更贵的套餐之前,先搞清楚这个榜单是哪个、谁跑的、测的是什么。
2026 年这件事更值得留意,因为排行榜已经成了一门生意。Arena(前身为 LMArena 的公开排名网站)今年以 31 亿美元估值融资 2 亿美元,估值几乎是 2026 年初 17 亿美元的两倍(Phemex)。Arena 称其年化收入已超过 1 亿美元(Arena)。如今每次模型发布都以排名开场,而排名确实能带来销量。
这并不是说榜单是假的。大多数榜单出自认真做事的人之手,测的也是真东西。问题在于每个榜单测的"东西"各不相同,而发布文章只会引用对自家模型最有利的那一个。本文讲解主要榜单的运作方式、各自的漏洞,以及怎样用两分钟左右读懂一条排名说法。
四类榜单,四个不同的问题
你遇到的大多数排名都属于四类之一。分类比任何单个榜单都重要,因为只有知道数字来自哪一类,它才有意义。
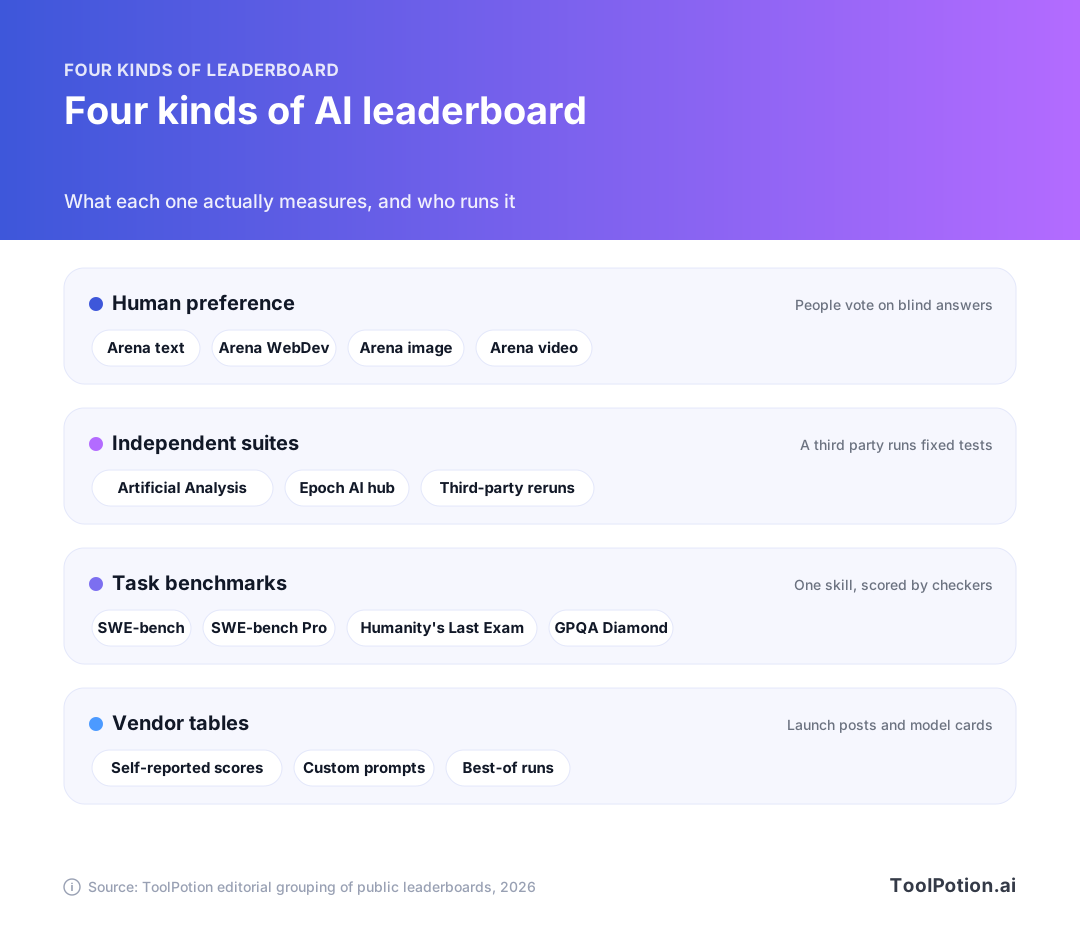
人类偏好竞技场让人们选出自己更喜欢哪个回答。独立测试套件在相同条件下,对每个模型跑一套固定的测试。任务基准测试用自动评分器检验某一项技能,比如修复真实的软件 bug。厂商表格则是实验室在自家发布文章或模型卡里公布的成绩,通常用的是实验室自己挑的设置。
这几类榜单与其说是互相竞争,不如说是在回答不同的问题。偏好榜告诉你,人们更愿意和哪个模型聊天。测试套件告诉你,由中立的第三方计时时,模型之间怎么比。任务基准告诉你,模型能不能完成某一项具体工作。厂商表格告诉你的,则是实验室希望你注意到什么。
| 榜单类型 | 示例 | 衡量内容 | 主要短板 |
|---|---|---|---|
| 人类偏好 | Arena 文本榜和 WebDev 榜 | 人们投票选哪个回答 | 偏向风格和篇幅,可被刷分 |
| 独立测试套件 | Artificial Analysis、Epoch AI hub | 固定测试集上的得分 | 好坏取决于所选的测试 |
| 任务基准 | SWE-bench、Humanity's Last Exam | 单项技能,自动评分 | 数据污染、题目有缺陷、分数饱和 |
| 厂商表格 | 发布文章、模型卡 | 实验室自己选择公布的内容 | 设置和 prompt 无法核实 |
一张竞技场选票如何变成评分
Arena 最初叫 Chatbot Arena,是加州大学伯克利分校的一个研究项目。思路很简单:你输入一个 prompt,两个匿名模型各自作答,你选出更好的那个。研究者的原始论文介绍,这个平台在最初几个月就收集了超过 240,000 张选票,并发现众包投票与专家判断高度吻合(arXiv)。
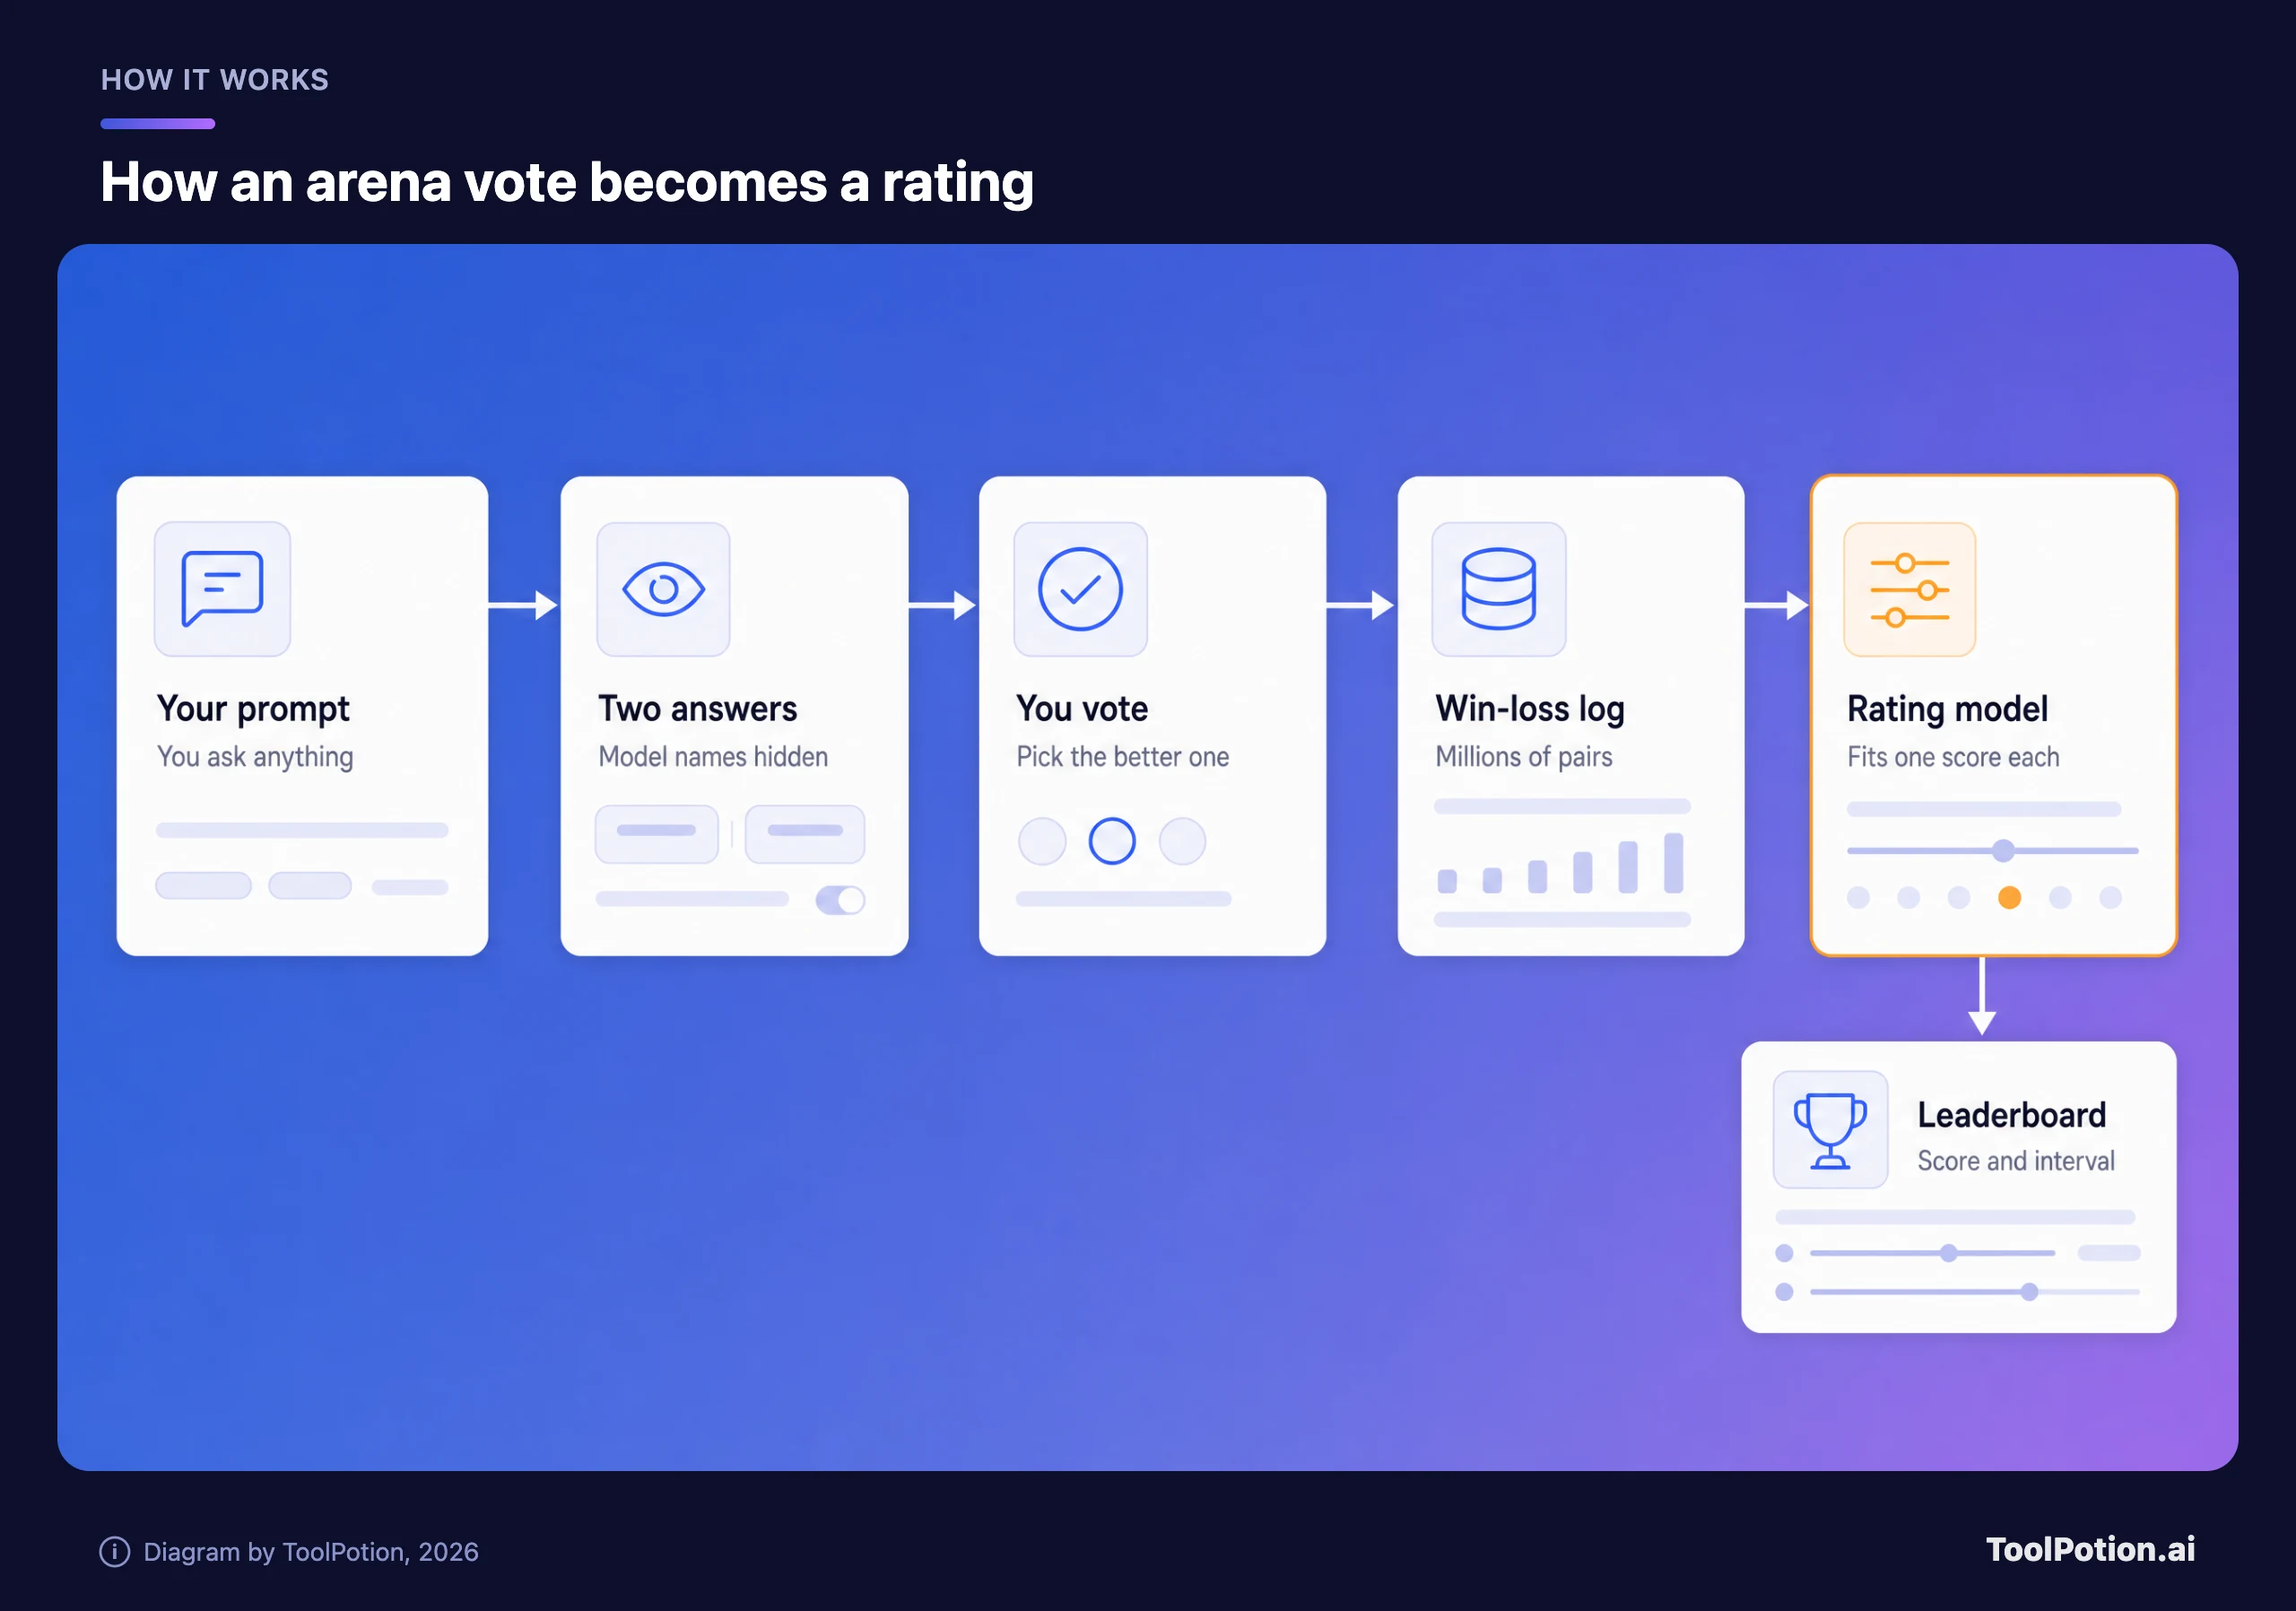
每张选票就是一条极小的记录:在这个 prompt 上,模型 A 胜过模型 B。数百万条这样的记录被送进一个统计模型,给每个模型算出一个分数。Arena 自己的文章把这种方法称为 Bradley-Terry 回归,是国际象棋所用 Elo 系统的近亲(LMSYS)。模型击败强对手,分数就上升;输给弱对手,分数就下降。文本排行榜还会在每个分数旁边显示一个区间("±"数值),而不只是一个点估计。
发布文章恰恰会跳过这个区间。如果两个模型只差几分,且区间重叠,老实的解读就是平手。一个靠两三分差距得来的"第一",通常相当于抛硬币。
Arena 早已不只是聊天。它的排行榜现在分为文本、WebDev、视觉、搜索、图像生成与编辑、视频等多个榜单,还有一个较新的 agent 榜,在胜率旁边同时列出每个任务的成本(Arena)。成本这一列值得看。排名高一位、价格却贵好几倍的模型,给出的就是另一种建议了。
竞技场告诉不了你什么
偏好投票有三个已被充分记录的问题。第一是风格。人们喜欢又长又排版漂亮的回答,所以模型可以靠多写、多加标题来爬升排名。Arena 团队自己的分析发现,回答长度是最主要的风格影响因素,校正长度和 markdown 之后,模型的名次会发生变动。在那次 2024 年的分析中,GPT-4o-mini 从第六跌到第十一,Claude 3.5 Sonnet 则从第六升到第四(LMSYS)。Arena 现在提供控制风格后的视图,值得用起来。
第二个问题是数据获取机会。2025 年一篇题为"The Leaderboard Illusion"的论文(作者包括 Sayash Kapoor 和 Noah Smith)认为,大型实验室在 Arena 上拥有结构性优势。论文称 Meta 在 Llama 4 发布前测试了 27 个私有模型变体,只公布了最好的那个分数;并估计 Google 和 OpenAI 分别拿到了约 19.2% 和 20.4% 的 Arena 全部数据,而 83 个开放权重模型加起来只拿到约 29.7%(arXiv)。
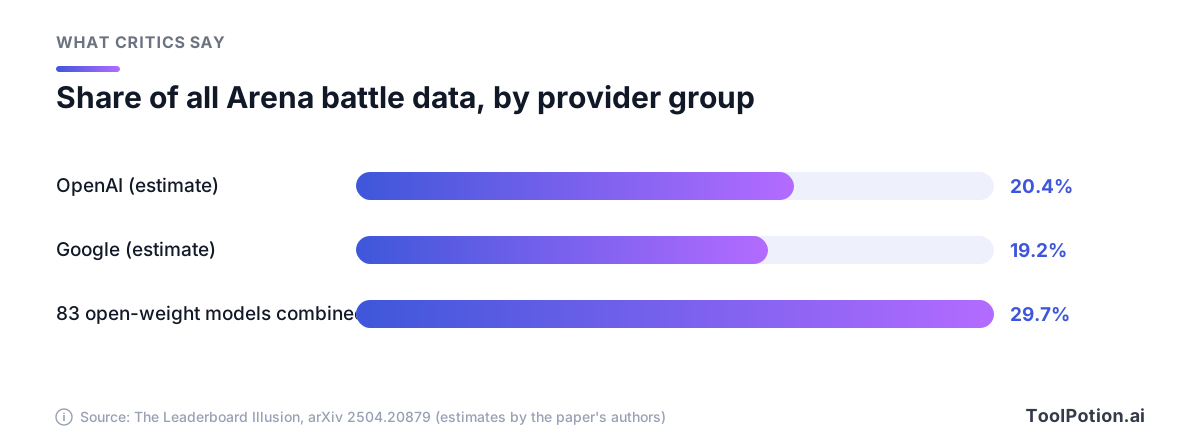
论文还提到,用 Arena 风格的数据训练,可以把模型在 Arena 分布上的表现最多提升 112%,这会让人倾向于针对榜单调优,而不是提升通用能力。这些都是作者的估算和主张,反映的也只是论文撰写时的一个快照。不过,对于偏好榜如何在没人违规的情况下被刷分,这依然是目前外界最清楚的描述。
第三个问题是,偏好不等于正确。一个自信、友好的回答可能赢得投票,同时仍然包含错误的事实。对于聊天手感和写作,偏好是个靠谱的参考;对于必须能跑通的代码,或者必须准确的数字,它就很弱。
Arena 现行的政策页面处理了其中一部分问题。页面称,发布前的模型会以匿名名称接受测试,直到分数稳定(至少 1,000 张选票),这些分数会私下分享给模型提供方,公开发布后模型的分数会标记为"preliminary"(初步),直到有新的选票进来。页面还称,每场对战至少包含一个公开可用的模型,且至少 20% 的对战只涉及公开模型(Arena)。实用的规则是:看到"preliminary"标签,说明这个数字还没定。
独立测试套件:Artificial Analysis 和 Epoch AI
如果说偏好榜问的是人们喜欢什么,独立测试套件问的就是:大家做同一份试卷时,模型能做到什么程度。Artificial Analysis 是其中最有名的一个。它的 Intelligence Index 目前是 4.3.2 版,整合了四个类别共 10 项评测:agent(权重 30%)、通用知识与推理(30%)、编码(20%)和科学推理(20%)。每个模型都在相同条件下以 pass@1 评分,也就是每道题只答一次,网站称自己保留了数据集的副本。对于主观题的评分,它使用由来自不同实验室的三个前沿模型组成的评审团。该指数以英文和文本为主,多语言和多模态能力由网站另行评测(Artificial Analysis)。
权重是一种编辑选择。换一种权重,比如减少 agent 的占比、加重编码,部分模型的排序就会改变。这不算缺陷,但意味着"综合"分数只是对"什么重要"的一种看法。如果你主要关心编码,就去看编码结果,别看总榜数字。
Epoch AI 运营着一个基准测试 hub,既有自己亲自跑的测试,比如 GPQA Diamond、FrontierMath 和 SWE-bench Verified,也收录外部来源的结果。对读者来说,它最有用的发现与厂商数字有关。Claude 3.5 Sonnet 在 GPQA Diamond 上被报告为 65%,而 Epoch 跑了 16 次,测得 55%,误差 ±3,并指出实验室往往不公布所用的 prompt 或 temperature(Epoch AI)。仅仅因为设置不同就差出 10 个百分点,足以说明为什么应该优先相信第三方的复测。这个 hub 由英国 AI 安全研究所资助,数据可免费复用。
独立不等于没有偏见。第三方依然要挑选测试,而任何包含 LLM 评审的指数,都会继承评审模型的习惯。Arena 自己对 AI 评审的研究发现,模型会偏向自己的回答。在由 12 个模型评判的 1,460 场 Text Arena 对战中,评审选择自家回答的频率比人类高出约 70%(Arena)。
基准测试会过时
任务基准的问题正好相反。它们客观,但老化得很快。基准刚发布时很难,实验室针对它优化,分数上升,测试题泄漏进训练数据,不久所有顶尖模型都挤在天花板附近,排名也就失去了意义。
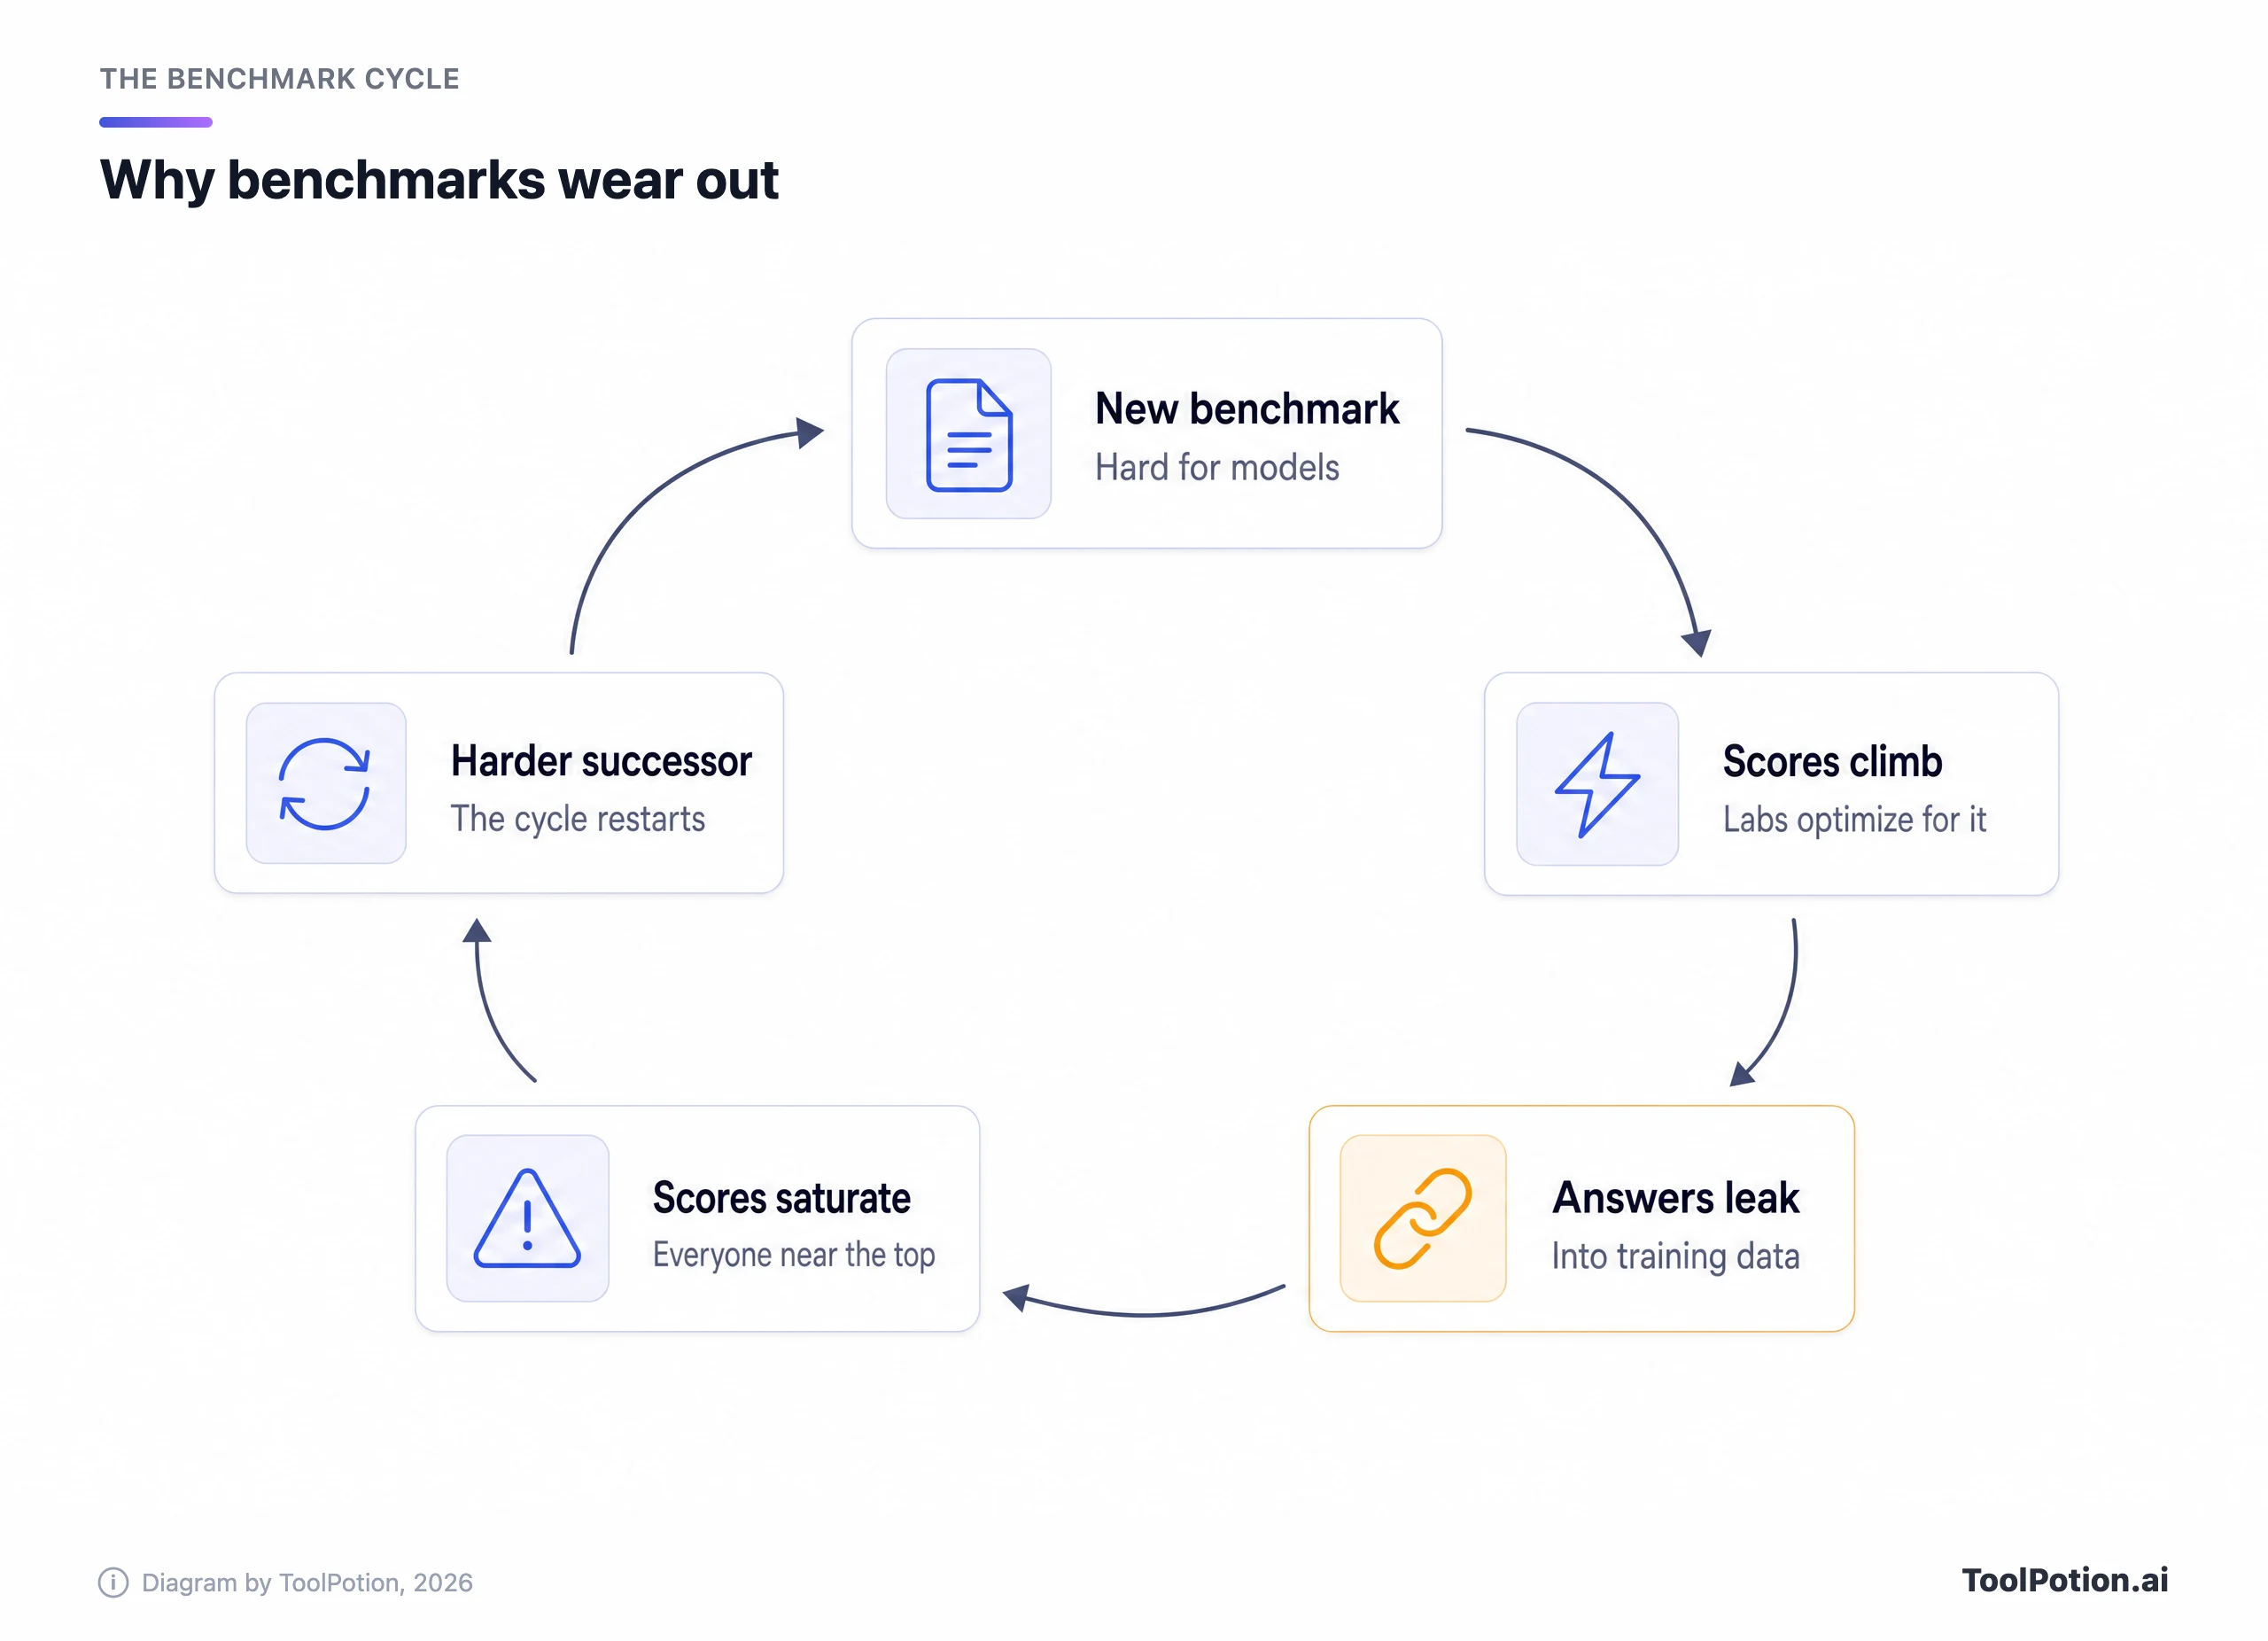
Humanity's Last Exam 是应对这个问题的好例子。它有 2,500 道题,涵盖一百多个学科,由 500 多家机构的近 1,000 位专家撰写,并保留一套私有测试集来防止过拟合。作者之所以做它,是因为 MMLU 这类老测试已被前沿模型推到了 90% 以上(arXiv)。它于 2026 年发表在 Nature 上,即便是它的创建者,也预期分数会很快上涨。
SWE-bench 展示了完整的生命周期。最初的基准包含来自 12 个 Python 项目的 2,294 个真实 GitHub issue,当时最强的模型 Claude 2 只解决了其中的 1.96%(出自原始论文)。后来一个经过清理的 500 题子集 Verified,成了编码类发布中的标准数字。再后来,审计来了。
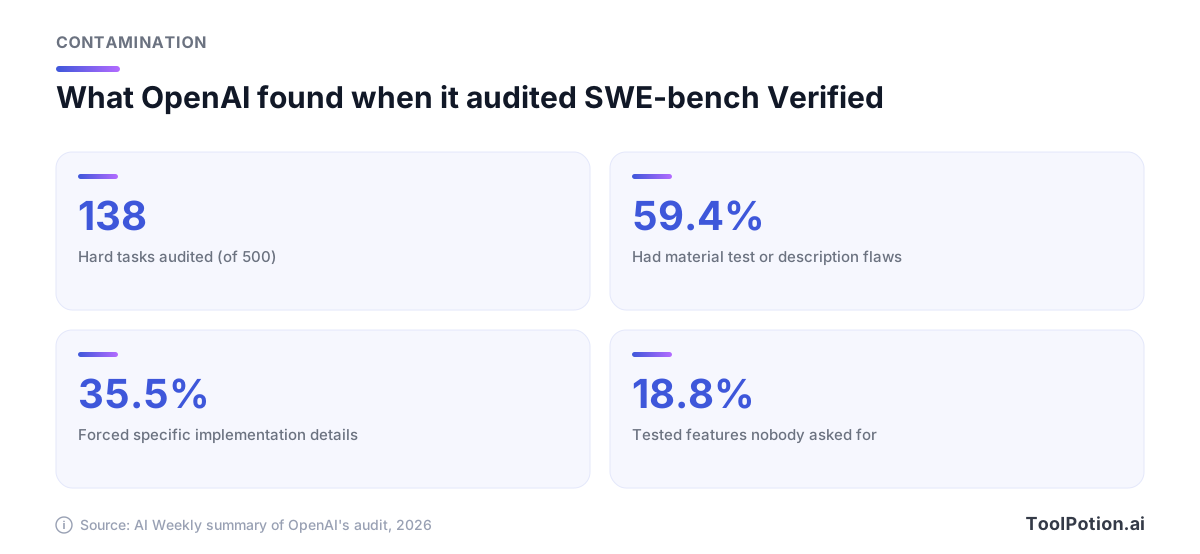
OpenAI 审计了 138 道其 o3 模型无法稳定解出的 Verified 题目,每道题都至少由六名工程师复核。结果发现,59.4% 的题目在测试或描述上存在实质性问题。在另一项污染测试中,GPT-5.2、Claude Opus 4.5 和 Gemini 3 Flash Preview 都能复现原始修复的细节,说明这些题目已经泄漏进了训练数据。OpenAI 表示已停止报告 Verified 分数,并推荐改用 SWE-bench Pro(OpenAI)。AI Weekly 的总结补充说,顶尖模型在 Verified 上约为 80%,在 Pro 上则低约 35 个百分点,而后来一次外部审计也对 Pro 的评分器提出了质疑(AI Weekly)。
这并不是说编码基准没用。要点是:来自已退役或已泄漏的测试的分数,是个旧数字。当发布文章引用 SWE-bench 时,要查清是哪个版本,还要查清模型外面包了什么 agent 脚手架。Arena 的"HarnessTax"研究分析了 21 组模型与脚手架的组合,发现脚手架的选择对任务成功率影响不大,但在结果相近的情况下,成本最多可相差 5 倍;不过样本很小,每个基准只有 30 个任务(Arena)。
读懂任何"第一名"说法的检查清单
这是两分钟版本。相信一个排名之前,尤其是为它掏钱之前,先过一遍。
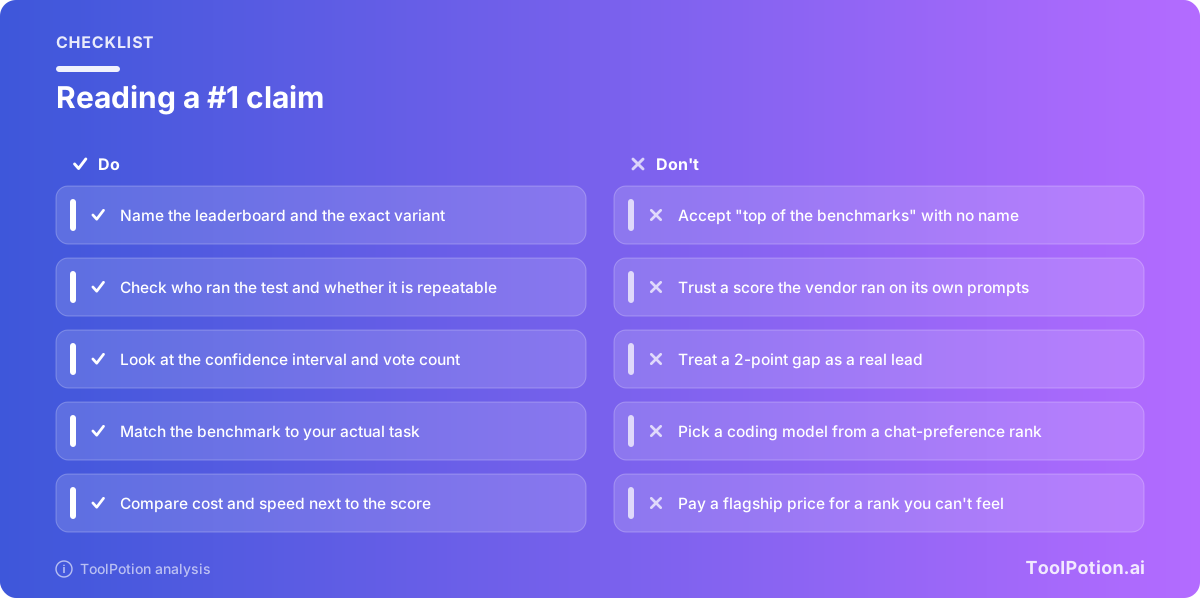
- 找到具体的榜单和版本。"在各项基准中名列前茅"是没法核实的说法,"在 Arena 文本榜(控制风格)排名第一"才可以。
- 查清是谁跑的。实验室用自己的 prompt 自己跑的成绩,是营销数字;第三方的复测更有分量。
- 看区间和票数。如果领先幅度小于区间,那就是平手。
- 确认模型是否公开。你今天没法试用的东西,它的分数帮不了你做选择。
- 问问这项测试和你的任务是否匹配。聊天偏好预测不了模型处理你的表格或代码库的表现。
- 找第二个不同的榜单来印证。单个榜单可能出错,也可能被刷分。两个互不相干的榜单结论一致,要造假就难得多。
- 把价格和速度放在分数旁边比。排名低两位的便宜模型,往往才是更划算的选择。
你可以用下面的清单自己给一条说法打分。它的权重偏向最难造假的那些项,比如第三方复测和多个榜单互相印证。
让榜单匹配你的问题
既然各个榜单回答的是不同的问题,更有用的做法是先从你的问题出发,再去选榜单。如果你要挑一个用于写作和对话的助手,偏好竞技场是不错的初筛。如果你想对原始能力做可重复的比较,就用独立测试套件。如果你在选编码工具,就看基于真实代码仓库的任务基准,然后拿自己的代码去测。
这棵决策树只是个起点,不是定论。不管最后落在哪个榜单上,在自己的工作上做个小测试,都胜过任何公开排名。拿 10 个你每周都要做的真实任务,让两三个入围模型各跑一遍,把输出并排对比。一个下午就能搞定,它衡量的是任何排行榜都测不了的那件事:你自己的工作。
想按类别挑选的话,ToolPotion 的 AI Models & LLMs 目录和 AI 模型榜把模型并排列出,如何按任务匹配 AI 模型档位的指南则讲了什么时候旗舰模型值得付费。想看更全面的盘点,可以读 2026 年 Top 15 AI Models & LLMs;如果你是从某个助手出发,也可以看 2026 年 ChatGPT 替代品。
数字最不可靠的地方
有几种情况需要格外怀疑。新模型发布头几天的票数少、区间宽,Arena 把这些分数标为 preliminary 是有原因的。开放权重模型,也就是你可以从 Hugging Face 下载的那类,是另一个盲区:Leaderboard Illusion 的作者估计它们拿到的 Arena 数据份额更小,所以分数可能噪声更大。托管模型也可能在名称不变的情况下改变行为,所以发布当周的分数,未必能描述你几个月后用的那个模型。
专业领域是最大的空白。法律文书起草、医疗编码、小语种,以及公司内部代码库,公开榜单对它们的覆盖都很差。Real-SWE Benchmark 是一种解法:它在私有的企业代码库上评测前沿模型,相比公开仓库,这些代码库泄漏进训练数据的可能性更小。把这类榜单当作有用的第二意见,而不是用来取代你自己的测试。
另外,如果你只是普通用户,可能根本用不着这些。对于日常写作和提问,OpenAI、Anthropic 和 Google 的头部几款模型已经足够接近,最后的选择往往取决于价格、界面和使用习惯。花一个小时研究排名,只为在几乎打平的选项之间做选择,并不划算。
常见问题
Arena 和 LMArena 是同一个东西吗?
是的。LMArena 源自加州大学伯克利分校的 Chatbot Arena 研究项目,现在改名为 Arena,网址是 arena.ai。旧名字仍会出现在一些文章和早期论文里。
哪个排行榜最值得信任?
没有哪个榜单在所有情况下都值得信任,这取决于你想知道什么。要可重复性,自己跑每个模型的第三方测试套件最可靠。要看人们的偏好,Arena 的数据最多。最可靠的证据,是两个互不相干的榜单结论一致,再加上在你自己的任务上做一次简短测试。
什么是基准测试污染?
指模型在训练期间见过测试的题目或答案,所以高分反映的是记忆而不是能力。OpenAI 对 SWE-bench Verified 的审计发现,前沿模型能复现部分任务的原始修复。私有测试集(比如 Humanity's Last Exam 保留的那套)是一种防御手段。
厂商会在排行榜上作弊吗?
证据支持的是一个更窄的说法。实验室会选择公布哪些分数、使用哪些设置,而且据 Leaderboard Illusion 论文所述,还会选择披露哪些私有变体。这是规则之内的选择性报告,不一定是违规。这也正是独立复测重要的原因。
每次有新模型登顶,我都该换模型吗?
不用。排名差距常常落在误差范围之内,而换模型在 prompt、工作流和测试上都有实实在在的成本。只有当某个模型在你自己的任务上胜过现在这个,或者效果相当但价格明显更低时,再换。