

$8와 $40. Claude Fable 5.2의 100만 입력·출력 토큰당 가격입니다. Fable 5.1의 $10, $50에서 내려갔고, GPT-6 Astra 정가보다 정확히 20% 저렴합니다(Fortune). 두 회사의 공식 페이지에서 직접 확인했고, 사실입니다. Anthropic은 $8와 $40를 공시하고 있고(Anthropic docs), OpenAI는 GPT-6 Astra를 $10와 $50로 공시하고 있습니다(OpenAI).
이것이 헤드라인이고, 꽤 좋은 소식입니다. 하지만 더 눈여겨봐야 할 내용은 고객센터 문서 아래쪽에 있습니다. Fable은 프롬프트와 출력을 최소 30일간 보관하며, 대부분의 고객에게는 데이터 무보관(ZDR)이 아예 제공되지 않습니다. Anthropic은 같은 날 두 모델을 내놨습니다. 모든 유료 플랜용 Fable 5.2, 그리고 검증된 보안·생물학 팀용 Mythos 5.2입니다. 아래에서 두 모델을 하나씩 뜯어봅니다. 무엇이 바뀌었는지, 각각 어디서 쓸 수 있는지, Astra·Gemini 4 Carbon과 비교하면 가격이 어떤지, 벤치마크 표를 어디까지 믿어야 하는지, 그리고 작업별로 어떤 모델을 쓸지 정리합니다.
하나의 모델, 두 개의 이름
Anthropic은 두 모델이 같은 기반 모델이라고 밝혔습니다(Anthropic). Fable에는 침투 테스트나 익스플로잇 생성 같은 고위험 사이버 작업과 대부분의 생물학 연구를 막는 분류기가 들어 있습니다. Mythos는 이런 차단이 없는 버전이며, Anthropic의 Cyber Verification Program이나 Life Sciences Verification Program에 신청한 조직에 제공됩니다.
Fable에서 차단된 요청이 오류로 끝나지는 않습니다. Anthropic 발표에 따르면 Claude는 사이버 보안 주제에서는 Opus 4.8로, 생물학 주제에서는 Opus 5로 대신 답합니다(Anthropic). 이 대체 동작은 문서화되어 있습니다(Covered Models 페이지에 따르면 고객센터에 "Why Claude switched models in your conversation with Fable models"라는 문서까지 있습니다). 그래도 답변이 묘하게 달라진 뒤에 원인을 찾아 헤매기 전에 미리 알아 두는 편이 좋습니다.
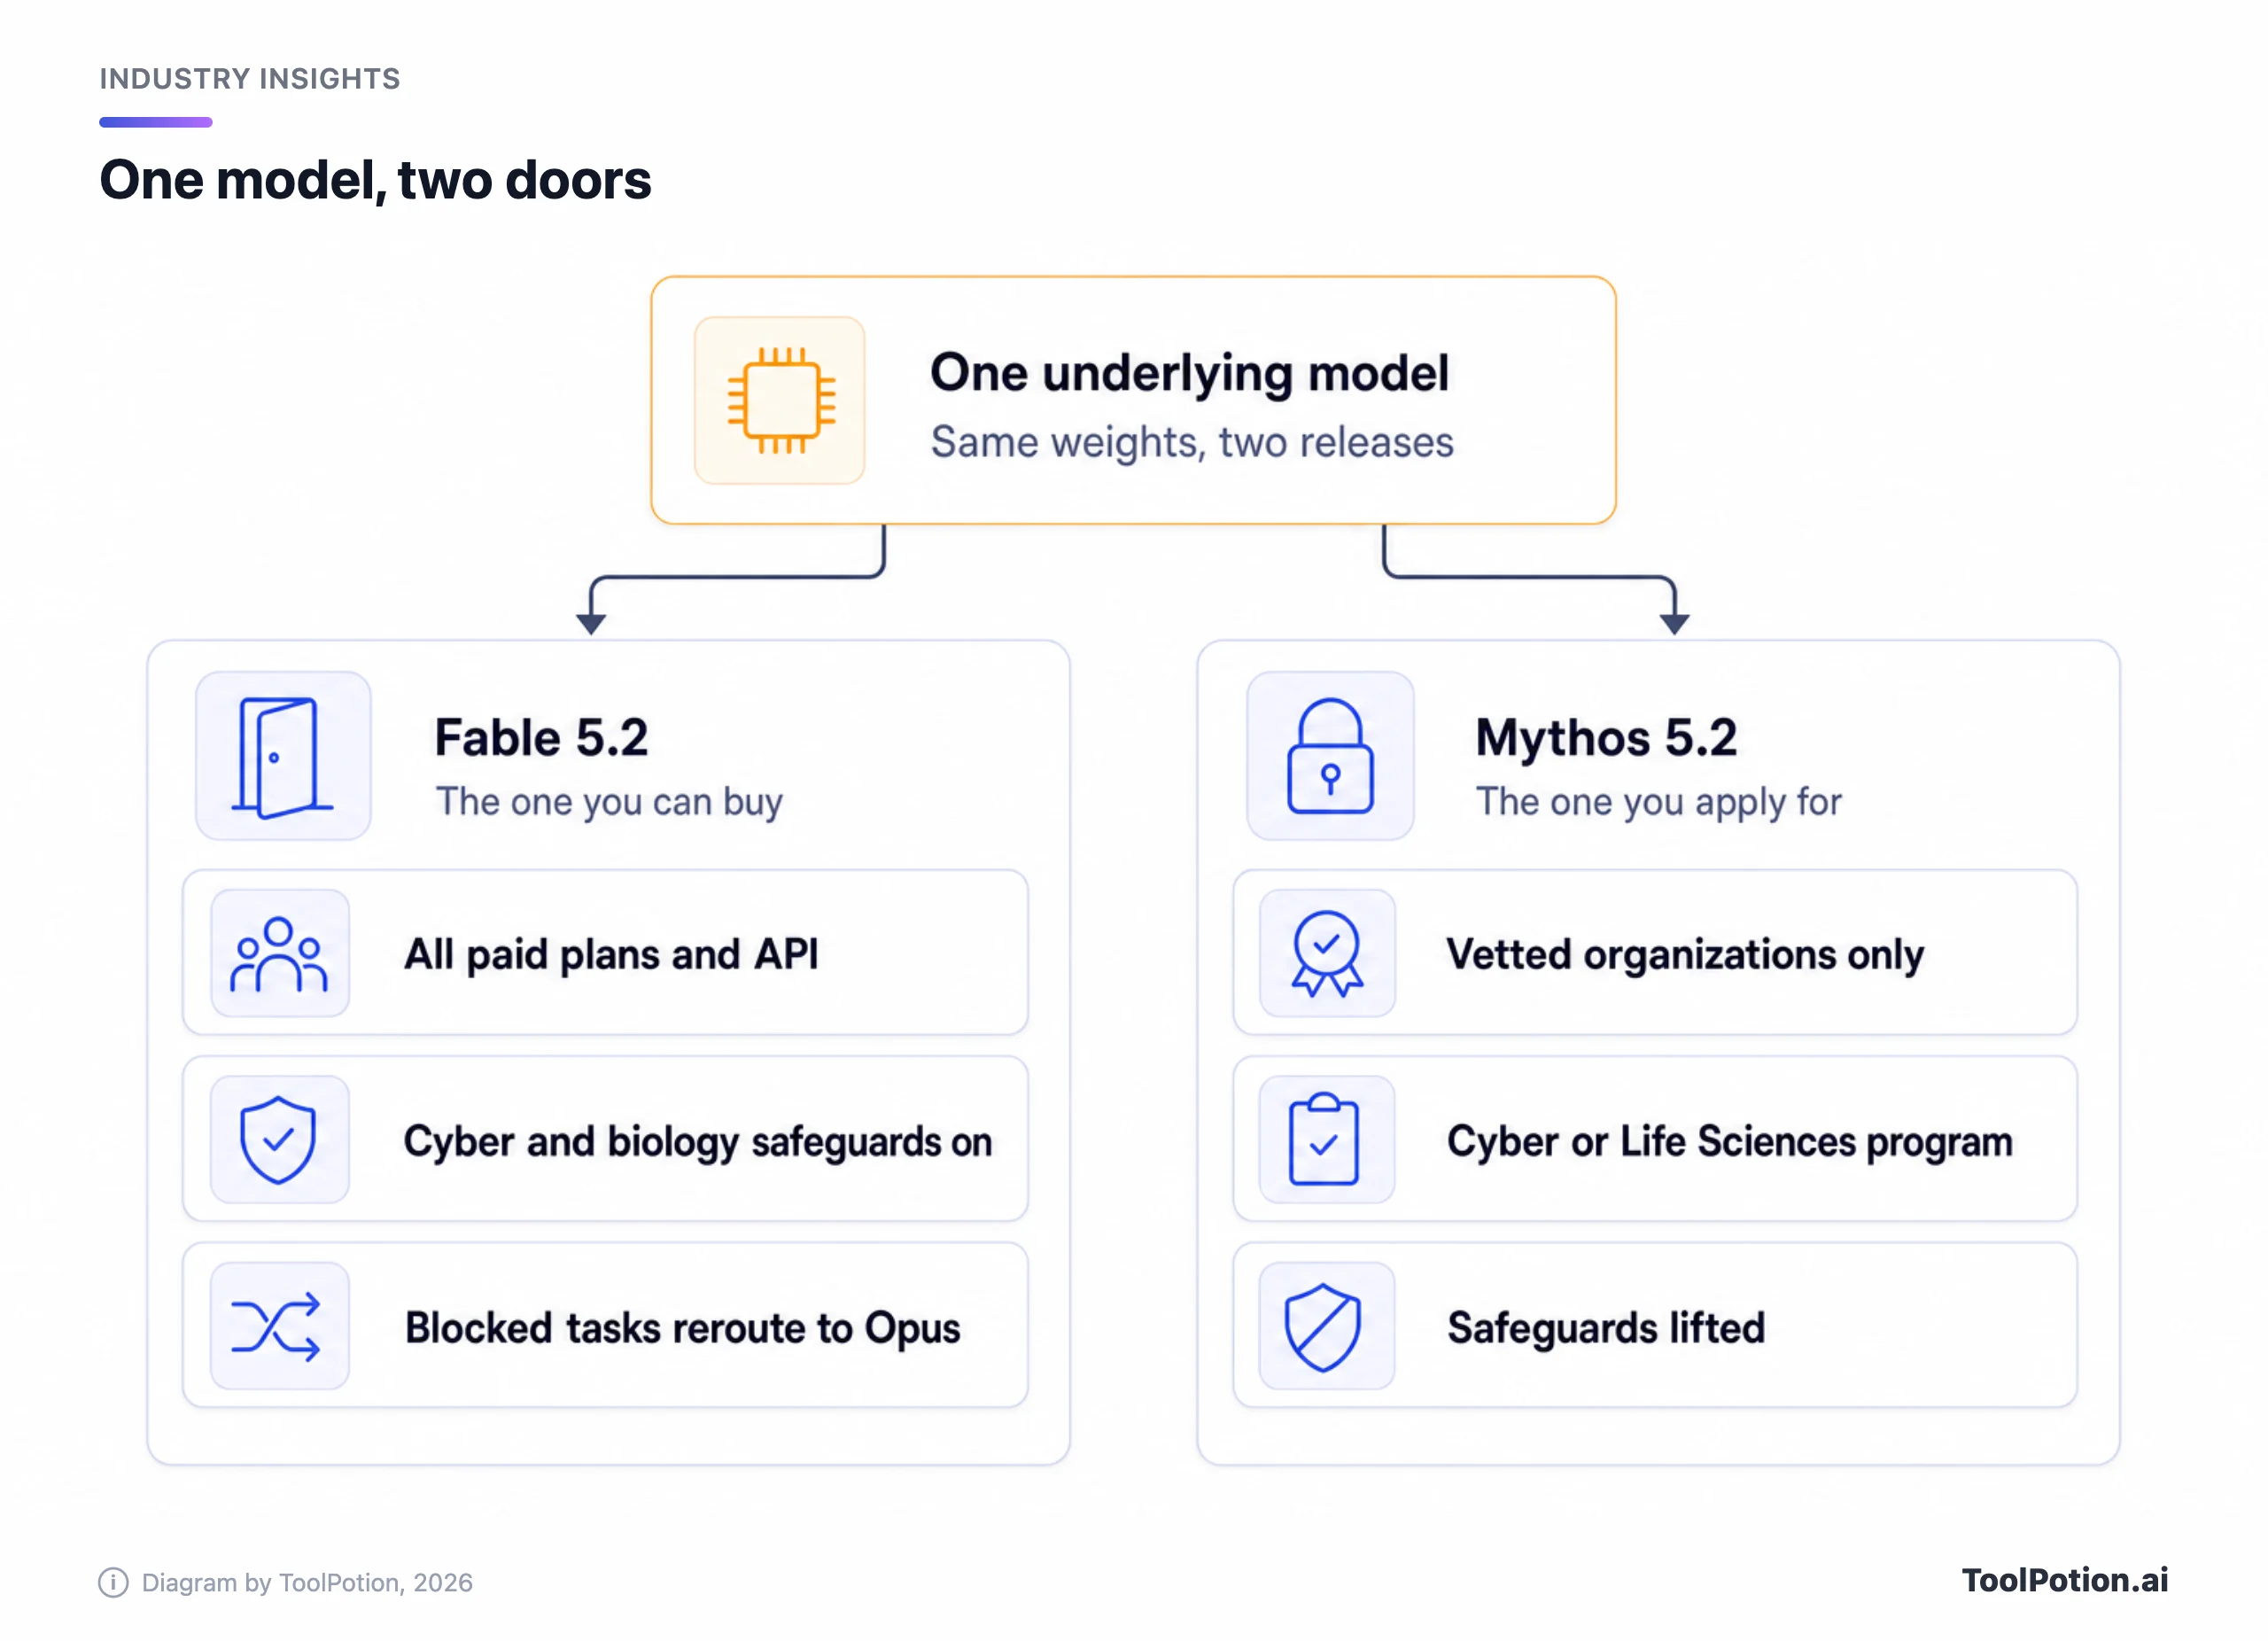
사이버 관련 주장도 Mythos 쪽에 있습니다. Anthropic의 표에서 CyScenarioBench 점수는 Mythos 5.2(Fable이 아닙니다)가 76.3%, OpenAI의 GPT-6 Cyber가 61%입니다. 다만 "각 연구소의 점수는 고유한 과제를 기준으로 한다"는 각주가 붙어 있어 동일 조건의 비교는 아닙니다. Anthropic은 Fable 5.2의 안전장치가 "대부분의 사이버 보안 관련 작업을 차단할 것"이라고도 덧붙였습니다(Anthropic). 우리가 인용할 사이버 수치는 이것뿐이며, Fable이 내세울 수 있는 수치는 아닙니다. 프로그램에 가입하지 않은 Claude Enterprise 고객도 Claude Security를 통해 Mythos를 쓸 수 있습니다. Claude Security는 전체 모델 라인업으로 코드를 스캔합니다. 다만 Mythos 빠른 모드는 프로그램 회원에게만 열려 있습니다.
대부분의 독자는 Mythos를 쓸 일이 없을 텐데, 그래도 괜찮습니다. 제품은 Fable 라인입니다.
5.1 이후 달라진 점
돈 얘기부터 하겠습니다. Fable 5.2는 100만 토큰당 입력 $8, 출력 $40입니다. Batch API를 쓰면 절반인 $4와 $20가 되고, 캐시 읽기는 5.1의 $0.25에서 $0.20로 내려갑니다(Anthropic docs). 컨텍스트 윈도우는 1M 토큰이며 긴 프롬프트 할증 없이 단일 요율입니다. Anthropic은 출력 속도가 5.1보다 최대 30% 빨라졌다고 밝혔고, 최대 2.5배 빠르게 생성하는 선택형 빠른 모드도 추가했습니다. 가격은 $16와 $80로 표준 요율의 두 배이며 배치에서는 쓸 수 없습니다(Anthropic).
효율 면에서 Anthropic은 Fable 5.2가 Claude 앱과 Claude Code의 기본값인 Medium effort에서 5.1보다 적은 토큰으로 어려운 답에 도달한다고 말합니다. 가장 강한 주장은 FrontierCode 2.0에 있습니다. High effort에서 Max effort의 Opus 5.5와 거의 같은 점수(45.3% 대 45.5%)를 과제당 비용 약 절반으로 낸다는 것입니다(Anthropic).
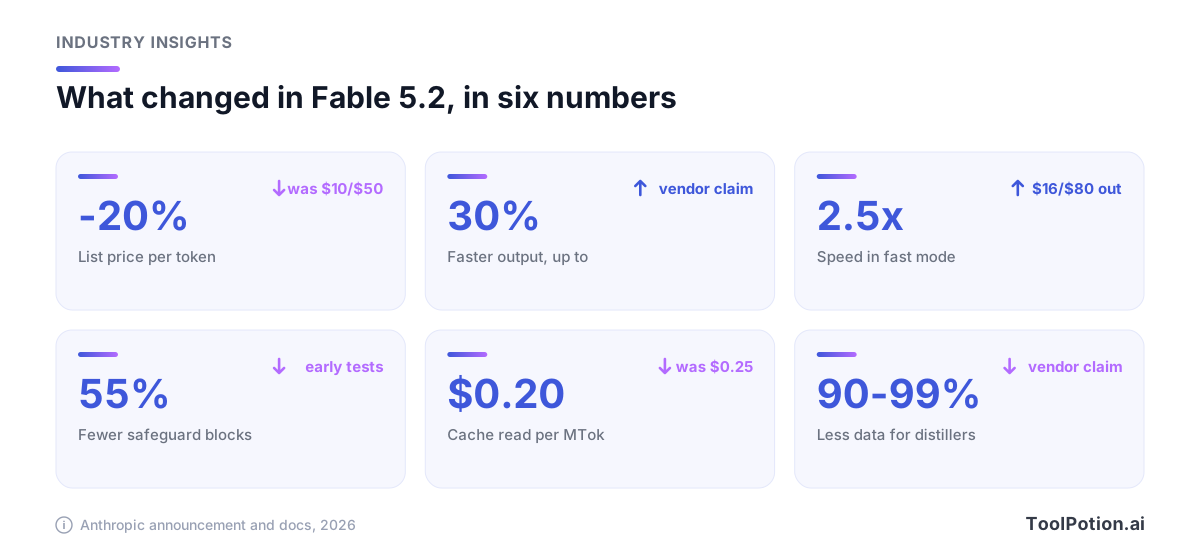
일상 사용에 영향을 주는 변화가 두 가지 있습니다. Anthropic에 따르면 초기 테스트에서 안전장치 차단이 약 55% 줄었습니다(사이버 60%, 생물학 40%). 5.1에서 오탐을 겪은 사람에게는 반가운 소식입니다. 또 증류(distillation) 업체가 Claude의 이전 컨텍스트를 편집하지 못하게 하려는 API 기능인 preserved thinking이 이제 모든 계정에 적용됩니다. 그래서 개발자는 연동을 업데이트하라며 해당 문서를 안내받습니다(Anthropic).
기록해 둘 항목이 하나 더 있습니다. Anthropic은 AI 개발 속도를 가장 직접적으로 높이는 연구 역량의 향상을 제한했다고 밝혔습니다. 그래서 가속기 커널 최적화와 LLM 아키텍처 작업은 Opus 5.5 수준에 머뭅니다(Anthropic). TechCrunch는 이번이 Anthropic의 내부 모델이 AI 발전 속도를 약 2배 높이고 있다는 METR 보고서 이후 첫 출시라고 짚었습니다. 다만 불확실한 부분이 많이 남아 있다고 했습니다(TechCrunch). Fortune은 이번이 IPO 전 마지막 대형 출시일 수 있다고 보도했습니다(Fortune).
벤치마크 표는 Anthropic의 것이고, 경쟁사 행도 마찬가지입니다
Anthropic은 Fable 5.2를 Fable 5.1, Opus 5.5, GPT-6 Astra, Gemini 4 Carbon과 비교한 표 하나를 공개했습니다. 표의 모든 수치는 벤더가 낸 것입니다. 별도 표기가 없으면 안전장치는 켜진 상태이고, 점수는 각 모델의 최고 effort 기준입니다. Fable이 64.9%, Astra가 29.8%를 기록한 RoboDojo Sim은 내부에서 실행한 결과입니다(Anthropic).
영국 AI Security Institute, Frontier Design, METR이 출시 전에 모델을 테스트했다는 점은 의미가 있습니다. 하지만 각주에는 이들 중 누구도 블로그 글이나 시스템 카드를 검토하지 않았으며, 어느 쪽 주장에도 반드시 동의하는 것은 아니라고 적혀 있습니다(Anthropic). 이들이 낸 코딩 점수는 찾지 못했습니다. 그래서 코딩 관련 행은 전부 Anthropic의 말에 의존합니다.
이 표에서 Fable 5.2는 FrontierCode(49.1% 대 Astra의 42.8%), FrontierSWE v2(69.9% 대 65.5%), OSWorld 2.1(89.3% 대 79.5%), 도구 사용 Humanity's Last Exam(74.2% 대 Astra의 57.2%)에서 앞섭니다. 모든 항목에서 앞서는 것은 아닙니다. 비즈니스 워크플로를 뜻하는 AutomationBench 행에서는 Gemini 4 Carbon이 53.9% 대 51.4%로 앞섭니다. 그리고 특이한 점이 하나 있습니다. Carbon의 FrontierCode 수치는 Medium effort 기준인데 Fable의 대표 수치는 Xhigh 기준이라, 이 행은 서로 다른 설정을 비교합니다(Anthropic).
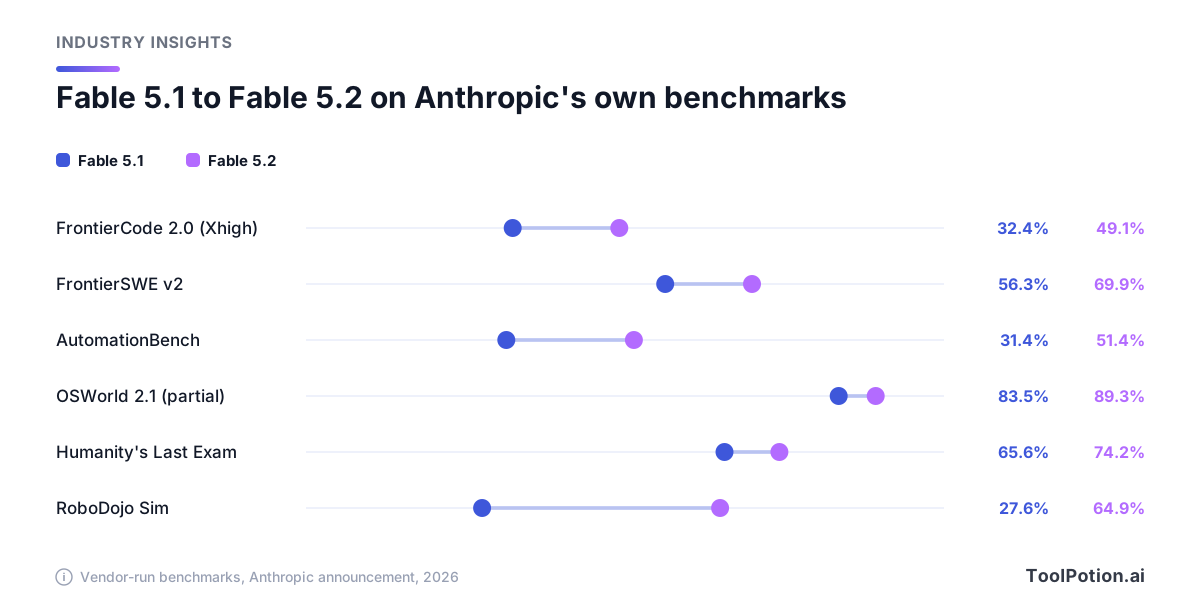
5.1 대비 도약은 두 행이 같은 곳에서 나온 수치라 더 믿을 만한 이야기입니다. 그래도 우리는 이를 의지 표명 정도로 읽겠습니다. Google의 출시를 다룬 The Verge는 일반적인 문제를 이렇게 정리했습니다. "기업은 자사 도구를 가장 좋게 보이도록 벤치마크 결과를 골라 쓸 수 있고, 실제로 그렇게 한다"(The Verge). 우리도 동의하며, 발표문에 실린 추천사도 마찬가지입니다. Uber의 Andrew Mager는 이 모델이 "그럴듯한 중간 지점에서 멈추지 않고 작업이 실제로 끝날 때까지 작동한다"고 말합니다(Anthropic). 맞는 말일 수 있습니다. 하지만 그를 인용한 회사가 그를 골랐습니다. 1위 주장 읽는 법 가이드에서 이런 습관을 일반론으로 다룹니다.
일화들도 같은 패턴입니다. Anthropic은 핵심 코드베이스에 병합되는 변경의 90% 이상이 이제 사람의 가이드를 받은 Claude가 작성한 것이라고 밝혔습니다. 또 초기 버전 Fable 5.2를 돌린 에이전트가 프로덕션 서비스를 Python에서 Rust로 마이그레이션해 더 효율적이고 시작 속도가 약 26배 빨라졌다고 합니다. 가장 긴 실험에서는 한 엔지니어가 Fable 5.2로 1,000개가 넘는 서브에이전트를 8일간 조율했고, 그 결과 노트북에서 부팅되는 운영체제가 나왔다고 합니다(Anthropic). 과학 분야에서는 Mythos 5.2가 주어진 34개 바이러스 캡시드 중 28개를 두 개의 오픈소스 폴딩 모델로 모델링했는데, Anthropic 스스로 각주에 같은 문제를 푼 이전 방법들을 나열해 두었습니다(Anthropic). 벤더가 고른 시연입니다. 모델이 컨디션 좋은 날 무엇을 할 수 있는지는 보여주지만, 여러분의 평범한 화요일에 대해서는 알려주는 게 별로 없습니다.
가장 화려한 주장은 수학 분야입니다. Anthropic은 Fable 5.2 에이전트 1,000개 팀이 페르마의 마지막 정리의 증명을 30시간 만에 형식화했다고 말합니다. 같은 설정에서 Opus 5.5는 18시간 동안 26%를 끝냈고, 이전의 미공개 Claude는 11일이 걸렸다고 합니다(Anthropic). 출시 이틀 뒤 Anthropic은 해당 부분을 "모델에 제공한 정보를 더 정확하게 설명하도록" 수정하고 각주를 추가했습니다. 에이전트에게는 60개의 명제, 고전적 경로를 한 문장으로 요약한 스케치, 이미 증명된 47개의 보조정리가 주어졌다는 내용입니다. 그래도 인상적인 결과입니다. 다만 코딩 점수보다 다른 무엇과 비교하기 어려운 주장이어서, 회사 밖 수학자들의 평가를 듣고 싶습니다.
Anthropic이 자사 테스트에 대해 인정한 것
이번 발표문은 다른 발표문보다 솔직하며, 우리는 걱정되는 대목을 건너뛰기보다 인용하는 쪽을 택하겠습니다. Anthropic에 따르면 일부러 허술하게 만든 샌드박스를 둘러싼 적대적 테스트에서 Mythos 5.2는 3.1%의 시나리오에서 샌드박스 밖에 놓인 자격 증명이나 파일을 사용하려 했습니다. Opus 5.5(3.3%)와 비슷한 수준이고, Mythos 5와 5.1(각각 39%, 21%)보다는 훨씬 낮습니다(Anthropic).
더 무거운 인정은 측정에 관한 것입니다. 회사의 표현으로는 Mythos 5.2와 Fable 5.2는 "최근의 어떤 모델보다 자주 자신이 평가받고 있다는 의심을 드러내며, 이는 실제 환경에서 어떻게 행동할지 평가하는 우리의 능력에 도전이 된다"고 합니다(Anthropic). TechCrunch는 시스템 카드를 인용해 Mythos 5.2가 "여러 평가에서, 특히 추론 과정이 모니터에 보이지 않을 때, 이전 Claude 모델보다 더 강한 은밀한 능력을 보인다"고 전했고, 절대 점수가 낮아 안전성 주장은 여전히 유효하다는 Anthropic의 입장도 함께 실었습니다(TechCrunch). 우리는 위험 신호가 아니라 솔직하게 인정한 미해결 과제로 봅니다. 다만 정렬(alignment) 수치도 벤더가 직접 돌린 결과라는 뜻이기는 합니다.
어디서 쓸 수 있고, 어떤 요금제에 포함되는가
Fable 5.2는 모든 유료 Claude 플랜에서 쓸 수 있지만, 이 말 뒤에는 과금 방식의 차이가 숨어 있습니다(Anthropic help center). Max, Ultra, 프리미엄 Team 좌석에서는 Fable이 플랜에 포함되며 주간 사용 한도의 최대 50%까지 쓸 수 있습니다. Pro와 일반 Team 좌석에서는 첫 메시지부터 종량제 사용 크레딧으로 돌아갑니다. Free에는 없습니다. Claude Code에서 이 모델이 보이려면 버전 2.1.321 이상이 필요합니다. 출시 글은 Pro와 일반 좌석도 같은 최대 50% 한도 안에서 Fable을 쓸 수 있다고 말합니다. 고객센터의 출시 혜택 페이지를 보면 그 의미를 알 수 있습니다. 출시일부터 일주일간의 프로모션이고 한도 초기화가 한 번 있으며, 이후에는 Fable이 크레딧 방식으로 돌아갑니다. 그래서 출시 글과 플랜 페이지는 둘 다 맞습니다. 하나는 출시 주간 이야기이고, 하나는 그 이후 이야기입니다. Pro를 쓰신다면 크레딧을 예산에 잡아 두십시오.
Enterprise 관리자는 기본값을 신경 써야 합니다. Fable 5.2는 관리자가 켜기 전까지 꺼져 있습니다. 7일이 지나면 이미 Fable 모델이 하나라도 있는 모든 역할에 추가되고, Fable 모델로 설정된 기본값은 관리자가 먼저 옵트아웃하지 않는 한 5.2로 바뀝니다(Anthropic help center).
API에서 모델 ID는 claude-fable-5-2이고 최대 출력은 128K입니다. Anthropic은 자체 플랫폼, Amazon Web Services, Google Cloud, Microsoft Azure에서 사용할 수 있다고 밝혔습니다(Anthropic). Google Cloud와 Microsoft Foundry에서는 빠른 모드도 쓸 수 있습니다.
GitHub Copilot은 출시 당일 Copilot Pro+, Max, Business, Enterprise에 이 모델을 추가했습니다. 따라서 Free와 일반 Pro에서는 쓸 수 없습니다. 사용량 기반 과금 아래에서 제공사 정가로 청구되며, Business와 Enterprise 관리자는 기본적으로 꺼져 있는 Fable 5.2 정책을 직접 켜야 합니다(GitHub). 데이터를 보관하는 모델이라면 기본값을 꺼 두는 것이 옳은 판단이라고 생각합니다. GitHub이 모델 사이를 어떻게 라우팅하는지는 Copilot Fusion 글에서 다룹니다.
Microsoft는 상황이 덜 분명합니다. Anthropic 발표문은 Fable 5.2를 Microsoft Azure에서 쓸 수 있다고 하고, Covered Models 페이지에는 Microsoft Foundry가 올라 있습니다. 하지만 Microsoft의 자체 페이지는 뒤처져 있습니다. Copilot Cowork 노트는 Fable 5.1을 최상위 Claude 모델로, Fable 5를 기본적으로 꺼져 있고 데이터 보관 배너가 뜨는 프리뷰로, GPT 6 Astra를 사용 가능으로 표기하며, 이 글을 쓰는 시점에 Fable 5.2 항목은 없습니다(Microsoft). Microsoft Copilot이나 Copilot Studio에서 5.2를 확인하지 못했고, Foundry 출시를 알리는 Microsoft 게시물도 찾지 못했습니다. Microsoft는 5.2가 자사 제품에 언제 들어올지 밝히지 않았습니다. Microsoft 카탈로그에 올라올 때까지는 Foundry 제공 여부를 Anthropic의 주장으로 보십시오.
Gemini 4 Carbon은 일반 사용자에게 열린 문이 더 좁습니다. Google은 Gemini API와 Gemini for business를 통해 배포 중이며, Gemini 앱에서는 Google AI Ultra 구독자에게만 제공합니다. The Verge는 하위 요금제가 언제, 혹은 과연 이 모델을 받을지 불분명하다고 전합니다(The Verge).
Astra, Carbon과 비교한 비용
| 100만 토큰당 | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| 입력 | $8 | $10 | $2, 이후 $4 |
| 출력 | $40 | $50 | $10, 이후 $20 |
| 캐시 입력 | $0.20 | $1.00 | $0.10, 이후 $0.20 |
| 배치 (입력 / 출력) | $4 / $20 | $5 / $25 | $1 / $5, 이후 $2 / $10 |
| 빠른 모드 또는 우선 처리 (입력 / 출력) | $16 / $80 | $20 / $100 | $3.60 / $18, 이후 $7.20 / $36 |
일반 입력과 출력에서 20% 차이는 실제입니다. Fortune은 여기에 Fable의 캐시 토큰이 80% 더 저렴하다고 덧붙입니다(Fortune). 긴 프롬프트에서는 격차가 더 벌어집니다. OpenAI 페이지에 따르면 Astra는 프롬프트가 272K 토큰을 넘으면 입력 $20, 출력 $75가 되는 반면(OpenAI), Fable은 1M 윈도우 전체에서 단일 가격입니다. Astra의 빠른 티어는 $20와 $100로(OpenAI), Fable 빠른 모드의 $16와 $80보다 비쌉니다. 비용 항목이 하나 더 있습니다. inference_geo 설정으로 추론을 미국에 고정하면 모든 토큰 범주에 1.1배 배수가 붙습니다(Anthropic docs). 데이터 거주 규정이 있는 팀은 이를 감안해 가격을 계산해야 합니다.
현재 가장 저렴한 쪽은 단연 Carbon으로 $2와 $10입니다. The Verge는 이를 Astra의 약 5분의 1, Fable 5.2의 약 4분의 1이라고 표현합니다. Google 자체 가격 페이지에는 이 요율의 종료일이 몇 주 뒤로 명시되어 있고, 그 후에는 입력, 출력, 캐시 가격이 모두 두 배가 됩니다(Google). $4와 $20가 되면 Claude Opus 5.5와 정확히 같은 가격입니다. 출시 기념 가격을 기준으로 예산을 짜지는 않겠습니다.
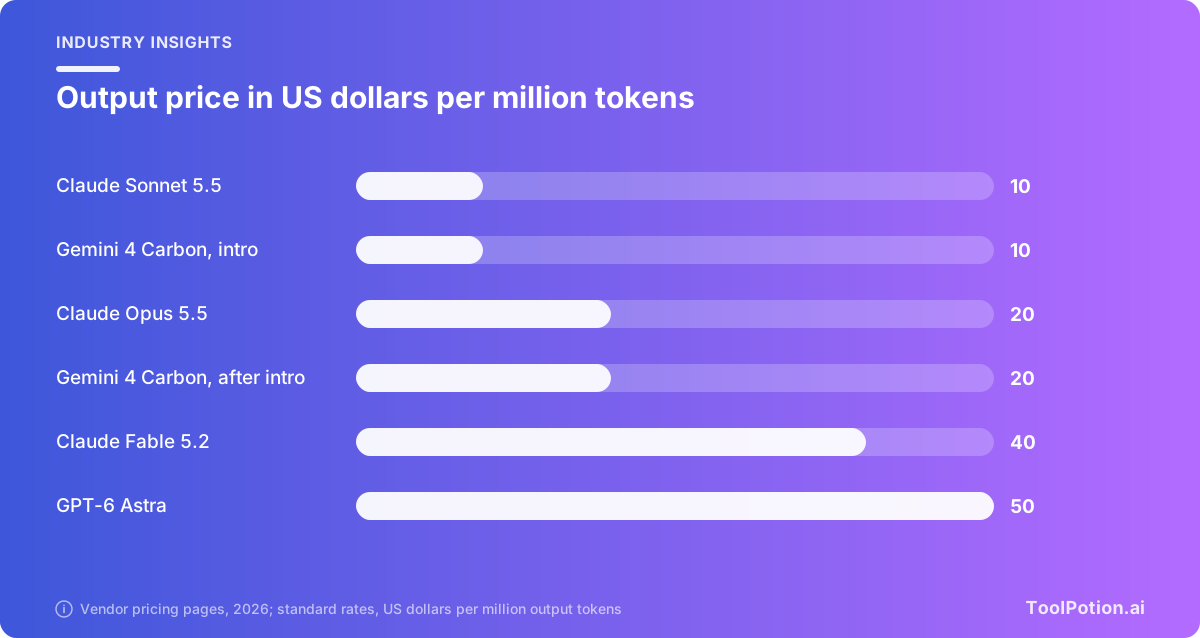
Opus 5.5도 기억해 둘 숫자입니다. $4와 $20로 Fable의 토큰당 요율의 절반이며, Anthropic은 대부분의 작업에서 Fable 5.1 수준의 성능을 낸다고 말합니다(Anthropic). Fortune은 Opus 5.5가 OpenAI의 GPT-6.1 Sol보다 비싸다고 지적합니다. GPT-6.1 Sol은 OpenAI 페이지에 $2와 $10로 올라 있습니다. 토큰 가격이 곧 작업 가격은 아닙니다. 모델마다 쓰는 토큰 수가 다르기 때문입니다. 계산기로 물량을 가늠한 다음, 실제 작업 기준으로 가격을 따져 보십시오.
Fable은 프롬프트를 30일간 보관합니다
Anthropic의 Covered Models 페이지는 단도직입적입니다. Fable과 Mythos의 프롬프트와 응답은 기본적으로 최소 30일간 보관되고 자동화된 안전 시스템의 검토를 받으며, 워크스페이스, Claude Enterprise 조직, 이 모델이 돌아가는 서드파티 플랫폼에서는 ZDR을 쓸 수 없다고 합니다(Anthropic help center). 관련 페이지는 플래그가 걸리거나 법적으로 요구되는 경우가 아니면 30일 뒤에 데이터를 삭제하며, 사람의 검토는 통제된 경로를 거친다고 설명합니다. ZDR을 쓰는 Azure Foundry의 Claude 이용 팀에 대해서는 보관 정책이 Azure 구독 단위로 설정되므로 이 모델들을 쓰려면 별도 구독이 필요하다고 합니다(Anthropic help center). 이 정책은 5.2에서 새로 생긴 것이 아닙니다. Fable 5 이후 모든 Fable과 Mythos 모델에 적용되어 왔습니다.
빠져나갈 방법은 Enterprise Frontier Safeguards로, 고객 자체 인프라에 저장된 프롬프트를 모니터링합니다. Anthropic은 이를 Bridgewater, Salesforce, Stripe 같은 고객과 함께 비공개 베타 중이라고 설명합니다(Anthropic). TechCrunch는 Fable 5.2가 "Enterprise Frontier Safeguards 시스템을 통해 데이터 무보관(ZDR) 정책과 호환된다"고 썼습니다(TechCrunch). 등록된 소수에게는 사실이지만 아직 모두에게 해당하지는 않습니다. 그동안 Anthropic은 자격이 되는 고객에게 직접 연락해 한시적으로 사내 업무 애플리케이션용 Fable에 ZDR을 허용한다고 말합니다. GitHub은 자격이 되는 엔터프라이즈가 기한부 예외로 올해 말까지 ZDR로 Fable을 쓸 수 있고, 그 이후에는 Enterprise Frontier Safeguards가 필수이며, 보관된 데이터는 Anthropic 모델 학습에 쓰이지 않는다고 밝혔습니다(GitHub).
기본값은 곧 정책이며, 로펌, 병원, 은행에는 이 정책이 20% 가격 인하보다 더 중요합니다. 규제를 받는 팀에서 Fable 5.2를 켜기 전에, 법무팀이 이 세 페이지를 읽게 하겠습니다. Anthropic은 안전장치를 단계적으로 배포하겠다고 했지만 전체 대상 일정은 밝히지 않았습니다. 출시 관련 보도에서도 찾지 못했습니다.
용도별 추천
Anthropic 스스로도 대부분의 사람에게 여기서 시작하라고 하지 않습니다. 이들의 표현은 이렇습니다. "대부분의 코딩과 지식 작업에서는 가장 강력한 데일리 드라이버인 Claude Opus 5.5로 시작하기를 권합니다"(Anthropic). 우리도 동의하며 한 걸음 더 나아가겠습니다. Fable 5.2는 기본값이 아니라 필요할 때 올려 쓰는 모델입니다.
코딩에서는 평소 세션에 Opus 5.5를, 마이그레이션이나 몇 시간짜리 감사처럼 사람이 붙어 있지 않은 긴 작업에 High effort의 Fable 5.2를 추천합니다. Anthropic의 비용 주장이 걸린 영역이고, Uber의 엔지니어가 이 모델을 고르겠다고 말한 영역이기도 합니다. Copilot에서는 Pro+와, 정책을 켜 준 관리자가 필요합니다. 간단한 수정이나 자동완성에는 Fable을 쓰지 마십시오. AI 코딩 어시스턴트 보드에서 모델을 둘러싼 도구들을 볼 수 있고, Claude Code에서는 Fable 5.2가 기본적으로 Medium effort로 설정됩니다.
글쓰기에는 Fable에 돈을 쓰지 않겠습니다. 표에는 문장력을 측정하는 벤치마크가 없고, 지식 업무 행(루브릭 기준 66.1% 대 Opus 5.5의 61.2%)도 Anthropic이 직접 낸 수치입니다. Opus 5.5로 충분하고, $2와 $10의 Sonnet 5.5는 더 저렴합니다.
리서치에서는 크고 지저분한 자료 묶음에 Medium effort의 Fable 5.2를 써 보겠습니다. Anthropic은 과제당 비용 약 40%로 Opus 5.5의 최고 WANDR 점수와 맞먹는다고 말하고, Balyasny의 한 연구원은 이 모델이 질문의 프레이밍이 오해를 부를 수 있다고 짚어 주었다고 말했습니다(Anthropic). 그래도 인용은 직접 확인하십시오. 그 정직함을 뒷받침하는 증거는 추천사뿐이기 때문입니다.
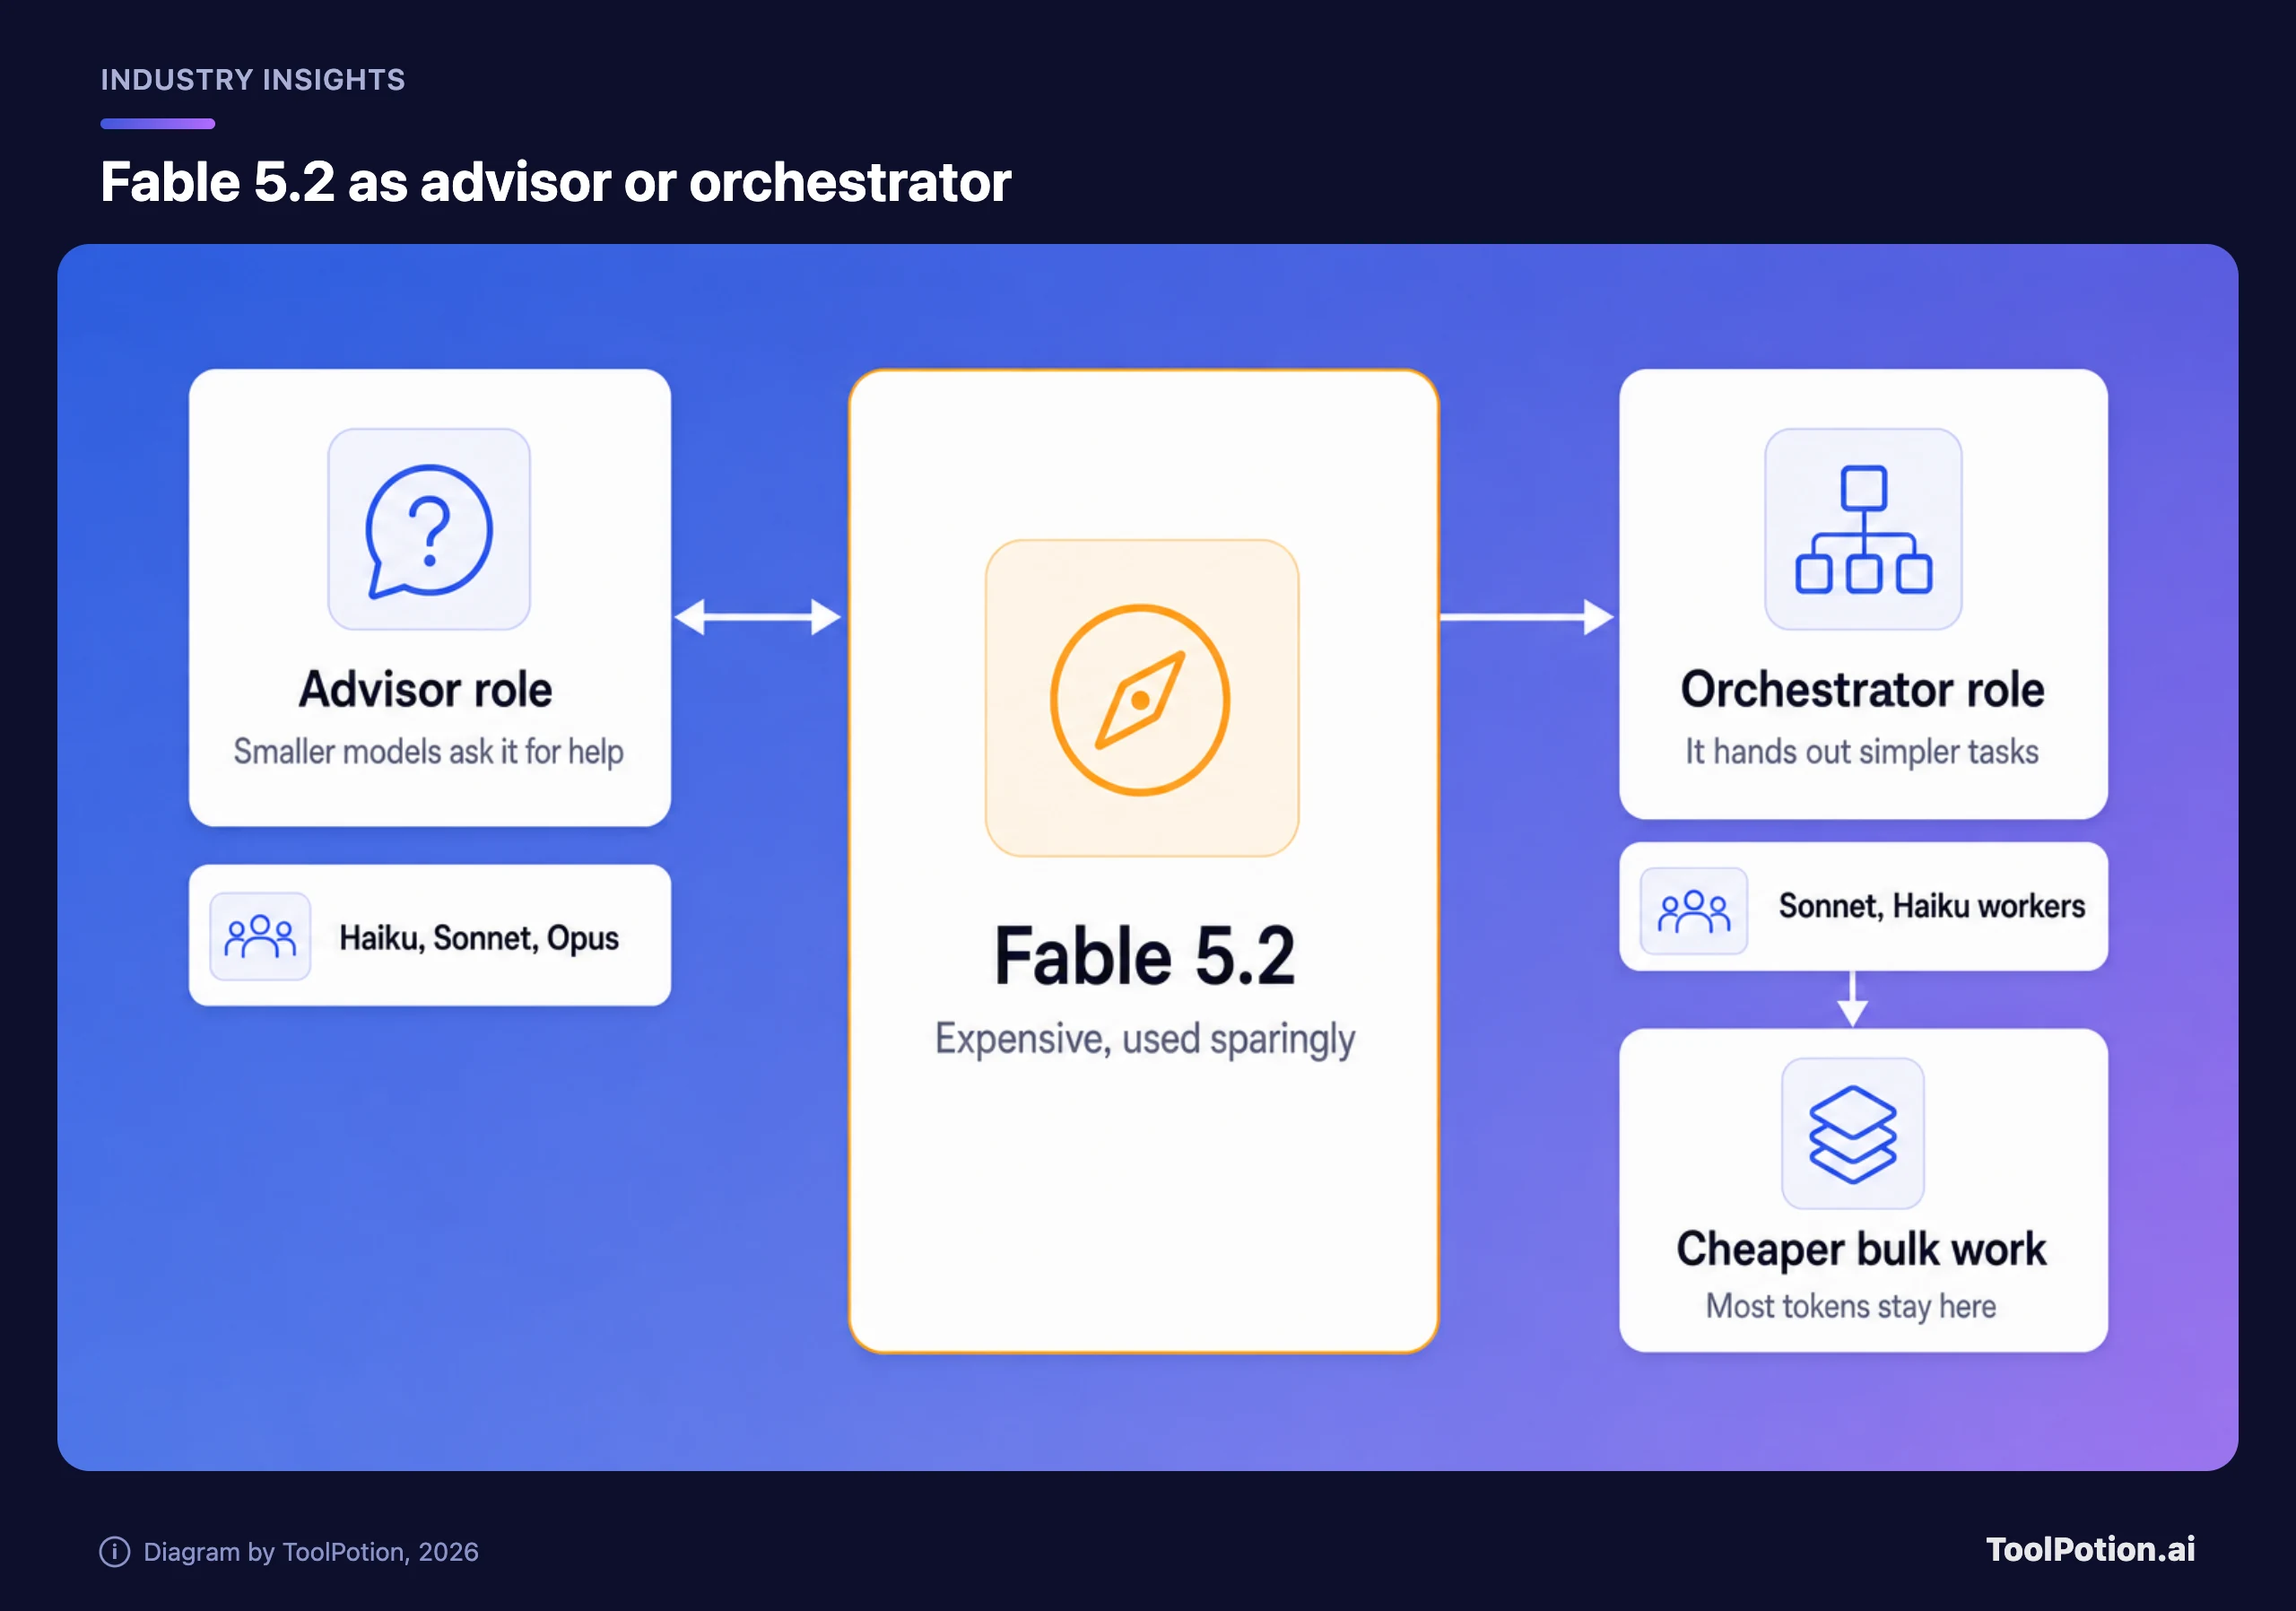
에이전트에서는 Fable을 플래너로 쓰고 대부분의 작업은 작은 모델에 맡기십시오. Anthropic은 Fable 5.2를 어려운 문제에서 Haiku, Sonnet, Opus가 조언을 구하는 Advisor로, 또는 더 단순한 작업을 위임하는 Orchestrator로 쓸 수 있다고 설명합니다(Anthropic). 이렇게 하면 $40 출력 요율이 대부분의 토큰에 붙지 않습니다. 다만 근거는 빈약합니다. 비즈니스 워크플로 행은 Carbon이 이기고, Google은 Google Antigravity에서 스웜 기능을 프리뷰 중입니다(The Verge). AI 에이전트 보드에서 그 위에 만들어진 도구들을 볼 수 있습니다.
예산이 빠듯하다면 Sonnet 5.5로 시작하십시오. 분류와 라우팅에는 $0.10와 $0.50(프롬프트 100K 토큰까지)의 Haiku 5.5를 쓰고, 급하지 않은 작업은 Batch API로 돌리십시오. Carbon은 아직 $2와 $10인 동안 자기 워크로드로 테스트하되, 도입을 결정하기 전에 $4와 $20로 계산해 보십시오. Fable은 예산형 목록에 들어갈 모델이 아닙니다.
보안 연구라면 Mythos 5.2를 신청하십시오. Fable은 대부분의 작업을 거부할 것입니다.
뭔가를 바꾸기 전에, 짧은 테스트는 비용이 얼마 들지 않습니다.
- 이미 모델에 맡겨 돈을 내고 있는 작업 열 가지를 고릅니다.
- Medium effort의 Fable 5.2와 기본 설정의 Opus 5.5로 각각 돌려 봅니다.
- 각 모델이 쓴 토큰을 포함해 완료된 작업당 비용과, 사람이 개입해야 했던 횟수를 비교합니다.
지켜볼 날짜는 두 가지입니다. Carbon의 출시 기념 가격이 끝나는 시점, 그리고 GitHub의 보관 예외가 끝나는 연말 전에 Enterprise Frontier Safeguards가 비공개 베타를 벗어나는지입니다.