

"리더보드 1위"라는 주장은 특정한 테스트를, 특정한 방식으로, 특정한 날에 돌렸을 때 참이라는 뜻일 뿐입니다. 그 모델이 여러분의 업무에 최선이라는 뜻은 아닙니다. 순위 때문에 도구를 바꾸거나 상위 요금제에 결제하기 전에, 그 순위가 어느 보드에서 나왔는지, 누가 돌렸는지, 무엇을 측정하는지부터 확인하세요.
2026년에는 이 점이 더 중요해졌습니다. 리더보드가 하나의 사업이 되었기 때문입니다. 예전 이름이 LMArena였던 공개 랭킹 사이트 Arena는 올해 2억 달러를 투자받아 31억 달러의 기업가치를 인정받았습니다. 2026년 초 17억 달러였던 가치가 거의 두 배가 된 것입니다(Phemex). Arena는 연환산 매출이 1억 달러를 넘었다고 밝혔습니다(Arena). 이제 모델 출시 때마다 순위가 맨 앞에 나오고, 그 순위가 제품을 팝니다.
그렇다고 보드가 가짜라는 말은 아닙니다. 대부분 진지한 사람들이 만들었고, 실제로 의미 있는 것을 측정합니다. 문제는 보드마다 측정하는 대상이 다르고, 출시 글은 모델에게 유리한 보드만 골라 인용한다는 점입니다. 이 글에서는 주요 보드가 어떻게 작동하는지, 각각 어디서 허점이 생기는지, 그리고 2분 안에 주장을 점검하는 방법을 설명합니다.
네 종류의 보드, 네 가지 다른 질문
여러분이 접하게 될 랭킹은 대부분 네 그룹 중 하나에 속합니다. 개별 보드보다 그룹이 더 중요합니다. 숫자가 어느 그룹에서 나왔는지 알아야 비로소 그 숫자의 의미를 알 수 있기 때문입니다.
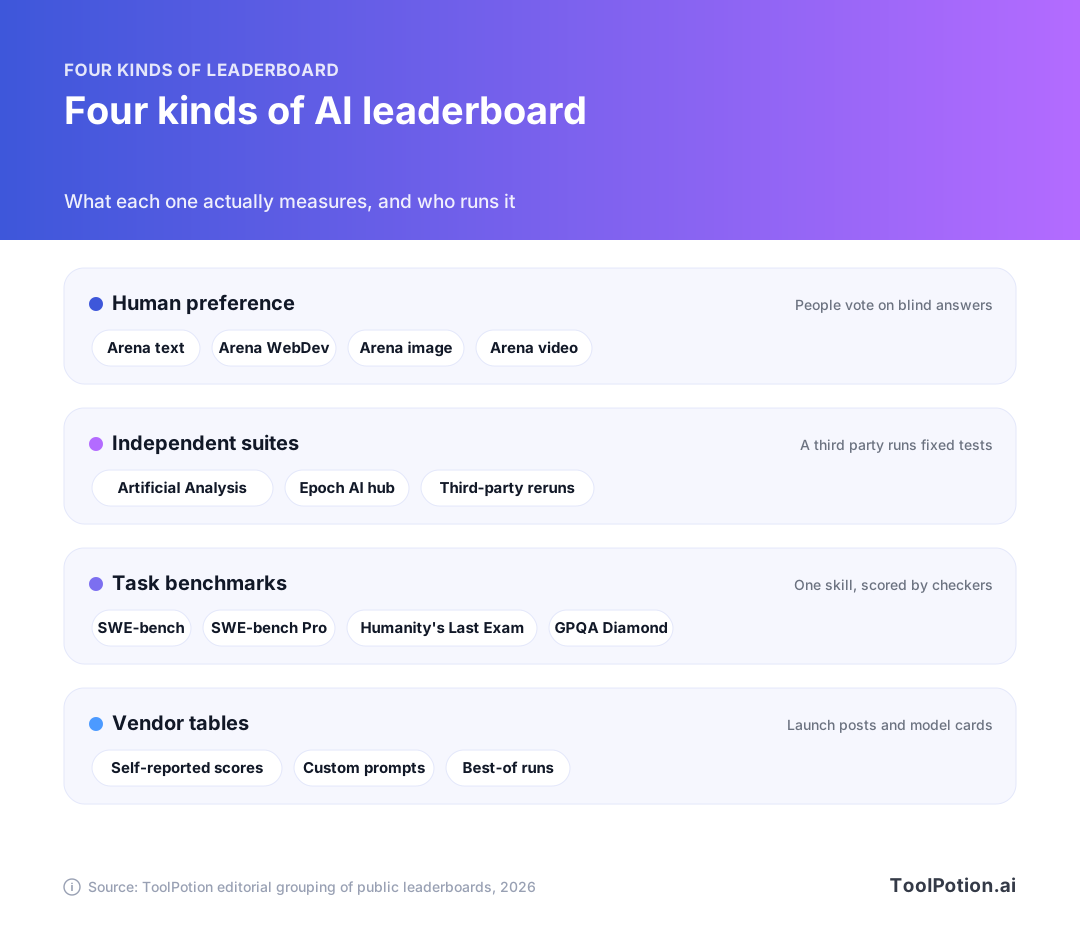
사람 선호도 아레나는 어떤 답변이 더 마음에 드는지 사람에게 묻습니다. 독립 평가 스위트는 모든 모델에 같은 조건에서 고정된 테스트 세트를 돌립니다. 과제형 벤치마크는 실제 소프트웨어 버그 수정처럼 한 가지 능력을 자동 채점기로 확인합니다. 벤더 표는 연구소가 자체 출시 글이나 모델 카드에 싣는 점수로, 대개 연구소가 고른 설정으로 측정한 것입니다.
이 그룹들은 경쟁 관계라기보다 서로 다른 질문에 답합니다. 선호도는 사람들이 어떤 모델과 대화하는 것을 즐기는지 알려줍니다. 평가 스위트는 중립적인 제3자가 시간을 재면 모델들이 어떻게 비교되는지 보여줍니다. 과제형 벤치마크는 모델이 좁은 한 가지 일을 해낼 수 있는지 알려줍니다. 벤더 표는 연구소가 여러분이 주목하길 바라는 것을 보여줍니다.
| 보드 유형 | 예시 | 측정 대상 | 주요 약점 |
|---|---|---|---|
| 사람 선호도 | Arena 텍스트·WebDev | 사람들이 투표한 답변 | 문체와 길이에 유리, 조작 가능 |
| 독립 평가 스위트 | Artificial Analysis, Epoch AI 허브 | 고정 테스트 세트 점수 | 선택한 테스트만큼만 신뢰 가능 |
| 과제형 벤치마크 | SWE-bench, Humanity's Last Exam | 자동 채점되는 단일 능력 | 오염, 결함 있는 과제, 포화 |
| 벤더 표 | 출시 글, 모델 카드 | 연구소가 보고하기로 한 것 | 확인할 수 없는 설정과 프롬프트 |
아레나 투표가 레이팅이 되는 과정
Arena는 UC 버클리의 연구 프로젝트인 Chatbot Arena에서 시작했습니다. 아이디어는 단순합니다. 프롬프트를 입력하면 익명의 모델 두 개가 답하고, 더 나은 답을 고릅니다. 연구진의 원 논문에 따르면 초기 몇 달 만에 24만 표 이상을 모았고, 다수 투표가 전문가 판단과 잘 일치했습니다(arXiv).
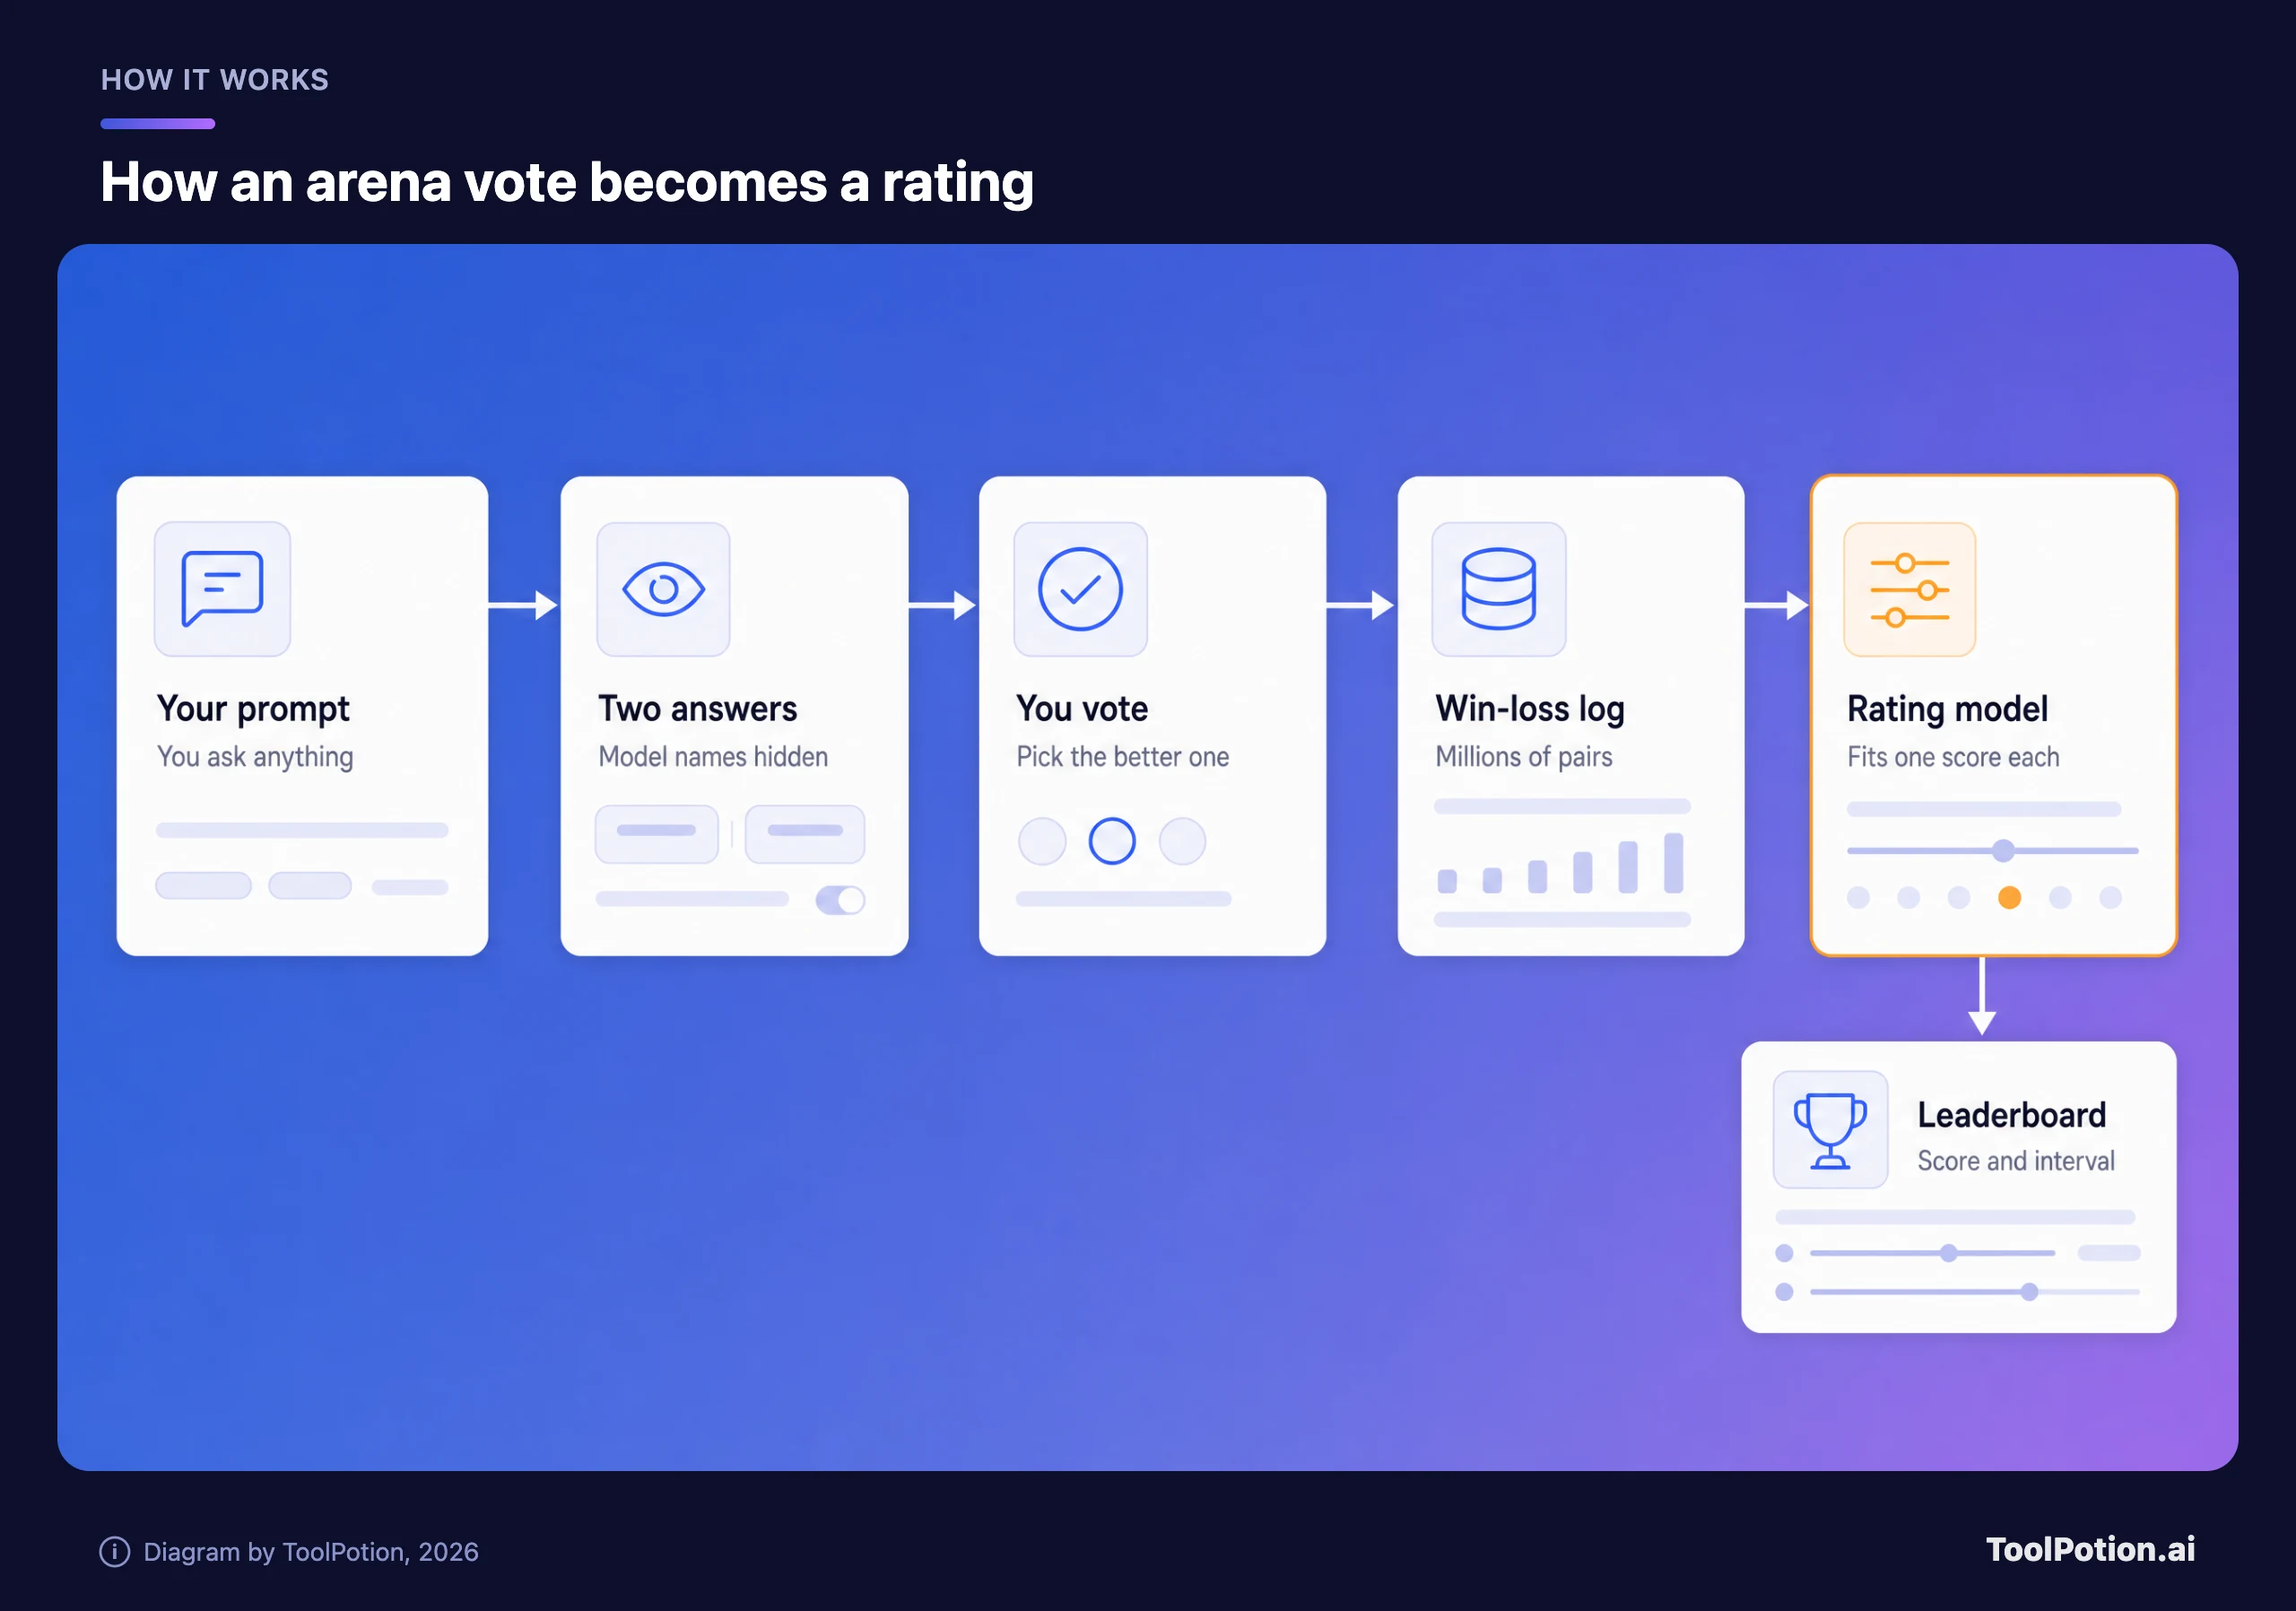
투표 하나는 "이 프롬프트에서는 모델 A가 모델 B를 이겼다"라는 아주 작은 기록입니다. 이런 기록 수백만 건이 통계 모델에 들어가 모델마다 점수 하나를 매깁니다. Arena의 자체 글은 이 방식을 Bradley-Terry 회귀라고 설명하는데, 체스에서 쓰는 Elo 시스템과 가까운 방법입니다(LMSYS). 강한 상대를 이기면 점수가 오르고 약한 상대에게 지면 내려갑니다. 텍스트 리더보드는 각 점수 옆에 점추정치만이 아니라 구간("±" 수치)도 함께 표시합니다.
출시 글이 건너뛰는 부분이 바로 이 구간입니다. 두 모델이 몇 점 차이이고 구간이 겹친다면, 정직하게 읽으면 동률입니다. 2~3점 차이에 기대 "1위"라고 하는 것은 대개 통계적으로 동전 던지기입니다.
Arena는 채팅을 훌쩍 넘어 성장했습니다. 현재 리더보드에는 텍스트, WebDev, 비전, 검색, 이미지 생성·편집, 비디오 보드가 따로 있고, 승률과 함께 과제당 비용을 보고하는 새로운 에이전트 보드도 있습니다(Arena). 비용 열은 읽어볼 만합니다. 한 계단 높은 순위가 몇 배의 가격을 치르고 얻은 것이라면 추천도 달라지기 때문입니다.
아레나가 알려주지 못하는 것
선호도 투표에는 잘 알려진 문제가 세 가지 있습니다. 첫째는 문체입니다. 사람들은 길고 서식이 잘 갖춰진 답변을 좋아하기 때문에, 모델은 더 길게 쓰고 헤더를 붙이는 것만으로 순위가 오를 수 있습니다. Arena 팀의 자체 분석에서도 답변 길이가 가장 큰 문체 효과였고, 길이와 마크다운을 보정하자 모델 순위가 바뀌었습니다. 2024년 분석에서 GPT-4o-mini는 6위에서 11위로 내려갔고 Claude 3.5 Sonnet은 6위에서 4위로 올라갔습니다(LMSYS). Arena는 이제 문체 보정 보기를 제공하니 활용하는 것이 좋습니다.
둘째 문제는 접근성입니다. Sayash Kapoor, Noah Smith 등이 저자로 참여한 2025년 논문 "The Leaderboard Illusion"은 대형 연구소가 Arena에서 구조적 이점을 누린다고 주장했습니다. 논문에 따르면 Meta는 Llama 4 출시 전에 비공개 모델 변형 27개를 테스트하고 최고 점수만 공개했습니다. 또 Google과 OpenAI가 전체 Arena 데이터의 약 19.2%와 20.4%를 받은 반면, 오픈 웨이트 모델 83개가 받은 몫은 합쳐서 약 29.7%로 추정했습니다(arXiv).
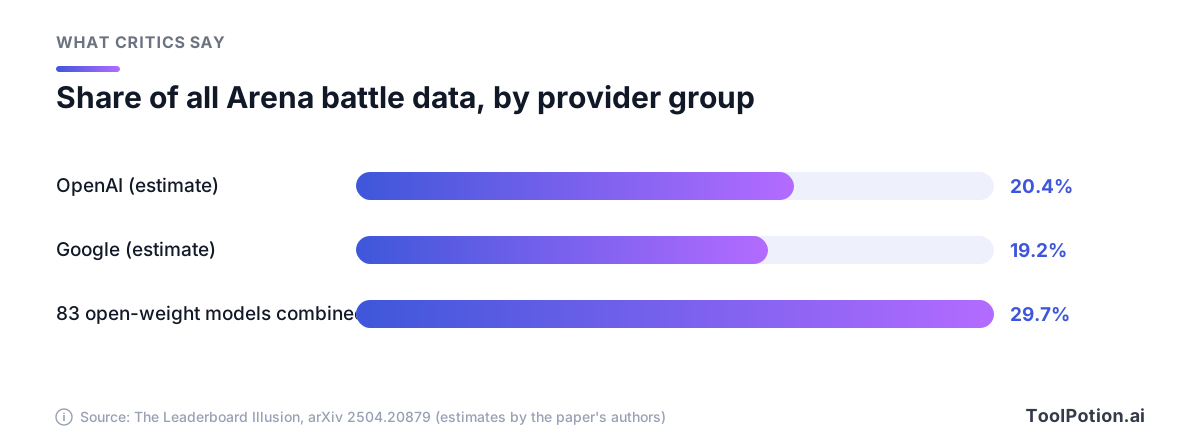
이 논문은 Arena 스타일 데이터로 학습하면 Arena 분포에서의 성능이 최대 112%까지 오를 수 있다고도 보고했습니다. 이는 범용 능력이 아니라 보드에 맞춰 튜닝할 유인이 된다는 뜻입니다. 이는 저자들의 추정과 주장이며, 논문 작성 시점의 스냅숏을 반영합니다. 그래도 선호도 보드가 누구도 규칙을 어기지 않고 어떻게 조작될 수 있는지를 외부에서 가장 분명하게 설명한 자료입니다.
셋째 문제는 선호도가 정확성은 아니라는 점입니다. 자신 있고 친절한 답변은 투표에서 이기고도 틀린 사실을 담고 있을 수 있습니다. 대화의 느낌이나 글쓰기를 볼 때는 선호도가 괜찮은 지표입니다. 하지만 실제로 돌아가야 하는 코드나 정확해야 하는 수치에는 약한 지표입니다.
Arena의 현재 정책 페이지는 이 문제 일부를 다룹니다. 공개 전 모델은 점수가 안정될 때까지(최소 1,000표) 익명 이름으로 테스트하고, 그 점수는 제공사에만 비공개로 공유한다고 합니다. 또 공개 출시 후에는 새 투표가 쌓일 때까지 모델 점수에 "preliminary"(잠정) 표시를 붙인다고 합니다. 모든 대결에는 공개된 모델이 최소 하나 포함되고, 전체 대결의 최소 20%는 공개 모델끼리의 대결이라고도 밝힙니다(Arena). 실용적인 규칙은 이렇습니다. "preliminary" 표시는 그 숫자가 아직 확정되지 않았다는 뜻입니다.
독립 평가 스위트: Artificial Analysis와 Epoch AI
선호도 보드가 사람들이 무엇을 좋아하는지 묻는다면, 독립 평가 스위트는 모두에게 같은 시험을 치르게 했을 때 모델이 무엇을 할 수 있는지 묻습니다. 가장 잘 알려진 곳이 Artificial Analysis입니다. 현재 버전 4.3.2인 Intelligence Index는 평가 10개를 네 그룹으로 묶습니다. 에이전트(가중치 30%), 일반 지식과 추론(30%), 코딩(20%), 과학적 추론(20%)입니다. 모든 모델을 같은 조건에서 pass@1(문항당 한 번만 시도) 방식으로 채점하며, 사이트는 데이터셋 사본을 자체 보관한다고 밝힙니다. 주관식 채점에는 서로 다른 연구소의 최상위 모델 세 개로 구성된 패널을 씁니다. 이 지수는 대체로 영어와 텍스트 중심이고, 다국어와 멀티모달 능력은 따로 벤치마크합니다(Artificial Analysis).
가중치는 편집상의 선택입니다. 에이전트 비중을 줄이고 코딩 비중을 높이는 식으로 가중치를 바꾸면 일부 모델의 순서가 달라집니다. 결함은 아니지만, "종합" 점수가 무엇이 중요한지에 대한 하나의 의견이라는 뜻입니다. 코딩이 가장 중요하다면 헤드라인 점수가 아니라 코딩 결과를 보세요.
Epoch AI는 벤치마크 허브를 운영합니다. GPQA Diamond, FrontierMath, SWE-bench Verified처럼 직접 실행하는 테스트와 외부 출처의 결과를 함께 담고 있습니다. 독자에게 가장 유용한 발견은 벤더 수치에 관한 것입니다. Claude 3.5 Sonnet은 GPQA Diamond에서 65%로 보고되었는데, Epoch이 16회 실행해 측정한 값은 55%(±3)였고, 연구소들이 사용한 프롬프트나 temperature를 공개하지 않는 경우가 많다고 지적했습니다(Epoch AI). 설정만으로 10포인트 차이가 난다면, 제3자의 재실행을 더 신뢰할 이유로 충분합니다. 이 허브는 영국 AI Security Institute의 지원을 받으며 데이터는 자유롭게 재사용할 수 있습니다.
독립적이라고 해서 편향이 없는 것은 아닙니다. 제3자도 테스트를 직접 고르고, LLM 심사위원을 쓰는 지수라면 심사위원의 습관을 물려받습니다. Arena가 AI 심사위원을 연구한 결과, 모델은 자기 답변을 선호했습니다. 모델 12개가 심사한 Text Arena 대결 1,460건에서 심사위원은 사람보다 약 70% 더 자주 자기 답변을 골랐습니다(Arena).
벤치마크는 닳습니다
과제형 벤치마크는 반대 문제를 안고 있습니다. 객관적이지만 빨리 낡습니다. 벤치마크가 어렵게 출범하면 연구소들이 최적화하고, 점수가 오르고, 테스트가 학습 데이터로 새어 들어갑니다. 곧 상위 모델이 모두 천장 근처에 몰려 순위가 의미를 잃습니다.
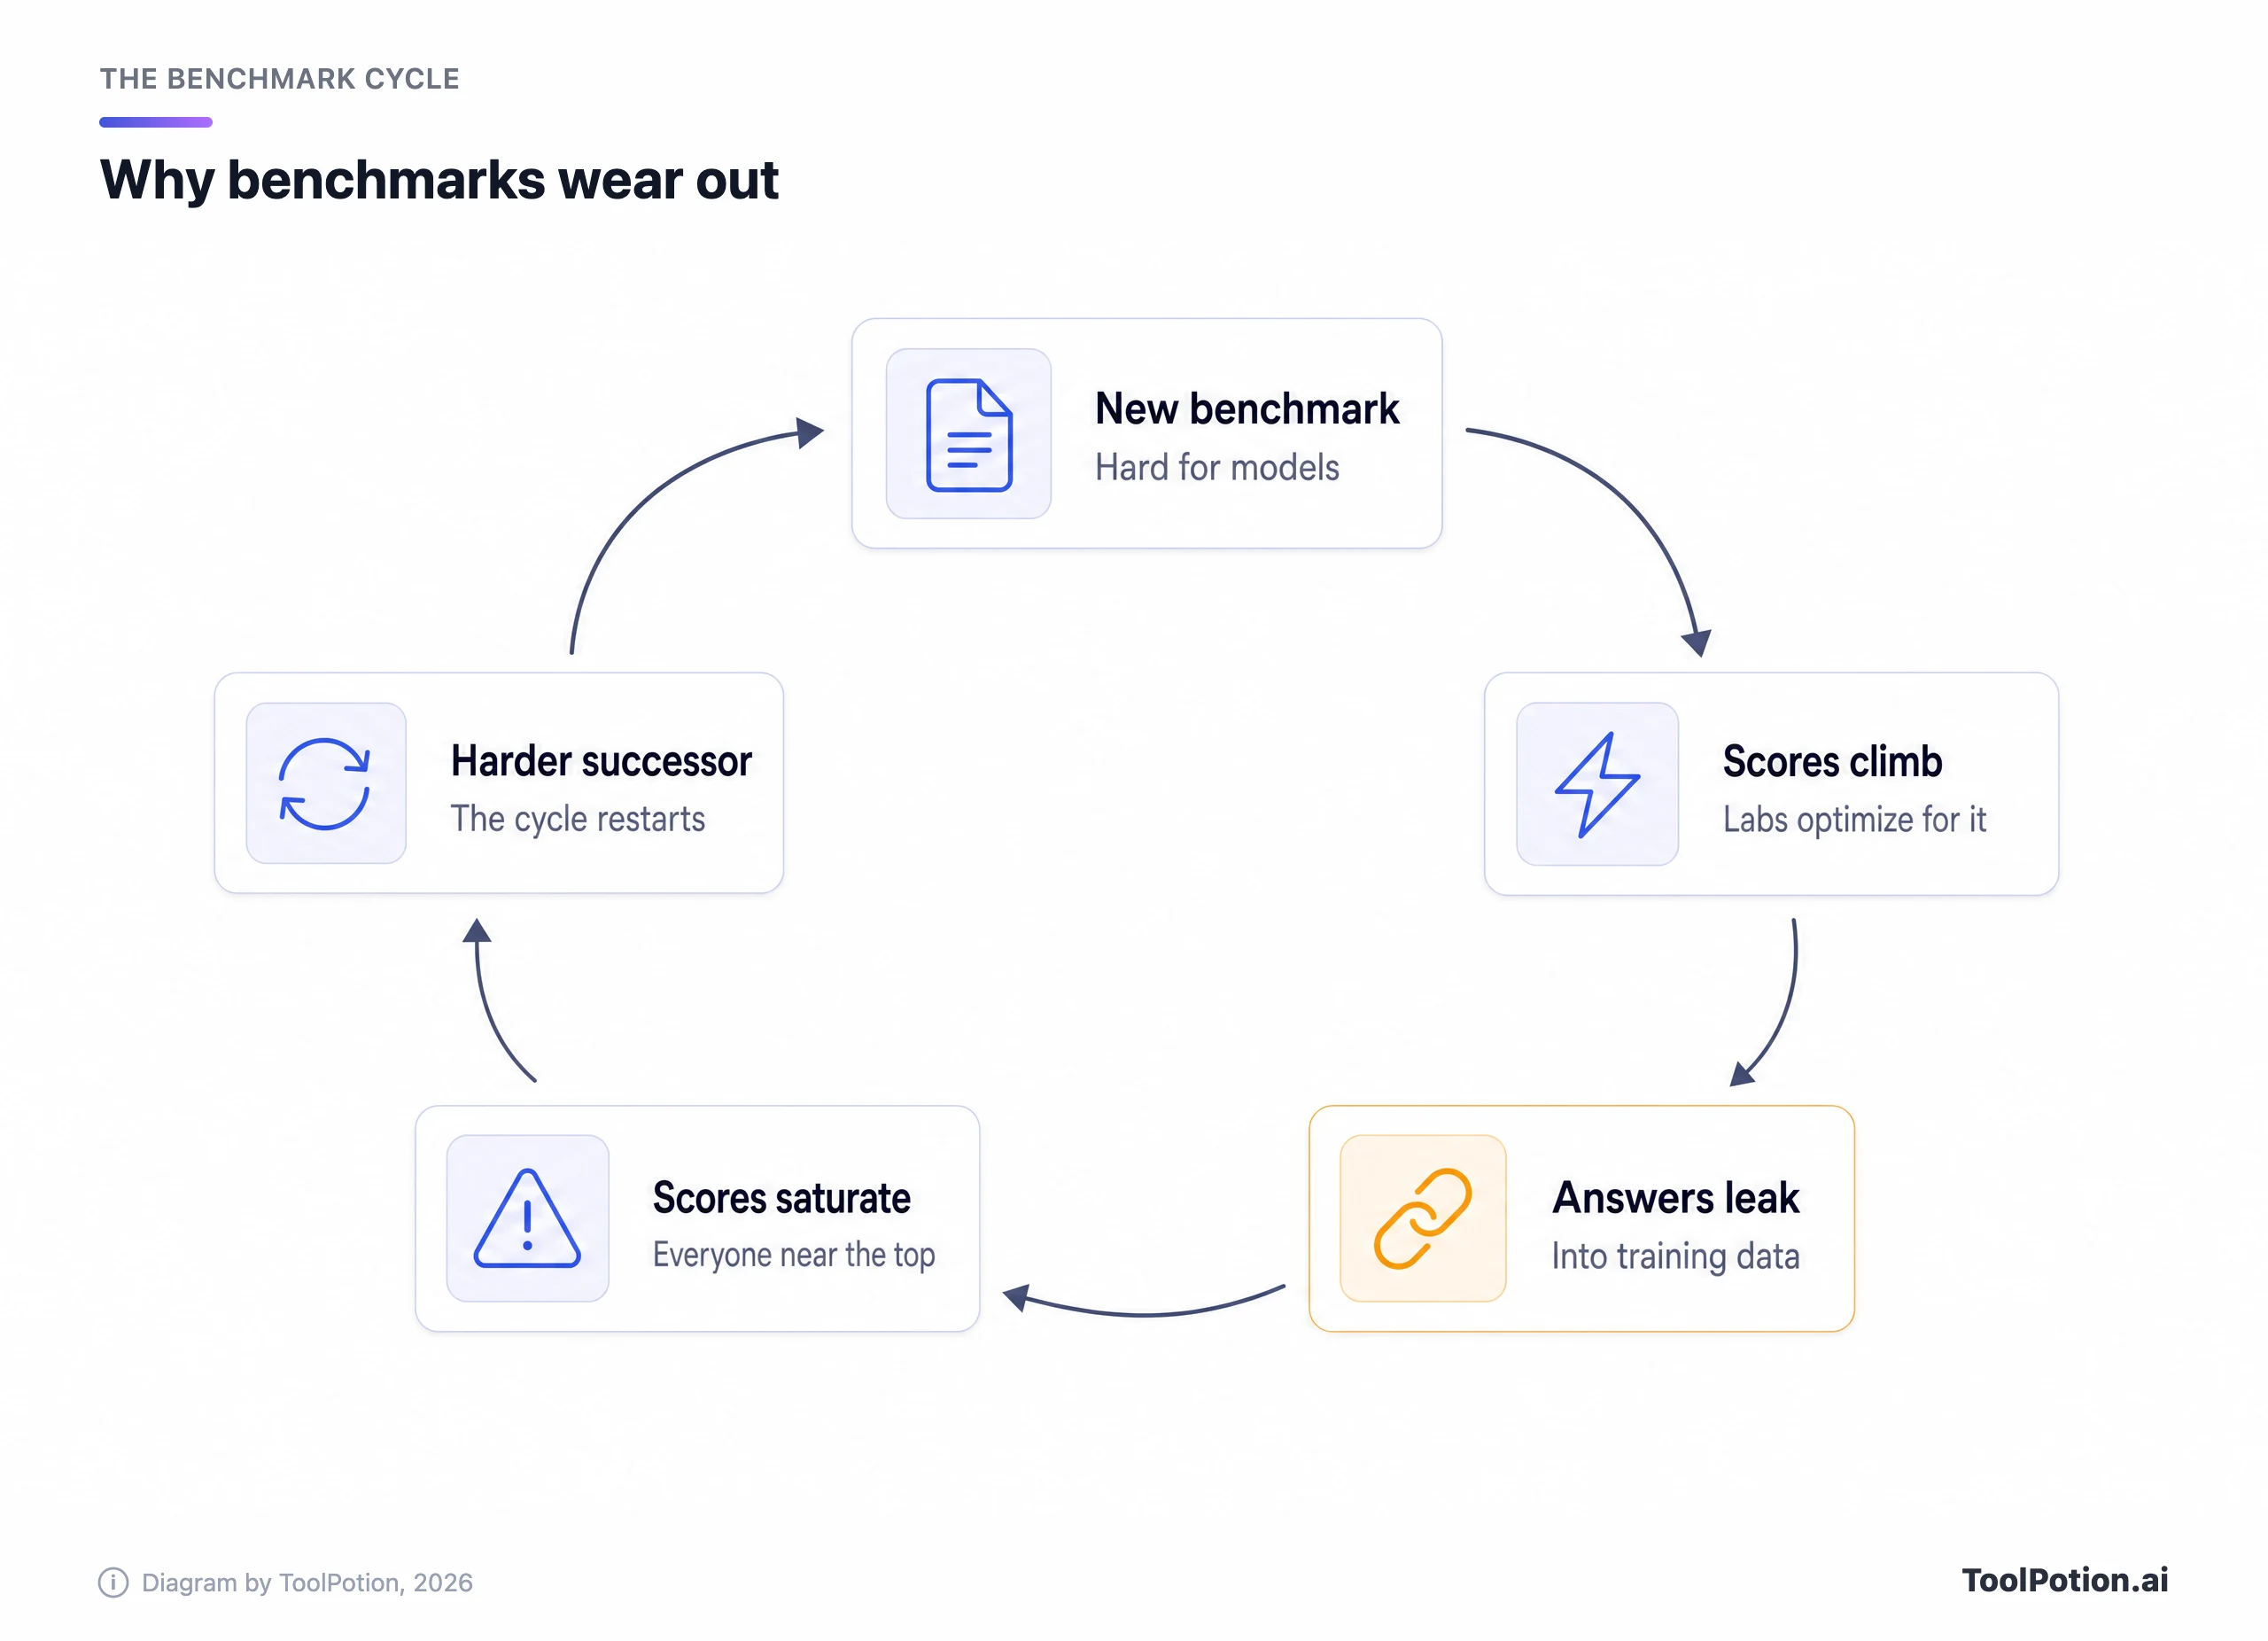
Humanity's Last Exam은 이런 문제에 대한 대응의 좋은 예입니다. 100개가 넘는 분야에 걸쳐 2,500문항으로 구성되어 있고, 500개 이상 기관의 전문가 약 1,000명이 출제했으며, 과적합을 잡아내기 위해 비공개 테스트 세트를 따로 둡니다. 저자들은 MMLU 같은 기존 시험을 최상위 모델이 90% 넘게 풀어버렸기 때문에 이 시험을 만들었습니다(arXiv). 2026년에 Nature에 게재되었고, 제작진조차 점수가 빠르게 오르리라 예상했습니다.
SWE-bench는 전체 수명 주기를 보여줍니다. 원래 벤치마크는 Python 프로젝트 12개의 실제 GitHub 이슈 2,294건으로 구성되었고, 당시 최고 모델이던 Claude 2는 그중 1.96%를 해결했습니다(원 논문 기준). 정제된 500개 과제 하위 집합인 Verified는 코딩 모델 출시 때 표준 수치가 되었습니다. 그러다 감사 결과가 나왔습니다.
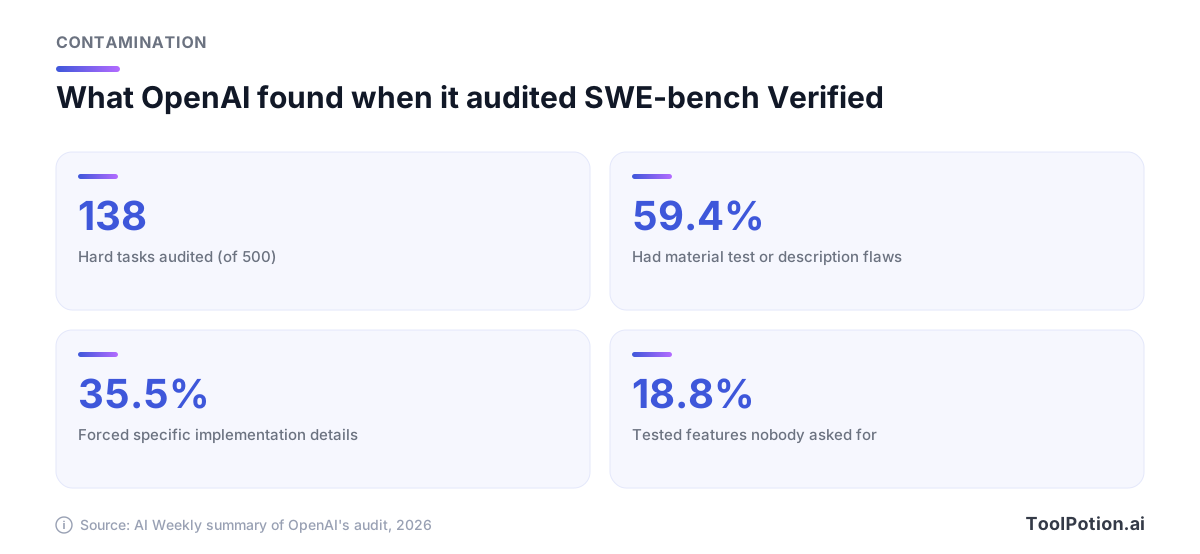
OpenAI는 자사 o3 모델이 안정적으로 풀지 못한 Verified 문제 138개를 감사했고, 각 문제는 엔지니어 최소 6명이 검토했습니다. 그 결과 59.4%에서 테스트나 설명에 중대한 문제가 발견되었습니다. 별도의 오염 테스트에서는 GPT-5.2, Claude Opus 4.5, Gemini 3 Flash Preview가 모두 원래 수정 내용의 세부사항을 재현할 수 있었는데, 이는 과제가 학습 데이터로 유출되었다는 신호입니다. OpenAI는 Verified 점수 보고를 중단했고 대신 SWE-bench Pro를 권장한다고 밝혔습니다(OpenAI). AI Weekly의 요약에 따르면 상위 모델은 Verified에서 약 80%였지만 Pro에서는 대략 35포인트 낮았고, 이후 외부 감사에서는 Pro의 채점기에도 의문이 제기되었습니다(AI Weekly).
교훈은 코딩 벤치마크가 쓸모없다는 것이 아닙니다. 폐기되었거나 유출된 테스트의 점수는 낡은 숫자라는 것입니다. 출시 글이 SWE-bench를 인용하면 어느 버전인지, 모델을 감싼 에이전트 스캐폴딩이 무엇인지 확인하세요. 모델과 스캐폴딩 조합 21쌍을 다룬 Arena의 "HarnessTax" 연구에서는 스캐폴딩 선택이 과제 성공률에는 거의 영향을 주지 않았지만, 비슷한 결과를 내는 데 드는 비용은 최대 5배까지 바꿨습니다. 다만 벤치마크당 30개 과제라는 작은 표본입니다(Arena).
모든 "1위" 주장을 위한 체크리스트
2분이면 되는 버전입니다. 순위를 믿기 전에, 특히 순위 때문에 돈을 쓰기 전에 하나씩 확인해 보세요.
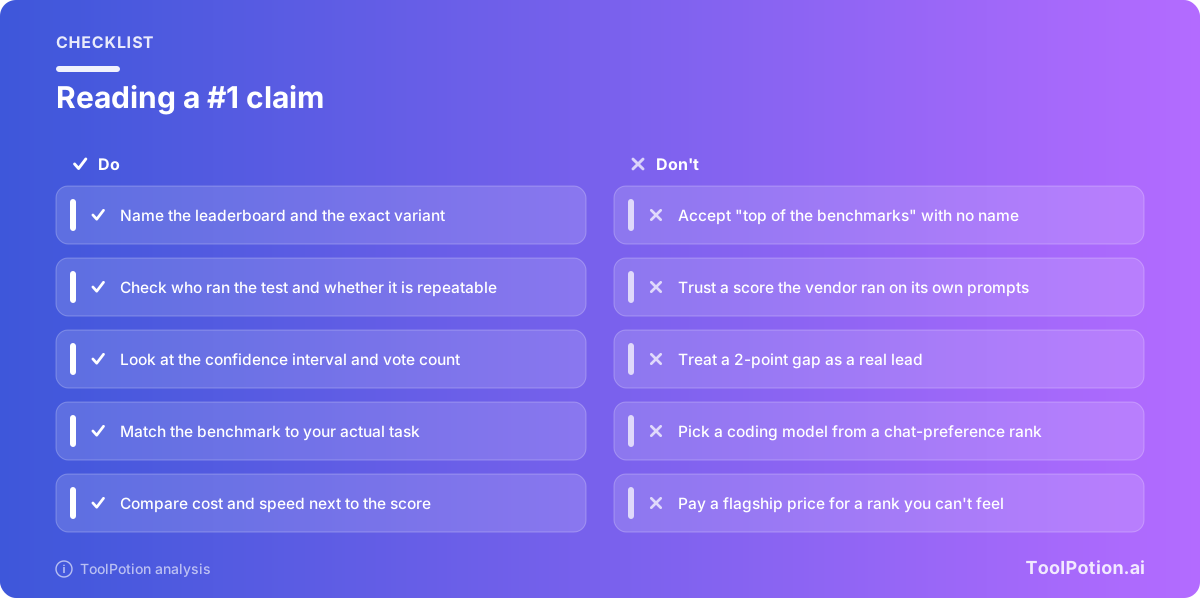
- 정확한 보드와 버전을 찾으세요. "벤치마크 석권"은 확인할 수 없는 주장입니다. "문체 보정을 적용한 Arena 텍스트 1위"는 확인할 수 있습니다.
- 누가 돌렸는지 찾으세요. 연구소가 자기 프롬프트로 직접 돌린 결과는 마케팅 수치입니다. 제3자의 재실행이 더 무게가 있습니다.
- 구간과 투표 수를 읽으세요. 격차가 구간보다 작으면 동률입니다.
- 모델이 공개되어 있는지 확인하세요. 지금 써볼 수 없는 모델의 점수는 선택에 도움이 되지 않습니다.
- 테스트가 내 작업과 맞는지 따져보세요. 채팅 선호도로는 내 스프레드시트나 코드베이스를 모델이 얼마나 잘 다루는지 예측할 수 없습니다.
- 서로 다른 두 번째 보드가 같은 결과를 내는지 찾아보세요. 보드 하나는 틀리거나 조작될 수 있습니다. 서로 무관한 두 보드가 일치하는 결과는 훨씬 위조하기 어렵습니다.
- 점수 옆에 가격과 속도를 나란히 놓으세요. 두 계단 낮은 더 저렴한 모델이 더 나은 선택인 경우가 많습니다.
아래 체크리스트로 주장을 직접 채점해 볼 수 있습니다. 제3자 실행이나 보드 간 일치처럼 위조하기 가장 어려운 항목에 가중치를 더 두었습니다.
내 질문에 맞는 보드 고르기
보드마다 답하는 질문이 다르기 때문에, 질문에서 출발해 보드를 나중에 고르는 것이 유용합니다. 글쓰기와 대화용 어시스턴트를 고른다면 선호도 아레나가 괜찮은 1차 필터입니다. 원초적인 능력을 반복 가능하게 비교하고 싶다면 독립 평가 스위트를 쓰세요. 코딩 도구를 고른다면 실제 저장소를 바탕으로 한 과제형 벤치마크를 보고, 그다음 내 코드로 직접 테스트하세요.
이 의사결정 트리는 출발점일 뿐 판정이 아닙니다. 어떤 보드에 도착하든 내 업무로 해보는 짧은 테스트가 어떤 공개 순위보다 낫습니다. 매주 하는 실제 작업 10개를 골라 후보 두세 개에 돌려 보고 결과물을 나란히 비교하세요. 오후 한나절이면 됩니다. 그리고 어떤 리더보드도 측정하지 못하는 단 하나, 바로 여러분의 업무를 측정해 줍니다.
카테고리별로 찾아보려면 ToolPotion의 AI Models & LLMs 디렉터리와 AI 모델 보드에서 모델을 나란히 비교할 수 있습니다. 플래그십 모델에 돈을 쓸 가치가 있는 경우는 작업에 맞는 AI 모델 등급 고르기 가이드에서 다룹니다. 더 폭넓은 정리가 필요하면 2026년 Top 15 AI Models & LLMs를, 어시스턴트 하나를 출발점으로 삼고 있다면 2026년 ChatGPT 대안을 보세요.
숫자를 가장 덜 믿어야 하는 경우
특별히 더 의심해야 하는 상황이 몇 가지 있습니다. 출시 직후 며칠간의 신규 모델은 투표 수가 적고 구간이 넓습니다. Arena가 이런 점수를 잠정으로 표시하는 데는 이유가 있습니다. Hugging Face에서 내려받을 수 있는 오픈 웨이트 모델도 또 다른 사각지대입니다. Leaderboard Illusion의 저자들은 이런 모델이 Arena 데이터에서 더 작은 몫을 받는다고 추정했고, 그래서 점수의 변동이 더 클 수 있습니다. 호스팅되는 모델은 같은 이름 뒤에서 동작이 바뀔 수도 있어서, 출시 주간의 점수가 몇 달 뒤 쓰고 있는 모델을 설명하지 못할 수 있습니다.
전문 분야 업무는 가장 큰 공백입니다. 법률 문서 작성, 의료 코딩, 소수 언어, 회사 내부 코드베이스는 모두 공개 보드가 제대로 다루지 못합니다. Real-SWE Benchmark가 하나의 답입니다. 비공개 기업 코드베이스로 최상위 모델을 평가하는데, 공개 저장소보다 학습 데이터로 유출됐을 가능성이 낮습니다. 이런 보드는 유용한 세컨드 오피니언으로 보되, 직접 해보는 테스트를 대체하는 것으로 여기지는 마세요.
일반 사용자라면 이 모든 것이 필요 없을 수도 있습니다. 일상적인 글쓰기와 질문에는 OpenAI, Anthropic, Google의 상위 모델 몇 개가 서로 충분히 비슷해서, 선택은 가격과 인터페이스, 익숙함으로 갈립니다. 사실상 동률인 모델 중에서 고르려고 순위를 한 시간씩 들여다보는 것은 손해 보는 거래입니다.
자주 묻는 질문
Arena와 LMArena는 같은 건가요?
네, 같습니다. LMArena는 UC 버클리의 Chatbot Arena 연구 프로젝트에서 출발했고 지금은 arena.ai에서 Arena라는 이름을 씁니다. 예전 이름은 기사와 오래된 논문에 아직 남아 있습니다.
가장 신뢰할 만한 리더보드는 어디인가요?
모든 경우에 신뢰할 수 있는 보드는 없고, 무엇을 알고 싶은지에 따라 답이 달라집니다. 재현 가능성을 보려면 모든 모델을 직접 돌리는 제3자 평가 스위트가 가장 강합니다. 사람들이 무엇을 선호하는지는 Arena에 데이터가 가장 많습니다. 가장 믿을 만한 근거는 서로 무관한 두 보드가 일치하는 경우이고, 그다음이 내 작업으로 해보는 짧은 테스트입니다.
벤치마크 오염이란 무엇인가요?
모델이 학습 중에 테스트의 문제나 정답을 본 탓에, 높은 점수가 실력이 아니라 암기를 반영하는 상황입니다. OpenAI의 SWE-bench Verified 감사에서는 최상위 모델이 일부 과제의 원래 수정 내용을 재현할 수 있었습니다. Humanity's Last Exam이 유지하는 것 같은 비공개 테스트 세트가 한 가지 방어책입니다.
벤더들이 리더보드에서 부정행위를 하나요?
증거로 뒷받침되는 것은 더 좁은 주장입니다. 연구소는 어떤 점수를 공개할지, 어떤 설정을 쓸지, 그리고 Leaderboard Illusion 논문에 따르면 어떤 비공개 변형을 공개할지 직접 고릅니다. 이는 규칙 안에서의 선택적 보고이지, 반드시 규칙 위반은 아닙니다. 독립적인 재실행이 중요한 이유가 바로 이것입니다.
새 모델이 1위에 오를 때마다 갈아타야 하나요?
아니요. 순위 차이는 오차 범위 안에 있는 경우가 많고, 갈아타면 프롬프트, 워크플로, 테스트에 실제 비용이 듭니다. 내 작업에서 현재 모델을 이길 때, 또는 눈에 띄게 낮은 가격으로 비슷한 성능을 낼 때 갈아타세요.