

GitHub는 Artificial Analysis Coding Agent Index에서 Copilot Fusion Max가 "60점을 기록해 Opus 5.5 Max 기반 Claude Code와 2점 차이 이내"라고 밝혔습니다(GitHub changelog). The New Stack의 헤드라인은 이를 "API 비용 절반으로 Claude Code를 이긴다"는 시스템으로 바꿔 놓았습니다(The New Stack). 두 문장은 서로 다릅니다. 팀이 따져봐야 할 부분은 바로 그 차이입니다.
Fusion은 GitHub Copilot의 모델 선택기에 새 항목으로 추가되어 정식 출시되었습니다. 모델을 직접 고르지 않고 effort 수준을 고르면, 프롬프트마다 Copilot이 어떤 모델을 어떤 순서로 실행할지 정합니다. 좋은 아이디어지만 근거는 아직 빈약하므로, 품질 주장보다 먼저 비용 절감 기능으로 보시길 권합니다.
60점은 62점이 아닙니다
GitHub의 표현을 다시 읽어보십시오. Fusion Max는 Opus 5.5 Max 기반 Claude Code와 2점 차이 이내였고, 작업당 평균 API 비용은 약 절반, 토큰은 약 절반, 소요 시간은 약 40% 적었습니다(changelog). 충분히 괜찮은 결과이고 타당한 셀링 포인트입니다. 하지만 승리는 아닙니다. New Stack도 본문에서는 "comparable(비슷한 수준)"이라고 쓰면서 헤드라인에는 "beats(이긴다)"를 달았습니다. GitHub는 Universe recap에서도 같은 주장을 반복했고, 널리 퍼지는 것은 "절반 비용"이라는 버전입니다.
GitHub가 인용한 지수는 Artificial Analysis가 발표합니다. FrontierCode, Terminal-Bench 4.0, SWE-Atlas-QnA-AA 세 벤치마크를 동일한 가중치로 합산합니다(Artificial Analysis). 이 페이지의 기본 화면에서는 Opus 5.5 Max 기반 Claude Code가 62점이고 Fusion 항목은 없습니다. "Router models" 토글을 켜면 GitHub Copilot - Copilot Fusion (Max)가 60점으로 나타나므로, 숫자는 사실이고 GitHub가 말한 위치와 일치합니다. 같은 토글에는 Opus 5.5 Max와 GPT-6 Luna를 짝지은 Cognition의 Devin Fusion CLI도 Claude Code와 같은 62점으로 올라와 있습니다. 라우터라는 부류 전체가 따라잡고 있다는 뜻이지, GitHub의 라우터가 넘어서야 할 대상이라는 뜻은 아닙니다. 이 페이지의 비용 열을 GitHub의 "절반 비용" 수치와 대조해 보지는 않았으므로, 그 부분은 아직 GitHub의 주장으로 남아 있습니다.
메뉴 항목 하나 뒤의 세 갈래 경로
문서는 Fusion을 "지능형 런타임 모델 라우터이자 오케스트레이터"라고 설명합니다(GitHub Docs). 프롬프트마다 세 가지 실행 패턴 중 하나를 고르며, 한 세션 안에서도 프롬프트에 따라 경로가 달라질 수 있습니다.
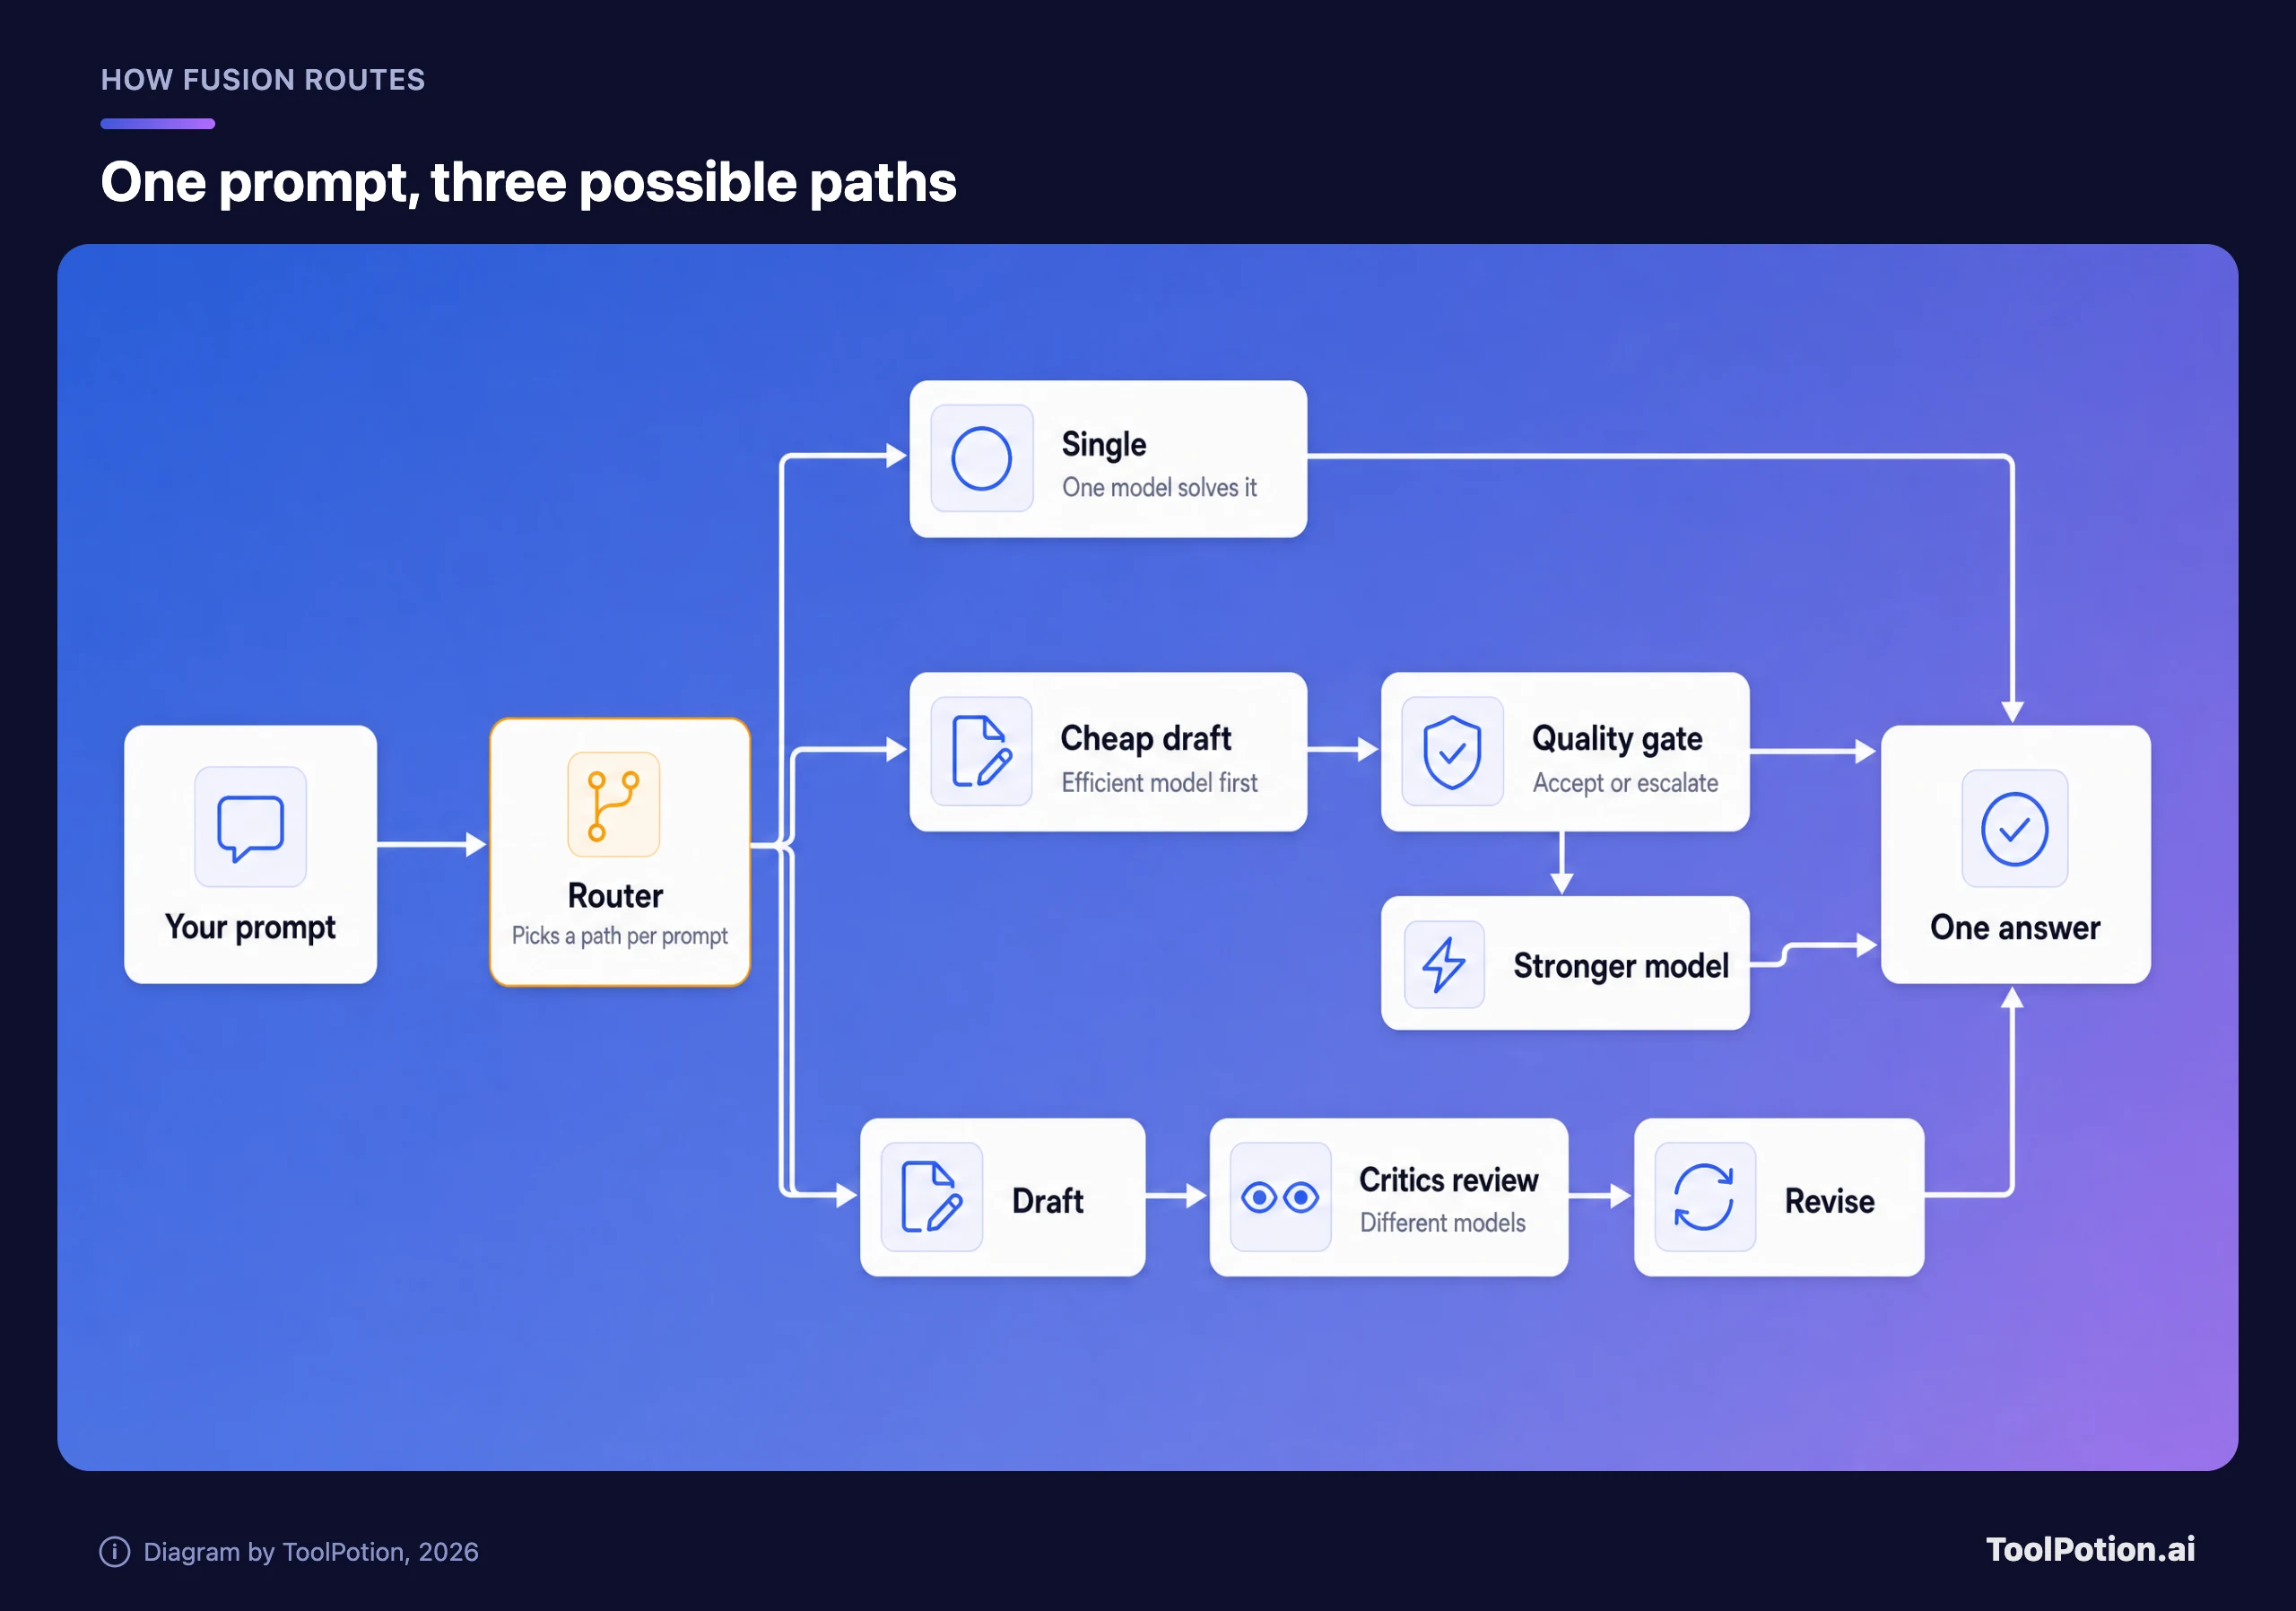
Single은 한 모델이 바로 답하는 방식입니다. Cascade는 효율적인 모델이 초안을 쓰면 judge가 그 초안을 채택할지, 더 강한 모델로 넘길지 결정합니다. Critique는 한 모델이 초안을 쓰는 동안 다른 모델들이 검토하고, 작성한 모델이 이를 반영해 수정합니다. effort 수준은 라우팅이 얼마나 적극적인지를 정합니다. Standard는 일상 작업, High는 규모가 큰 작업, Max는 가장 어려운 추론용입니다.
프리뷰와 정식 출시 사이에 바뀐 점이 하나 있습니다. GitHub의 이전 리서치 프리뷰 글은 "다른 모델 계열의 독립적인 읽기 전용 비평가"를 설명했습니다(GitHub blog). 출시 changelog는 "another model reviews it(다른 모델이 검토한다)"이라고 쓰고, 문서는 여러 모델이 병렬로 비평하고 그 피드백을 취합한다고 설명합니다. 비평 단계가 리뷰어 하나에서 여럿으로 늘어난 것으로 보이지만, GitHub는 그렇게 밝히지 않았고 changelog에도 차이가 표시되어 있지 않습니다.
모든 플랜에서 쓸 수 있고, 모델별로 과금됩니다
changelog에 따르면 Fusion은 VS Code, Copilot 앱, Copilot CLI, JetBrains IDE의 모든 Copilot 플랜에서 사용할 수 있으며, 지원 클라이언트는 더 늘어날 예정입니다. 사용된 모든 모델에 해당 모델의 표준 요율이 청구되고, Fusion 전용 요금은 따로 없습니다. 유료 플랜은 한시적으로 모델 비용을 30% 할인받으며, 문서에 따르면 이 할인은 올해 후반에 종료됩니다(docs).
확실하지 않은 부분이 두 가지 있습니다. Fusion 문서는 "모든 GitHub Copilot 플랜에서 사용 가능"하다고 하지만, 플랜 페이지는 Free와 Student에서는 모델 접근이 자동 모델 선택으로만 가능하다고 설명합니다. GitHub는 이 둘을 조율해 설명하지 않습니다. 문서의 플랜별 effort 수준 표는 아이콘으로 제공 여부를 표시하는데, 저희가 읽었을 때는 빈 셀로 나와서 Free와 Student 시트에서 어떤 수준을 쓸 수 있는지 알 수 없습니다. 직접 선택기를 확인해 보십시오. 또 High와 Max는 여러 모델을 호출할 수 있어서, 문서도 Standard보다 AI 크레딧을 더 쓸 수 있다고 경고합니다. 작업당 비용이 절반이라는 것은 Max를 Claude Code와 비교한 주장이지, 여러분의 크레딧 잔액에 대한 약속이 아닙니다.
벤치마크는 GitHub가 GitHub를 채점한 것입니다
앞서 나온 HydraFusion 글은 출시 글보다 솔직합니다. 테스트는 모든 모델에 같은 medium 추론 수준을 적용했고, 공통 가격 가정 아래 추정 비용을 썼으며, Opus 5와 GPT-5.6 Sol을 비교 대상으로 삼았습니다. GitHub는 또한 보고한 것과 같은 세 벤치마크에서 beam search로 라우팅 정책을 튜닝했다고 밝힙니다(GitHub blog).
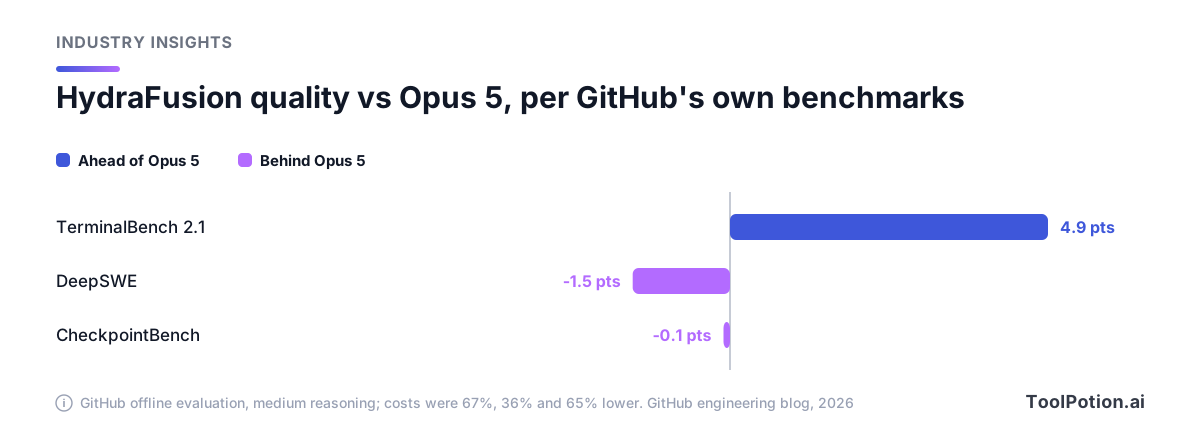
결과의 모양을 보십시오. 한 벤치마크에서는 4.9점 올랐고, 나머지 둘은 소폭 하락했으며 비용은 36%에서 67% 낮았습니다. 품질은 대략 비슷하게 유지하면서 비용을 줄였다는 이야기이고, 출시 홍보 문구도 결국 같은 말을 하고 있습니다.
Hacker News의 개발자들은 비교 기준을 문제 삼았습니다. 한 댓글은 "Opus 5는 (실제로는) 비교 기준으로 좋지 않다"고 썼습니다(HN). 다른 댓글은 결과를 의심하며 "모델과 하네스 사이에 소프트웨어를 하나 더 끼우면 개별 벤치마크에서 프런티어를 이기는 건 어렵지 않다"고 했습니다(HN). 같은 스레드의 Copilot CLI 사용자는 auto 모드가 "세션 시작이나 compaction 이후에만 모델을 바꾼다"고 했고(HN), 또 다른 사용자는 자동 선택이 자신에게는 "사실상 쓸 수 없다"고 했습니다(HN). 연구가 아니라 개별 댓글이지만, 회의론이 어디에 있는지는 보여줍니다.
청구 방식의 불일치도 염두에 두셔야 합니다. 지수와 GitHub의 비교는 토큰당 과금되는 API 비용을 기준으로 합니다. 정액제 Claude Code 구독을 쓰는 개발자는 그 숫자를 볼 일이 없으므로, "절반 비용"은 개인 사용자와 API 지출을 계량하는 팀에게 다르게 와닿습니다. Artificial Analysis 스스로도 많은 사용자가 토큰당 과금이 아닌 구독으로 이 도구들을 쓴다고 언급합니다. 이 결론은 GitHub의 주장이 아니라 저희의 추론이지만, 헤드라인이 누구를 겨냥하는지를 바꿉니다.
GitHub가 내놓은 고객 목소리는 AT&T의 Hari Pokhrel 한 명이며, GitHub 자체 changelog에 인용되어 있습니다. "예전에는 개발자들이 복잡한 작업에 더 강력한 모델을 골라 놓고, 일상 작업에서 다시 바꾸는 것을 잊곤 했습니다." 이것이 Fusion을 쓰는 솔직한 이유입니다. 일상 작업에 비싼 모델을 계속 켜 두는 일을 막아 줍니다.
누가 여러분의 diff를 읽는지는 정책이 정합니다
벤치마크보다 먼저 읽어야 할 부분입니다. Fusion은 엔터프라이즈 및 조직 정책에서 활성화된 모델만 사용합니다. 관리자는 다른 곳에서는 그대로 두고 Fusion에서만 특정 모델을 비활성화할 수 있고, 데이터 레지던시나 FedRAMP 정책에 따라 제외된 모델은 쓰이지 않습니다(docs).
두 번째 모델의 리뷰가 이 설계의 핵심 베팅이고, 프리뷰 글은 그 리뷰어가 다른 모델 계열이라고 했습니다. 다른 벤더라는 뜻이라면 그 벤더가 여러분의 diff를 보게 되므로, 팀의 누군가가 의도를 갖고 내려야 할 데이터 처리 결정입니다. 응답이 끝난 뒤 effort 라벨에 마우스를 올리면 어떤 모델이 실행되었는지 볼 수 있습니다.
제한 사항 항목도 중요합니다. Fusion이 초안을 폐기해도 그 초안이 이미 만든 파일 수정은 자동으로 되돌려지지 않으므로, 커밋하기 전에 diff를 검토하십시오. 또 Fusion에는 자체 컨텍스트 윈도우가 없고, 표시되는 값은 포함된 모델 중 가장 작은 값입니다.
팀 트라이얼에서 둘 위치
Copilot 팀의 기본값으로는 Fusion Standard를 쓰고, Max는 기본값에서 제외하겠습니다. 독립 지수에서 받은 60점은 괜찮은 수치지만, Max는 가장 많은 모델을 호출하고 크레딧을 가장 많이 쓰는 수준입니다. AT&T 사례가 해당하는 곳이 Standard이고, 라우팅으로 가장 많이 절약되는 곳도 Standard입니다. 이미 Claude Code나 Codex를 쓰는 팀이라면 락인 문제는 반대 방향으로 작용합니다. 이 도구들은 한 벤더의 모델에 묶여 있고, Fusion은 GitHub가 통제하며 언제든 재편할 수 있는 라우터입니다. 어느 쪽도 종속성에서 자유롭지 않습니다.
기존 비교 글은 도구 자체를 다룹니다. 터미널 코딩 에이전트, Cursor와 Copilot, Windsurf 비교, 작업에 맞는 모델 등급 고르기, 더 넓은 코딩 도구 목록이 있습니다. Fusion은 그 글들의 비용 항목을 바꿀 뿐, 어떤 도구를 고를지는 바꾸지 않습니다. Cursor 사용자에 대해서는 아직 이에 해당하는 평가가 없으며, 현재 판도가 어떻게 정렬되는지는 ToolRank 코딩 어시스턴트 보드에서 확인하실 수 있습니다.
결판을 내는 테스트는 비용이 적게 듭니다. 실제 티켓 열 개를 Fusion Standard와 현재 설정에서 각각 돌려, 채택된 변경 수와 소비한 크레딧을 세어 보십시오. GitHub의 할인은 올해 후반에 끝나므로 그 전에 측정하십시오. 그런 다음 Artificial Analysis의 Router models 보기를 다시 확인하십시오. 변동이 생길 가능성이 큰 것은 그곳의 라우터 항목이기 때문입니다.