

2026년 대부분의 개발자에게 실질적인 선택지는 Claude Code와 Codex 둘 중 하나이며, 터미널 작업용 공개 벤치마크 중 가장 어려운 것에서 두 도구는 오차 범위 안에서 동점입니다. 작년 비교에서 빠짐없이 세 번째로 등장하던 Gemini CLI는 무료 및 개인 사용자에게는 더 이상 쓸 수 없습니다. Google이 올해 초 이를 Antigravity CLI라는 비공개 소스 도구로 대체했기 때문입니다.
이 때문에 판단 기준이 달라졌습니다. 상위 두 도구는 릴리스마다 선두를 주고받으므로 모델 품질은 약한 결정 요인입니다. 이제 도구를 가르는 것은 에이전트가 내 컴퓨터에서 묻지 않고 무엇을 할 수 있는지, 비용을 어떻게 내는지, 팀 리더가 이 둘을 통제할 수 있는지입니다. Codex는 가장 안전한 기본값과 오픈 소스 클라이언트를 제공합니다. Claude Code는 스크립트로 다루고 확장하려는 팀에게 가장 깊은 도구 세트를 갖추고 있습니다. GitHub Copilot의 CLI는 이미 GitHub 중심으로 일하면서 여러 연구소의 모델을 한 청구서로 쓰고 싶은 조직에 맞고, 오픈 소스에 원하는 모델을 자유롭게 쓰고 싶다면 OpenCode가 답입니다.
아래 가격과 기능은 각 벤더의 문서와 요금 페이지를 기준으로 하며, 모든 벤치마크 수치에는 출처를 밝혔습니다.
올해 터미널 에이전트에서 달라진 점
1년 전에 이 카테고리를 마지막으로 살펴보셨다면 네 가지 변화를 알아두셔야 합니다.
Google이 대부분의 사용자에게 Gemini CLI를 종료했습니다. Google I/O에서 Gemini CLI가 무료 사용자와 Google AI Pro 및 Ultra 구독자의 요청 처리를 중단하고, IDE 확장도 같은 날 꺼진다고 발표했습니다(Google Developers Blog). 후속 도구인 Antigravity CLI는 Go로 작성되었고, Google의 새 데스크톱 앱 Antigravity 2.0과 같은 에이전트 백본 위에서 동작합니다. Gemini Code Assist Standard 또는 Enterprise를 쓰는 조직과 Gemini API 키로 결제하는 개발자는 계속 Gemini CLI를 사용할 수 있습니다.
GitHub는 Copilot CLI를 정식 출시한 뒤 모든 Copilot 요금제를 사용량 기반 AI 크레딧으로 전환했습니다. 이제 터미널 세션은 크레딧당 $0.01 가치의 종량 허용량에서 차감됩니다(GitHub Docs).
Anthropic은 세션을 열 때의 동작을 바꿨습니다. Claude Code v2.1.283부터 대화형 터미널 세션은 auto 모드로 시작합니다. 이 모드에서는 Anthropic이 classifier라고 부르는 두 번째 모델이 매번 사용자에게 묻는 대신 동작을 검토합니다(Claude Code docs).
OpenAI는 이번 주 Codex CLI를 업데이트하며 음성 제어, 병렬 작업을 추적하는 /agents 뷰, 승인된 설정과 권한으로 팀이 공유할 수 있는 재사용 가능한 클라우드 환경을 추가했습니다(TechCrunch). 한편 오픈 소스의 베테랑 Aider는 올해 초 마이너 패치 이후 새 릴리스가 없고, 마지막 기능 릴리스는 작년입니다(PyPI).
모든 터미널 에이전트가 도는 루프
브랜드를 걷어내면 이 도구들은 모두 같은 일을 합니다. 사용자가 작업을 평이한 말로 설명하면, 에이전트가 관련 파일을 읽고 계획 초안을 세우고, 필요한 만큼 여러 파일을 수정하고, 빌드와 테스트를 실행하며, 실패하면 diff를 보여줄 수 있을 때까지 반복합니다.
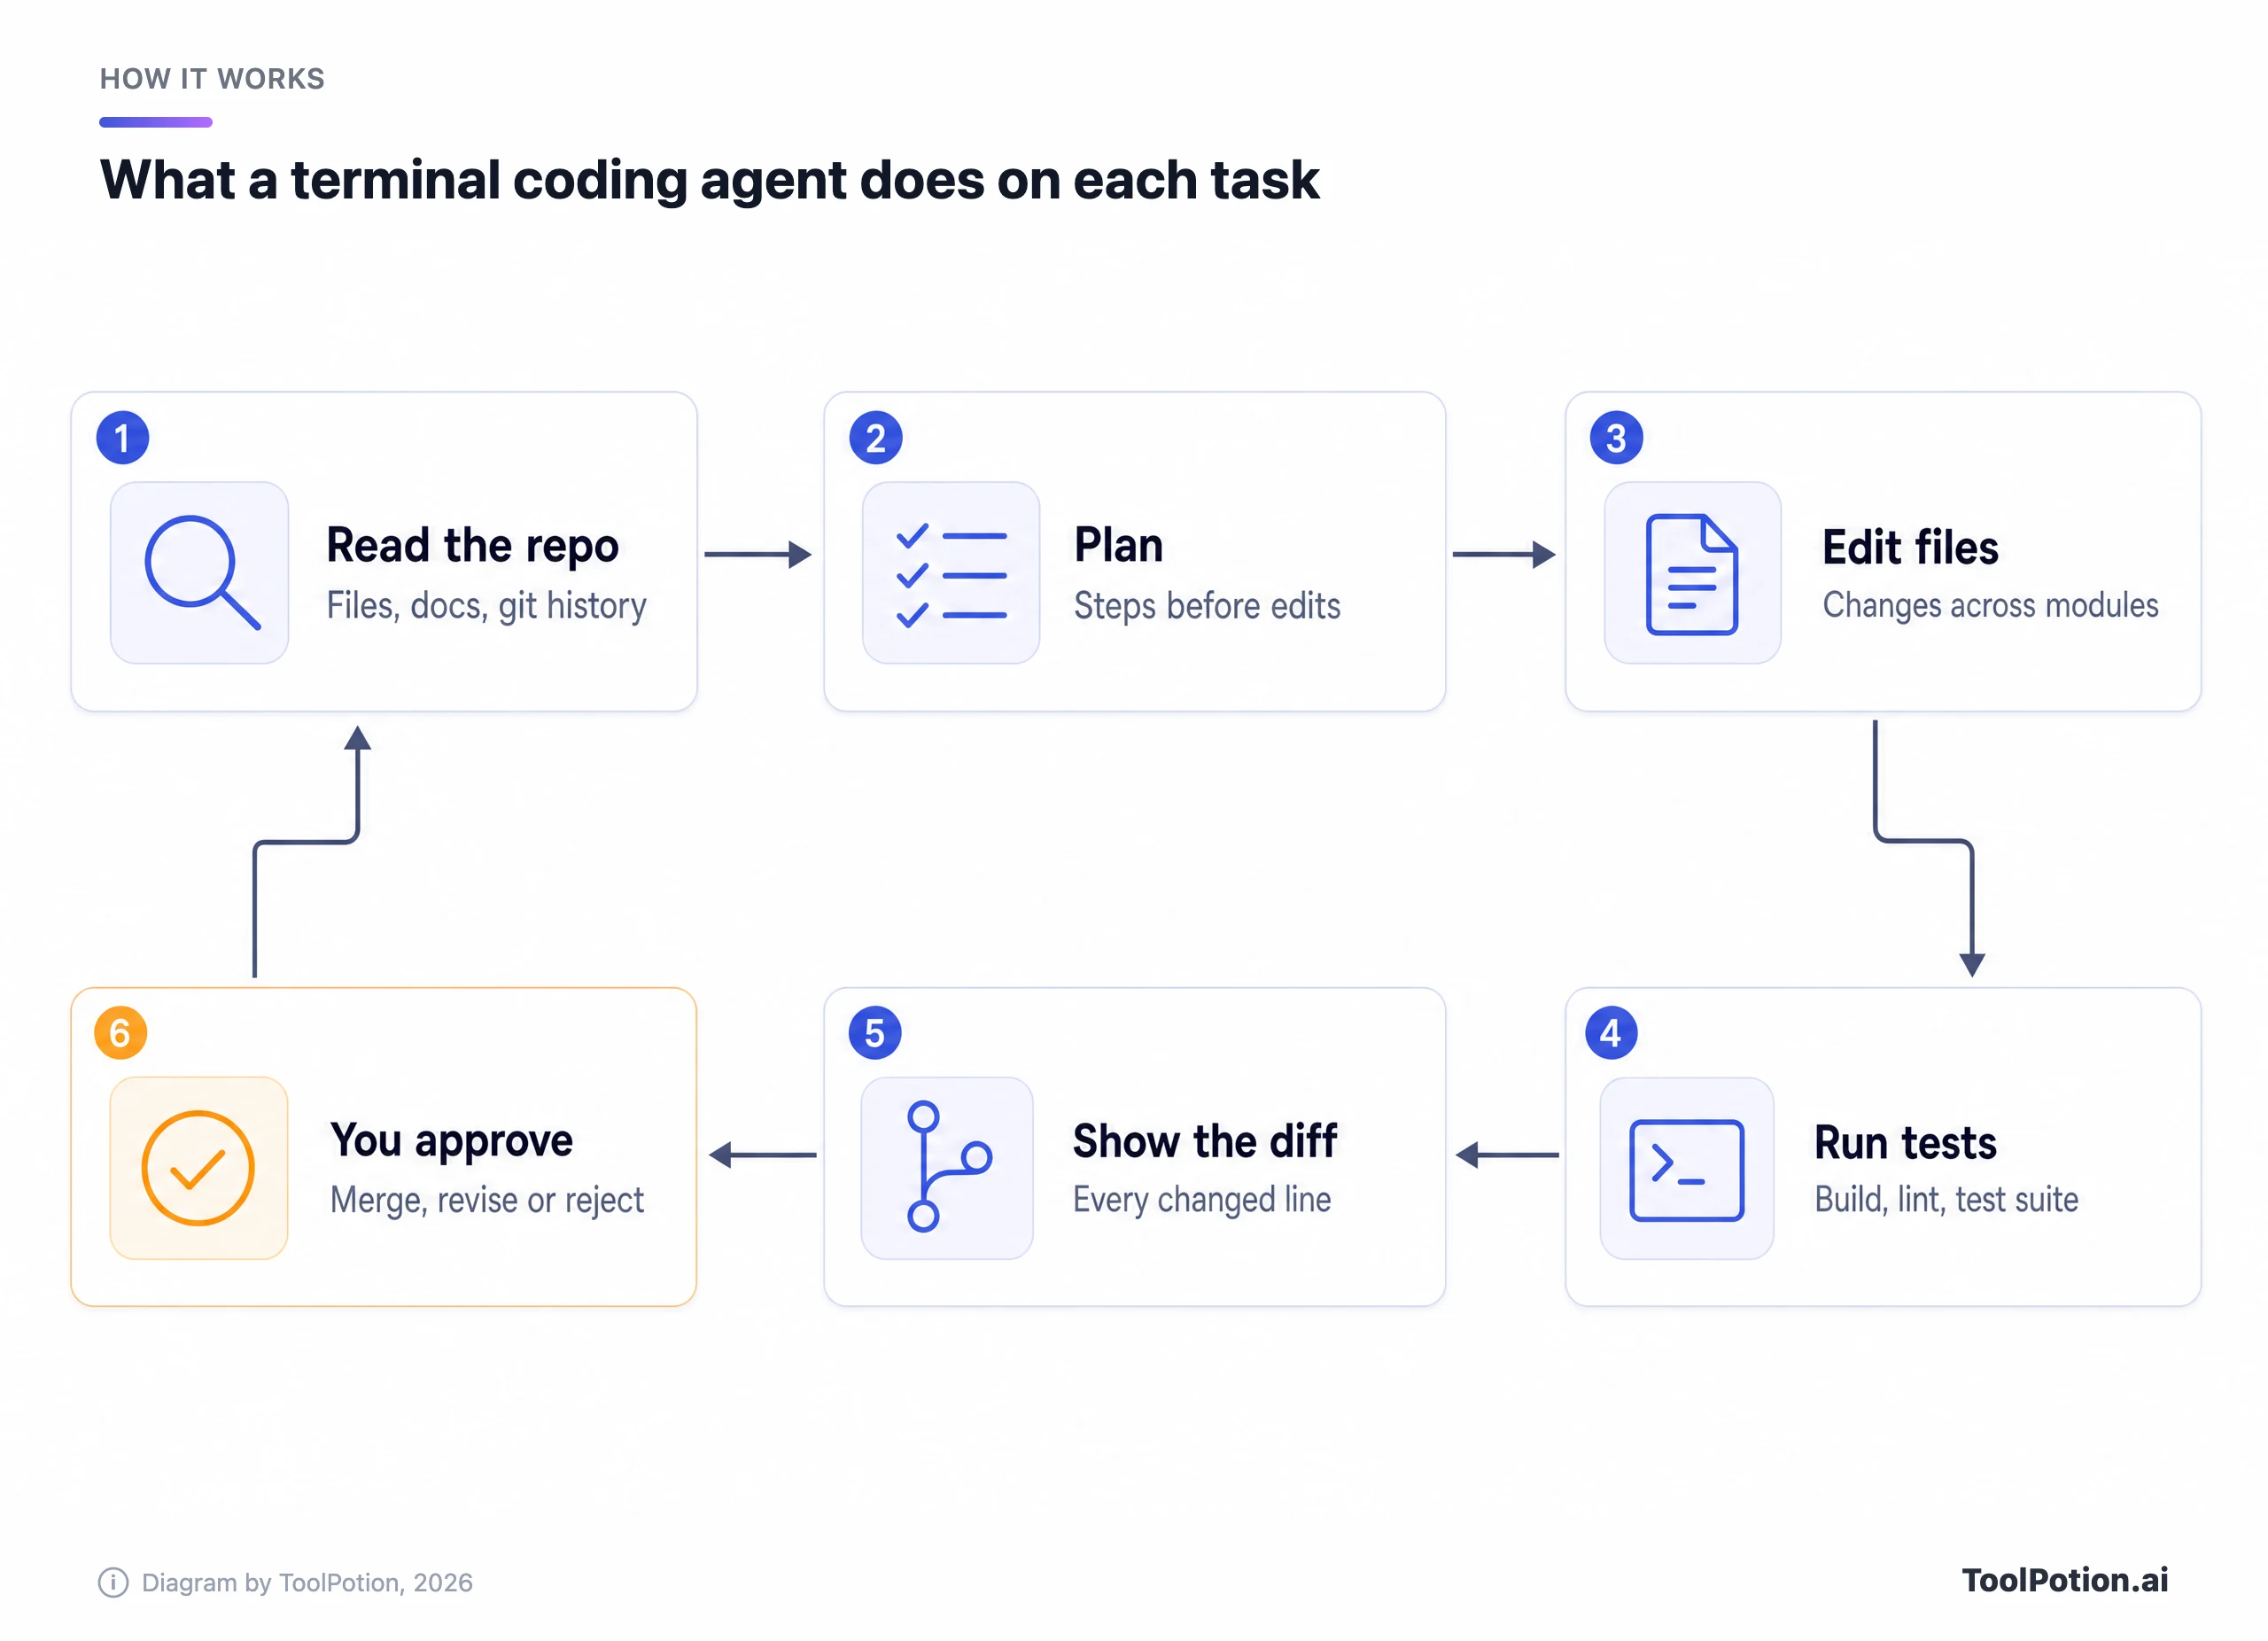
강조된 단계가 설계의 중심이 되어야 합니다. 승인 단계에 여러분의 판단과 보안 정책이 담기기 때문입니다. 도구마다 이 루프 주변의 세 가지가 다릅니다. 어떤 모델이 구동하는지, 승인 전에 에이전트가 무엇을 할 수 있는지, 어디서 실행되는지(내 노트북, OS 샌드박스, 벤더의 클라우드)입니다. 모델이 주목받지만, 팀 전체가 쓸 수 있는지는 나머지 둘이 좌우합니다.
Claude Code vs Codex 정면 비교
이 둘이 기본 선택지가 된 데는 이유가 있습니다. 둘 다 macOS, Linux, Windows에서 실행되고, AGENTS.md 파일을 읽고, MCP 서버·skills·hooks·plugins·subagents를 지원하며, 작업을 클라우드로 넘길 수 있고, 월 $20 요금제가 있습니다. 차이는 세부 사항에 있습니다.
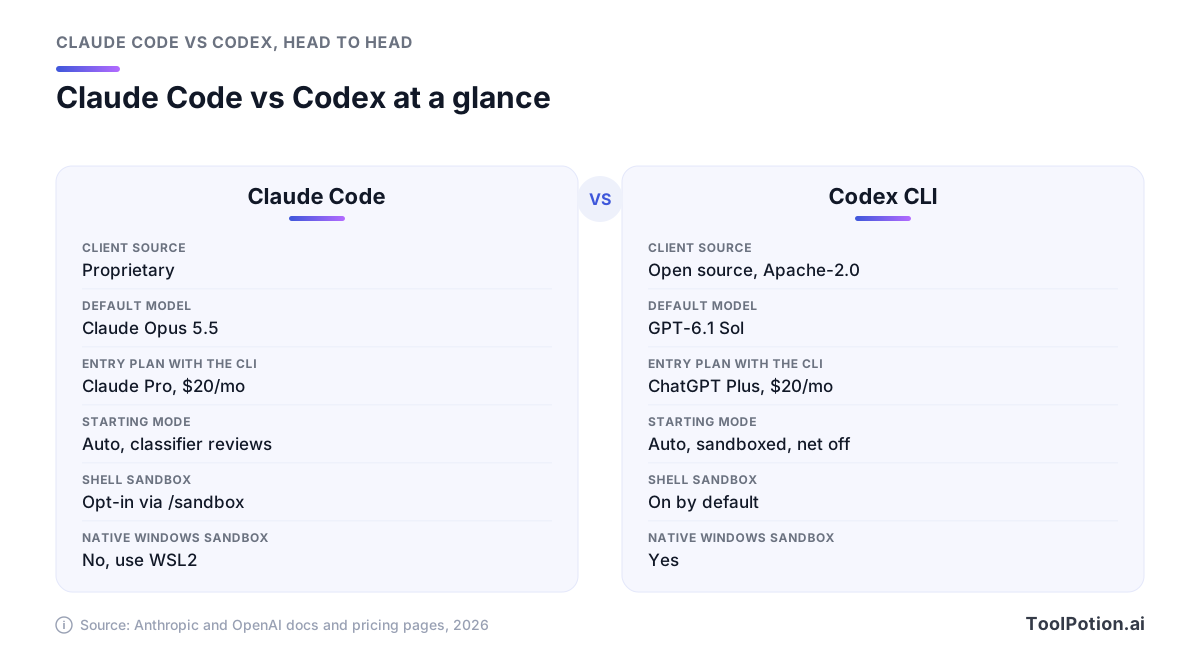
모델부터 보겠습니다. Claude Code는 Anthropic 모델만 쓰며 모든 요금제에서 기본값이 Claude Opus 5.5이고, 더 저렴한 선택지로 Sonnet 5.5와 Haiku가 있습니다. Claude Code에서 가장 강력한 모델인 Fable 5.1은 명시적으로 선택해야 하며, 일부 요금제에서는 추가 사용 크레딧으로 청구됩니다. Codex의 기본값은 GPT-6.1 Sol로, OpenAI는 에이전트 코딩에서 플래그십 GPT-6 Astra에 거의 필적하면서 API 가격은 5분의 1이라고 밝힙니다. Codex 클라이언트는 Apache-2.0 라이선스의 오픈 소스인 반면(openai/codex 저장소는 Rust로 작성되었습니다), Claude Code의 라이선스는 모든 권리 보유(all rights reserved)로 되어 있습니다.
안전 기본값에서 차이가 더 뚜렷합니다. git 저장소 안에서 Codex는 Auto라는 프리셋으로 시작합니다. 작업 공간에서 읽고, 수정하고, 명령을 실행할 수 있지만, OS 샌드박스(macOS는 Seatbelt, Linux는 bubblewrap과 seccomp, Windows는 네이티브 샌드박스)가 승인하기 전까지 네트워크 접근과 프로젝트 밖의 모든 접근을 막습니다(OpenAI docs). git 저장소 밖에서는 읽기 전용으로 돌아갑니다.
Claude Code는 반대 방향을 택했습니다. 셸 샌드박스는 기본적으로 꺼져 있고, 1차 방어선은 auto 모드 classifier와 모든 모드에서 차단되는 deny 규칙입니다. 샌드박스를 켜더라도 셸 명령만 감싸며, 샌드박스 안의 명령도 deny 규칙을 추가하기 전에는 ~/.ssh와 ~/.aws/credentials를 포함해 컴퓨터 대부분을 읽을 수 있습니다(Claude Code docs). 네이티브 Windows에서는 샌드박스가 아예 없으며, Anthropic은 WSL2를 쓰라고 안내합니다.
깊이에서는 Claude Code가 앞섭니다. Plugins는 skills, subagents, hooks, MCP 서버를 묶어 제공하고, 관리자가 허용 목록에 넣거나 차단할 수 있는 마켓플레이스에서 설치합니다. Routines는 Anthropic 클라우드에서 예약 작업을 실행하고, GitHub Actions와 GitLab CI/CD 연동으로 리뷰와 이슈 분류를 처리하며, Agent SDK로 같은 도구 위에 에이전트를 직접 만들 수 있습니다. Codex도 훨씬 간결하게 비슷한 영역을 대부분 다룹니다(hooks, skills, plugins, 스크립트용 codex exec, GitHub Action). 자동 코드 리뷰는 GitHub pull request와 GitLab merge request를 지원합니다.
그렇다면 각각의 약점은 어디일까요? Claude Code는 한 연구소에 묶이고, 설정을 바꾸기 전까지는 OS 경계가 아닌 모델의 판단에 의존하는데, 일부 보안팀은 이를 받아들이지 않을 것입니다. Codex도 한 연구소에 묶여 있고, $20 요금제에서는 플래그십 사용량이 크게 제한됩니다. OpenAI는 Plus에서 5시간당 로컬 메시지를 GPT-6 Astra로는 5~45건, GPT-6.1 Sol로는 15~160건으로 추정합니다(OpenAI pricing).
Antigravity CLI가 대부분의 사용자에게서 Gemini CLI를 대체했습니다
지금 Gemini CLI를 검색하면 Apache-2.0 저장소가 여전히 나오고, 릴리스도 계속 이어지고 있습니다(v0.62.0이 이번 주에 나왔습니다). 다만 문서에는 무료 사용자와 Google One 사용자에게 Gemini CLI가 대체되었음을 알리는 배너가 붙어 있습니다. 계속 쓸 수 있는 쪽은 Gemini Code Assist Standard 또는 Enterprise 라이선스를 쓰는 조직, 그리고 유료 Gemini 또는 Gemini Enterprise Agent Platform API 키를 가진 개발자입니다.
Google Antigravity 안에서 이를 대체한 CLI는 성격이 다른 제품입니다. 비공개 소스이며, Tech Times에 따르면 공개 저장소에는 소스 코드가 전혀 없습니다. Google 스스로 집계한 pull request가 6,000건 병합된 프로젝트로서는 뼈아픈 대목입니다. Google은 아직 기능이 1:1로 대응되지는 않는다고 인정하지만, skills, hooks, subagents, extensions(현재 이름은 plugins)는 이전되었습니다.
실질적인 장점도 있습니다. Antigravity의 모델 목록에는 Gemini 3.8 Flash와 Gemini 3.1 Pro가 Claude Sonnet 5.5, Claude Opus 5.5, 오픈 웨이트 GPT-OSS-120b와 함께 올라 있어, Google 구독 하나로 두 연구소의 모델에 접근할 수 있습니다(제공 여부는 요금제에 따라 다릅니다). macOS와 Linux의 기본 프리셋은 문서상 Codex만큼 엄격하기도 합니다. 터미널 명령은 네트워크가 없는 샌드박스에서 실행되고, 파일 접근은 작업 공간과 임시 폴더까지만 허용되며, ~/.ssh와 .env 파일은 차단되고, MCP와 웹 동작은 먼저 물어봅니다(Antigravity docs). Windows에서는 이 샌드박스가 기본적으로 꺼져 있습니다.
문제는 사용량 한도입니다. 무료 Individual 티어는 기본적인 주간 사용 한도만 제공하며, Gemini CLI가 개인 계정에 하루 1,000건씩 무료로 주던 것과는 큰 차이가 있습니다. 유료 사용량은 Google AI Pro와 Ultra 요금제에 달려 있고, Google이 Antigravity 출시와 함께 티어를 개편했으므로, 결정하기 전에 Google의 요금제 페이지에서 최신 한도를 확인하세요. Google Cloud를 주로 쓰거나, Anthropic과 별도 계약 없이 Claude 모델을 쓰고 싶거나, 엄격한 샌드박스 기본값을 바로 쓰고 싶다면 Antigravity CLI를 고르세요. 오픈 소스 클라이언트가 중요하다면 건너뛰세요.
Copilot CLI, Cursor, OpenCode 등
Copilot CLI는 기업에게 가장 저평가된 선택지입니다. Anthropic, OpenAI, Google의 모델을 하나의 청구서로 쓸 수 있고, 현대적인 기능도 갖췄습니다. plan 모드, autopilot 모드, 코드 탐색과 리뷰용 내장 에이전트, MCP, plugins, skills, hooks, 그리고 작업을 GitHub 클라우드 코딩 에이전트에 넘기는 & 접두사가 있습니다(GitHub Changelog). 모든 요금제에 포함됩니다. Free, 월 $10의 Pro, $39의 Pro+, $100의 Max가 있고, 좌석당 Business $19, Enterprise $39가 있습니다(GitHub Docs).
약점은 권한입니다. Copilot은 먼저 폴더를 신뢰하도록 요구한 뒤 도구를 하나씩, 또는 세션 전체에 대해 승인하게 하는데, GitHub 자체 문서가 세션 동안 rm을 승인하면 해당 디렉터리 트리의 모든 파일을 묻지 않고 삭제할 수 있다고 경고합니다. 로컬 샌드박스는 /sandbox enable로 직접 켜야 하고, --yolo 플래그는 모든 검사를 꺼버립니다.
마케팅 문구가 아니라 문서와 라이선스에서 확인할 수 있는 항목으로 주요 네 가지 도구를 비교하면 다음과 같습니다.
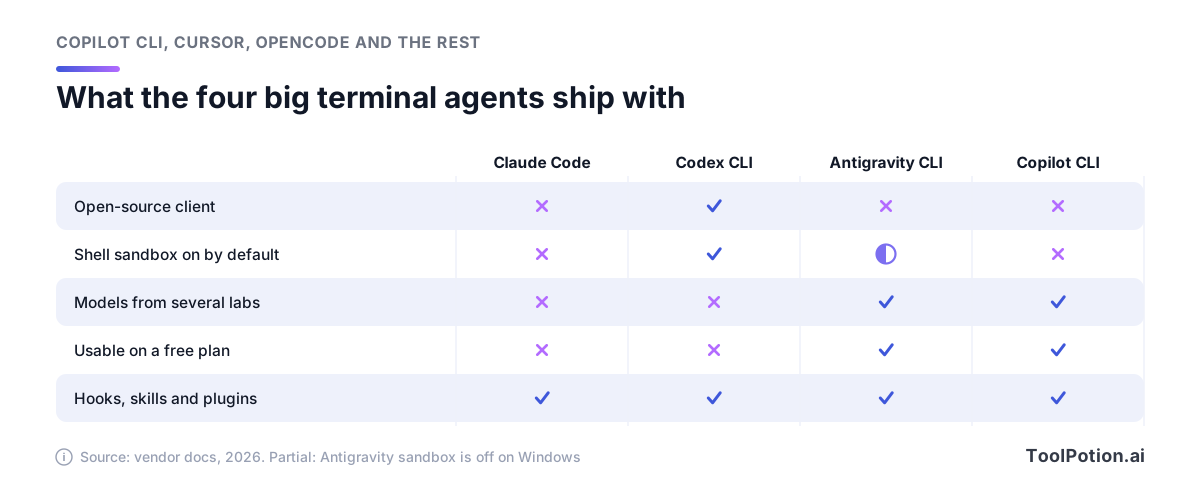
오픈 소스 클라이언트와 모든 환경에서 기본으로 켜진 샌드박스를 함께 갖춘 것은 Codex뿐입니다. 별도 작업 없이 여러 연구소의 모델을 섞어 쓸 수 있는 것은 Antigravity와 Copilot입니다. 확장성은 수렴해서, 네 도구 모두 hooks, skills, plugins를 지원합니다.
Cursor는 에디터 에이전트를 터미널로 가져와 agent, plan, ask 모드와 스크립트·CI용 print 모드, 클라우드 에이전트로 넘기는 같은 & 핸드오프를 제공합니다. 이미 팀이 Cursor 비용을 내고 있다면(Individual은 월 $20부터, Teams는 사용자당 $40) 당연한 추가 옵션이지만, 그렇지 않다면 설득하기 어렵습니다.
OpenCode는 오픈 소스의 눈에 띄는 주자입니다. MIT 라이선스이고, GitHub 스타가 211,000개를 넘었으며, 로컬 모델을 포함해 75개 이상의 모델 제공자와 연결됩니다. GitHub Copilot이나 ChatGPT Plus·Pro 계정으로 로그인할 수 있어 이중으로 결제할 필요가 없습니다. 다만 기본값은 주의하세요. OpenCode는 규칙을 직접 작성하지 않으면 에이전트가 묻지 않고 파일을 수정하고 셸 명령을 실행하게 두며, OS 샌드박스가 없고, 내장 보호 장치는 .env 파일, 프로젝트 밖 경로, 같은 동작을 반복하는 에이전트만 다룹니다(OpenCode docs).
세 가지를 더 짧게 짚겠습니다. Amp는 개인에게 모델 비용을 마크업 없이 제공자 가격 그대로 전달하고, 내부적으로 GPT-5.6과 Claude Fable 5.1을 섞어 쓰며, 무료 티어와 $20 요금제가 있습니다. Warp는 이제 자체 에이전트를 갖춘 AGPL 라이선스의 에이전트형 터미널이며, 가격은 무료부터 $20 Build, $200 Max까지이고 MCP를 지원하는 어떤 코딩 에이전트와도 작동한다고 밝힙니다. Aider는 모든 변경을 diff로 확인하고 되돌릴 수 있는 메시지와 함께 커밋해 git 연동이 여전히 가장 깔끔하지만, 릴리스 속도가 멈췄으므로 쓰려는 모델을 지원하는지 먼저 확인하세요. 더 넓은 범위는 AI 코딩 어시스턴트 보드와 AI 에이전트 보드에서 순위 변화를 추적하고 있습니다.
벤치마크에서 Claude Code와 Codex는 막상막하입니다
이 카테고리에서 가장 유용한 공개 척도는 Stanford, Harbor, Laude Institute가 운영하는 Terminal-Bench로, 실제 터미널 안의 어려운 과제로 에이전트와 모델 조합을 평가합니다. 현재 4.0 리더보드에서는 최대 추론 강도의 Codex와 GPT-6 Astra가 58.2%로 선두이고, 최대 강도의 Claude Code와 Fable 5.1이 57.9%입니다(Terminal-Bench). 각 항목은 330회 시도를 거치며 신뢰구간이 위아래로 약 3포인트이므로, 동점으로 보면 됩니다.
더 큰 이야기는 추론 강도 설정입니다. 각 조합을 가장 낮은 설정과 가장 높은 설정에서 비교해 보겠습니다.
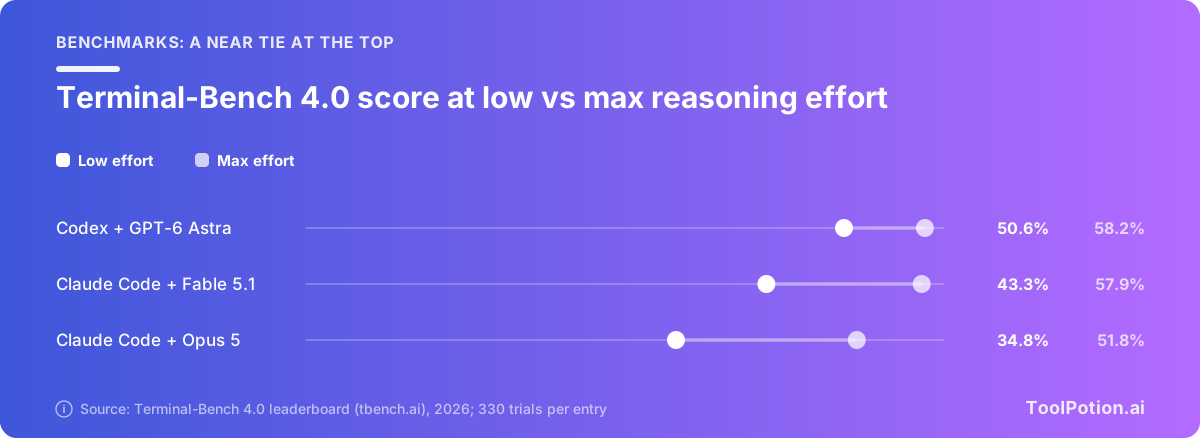
최대에서 낮은 강도로 내리면 Astra를 쓴 Codex는 8포인트 미만, Fable 5.1을 쓴 Claude Code는 15포인트 가까이 떨어집니다. 이전 모델인 Opus 5를 쓴 Claude Code는 17포인트 하락합니다. 기본값으로 둔 설정이 상자에 붙은 브랜드만큼 중요할 수 있습니다.
비용은 또 다른 이야기를 합니다. 리더보드는 각 실행의 지출을 기록하는데, 최대 강도에서 Astra를 쓴 Codex는 $3,267, Fable 5.1을 쓴 Claude Code는 $6,244로, 같은 점수에 작업당 약 $9.90 대 $18.90입니다. 이는 길고 어려운 작업에 대한 API 요금 기준 비용이며, 구독자가 내는 금액이 아닙니다. 보드에는 Google 에이전트가 아예 없어서, Gemini 모델을 쓰는 최고 항목은 Gemini 3.8 Flash를 쓴 서드파티 에이전트의 19.1%입니다. Sonnet 5.5가 에이전트 코딩에서 Opus 5.5를 앞선다는 Anthropic의 주장 같은 벤더 발표는 벤더 자체 테스트에서 나온 것입니다.
권한 모드: 읽기 전용부터 완전 자동까지
이제 모든 도구가 이름만 다른 같은 자율성 단계를 제공합니다. 어느 단계를 고르느냐에 따라 얼마나 자주 중단되는지, 잘못된 지시(또는 README에 숨겨진 prompt injection)가 얼마나 큰 피해를 줄 수 있는지가 정해집니다.
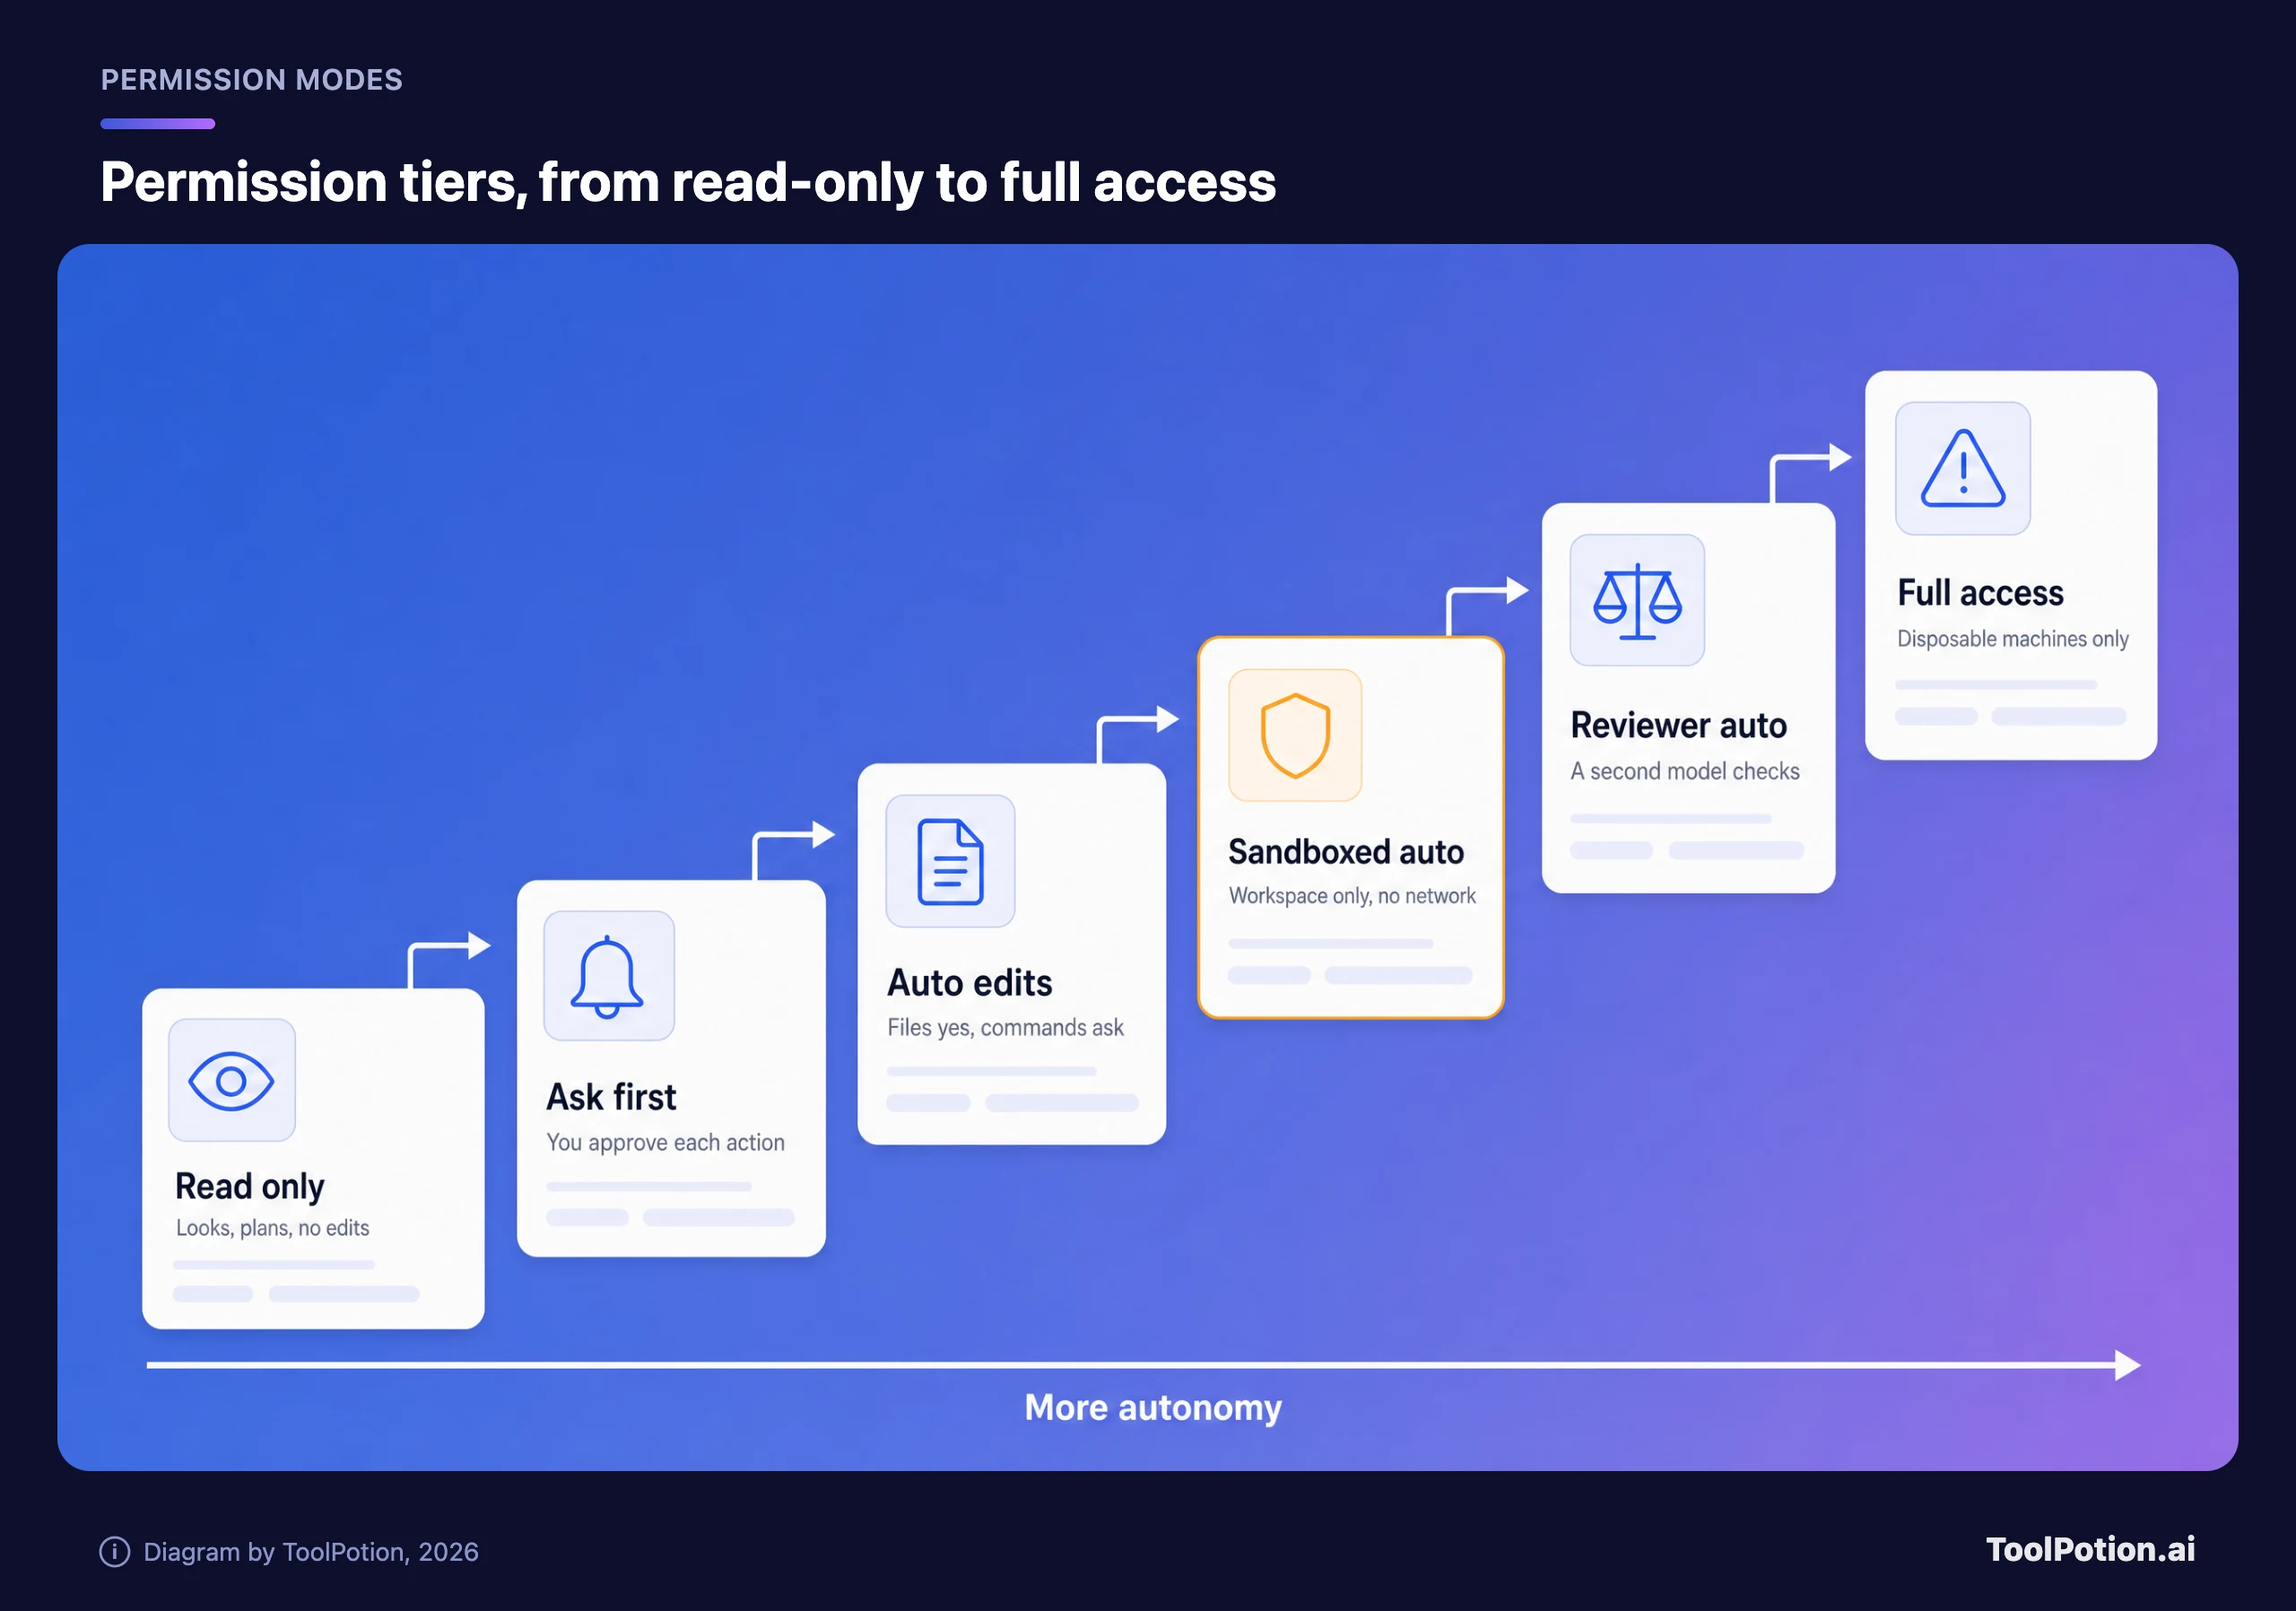
일상용 기본값으로는 샌드박스 자동이 맞습니다. 에이전트가 프로젝트 안에서는 자유롭게 수정하고 명령을 실행하되, 네트워크가 없고 홈 디렉터리에는 닿지 못합니다. 리뷰어 자동은 확인 요청을 더 줄이지만 모델의 판단을 신뢰합니다. 전체 접근은 일회용 컨테이너와 VM에서만 써야 하며, bypassPermissions에 대한 Anthropic 문서의 설명도 같습니다. 주요 네 도구에서 각 단계를 부르는 이름은 다음과 같습니다.
| 단계 | Claude Code | Codex CLI | Antigravity CLI | Copilot CLI |
|---|---|---|---|---|
| 읽기 전용 | plan | read-only | Plan 모드 | Plan 모드 |
| 먼저 묻기 | default (Manual) | 세분화된 승인 | Request Review | 도구별 확인 |
| 자동 수정 | acceptEdits | 없음 | Accept-Edits | 세션 동안 도구 승인 |
| 샌드박스 자동 | /sandbox auto-allow | Auto (git 저장소에서 기본값) | 기본 프리셋 | /sandbox enable |
| 리뷰어 자동 | auto (기본값) | Auto-review (옵트인) | 없음 | 없음 |
| 전체 접근 | bypassPermissions | danger-full-access | Turbo | --yolo |
눈에 띄는 기본값 두 가지가 있습니다. Codex와 Antigravity는 샌드박스 안에서 시작하는 반면, Claude Code와 Copilot은 확인 요청이나 모델의 검토에 의존하는 모드로 시작합니다. Claude Code를 쓴다면 샌드박스를 켜는 것이 할 수 있는 가장 유용한 설정 변경입니다.
요금제 vs API 키: 얼마나 낼까요
벤더마다 두 가지 진입 방법을 팝니다. 월 정액 요금제는 청구액에 상한을 두는 대신 5시간 단위와 주간 한도로 사용량을 제한하며, 벤더는 이를 토큰 수가 아닌 배수로 설명합니다. API 키는 모든 토큰을 정가로 청구하며 상한이 없습니다.
| 에이전트 | 입문 요금제 | 상위 티어 | 팀 |
|---|---|---|---|
| Claude Code | Claude Pro, 월 $20 (연간 결제 시 $17) | Max 5x $100, Max 20x $200 | Team 좌석 월 $25 또는 $125, Enterprise는 좌석 $20 + API 요금 기준 사용량 |
| Codex | ChatGPT Plus, 월 $20 (Free와 Go에서는 CLI 사용 불가) | Pro $100, $200, $500 | Business 사용자당 $20 (연간) |
| Copilot CLI | Pro 월 $10 (Free는 소량 제공) | Pro+ $39, Max $100 | Business $19, Enterprise 좌석당 $39 |
| Antigravity CLI | 무료 Individual 티어 | Google AI Pro 및 Ultra | Google Cloud를 통한 Business 좌석당 $30부터 |
| Cursor CLI | Individual 월 $20 | 상위 개인 티어 | Teams 사용자당 $40 |
가격은 Anthropic을 포함한 각 벤더의 요금 페이지를 기준으로 했습니다. 요금 계산이 헷갈린다면 크레딧, 좌석, 토큰을 설명한 AI 도구 요금 모델 가이드를 참고하세요.
API 방식은 헤비 유저와 CI에서 가장 중요합니다. Anthropic은 Opus 5.5에 입력 100만 토큰당 $4, 출력 $20를, Sonnet 5.5에 $2와 $10를 청구합니다. OpenAI는 GPT-6.1 Sol에 $2와 $10, GPT-6 Astra에 $10와 $50를 청구합니다(OpenAI pricing). 에이전트 루프는 같은 컨텍스트를 계속 다시 보내기 때문에, 표면적인 단가보다 캐싱이 청구액을 더 크게 좌우합니다. 위 Terminal-Bench 실행에서 Codex 입력 토큰의 약 96%가 캐시 읽기였으며, OpenAI는 이를 Astra 입력 단가의 10분의 1로 청구합니다.
아래에 직접 숫자를 넣어 보세요. 기본값은 해당 벤치마크 작업 하나의 토큰 구성(Astra 기준 작업당 약 $10)을 그대로 따랐으며, 벤치마크 실행은 길고 어려우므로 예산을 잡기 전에 직접 쓰는 사용량 대시보드의 수치로 바꿔 넣으세요.
기본값 기준으로, 이런 작업을 한 달에 40건 Opus 5.5로 돌리는 개발자는 API 키로 약 $126를 쓰게 되므로, 한도가 유지된다면 Claude Pro와 Max 5x 모두 더 저렴합니다. 모델을 GPT-6 Astra로 바꾸면 같은 작업량에 약 $401가 듭니다. 이 격차 때문에 Codex 사용자는 플래그십을 꼭 필요한 문제에만 쓰고 나머지는 GPT-6.1 Sol에 맡겨야 합니다.
하나를 고르고 안전하게 도입하는 방법
이미 코드와 계약이 있는 곳에서 출발하고, 동률일 때는 안전 기본값으로 가르세요.
- 팀이 이미 ChatGPT 비용을 내고 있거나, 기본으로 샌드박스가 켜진 오픈 소스 클라이언트를 원한다면 Codex로 시작하세요.
- 가장 깊은 커스터마이징을 원하고 Claude 모델이 만족스럽다면 Claude Code를 고르고, 무엇보다 먼저 샌드박스를 켜세요.
- 조직이 GitHub 기반이고 Claude, GPT, Gemini 모델을 사용자별 한도와 함께 하나의 예산으로 쓰고 싶다면 Copilot CLI가 마찰이 가장 적습니다.
- Google Cloud 중심 조직이라면 Antigravity CLI를 써 보세요.
- 처음부터 끝까지 오픈 소스이거나 로컬 모델이 필요하다면 OpenCode를 고르되, 보호 장치는 직접 작성해야 한다는 점을 감수하세요.
아직 고민 중이신가요? 아래에서 중요하게 생각하는 항목에 가중치를 주세요. 점수는 각 벤더의 문서와 요금제를 바탕으로 한 저희 편집팀의 평가이며, 테스트 결과가 아닙니다.
안전성에 가장 높은 가중치를 주면 Codex가 앞서고 Copilot CLI가 2위입니다. 팀 관리와 지출 한도를 맨 위로 올리면 Copilot이 근소하게 앞서고, 모델 선택과 오픈 소스를 최대로 올리면 OpenCode가 1위가 됩니다. 안전한 기본값보다 확장성이 중요해지면 Claude Code가 올라갑니다.
안전한 팀 도입 방법
- 소수의 개발자가 한 저장소에서 에이전트 하나만 시범 운영해, 도구 자체가 아니라 결과를 비교하세요.
- 권한 기본값은 중앙에서 설정하세요. Claude Code에서는 샌드박스를 켜고 push와 배포를 막는 deny 규칙을 넣은 managed settings를 쓰며, 관리자는 조직 전체에서 auto 모드를 끌 수 있습니다. Codex에서는 네트워크를 끈 workspace-write를 유지하고, danger-full-access는 일회용 CI 러너에만 허용하세요.
- 비밀 정보는 손이 닿지 않게 하세요. 운영 환경 자격 증명이 있는 셸에서는 에이전트를 실행하지 말고, ~/.ssh, 클라우드 자격 증명 파일, .env 읽기를 거부하며, Claude Code의 hooks와 로컬 MCP 서버는 샌드박스 밖에서 사용자의 전체 권한으로 실행된다는 점을 기억하세요.
- 에이전트가 만든 diff는 신입 사원의 pull request처럼 리뷰하세요. 에이전트가 브랜치와 PR을 열 수는 있지만 병합은 사람이 합니다. Claude Code Security Review나 Codex의 코드 리뷰 같은 자동 리뷰어는 두 번째 점검일 뿐 대체재가 아닙니다.
- 확장하기 전에 지출 상한부터 정하세요. Copilot은 사용자 및 코스트 센터 단위 예산을 지원하고 추가 사용이 기본으로 켜져 있으니, 한도를 두거나 끄세요. Anthropic의 Enterprise 요금제는 좌석 비용에 더해 사용량을 API 요금으로 청구하며, Antigravity의 비즈니스 요금제는 API와 구독 사용 전체에 대한 지출 상한을 제공합니다.
- plugins와 MCP 서버는 의존성처럼 검증하세요. Anthropic 문서에 따르면 설치한 plugin은 사용자 권한으로 코드를 실행하므로, 각자 추가하게 두지 말고 마켓플레이스를 허용 목록으로 관리하세요.
- CI에는 정확한 허용 목록을 주세요. 이름을 지정한 도구와 함께 쓰는 Claude Code의 dontAsk 모드, 또는 읽기 전용이나 workspace-write 샌드박스의 Codex를 쓰면 무인 실행을 예측 가능하게 유지할 수 있습니다.
이미 사업의 다른 부분에서 에이전트를 운영하는 팀이라면 프로덕션 환경의 AI 에이전트에서 이 내용 대부분이 익숙할 것입니다. 에디터 중심 도구를 더 폭넓게 보고 싶다면 AI 코딩 어시스턴트 총정리를 참고하세요.
자주 묻는 질문
Gemini CLI는 아직 쓸 수 있나요?
네, Gemini Code Assist Standard 또는 Enterprise를 쓰는 조직과 유료 Gemini API 키를 쓰는 개발자는 가능합니다. 무료, Google AI Pro, Ultra 사용자는 Antigravity CLI로 옮겨졌습니다. Apache-2.0 코드는 GitHub에 남아 있어 누구나 포크할 수 있습니다.
ChatGPT 구독으로 Claude Code를, Claude 요금제로 Codex를 쓸 수 있나요?
아니요. 각 요금제는 해당 벤더의 에이전트만 지원합니다. 벤더를 넘나드는 하나의 클라이언트를 원한다면 OpenCode가 ChatGPT Plus·Pro와 GitHub Copilot 계정으로 로그인을 지원하고, Copilot CLI와 Antigravity CLI는 여러 연구소의 모델을 하나의 구독에 묶어 제공합니다.
개인 개발자에게 가장 저렴한 터미널 에이전트는 무엇인가요?
유료로 가장 저렴하게 시작하는 방법은 월 $10의 Copilot Pro입니다. $8의 ChatGPT Go에는 Codex CLI가 포함되지 않으며, Plus부터 쓸 수 있습니다. Copilot Free와 Antigravity 무료 티어는 비용이 들지 않지만 제공량이 적습니다. 더 많이 쓴다면 $20의 Claude Pro 및 ChatGPT Plus를 예상 API 청구액과 비교해 보세요.
모든 diff를 리뷰한다면 샌드박스가 필요 없나요?
필요합니다. diff 리뷰는 나쁜 코드를 잡아내지만, 그것은 에이전트가 이미 명령을 실행한 뒤입니다. 샌드박스는 명령이 실행되는 동안 닿을 수 있는 범위를 제한하며, 비밀 정보를 엉뚱한 곳으로 보낼 수 있는 네트워크 호출도 여기에 포함됩니다.
Terminal-Bench는 선택 기준으로 믿을 만한가요?
터미널 작업에 대해서는 가장 좋은 공개 척도이지만, 어려운 과제에서 고정된 강도 설정으로 에이전트와 모델 조합을 측정한 결과입니다. 몇 포인트 차이는 신뢰구간 안에 있으므로 동점으로 보고, 직접 쓰는 저장소에서 짧은 시범 운영을 해 보세요.