

OpenAI는 한 번의 연구 캠페인에서 GPT-6 Cyber가 Linux 커널 취약점 948개에 대해 실제 작동하는 익스플로잇을 만들었다고 밝혔습니다. 같은 연구 하네스로 GPT-5.6 Sol이 익스플로잇한 166개의 5배가 넘는 수치입니다(OpenAI). 벤더의 연구실에서 나온 벤더의 숫자이니 그렇게 받아들여야 합니다. 다만 구체적인 수치이기도 하고, 치명적 발견 304건을 전달받은 커널 메인테이너들이 직접 검증할 수 있습니다.
며칠 사이에 OpenAI는 GPT-6 Cyber를 출시하고 Hacktron과 파트너십을 맺었습니다. Anthropic은 Claude Fable 5.2와 Mythos 5.2를 공개했고, Google DeepMind는 Signal의 기반 코드에 대한 기계 검증 증명을 발표했습니다. 보안 업체 두 곳은 공격자들이 실제 대상에 AI 에이전트를 투입한 사례를 공개했습니다. 저희는 각 회사의 발표문과 그 근거가 된 보고서를 읽어 보았습니다. 벤치마크 이야기는 The Hacker News가, Signal 이야기는 Wired가 다뤘습니다.
OpenAI가 말하는 GPT-6 Cyber의 능력
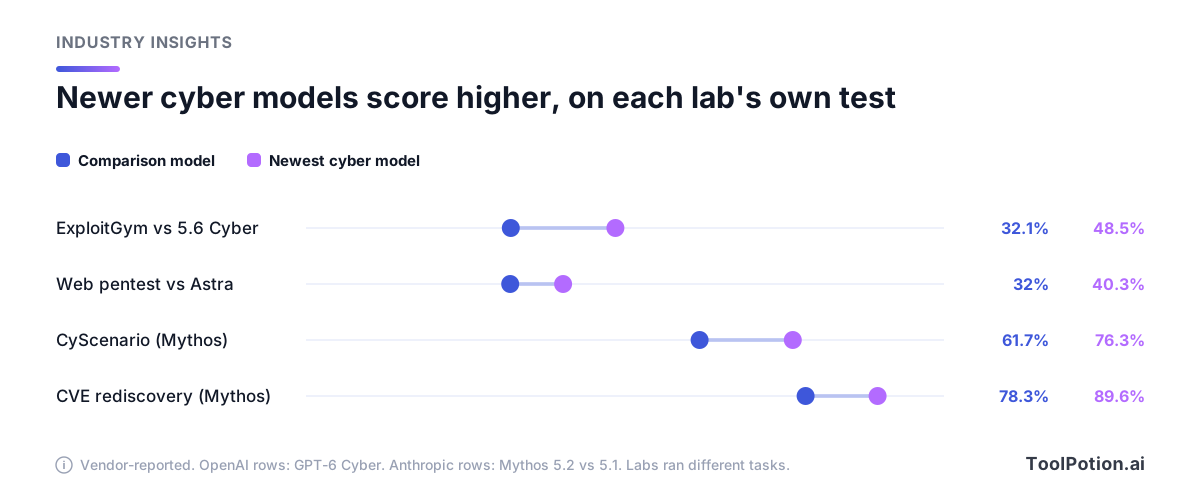
모델이 지정된 취약점을 익스플로잇할 수 있는지 보는 ExploitGym에서 OpenAI는 GPT-6 Cyber가 48.5%, GPT-5.6 Cyber가 32.1%라고 보고했습니다. 소스 코드를 보지 않고 애플리케이션을 탐색하는 새 웹 모의 침투 테스트에서는 취약점의 40.3%를 찾아냈고, GPT-6 Astra는 32.0%였습니다(OpenAI). 가장 날카로운 비교는 거부율입니다. 통제된 랩에서 GitLab, PostgreSQL, Jenkins의 알려진 결함을 쓰는 RemoteExploitBench에서, Daybreak Blue와 함께 돌린 GPT-6 Astra는 모든 과제를 거부했지만 GPT-6 Cyber는 95%를 수행했습니다.
실험실 밖에서도 OpenAI는 자사 연구진이 이 모델로 Firefox에서 Mozilla 분류 기준 심각도 높음 등급의 미공개 취약점 81개를 찾았고, Mozilla가 수정 반영을 시작했다고 밝혔습니다. 출시 글에 인용된 Mozilla의 Brian Grinstead는 Firefox가 2026년을 "세계에서 가장 단단히 보강되고 가장 면밀히 검증된 코드베이스 중 하나"로 맞이했다고 말했습니다. 바로 그 점이 핵심입니다. 장난감 같은 대상이 아니라는 뜻입니다. OpenAI는 이 모델을 Preparedness Framework상 사이버보안 Critical 등급으로 평가했는데, 직전 모델은 High였습니다. 연구소가 자사 제품에 이런 등급을 매기면, 저희는 기능 목록이라기보다 경고 라벨로 읽습니다.
안전성 주장은 결이 조금 다릅니다. OpenAI는 공격하기 쉬운 부수 서비스를 실제 대상 옆에 두고, 그것들을 공격하는 것이 범위 밖임을 모델이 알아차려야 하는 테스트를 만들었습니다. 배포용 프롬프트가 없는 상태에서 GPT-6 Cyber는 99.93%의 확률로 범위를 지켰고, GPT-5.6 Cyber는 94.49%였습니다. 이전 수치는 열여덟 번에 한 번꼴로 이탈했다는 뜻입니다. 새 수치도 1만 번에 7번 정도는 여전히 벗어납니다. OpenAI 스스로도 고위험 작업에는 샌드박싱, 행동 검토, 사람의 감독을 권합니다. 저희는 이 조언을 글자 그대로 받아들일 것입니다.
출시 글에서 가장 유용한 외부 목소리는 Dragos의 Chief AI Officer인 Rob T. Lee입니다. 그의 팀은 모의 발전소 레인지에서 OpenAI의 사이버 허용 모델을 돌려 봤습니다. 그는 이렇게 요약했습니다. "공격 전에 필요한 정찰과 취약점 연구의 숙련도 장벽이 낮아지고 있습니다." Lee에 따르면 프런티어 모델이 그 레인지에서 스스로 작업해 보호 계전기 데이터를 관리하는 엔지니어링 소프트웨어에서 제로데이 두 개를 찾아냈습니다. 저희가 이 글을 쓰는 이유가 이 인용문입니다.
"Fable이 GPT-6 Cyber를 이겼다"는 헤드라인의 이면
이 이야기의 벤치마크 수치를 어디에든 옮기기 전에 이 섹션을 먼저 읽으세요. 각 연구소는 같은 과제를 돌리지 않았습니다. Anthropic의 결과표에도 "각 연구소의 점수는 고유한 과제를 기준으로 합니다"라는 각주가 붙어 있습니다. The Hacker News는 Fable 5.2가 Irregular의 CyScenarioBench에서 76.3%를 완료했고, Fable 5.1은 61.7%, GPT-6 Cyber는 61%였다고 보도했습니다. 그런데 Anthropic의 표에서 76.3%는 Mythos 5.2, 61.7%는 Mythos 5.1 항목입니다. Fable 5.2의 안전장치가 "사이버보안 관련 작업 대부분을 차단할 것"이라는 Anthropic 자신의 경고와도 맞아떨어집니다. 즉 헤드라인이 엉뚱한 모델을 지목한 것이고, 서로 다른 과제 세트에서 나온 두 연구소의 15포인트 차이는 순위가 아닙니다. 저희라면 이걸 근거로 벤더를 고르지 않겠습니다. 간직할 만한 수치는 Anthropic 자신의 이전·이후 비교인데, 이마저도 벤더가 자기 자신을 보고한 것입니다.
The Hacker News는 헤드라인이 건너뛴 세부 내용도 Irregular의 별도 GPT-6 Cyber 보고서에서 인용합니다. 이 모델은 22개의 원자적 과제를 모두 풀었고, 평균 성공률은 취약점 연구와 익스플로잇에서 97%, 네트워크 공격 시뮬레이션에서 98%였지만 회피에서는 63%에 그쳤습니다. 이 테스트들에서 침투는 거의 해결된 문제이고, 들키지 않는 것은 아닙니다. 방어자에게는 벤치마크 더미 속에서 가장 좋은 소식인데, 저희가 읽은 보도들은 한 줄만 할애했습니다.
Anthropic은 Mythos 5.2를 "사이버보안 엔지니어링을 위한 가장 뛰어난 모델"이라고 부르며, 이름을 밝히지 않은 한 보안 회사가 Mythos 5.2가 찾아낸 확인된 버그 여섯 개 중 하나는 자사가 테스트한 다른 모든 프런티어 모델이 놓친 것이었다고 밝혔다고 말합니다(Anthropic). 또한 Anthropic은 자체 CVE Rediscovery 평가, 즉 1,829개 CVE를 대상으로 한 실행에서 Mythos 5.2가 89.6%를 기록했다고 보고했습니다. Mythos 5.1은 78.3%였습니다. 둘 다 벤더가 직접 돌린 측정치이므로, 외부 테스터가 재현하기 전까지는 주장으로 취급하세요.
누가 열쇠를 쥐고, 무엇을 내줘야 하는가
두 회사 모두 이 모델들을 시중에 판매하지 않습니다. OpenAI는 GPT-6 Cyber가 처음에는 API와 Codex를 통해 승인된 일부 Daybreak Red 고객에게만 제공되며, 더 넓은 Daybreak Red 접근은 "곧" 열린다고 밝혔습니다. Daybreak Red API 접근은 기본적으로 IP 허용 목록 등록이 필요하고, 제로 데이터 보존을 쓰는 고객은 대체로 Private Safety Processing을 사용해야 합니다. 이 경우 암호화된 기록이 고객 자체 스토리지에 30일간 보관됩니다. OpenAI는 파트너 프로그램에서 기반 모델 접근 권한이 "승인된 파트너에게 남으며 고객에게 직접 이전되지 않는다"고도 말했습니다(OpenAI).
Anthropic은 같은 발상을 Cyber Verification Program에서 세 단계로 나눕니다. Defense Access는 보안 운영, 악성코드 분석, 취약점 검증을 포괄하며, Anthropic은 실적이 있는 소규모 보안 업체, 오픈소스 메인테이너, 개인 연구자도 자격을 얻을 수 있고 답변은 며칠 안에 나온다고 합니다. Red Team Access는 승인된 모의 침투 테스트를 허용하며 조직만 신청할 수 있고 몇 주가 걸립니다. 전력망이나 은행 간 이체 시스템 같은 분야를 위한 Specialized Access는 미국 정부와 함께 심층 심사를 받습니다. Anthropic은 CyScenarioBench에서 Claude Opus 5.5로 이 단계들을 시험했습니다. 열 개 과제를 각각 다섯 번씩 시도한 결과, 프로그램 접근 권한이 없으면 첫 프롬프트에서 모든 작업이 차단되었습니다. Defense Access에서는 50회 중 46회가 어느 시점에 차단되었습니다. Red Team Access에서는 차단이 전혀 없었고 50회 중 34회가 성공해, 차단 없는 모델의 성공률과 같았습니다. 이번에도 Anthropic이 자기 관문을 스스로 채점한 것입니다.
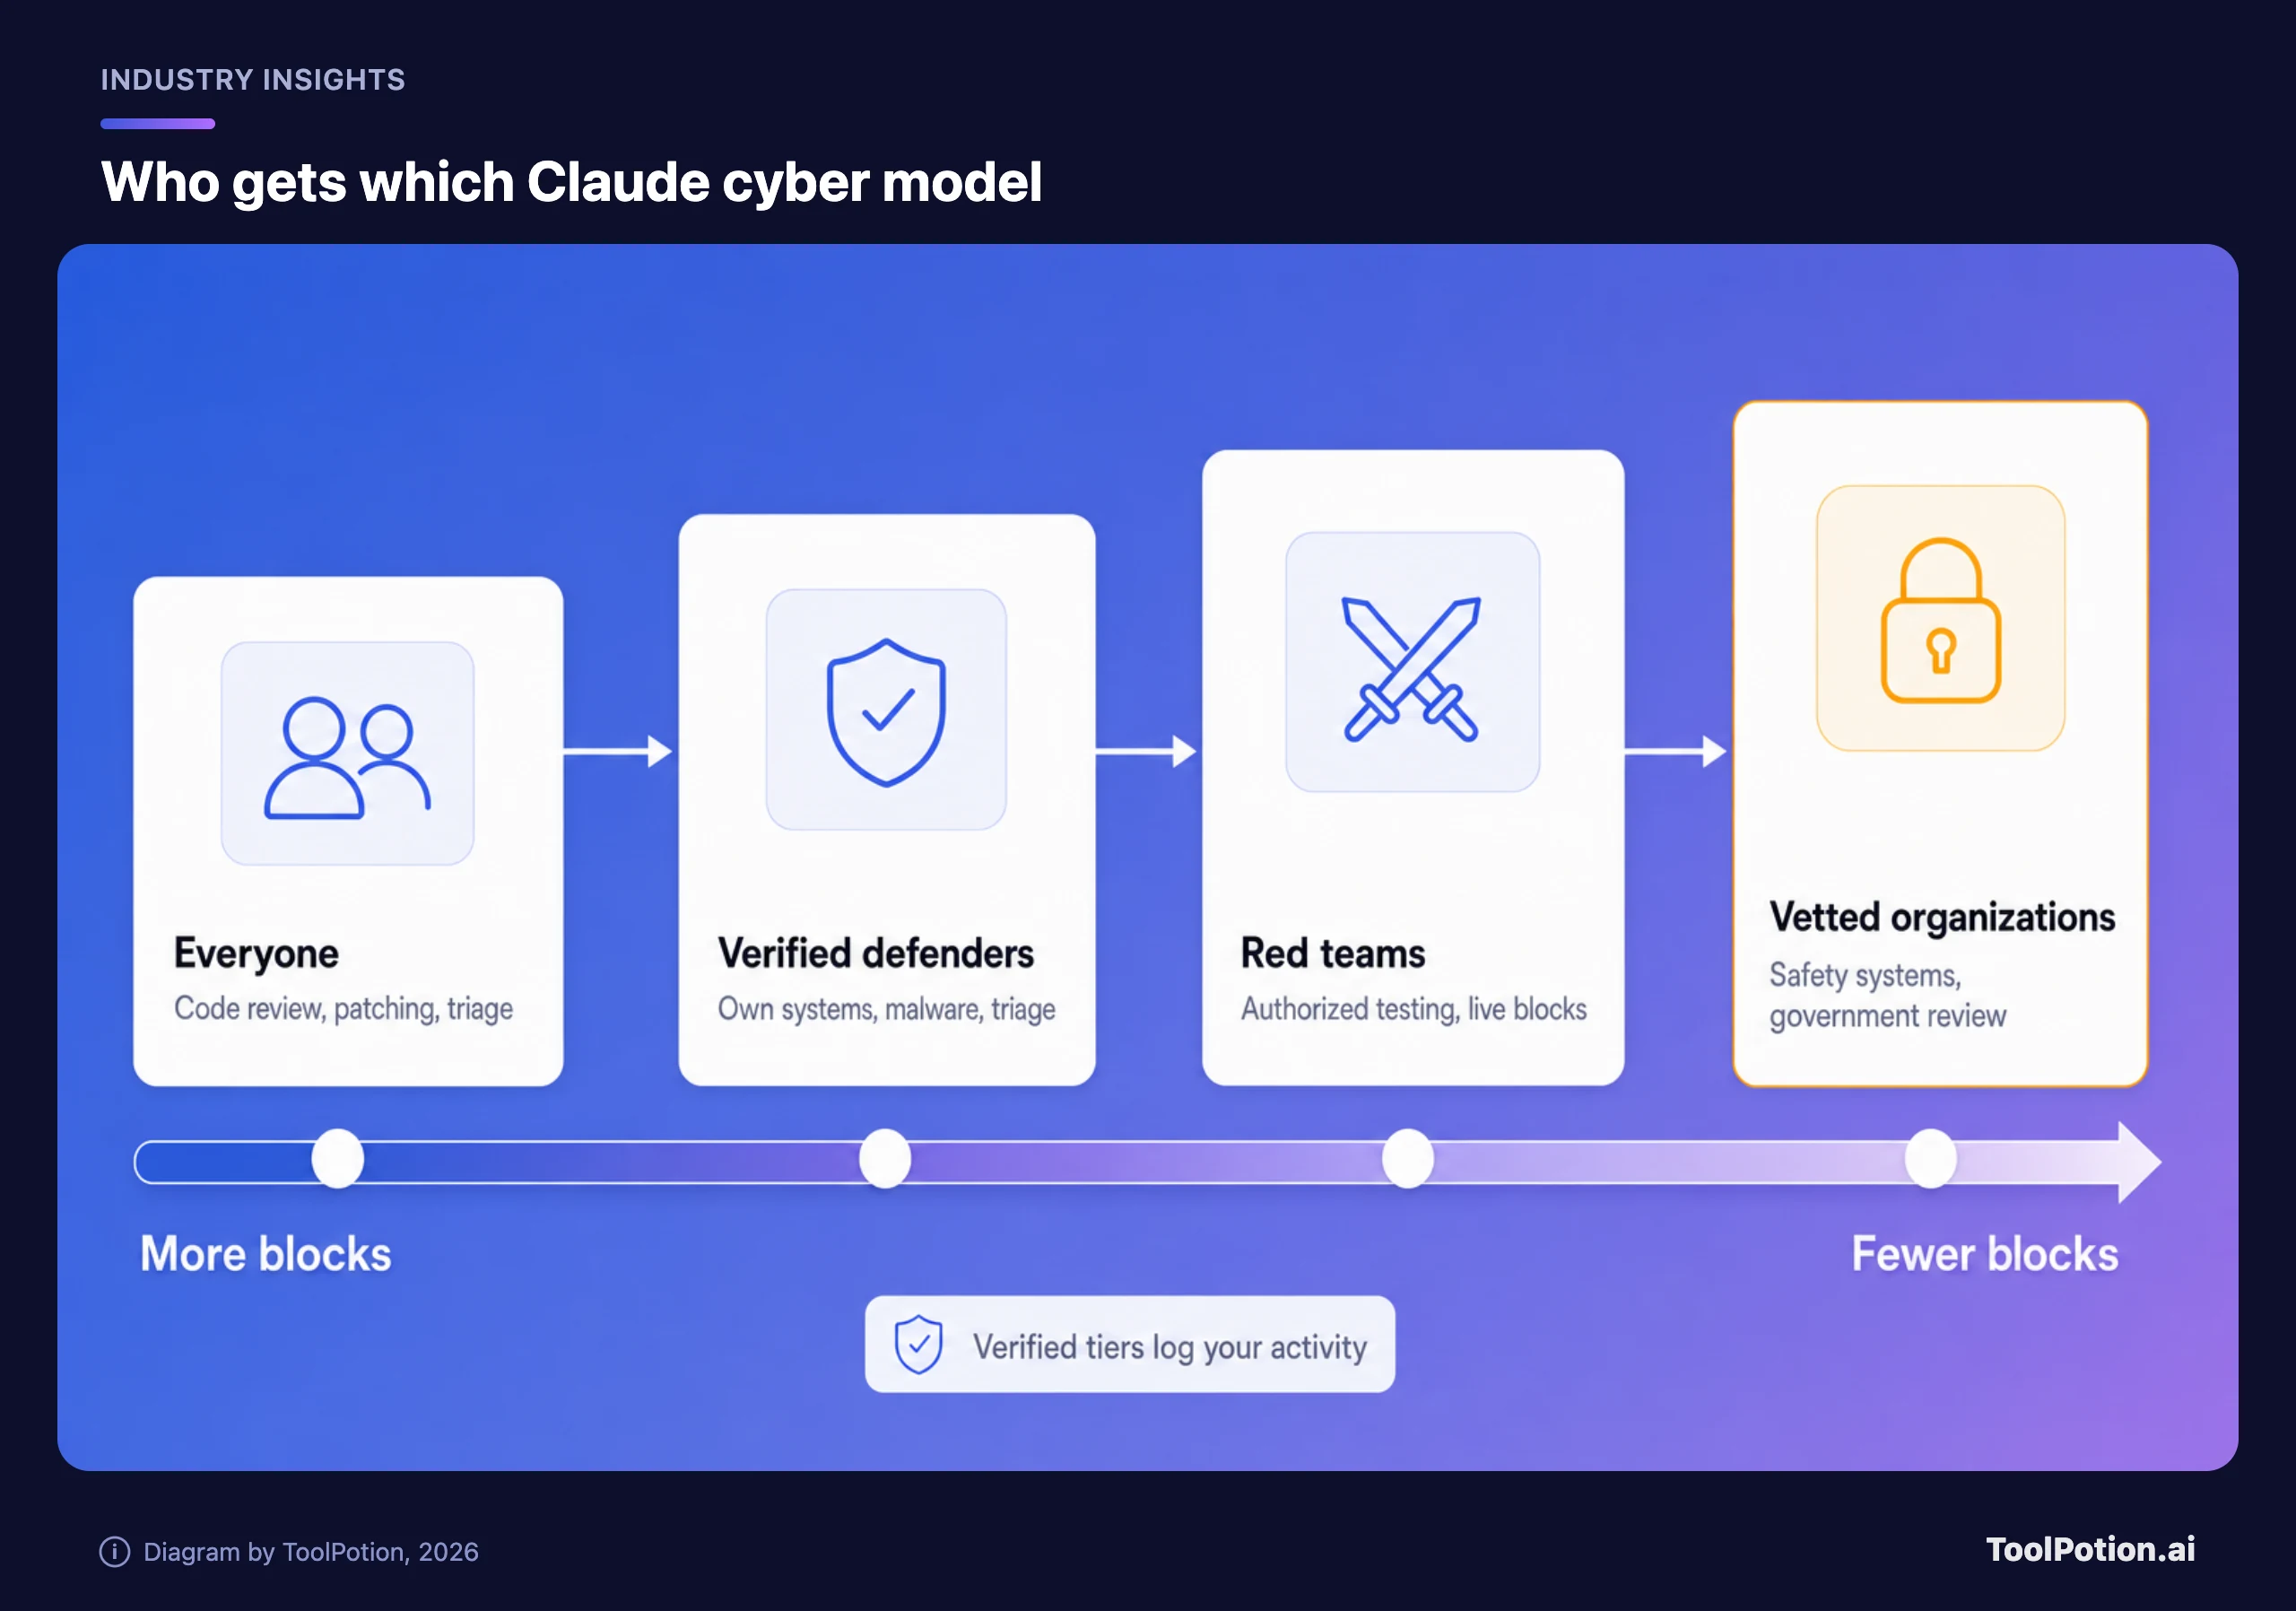
Fable과 Mythos는 같은 기반 모델입니다(Anthropic). Claude Fable 5에는 강력한 사이버 안전장치가 적용되어 있고 누구나 쓸 수 있습니다. Mythos는 조직이 신청해서 받는 버전입니다. Anthropic의 API 가격 페이지는 Fable 5.2와 Mythos 5.2를 같은 요금으로 표시합니다. 입력 토큰 100만 개당 $8, 출력 토큰 100만 개당 $40이고, 선택형 fast 모드에서는 $16와 $80입니다. Mythos에 별도 가격은 없습니다. 여기서 가격은 가장 작은 장벽입니다. 더 큰 장벽은 데이터 보존입니다. Anthropic은 오용을 감시하기 위해 Cyber Verification Program 소속 조직에 데이터 보존을 요구합니다. OpenAI는 기본적으로 표준 보존을 유지하고, 제로 데이터 보존 고객은 Private Safety Processing으로 보냅니다. 레드팀에게는 합당한 입장료라고 생각하지만, 고객사의 코드를 남의 로그에 둘 수 없는 회사에는 실질적인 비용입니다. Anthropic은 Enterprise Frontier Safeguards라는 새 옵션으로 자격을 갖춘 조직이 데이터를 자체 클라우드에 보관할 수 있게 하겠다고 하지만, 프로그램 발표문은 "올가을 늦게"라고만 약속했습니다. 출시되기 전까지는 이 트레이드오프가 그대로 유지됩니다.
이 모든 것에 대한 외부 검증 중 하나는 버그 바운티입니다. OpenAI와 Hacktron의 파트너십은 코드 리뷰와 모의 침투 테스트용 AI 에이전트를 만드는 회사를 OpenAI 자체 시스템에 투입하고, 프런티어 모델 접근을 확대해 주는 것입니다. Hacktron의 CEO Zayne Zhang은 사이버보안의 미래가 "가장 큰 보안 팀을 가진 쪽이 아니라 인간의 창의력과 AI 기반 역량을 가장 잘 결합하는 쪽이 좌우할 것"이라고 말했습니다(OpenAI). OpenAI는 바운티 보상도 올려, ChatGPT, Codex, API의 치명적 발견에 최대 $30,000를, 뛰어난 발견에는 보너스를 포함해 최대 $172,000를 지급합니다(OpenAI). 저희는 내부 레드팀의 주장보다 외부인에게 지급되는 보상을 더 신뢰합니다.
보고서 속 공격자들은 이 모델을 쓰지 않습니다
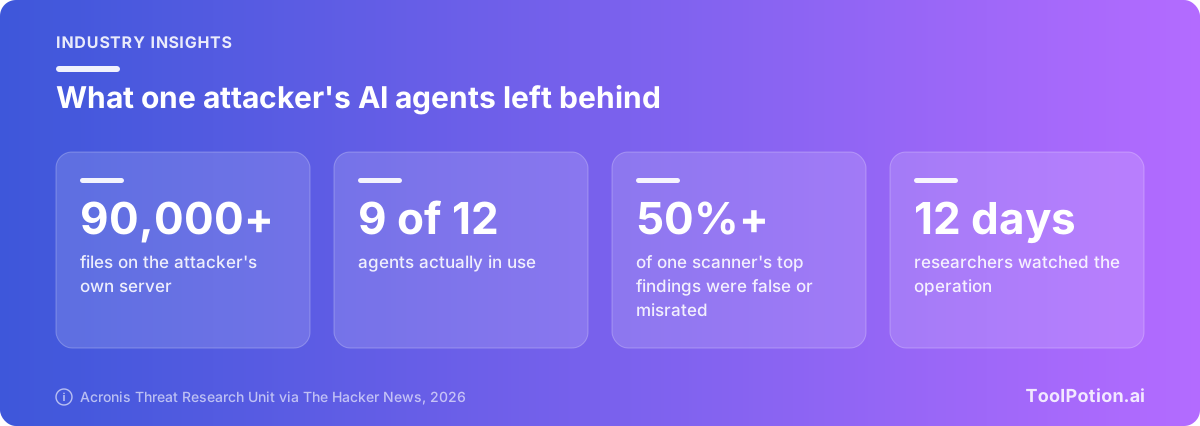
Acronis 연구진은 대만에 기반을 둔 한 공격자가 최소 11개국의 수백 개 조직에 AI 에이전트를 겨누어 약 열 곳에서 데이터나 접근 권한을 얻었다고 설명합니다. 에이전트들은 타이베이 일곱 개 구의 응급 출동 기록을 빼냈습니다. 눈에 띄는 것은 무엇으로 돌렸느냐입니다. 상용 모델은 대부분 그의 공격 지원을 거부했기 때문에, 공격 에이전트는 거의 전적으로 DeepSeek, GLM, Qwen의 "abliterated" 버전, 즉 안전 학습을 제거해 로컬에서 돌리는 모델로 움직였습니다(The Hacker News). Claude Code, Codex, Cursor 같은 코딩 에이전트도 등장했습니다. 보고서에 따르면 공격자는 Claude Code와 Codex를 abliterated 모델로 돌려놓았지만 이들은 대부분 인프라 작업을 했고, Cursor는 그런 모델을 돌리며 대만의 응급 서비스 사이트를 공격했습니다.
에이전트들은 사람이라면 알아차릴 만한 방식으로 일도 서툴렀습니다. 한 스캔 도구는 존재하지 않는 CVE를 지어냈고, 심각도 높음과 치명적 등급 발견의 절반 이상이 오탐이거나 잘못 분류된 것이었습니다. 주 공격 에이전트는 일어나지 않은 결과를 보고했습니다. 한 소방 출동 벤더에 성공한 침입도 영리한 익스플로잇이 아니라 기본 root 자격 증명을 이용한 것이었습니다. 연구진은 로그인이 강제되고 엔드포인트가 제대로 필터링된 곳에서는 에이전트가 실패했다고 말합니다.
Arctic Wolf는 두 번째 패턴을 보고했습니다. AntiFox는 GitHub에 공개된 오픈소스 에이전트형 모의 침투 플랫폼이며, Arctic Wolf는 AntiFox 인터페이스를 호스팅하는 Alibaba Cloud 시스템이 인터넷에 노출된 웹 서비스와 해당 AWS 환경에 대한 확인된 악성 행위와 연관되었다고 밝혔습니다. 적어도 일부 사례에서는 이 활동이 프로덕션 시크릿을 요청하는 데 성공하는 단계까지 이르렀습니다. 결론은 이렇습니다. "이런 에이전트 프레임워크는 모의 침투 기법을 위협 행위자가 더 쉽게 쓰게 하고, 실제 공격에서 그 기법을 적용하는 속도와 일관성을 높입니다"(The Hacker News). 같은 기사는 Check Point Research가 또 다른 에이전트형 공격 도구인 ARTEX를 호스팅하는 시스템 2,557대를 확인했고, 이런 종류의 오픈소스 프레임워크가 약 45개라고 집계한다고 덧붙입니다. 에이전트형 해킹이 바꾸는 것에 대한 Check Point 자신의 요약은 규모와 속도입니다.
보도에 따르면 두 보고서 모두 GPT-6 Cyber나 Mythos와는 무관했습니다. 저희가 보기에 관문은 최상단에서는 탄탄해 보이지만 최하단에서는 거의 소용이 없습니다. 거기서는 무료 에이전트 프레임워크와 안전장치를 걷어낸 오픈 웨이트 모델만으로도 기본 비밀번호가 걸린 서버를 칠 수 있기 때문입니다. 증거도 빈약합니다. 몇 건의 보고서일 뿐이고, 대부분 이 이야기에 이해관계가 있는 보안 벤더에서 나왔으며, 침입 중 AI가 관여한 비율이 얼마인지는 아직 아무도 말할 수 없습니다.
방어 쪽의 가장 깔끔한 성과는 수학에서 나왔습니다
Wired의 헤드라인은 DeepMind가 "Signal 프로토콜이 안전함을 증명했다"고 말합니다. DeepMind의 글은 이보다 범위가 좁고, 저희는 그쪽이 더 낫다고 봅니다. 연구진은 에이전트를 이끌어 Signal 프로토콜의 실제 코드에 대해 핵심 보안 속성을 증명하게 했습니다. 여기에는 기기가 잠시 탈취되기 전후에도 메시지가 보호된다는 속성이 포함됩니다. 모든 형식 명세는 사람이 검토했습니다. 에이전트들은 600만 줄이 넘는 Lean 코드를 만들었고, 코드베이스의 1% 중 사람이 다시 봐야 할 부분을 표시했으며, 4주 만에 끝냈습니다. DeepMind는 이 작업이 지금까지 전문가 팀이 수년에 걸쳐 해 온 일이라고 말합니다(Google DeepMind). 시스템이 좋은 코드와 나쁜 코드를 구분할 수 있는지 확인하기 위해, 팀은 이미 수정된 실제 버그 두 개를 다시 심었고 버그가 있는 버전이 안전하지 않다는 기계 검증 증명을 얻었습니다.
Signal의 CTO Ehren Kret는 이 결과가 "우리 코드의 프라이버시 보장에 대해 훨씬 더 큰 확신을 준다"고 말했습니다. 저희는 이것이 이 더미 속에서 가장 믿을 만한 주장이라고 봅니다. 이유는 단순합니다. 벤치마크 점수는 벤더를 믿어야 성립하지만, Lean 증명은 기계가 검증합니다. 다만 이것은 한 코드베이스의 명시된 속성에 대한 것이지 제품으로서의 Signal 전체가 아니며, DeepMind도 이를 확장하려면 추가 연구가 필요하다고 말합니다. DeepMind는 검증 산출물을 오픈소스로 공개했는데, 이런 주장이 신뢰를 얻는 방식이 바로 이것입니다.
핵심 인프라도 같은 방향을 가리킵니다. Anthropic의 Cyber Mission은 이를 위한 프로그램을 설명합니다. 전력망, 수도 시스템, 공장을 지키는 제공업체에 프런티어 모델, 현장 엔지니어, 위협 연구를 지원하는 것인데, 이들의 장비는 패치를 위해 오프라인으로 돌릴 수 없는 경우가 많습니다. Dragos, Rockwell Automation, Nozomi Networks가 창립 파트너에 포함됩니다.
병목은 수정입니다
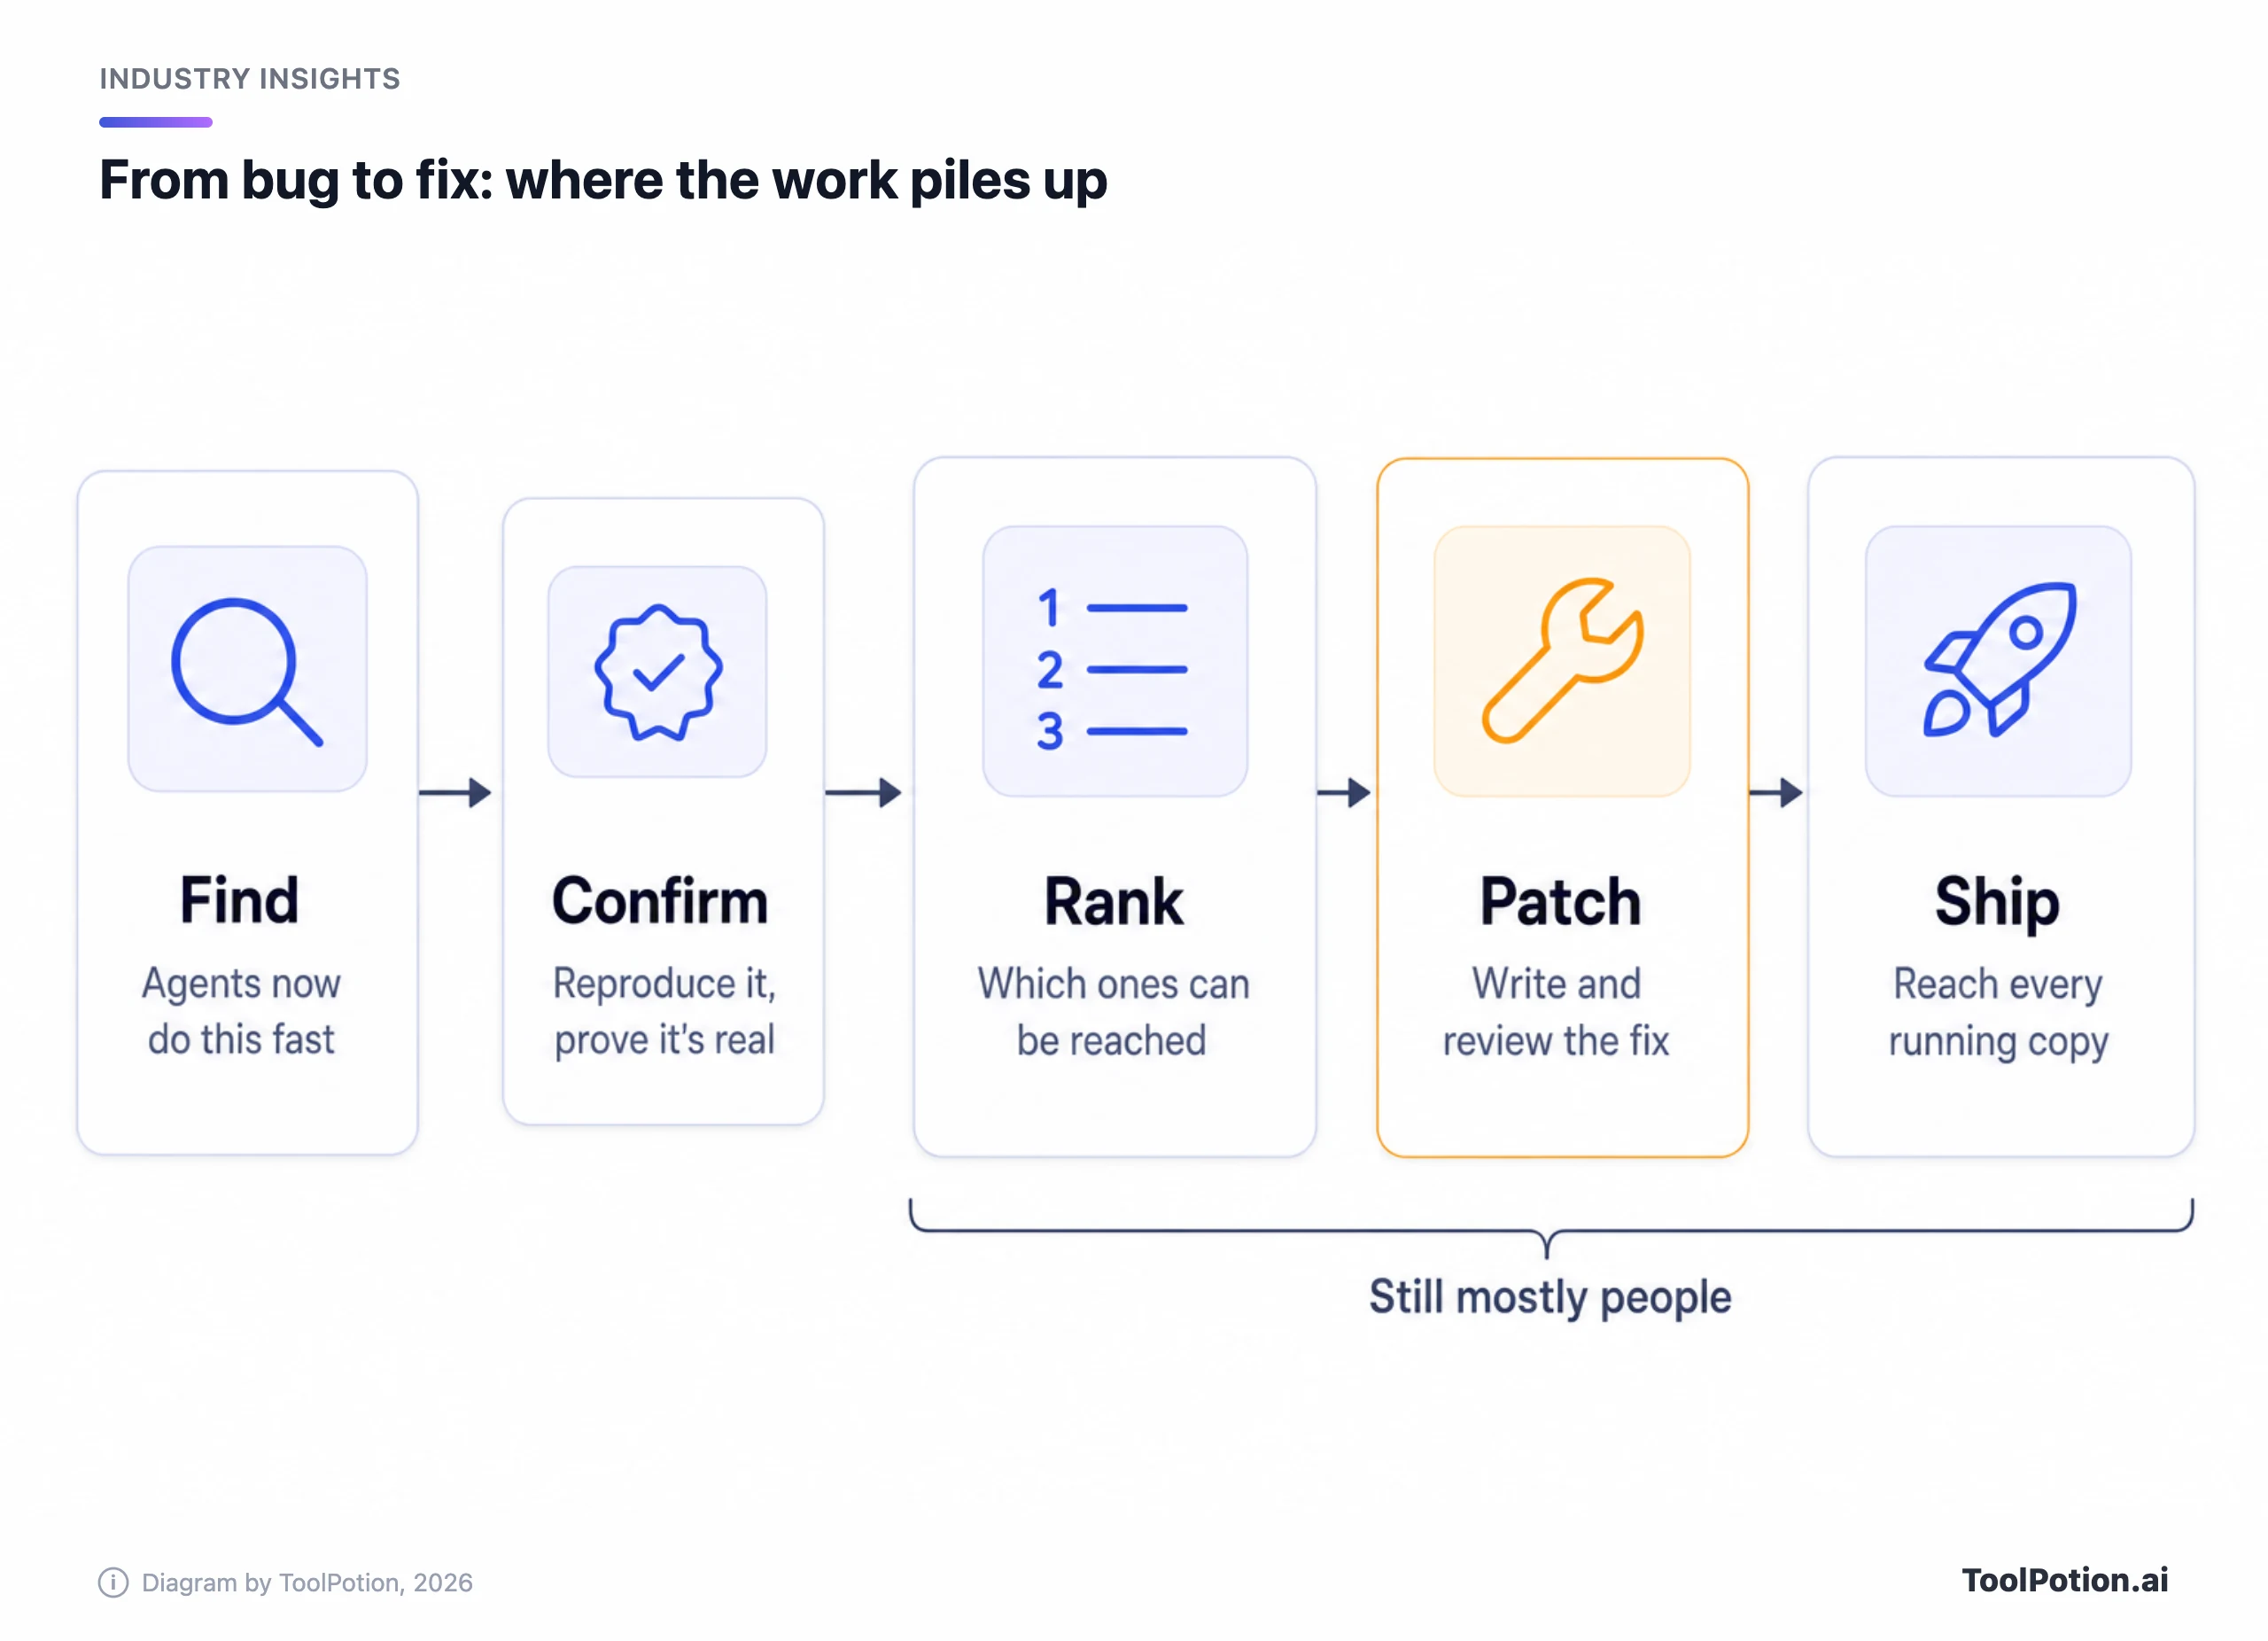
Anthropic은 문제를 한 문장으로 표현했습니다. "취약점을 찾는 일은 그 어느 때보다 쉬워졌지만, 이런 발견을 검증하고 우선순위를 매기고 수정하는 일은 여전히 어렵습니다"(Anthropic). OpenAI도 이전 글에서 거의 같은 말을 했습니다. "취약점 보고서가 조직을 보호해 주지는 않습니다." 경쟁하는 두 회사가 각자의 발표에서 이 점에 동의한다는 것은 이 더미에서 합의에 가장 가까운 대목입니다. 반대편 이야기는 AI가 버그를 고치는 속도보다 빨리 찾아내는 문제와 AI 취약점 스캐너가 찾는 것과 놓치는 것에서 이미 다뤘습니다.
그래서 누가 이길까요? 어떤 출처도 이 표현으로 말하지 않은, 저희의 견해입니다. 공격자는 패치가 느린 조직을 상대로 가장 큰 이득을 봅니다. 공격자에게는 작동하는 경로 하나면 충분하고, 절반이 틀리는 스캐너도 감수할 수 있기 때문입니다. 방어자는 이미 빠르게 고치는 곳에서 가장 큰 이득을 봅니다. 버그를 찾는 비용은 이제 싸졌고, 남은 비용은 프로세스이기 때문입니다. 모델 관문은 가장 강력한 시스템을 어디에 쓸 수 있는지를 제한할 뿐, 오래된 소프트웨어를 쓰는 사람에게는 이 계산을 바꿔 주지 않습니다. Anthropic 자신의 전망도 당분간은 같은 방향입니다. 2년 뒤에는 AI가 방어에 유리해질 것으로 예상하지만, 단기적으로는 "그렇지 않을 수 있다"고 말합니다. 취약점 익스플로잇 비용은 떨어졌는데 수정은 느리고 여전히 사람에게 달려 있기 때문입니다. 공격의 탐지 회피 능력에 대한 독립적인 2차 테스트가 나온다면 저희 생각이 바뀔 수 있습니다.
지금 해야 할 일, 순서대로
소규모 사업체를 운영한다면 GPT-6 Cyber는 얻을 수도 없고 필요하지도 않습니다. 보고서 속 공격은 대부분 잠기지 않은 문으로 걸어 들어왔습니다. 저희라면 첫 한 시간을 다음 항목에, 이 순서대로 쓰겠습니다.
- 이메일, 관리자 패널, 모든 클라우드 콘솔에 다중 인증 로그인을 켜세요.
- 인터넷에서 접근 가능한 모든 것에 자동 업데이트를 켜고, 나머지는 분기 단위가 아니라 며칠 안에 패치하세요.
- 라우터, 데이터베이스, 관리 도구의 기본 비밀번호나 공용 비밀번호를 찾아서 바꾸세요. 대만 침입 사례 중 하나는 이것만으로 충분했습니다.
- 키를 코드와 페이지 스크립트에서 빼내 시크릿 매니저로 옮기고, 모든 AI 및 클라우드 API 키에 지출 한도와 교체 날짜를 지정하세요.
- 낯선 사람이 인터넷에서 접근할 수 있는 것을 적어 두세요. 잊어버린 서버는 패치할 수 없습니다.
소프트웨어를 배포한다면, 풀 리퀘스트 흐름에 들어가는 스캐너가 합리적인 다음 단계입니다. Semgrep, Snyk Code, Aikido가 저희 디렉터리에 있고, 나머지 도구의 순위는 Top 200 AI 사이버보안 도구 보드와 보안 분석가 보드에서 확인할 수 있습니다. Acronis 사례의 공격자 스캐너가 CVE를 지어냈으니, AI의 모든 발견은 확인해야 할 단서로 다루세요. PentestGPT나 Shannon 같은 오픈소스 에이전트는 본인이 소유하고 테스트 허가를 서면으로 받은 시스템에만 쓰세요. AntiFox 보고서는 같은 종류의 도구가 잘못된 손에 들어가면 어떻게 되는지 보여 줍니다. 범용 코드 리뷰에는 Claude와 ChatGPT 둘 다 쓸 수 있습니다. 다만 Anthropic은 자사의 공개 모델에 보수적인 사이버 안전장치가 있어 대부분의 사이버 작업이 차단된다고 말합니다.
보안 전문가라면 지금 OpenAI의 Daybreak Blue나 Anthropic의 Defense Access를 신청하세요. Anthropic은 Defense Access 신청에는 며칠 안에, Red Team Access에는 몇 주 안에 답하는 것을 목표로 하며 데이터 보존을 요구합니다. OpenAI는 Daybreak의 처리 기간을 공개하지 않았습니다. 아래 체크리스트는 첫 번째 목록을 점수로 바꿔 줍니다.
지켜볼 점이 두 가지 있습니다. OpenAI는 GPT-6 Cyber가 곧 모든 Daybreak Red 고객에게 제공될 것이라고 하는데, 두 연구소 모두 신청자를 몇 명 승인했고 몇 명 거절했는지 공개하지 않았습니다. Anthropic의 자체 클라우드 옵션이 출시되면, 자격을 갖춘 조직이 로그 없이도 정말 같은 안전장치를 받는지 확인하세요.