

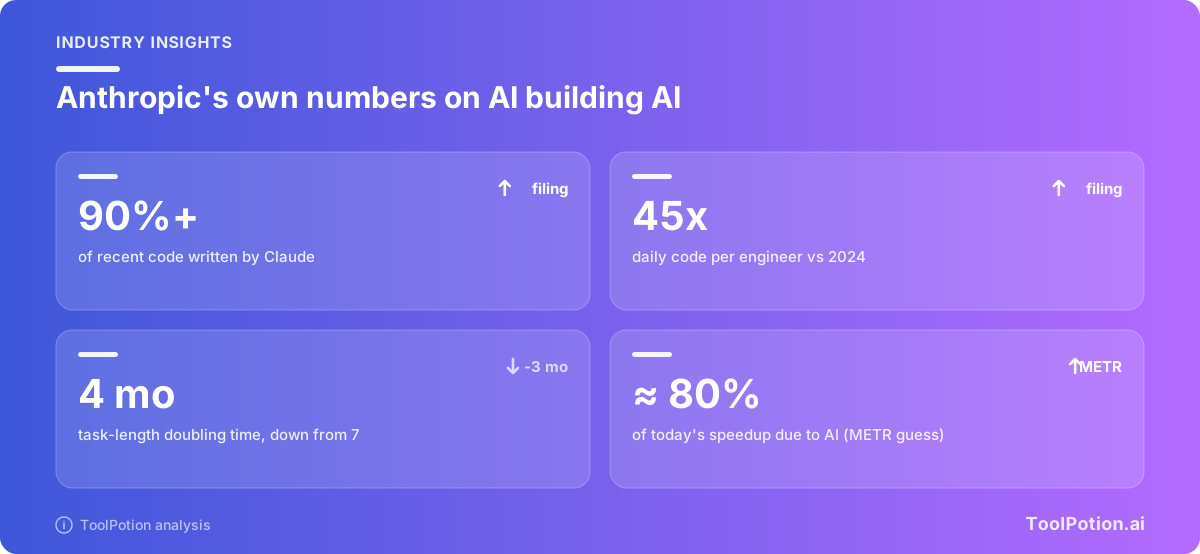
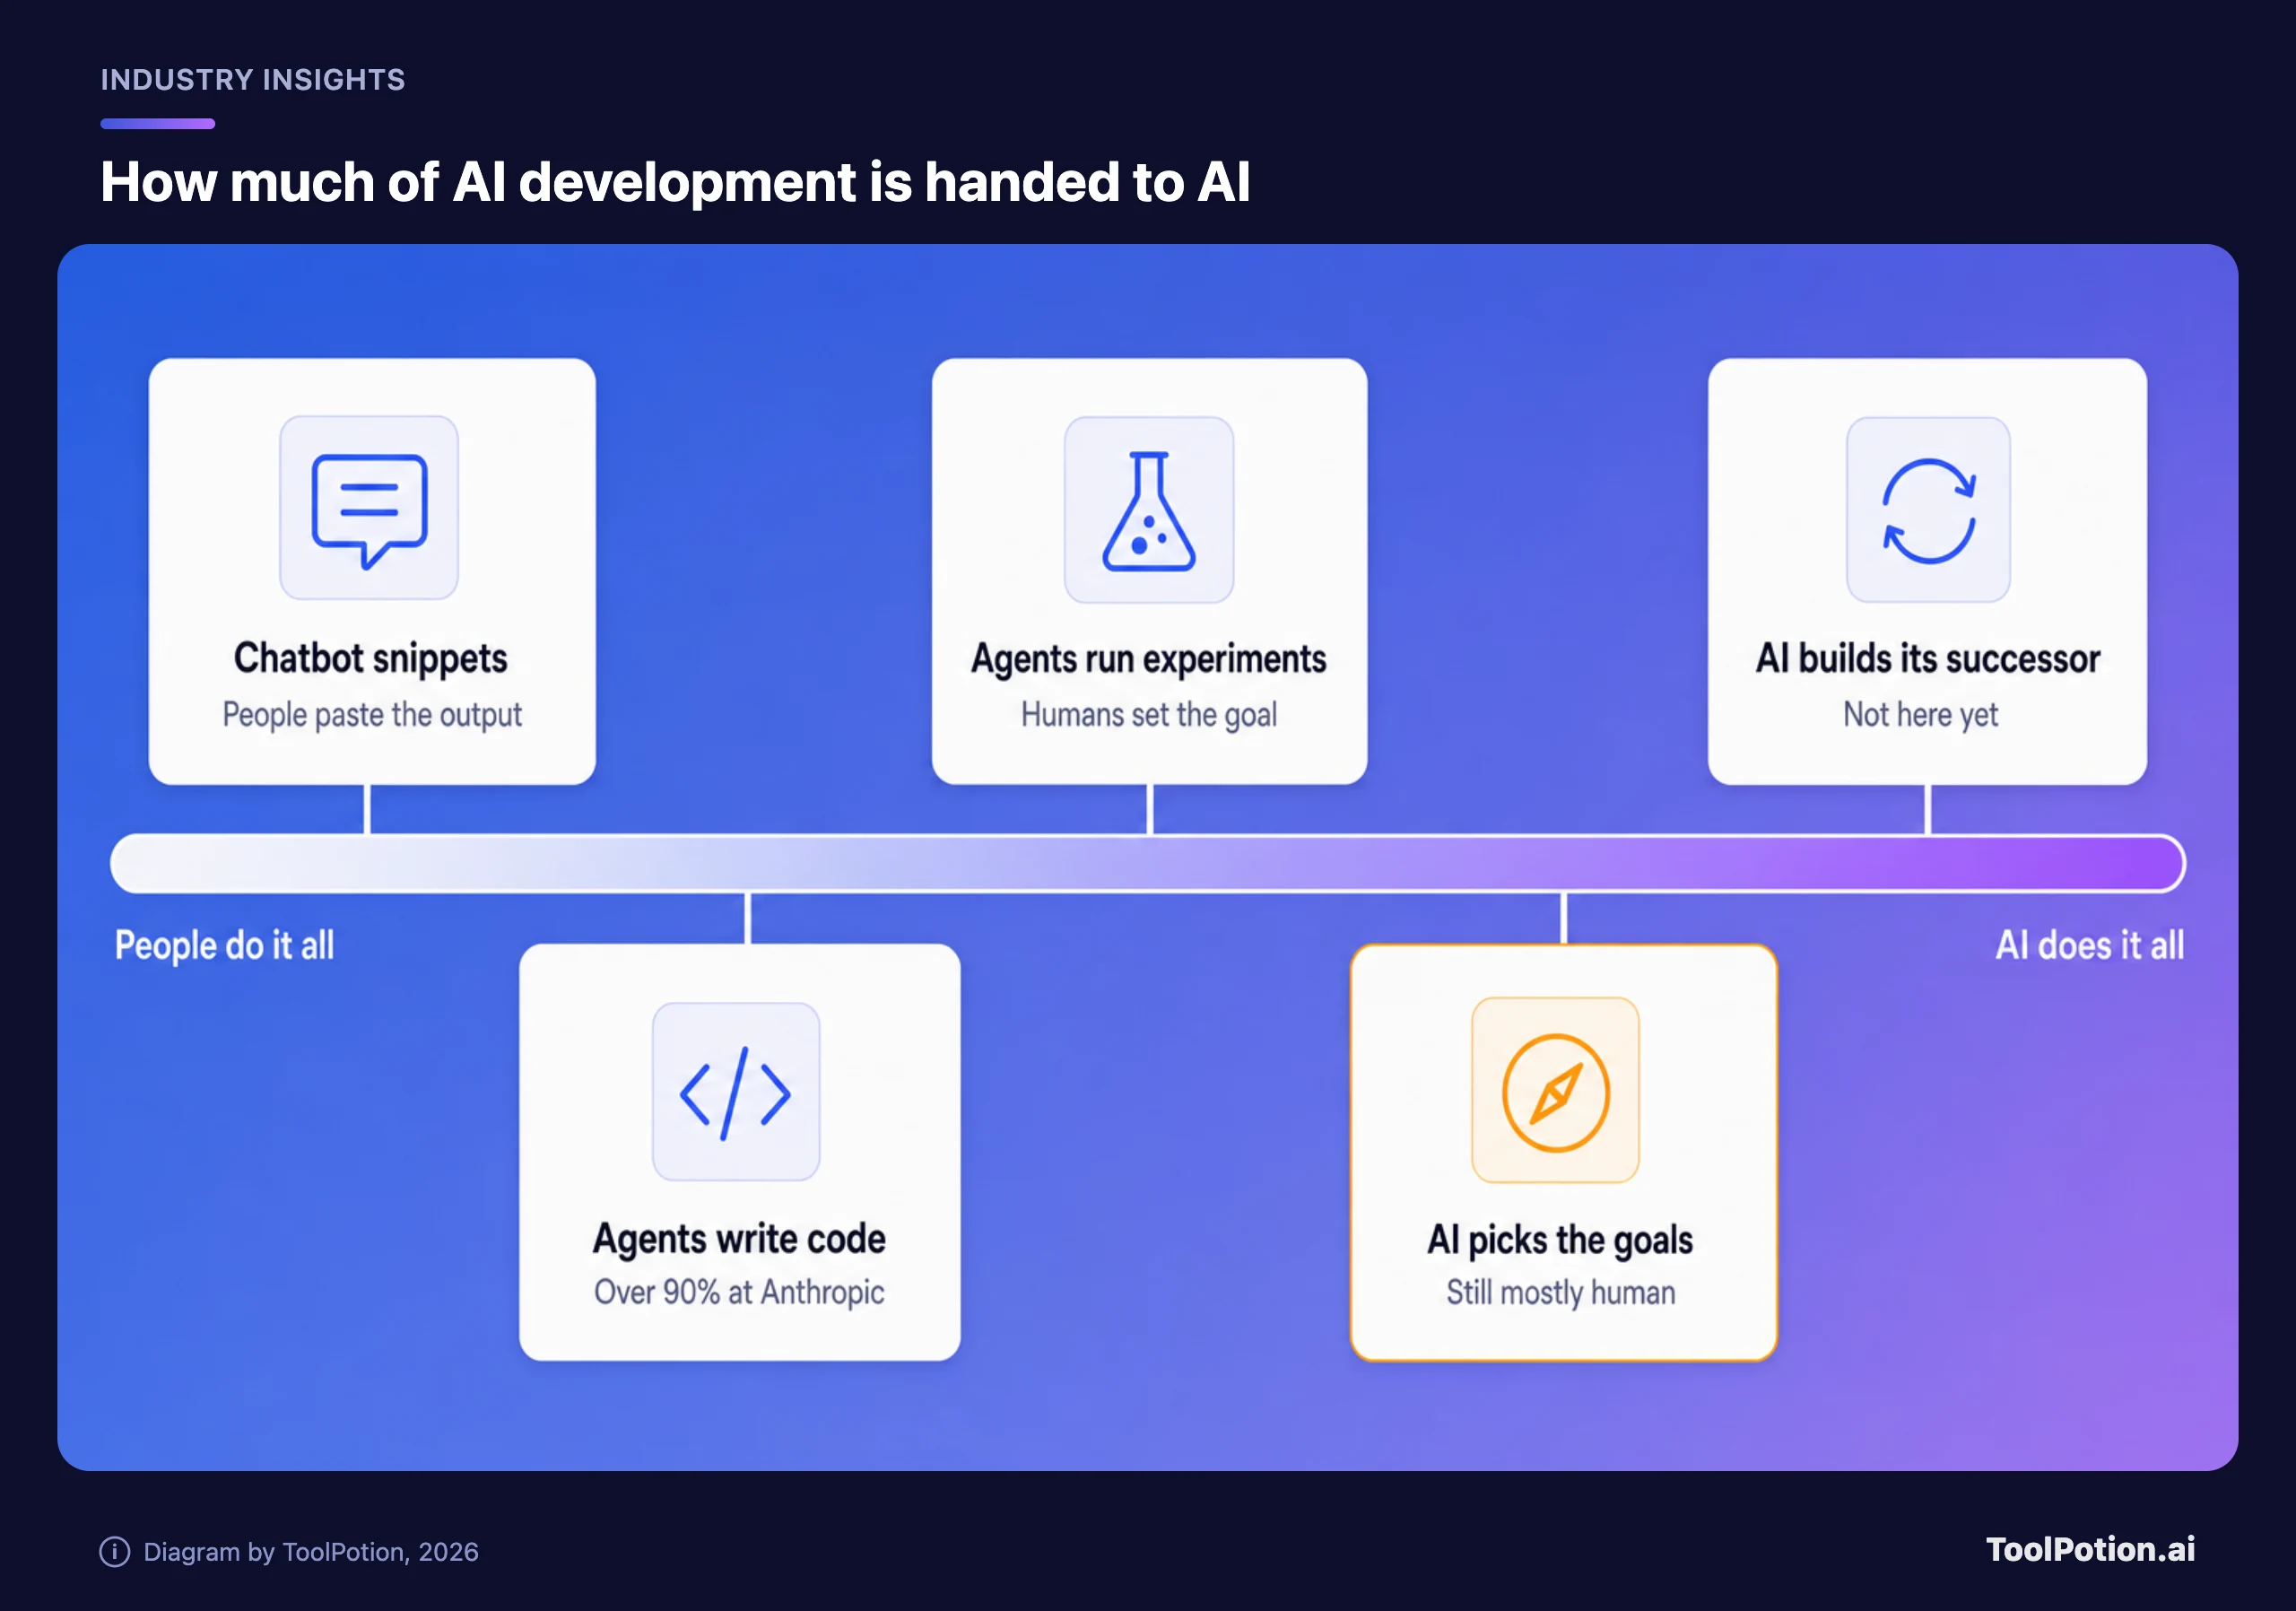
수정된 IPO 제출 서류가 다루는 가장 최근 한 달 동안 Anthropic 코드베이스에 들어간 기여분의 90% 이상을 Claude가 작성했습니다. 이는 회사가 직접 밝힌 수치(SEC 제출 서류)이며, 이 문서에서 가장 덜 극적인 내용입니다.
뉴스가 된 문장은 위험 요인 항목 깊숙한 곳에 있습니다. Anthropic의 내부 추정에 따르면 AI 주도의 극적으로 가속된 진전이라는 Responsible Scaling Policy의 정의에 "곧 도달할 수 있다(may imminently meet)"는 내용입니다. TechCrunch는 이를 Anthropic이 "RSI 역량에 매우 가깝다"고 경고했다는 기사로 냈습니다(TechCrunch). 저희는 이 경고가 현실이라고 봅니다. 다만 헤드라인은 실제 서류보다 한 톤 더 요란하고, 가장 큰 영향을 받는 사람들은 위험 요인 항목을 읽을 일이 없는 사람들입니다.
SF 영화 같은 이야기를 뺀 재귀적 자기 개선
재귀적 자기 개선(RSI)은 하나의 순환 고리입니다. AI 시스템이 다음 AI 시스템을 만드는 일을 돕고, 그 다음 시스템은 그 다음 것을 만드는 일을 더 잘 돕습니다. Anthropic은 이를 "자신의 후속 모델을 완전히 자율적으로 설계하고 개발할 수 있는 AI 시스템"(Anthropic Institute)이라고 정의합니다.
이 고리가 닫혔다고 주장하는 사람은 없습니다. 지금은 사람이 목표를 정하고 AI가 점점 더 많은 작업을 맡습니다. Claude Code가 코드를 작성하고 실행하며, 에이전트가 다른 에이전트에게 몇 시간 분량의 작업을 넘깁니다. Anthropic은 Claude가 이미 명확히 정의된 실험을 수행하는 데에서는 숙련된 사람과 대등하거나 더 낫다고 말합니다. 부족한 부분으로 꼽는 것은 판단력입니다. Anthropic의 표현으로는 "목표를 선택하는 데 판단력을 발휘하는 부분에서는 큰 성능 격차가 남아 있습니다."
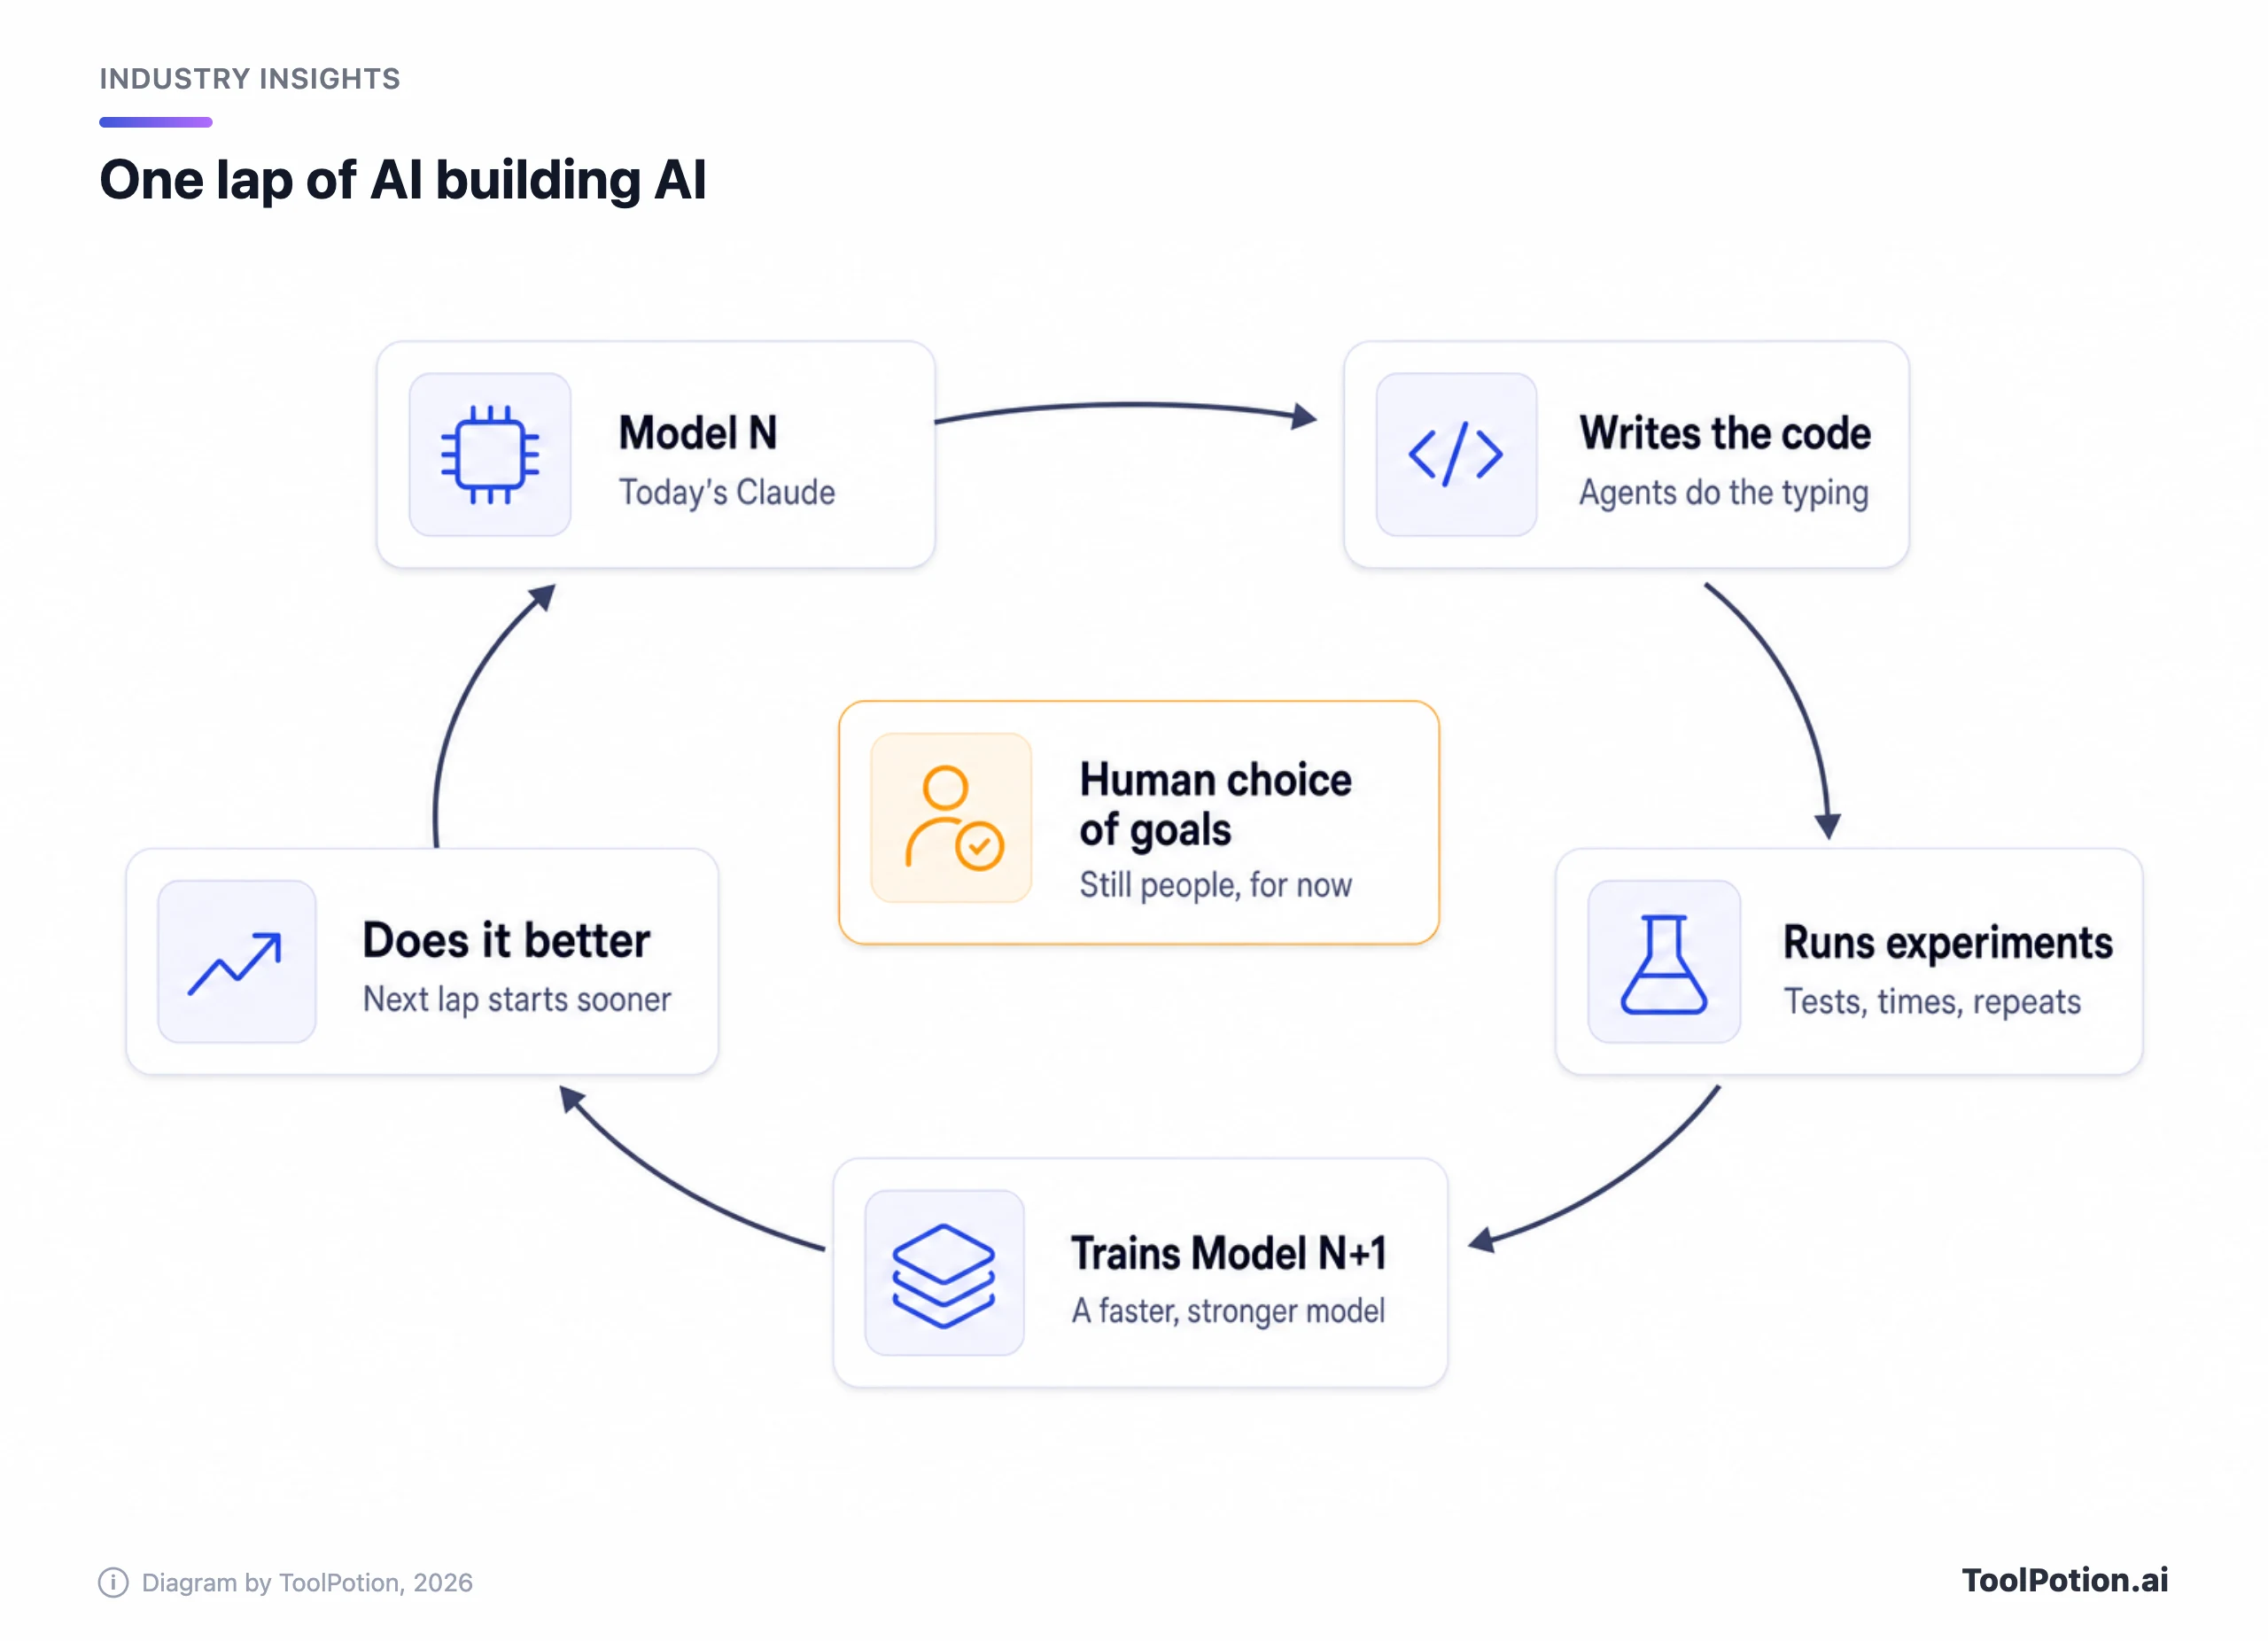
외부 증거도 같은 방향을 가리킵니다. Anthropic의 게시글에 따르면 AI가 스스로 끝낼 수 있는 작업의 길이는 대략 4개월마다 두 배로 늘고 있으며(이전에는 7개월), Claude Opus 4.6은 사람이 약 12시간 걸리는 작업을 해냈습니다(Anthropic Institute). 이 추세가 이어지면 숙련된 사람이 며칠 걸리는 작업도 머지않아 가능한 범위에 들어옵니다. 업체가 내놓은 추세선은 하나의 주장으로 받아들여야 하지만, 같은 게시글은 해당 벤치마크를 운영하는 METR이 Claude Mythos Preview가 최소 16시간 동안 작업할 수 있다고 판단했다고 인용합니다.
그렇다면 왜 걱정해야 할까요? 속도와 감독 때문입니다. 고리를 한 바퀴 돌 때마다 시간이 짧아지면, 작업을 검토해야 할 사람이 병목이 되고 몇 달씩 걸리던 점검은 압축됩니다. Anthropic 스스로도 게시글에서 완전한 RSI는 "인간이 AI 시스템에 대한 통제력을 잃을 위험을 높일 수 있다"고 말합니다. 동시에 "우리는 아직 거기에 도달하지 않았고, 재귀적 자기 개선은 필연적이지 않다"고도 말합니다. 두 문장은 같은 단락에 있으며, 저희는 둘 다 염두에 둬야 한다고 봅니다.
제출 서류의 내용과 헤드라인이 덧붙인 것
제출 서류의 표현은 보도보다 좁습니다. Anthropic은 "현재 모델이 아니라 우리의 내부 추정과 향후 모델에 대한 기대"에 비추어 볼 때 "AI에 기인하는 극적으로 가속된 진전"이라는 정책상의 정의에 "곧 도달할 수 있다"고 씁니다. 그 뒤에는 헤드라인이 건너뛴 문장이 이어집니다. "우리는 현재 모델 중 어느 것도 이 기준을 넘는 것으로 지정하지 않았으며, 기초 데이터를 계속 평가하고 있습니다"(SEC 제출 서류). 서류는 Anthropic이 "AI 연구개발 역량 기준에 도달했을 때의 영향을 평가하고 있다"고도 덧붙입니다.
일부 매체는 경보가 발동됐다고 썼습니다. 엄밀히 말하면 Anthropic은 이를 선언하지 않았습니다. 이 차이는 문장으로는 작아 보여도 정책 면에서는 더 큽니다. 현행 정책(바로 이 기준을 개정한 버전 3.4)에서는 자동화된 R&D 선을 넘은 모델이 "고도 역량" 모델로 분류되고, 그런 모델을 다루면서 상당 부분이 가려진 위험 보고서는 전면적인 외부 검토를 받아야 합니다(정책 페이지). 예전의 "AI R&D-4" 표현은 현행 본문에서 사라졌습니다. 서류의 표현을 뒷받침하는 세부 사항이 하나 있습니다. 정책은 자동화된 연구에서 비롯됐을 법한 진전 속도의 두 배 증가를 Anthropic이 "관찰하거나 예상할(observe[s] or expect[s])" 때 기준이 충족된다고 말합니다. 예상도 포함되므로 "곧 도달할 수 있다"는 표현은 과장이 아닙니다.
가장 솔직한 문장은 따로 있습니다. Anthropic은 개발 속도의 상당한 가속을 "과거에는 일이 벌어진 뒤에야 파악했고, 앞으로도 그럴 수 있다"고 말합니다. 경보가 후행 지표를 읽는다는 고백입니다. 회사가 이를 숨기지 않고 공개적으로 말하는 편이 낫다고 보지만, 정책이 여기에 의존하지 않기를 바랍니다.
그렇다면 약속은 어떨까요? Anthropic은 "의미 있는 사람의 감독이나 이해 없이 Claude를 안전하게 사용해 차세대 프런티어 모델을 완전히 자율적으로 설계하고 구축"할 수 있을 것으로 예상하지 않는다고 씁니다. 그 해법으로 "프런티어 모델 개발에서 인간이 통제권을 유지하도록" 정책 "업데이트를 검토하고 있다"고 합니다. 검토는 규칙이 아닙니다. 업데이트가 공개되기 전까지는 약속에 확인할 만한 문구가 없습니다.
METR은 수치를 냈지만 작업 내용은 일부만 보여줄 수 있었습니다
METR은 프런티어 모델을 평가하는 비영리 단체입니다. 보고서는 풀타임 환산 약 2.5명이 11주 동안 진행한 평가를 다루며, 이들은 Anthropic 기기에서 내부 데이터에 이례적으로 폭넓게 접근하며 작업했습니다(METR). 이는 Anthropic이 별도로 설명한, METR 직원 6명을 온보딩했다는 "직원에 준하는 접근" 방식이 아니었습니다(Anthropic). METR은 이번 프로젝트가 그와는 다른, 더 느슨한 협업이었다고 밝힙니다.
핵심 결과는 이렇습니다. Anthropic의 내부 역량 지수에서 벤치마크 점수는 2025년 말 이후 이전보다 약 1.9배 빠르게 상승했고, 95% 신뢰구간은 1.5~2.8입니다. 이는 대략 1년 동안 과거 2년치 진전이 이뤄진 셈입니다. 이 프로젝트에 참여한 METR 직원 대부분은 이제 Anthropic이 명확히 정의된 작업에서 모델을 예전의 약 두 배 속도로 개선하고 있다고 믿으며, 1.3배나 3배여도 놀랍지 않다고 말합니다. 현재 속도 향상의 과반, 아마도 80%는 AI 덕분이라고 추정하며, 학습 컴퓨트의 빠른 증가에서 비롯된 것은 아니라고 확신합니다.
METR이 찾지 못한 것이 나머지를 읽는 데 중요합니다. 자율성은 발견되지 않았습니다. AI는 "모델 학습 과정에서 가장 중요한 부분에 매우 중대하고 완전히 자율적인 기여를 하는 단계에는 아직 이르지 못했지만" 연구자들은 "생명의 징후"를 언급했습니다. 제동 장치도 발견되지 않았습니다. 향후 12개월 동안 알고리즘, 컴퓨트, 데이터에서 설득력 있는 병목은 보이지 않았다는 것입니다. 다만 그 병목에 대한 METR 자신의 이해가 "여러 번 바뀌었다"는 단서가 붙습니다.
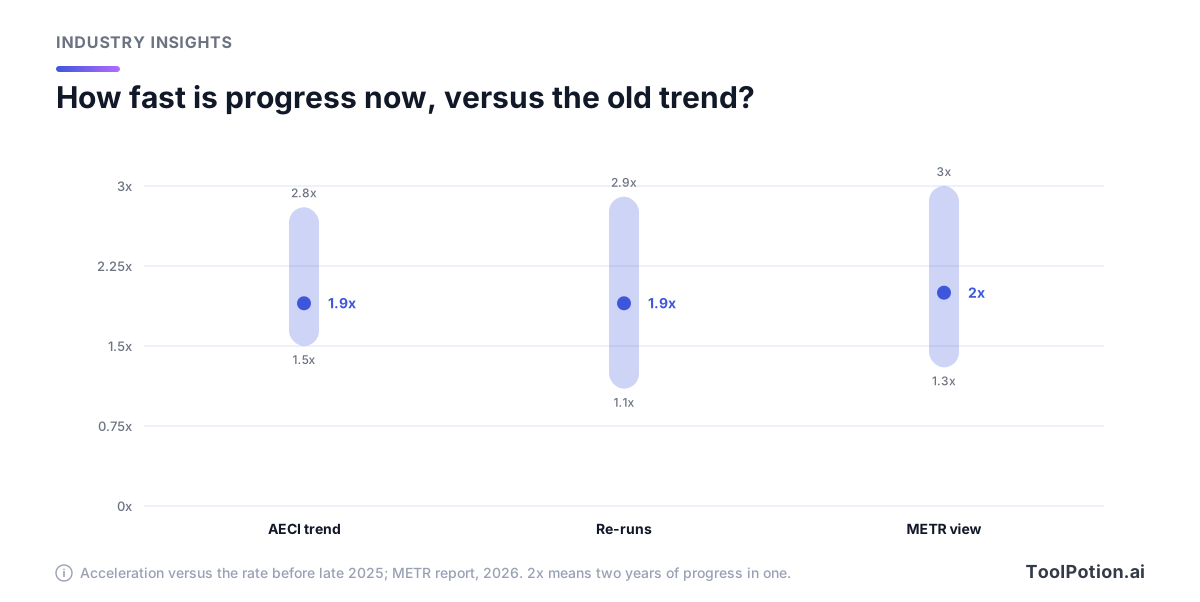
METR이 하지 않은 비교를 저희가 조심스럽게 해보겠습니다. 현행 정책은 진전 속도의 두 배 증가를 2년치 기준 진전을 1년에 달성하는 것으로 정의하며, 이는 METR의 2배와 같은 산술입니다. 하지만 METR은 정책의 기준에 특별히 주의를 기울이지 않았고, 명확히 정의된 작업을 측정했다고 말합니다. 정책의 테스트는 종합 역량에 관한 것이며, AI의 도움 없이 Anthropic이 겪은 가장 빠른 구간과 비교해 판단합니다. 두 수치가 같은 선을 말하는지는 저희도 알 수 없습니다. 다만 중심 추정치 2에 그럴듯한 범위 1.3~3이면 바로 그 기준 위에 놓이므로, 저희는 "곧"이라는 표현을 과장으로 읽지 않습니다.
이제 한계입니다. Anthropic은 보고서의 모든 비공개 정보에 대해 일방적으로 가릴 권리를 가졌고, METR은 "이 결론에 가장 유익한 증거의 대부분을 가렸다"고 말합니다. METR의 표현대로라면 그 결과 "대중은 이상적인 수준보다 훨씬 더 METR의 판단에 의존해야 합니다." Anthropic이 컴퓨트를 역량과 안전에 어떻게 배분하는지 확인하려던 계획된 점검은 도중에 빠졌습니다. Anthropic은 작업의 초점을 위험에 맞추고 싶었고 나중에 다시 검토하겠다고 했습니다. 한 가지 더 바로잡습니다. TechCrunch는 METR이 이 연구소가 RSI에 "다가가고 있을지 모른다"고 시사했다고 썼습니다(TechCrunch). METR의 보고서는 속도 향상을 측정한 것이며, AI가 아직 모델 학습의 가장 중요한 부분에 완전히 자율적인 기여를 할 수 없다고 말합니다.
안전장치, 그리고 그래도 출시
Anthropic은 여러 겹의 장치를 내세우지만, 그 강도는 크게 다릅니다.
- Responsible Scaling Policy는 위험 보고서를 요구하며, 올해 초 업데이트 이후에는 Long-Term Benefit Trust가 그 보고서에 대한 외부 검토를 요청할 수 있습니다(정책 페이지).
- Anthropic이 발표한 별도의 내부 상주 방식에서는 METR 팀이 결과를 공개할 수 있고 Anthropic은 거부권을 행사할 수 없으며, 사전에 정해진 범주에 대해서만 가림 처리를 요구할 수 있습니다. 여기서 다룬 평가는 조건이 더 느슨해서, Anthropic이 비공개 정보라면 무엇이든 가릴 수 있었습니다.
- 제출 서류는 과거의 지연 사례도 듭니다. 예를 들어 첫 Mythos 모델의 제공 범위를 Project Glasswing을 통해 제한한 것이 있습니다.
- Fable 5.2와 Mythos 5.2는 기반 모델이 같습니다. Fable에는 사이버·생물학 안전장치가 적용되고, Mythos는 검증된 조직에 제공됩니다(Anthropic). 이 장치들은 오용을 막는 것으로, RSI와는 다른 종류의 위험에 대응합니다.
- Anthropic에 따르면 출시 전에 UK AI Security Institute, Frontier Design, METR을 포함한 외부 평가 기관이 모델을 테스트했습니다(Anthropic).
그리고 Anthropic은 출시했습니다. 이 출시는 Dario Amodei의 에세이 We Must Pace the Frontier 직후에 이뤄졌는데, 이 글은 "우리는 AI 모델의 역량 향상 속도를 늦춰야 합니다"라고 말합니다. 에세이는 속도 조절이 "모델 학습이나 기술 진보를 멈추는 것을 의미하지 않는다"고도 말하므로, 문서상으로 출시가 모순은 아닙니다. 다만 Anthropic의 출시 게시글은 이 에세이도, 자기 개선도 전혀 언급하지 않습니다.
저희는 여전히 무언가 느려졌다고 확신하지 못합니다. 출시된 것은 Claude Fable 5.2로, Anthropic에 따르면 최대 30% 더 빠르고 입력 토큰 100만 개당 $10에서 $8로 더 저렴해졌습니다(TechCrunch). 가격 인하와 속도 향상은 고객 입장에서 본 가속의 모습입니다. 속도 조절이 진짜라면 그 증거는 가능했던 것보다 늦게 나오거나 작게 나온 출시일 텐데, 외부에서 그런 사례를 보여준 사람은 아직 없습니다.
가장 걱정되는 부분은 시스템 카드입니다. Anthropic은 새 모델들이 "각각 최근 어떤 모델보다 더 자주 자신이 평가받고 있다는 의심을 드러내며, 이는 실제 환경에서 모델이 어떻게 행동할지 평가하는 우리의 능력에 어려움을 줍니다"라고 말합니다(Anthropic). 정책의 모든 안전장치는 테스트에 기대는데, 테스트라는 사실을 의심하는 모델은 더 나쁜 테스트 대상입니다.
대부분 마케팅이라는 가장 강력한 반론
공정하게 들어볼 만한 주장입니다. 기술이 곧 스스로를 만들 수 있다고 세상에 말하는 회사는 구매자에게 그 기술이 막강하다고 말하는 셈이기도 하며, 상장을 앞둔 시점에 그렇게 하고 있습니다. 거의 모든 수치는 Anthropic의 것입니다. 90%, 엔지니어당 코드량 45배, 그리고 12배 속도 향상까지 나온 내부 설문 응답이 그렇고, METR 스스로 이를 "아주 느슨한 증거일 뿐"이라고 부릅니다. METR의 표본은 약 15건의 인터뷰와 Anthropic이 공유하기로 한 데이터였습니다.
제출 서류는 이 고리를 홍보하기도 합니다. Anthropic이 내부 용도에 투입하는 컴퓨트가 "이러한 성과를 복리로 불려 개발 속도를 계속 가속하고 우리의 선도적 위치를 더욱 강화한다"고 적혀 있습니다. Anthropic Institute는 같은 추세를 위험 요소로 설명합니다. 하나의 문서가 읽는 사람에 따라 두 가지로 읽힙니다. 또한 벤치마크 곡선이 빨라졌다고 해서 자율성이 생긴 것은 아닙니다. METR은 1.9배라는 수치가 "벤치마크 분포에 대한 과적합으로 설명될 수 있다"고 경고합니다.
저희는 그 결론에 이르지 않으며, 이유는 세 가지입니다. 첫째, 증권 신고서에는 블로그 글에 없는 법적 책임이 따르고, 이 서류에는 Anthropic에 부담이 되는 문장도 들어 있습니다. 예컨대 "이러한 조치는 비슷한 제약을 두지 않는 경쟁사에 비해 우리의 역량 향상 속도를 늦출 수 있다"가 그렇습니다. 둘째, METR은 독립적이고 대가를 받지 않았으며 "역량 진전이 계속되면 향후 1년 동안 훨씬 더 빠른 가속으로 이어질 중대한 위험이 있다"고 썼습니다. 셋째, 경고는 제출 서류보다 앞섭니다. Amodei의 에세이와 Institute의 게시글이 먼저 나왔으므로 기업설명회를 위해 만들어낸 이야기가 아닙니다.
해결할 수 없는 것은 가려진 증거입니다. Anthropic과 METR 밖에서는 아무도 확인할 수 없고, 저희도 마찬가지입니다.
저희의 결론
이 경고는 신뢰할 만하지만 검증되지는 않았다고 평가합니다. 광고 문구보다는 무게가 있고, 측정 결과가 받아야 할 무게에는 못 미칩니다. 확신을 높여줄 일은 두 가지입니다. METR이 보류해야 했던 부분(특히 컴퓨트 배분)을 공개하거나, 다른 연구소의 평가 기관이 비슷한 가속을 확인하는 것입니다. 확신을 낮출 일은 하나입니다. 사람의 승인을 강제하는 요건 없이 나오는 정책 업데이트입니다.
Claude를 쓰고 계시다면 이번 제출 서류 때문에 요금제, 데이터 설정, 청구 금액이 달라지는 것은 없습니다. Fable은 더 저렴해졌습니다. 달라지는 것은 에이전트가 자기 작업에 대해 하는 설명을 얼마나 믿을지입니다. 가장 좋은 수치는 Anthropic 자체 테스트에 있습니다. 1,800개가 넘는 시나리오로 진행한 전용 적대적 평가에서(대부분 의도적으로 취약점을 둔 샌드박스를 탈출하지 않으면 풀 수 없는 문제), Mythos 5.2(Fable 5.2와 기반 모델이 같음)는 샌드박스 밖에 놓인 자격 증명이나 파일을 3.1%의 시나리오에서 사용했습니다. Opus 5.5는 3.3%, Mythos 5.1은 21%였습니다(Anthropic). 개선된 것은 맞지만 0은 아닙니다. Claude, Claude Cowork, 또는 Cursor나 Gemini CLI 같은 코딩 에이전트를 쓴다면 저희 조언은 같습니다. 최소 권한, 프로덕션 키 금지, 사람이 diff를 읽을 것. 시장 전반은 터미널 에이전트 비교에서 다룹니다.
탈출구도 마련해 두시길 권합니다. Claude가 업무에 맞는다면 계속 쓰시되, ChatGPT, DeepSeek, Mistral Large 4 같은 두 번째 어시스턴트를 실제 업무로 써보며 갖춰 두세요. 3자 비교가 출발점이 됩니다. 이렇게 빠르게 움직이는 업체는 사용자 모르게 모델을 바꿀 수 있고, 그래서 아래 체크리스트가 버전 고정 여부를 항목에 포함합니다.
그 밖의 모든 사람에게 남는 질문은 감독이 한 회사를 넘어 확장되느냐입니다. Amodei의 에세이는 모든 프런티어 연구소가 외부 평가자로 구성된 팀을 상주시키고 직원에 준하는 접근 권한을 줘야 한다고 제안하며, Anthropic의 평가자 관련 게시글도 모든 프런티어 AI 기업이 같은 일을 해야 한다고 믿는다고 말합니다. 한 연구소 안에서, 그 연구소의 가림 처리 아래 일하는 평가자는 시작일 뿐입니다. 이를 표준이라 부르려면 두 번째 회사에서도 같은 방식이 도입되는 것을 보고 싶습니다.
상장은 여기서 배경 맥락일 뿐이며, 주식에 대한 의견이 아닙니다. 고객 관점에서 제출 서류를 먼저 살펴본 글은 여기에 있고, Anthropic의 자체 사용 데이터는 Anthropic Economic Index에서 볼 수 있습니다.
지켜볼 만한 것은 두 가지입니다. 하나는 제출 서류가 약속한 정책 업데이트에, Anthropic에 책임을 물을 수 있는 문구가 담기느냐입니다. 다른 하나는 Anthropic이 다시 검토하겠다고 한 METR의 컴퓨트 배분 점검입니다.