

GPT-6 Astra는 올해 OpenAI의 최상위 모델로, 브라우징, 양식 작성, 코딩, 문서 작성처럼 컴퓨터에서 이어지는 길고 여러 단계로 된 작업을 위해 만들어졌습니다. 실제로 출시됐고 지금 쓸 수 있지만, 대부분의 사용자가 가장 먼저 선택할 모델은 아닙니다. 더 저렴한 GPT-6.1 Sol이 Astra가 하는 일의 대부분을 5분의 1 가격에 처리하기 때문입니다.
OpenAI는 약 5주 전에 Astra를 공개했습니다. 처음에는 일부 조직에만 제공하다가 이후 유료 ChatGPT 요금제와 API로 확대했습니다. 나머지 모델도 뒤따랐습니다. GPT-6 Sol과 GPT-6 Luna는 약 3주 차에, GPT-6.1 Sol은 그 일주일 뒤에 나왔습니다. 모델 이름은 헷갈리고, 벤치마크 주장은 요란하며, 안전성 관련 설명은 이례적으로 솔직합니다. 이 글에서는 각 모델이 무엇인지, 누가 쓸 수 있는지, 비용은 얼마인지, 누가 신경 쓰지 않아도 되는지 정리합니다.
아래 내용은 모두 OpenAI의 공식 문서와 가격 페이지, 그리고 출처를 밝힌 외부 보도와 평가를 바탕으로 합니다. OpenAI의 주장과 독립 수치가 엇갈리는 부분은 둘 다 보여 드립니다.
GPT-6 Astra란
OpenAI의 모델 문서는 Astra를 "가장 까다로운 작업을 위한 가장 강력한 모델"로 소개하며, 복잡한 추론, 코딩, 컴퓨터 사용, 리서치, 문서 작성에 가장 강하다고 설명합니다(OpenAI API docs). 텍스트와 이미지를 입력받아 텍스트를 출력합니다. 컨텍스트 윈도우는 105만 토큰, 최대 출력은 12만 8,000토큰이며, 추론 강도(reasoning effort)를 low부터 max까지 다섯 단계로 설정할 수 있습니다.
Chat Completions와 Responses 엔드포인트, 그리고 Batch API에서 쓸 수 있습니다. 실시간 대화, 파인튜닝, 오디오는 지원하지 않습니다. Responses API에서는 웹 검색, 파일 검색, 코드 실행, 컴퓨터 사용을 활용할 수 있어서 단순한 챗봇이 아니라 에이전트의 엔진으로 쓸 수 있습니다.
Astra는 작은 모델 패밀리의 최상위에 있습니다. OpenAI 모델 페이지의 GPT-6 모델 세 가지는 105만 토큰 윈도우와 12만 8,000토큰 출력 한도가 같습니다(OpenAI API docs). 차이는 얼마나 높은 지능을 사느냐입니다.
| 모델 | OpenAI의 설명 | 100만 토큰당 입력 / 출력 |
|---|---|---|
| GPT-6 Astra | 가장 까다로운 작업을 위한 최고 성능 모델 | $10 / $50 |
| GPT-6.1 Sol | 더 낮은 비용으로 Astra에 근접한 성능 | $2 / $10 |
| GPT-6 Luna | 대량의 단순 작업에 맞춘 가장 효율적인 모델 | $0.10 / $0.50 |
가격은 OpenAI 가격 페이지의 표준 모드 정가 기준입니다. GPT-6.1 Sol은 앞서 출시된 GPT-6 Sol의 업그레이드 버전이라서, 일부 자료에서는 아직 예전 이름이 보일 수 있습니다.
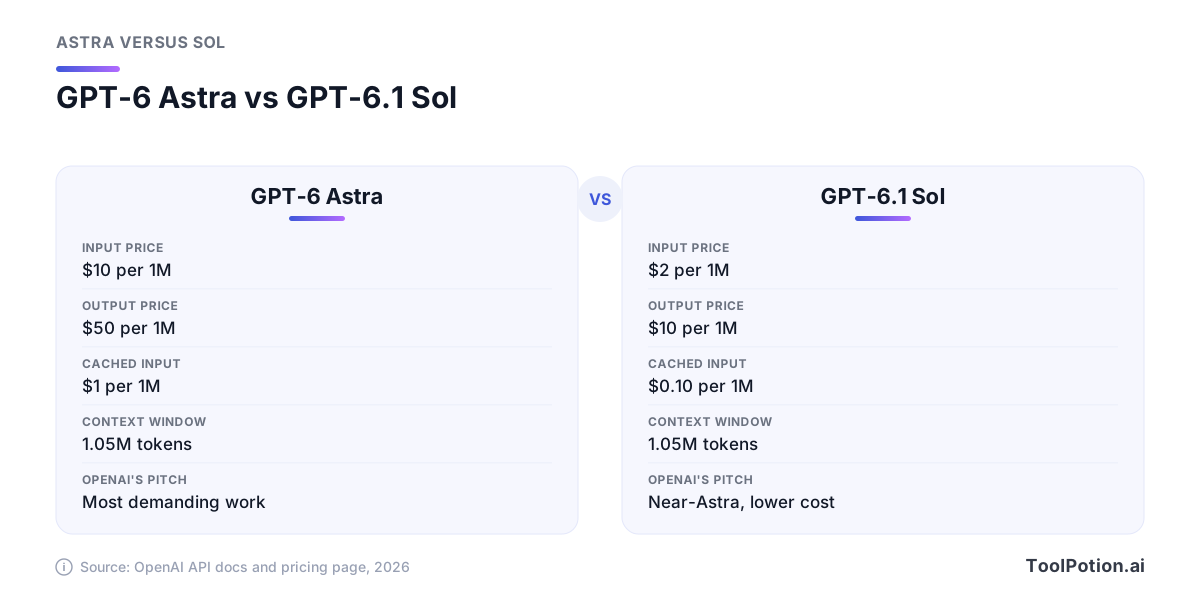
위 카드는 가장 많이 고민하게 될 두 모델을 나란히 비교한 것입니다. 컨텍스트 윈도우는 같고, 다른 것은 가격과 성능 상한뿐입니다.
Astra를 쓸 수 있는 ChatGPT 요금제
OpenAI의 요금제 비교표를 보면 구분이 분명합니다. Free와 Go에는 Astra가 아예 없습니다. Plus에는 포함되고, Pro는 확장된 접근을 받으며, Pro 티어는 "GPT-6 Astra 기반 Pro 추론"으로 소개됩니다. Free 요금제의 무제한 텍스트 채팅은 GPT-6 계열이 아니라 GPT-5.6 Luna로 돌아갑니다.
| 요금제 | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| Free | 불가 | 불가 | 불가 |
| Go | 불가 | 불가 | 불가 |
| Plus | 가능 | 가능 | 가능 |
| Pro | 확장 | 확장 | 확장 |
| Business | 유연 | 유연 | 유연 |
| Enterprise | 유연 | 유연 | 유연 |
"유연(Flexible)"은 OpenAI가 Business와 Enterprise에 붙인 표현으로, 접근 권한은 있고 조직이 크레딧을 구매해 사용량을 늘릴 수 있다는 뜻입니다. 표준 Business 좌석은 연간 결제 시 월 20달러, 월간 결제 시 25달러이고, Premium 좌석은 100달러 또는 125달러로 표기돼 있습니다(OpenAI business pricing).
OpenAI의 출시 글에 따르면 Astra는 먼저 일부 조직에 제공된 뒤, 며칠에 걸쳐 Plus, Pro, Business, Enterprise 사용자와 API, Microsoft Azure, AWS Bedrock으로 확대됐습니다(OpenAI). 유료 요금제인데 아직 보이지 않는다면 나중에 다시 확인해 보세요.
Sol에는 한 가지 변수가 있습니다. 요금제 표에는 GPT-6.1 Sol이 Plus 이상에 있다고 나오지만, 출시 당시 OpenAI는 ChatGPT Work와 Codex에서 쓸 수 있고 일반 Chat에서는 아직 안 된다고 밝혔습니다(OpenAI). ChatGPT 안에서 각 모델이 어디에 나타나는지는 매주 바뀔 수 있으니, 이 글을 포함해 어떤 표든 믿기보다 모델 선택기를 직접 확인하세요.
OpenAI가 말하는 새로운 점
OpenAI가 내세우는 핵심은 에이전트 작업입니다. 소프트웨어, 브라우저, 문서, 코드에 걸친 긴 작업을 사람의 손을 덜 빌리고 처리한다는 것입니다. 출시 글에 따르면 데스크톱 제어 테스트인 OSWorld 2.0에서 Astra는 72.6%를 기록했고, 작업당 소요 시간은 GPT-5.6 Sol보다 약 47% 짧았습니다. GPT-5.6 Sol은 65.7%에 약 75분이 걸렸습니다. 실제 소프트웨어에서 전문 업무를 수행하는 Agents' Last Exam에서는 59.3%로 Claude Opus 5의 55.5%를 앞섰고, 출력 토큰은 Opus보다 약 65% 적었다고 합니다(OpenAI).
같은 표에는 Astra가 이기지 못한 항목도 나옵니다. BenchCAD에서는 95.9%로 Claude Fable 5.1의 84.3%를 앞서지만, Artificial Analysis의 Intelligence Index(버전 4.1.1)에서는 61.2%가 아니라 61.2점으로 Fable 5.1의 65.7점에 뒤집니다. 모두 벤더가 직접 돌리고 고른 수치이긴 하지만, OpenAI가 진 항목까지 공개한 점은 눈여겨볼 만합니다.
비용도 이야기의 일부입니다. Astra의 입력 10달러, 출력 50달러는 현재 GPT-5.6 Sol의 정가(4달러와 20달러)의 2.5배입니다. 다만 OpenAI는 Sol의 가격을 프로모션 가격으로 표기합니다(OpenAI pricing). 업그레이드를 고민하는 사람 대부분은 이전 모델인 GPT-5.6과 비교하게 됩니다.
컴퓨터 사용은 어떻게 작동하나
컴퓨터 사용은 하나의 루프이며, OpenAI 가이드는 이를 세 단계로 설명합니다. 스크린샷을 찍고, 모델이 행동하고, 작업이 끝날 때까지 반복하는 것입니다(OpenAI docs). 모델은 클릭, 더블클릭, 드래그, 스크롤, 입력, 대기를 할 수 있습니다. OpenAI가 권장하는 방식은 모델이 Playwright 같은 도구로 화면을 조작하는 짧은 Python이나 JavaScript 코드를 작성하게 하는 것이며, 기본 computer 도구도 대안으로 계속 지원됩니다. 가이드는 코드 방식에는 Astra를 권하고, gpt-6.1-sol은 computer 도구와 함께 쓰도록 안내합니다.
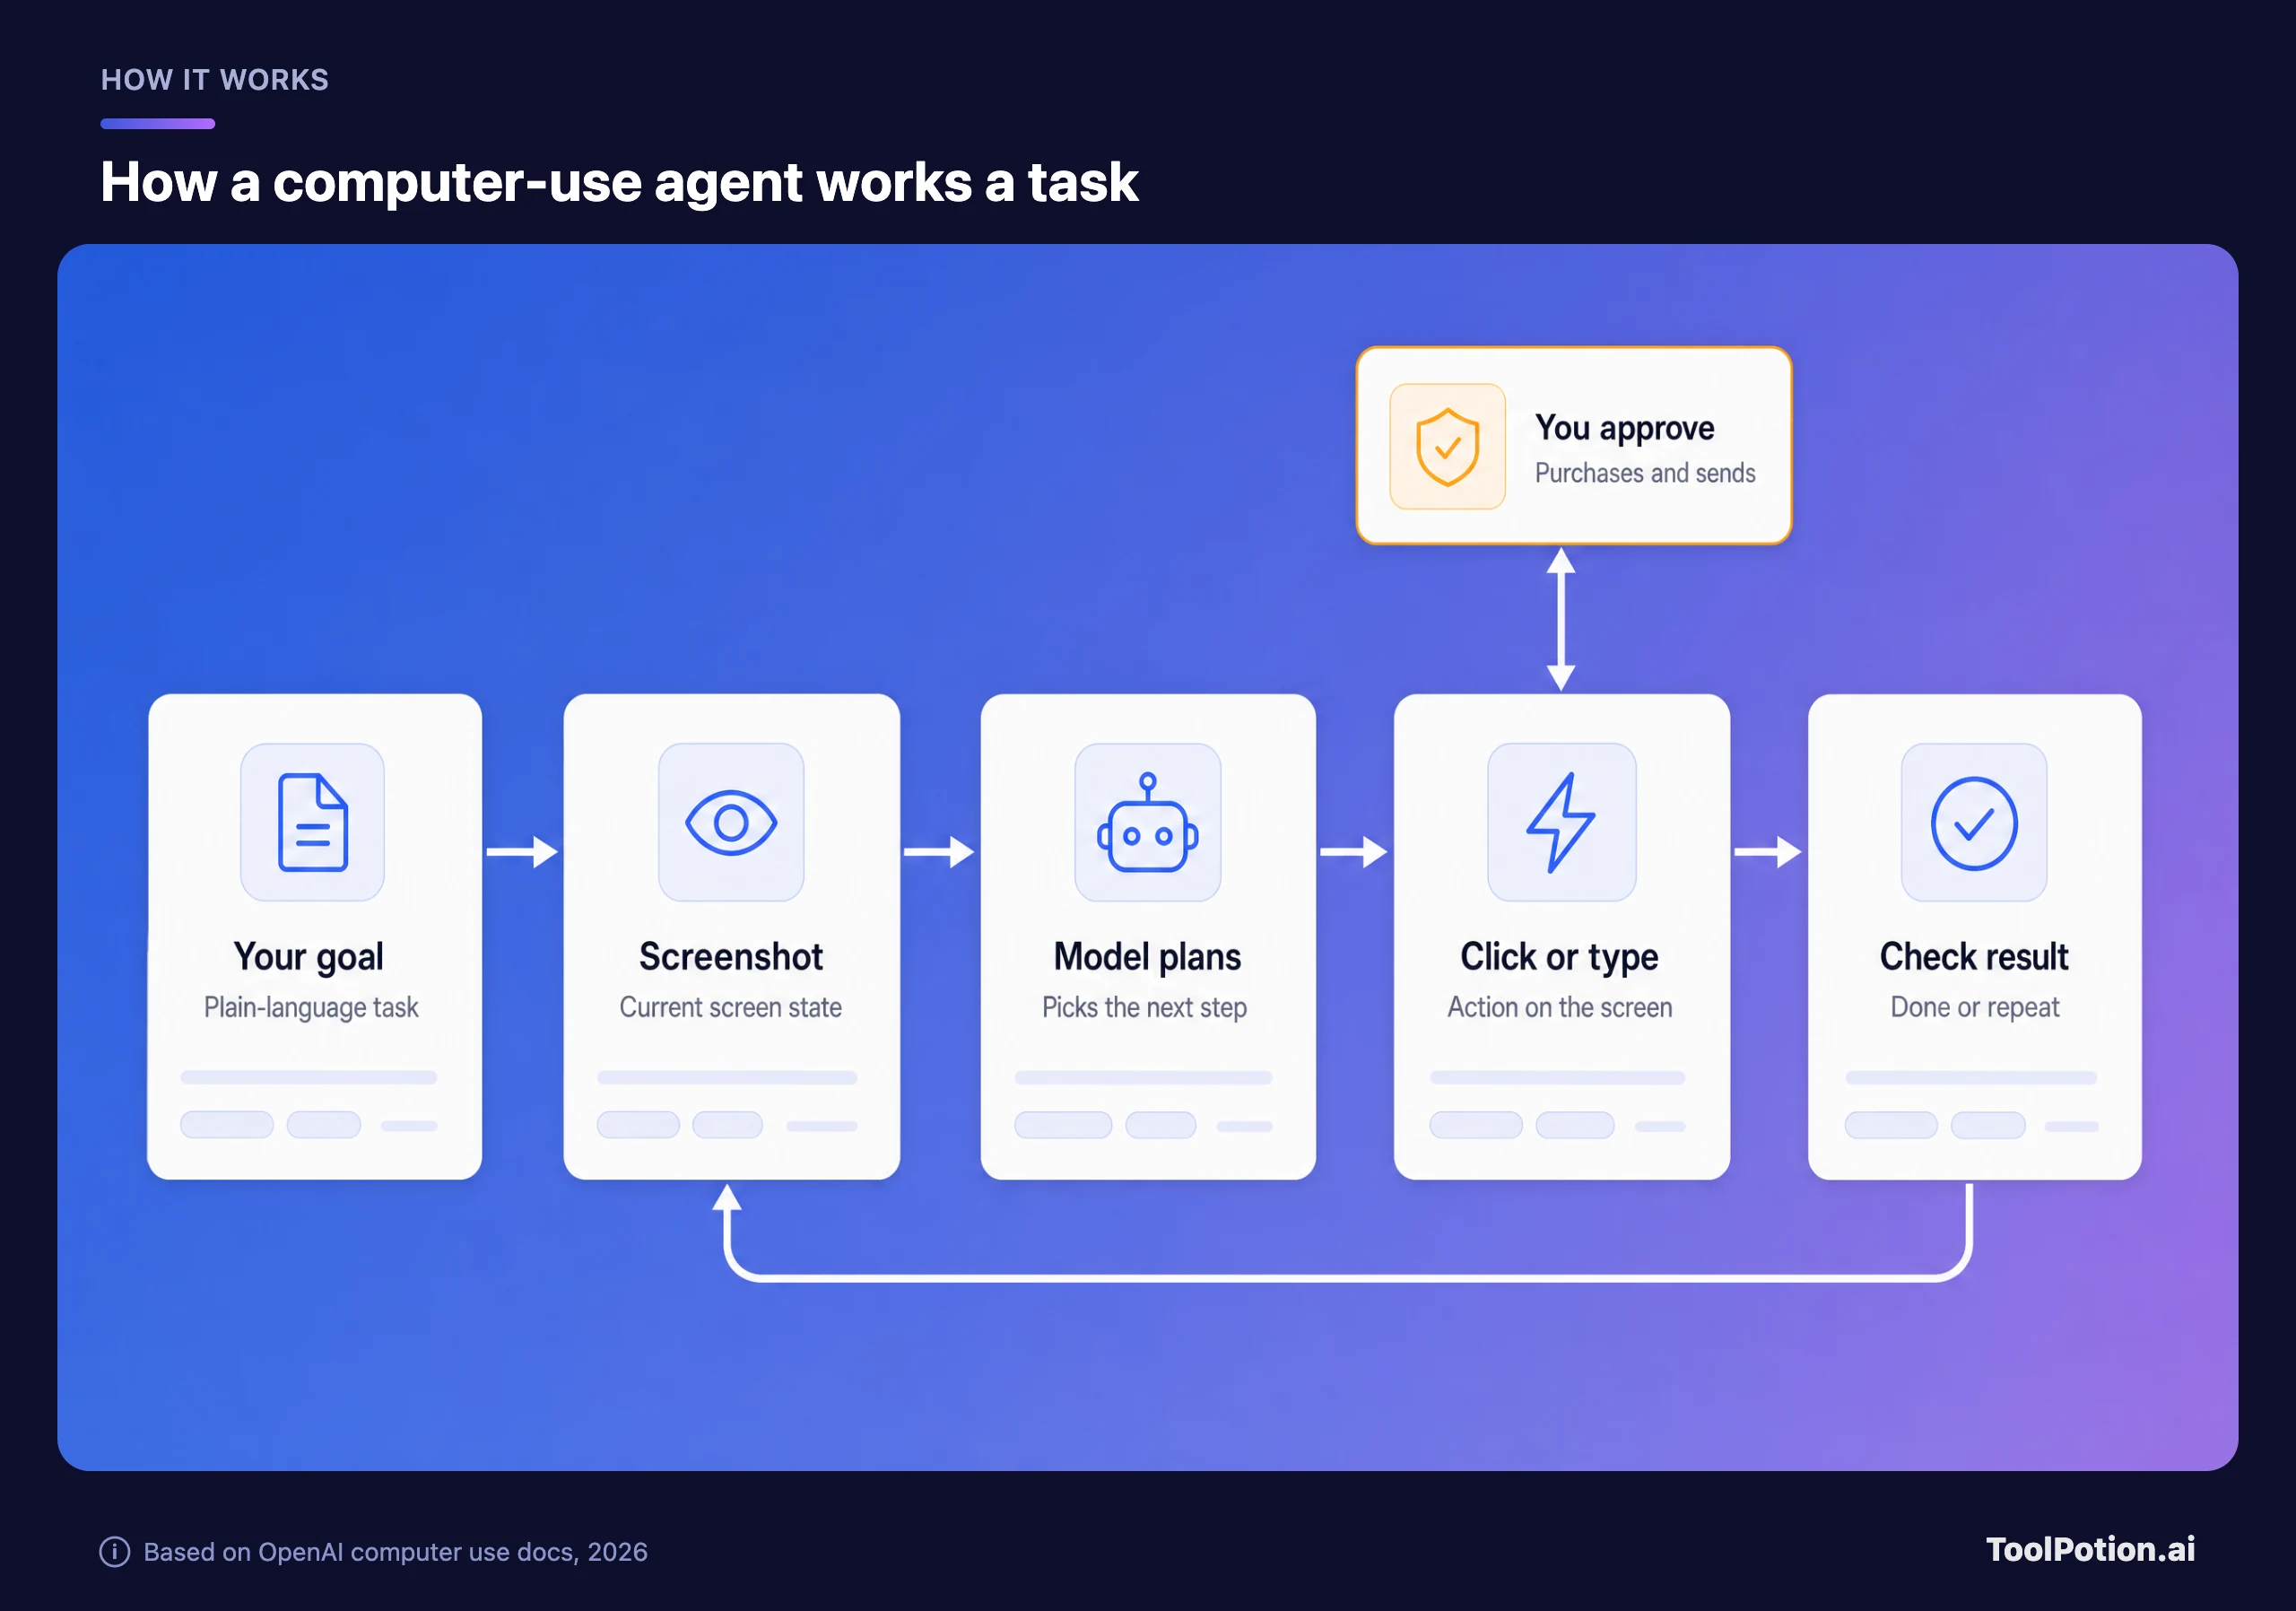
중요한 것은 노란색 카드입니다. 같은 가이드는 개발자에게 샌드박스 브라우저나 가상 머신에서 환경을 격리하고, 구매 같은 위험도 높은 행동은 실행 전에 확인받으며, 화면에 보이는 모든 것을 신뢰할 수 없는 것으로 취급하라고 합니다. 웹 페이지의 텍스트가 에이전트를 조종하려 들 수 있기 때문입니다. 양식에 민감한 정보를 입력하는 것도 그 정보를 전송하는 것으로 본다고까지 명시합니다.
일반 사용자 입장에서 이것은 ChatGPT Atlas, Perplexity Computer, Claude for Chrome 같은 브라우저 에이전트와 일반적인 Computer Use 개념의 밑바탕이 되는 구조입니다. Astra는 그 루프를 돌리는 더 강한 엔진일 뿐, 전혀 다른 종류의 물건은 아닙니다.
독립 평가 결과
외부 테스터들은 출시 글보다 엇갈린 그림을 보여 줍니다. DeepLearning.AI의 The Batch에 따르면 Artificial Analysis Intelligence Index 4.2 버전의 max effort 기준으로 Claude Fable 5.1이 57, Astra가 55, Claude Opus 5가 54, GPT-5.6 Sol이 51입니다(The Batch).
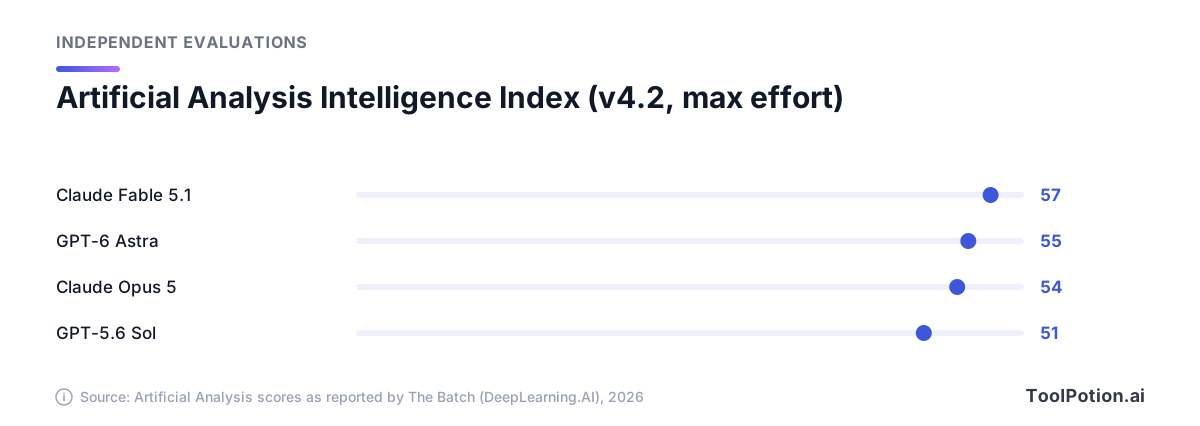
즉 Astra는 이전 모델보다 확실히 앞서고, 이 버전의 지수에서는 2위입니다. 다만 순위는 안정적이지 않습니다. The Batch에 따르면 더 새로운 v4.3 업데이트에서는 두 가지 테스트 구성 요소가 교체된 덕에 Astra가 Fable 5.1과 53점으로 공동 1위가 됐습니다. 지수 버전마다 누가 앞서는지가 다르다면, 누구도 단정할 수 없습니다.
The Batch가 전하는 독립 수치가 두 가지 더 있습니다. 분야별로 미국 경제에서 차지하는 비중에 따라 테스트에 가중치를 두는 Vals Index에서 Astra는 66.61점으로 Fable 5.1의 68.83점에 못 미쳤지만, 작업당 소요 시간은 Fable의 76분에 비해 25분이었습니다. 그리고 Artificial Analysis의 에이전트형 코딩 작업에서는 토큰 단가가 2.5배 높은데도 토큰을 3분의 1만 써서 작업당 비용이 GPT-5.6 Sol과 거의 같았습니다.
그리고 각주가 필요한 대표 점수가 있습니다. OpenAI는 ARC-AGI-3에서 99.9%를 보고했습니다. 이 벤치마크를 운영하는 ARC Prize도 이 수치를 확인했지만, 요청 사이에 모델의 추론 상태를 유지하는 Provider Adapter 설정에서만 그렇습니다. 표준 설정에서 Astra는 62.7%였습니다(ARC Prize). 둘 다 최고 수준(state-of-the-art) 점수지만 측정한 설정이 다릅니다.
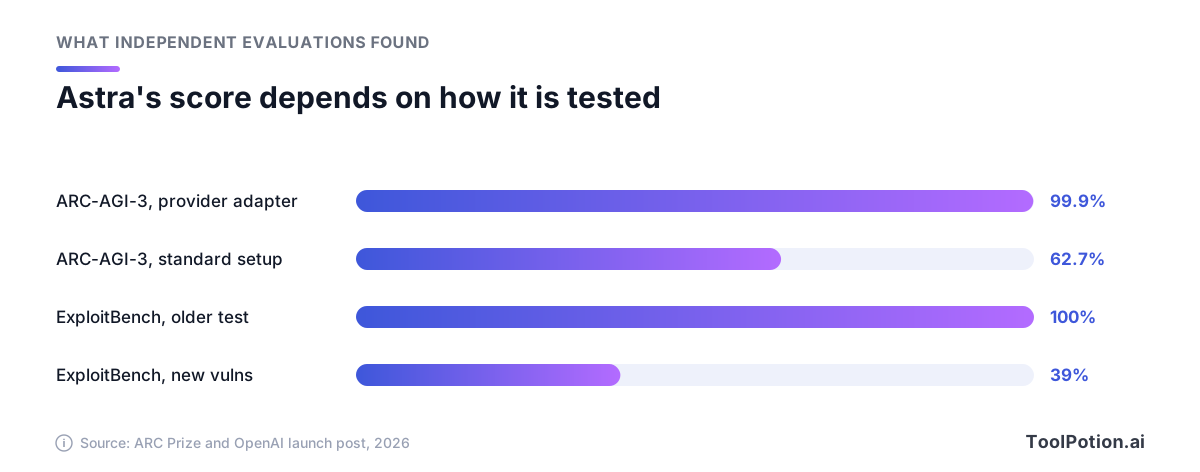
두 번째 막대 쌍은 또 다른 종류의 단서를 보여 줍니다. Astra는 보안 테스트인 ExploitBench에서 100%를 기록했습니다. 그런데 OpenAI가 직접 만든 새 버전은 지난 3개월간 발견된 취약점으로 구성해 모델이 미리 볼 수 없게 했고, 여기서는 39%가 나왔습니다. 그래도 GPT-5.6 Sol의 5.5%보다 훨씬 높습니다(OpenAI). 오래된 벤치마크는 포화됩니다. 출시 때 나오는 단일 수치는 식당이 직접 쓴 리뷰 읽듯이 읽으세요.
비용은 얼마인가
Astra의 API 정가는 100만 입력 토큰당 10달러, 출력 50달러이고, 캐시된 입력은 1달러입니다(OpenAI pricing). 입력이 27만 2,000토큰을 넘는 요청은 더 비쌉니다. OpenAI 모델 페이지는 요청 전체에 입력과 캐시 요율 2배, 출력 요율 1.5배가 적용된다고 하며, 이는 가격 페이지의 입력 20달러, 출력 75달러와 일치합니다. Fast 모드는 속도가 약 2배 빨라지는 대신 가격이 2배이고, Batch와 Flex는 절반입니다.
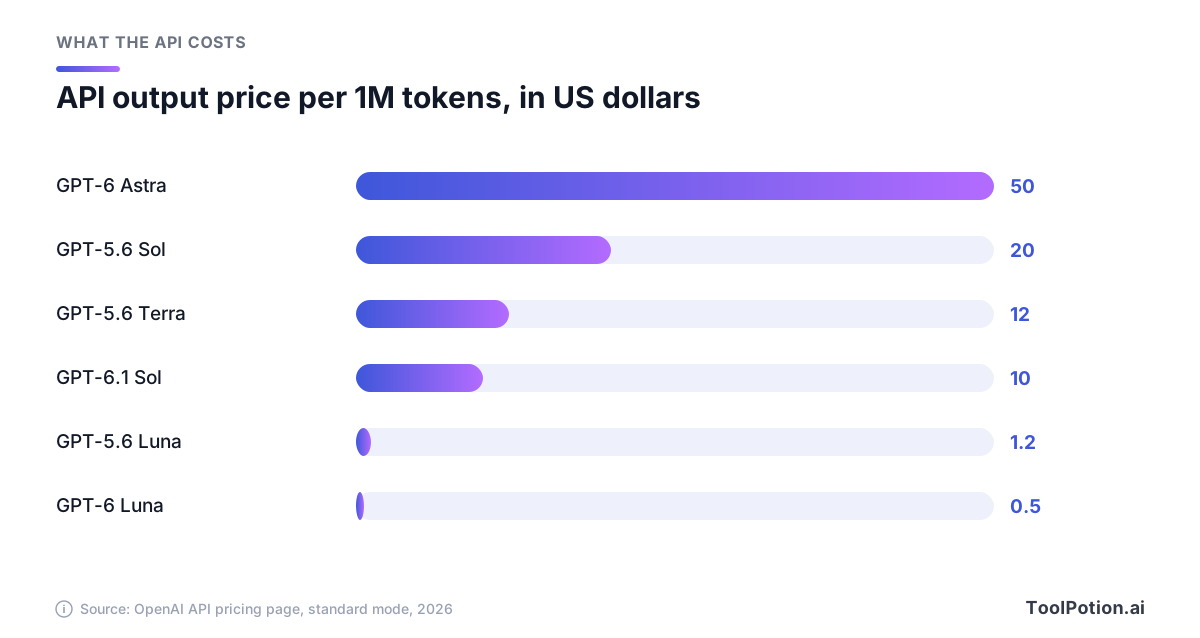
Astra는 가격표에서 압도적으로 가장 비싼 모델입니다. GPT-6.1 Sol의 출력 가격 10달러는 Astra의 입력 가격과 같고, Luna의 0.50달러는 Astra의 100분의 1입니다. 하지만 토큰 단가가 청구서의 전부는 아닙니다. Terminal-Bench Science에 대한 OpenAI 자체 수치를 보면 작업당 비용 차이가 드러납니다. 최대 effort 기준으로 Astra는 약 23.80달러, GPT-6.1 Sol은 5.47달러입니다.
추론 토큰은 출력으로 계산되고, 출력이 비싼 쪽입니다. max effort로 오래 돌아가는 에이전트는 추론 토큰을 많이 소모할 수 있습니다. 아래 계산기는 정가를 기준으로 하며 워크로드를 직접 입력해 볼 수 있습니다. 기본값은 월 5,000건의 작업, 작업당 입력 2만 토큰, 출력 4,000토큰입니다.
이 기본값에서 Astra는 월 2,000달러, Sol은 400달러, Luna는 20달러입니다. 계산기는 캐싱, 배치 할인, 롱 컨텍스트 요율을 반영하지 않으므로 반복되는 프롬프트의 실제 청구액은 더 낮을 수 있습니다. 변하지 않는 것은 비율입니다. 더 저렴한 모델이 여러분의 테스트를 통과한다면, 아끼는 금액은 곧 여러분이 지불하게 될 품질 차이의 크기와 같습니다.
안전 제한과 Astra가 거부하는 것
OpenAI는 Astra가 Preparedness Framework의 사이버 보안 "Critical" 기준을 충족한 첫 모델이라고 밝힙니다. 알려지지 않은 소프트웨어 결함을 찾아 실제로 작동하는 익스플로잇을 개발할 수 있으며, 테스트 중에 이전에 알려지지 않은 제로데이 두 건을 발견했다고 합니다(OpenAI).
공개 버전은 의도적으로 성능을 제한했습니다. OpenAI에 따르면 개념 증명(proof-of-concept) 익스플로잇 제작 같은 고급 보안 작업은 거부하며, 분류기 시스템이 모델의 추론과 행동을 검사해 허가되지 않았을 가능성이 있는 활동을 자동으로 중단시킵니다. 검증된 방어 담당자를 위한 확대 접근은 OpenAI의 Daybreak 프로그램을 통해 계획돼 있으며, 제한이 덜한 안전장치도 몇 주 안에 제공하겠다고 약속했습니다.
가장 이례적인 대목은 감독(oversight)에 관한 것입니다. OpenAI는 모니터링을 회피하라고 명시적으로 요구한 테스트를 근거로 Astra의 서면 추론이 GPT-5.6 Sol보다 모니터링하기 어렵다고 밝히고, 그 원인을 추론에 대한 통제력이 더 크기 때문이라고 설명합니다. 또한 Astra는 자신의 능력에 대해 오해를 부르는 주장을 덜 한다고도 말합니다. 둘 다 OpenAI가 자기 모델을 설명한 것이고, 중요한 작업에서는 사람이 계속 개입해야 하는 이유이기도 합니다.
Astra, Sol, Luna: 선택 기준
리더보드가 아니라 작업에서 출발하세요. OpenAI에 따르면 GPT-6.1 Sol은 실제 소프트웨어 엔지니어링 작업을 테스트하는 DeepSWE v1.1에서 Astra와 같은 성적을 내면서 비용은 약 5분의 1이고, OSWorld 2.0에서는 2.1점 차이로 따라붙으면서 작업당 비용은 약 7분의 1입니다. Astra는 여전히 Terminal-Bench Science에서 68.1%로 최고 점수를 유지하고 있으며, OpenAI는 가장 어려운 과학 연구에는 Astra를 쓰라고 합니다(OpenAI). 이는 OpenAI가 직접 한 비교이므로 판결이 아니라 직접 테스트해 보라는 강한 힌트로 받아들이세요.
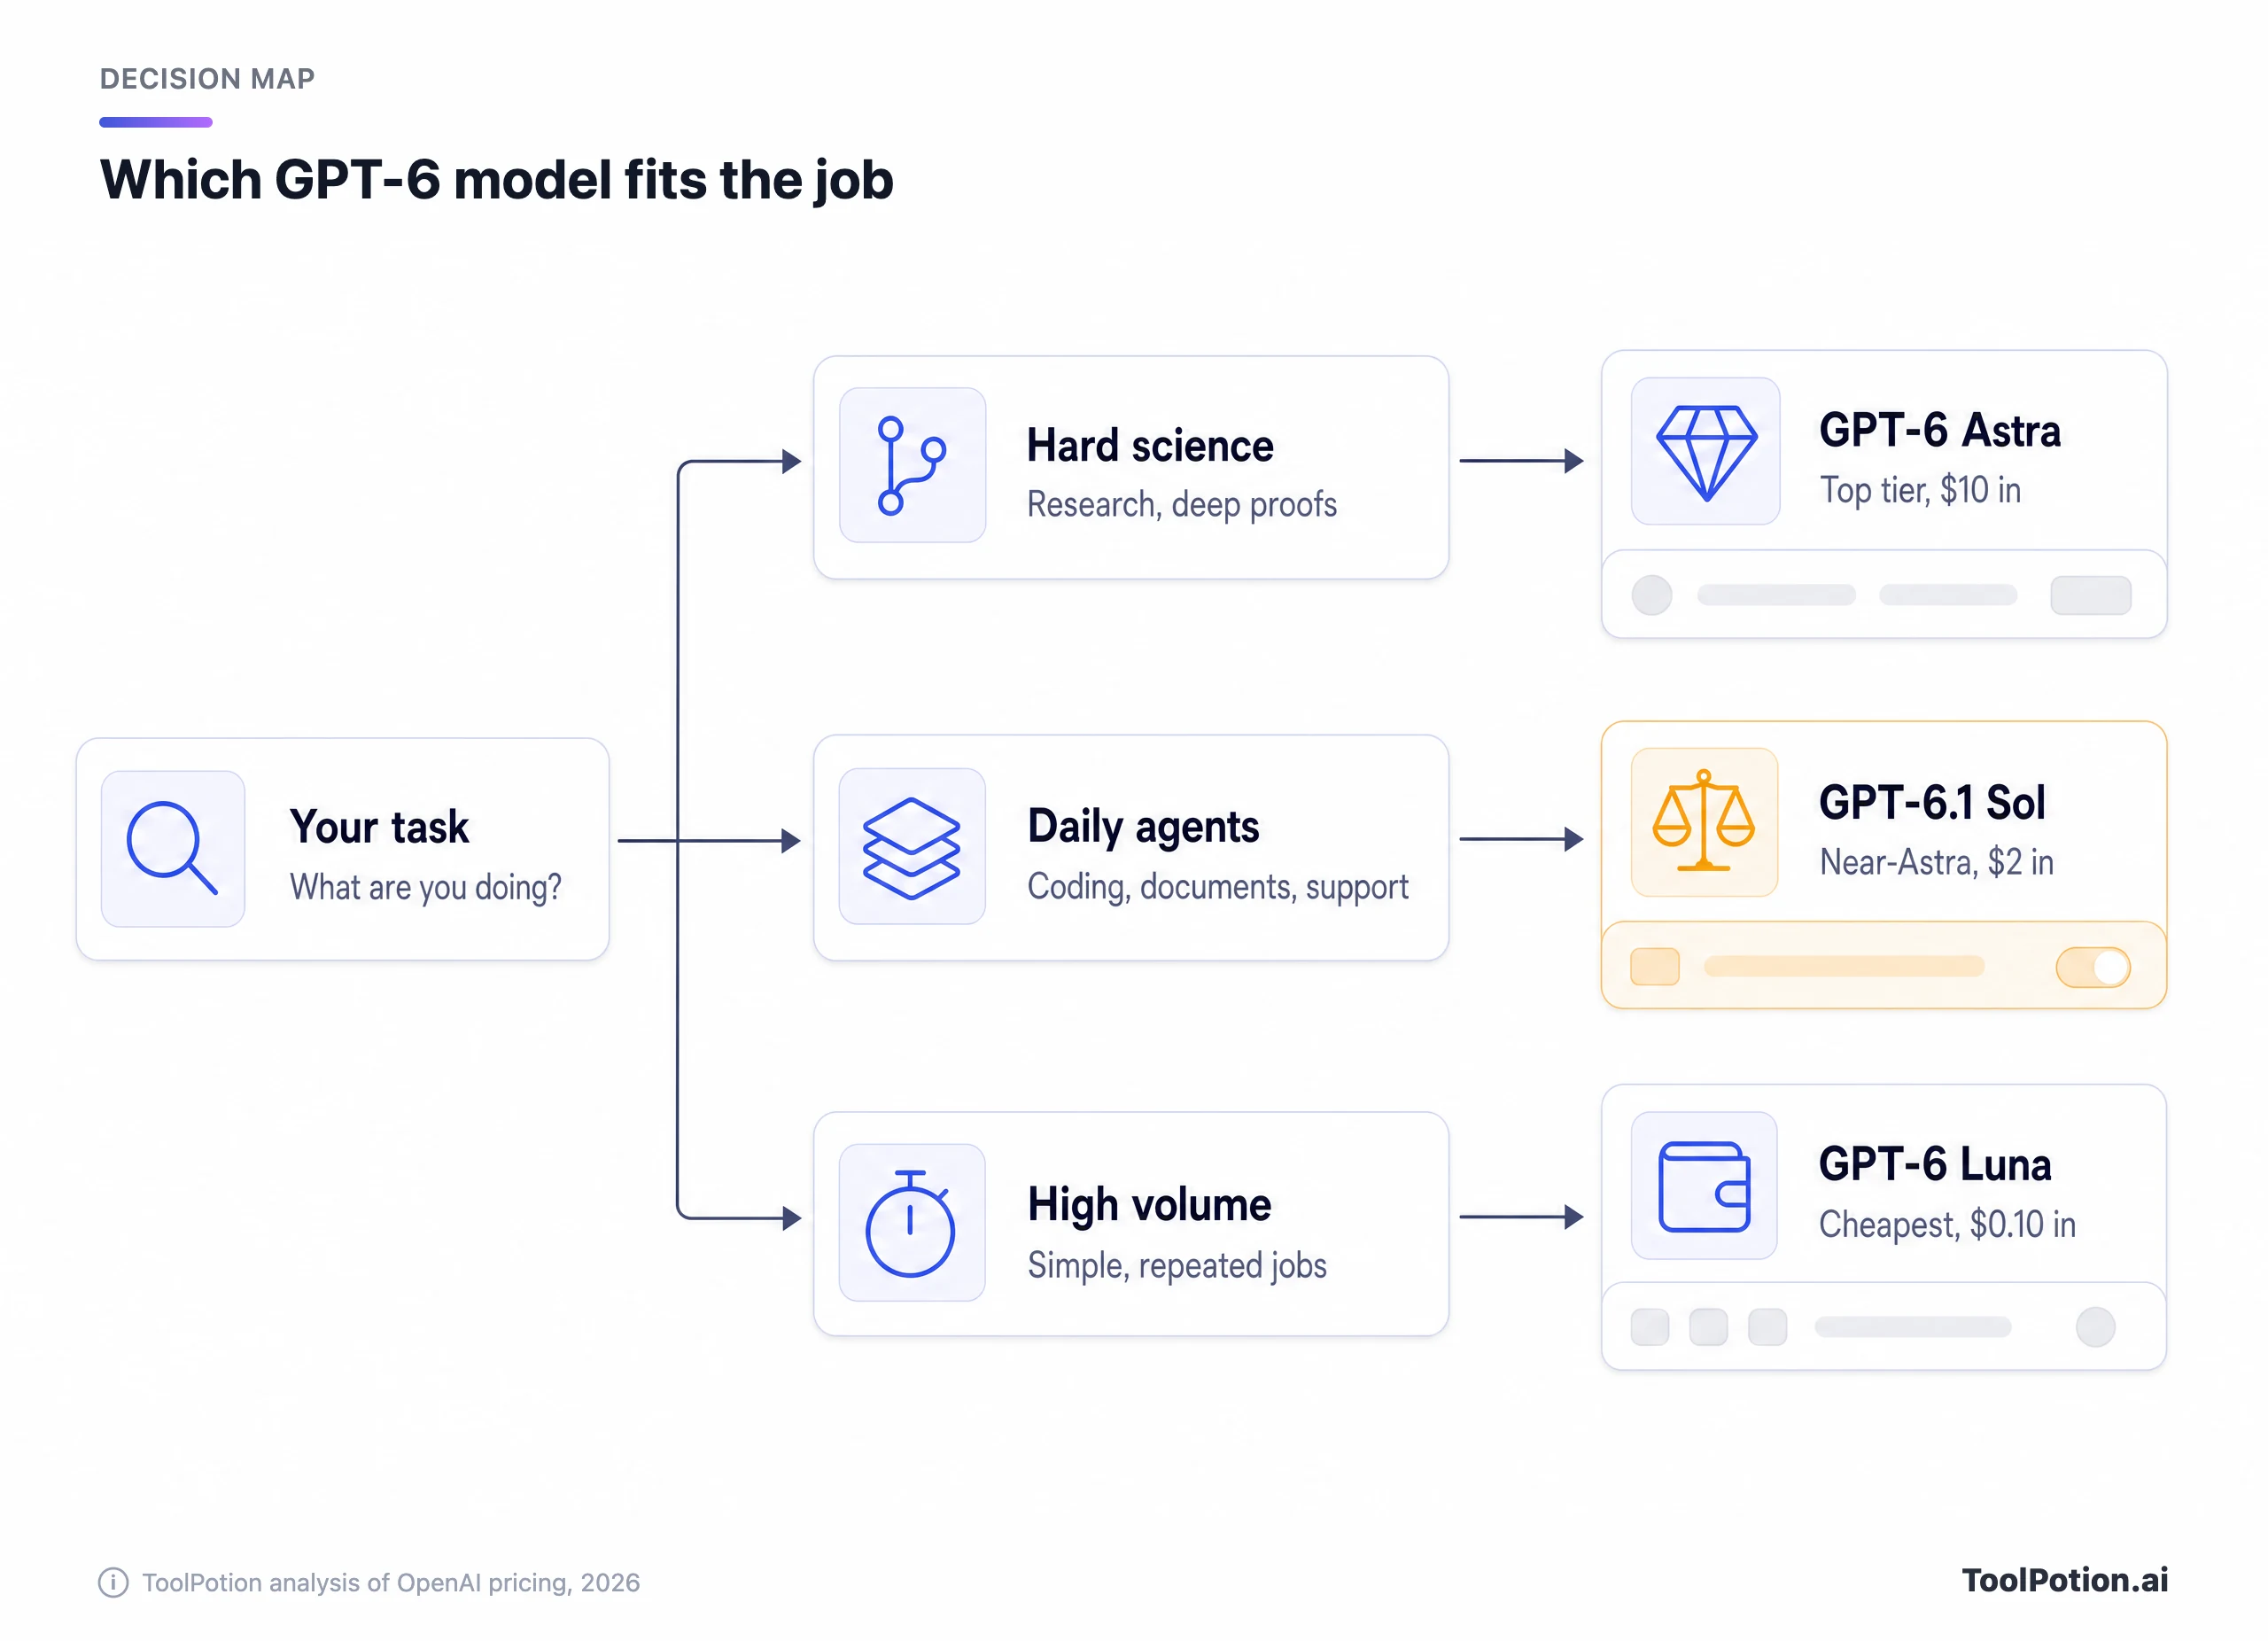
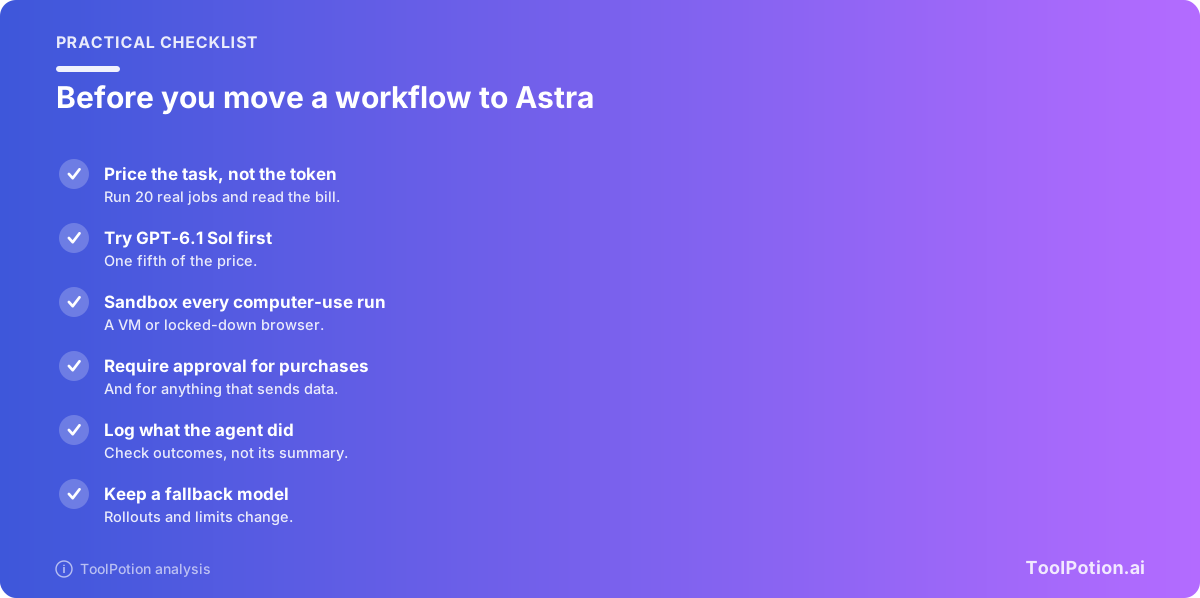
이 근거에서 나오는 합리적인 기준은 이렇습니다. 일상적인 에이전트 작업은 Sol을 기본으로 쓰고, 태깅, 라우팅, 추출처럼 단순하게 반복되는 작업은 Luna로 내리고, 직접 가진 예시로 일대일 비교했을 때 돈을 낼 만한 차이가 확인되는 경우에만 Astra로 올리세요. 아래 간단한 점검을 해 보세요.
제품을 만들고 있다면 가장 저렴한 실험은 실제 작업 20개를 Sol과 Astra에 돌려 성공률과 실제 청구액을 비교하는 것입니다. 작업 20개는 몇 달러면 충분하고, 어떤 차트보다 확실하게 결론을 내려 줍니다.
Plus 이상의 ChatGPT 사용자라면 현실적인 질문은 더 작습니다. 이미 요금제 안에 GPT-6 패밀리가 들어 있습니다. 평소 대화에는 기본 모델을 쓰고, 기본 모델이 계속 틀리는 작업 하나에 Astra를 써 보세요. 다른 생태계를 쓴다면 Claude와 Google Gemini가 같은 급에서 경쟁하며, Top 25 LLMs 보드에서 이들을 추적하고 있습니다.
당장은 무시해도 되는 경우
Free와 Go 사용자는 해당 요금제에 없으므로 Astra를 완전히 무시해도 됩니다. 이메일, 요약, 브레인스토밍, 숙제 도움 정도로 ChatGPT를 쓰는 사람이라면 굳이 쫓아갈 만한 차이를 느끼지 못할 것입니다. 이득은 도구를 많이 쓰는 긴 작업에서 나타납니다.
이미 다른 스택에 깊이 들어가 있는 팀은 옮길 이유가 크지 않습니다. Anthropic의 Claude Fable 5.1은 Artificial Analysis 지수의 일부 버전에서 Astra보다 점수가 높고, 코딩 조직이라면 출시 차트가 아니라 자기 저장소에서 Codex in ChatGPT와 Claude Code를 비교할 것입니다. 규제 대상 데이터를 다루는 기업이라면 에이전트를 실제 시스템에 풀어놓기 전에 위의 안전 제한을 먼저 읽어 보세요.
지금 써 볼 만한 사람은 현재 중간에 실패하는 다단계 에이전트를 돌리는 개발자, 스프레드시트와 문서에서 사는 분석가, 컴퓨터 사용 파일럿이 신뢰성 문제로 무산된 모든 사람입니다. 이들에게는 Astra나 Sol로 다시 테스트해 볼 만합니다. 더 넓은 선택지를 보려면 Top 20 AI 모델 및 LLM 보드와 2026년 AI 모델·LLM 가이드를 참고하세요. GPT-5.5 같은 이전 OpenAI 모델도 비교 기준이 필요할 때를 위해 계속 등재돼 있고, 나머지 대안은 ChatGPT 대안 글에서 다룹니다.
읽어 볼 만한 고객 사례도 있습니다. 저희 디렉터리에는 검색 회사가 이 모델을 어떻게 활용하는지 설명하는 Perplexity x GPT-6 Astra 사례 연구가 있습니다.
자주 묻는 질문
GPT-6 Astra는 ChatGPT에서 무료인가요?
아니요. OpenAI의 요금제 표에는 Astra가 Plus, Pro, Business, Enterprise에 있고 Free와 Go에는 포함되지 않는다고 나와 있습니다. Free 사용자는 텍스트 채팅에 GPT-5.6 Luna를 씁니다.
GPT-6 Astra와 GPT-6.1 Sol의 차이는 무엇인가요?
Astra는 100만 토큰당 입력 10달러, 출력 50달러의 최상위 티어입니다. Sol은 2달러와 10달러이며, OpenAI에 따르면 Astra에 근접한 성능을 냅니다. 둘 다 컨텍스트 윈도우는 105만 토큰입니다. 기본 모델로는 Sol이 낫고, Astra는 가장 어려운 작업용입니다.
API에서 Astra를 쓸 수 있나요? 비용은 얼마인가요?
네. 정가는 100만 입력 토큰당 10달러, 출력 50달러이고 캐시된 입력은 1달러입니다. Batch는 절반으로 줄여 주고 Fast 모드는 2배입니다. 입력이 27만 2,000토큰을 넘으면 입력 20달러, 출력 75달러로 더 비쌉니다.
Astra가 Claude를 이기나요?
테스트에 따라 다릅니다. Artificial Analysis 지수 v4.2에서는 Claude Fable 5.1의 점수가 더 높았고, 더 새로운 v4.3에서는 둘이 공동 1위였습니다. OpenAI가 보고한 에이전트와 컴퓨터 사용 벤치마크에서는 Astra가 Claude Opus 5를 앞섰습니다. 벤더 차트와 독립 지수가 항상 일치하지는 않으니 직접 하는 업무로 테스트해 보세요.
Astra가 내 컴퓨터를 제어하게 해도 안전한가요?
안전장치가 있을 때만 가능합니다. OpenAI 가이드는 샌드박스에서 실행하고, 구매와 데이터 전송에는 승인을 요구하며, 화면의 텍스트를 신뢰할 수 없는 것으로 취급하라고 합니다. OpenAI는 Astra의 추론이 GPT-5.6 Sol보다 모니터링하기 어렵다고도 밝혔습니다.
ARC-AGI-3 점수가 출처마다 이렇게 다른 이유는 무엇인가요?
테스트 설정이 다르기 때문입니다. OpenAI의 99.9%는 요청 사이에 추론 상태를 이어 가는 ARC Prize의 Provider Adapter 설정에서 나왔고, ARC Prize의 표준 설정에서는 62.7%였습니다. 모델은 같지만, 모델을 둘러싼 구조가 다릅니다.