

한 학생은 연구진에게 같은 반 친구들이 서로 "이 에세이 전체를 ChatGPT로 썼어"라고 털어놓는다고 말했습니다. 이어진 한마디가 오래 남았습니다. "그런데 걸리지도 않고, 아마 좋은 점수도 받아요. 그리고 처음에 통했으니까 다음 과제에서도 똑같이 하는 거죠" (OfS 및 Advance HE 보고서).
이 인용문은 잉글랜드 고등교육 규제기관인 Office for Students(OfS)가 자선단체 Advance HE와 함께 발표한 보고서에 실려 있습니다. 제목은 Making AI work for students로 온건하지만, 평가에 관한 결론은 전혀 온건하지 않습니다. 학생이 집에서 감독 없이, ChatGPT 탭을 열어놓고 하는 과제는 학생이 거의 참여하지 않아도 높은 수준으로 끝낼 수 있고, 때로는 몇 분이면 되며, 채점자는 그 차이를 구분하지 못하는 경우가 많습니다.
저희는 기사만이 아니라 보고서 원문을 읽었습니다. Guardian의 헤드라인과 규제기관 본문의 표현이 다르고, 둘 중 더 신중한 쪽은 보고서이기 때문입니다. 가장 쓸모 있는 부분은 가장 덜 극적인 부분, 즉 몇몇 대학이 이미 실행하고 있는 대응입니다.
규제기관이 확인한 것, 확인하지 못한 것
이 조사는 올해 초에 진행됐고, 300명이 넘는 학생과 교직원과의 대화를 바탕으로 합니다. Guardian은 여기에 127개 대학과 칼리지가 포함됐다고 집계합니다(The Guardian). OfS 요약 페이지는 "120개 이상의 기관"(OfS)이라고 하고, 보고서의 방법론 부분은 최소 127개라고 밝힙니다(보고서). 주로 잉글랜드 기관을 대상으로 한 인터뷰와 설문 증거입니다. AI가 완료한 평가가 얼마나 되는지는 아무도 측정하지 않았고, OfS는 "변화의 규모와 성격을 파악하기 위해" 추가 연구를 하겠다고 밝혔습니다(OfS 보도자료). 그때까지 2026년 잉글랜드의 어떤 비율 수치도 추측일 뿐입니다.
참가자들의 설명은 일관됩니다. 감독 없는 평가는 "학생의 참여가 적어도 AI 도구로 높은 수준까지 완성할 수 있고", 온라인으로 제출하는 에세이 중심의 프로그램은 특히 취약하다고 했습니다(보고서). 학생들은 "때로는 단 몇 분 만에" 과제를 끝내고도 직접 한 학생과 비슷한 점수를 받은 동료들 이야기를 했습니다. 방금 제출한 내용의 기본적인 사항조차 떠올리지 못하는 학생도 있었습니다. 교직원들은 똑같아 보이고, 같은 문헌을 인용하고, 같은 문체로 쓰인 제출물이 대량으로 들어온다고 설명했습니다.
설문에 응한 한 학생은 그 피해를 개인적인 말로 표현했습니다. "계획을 세우고 에세이를 전부 혼자 쓴 뒤, AI로 쓴 사람과 똑같은 점수를 받으면 정말 당혹스럽습니다." 손해를 보는 쪽은 정직한 학생들이고, 저희는 이 문제를 가장 먼저 꼽겠습니다.
헤드라인에 대해 짚어둘 점이 있습니다. "거의 불가능"은 교직원 응답자의 표현이고, 전체 문장은 Guardian의 헤드라인보다 범위가 좁습니다. AI 사용이 만연하면 "일부 영역에서는 학생 평가가 거의 불가능해질 수 있다"는 것입니다. 규제기관 자체의 요약은 AI가 "평가의 타당성과 효과에 중대한 위험을 초래한다"고 말합니다. 저희는 두 번째 표현이 더 정확하다고 보지만, 그것만으로도 충분히 심각합니다.
보고서는 공정성 문제도 지적합니다. 참가자들은 가장 진보한 모델에 돈을 내는 학생이, 같은 지식을 갖췄지만 저렴한 모델을 쓰거나 아예 쓰지 않는 동료보다 더 높은 점수를 받을 수 있다고 우려했습니다(보고서).
수단을 가진 규제기관, 그리고 그것을 쓰겠다는 경고
OfS의 전략·실행 총괄 Josh Fleming은 고등교육에서의 AI 사용을 "현 체제에 대한 세대적 위험이며, 학생의 학습과 기관의 평가 능력을 훼손할 우려가 있다"고 말했습니다. 이어 이렇게 덧붙였습니다. "이런 위험에 대응하려는 훨씬 더 큰 노력이 필요하며, AI를 쓰지 않는 평가의 활용도 훨씬 늘어야 합니다"(OfS 보도자료).
힘이 실린 곳은 보도자료입니다. OfS는 기관이 평가가 지식과 기술을 타당하고 신뢰할 수 있게 측정하도록 요구하겠다고 밝혔고, "많은 경우 보안이 확보된(AI-free) 평가가 필요할 것"이라고 했습니다. 기관이 기준에 미달하면 특정 등록 조건 부과, 금전적 제재, 학생 지원 기금 및 OfS 보조금 접근 정지 등의 수단을 쓸 수 있습니다. 기관이 어떻게 준수할 수 있는지에 대한 가이드라인도 보고서와 함께 발표했습니다.
교육부(Department for Education)는 Guardian에 OfS가 AI에 관해 "기존 기준을 효과적으로 집행하면서 속도감 있게 대응하기를" 기대한다고 밝혔습니다. 147개 기관을 대표하는 Universities UK는 "갈 길이 더 남아 있지만 많은 곳이 상당한 변화를 이뤘다"고 답했습니다(The Guardian). 참가자들은 AI에 특화된 새 등록 조건이 역효과를 낼 수 있다고 경고하며 기존 조건을 명확히 해달라고 요청하기도 했습니다(OfS). OfS는 후자로 답했습니다. 기존 조건이 AI에 어떻게 적용되는지에 대한 가이드라인입니다.
세 가지 해법, 그리고 규제기관이 선호하는 하나
보고서는 대학들의 대응을 세 가지로 분류합니다. 보안 평가(secure assessment)는 학생이 치르는 동안 AI를 쓸 수 없게 설계한 것으로, 대면 필기시험, 발표, 구술시험(제출한 과제에 대한 짧은 구두 토론), 실습, 공연이 여기에 속합니다. 과정 기반 평가(process-based assessment)는 결과물뿐 아니라 만들어 가는 과정도 평가하며, 보고서가 스테이지 게이트라 부르는 여러 중간 점검 단계를 두기도 합니다. 개방형 평가(open assessment)는 AI 사용을 허용하거나 요구합니다. 예를 들면 AI의 결과물을 비평하게 하거나, AI가 쓴 초안을 편집하게 하는 식입니다(보고서).
규제기관은 한쪽으로 기웁니다. 보안 방식은 "학생이 자신의 지식과 기술을 보여주고 있다는 높은 확신을 주기 때문에 흔히 가장 효과적인 평가 형태가 될 것"이라고 합니다. 반대편에 대해서는, 평가가 시험하려는 지식 없이도 AI로 완료될 수 있다면 "그 평가는 교체되어야 한다"고 말합니다. 또 기술이 아닌 지식을 평가하려면 "대개 평가가 보안 방식이어야 한다"고 합니다.
저희도 동의하고, 점잖은 표현보다 한 걸음 더 나아가겠습니다. 참고문헌 목록의 내용을 기억하는지 묻는 집에서 쓰는 에세이는 측정 도구로서는 끝났습니다. 이를 대체할 수 있는 것은 감독이 있는 시험장, 대화, 다시 설계한 과제뿐입니다.
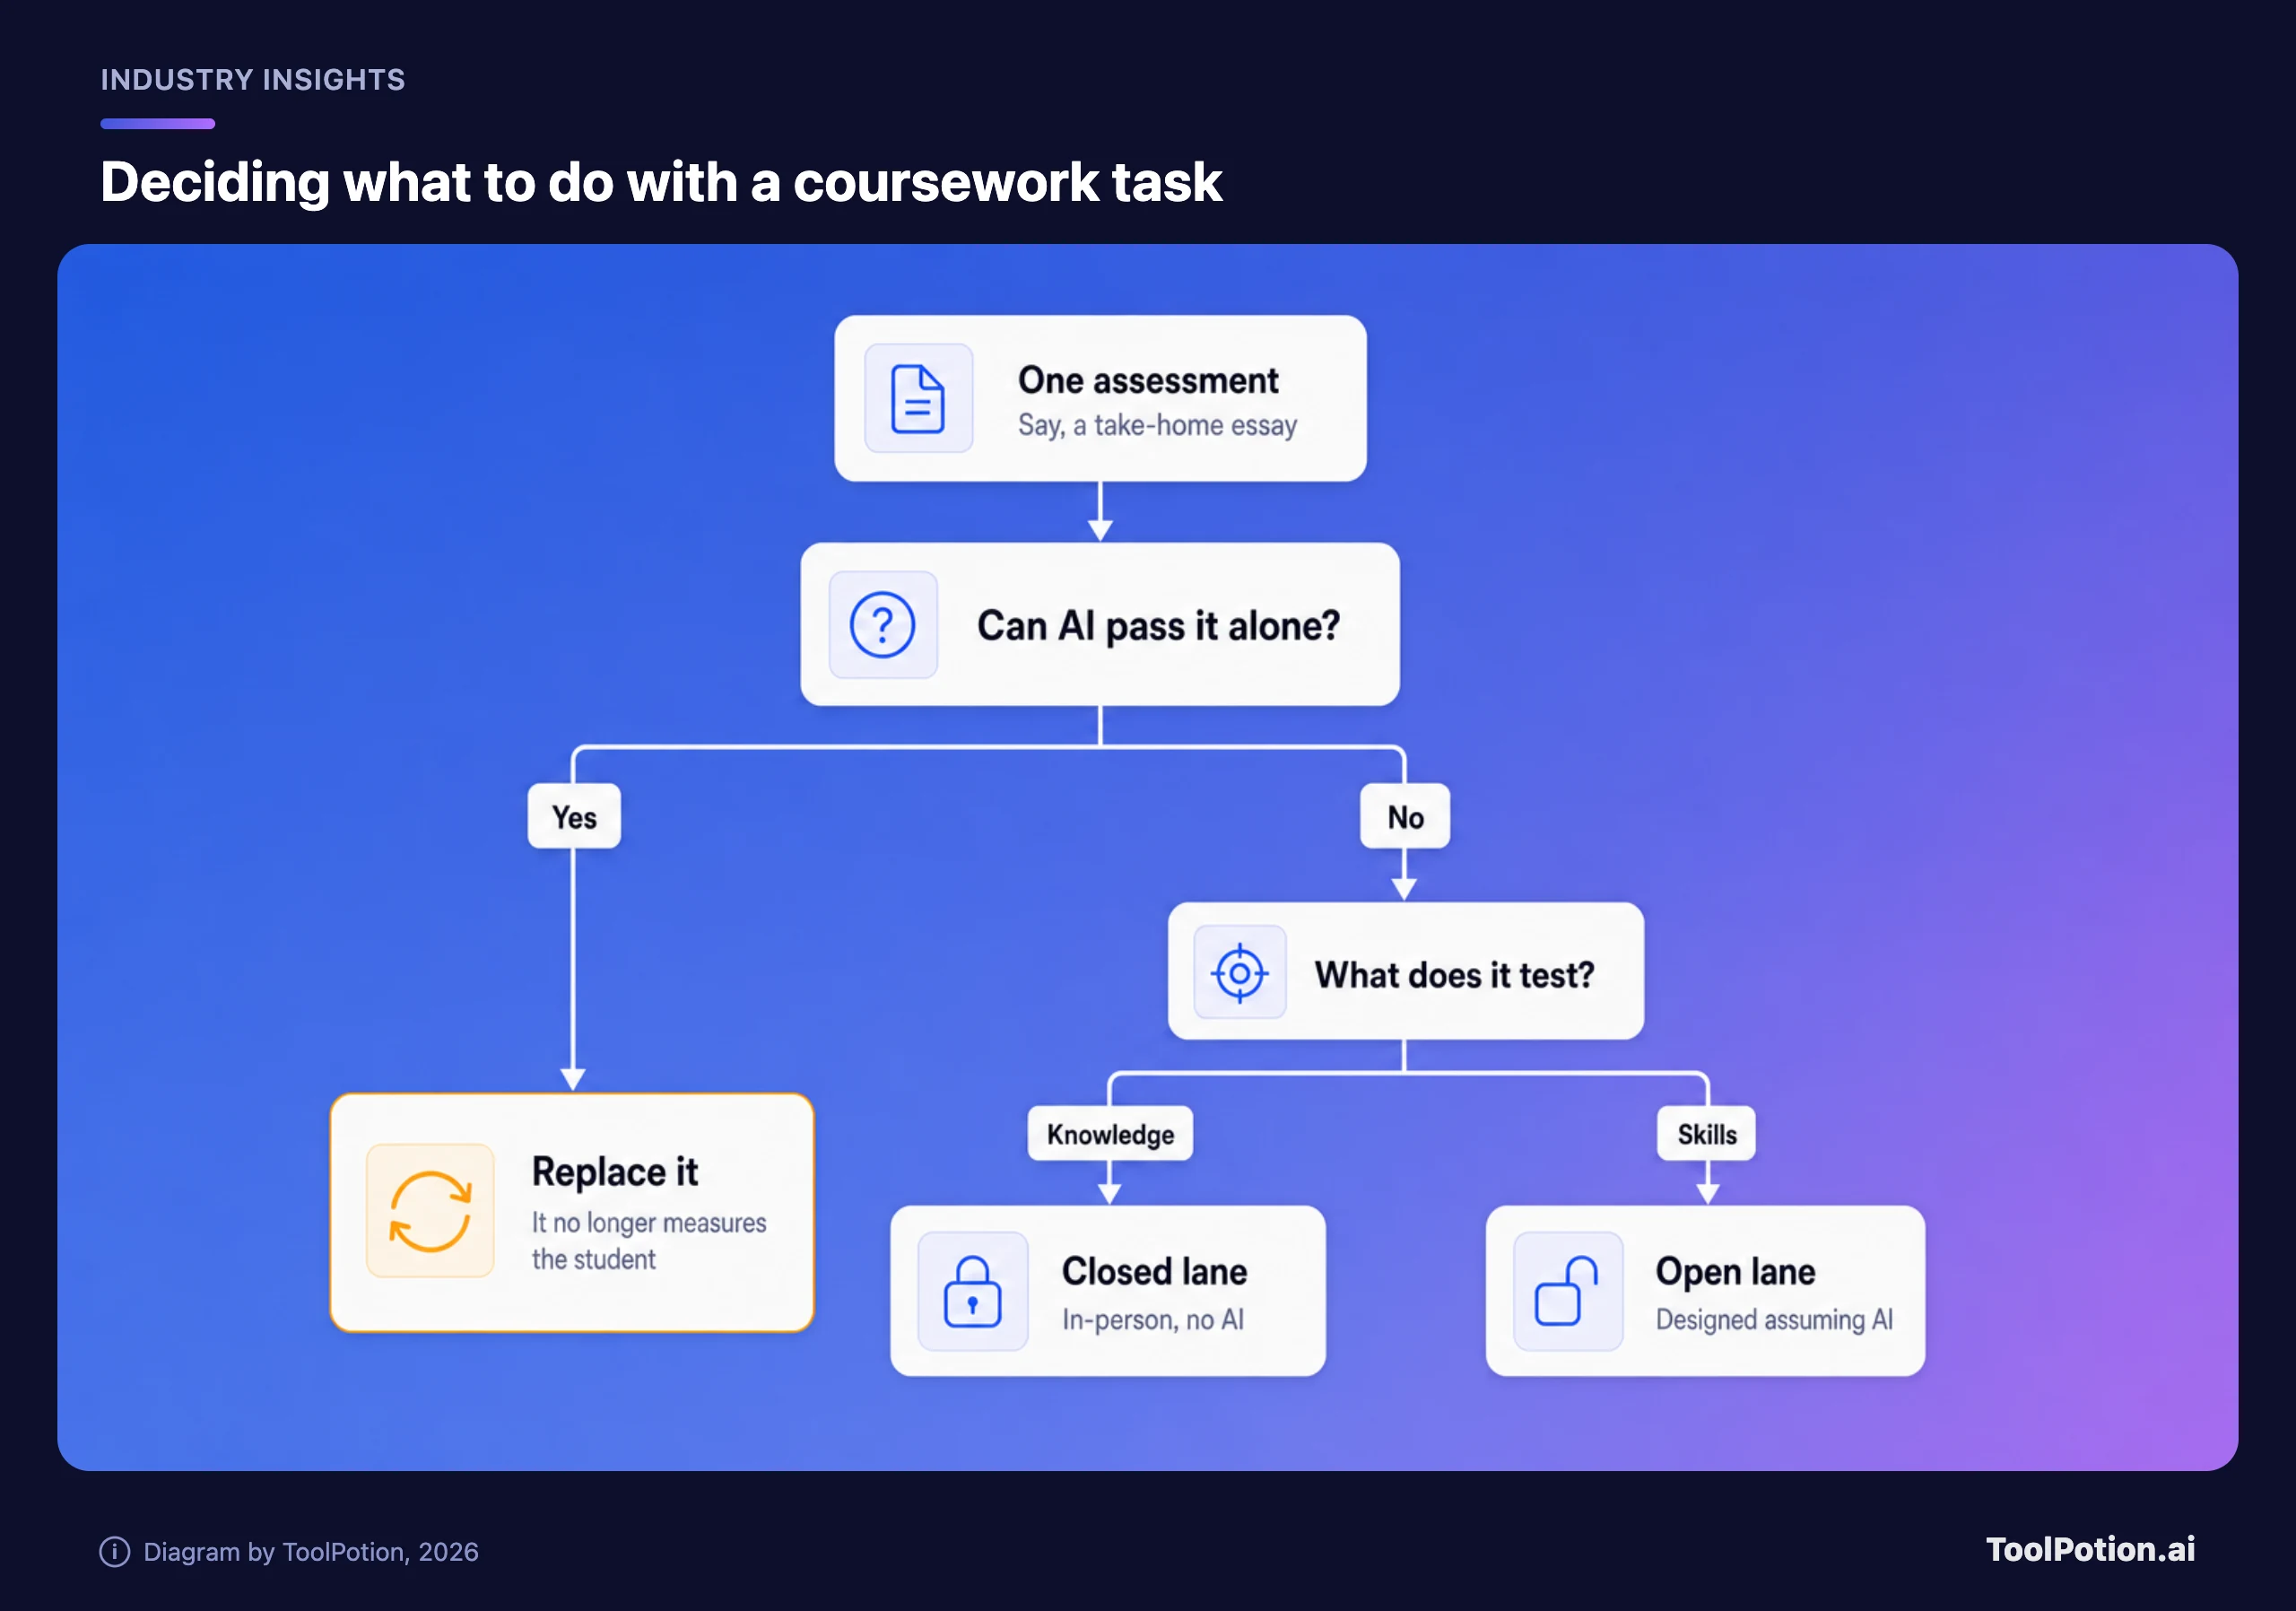
보고서는 장단점도 정리합니다. 대면 시험과 구술시험은 자원이 많이 듭니다. 책을 볼 수 없는 시험은 실제 직무와 거의 닮지 않을 수 있고, 장기 기억에 의존하기 때문에 장애 학생을 비롯한 일부 집단이 불리할 수 있습니다. 전문 단체가 특정 형식을 규정하는 경우도 있습니다. 또 웨어러블 기기 때문에 보안 평가에서 부정행위가 더 쉬워질 수도 있습니다. 실제성에 대한 우려에 규제기관이 내놓은 답은 실제성과 견고함을 모두 갖춘 평가를 만들려는 노력이 "환영받는다"는 것인데, 이는 계획이라고 할 수 없습니다.
Bath는 신호등 방식을 포기했다
보고서의 사례 연구가 가장 볼만합니다. University of Bath는 세 가지 범주를 운영했습니다. AI 금지, 명시된 일부 용도만 허용, AI가 평가에 필수인 경우입니다. 가운데 범주가 무너졌습니다. 교직원들은 "B 범주 평가에서 명시된 AI 사용을 신뢰할 수 있고 공평하게 단속하는 것은 불가능했다"고 판단했습니다.
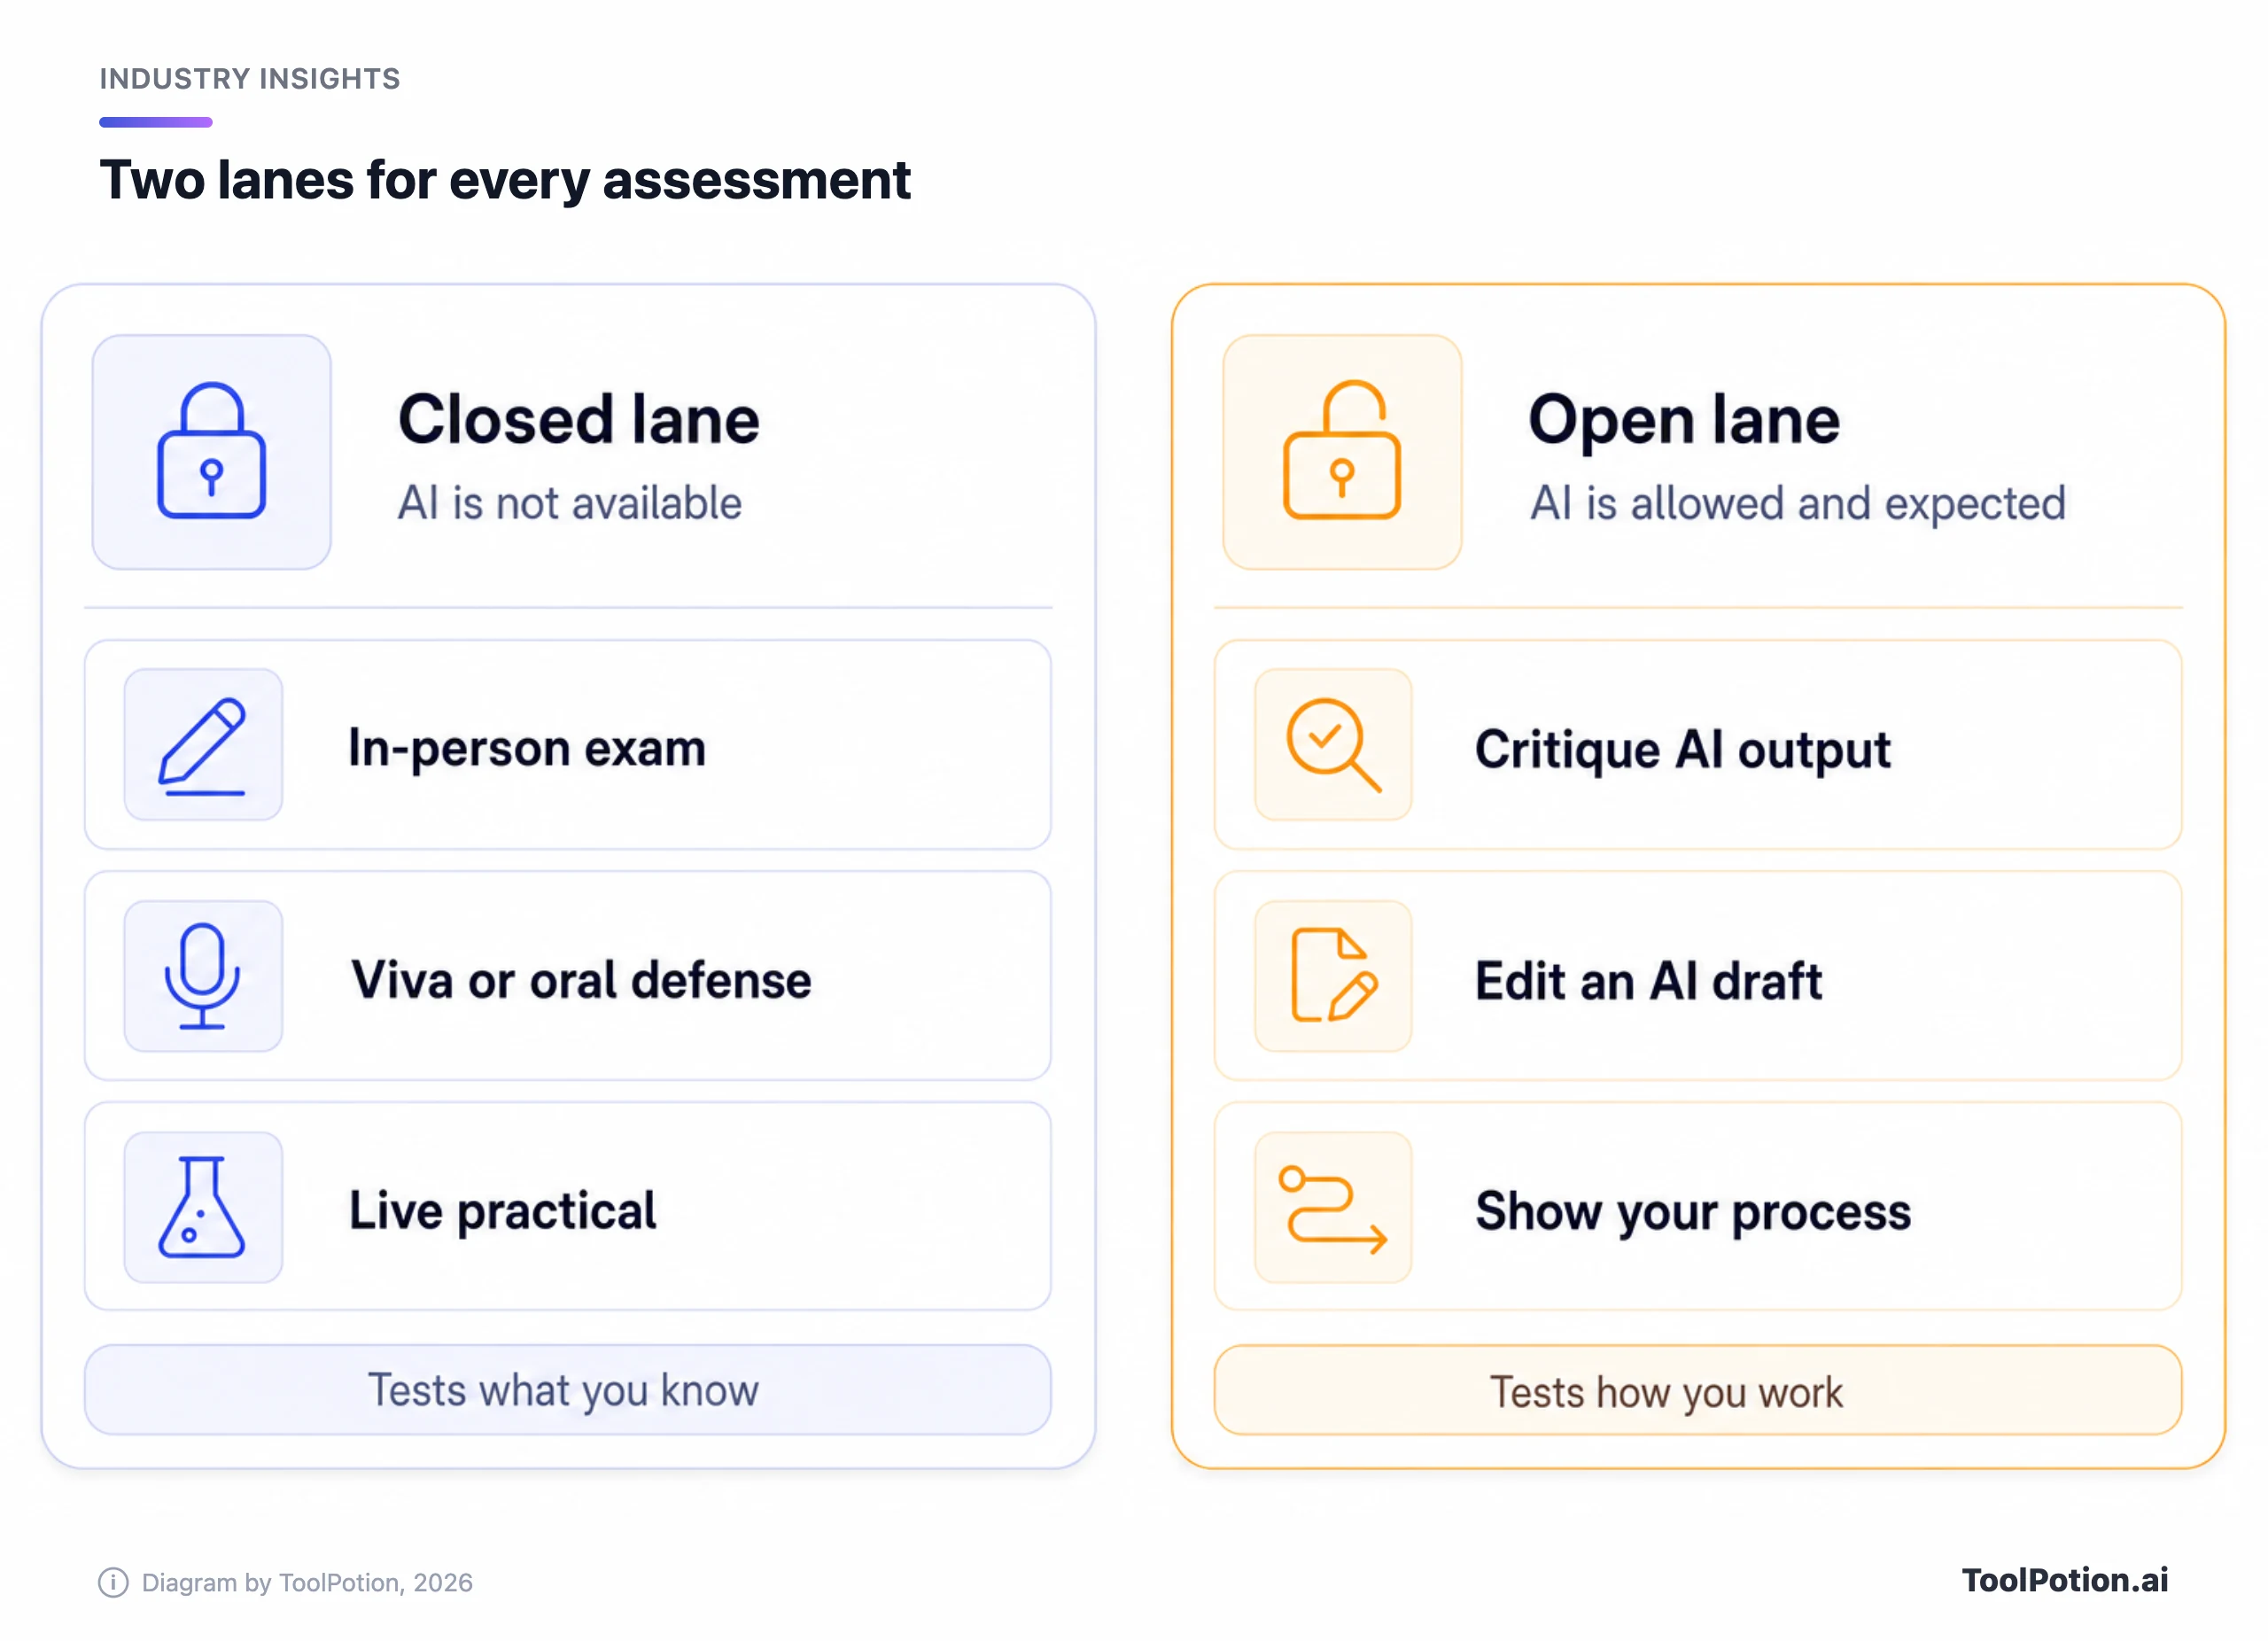
2026년에 Bath는 University of Sydney가 처음 개발한 두 트랙 모델로 옮겼습니다. 모든 평가는 학생이 AI 도구에 접근할 수 없도록 조건을 갖춘 폐쇄형 트랙이나, AI를 허용하고 학생이 쓸 것을 전제로 과제를 설계하는 개방형 트랙 중 하나에 들어갑니다. Bath 교직원들은 견고한 개방형 트랙 과제를 만들기 위해 워크숍을 열었고, 대학은 폐쇄형 트랙의 평가도 의도한 학습 성과를 중심으로 설계해야 한다고 강조합니다(보고서).
저희가 이 방식을 좋아하는 이유는 하나입니다. "브레인스토밍에는 AI를 쓰되 초안 작성에는 쓰지 말라"는 규칙을 검증할 수 있는 척하지 않기 때문입니다. 보고서도 같은 말을 합니다. 구조를 바꾸지 않으면 학생이 AI 정책을 따랐는지 확인하거나 오용을 의미 있게 억제하는 것이 불가능하다는 것입니다.
시험은 잠그는 대학들이 AI를 나눠주기도 합니다. Kent는 2026년에 대학이 라이선스를 구매한 ChatGPT Edu 플랫폼을 도입했습니다. 학생은 접속 전에 AI 리터러시, 책임 있는 사용, 데이터 보호, 프롬프트 작성, 학문적 진실성에 관한 교육을 이수해야 하고, 사용은 선택입니다. Imperial은 학생과 교직원에게 dAIsy라는 워크스페이스를 제공하는데, 데이터가 보호되는 하나의 인터페이스로 ChatGPT, Claude, DeepSeek에 접근할 수 있고, 업무에서의 AI를 다루는 40시간 과정도 시작할 예정입니다. 보고서에 따르면 Oxford와 London School of Economics도 AI 업체와 협약을 맺고 있습니다(보고서).
이는 위선이 아닙니다. 졸업생이 이런 도구를 잘 쓰기를 바라면서, 도구 없이 각자 무엇을 할 수 있는지도 알게 하려는 대학이라면 둘을 위한 공간이 각각 필요합니다. 저희라면 어느 한 극단보다 이 조합을 택하겠습니다. 아직 어떤 어시스턴트를 쓸지 고르는 중이라면 ChatGPT vs Claude vs Gemini에서 세 가지의 차이를 확인해 보세요.
탐지기가 심판이 될 수 없는 이유
모든 것을 다시 설계하는 대신 떠올릴 만한 대안은 사후에 AI 텍스트를 잡아내는 것입니다. 보고서는 이 방법이 충분히 작동하지 않는다고 분명히 말합니다. 학술 연구에 따르면 사람은 AI 텍스트를 안정적으로 식별하지 못하고, 새 탐지기가 예전 것보다 나을 수는 있지만 그 개선은 "대개 일시적이며 곧이어 AI 시스템이 발전한다"고 합니다. 탐지기를 속이도록 텍스트를 바꿔 쓰는 도구(휴머나이저)는 정확도를 더 떨어뜨립니다(보고서).
그래도 많은 기관이 이 도구를 씁니다. 점수를 부정행위 사건에 보조 증거로 넣는 곳도 있고, 일부 교직원은 비공식적으로 써서 문제 제기하거나 감점할 과제를 골라냅니다. 영국 고등교육에서 널리 쓰이는 AI 탐지기를 제공하는 Turnitin은 연구진에게 결과를 하나의 데이터 포인트로만 써야 한다고 밝혔습니다. 탐지기 사용을 아예 중단한 기관도 있었습니다.
학생 참가자들은 더 날카로웠습니다. 탐지기는 부정확하고 AI 사용을 과장한다고 했고, 일단 높은 점수가 나오면 결백을 증명할 길이 없어 보여 답답했다는 학생도 있었습니다. 학생들은 엠 대시(em dash) 같은 AI 텍스트의 특징을 지우거나, 휴머나이저를 쓰거나, 일부러 맞춤법과 문법 오류를 넣어 점수를 낮췄다고 설명했습니다. (저희는 자체 스타일 가이드에서 엠 대시를 금지하고 있어서 살짝 섬뜩했습니다.) 정직한 필자가 글을 일부러 망치게 만드는 도구는 정직함을 측정하는 것이 아닙니다.
점수에 대한 보고서의 입장은 저희도 같습니다. 학생이 부정행위를 했는지 철저히 판단하는 과정에서 증거 중 하나일 뿐이며, "강력한 증거 없는 AI 사용 의심을 근거로 학생에게 낮은 점수를 줘서는 안 됩니다." 보고서는 부정행위 절차가 "시간과 자원이 많이 들고, 학생에게 스트레스를 주며, 평가 과정의 타당성을 확보하는 데는 효과적이기 어렵다"고도 덧붙입니다.
사람 채점자도 놓칩니다. 2024년 연구에서 University of Reading 연구진은 한 심리학 학위의 다섯 개 모듈에 채점자에게 알리지 않고 AI(GPT-4)가 전부 쓴 답안을 섞어 넣었습니다. 94%가 발각되지 않았고 평균적으로 실제 학생보다 약 반 등급 경계만큼 높은 점수를 받았습니다(PLOS One). 도구별 비교는 상위 AI 콘텐츠 탐지기 글에서 GPTZero, Grammarly 탐지기, Copyleaks 확장 프로그램을 다루고 있고, AI 콘텐츠 탐지기 순위표에서 전체 순위를 볼 수 있습니다. 탐지기에 대한 저희 관점은 규제기관과 같습니다. 화재경보기로는 써도, 판사로 쓰면 안 됩니다.
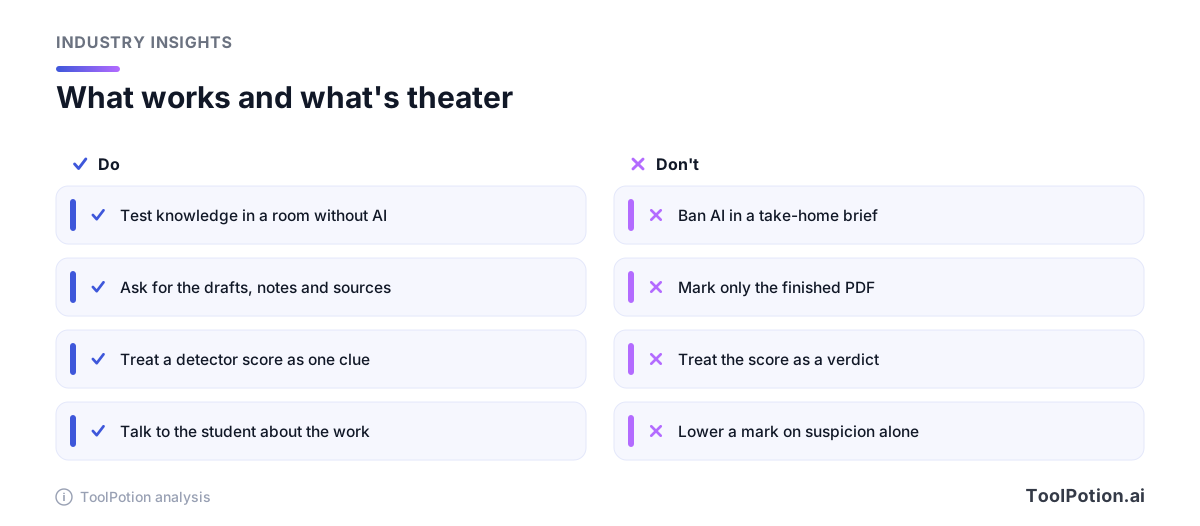
그래서 저희의 구분은 이렇습니다. 효과가 있는 것은 지식을 평가하는 AI 없는 시험장, 프로젝트의 초안과 출처 수집, 학생 본인의 작업에 대한 짧은 대화입니다. 쇼에 불과한 것은 집에서 하는 과제에 AI 금지를 써놓고 기대하는 것, 최종 파일만 채점하는 것, 탐지기 퍼센트를 결과로 취급하는 것입니다.
학생과 학부모가 기대해야 할 것
이 중 어느 것도 학생에 대한 판단이 아닙니다. 보고서 자체가 학생들이 어려운 개념을 설명받고, 긴 문서를 요약하고, 연습 문제를 만들고, 복습하는 데 AI를 널리 쓴다고 말하며, 신경다양성이 있거나 장애가 있는 학생, 모국어가 영어가 아닌 학생에게 도움이 될 수 있다고 합니다. 또 지금은 많은 학생이 AI를 높은 점수를 받는 가장 효과적인 길로 보고, 쓰지 않으면 불리하다고 느낄 수 있다고도 합니다. 차이를 구분하지 못하는 평가를 생각하면 합리적인 판단입니다.
OfS 보도자료에 따르면 많은 학생이 소속 기관이나 학과의 정책을 이해하기 어렵다고 느낍니다. 규제기관 자신의 보고서도 허용되는 사용과 그렇지 않은 사용의 경계를 긋기 어렵다고 인정합니다. AI가 "학생과 기계의 작업을 흐릿하게 만드는 방식으로 아이디어와 추론을 생성할 수 있기" 때문입니다(보고서). 그러니 신입생이나 학부모가 가장 안전하게 전제할 만한 것은 다음과 같습니다.
- 최종 점수에서 시험장에서 하는 것의 비중이 더 커질 것으로 예상하세요. 필기시험, 발표, 실습, 또는 제출한 과제에 대한 짧은 구술 토론입니다.
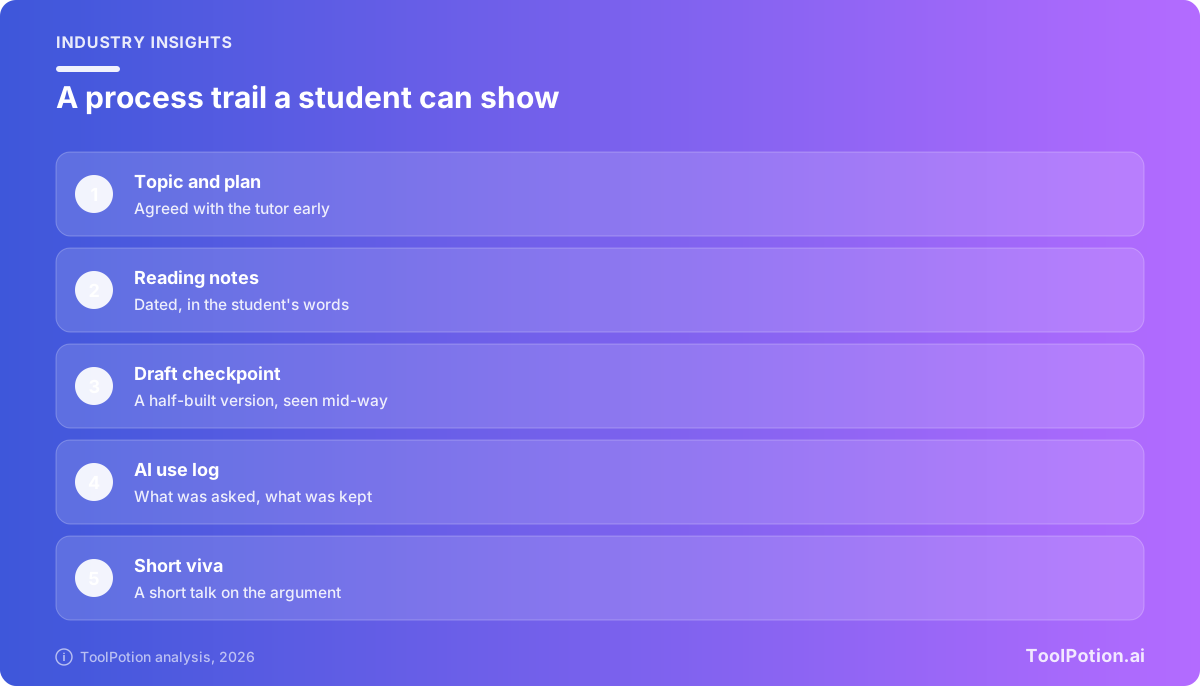
- 작업 과정을 요구받을 것으로 예상하세요. 메모, 날짜가 찍힌 초안, 출처는 과정 기반 평가가 살피는 대상이고, 일부 기관은 이미 AI를 어떻게 썼는지 학생에게 신고하게 합니다(보고서에 따르면 많은 학생이 신고가 자신의 과제에 대한 의심을 부를까 두려워합니다).
- 규칙은 모듈마다 다를 것으로 예상하세요. 한 평가는 폐쇄형이고 다음 평가는 개방형일 수 있으며, 중요한 것은 대학 홈페이지가 아니라 각 평가의 안내서입니다.
- 과제가 의심받는다면 탐지기 점수 외에 어떤 증거가 있는지 묻고, 직접 만나서 작업을 설명하겠다고 요청하세요. 규제기관은 점수만으로 결과를 정해서는 안 된다고 말합니다.
- 합리적 편의 제공(reasonable adjustments)에 의존한다면 새 평가 형식에도 그것이 반영되는지 확인하세요. 보고서에 따르면 모든 학생은 포용적 설계와 편의 제공을 통해 보안 평가와 개방형 평가 모두에서 자신의 지식과 기술을 보여줄 수 있어야 합니다.
학부모에게는 질문이 하나 더 있습니다. 마지막 학년에는 과정이 어떻게 평가되는지, 그중 감독 아래 이뤄지는 비중이 얼마나 되는지 물어보세요. 그 답은 어떤 AI 정책 성명보다 많은 것을 말해줍니다.
규칙 안에서 AI 사용하기
해당 평가의 규칙을 서면으로 확인하는 것부터 시작하세요. 불분명하면 튜터에게 묻고 답변을 보관하세요. 여러분의 모듈이 무엇을 허용하는지는 저희가 알려드릴 수 없습니다. AI가 허용되는 경우 보고서가 설명하는 학생들의 사용 방식은 어려운 내용 설명 듣기, 스스로 퀴즈 내기, 복습 계획 짜기, 이해도 확인하기입니다. NotebookLM과 NotebookLM vs ChatGPT Projects vs Claude Projects 비교에 나오는 다른 도구들은 자신의 자료로 공부하도록 만들어졌습니다.
저희가 쓰는 기준은 구술시험 테스트입니다. 화면 없이 소리 내어, 글의 모든 논점을 설명할 수 있습니까? 그렇다면 AI는 아마 학습에 도움이 됐을 것입니다. 아니라면 AI가 대신 일한 것이고, 읽기, 조사, 문제 해결을 AI가 대체하는 '인지적 오프로딩(cognitive offloading)'에 대한 보고서의 우려는 규칙이 어떻든 여러분에게 해당합니다. Grammarly 같은 도구의 문법과 맞춤법 도움은 다른 문제처럼 느껴지지만, 보고서는 문장부호와 문법 도구에도 강력한 AI 기능이 들어 있을 수 있다고 지적하므로 단정하기 전에 규칙을 확인하세요.
위의 체크리스트는 공식 도구가 아닙니다. 채점자와 편하게 대화할 수 있게 해주는 여섯 가지 습관입니다.
앞으로 지켜볼 것
OfS가 기존 조건이 AI에 어떻게 적용되는지에 대한 가이드라인을 기관에 제공했으므로, 다음 증거는 집행입니다. 어느 대학이 특정 등록 조건을 부과받는지, 그 사유는 무엇인지가 관건입니다. Advance HE는 2027년 초 회원 기관을 대상으로 AI 중심의 Change Academy 프로그램을 계획하고 있습니다(OfS 보도자료).
부정행위 통계도 지켜볼 만합니다. Guardian의 2025년 조사에 따르면 2023-24학년도에 입증된 AI 부정행위가 약 7,000건, 학생 1,000명당 5.1건이었고, 응답한 대학의 27% 넘게가 AI 오용을 별도 범주로 아직 기록하지 않았습니다(The Guardian). 시험이 돌아오면서 입증 건수가 줄어든다면 재설계가 효과를 냈다는 뜻이거나, 적발이 더 어려워졌다는 뜻일 것입니다. 숫자만으로는 둘을 구분할 수 없습니다. 그래서 저희는 누군가를 잡아내는 데 의존하지 않는 평가를 주장합니다.