

Anthropic 엔지니어들은 한때 리드 에이전트가 "반도체 부족 현상을 조사하라" 같은 짧은 지시를 서브에이전트에게 내리도록 두었습니다. 서브에이전트들은 이를 잘못 해석했습니다. 하나는 2021년 자동차 반도체 위기를 파고들었고, 나머지 둘은 2025년 공급망을 놓고 같은 작업을 중복으로 했습니다(Anthropic Engineering). 오류가 난 것은 없었습니다. 여러 방식으로 읽힐 만큼 모호한 요청을 받고, 에이전트들이 각자 나름대로 합리적인 일을 했을 뿐입니다.
우리 대부분도 ChatGPT, Claude, Gemini CLI, 혹은 터미널 코딩 에이전트에 일을 맡길 때마다 같은 실수를 반복합니다. 작업 하나를 입력해 놓고 그걸 브리프라고 부르니까요. 이 글에서는 브리프에 필요한 여섯 가지 요소, 그대로 가져다 쓸 수 있는 재작성 예시 세 가지, 템플릿, 그리고 브리프가 실패하는 유형을 정리한 표를 다룹니다. 우리의 입장은 글을 진행하면서 차차 밝히겠습니다. 완료 조건 문장을 가장 먼저 쓸 것, "확실하지 않으면 물어봐" 대신 구체적인 행동 목록을 줄 것, 대문자 경고문의 벽은 걷어낼 것. 인용하는 벤더 문서가 뒷받침하는 부분도 있고 다루지 않는 부분도 있는데, 어느 쪽인지 그때그때 밝히겠습니다.
작업은 브리프가 아닙니다
작업은 활동의 이름을 말할 뿐입니다. 브리프는 일을 하는 사람이 그렇지 않으면 추측해야 할 모든 것을 알려줍니다. Anthropic의 프롬프트 가이드는 이를 신입 직원에 비유합니다. "Claude를 뛰어나지만, 여러분의 규범과 업무 방식에 대한 맥락이 없는 신입 직원이라고 생각하세요." (Anthropic docs) OpenAI도 모델 유형 사이에 비슷한 선을 긋습니다. 추론 모델은 목표를 받아 세부 사항을 스스로 알아내는 "시니어 동료" 같고, GPT 모델은 "특정 결과물을 만들기 위한 명확한 지시"를 줄 때 가장 잘 일하는 "주니어 동료" 같다고 합니다(OpenAI docs).
OpenAI는 추론 모델이 높은 수준의 가이드만으로도 잘 해낸다고 말하지만, 작업이 수십 단계로 이어지고 부수 효과까지 있다면 저희는 그 말을 그대로 믿지는 않겠습니다. 시니어 동료라도 여러분에게 "완료"가 무엇을 뜻하는지는 알 수 없고, 주니어가 잘못 짐작하면 이메일 한 통 값이면 됩니다. 반면 에이전트는 처음 잘못 읽은 내용을 근거로 이후 모든 단계를 실행합니다. Anthropic의 리드 에이전트가 보여준 그대로입니다.
Anthropic이 제안하는 테스트는 2분이면 끝나서 저희도 좋아합니다. "해당 작업에 대한 맥락이 거의 없는 동료에게 프롬프트를 보여주고 따라 해 보라고 하세요. 그 동료가 헷갈린다면 Claude도 헷갈릴 겁니다." (Anthropic docs) 외주 작업자가 여러분의 메시지만 보고는 질문 다섯 개를 보내지 않고서는 시작할 수 없다면, 에이전트는 그 다섯 가지 질문에 말없이 스스로 답해 버리고, 여러분은 결과물을 보고서야 그 사실을 알게 됩니다.
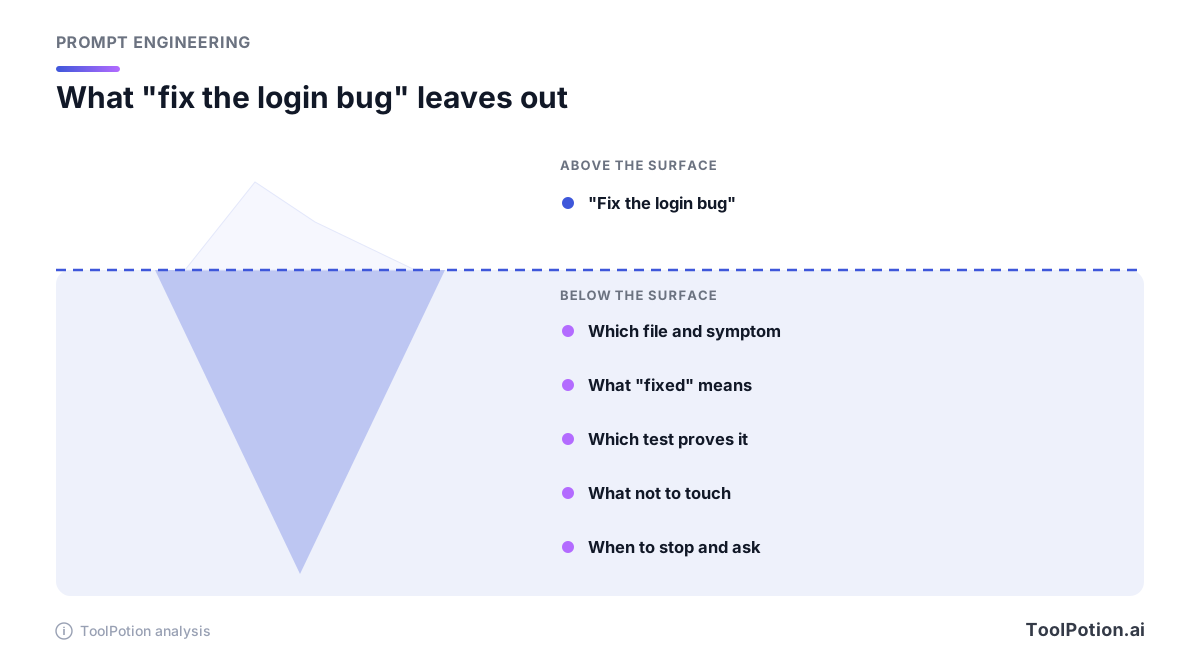
무엇보다 먼저 완료 조건을 쓰세요
Claude Code의 모범 사례 페이지는 단언합니다. "Claude는 작업이 끝난 것처럼 보이면 멈춥니다." 작업이 끝났는지 알려주는 실행 가능한 무언가가 없으면, 페이지는 이렇게 이어집니다. "결국 여러분이 테스트 스위트가 되고, 모든 실수는 여러분이 우연히 알아챌 때까지 그대로 남아 있게 됩니다." (Claude Code docs)
OpenAI의 Codex 가이드는 같은 발상을 반대편에서 접근합니다. 프롬프트에 네 가지를 넣으라고 제안합니다. 목표, 맥락, 제약 조건, 그리고 "Done when"입니다. 마지막은 작업이 완료되기 전에 무엇이 참이어야 하는가라는 질문 형태로 쓰며, "테스트 통과, 동작 변경, 버그 재현 불가 등"이 예로 나옵니다(OpenAI Codex docs). 두 벤더, 두 제품, 하나의 뼈대입니다. 저희는 여기에 두 가지(중단 후 질문, 보고)를 더하고, 완성된 브리프에서는 네 번째에 오더라도 완료 조건 문장을 가장 먼저 쓰겠습니다. 쓰다 보면 내가 무엇을 원하는지 알아내게 되기 때문입니다.
코드 밖에서도 같은 문장이 통하고, 확인 방식만 달라집니다. "공급업체 열두 곳의 표, 모든 가격 옆에 출처 링크, 비공개 가격에는 표시"는 에이전트가 셀 수 있는 조건입니다. "꼼꼼한 비교"는 에이전트가 느낌으로밖에 판단할 수 없습니다.
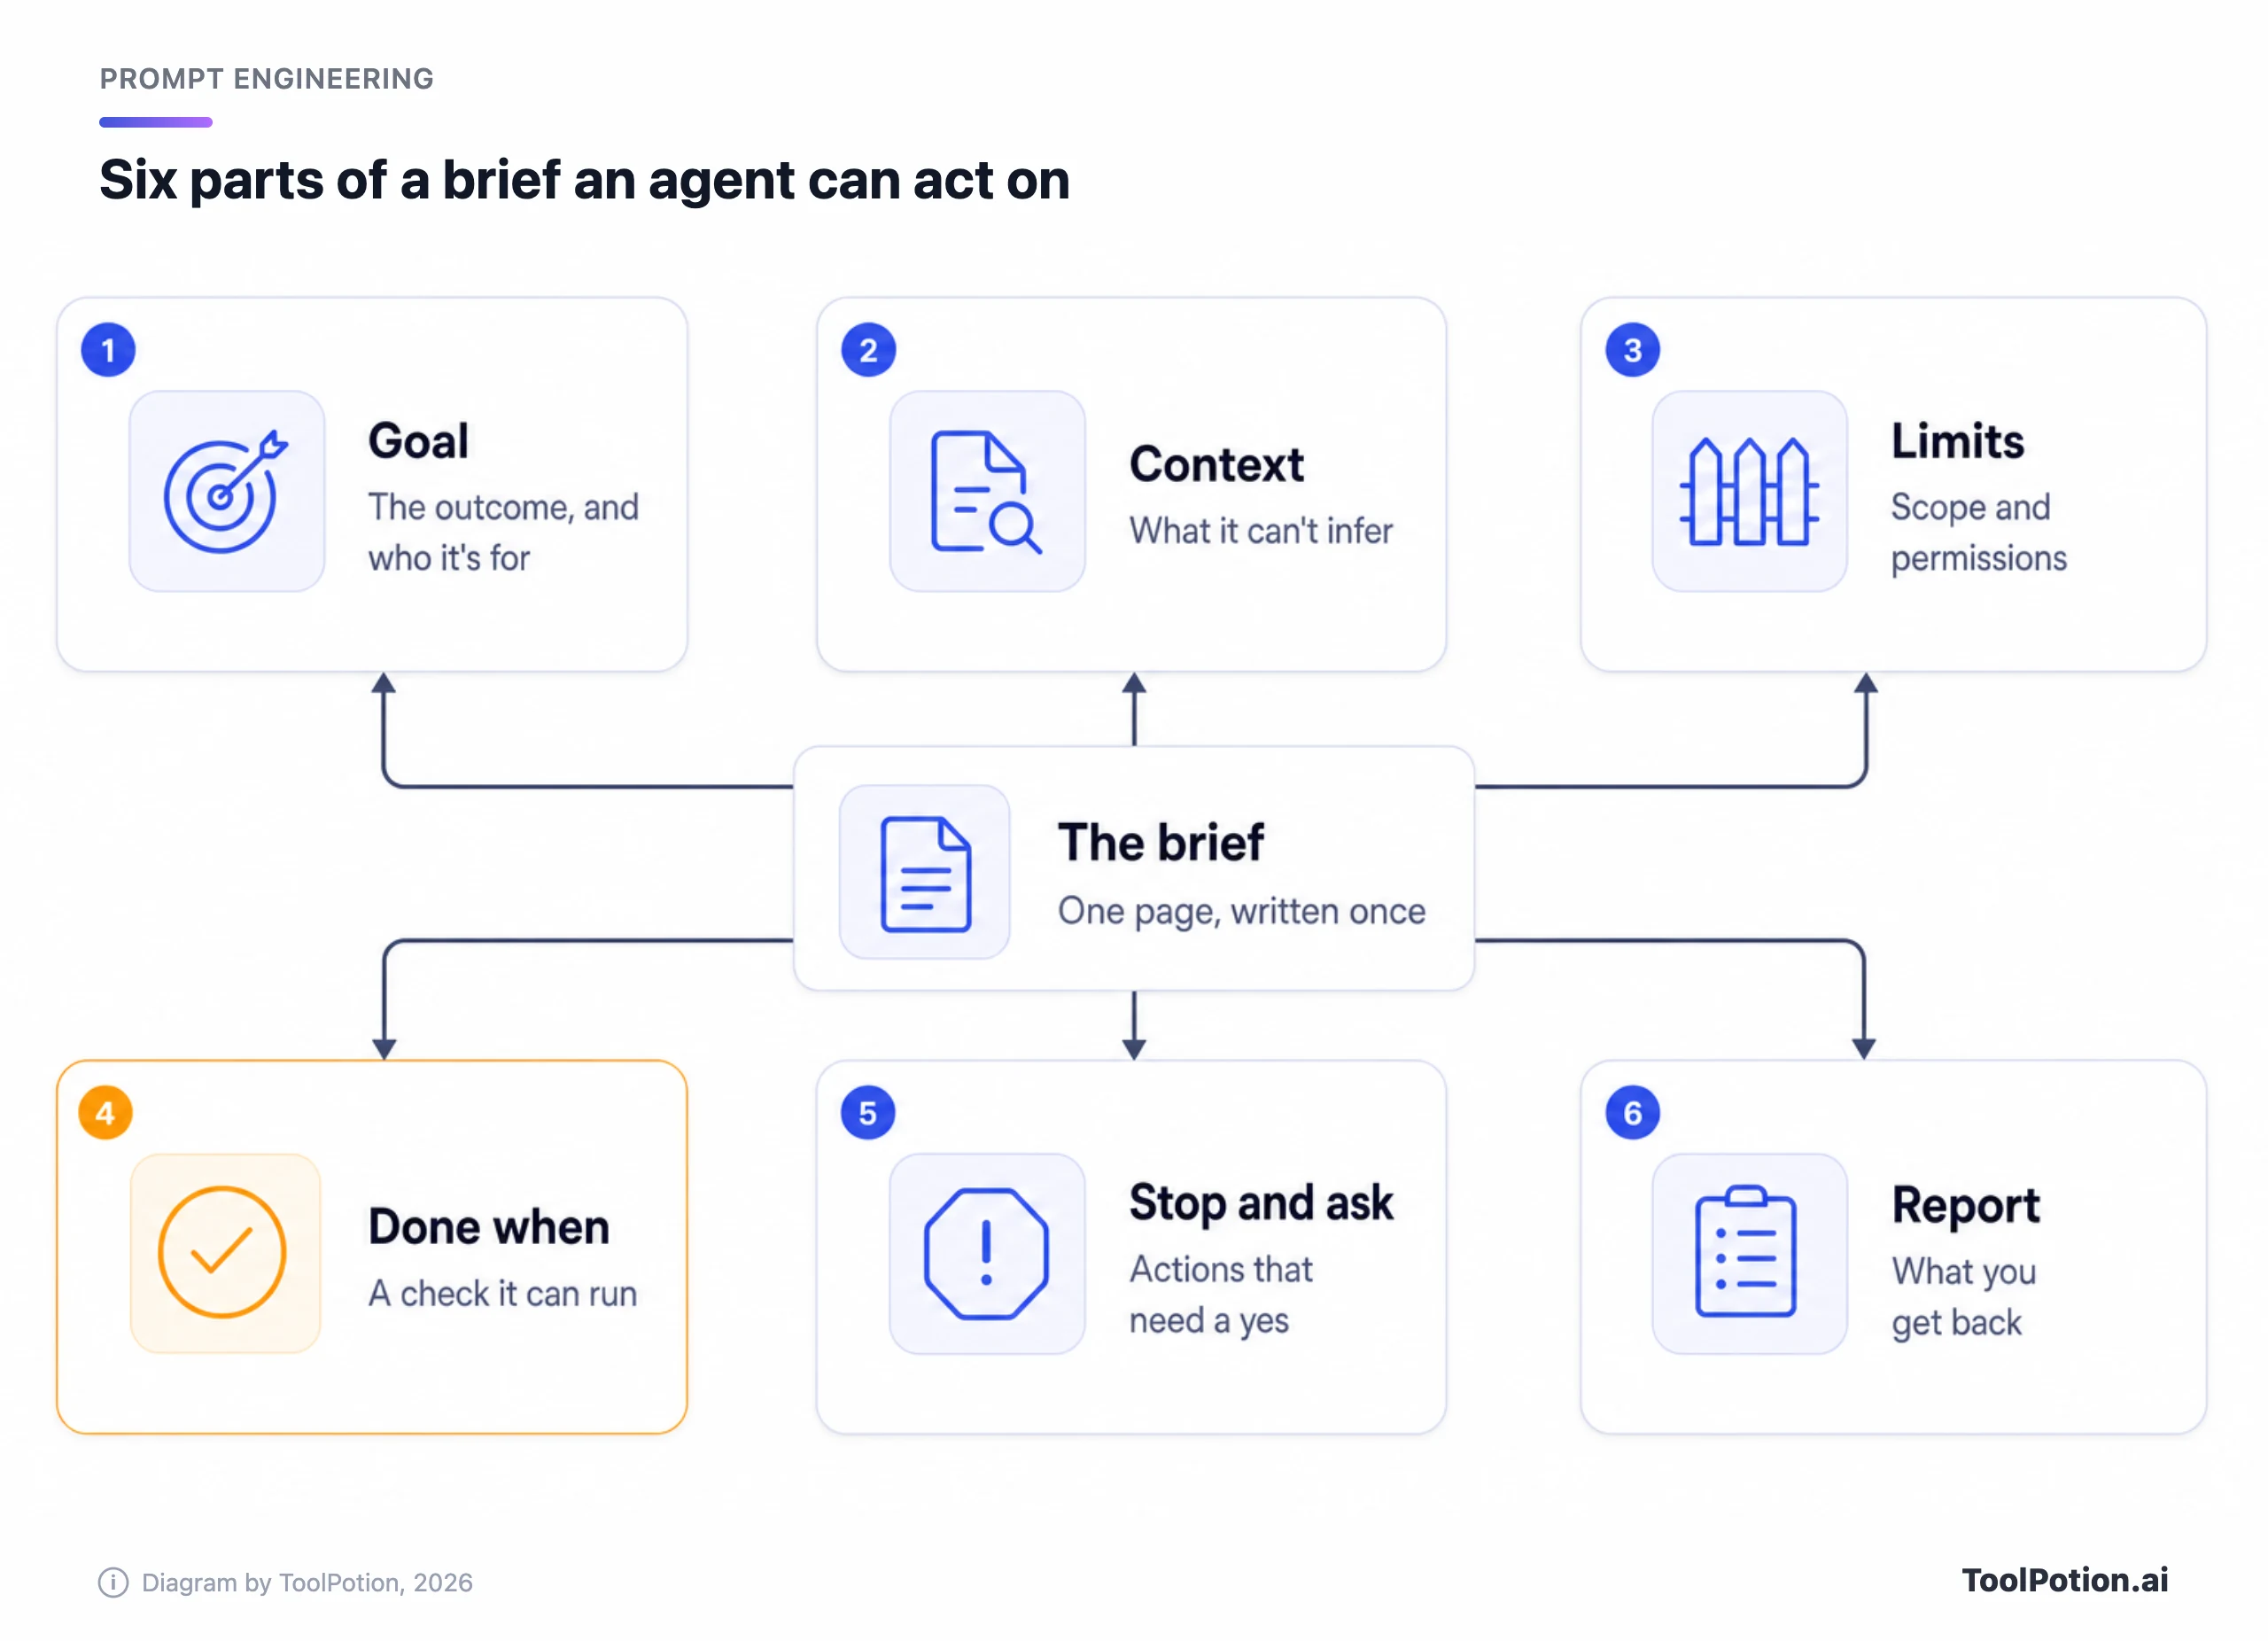
브리프의 여섯 가지 요소, 위에서 아래로
목표는 결과와 그 사용자를 밝힙니다
한두 문장이면 됩니다. 마지막에 무엇을 원하는지, 그 결과가 어디에 쓰이는지 말하세요. 파트너 두 명이 5분 안에 읽을 추천안인지, 금요일에 배포할 수정인지, 구매를 위한 후보 목록인지 같은 것입니다. 목적지가 달라지면 에이전트가 무엇을 넣고 무엇을 뺄지도 달라집니다. "가격을 알아봐"는 분량을 만들어 내고, "좌석당 $15 미만인 도구 하나를 추천해"는 결정을 만들어 냅니다.
맥락은 에이전트가 스스로 찾을 수 없는 모든 것입니다
Claude Code 문서에는 쓸 만한 기준이 있습니다. "코드를 읽으면 찾을 수 있는 내용인가? 실제로 찾아볼 것인가? 둘 다 그렇다면 빼세요." (Claude Code docs) 남겨야 할 것은 저장소에 반영되지 않은 회의 결정, 에이전트가 써야 할 계정, 이미 써 보고 버린 도구, 독자의 수준 같은 것들입니다.
규칙 뒤에 있는 이유도 함께 적으세요. Anthropic의 가이드는 지시 뒤의 맥락이나 동기가 "Claude에게 여러분의 목표에 대한 더 많은 정보를 주고 더 정확한 응답을 내도록 도와준다"고 말하며, 약한 버전의 예로 드는 것은 이유 없는 "NEVER use ellipses"입니다(Anthropic docs).
제한은 범위 안과 범위 밖을 구분합니다
에이전트는 요청받은 것보다 더 많이 하는 경향이 있습니다. Anthropic의 가이드에 따르면 Claude Opus 4.5와 4.6은 "추가 파일 생성, 불필요한 추상화 추가, 요청하지 않은 유연성 구축"을 하는 경향이 있으며, 샘플 지시문으로 "Don't add features, refactor code, or make \"improvements\" beyond what was asked."를 제시합니다(Anthropic docs). 가이드는 이 습관을 해당 두 모델과 연결해 말하므로, 여러분이 쓰는 모델에 맞는지 확인해 보세요. 어느 모델이든 저희는 이 문장을 빌려 쓰겠습니다. 그런 다음 여러분만의 목록을 추가하세요. 건드려도 되는 폴더, 써도 되는 출처, 로그인하면 안 되는 계정 같은 것들입니다.
Google의 Gemini 가이드는 에이전트 프롬프트가 제어하는 설정 중 하나로 위험 평가를 꼽으며, 위험이 낮은 탐색 행동(읽기)과 위험이 높은 상태 변경(쓰기)을 명시적으로 구분할 수 있다고 말합니다(Google AI docs). 이 구분이 핵심입니다. 읽기와 테스트 실행에는 허가증이 필요 없고, 삭제, 전송, 결제에는 필요합니다.
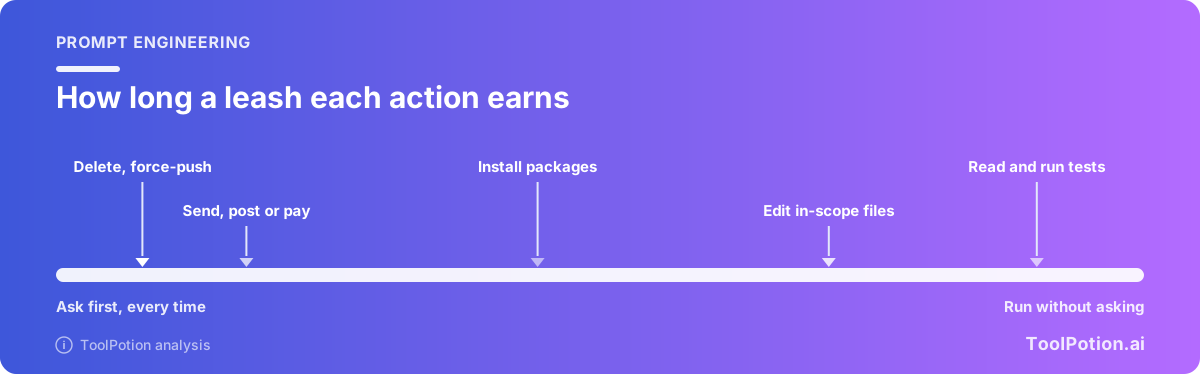
여기에 기대기 전에 한 가지 단서를 달겠습니다. 브리프에 적는 말은 요청입니다. 샌드박스, 읽기 전용 토큰, 권한 규칙은 강제입니다. 둘은 서로를 대체하지 못합니다. 강제 쪽은 AI 에이전트 격리 가이드에서 다루고, 이 글은 여러분이 쓰는 내용에 집중합니다.
완료 조건은 에이전트가 실행할 수 있는 확인입니다
명령어, 개수, 파일을 지정하세요. "테스트 통과"는 시작일 뿐입니다. "pnpm test가 통과하고, 1분에 101번째 요청이 429를 받는다는 것을 증명하는 새 테스트가 있다"가 확인입니다. 리서치라면 항목 수, 필드, 어떤 필드를 찾지 못했을 때 무엇을 적을지를 말하세요. 확인이 실패할 수 있다면 그다음에 무엇을 할지 알려주고, 횟수에 상한을 두세요. Google의 가이드는 "높은 지속성은 성공률을 높이지만 토큰 비용 증가나 루프의 위험이 있다"고 지적하므로, "실패하는 테스트는 두 번 재시도한 뒤 멈추고 보고해"가 아무 말도 하지 않는 것보다 좋은 문장입니다(Google AI docs).
중단 후 질문은 기분이 아니라 행동 목록입니다
"확실하지 않으면 물어봐"는 에이전트에게 판단을 맡기는 것인데, 의욕이 넘치는 에이전트는 좀처럼 확신이 없어지지 않습니다. 대신 행동을 나열하세요. Anthropic의 가이드에는 바로 이 용도의 샘플 프롬프트가 있으며 Claude Opus 4.6용으로 작성되었습니다. "되돌리기 어렵거나, 공유 시스템에 영향을 주거나, 파괴적일 수 있는" 행동은 "진행하기 전에 사용자에게 물어보라"는 내용이고, 파일이나 브랜치 삭제, git push --force, 메시지 전송이 예로 들어 있습니다(Anthropic docs). 어떤 모델을 쓰든 저희가 가져다 쓰겠다는 부분은 이 목록입니다.
Anthropic의 에이전트 설계 에세이는 이 패턴을 설명합니다. 에이전트는 "체크포인트나 장애물을 만났을 때 사람의 피드백을 위해 일시 정지할 수 있다"고 합니다(Anthropic Engineering). 첫 번째 체크포인트는 계획으로 삼으세요. 어떤 변경이든 하기 전에 단계를 요청하고, 읽어 본 뒤, 진행하라고 말하는 겁니다. 한 번 오가는 비용이 들지만, 저희가 보기에 이것이 가장 저렴한 체크포인트입니다.
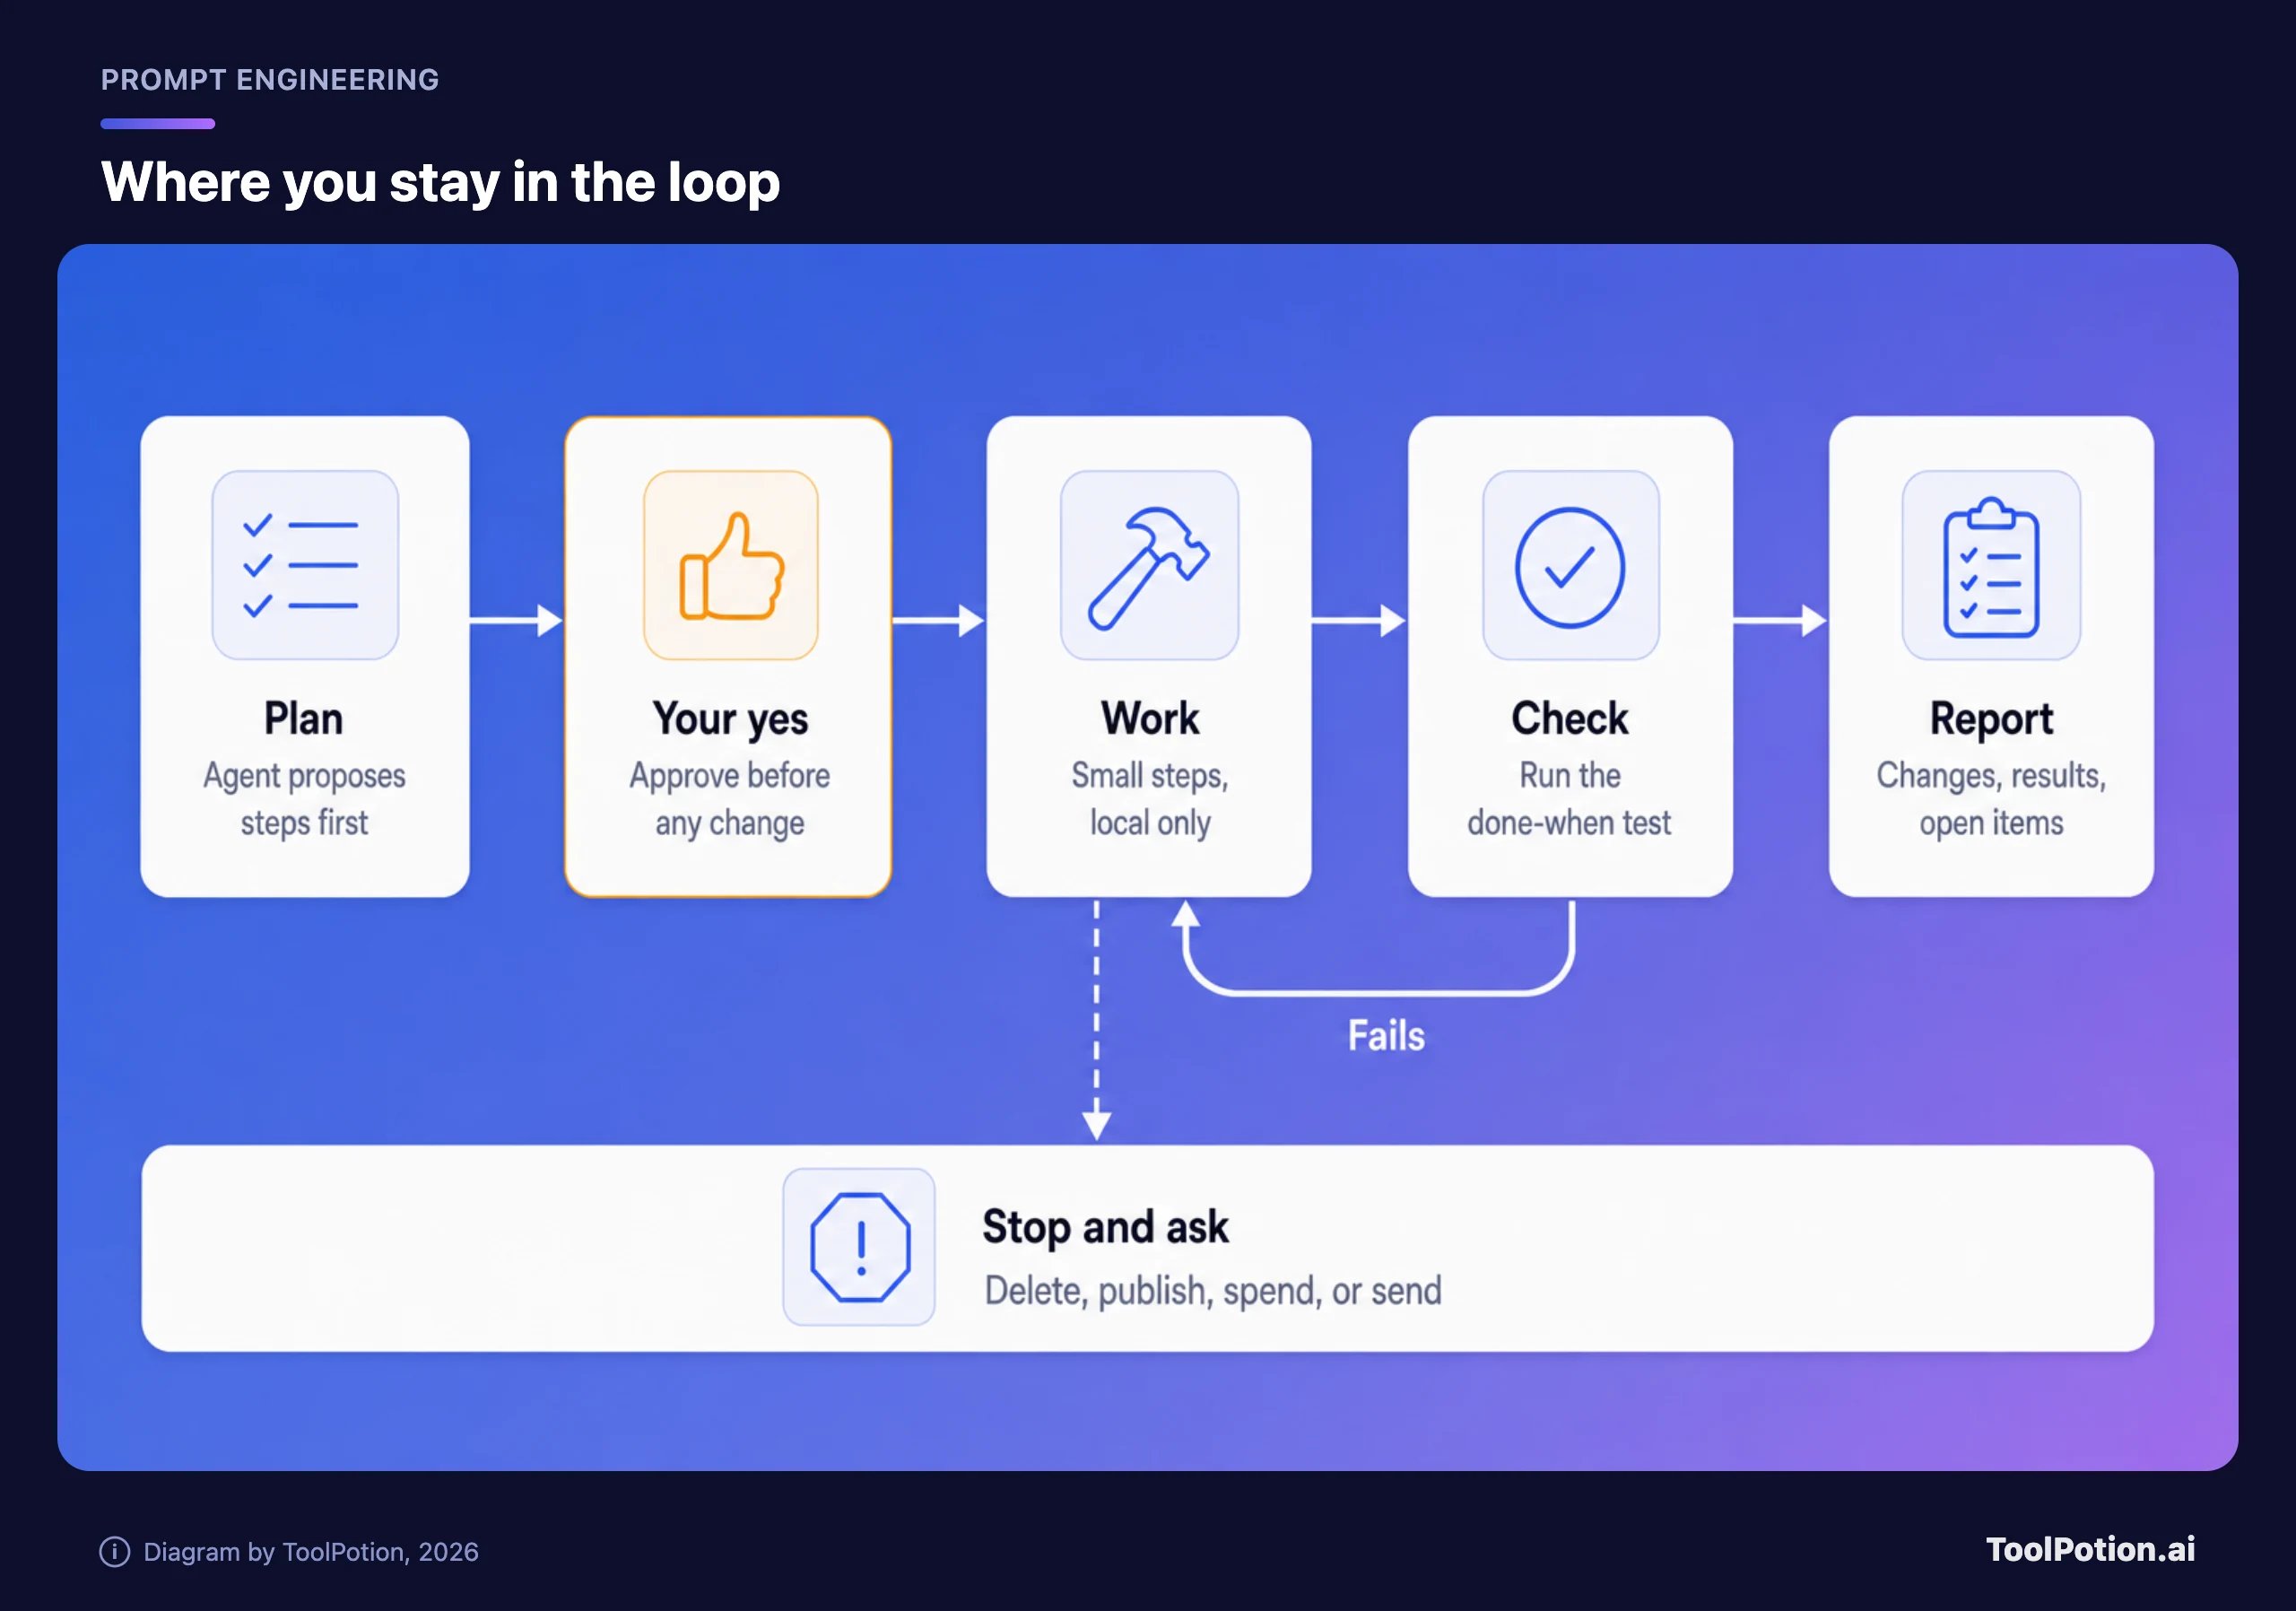
보고는 무엇이 돌아올지 정하는 부분입니다
변경한 내용, 실행한 확인과 그 결과, 에이전트가 가정한 것, 하지 않기로 선택한 것을 요청하세요. 마지막 항목은 사람들이 가장 자주 빠뜨립니다. 스키마를 건드리지 말라고 했기 때문에 마이그레이션을 건너뛰었다고 에이전트가 알려주는 곳이 바로 여기입니다.
브리프 전후 비교 3가지
아래의 재작성본은 각각 120~150단어 정도입니다. 평균적인 프롬프트보다 길고, 사람들이 두려워하는 것보다는 짧습니다. 세 브리프 모두 저희가 직접 지어낸 예시입니다. 작업, 도구, 숫자는 설명을 위해 만든 것이며 어느 벤더나 실제 프로젝트에서 가져온 것이 아닙니다.
리서치 에이전트 (가상의 예시)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.코딩 에이전트 (가상의 예시)
Claude Code 문서에도 자체적인 전후 비교가 있습니다. "캘린더 위젯 추가"가 기존 위젯 파일의 패턴을 따르되 "새 라이브러리는 쓰지 않는다"는 요청으로 바뀝니다(Claude Code docs). 여기서는 같은 방식을 더 큰 작업에 적용했으며, Claude Code나 Codex용으로 쓴 것입니다.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.받은편지함 에이전트 (가상의 예시)
메일에 접근하게 허용하는 모든 어시스턴트에 해당하는 예시이며, Manus나 Claude Cowork 같은 에이전트 제품이 팔리는 용도이기도 합니다. 메일은 "정리해줘"가 조용히 "삭제했어요"가 될 수 있는 곳입니다.
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.Goal 줄은 전후 사이에 거의 달라지지 않습니다. 무게는 마지막 네 줄에 있습니다. 확인, 중단, 보고, 그리고 에이전트가 절대 해서는 안 되는 일을 말하는 제한입니다.
붙여넣어 쓰는 템플릿
해당되지 않는 줄은 지워도 되지만, 의도적으로 지우세요.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
이 템플릿으로 직접 쓴 초안을 점검해 보세요. 예/아니오로 답하는 질문 여덟 개, 30초면 됩니다.
브리프가 실패하는 방식과 저희가 권하는 수정
| 실패 | 나타나는 증상 | 수정 방법 |
|---|---|---|
| 목표가 활동 자체임 | 결정 없이 수 페이지의 결과물 | 결과물이 어디에 쓰이는지 적기 |
| 완료 조건 없음 | "끝난 것처럼 보이면" 멈추거나 끝없이 계속함 | 실행 가능한 확인과 재시도 상한 추가 |
| 범위를 밝히지 않음 | 불필요한 파일, 리팩터링, 요청하지 않은 개선 | 범위 밖인 것을 나열 |
| 이유 없는 경고 | NEVER 줄의 벽, 무시되거나 과하게 적용됨 | 이유를 한 절로 덧붙이기 |
| 승인이 암묵적으로만 존재함 | 스스로 판단해 삭제, 푸시, 전송함 | 행동을 명시하고 먼저 계획을 요청 |
| 수정 지시가 쌓임 | 지시가 서로 모순됨 | 브리프를 다시 쓰고 새로 시작 |
이 중 두 가지는 좀 더 자세히 말씀드리겠습니다. 첫 번째는 대문자 더미입니다. 강조를 더한다고 빠진 이유가 해결된 적이 있다고는 생각하지 않으며, Anthropic의 가이드도 같은 방향을 가리킵니다. 이유 없는 "NEVER use ellipses"가 약한 예시로 나오니까요. Claude Code 문서는 "step by step으로 생각해 라거나 꼼꼼히 해 같은 문구는 키워드가 아니라 평범한 프롬프트 텍스트일 뿐이다"라고 덧붙입니다(Claude Code docs). 그래서 저희는 "꼼꼼히 해" 같은 상투적 문구는 걷어내겠습니다. Anthropic의 가이드는 한 문장이라도 Claude에게 역할을 주라고 권하니 역할 자체를 금지하지는 않겠지만, "세계적인 전문가" 페르소나는 쓰지 않겠습니다. 여섯 가지 요소가 직함보다 에이전트에게 더 많은 것을 알려주기 때문입니다.
두 번째는 반대쪽 문제입니다. OpenAI 가이드의 샘플 에이전트 프롬프트(규칙이 아니라 샘플로, gpt-6-astra 모델용으로 제시됨)는 모델에게 "사용자의 질의가 완전히 해결될 때까지 계속 진행하라"고 하고 "요청의 일부만 완료한 채 멈추지 말라"고 말합니다(OpenAI docs). 결승선이 분명한 작업이라면 합리적이지만, 그렇지 않은 작업에서는 함정입니다. 목표가 모호한 상태에서 끈질기게 구는 에이전트는 루프를 돌며 토큰을 계속 쓸 수 있고, Google의 가이드도 높은 지속성에 대해 같은 말을 합니다. Anthropic의 에세이는 통제를 유지하기 위해 "중단 조건(예: 최대 반복 횟수)"을 넣는 것이 흔하다고 말합니다(Anthropic Engineering).
저희가 버리고 싶은 습관이 하나 더 있습니다. 이미 수정 지시가 열 번 쌓인 스레드에 브리프를 붙여넣는 것입니다. 이러면 에이전트는 열한 벌의 지시를 갖게 되는데, 우선순위를 매길 방법이 없습니다.
첫 1분을 지켜보고, 다시 쓰세요
Claude Code 문서는 이렇게 조언합니다. "첫 1분을 지켜보다가 Claude가 방향을 벗어나는 순간 Esc를 누르고, 두 번 수정에 실패하면 세 번째 수정 대신 /clear를 실행해 더 나은 프롬프트를 쓰세요." (Claude Code docs) 저희는 이를 어떤 에이전트에도 적용하겠습니다. 첫 계획과 처음 몇 번의 행동을 보면 브리프가 의도한 대로 읽혔는지 알 수 있습니다.
아직 브리프를 쓸 수 없다면 에이전트가 여러분을 인터뷰하게 하세요. Claude Code 문서는 "스펙을 쓸 수 있을 때까지 나를 인터뷰한 다음, SPEC.md에 써줘"와 같은 프롬프트를 제안하고, Codex 가이드는 먼저 질문하게 하고 "여러분의 가정에 이의를 제기하게" 하라고 말합니다(Claude Code docs, OpenAI Codex docs). 그런 다음 작성된 스펙으로 새 세션을 시작하세요.
두 번 이상 통하는 브리프는 보관할 자리가 필요합니다. 상시 규칙(테스트 실행 방법, 절대 건드리면 안 되는 것)은 AGENTS.md나 CLAUDE.md 파일에 넣으세요. OpenAI는 "짧고 정확한 AGENTS.md가 모호한 규칙으로 가득한 긴 파일보다 더 유용하다"고 말합니다(OpenAI Codex docs). 반복하는 절차는 스킬이 될 수 있으며, 이는 프롬프트에서 스킬로에서 다룹니다. 애초에 세션에 무엇을 로드할지는 컨텍스트 엔지니어링 글의 주제이고, 모델이 바뀌어도 프롬프트가 계속 통하게 하는 습관은 모델 업데이트에도 살아남는 프롬프트 패턴에 있습니다. 이런 위임을 위해 만들어진 도구가 궁금하다면 AI 에이전트, 에이전트 구축 작업, 프롬프트 엔지니어링 도구 보드를 참고하세요.
자주 묻는 질문
브리프는 얼마나 길어야 하나요?
여섯 가지 요소를 담을 수 있을 만큼이면 되고, 대부분의 작업에서는 100~200단어입니다. 상시 선호 사항은 규칙 파일에 두어서 각 브리프가 이번 작업만 다루게 하세요. 브리프가 한 페이지를 넘어간다면 작업을 둘로 나누는 편이 맞을 가능성이 큽니다.
ChatGPT, Claude, Gemini는 각기 다른 브리프가 필요한가요?
뼈대는 같습니다. OpenAI Codex 가이드의 네 가지 요소, 맥락을 제공하고 위험한 행동 전에 물으라는 Anthropic의 조언, Google의 에이전트 차원(모호성 처리, 위험 평가, 지속성)은 하나의 필요를 서로 다른 말로 설명한 것입니다. 형식은 조금 다릅니다. Google의 가이드는 XML 스타일 태그나 Markdown 제목을 권하며 "하나의 형식을 골라 일관되게 사용하라"고 말합니다(Google AI docs). 어떤 어시스턴트가 어떤 작업에 맞는지는 별개의 문제이며, 2026년 ChatGPT vs Claude vs Gemini에서 다룹니다.
에이전트가 확신이 없을 때 어떻게 하라고 말해야 하나요?
적용할 수 있는 규칙을 주세요. "되돌릴 수 있는 것은 가정하고 보고서에 적어. 그렇지 않은 것은 먼저 물어봐"가 "확신이 없으면 물어봐"보다 잘 통합니다. Google의 가이드도 같은 선택을 모델이 언제 가정을 해도 되고 언제 명확화나 허가를 위해 멈춰야 하는가의 문제로 다룹니다.
좋은 브리프만으로 에이전트를 안전하게 만들 수 있나요?
아닙니다. 브리프는 실수를 줄여 줄 뿐 하나도 막아 주지는 못합니다. Anthropic은 "샌드박스 환경에서의 광범위한 테스트와 적절한 가드레일"을 권장하며(Anthropic Engineering), 저희의 격리 가이드는 권한과 감사 추적을 다룹니다.
그래도 에이전트가 틀렸습니다. 이제 어떻게 하죠?
처음 방향을 벗어난 단계를 찾아서, 그 단계에 대해 브리프가 뭐라고 했는지 살펴보세요. 그 문제를 막았을 한 줄을 추가한 뒤, 새 세션에서 다시 실행하세요.