

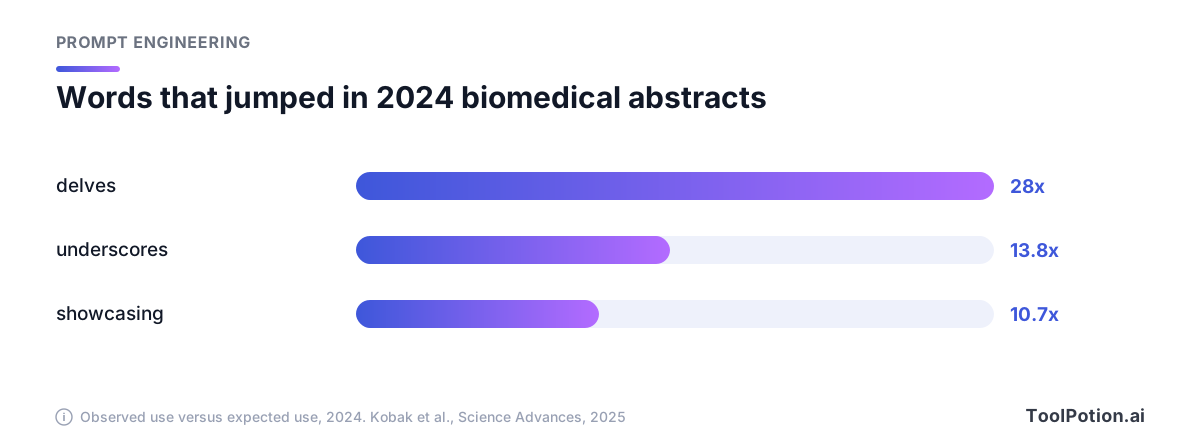
연구진이 PubMed의 생의학 논문 초록 1,500만 건 이상을 분석해, ChatGPT 등장 이후 사용 빈도가 급등한 단어를 찾았습니다. 논문 제목에도 들어간 동사 하나는 2024년 초록에서 기존 추세가 예측한 것보다 28배나 자주 등장했습니다. 다른 두 단어도 각각 13.8배, 10.7배였습니다. Dmitry Kobak과 공저자들은 이 어휘 변화만으로 2024년 초록의 최소 13.5%가 LLM으로 처리되었고, 일부 분야에서는 최대 40%에 이를 수 있다고 추정했습니다(Science Advances, 공개본은 PubMed Central).
이 단어들만으로는 그 과학자들에게 할 말이 있었는지 알 수 없습니다. 기계가 문장에 손을 댔고, 아무도 다시 읽어보지 않았다는 사실만 드러날 뿐입니다.
이 가이드는 초안이 나답게 읽히게 하고, 무엇보다 내가 하려는 말을 제대로 담게 하는 방법을 다룹니다. AI 탐지기를 피하는 방법이 아닙니다. 학교, 학술지, 직장에서 AI 사용이 금지되어 있거나 밝혀야 한다면 그 규칙을 따르십시오. 허용되지 않는 곳에서 기계가 쓴 글을 사람이 쓴 것처럼 내놓는 일은 돕지 않으며, 아래 내용은 어떤 정책도 우회하는 방법이 아닙니다. 그 외의 모든 글(이메일, 게시물, 보고서, 제안서)에 대해, 저희가 실제로 쓰는 작업 흐름을 소개합니다. 위키백과 편집자들의 AI 글쓰기 목록, 어휘 연구, 각 업체의 도움말 페이지를 바탕으로 만들었습니다.
기본 초안은 왜 전부 같은 사람이 쓴 것처럼 들릴까
위키백과의 자원봉사 편집자들은 챗봇이 쓴 글을 정리하는 일을 사실상 업으로 하고 있고, 이들의 안내서는 그 원리를 잘 설명합니다. 이들에 따르면 언어 모델은 "평균으로 회귀"합니다. 가장 넓은 범위의 사례에서 통계적으로 가장 그럴듯한 쪽으로 출력이 쏠린다는 뜻입니다. 두 번째 학습 단계를 거치면 "가장 폭넓게 무난한 문장"을 향해 한 번 더 조정됩니다.
그 결과는 구체적으로 나타납니다. 드문 사실이 흔한 설명으로 바뀝니다. 편집자들이 드는 예로, 아주 구체적인 "최초의 열차 연결 장치 발명가"가 "산업계의 혁명적 거인"이 됩니다. 이들의 비유로는 대상이 선명한 사진에서 흐릿한 스케치로 바뀌고 찬사만 더 커지는 셈입니다.
내 문체는 바로 평균이 지워 버리는 곳에 있습니다. 어색한 숫자, 고유명사, 조금 쑥스러운 의견, 긴 문장 뒤에 오는 짧은 문장 같은 것들입니다.
단어 목록을 중심으로 대응책을 짜지 말아야 할 이유가 하나 더 있습니다. 단어가 계속 바뀐다는 점입니다. 같은 위키백과 페이지에 따르면 앞서 말한 그 동사는 2023~2024년에 ChatGPT가 유난히 남용했지만 2025년에는 급격히 줄었고, 모델 세대마다 선호하는 단어도 다르게 정리되어 있습니다. 모두가 탓하던 엠 대시(em dash)에 대해서는, 다른 신호와 함께 볼 때 가장 유용하며 일부 최신 챗봇은 아예 쓰지 않도록 만들어졌다고 합니다. 어휘가 아니라 글의 형태를 잡아내십시오.
사람은 이를 잘 알아보지 못합니다. 이 페이지는 사람들이 우연보다 나을 게 없었던 2025년 연구를 인용하고, 독일어 학위논문을 대상으로 한 다른 연구에서는 독자가 AI 글의 57%, 사람 글의 64%만 맞혔다고 전합니다. 한편 전문 주석자 집단이 AI 글의 90%를 가려냈다는 2025년 프리프린트도 인용합니다.
직접 쓴 글 다섯 편으로 시작하기
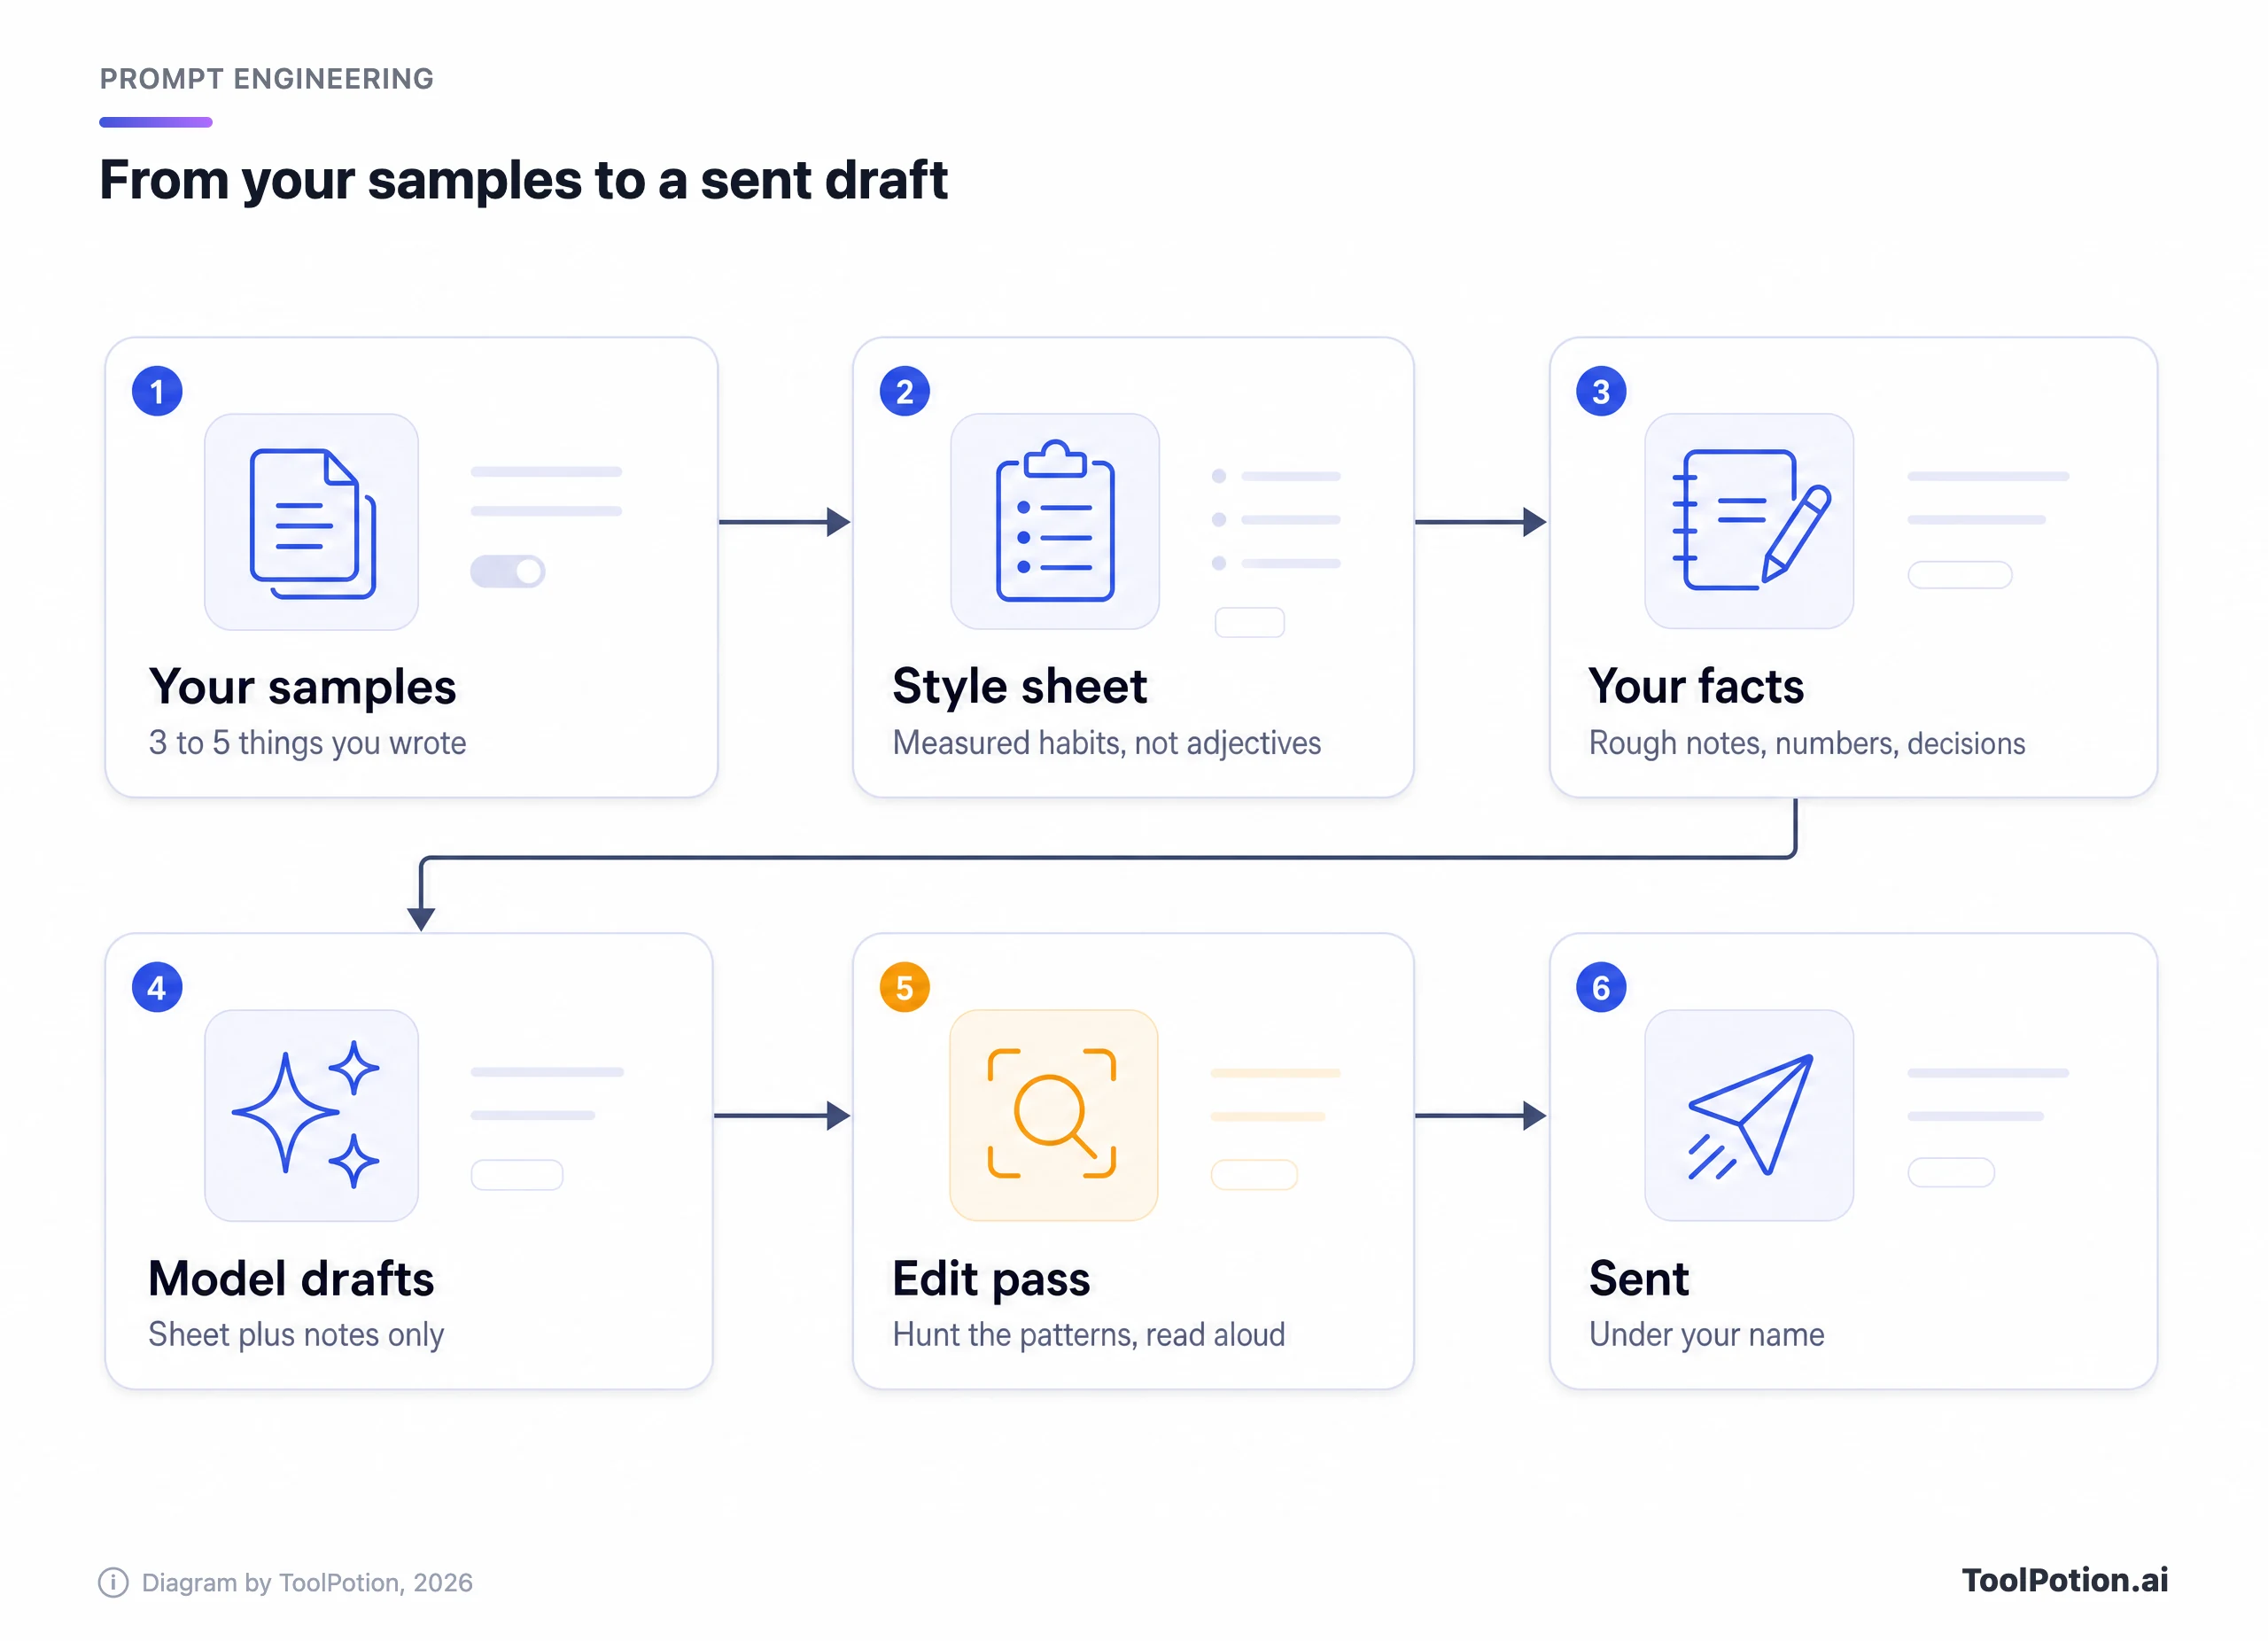
모델의 도움 없이, 실제 독자를 위해 직접 쓴 글을 세 편에서 다섯 편 고르십시오. 동료에게 보낸 이메일, 마음에 들었던 게시물, 신입에게 뭔가를 설명한 Slack 메시지처럼 각각 300~600단어 분량이면 됩니다. 제가 읽어 본 도움말 중에는 샘플이 몇 개면 충분한지 알려 주는 곳이 없습니다. 저희의 경험칙은 어떤 버릇이 두 번은 나타날 만큼입니다.
빠르게 쓴 다듬지 않은 글을 고르십시오. 친한 동료에게 휘갈겨 보낸 메모가 고객에게 공들여 쓴 문단보다 낫습니다. AI 초안을 다듬어 만든 글은 빼야 합니다. 모델에게 모델 자신의 버릇을 다시 가르치는 셈이기 때문입니다.
붙여넣기 전에 이름과 기밀 정보를 지우고, 낯선 사람이 읽는 것처럼 한 번 훑어보십시오. 기본 초안은 절대 하지 않는데 내가 하는 것이 무엇인지 찾아보는 겁니다.
스타일 시트에는 형용사가 아니라 습관을 적습니다
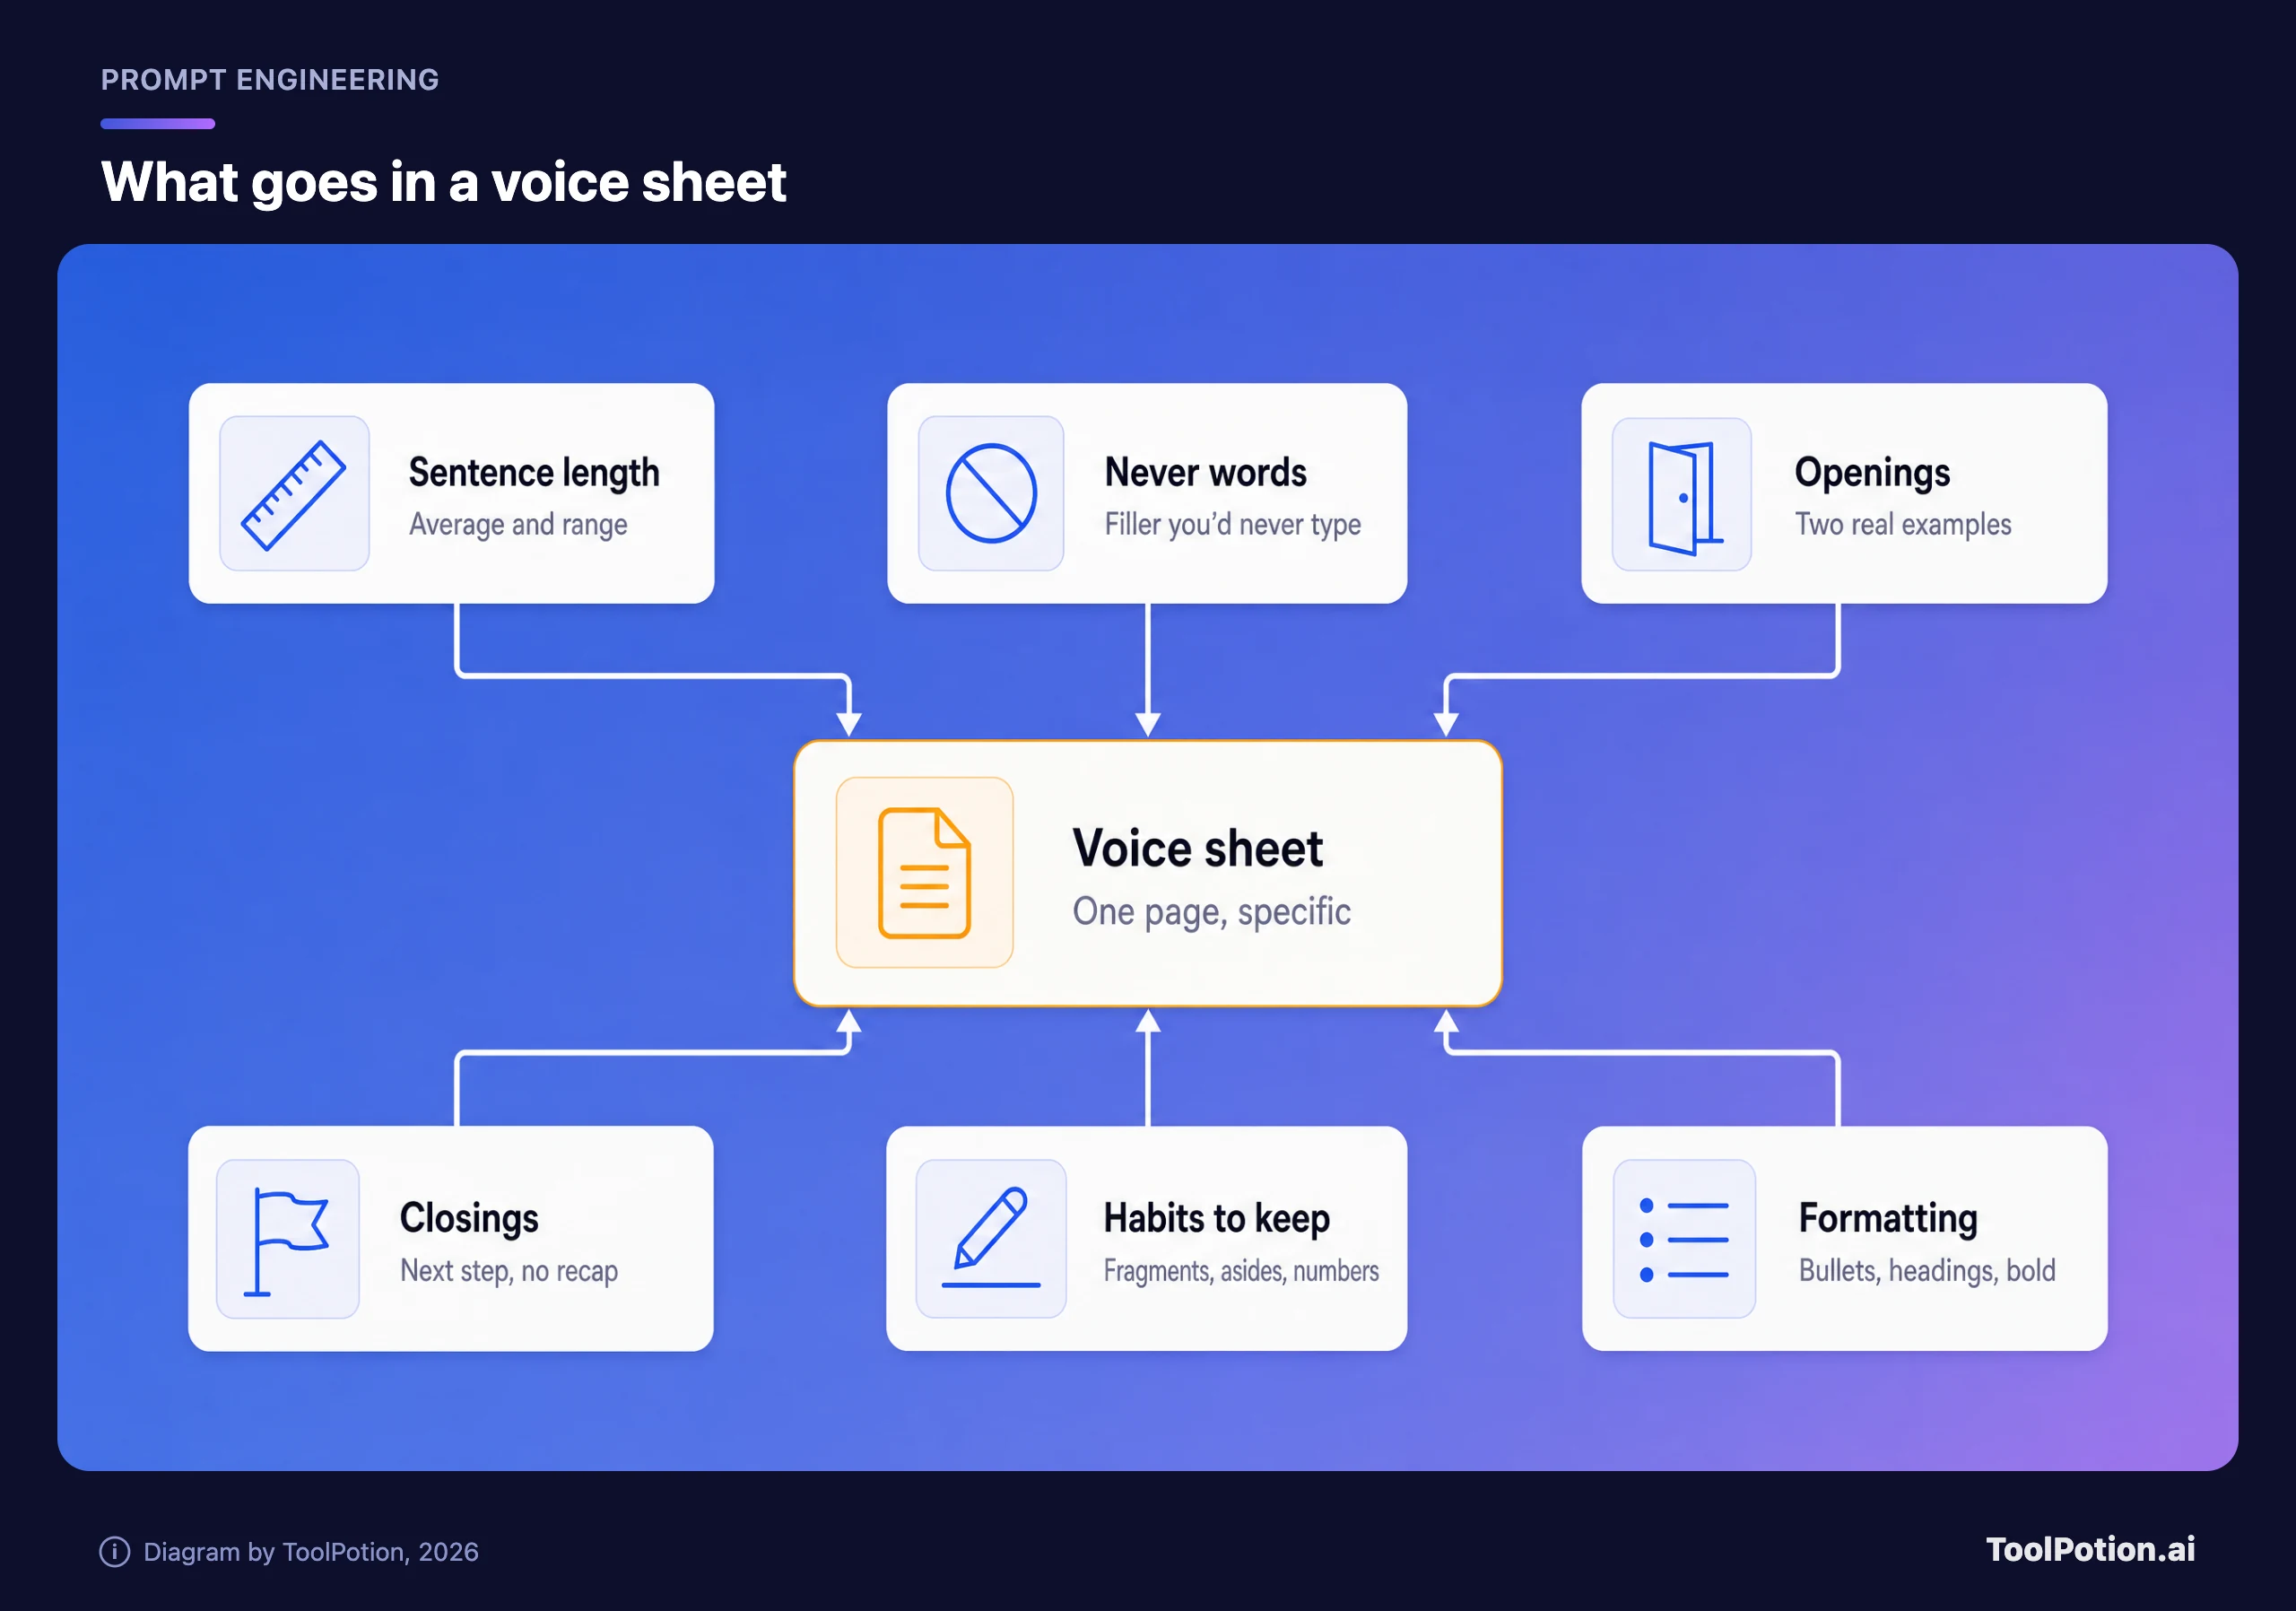
스타일 시트는 내 글에 대한 관찰을 적은 한 페이지짜리 문서로, 이것만 보고 누군가 나를 흉내 낼 수 있을 만큼 구체적이어야 합니다. 형용사는 쳐 주지 않습니다. "따뜻하지만 전문적인"은 수백만 명에게 해당하는 말입니다. 나를 설명하는 것은 측정값과 습관입니다. 적어둘 만한 것은 여섯 가지입니다.
- 문장 길이. 몇 문단의 단어 수를 세어 보십시오. 평균이 14단어쯤이고 3단어에서 35단어까지 오간다면 그렇게 적고, 긴 문장 뒤에 짧은 문장이 온다는 점도 적습니다.
- 절대 쓰지 않는 단어와 표현. 샘플을 훑어 내가 절대 치지 않을 상투적인 말을 찾고, 마음에 안 들어 버린 초안에서 발견한 것도 추가합니다.
- 시작하는 방식. 답으로, 숫자로, 질문으로, 사과로 시작합니까? 실제 도입부 두 개를 인용하십시오.
- 끝내는 방식. 그냥 끝내거나 다음 단계와 이름으로 마무리하는 사람이 많습니다. 내 방식이 어떤지 적고, 요약 반복은 하지 않는다고 적으십시오.
- 모델이 매끈하게 다듬어 버릴 습관. 문장 조각, 괄호, "그리고"로 시작하는 문장, 1인칭, 건조한 농담, 정확한 수치를 꼭 밝히는 버릇 등입니다.
- 서식. 글머리 기호를 아예 쓰는지, 문단은 얼마나 긴지, 소제목은 어떻게 다는지, 줄임말(축약형)을 쓰는지(대부분 씁니다).
실제로 쓴 문장 두세 개를 예시로 덧붙이십시오. 모델은 설명보다 예시를 더 잘 따라 합니다.
다음은 가상의 운영 매니저 Dana를 위해 저희가 압축해서 쓴 시트입니다. 형식을 보여 주는 용도이니 그대로 베끼지 마십시오. 여러분의 시트는 달라야 합니다.
VOICE SHEET: Dana
Sentences: average 14 words, range 3 to 35. A short one after every long one.
Openings: the answer first, or the number. Never a greeting line, never "I wanted to".
Closings: the next step and who does it. No recap, no offer to help further.
Contractions always. First person plural for the team, "I" for opinions.
Parentheses for asides, maybe one per email. Fragments are fine.
Never writes: "touch base", "circle back", "moving forward", "going forward", "leverage", "stakeholders", "ensure".
Numbers as digits, with units. Dates as "Thursday the 12th".
No bullets in emails under 200 words. No bold. No headings.
Examples of my sentences:
- "The vendor took nine days, not two."
- "We can cut invoices from this release. Nothing else can slip safely."
- "Not great, but fixable."
샘플을 주고 모델에게 시트 초안을 쓰게 할 수도 있지만, 모든 줄을 내가 실제로 쓴 문장과 대조해 확인하십시오. 모델은 작가를 평균적인 모습으로 묘사합니다. 내 문장 중 어느 것도 따르지 않는 규칙이라면 지우십시오.
도구별로 시트를 넣는 위치
주요 어시스턴트에는 모두 상시 지침을 넣는 곳이 있습니다. 들어가는 글자 수는 서로 다르고, 예시까지 갖춘 완전한 시트는 일부 도구가 허용하는 분량을 넘습니다.
| 도구 | 문체를 넣는 위치 | 업체 페이지의 설명 | 유의점 |
|---|---|---|---|
| ChatGPT | Settings → Personalization → Custom Instructions | 모든 대화에 즉시 적용됩니다. 한도는 Free와 Go가 1,500자, Plus, Pro, Business, Enterprise, Education이 5,000자 | 짧은 시트를 넣고, 예시는 대화 맨 위에 붙여넣기 |
| Claude | Settings → Your Claude → Instructions, 또는 프로젝트 지침 | 계정 전체 지침, 프로젝트 단위 지침, 그리고 "내 글을 바탕으로 한 커뮤니케이션 패턴"을 위한 skills | Anthropic의 개인화 페이지에는 지침, 프로젝트 지침, skills가 나와 있으며 별도의 스타일 기능은 없음 |
| Google Gemini | Gem: 이름, 지침, 선택 사항인 지식 파일 | Gemini가 Gem 지침을 대신 다시 써 줄 수 있음 | Google은 개인 계정의 Gem이 곧 skills로 전환될 예정이라고 밝힘 |
| Grammarly Humanizer | 글쓰기 샘플을 붙여넣어 맞춤 보이스 생성 | 프리셋 스타일 네 가지와, 샘플에서 학습해 이후 다시 쓰기에 적용하는 맞춤 보이스 | 이미 있는 글을 다시 써 주는 도구입니다. 빠뜨린 사실까지 채워 주지는 못함 |
출처: OpenAI, Anthropic, Google, Grammarly.
저희가 고른 방법은 평범합니다. 원본은 직접 관리하는 일반 텍스트 파일에 두고, 필요한 곳마다 붙여넣는 것입니다. 업체들은 이런 기능의 이름을 바꾸거나 없애기도 하는데(Google은 개인 계정의 Gem이 skills로 전환될 예정이라고 합니다), 어디에든 붙여넣을 수 있는 시트는 그런 변화에도 살아남습니다. 프롬프트를 재사용 가능한 형태로 만드는 방법은 재사용 가능한 AI 지침을, 영리한 표현보다 맥락이 중요한 이유는 컨텍스트 엔지니어링을 참고하십시오.
Grammarly의 샘플 기반 맞춤 보이스는 방향이 옳지만, "AI humanizer"라는 이름으로 판매됩니다. Grammarly의 FAQ는 이 도구가 "AI 탐지기를 우회하기 위한 것이 아니"라고 밝히며, 학술이나 업무용 글에서는 AI 도움을 받았다고 밝히기를 권합니다. 저희도 같은 방식으로, 내 습관을 학습하는 교정 편집자로 쓸 것입니다. AI humanizer 카테고리의 다른 제품들은 약속하는 바가 다를 수 있으니 각 제품의 약관을 읽어 보십시오. 더 폭넓은 도구는 글쓰기 어시스턴트 비교와 Grammarly와 QuillBot 비교에서 다룹니다.
내 사실을 주고 나서 초안을 요청하기
시트는 표면을 바로잡아 줍니다. 내용은 내가 줘야 합니다. 초안을 요청하기 전에, 원재료를 날것 그대로 적어 보십시오. 무슨 일이 있었는지, 숫자, 결정 사항, 독자가 해 주기를 바라는 일입니다. 대충 열 줄이면 충분합니다. 그런 다음 모델에게 이 자료만 쓰고, 빠진 사실은 채워 넣지 말고 나에게 물어보고, 시트를 따르라고 지시하십시오.
가장 중요한 것은 "나에게 물어봐"라는 지시입니다. 추측이 허용된 모델은 추측하고, 그 추측은 뻔하고, 듣기 좋고, 그럴듯한 종류입니다. 이런 지시를 내리는 구체적인 방법은 프롬프트 엔지니어링 가이드에서, 이메일에 적용하는 방법은 이메일 가이드에서 다룹니다.
업데이트 메일 하나, 전과 후
아래 두 버전은 차이를 보여 드리려고 저희가 직접 쓴 것입니다. 첫 번째는 챗봇에게 "고객에게 보낼 지연 관련 프로젝트 업데이트를 써 줘"라고 했을 때 나오는 전형적인 기본 초안입니다. 두 번째는 Dana가 열 줄짜리 메모와 시트를 모델에게 주고, 이어서 직접 편집한 뒤 보낼 글입니다.
| 전형적인 AI 초안 (저희가 만든 예시) | 스타일 시트로 편집한 초안 (이것도 저희가 만든 예시) |
|---|---|
| Subject: Project Update. I hope this message finds you well. I wanted to take a moment to provide an update on the project timeline. Our team has been working diligently to ensure we deliver a high-quality product, and we remain committed to transparency. Unfortunately, we have encountered some unforeseen challenges that have impacted our schedule. Moving forward, we will continue to prioritize clear communication and collaboration. Please don't hesitate to reach out if you have any questions. | Subject: We're a week late. The payment provider took nine days to approve our test account, not the two they quoted, so we couldn't test checkout until Monday. It works now. New date is Thursday the 12th. If that breaks your press embargo, call me and we'll cut invoices from this release, which is the only piece that can slip without breaking anything else. Dana |
무엇이 바뀌었는지 세어 보십시오. 두 번째 버전이 더 짧긴 하지만 핵심은 그게 아닙니다. 9일, 2일, 월요일, 목요일, 그리고 고객이 바로 움직일 수 있는 결정이 들어 있습니다. 이 중 모델이 내놓은 것은 하나도 없고, 낼 수도 없었습니다. 개선의 대부분은 사실이고, 문체 작업은 그 위에 얹힌 것입니다. 첫 번째 초안에는 거짓이 없습니다. 하지만 누구나 어떤 일에 대해서든 보낼 수 있는 글입니다.
편집 단계에서 찾아낼 여덟 가지
이 부분은 출력해 두십시오. 이 패턴들은 실제 문서, 초안, 토론 페이지의 사례를 바탕으로 한 위키백과 목록에서 가져왔습니다. 가운데 열은 각 패턴을 설명하며, 해당 페이지가 직접 보여 주는 표현도 몇 개 넣었습니다.
| AI 티가 나는 패턴 | 어떻게 나타나는가 | 해결법 |
|---|---|---|
| 부풀린 의의 | 평범한 사실을 전환점, 유산, 더 큰 흐름 속의 역할로 포장함 ("marking a pivotal moment", "reflects broader") | 문장을 지우거나, 그 문장이 부풀리던 평범한 사실로 바꿉니다 |
| 분사구문 꼬리 | 사실의 의미를 독자에게 알려 주는 "-ing" 해설로 끝나는 문장 | 나눕니다. 주장을 별도 문장으로 쓰거나, 뒷받침할 수 없으면 뺍니다 |
| 부정 병렬 | "It's not just X, it's Y"와 그 사촌 격인 "not X, but Y" | Y만 말합니다 |
| 모호한 출처 | 추적할 수 없는 주장에 이름 모를 전문가, 보고서, 관찰자를 끌어다 씀 | 누가 말했는지 밝히고 링크를 걸거나, 빼십시오 |
| 3의 법칙 | 반사적으로 나오는 형용사 세 개, 또는 병렬 절 세 개 | 사실인 한두 개만 남깁니다 |
| 생각처럼 꾸민 서식 | 모든 글머리 기호 앞의 굵은 라벨, 제목의 단어마다 대문자, 글머리 기호 대신 이모지 | 평범한 문장으로 쓰고, 항목이 서로 독립적일 때만 목록을 씁니다 |
| 깔끔하게 정리한 전망 문단 | 글을 되풀이하는 "과제와 향후 전망" 마무리 섹션 | 마지막 구체적인 요점이나 다음 단계로 끝냅니다 |
| 어시스턴트의 잔재 | 맨 위의 인사말, 맨 아래의 수정 제안, 본문에 남은 대괄호 자리표시자 | 전부 지우고, 대괄호를 검색합니다 |
이 목록을 쓸 때 주의할 점이 두 가지 있습니다. 먼저, 이 목록은 위키백과 편집자들이 밝히지 않은 AI 글을 가려내려고 만든 것이며, 이들은 이 신호들을 문제 자체로 취급하지 말라고 경고합니다. 이들의 표현으로는 "이 신호들을 단순히 고쳐야 할 문제로만 다루지 마십시오. 그러면 탐지가 더 어려워질 뿐일 수 있습니다." 저희는 이 목록을 알맹이 없는 문장을 찾는 편집 도구로 씁니다. 과장은 대개 할 말이 없었다는 뜻이므로, 해결책은 더 나은 단어가 아니라 사실입니다.
다음으로, 이 페이지에는 "효과 없는 지표" 목록이 있습니다. 완벽한 문법, 격식체와 구어체의 혼용, 출처 없는 내용은 사람의 글에서도 나타납니다. 내 시트에 적힌 내 방식과 다른 부분만 고치고, 내 버릇은 남겨 두십시오.
초안을 한 번 소리 내어 읽으면서 걸리는 곳마다 표시하십시오. 그다음 표를 따라 점검하십시오. 마지막으로 남은 문장마다 어떤 사실, 이름, 숫자를 담고 있는지 물어보십시오. 없다면 잘라내십시오.
모델에게 맡기지 말아야 할 세 가지
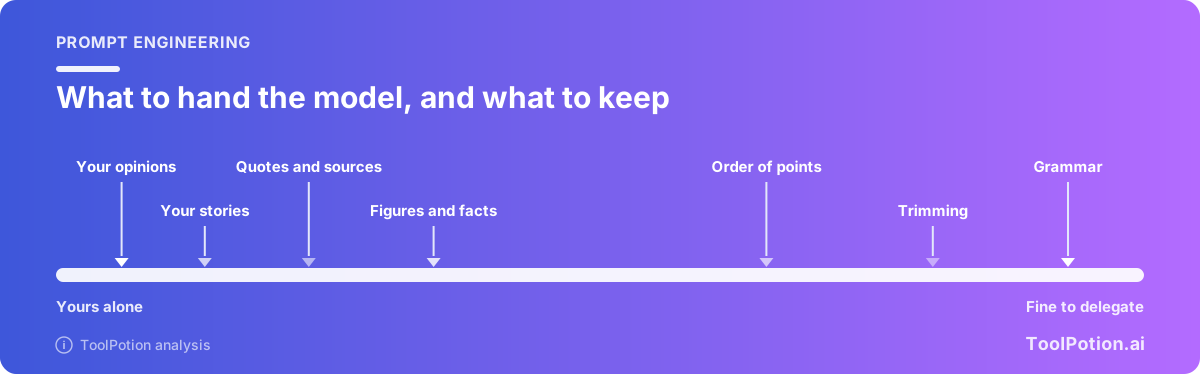
스타일 시트는 표현을 다루는 도구인데, 모델이 아무것도 모르는 영역까지 헤매게 두고 싶은 유혹이 생기기 쉽습니다. 저희는 세 가지에 확실히 선을 긋겠습니다.
내가 갖고 있지 않은 의견. 강한 주장을 요청받은 모델은 내 문체로 자신 있게 써 줄 텐데, 이는 밋밋한 글보다 더 나쁩니다. 아직 마음을 정하지 못했다면 "아직 결정하지 못했습니다"라고 쓰십시오.
일어나지 않은 일화. "최근 한 고객이 말하길"은 세상에 대한 주장입니다. 지어낸 것이라면 1인칭으로 거짓말을 한 것이고, 모델은 이런 문장을 아주 쉽게 씁니다.
아무도 하지 않은 말, 존재하지 않는 출처. 위키백과 페이지에는 그럴듯하게 들리지만 아무 데도 닿지 않는 참고문헌 목록이 기록되어 있고, "이 문장에 추가된 참고문헌이 존재하지 않았다"는 편집 사례도 있습니다. 초안의 모든 숫자, 인용, 링크는 누가 입력했든 내가 검증해야 합니다.
나머지는 모델에게 맡겨도 좋습니다. 내 메모에 질문하기, 순서 찾기, 다듬기, 문단을 여는 여러 방법을 내놓아 내가 썼을 법한 것을 골라 가져가게 하기 등입니다.
자주 묻는 질문
이렇게 하면 AI 탐지기를 통과할 수 있나요?
그런 용도로 만든 방법이 아니고, 저희도 약속하지 않습니다. 위키백과 편집자들은 GPTZero나 Pangram 같은 탐지기가 "우연보다는 낫게 작동"하지만 "무시할 수 없는 오류율"이 있으며, 점수가 높다는 것만으로는 증거가 되지 않는다고 말합니다. 점수가 깨끗하다고 해서 무엇이 증명되는 것도 아닙니다. 학교나 직장에서 AI 사용을 금지한다면 그 규칙을 따르는 것이 답입니다.
AI를 썼다고 밝혀야 하나요?
그 글이 가는 곳의 규칙을 따르십시오. AI의 도움을 받은 이메일을 개의치 않는 직장은 많지만, 학술지, 수업, 일부 고객은 그렇지 않습니다. 확신이 없으면 물어보십시오.
모델이 바뀌어도 시트가 계속 통할까요?
형태 수준의 규칙은 대체로 유지되지만, 단어 수준의 규칙은 금세 낡습니다. 위키백과 페이지는 모델 세대마다 선호하는 단어가 다르다고 정리하고 있으니, 몇 달에 한 번씩 "절대 쓰지 않는 표현" 줄을 다시 읽고 새로 받은 기본 초안과 비교해 보십시오.
고객 업무 자료를 스타일 도구에 붙여넣어도 괜찮을까요?
먼저 업체의 데이터 약관을 확인하십시오. 예를 들어 OpenAI 페이지는 사용자가 거부(opt out)하지 않으면 custom instructions를 사용한 정보가 모델 성능 개선에 쓰일 수 있다고 밝힙니다. 어느 쪽이든 샘플에서는 이름과 기밀 정보를 지우십시오.