

AI 출력물을 팩트체크하면서 허우적대지 않으려면 모든 문장을 검증하겠다는 생각부터 버려야 합니다. 주장을 뽑아내고, 틀렸을 때 무엇이 무너지는지를 기준으로 순위를 매긴 뒤, 글의 근간이 되는 주장은 원본 출처와 대조하십시오. 깔끔해 보이는 인용도, 모델이 말하는 "네, 확실합니다"도 아무것도 증명하지 못하기 때문입니다.
이 단계를 건너뛰는 대가는 계속 커지고 있습니다. AI가 만들어낸 허위 내용이 포함된 법원 판결을 모은 공개 데이터베이스에는 이 글을 쓰는 시점에 2,125건이 기록되어 있고, 그중 1,193건이 올해 한 해에 나왔습니다(AI Hallucination Cases database). 올해 초에는 KPMG가 AI 환각으로 보이는 문제 때문에 발간한 보고서를 회수했습니다. 보고서에서 AI 활용 사례로 언급된 조직들이 해당 내용을 "사실이 아니거나 오해의 소지가 있다"고 지적한 뒤였습니다(TechCrunch).
환각은 사라지지 않았습니다. 오히려 찾아내기가 더 어려워졌습니다. 주변 문장이 유려하고, 가짜 참고문헌이 진짜처럼 보이기 때문입니다. 이 글에서는 가장 자주 틀리는 주장 유형, 자체 점검이 부족한 이유, 바로 쓸 수 있는 프롬프트를 곁들인 위험도별 워크플로, 그리고 Gemini Notebook(구 NotebookLM), Perplexity, Consensus 같은 근거 기반 도구에 대한 솔직한 평가를 다룹니다.
가짜 인용은 이제 법정의 단골 소재입니다
이 문제를 가장 먼저, 그것도 공개적으로 겪은 쪽은 변호사들입니다. Damien Charlotin의 데이터베이스는 법원이나 재판소가 당사자가 환각 콘텐츠(대개 존재하지 않는 판례)에 의존했다고 판단하거나 시사한 판결을 기록합니다. 지금까지 제출된 모든 가짜 인용을 세려는 것이 아니라, 법원이나 재판소가 서면으로 다룬 사례만 집계합니다. 이렇게 좁은 기준을 적용해도 증가 곡선은 가파릅니다.
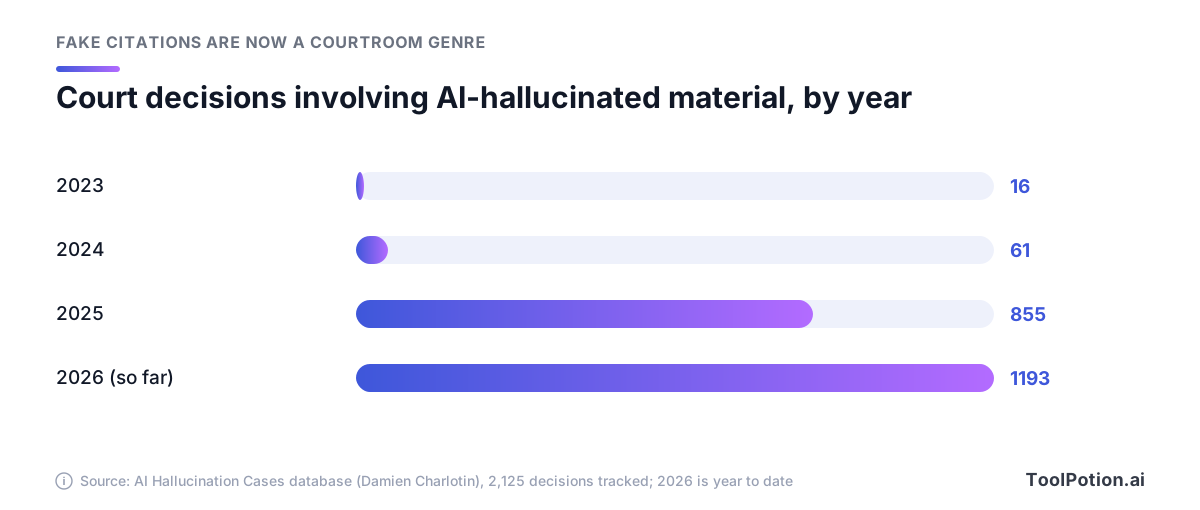
2026년 막대는 한 해의 일부만 포함하는데도 이미 2025년을 넘어섰습니다. 추적 중인 판결 가운데 본인 소송 당사자가 1,227건이고 변호사는 840건이며, 환각 자료가 판사로부터 나온 경우도 33건입니다. 국가별로는 미국이 1,459건으로 가장 많고, 캐나다 223건, 호주 112건이 뒤를 잇습니다.
모든 것의 시작이 된 사건은 지금도 가장 좋은 교훈입니다. 2023년 Mata v. Avianca 사건에서 뉴욕 연방법원 소송을 맡은 한 변호사가 ChatGPT에게 자신에게 알려준 판례 중 하나가 실제로 존재하는지 물었습니다. ChatGPT는 존재한다고 답했습니다. 다시 캐묻자 그 사건이 "실제로 존재하며 Westlaw와 LexisNexis 같은 법률 조사 데이터베이스에서 찾을 수 있다"고 답했습니다(CNN). 그 사건은 존재하지 않았고, 법원은 변호사들과 소속 로펌에 5,000달러의 벌금을 부과했습니다. 해당 변호사는 진술서에서 "그 내용이 거짓일 수 있다는 가능성을 알지 못했다"고 밝혔습니다.
이후 청구서는 더 커졌습니다. Couvrette v. Wisnovsky 사건에서 오리건주 연방법원은 원고 측 준비서면 전반에서 조작된 인용 15건과 잘못 인용된 문구 7건을 발견했습니다. 법원은 해당 서면을 삭제하고, 청구를 재소 불가로 기각했으며, 제재금과 비용으로 110,204달러를 부과했습니다. 데이터베이스에 있는 미국 사건 중 최대 규모입니다. 법률 업무에 AI를 쓰고 있다면 법률 업무용 AI 가이드에서 더 안전한 활용 방식을 확인하세요.
법정은 가장 눈에 띄는 무대일 뿐입니다. Deloitte는 호주 정부가 발주한 44만 달러 규모의 검토 보고서에서 대학 교수들이 쓴 존재하지 않는 보고서를 인용하고 실제 법원 판결에 대한 가짜 참조까지 넣은 일로 일부 환불에 합의했습니다. 이후 이 회사는 Azure OpenAI의 GPT-4o 기반 도구 체인을 사용했다고 공개했습니다(The Guardian). EY는 올해 가짜 각주가 포함된 것으로 보이는 로열티 프로그램 보고서를 철회했는데, KPMG를 다룬 같은 TechCrunch 기사에 나온 내용입니다. 그리고 2025년에는 Chicago Sun-Times가 배급 기사로 실은 여름 독서 목록에서 15권 중 10권이 지어낸 책이었다고 NPR이 보도했습니다.
AI 출력물은 어디서 틀리는가
요즘 모델은 철자를 거의 틀리지 않는데, OpenAI 연구진은 오류가 다른 곳으로 옮겨간 이유를 설명합니다. 철자는 대형 모델이 학습하는 패턴을 따르지만, "반려동물의 생일 같은 임의적이고 빈도가 낮은 사실은 패턴만으로는 예측할 수 없어 환각으로 이어집니다"(OpenAI). 연구진이 널리 쓰이는 챗봇에게 해당 논문 저자 중 한 명의 박사 학위 논문 제목을 물었더니 세 가지 서로 다른 답이 나왔고, 맞는 답은 하나도 없었습니다.
여기서 지도가 하나 나옵니다. 오류는 몇 가지 주장 유형에 몰려 있고, 가장 위험한 것은 증거처럼 꾸며진 주장입니다.
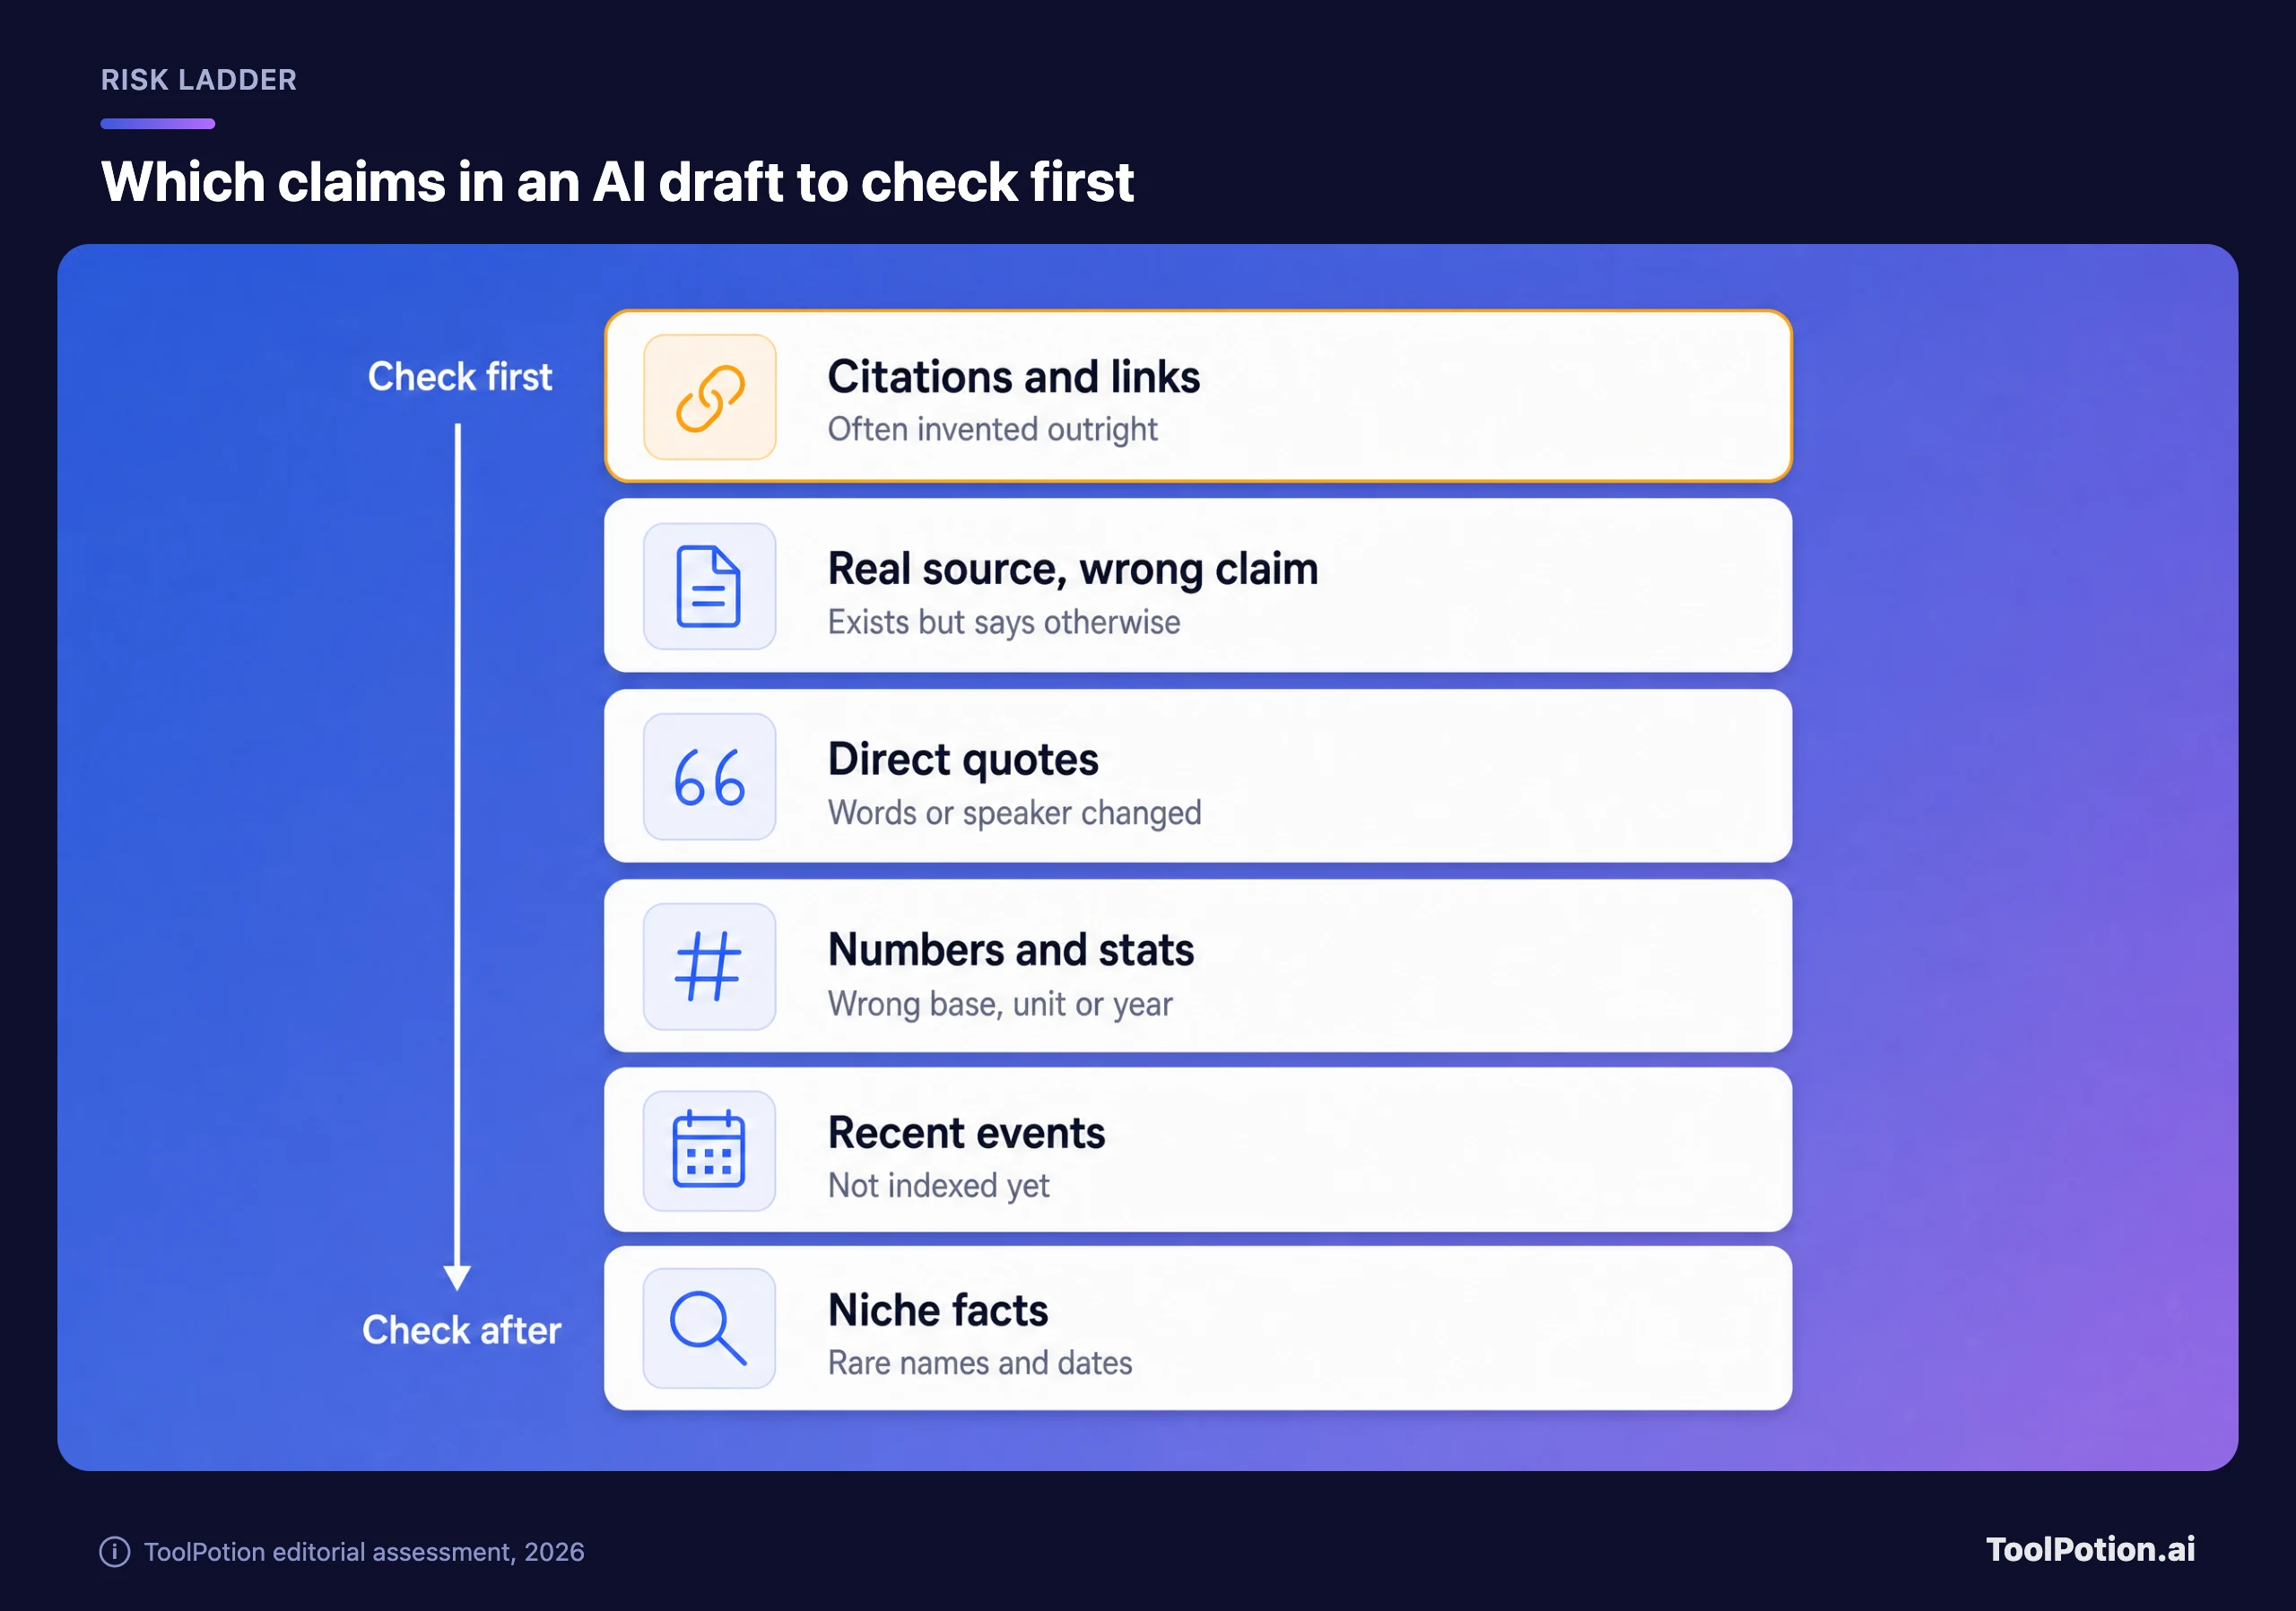
인용이 맨 위에 있는 이유는 두 가지 방식으로 틀리기 때문입니다. 하나는 아예 지어낸 경우입니다. 2025년 Columbia의 Tow Center가 AI 검색 도구 8종에 1,600건의 질의를 던져 뉴스 발췌문의 출처를 찾게 했을 때, 도구들은 합쳐서 60% 넘게 틀렸고 Grok 3는 인용 200건 중 154건을 오류 페이지로 연결했습니다(Tow Center). 다른 하나는 실제 출처이지만 거기에 없는 내용을 근거로 든 경우입니다. Charlotin의 데이터베이스는 조작 관련 1,752건과 별도로, 자료를 왜곡한 사례가 894건이라고 집계합니다. 링크가 열린다고 해서 이 두 번째 유형이 걸러지지는 않습니다.
다음은 직접 인용문입니다. 데이터베이스에는 가짜 인용문이 포함된 판결이 572건 있고, OpenAI 도움말 센터도 ChatGPT의 알려진 실패 유형으로 "존재하지 않는 출처에 대한 조작된 인용문, 연구, 인용 또는 참조"를 꼽습니다(OpenAI Help). 숫자는 더 조용히 틀립니다. 엉뚱한 연도의 실제 수치, 퍼센트포인트로 둔갑한 퍼센트, 전 세계 가격인 것처럼 제시된 특정 지역 가격 같은 식입니다.
최신성은 그 자체로 함정입니다. Perplexity 개발자 문서는 정보가 로그인이나 유료 벽 뒤에 있을 때, 검색이 "관련은 있지만 일치하지 않는 결과"를 반환할 때, 또는 "아주 최근 정보가 아직 색인되지 않았을 때" 환각 가능성이 가장 높다고 설명합니다(Perplexity docs). BBC가 주도한 2025년 연구는 ChatGPT, Microsoft Copilot, Google Gemini, Perplexity의 뉴스 답변 3,000건 이상을 분석해, 그중 20%에서 오래된 정보를 포함한 심각한 정확성 문제를 발견했습니다.
어조도 문제입니다. 같은 Tow Center 테스트에서 ChatGPT는 기사 134건의 출처를 잘못 짚었지만 200건의 응답 중 불확실성을 표시한 것은 15번뿐이었고, 일부 도구는 유료 등급에서 더 많은 질문에 정답을 내면서도 자신 있게 틀린 답 또한 더 많이 내놓았습니다. OpenAI 도움말은 이를 분명히 말합니다. "모델은 틀린 답에도 높은 확신을 표현할 수 있습니다." AI 출력에서 자신감 있는 어조는 정확도에 대해 거의 아무것도 알려주지 않습니다.
모델에게 다시 확인하라고 시키는 것으로는 부족한 이유
가장 손쉬운 지름길은 초안을 다시 붙여 넣고 정확한지 묻는 것입니다. Mata v. Avianca가 그 결과를 이미 보여줬고, 연구도 이를 뒷받침합니다. ICLR 2024에서 발표된 논문은 모델이 "외부 피드백 없이는 스스로 답을 교정하기 어려우며, 때로는 자기 교정 후 오히려 성능이 떨어지기도 한다"고 밝혔습니다(Huang et al.).
원인은 학습 방식에 있습니다. OpenAI 연구진은 객관식 시험이 백지 답안보다 찍기를 보상하듯 "표준적인 학습 및 평가 절차는 불확실함을 인정하는 것보다 추측을 보상한다"고 주장합니다. 또한 현실의 일부 질문은 답할 수 없으므로 정확도가 "결코 100%에 이르지 못할 것"이라고도 인정합니다. 모델이 자기 초안을 검토할 때는 오류를 만들어낸 바로 그 지식을 그대로 쓰기 때문에, 검토가 같은 오류를 되풀이하기 쉽습니다.
그래도 자체 검토에는 쓸모가 있습니다. 2023년 Chain-of-Verification 논문은 구조화된 방식이 도움이 된다는 것을 보여줬습니다. 모델이 답을 초안으로 작성하고, 검증 질문을 만들고, 초안과 독립적으로 그 질문에 답한 다음 수정하는 방식이며, 여러 과제에서 환각을 줄였습니다. 이는 의심 대상을 찾아내는 수단으로만 쓰고, 의심을 풀어주는 용도로는 쓰지 마십시오.
근거가 있다고 해서 정확한 것은 아닙니다
모델에게 참고할 출처를 주면 오류율은 낮아지지만 0이 되지는 않습니다. Vectara의 공개 리더보드는 모델에게 기사 7,700건 이상을 각 기사 안의 사실만으로 요약하게 한 뒤, Vectara 자체 탐지 모델로 요약문을 채점합니다. 이렇게 쉬운 조건에서도 목록의 모든 모델이 일정 비율의 요약문에 근거 없는 내용을 덧붙입니다(Vectara).
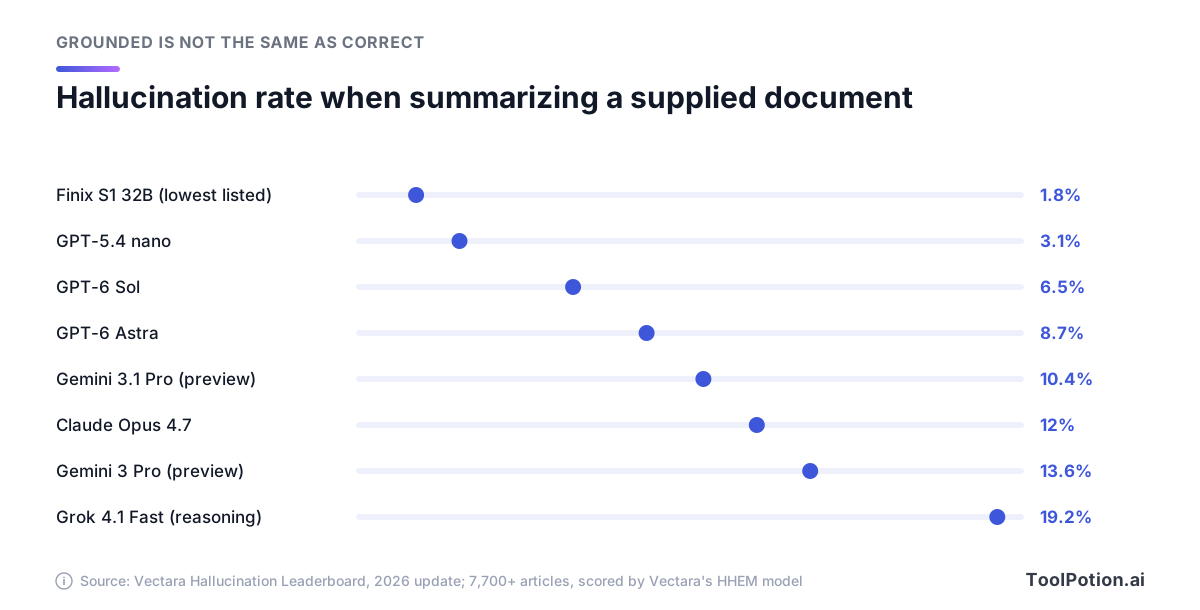
최신 업데이트에서 GPT-6 Sol은 요약문의 6.5%에, Claude Opus 4.7은 12%에 근거 없는 내용을 추가했습니다. 모델이 다른 모델을 채점하는 방식은 완벽하지 않고, Vectara도 이 테스트가 모든 종류의 환각을 포착하지는 못한다고 분명히 밝히며, 표에는 아직 현재 출시된 모든 모델이 포함되어 있지도 않습니다. 그래도 방향은 분명합니다. 실제 판례를 검색해 가져오는 법률 리서치 도구(Lexis+ AI, Westlaw의 AI-Assisted Research 포함)를 대상으로 한 2024년 연구에서도 환각 비율이 17%에서 33% 사이였습니다. 근거를 주면 문제가 "이 출처가 이렇게 말하고 있는가?"라는 하나의 질문으로 좁혀질 뿐입니다. 그 질문은 여전히 사람이 던져야 합니다.
위험도별로 나눈 검증 워크플로
해법은 분류(triage)입니다. 초안의 대부분은 프레이밍, 전환 문장, 어차피 직접 책임질 의견 같은 연결 조직입니다. 글을 떠받치는 것은 소수의 주장이며, 오류가 피해를 일으키는 곳도 거기입니다. 먼저 분류하고, 검증 시간은 효과가 큰 곳에 쓰십시오.
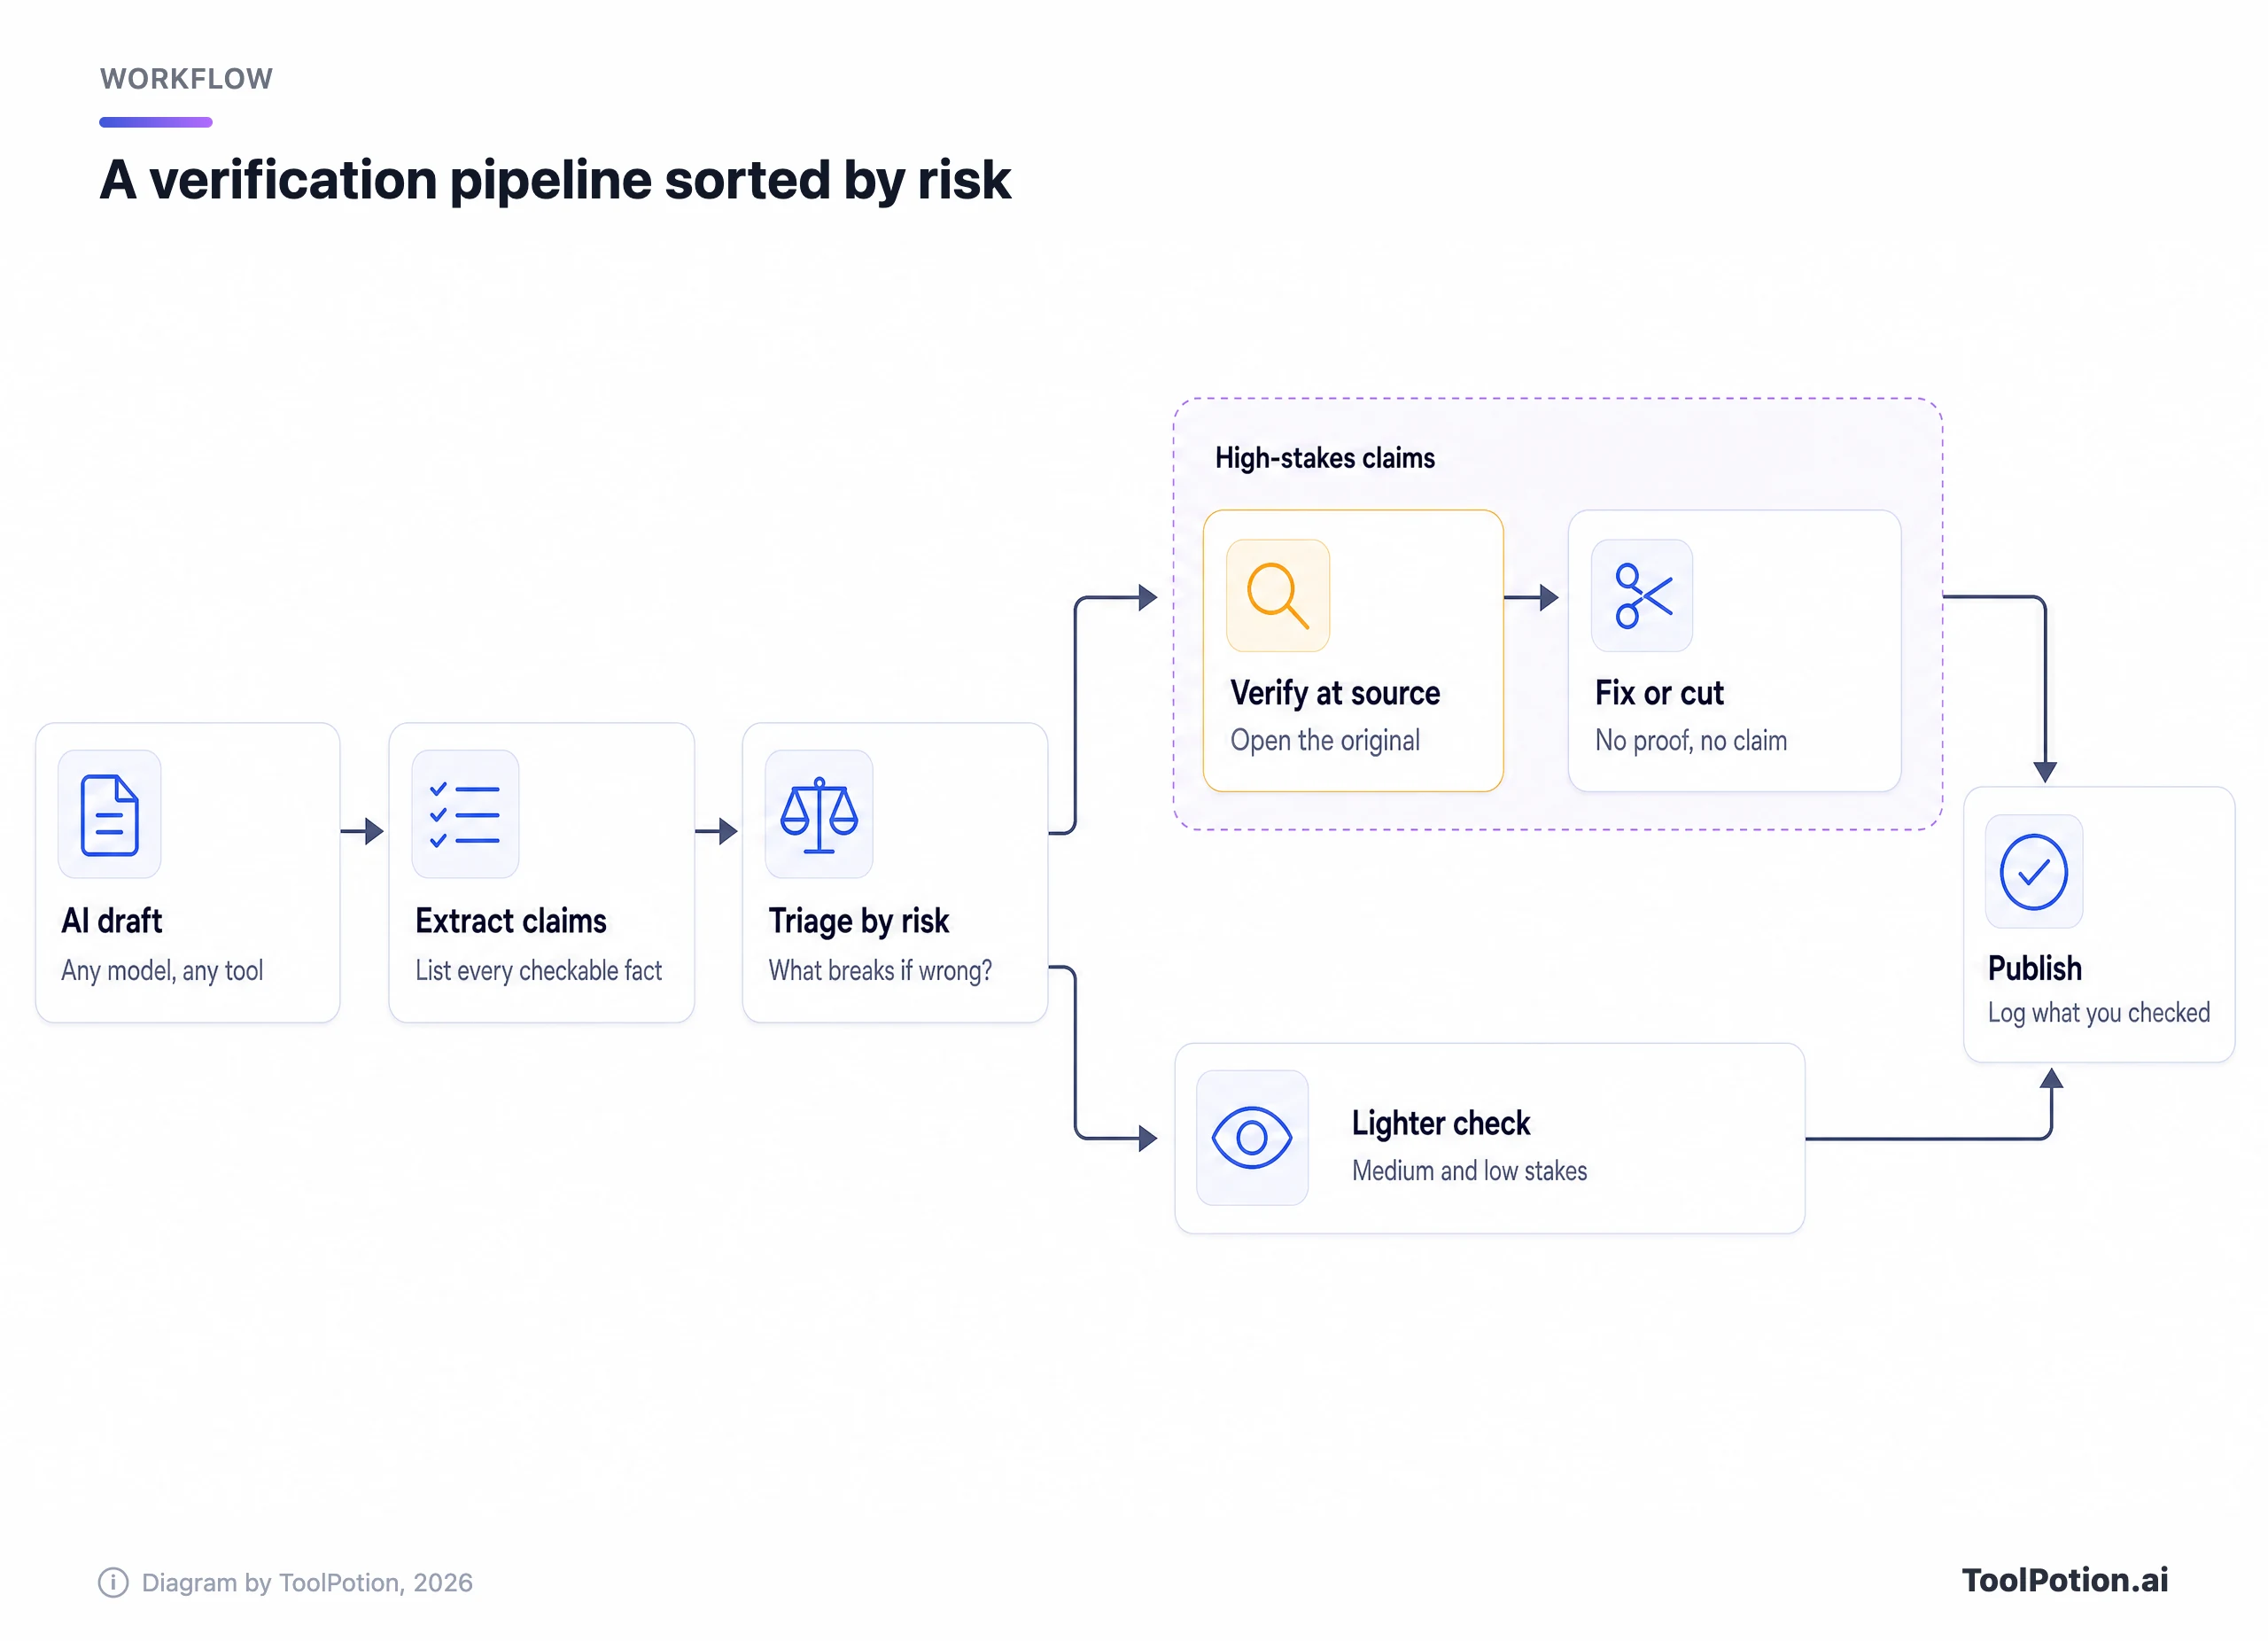
- 주장 추출하기. 모델에게 초안에서 확인 가능한 모든 진술(이름, 숫자, 날짜, 인용문, 출처, 인과 관계 주장)을 나열하게 하십시오. 자신이 하고 있는 줄 몰랐던 주장까지 발견하게 됩니다.
- 위험도로 분류하기. 각 주장이 틀리면 어떻게 되는지 물어보십시오. 법률·의료·금융 관련 내용은 고위험이고, 모든 출처 인용, 모든 직접 인용문, 제목이나 요약에 들어가는 통계, 실명이 언급된 인물이나 회사에 대한 주장도 마찬가지입니다. 독자가 다른 곳에서 반복할 법한 보조 맥락은 중위험입니다. 기억만으로도 방어할 수 있는 프레이밍은 저위험입니다.
- 고위험 등급은 1차 출처에서 검증하십시오. 법원 판결문, 제출 서류, 데이터셋, 기업 자체 페이지, 논문 원문 같은 것들입니다. 연구를 다룬 뉴스 기사는 그 연구 자체가 아닙니다.
- 중위험 등급은 아래에서 설명할 수평 읽기로 표본 점검하고, 저위험 등급은 편집자의 눈으로 읽으면 충분합니다.
- 수정, 완화 또는 삭제. 주장에 걸맞은 시간 안에 확인하지 못하면 삭제하거나 "업체 측 설명에 따르면"처럼 출처를 분명히 밝혀 쓰십시오. 그럴듯하게 들린다는 이유만으로 주장을 남겨두지 마십시오.
- 기록 남기기. 고위험 주장마다 주장, 출처, 출처 내 근거 위치를 한 줄로 적는 데는 몇 분이면 되고, 편집자나 고객, 판사가 결국 던질 질문에 대한 답이 됩니다.
검증 강도는 결과물이 얼마나 멀리 나가느냐에 맞추십시오. 브레인스토밍은 꼼꼼히 읽어보면 충분합니다. 고객에게 전달하는 결과물이라면 모든 고위험 주장의 출처를 직접 열어봐야 합니다. 검증 비용이 너무 커 보인다면 초안에 주장이 너무 많은 것일 가능성이 높고, 검증하는 것보다 덜어내는 편이 더 빠른 경우가 많습니다.
출력물이 어느 등급에 속하는지 모르겠나요? 아래에서 최대 세 가지 질문에 답해 보세요.
이 의사결정 트리가 묻는 것은 출력물이 어디로 가는지와 무엇을 담고 있는지이며, 어느 모델이 썼는지는 묻지 않습니다. 더 강력한 모델은 확률을 바꿔줄 뿐입니다. 실수에 대한 책임을 누가 지는지는 바뀌지 않습니다.
출처, 인용문, 숫자 확인하는 법
주장 유형마다 간단한 확인 방법이 있습니다. 특별한 소프트웨어는 필요 없고, 챗봇을 벗어나 원본을 열어보는 습관만 있으면 됩니다.
출처 인용
먼저 존재 여부를 확인하십시오. 제목, DOI, 사건 번호, URL을 그것을 만든 챗봇이 아닌, 직접 통제하는 데이터베이스나 검색 엔진에서 검색합니다. 그다음 근거를 확인합니다. 출처를 열어 해당 문장을 뒷받침하는 대목을 찾으십시오. 몇 분 안에 찾지 못하면 그 인용은 불합격입니다. 버전도 살펴보십시오. Tow Center는 AI 검색 도구가 원 발행처 대신 재배포된 사본을 가리키는 경우가 많다는 점을 발견했고, 프리프린트는 정식 게재된 논문과 다를 수 있습니다.
직접 인용문
고유한 문구 다섯, 여섯 단어를 따옴표로 묶어 검색하십시오. 어디에서도 나오지 않거나 기계가 쓴 것처럼 보이는 페이지에서만 나온다면 지어낸 인용문으로 보십시오. 실제로 존재한다면 앞뒤 문단을 읽고 발언자, 날짜, 의미를 확인합니다. 문맥에서 떼어낸 진짜 인용문도 가짜만큼 오해를 일으킵니다.
숫자
다시 계산할 수 있는 것은 모두 다시 계산하십시오. 단위(퍼센트인지 퍼센트포인트인지, 월간인지 연간인지, 어느 통화인지), 연도, 분모를 확인합니다. 초안에 어떤 수치가 두 배가 되었다고 적혀 있다면 두 숫자를 모두 찾아보십시오. 출처가 명시되지 않은 통계는 아무리 그럴듯해 보여도 넣지 않습니다.
최근 사건과 바이럴 주장
모든 출처의 날짜를 확인하고, 사건 이후에 발행된 보도를 우선하십시오. 이미 온라인에서 돌고 있는 주장이라면 Google의 Fact Check Explorer가 발행된 팩트체크를 검색해 어느 기관이 그 주장을 어떻게 평가했는지 보여줍니다. 이미지를 업로드해 이전에 검증된 적이 있는지 확인할 수도 있습니다.
발행 버튼을 누르기 전에 이 체크리스트로 초안을 점검하세요. 앞의 네 항목은 가중치가 두 배입니다.
가중치는 법원 데이터를 따랐습니다. 조작된 인용, 왜곡된 출처, 가짜 인용문이 해당 데이터베이스의 대부분을 차지하기 때문입니다. 이 네 칸이 비어 있다면, 목록의 나머지 항목을 다 채워도 그 초안을 안전하게 내보낼 수 없습니다.
출처가 없는 주장을 위한 수평 읽기
어떤 주장은 열어볼 인용 없이 도착합니다. 그럴 때는 전문 팩트체커의 습관을 빌리십시오. Stanford의 Civic Online Reasoning 그룹은 팩트체커들이 일하는 모습을 관찰한 뒤 "웹사이트에 대해 알아내는 가장 좋은 방법은 수평 읽기"라고 결론 내렸습니다. 페이지 자체를 파고들지 말고 그 페이지를 떠나 다른 출처들이 그것에 대해 뭐라고 하는지 확인하라는 뜻입니다.
Mike Caulfield는 이 습관을 SIFT라는 네 단계 루틴으로 정리했습니다(Caulfield). AI 답변에도 잘 맞지만 한 가지 조정이 필요합니다. 조사 대상 출처가 챗봇과 그 챗봇이 고른 링크라는 점입니다.
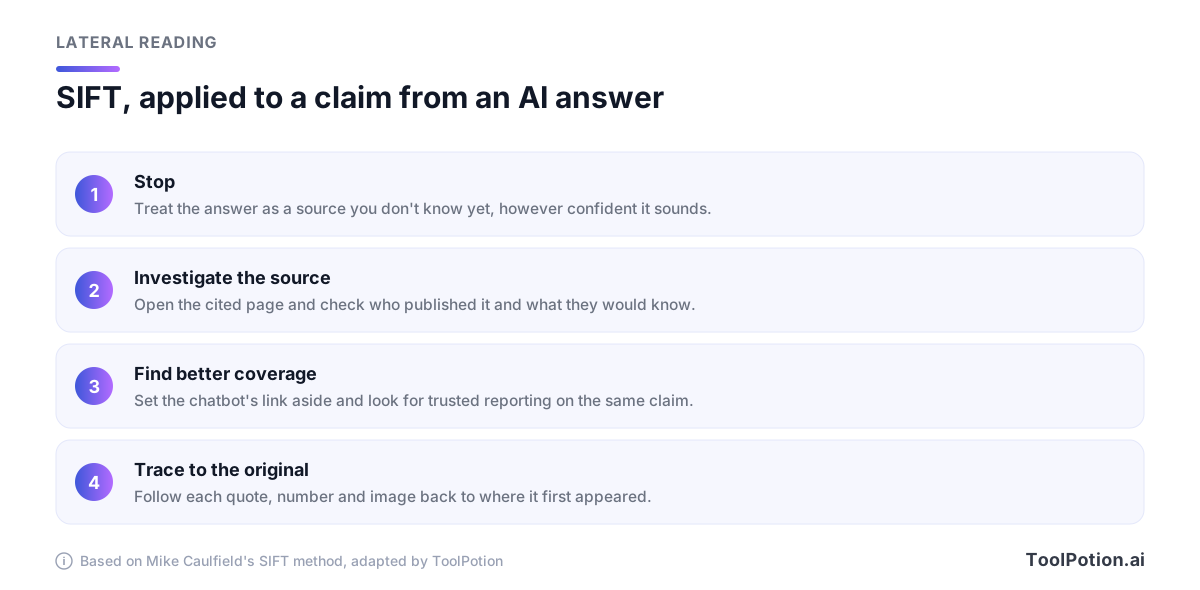
챗봇을 상대할 때는 세 번째 단계가 가장 큰 역할을 합니다. 주장이 그것을 실은 기사보다 중요할 때 Caulfield의 조언은 "당신에게 도달한 출처는 무시하고, 그 주장에 대한 신뢰할 만한 보도나 분석을 찾으라"는 것입니다. 그러니 주장 자체를 자기 말로 새로 검색하십시오. 널리 보도되어야 할 내용인데 독립적인 보도가 없다면 답은 이미 나온 셈입니다.
수평 읽기는 모델이 스스로 찾아낸 출처를 판단하는 데도 유용합니다. 들어본 적 없는 사이트의 실제 URL은 AI가 참고문헌을 아무리 깔끔하게 정리했더라도 약한 출처입니다.
검증하기 쉬운 출력을 만드는 프롬프트
프롬프트로 환각을 없앨 수는 없지만, 오류를 더 쉽게 잡아낼 수 있도록 출력의 형태를 잡을 수는 있습니다. 가장 좋은 길잡이는 각 벤더의 공식 문서입니다. Anthropic은 권장 기법이 "환각을 상당히 줄여주지만" "완전히 없애지는 못한다"고 말합니다(Anthropic docs). 프롬프트 습관 전반은 실전 프롬프트 엔지니어링 가이드를 참고하세요.
모르면 모른다고 말해도 된다고 허용하기
Anthropic과 Perplexity 모두 개발자에게 모델이 불확실성을 인정하거나 아무것도 찾지 못했다고 보고하는 것을 명시적으로 허용하라고 안내합니다. 왜 중요한지는 OpenAI의 연구가 보여줍니다. SimpleQA 벤치마크 비교에서 질문의 52%에 답변을 보류한 모델은 26%를 틀렸지만, 1%만 보류한 모델은 75%를 틀렸고 정확도는 거의 같았습니다. 다음을 상시 지침으로 사용하세요.
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
결론보다 인용문을 먼저 요구하기
Anthropic 문서는 작업에 들어가기 전에 긴 문서에서 원문 그대로의 인용문을 먼저 추출하게 하고, 이후 모델이 각 주장에 대해 뒷받침하는 인용문을 찾도록 한 다음 뒷받침하지 못하는 주장은 철회하게 하라고 권합니다. 실제로는 이런 모습입니다.
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
근접 오류를 표시하게 하고, 간결함을 강요하지 않기
Perplexity 가이드에는 가져다 쓸 만한 규칙이 하나 더 있습니다. "관련은 있지만 일치하지 않는 결과(예: 다른 연도, 모회사, 자회사)를 발견하면 답하기 전에 불일치를 명시적으로 밝힐 것." 이렇게 하면 올바른 사실이 엉뚱한 대상에 붙는 오류를 잡을 수 있는데, 눈으로 찾아내기 가장 어려운 오류 중 하나입니다. 이 가이드의 예시 규칙은 또한 모델에게 출처를 도메인으로 인용하고 "전체 URL은 쓰지 말라"고 지시합니다.
길이도 중요합니다. 파리에 본사를 둔 AI 테스트 기업 Giskard는 GPT-4o, Mistral Large, Claude 3.7 Sonnet에 간결한 답변을 요구하자 정확도가 떨어진다는 점을 발견했습니다. "짧게 쓰라고 강요받으면 모델은 일관되게 정확성보다 간결함을 택하기" 때문입니다. 같은 연구에서 모델은 사용자가 확신을 갖고 말한 논쟁적 주장에 반박할 가능성도 낮았습니다. "X가 왜 그런지 설명해줘"처럼 주장을 전제하지 말고, "X가 사실인가요?"처럼 중립적으로 질문하십시오.
주장을 추출하고, 두 번 실행하기
이 프롬프트는 워크플로의 첫 단계에 쓰입니다. 직접 쓴 글을 포함해 어떤 초안에도 실행해 보세요.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic은 best-of-N 점검도 제안합니다. 같은 프롬프트를 여러 번 실행해 비교하는 방식으로, 일관되지 않은 답은 환각일 가능성이 높다는 신호입니다. OpenAI가 박사 논문 제목 세 가지에서 본 것과 같은 증상입니다. 실행 결과가 서로 다르면 어디를 봐야 할지 알려줍니다. 결과가 일치한다고 해서 증명되는 것은 없습니다.
출처 기반 도구는 어느 정도까지만 도움이 됩니다
다른 부류의 도구는 모델이 참고할 수 있는 범위를 좁힙니다. 그러면 "이게 사실인가?"가 "출처가 이렇게 말하고 있는가?"로 바뀌어 확인이 더 빨라집니다. 다만 확인 자체가 사라지지는 않습니다.
Google은 올해 초 NotebookLM의 이름을 Gemini Notebook으로 바꾸면서 독립형 리서치 도구로 유지했으며, Google에 따르면 3,000만 명 넘는 사람이 사용합니다(Google). 채팅에서는 사용자가 추가한 출처로만 답하고 "출처의 직접 인용문, 텍스트, 이미지를 인용으로 사용합니다." 인용 위에 마우스를 올리면 인용된 텍스트가 보이고, 클릭하면 문맥 속 해당 위치로 이동합니다(Gemini Notebook Help). 덕분에 근거 확인이 빨라집니다. 한계도 알아두세요. Google 도움말에 따르면 유료 웹페이지는 지원되지 않고, Google 파일의 각주와 댓글은 가져오지 않습니다. 웹 검색과 코드 실행이 가능한 최신 에이전트형 채팅 기능은 실험 단계로 표시되어 있으며 "반드시 다시 확인하세요"라는 안내가 붙어 있습니다.
Perplexity 같은 답변 엔진은 답변마다 링크를 붙여 주는데, 출처 없는 챗봇보다 확실히 나아진 점입니다. 그래도 링크는 직접 열어봐야 합니다. Perplexity는 Tow Center의 2025년 테스트에서 질의의 37%를 틀렸고(이후 도구들은 바뀌었습니다), Google 자체 Gemini 도움말도 "모든 응답에 관련 링크나 출처가 포함되는 것은 아니다"라고 안내합니다.
연구 관련 주장에는 열린 웹이 아닌 논문에 근거해 답하는 학술 검색 도구가 있습니다. Consensus는 동료 심사를 거친 문헌을 검색하며, "충분히 관련된 근거를 찾지 못하면 그렇게 알려준다"고 밝혀 빈틈을 억지로 채우지 않습니다. Elicit은 AI가 생성한 모든 주장을 문장 단위 인용으로 뒷받침한다고 밝힙니다. Scite는 후속 연구가 어떤 논문의 결과를 지지했는지 반박했는지 보여주는데, 다른 도구들이 놓치는 실패, 즉 이후에 반박된 실제 연구를 잡아냅니다.
직접 파이프라인을 구축한다면 Anthropic의 Citations API는 각 주장의 근거가 되는 정확한 대목을 반환하며, Anthropic 문서는 이 인용이 "제공된 문서에 대한 유효한 포인터를 포함하도록 보장된다"고 설명합니다. 존재하지 않는 출처는 이것으로 배제됩니다. 하지만 그 대목이 붙은 문장을 실제로 뒷받침하는지는 확인해 주지 않습니다. 참고문헌 검사기는 맨 마지막 단계에 놓입니다. GPTZero는 참고문헌 목록을 스캔하는 환각 탐지기를 제공하며, GPTZero 팀은 KPMG 보고서를 짚어냈고 올해 초에는 AI 분야 주요 학회인 NeurIPS에 채택된 논문 51편에서 환각 인용 100건을 찾아냈다고 TechCrunch가 보도했습니다.
| 도구 유형 | 답변의 근거 | 여전히 확인할 것 |
|---|---|---|
| 노트북 도구(Gemini Notebook) | 업로드한 출처 | 인용된 각 대목이 주장을 뒷받침하는지, 그리고 내 출처가 올바른지 |
| 답변 엔진(Perplexity, 검색 기능을 켠 ChatGPT) | 실시간 웹 검색 결과 | 모든 링크를 열고 날짜를 확인하며 원 발행처 찾기 |
| 연구 검색(Consensus, Elicit, Scite) | 학술 논문 | 논문의 실제 결과와 한계, 이후에 나온 반박 연구 |
| 인용 API(Claude Citations) | 직접 제공한 문서 | 유효한 포인터를 넘어 주장에 대한 실제 근거 |
| 참고문헌 검사기(GPTZero) | 서지 기록 | 실존하는 참고문헌이 초안의 주장대로 말하고 있는지 |
옵션을 비교하려면 AI 리서치 어시스턴트 보드, AI 검색 엔진 보드, 학술 문헌 검색 보드를 살펴보세요. AI 리서치 어시스턴트와 AI 검색 엔진 정리 글에서는 기능과 가격을 더 자세히 다룹니다.
자주 묻는 질문
다른 AI 모델의 출력을 한 AI 모델로 팩트체크해도 되나요?
1차 점검으로는 괜찮습니다. 두 번째 모델, 특히 검색 기능이 있는 모델은 첫 번째가 놓친 오류를 일부 짚어내며, 의견이 갈리는 지점은 어디를 봐야 하는지 알려줍니다. 하지만 아무것도 확정해 주지는 못합니다. 두 모델이 같은 빈틈을 공유할 수 있기 때문입니다. 그 지적을 할 일 목록으로 보고, 하나하나 출처에서 결론을 내리십시오. 두 번째 어시스턴트를 고르는 중이라면 ChatGPT 대안 가이드에서 주요 선택지를 비교해 두었습니다.
AI 탐지기가 사실 여부도 확인해 주나요?
아닙니다. Originality.ai detector 같은 도구는 텍스트가 기계가 쓴 것인지를 추정합니다. 이는 주장이 참인지에 대해서는 아무것도 말해주지 않으며, 사람이 쓴 초안도 똑같이 틀릴 수 있습니다. 팩트체크에는 원본 출처가 필요합니다.
AI 초안을 팩트체크하는 데 시간이 얼마나 걸려야 하나요?
초안의 길이가 아니라 고위험 주장이 몇 개인지에 달려 있습니다. 분류 후에 세어 보십시오. 통계 네 개와 인용문 두 개가 든 2,000단어짜리 해설 글은 금방 끝나는 작업이지만, 인용으로 가득한 한 페이지짜리 메모는 그렇지 않습니다.
ChatGPT나 다른 챗봇을 출처로 인용해도 되나요?
사실 관계에서는 안 됩니다. OpenAI 스스로도 "ChatGPT는 최종 출처가 아니라 초안으로 사용하라"고 조언합니다. 직접 검증한 원문 문서를 인용하세요. 모델 테스트처럼 AI의 출력 자체가 주제라면, 어떤 모델을 언제 사용했는지 밝히면 됩니다.
딥 리서치 에이전트가 있으면 검증은 필요 없어지나요?
아닙니다. OpenAI의 deep research 같은 에이전트는 여러 웹 출처를 모아 인용이 달린 리서치 보고서를 작성하는데, 이는 확인할 주장이 줄어드는 것이 아니라 열어봐야 할 인용이 늘어난다는 뜻입니다. 출처 왜곡 문제는 인용된 모든 문장에 해당하므로, 보고서가 길어질수록 분류 단계가 더 중요해집니다.