

“이 증명을 아직 완전히 이해한다고 주장하지는 않습니다.” OpenAI가 Yang-Mills 결과를 검증하려고 꾸린 위원회가 한 말로, Scientific American에 인용되었습니다. 물리학자 David Gross가 이끄는 이 위원회는 문제의 절반에 대한 증명이 수학 검증용 프로그래밍 언어인 Lean에서 통과했음을 막 확인한 참이었습니다. 그러면서도 그 증명이 어떻게 작동하는지는 설명하지 못했습니다.
저희는 AI 과학 분야의 최신 자료를 읽었습니다. 앞의 기사, Anthropic 게시물 다섯 편, OpenAI의 웻랩 벤치마크, PSI라는 스타트업을 다룬 TechCrunch 기사, 그리고 AI 에이전트가 멕시코 공식 등록부에 없는 마야 유적을 찾아냈다고 밝힌 한 블로거의 글입니다. 헤드라인은 이 자료들보다 훨씬 앞서 나갑니다. 그래서 널리 퍼진 주장 여섯 가지를 골라, 각각 출처가 실제로 말하는 내용과 대조해 보았습니다.
주장 1: AI가 이제 스스로 새로운 과학을 발견하고 있다
판정: 스스로는 아닙니다. 가장 좋은 사례들은 실제로 존재하지만, 모든 사례에서 사람이 질문을 정했거나 검증을 했거나, 둘 다 했습니다.
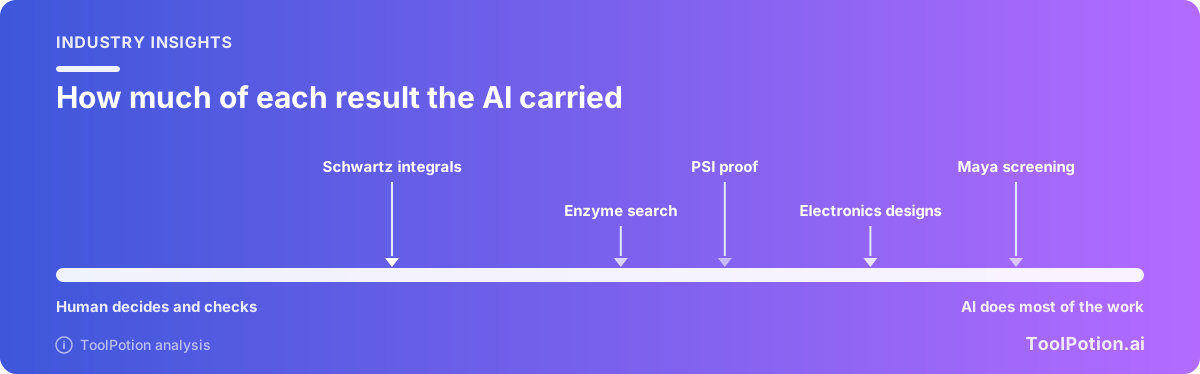
생물학부터 보겠습니다. Anthropic은 Claude 에이전트가 CRISPR와 유사한 반복 서열을 가진 효소 시스템을 찾아냈다고 밝혔습니다. 에이전트 약 950개, 토큰 2억 1,000만 개, 21시간이 들었습니다(Anthropic). 반복 패턴을 포착한 것은 에이전트 하나였습니다. 하지만 시작 프롬프트는 Anthropic 과학자들이 제공했고 실험실 작업도 전부 이들이 했으며, Claude가 내놓은 후보 대부분은 검토 과정에서 탈락했습니다. 게다가 결과물은 프리프린트입니다. 이 시스템의 주된 기능을 규명하는 작업도 아직 진행 중입니다. 게시물은 Claude가 이 시스템의 핵심 특징을 "가장 먼저 알아챈 것으로 보인다"고 하고, Claude가 "스스로 이상 징후를 감지할 수 있다"고 말합니다. 탐색 단계에 대해서는 타당한 말이지만, 나머지 단계에는 해당하지 않습니다. 같은 게시물에서 프리프린트를 읽은 MIT와 Broad Institute의 Feng Zhang은 이를 "AI 에이전트가 생물학적 발견에 기여할 수 있음을 보여주는 흥미로운 사례"라고 평가하면서 이 발견이 "추가 연구할 가치가 있다"고 말했습니다.
Anthropic 방문 연구원인 물리학자 Matthew Schwartz는 대부분의 사람보다 솔직합니다. 그는 Anthropic에 기고한 글에서 Claude로 적분 30개를 처음부터 끝까지 수행했고, 15개는 기존 결과를 재현했으며 15개는 이전에 계산된 적 없는 것이었다고 보고합니다(Anthropic). 그는 좋은 대상을 "Claude형" 문제라고 부르면서, "과학적 가치가 있는 무언가를 내놓게 하려면 손이 많이 갈 수 있다"고 덧붙입니다. 외부 전문가를 불러 확인해 보니 "거의 모든 경우에 Claude는 기술적으로 맞았지만, 전문가가 방향을 잡아 주기 전까지는 결과가 그다지 흥미롭지 않았다"고 합니다. 또 Claude는 "인용은 많이 됐지만 오래전에 잊힌 옛 논쟁을 선호하는 것 같다"고 말합니다. 무엇이 풀 가치가 있는 문제인지에 대한 판단은 사람에게 남아 있었습니다.
다음은 PSI입니다. TechCrunch에 따르면 스타트업 연구소 Physical Superintelligence(PSI)의 기술 스태프 David Turturean은 Anthropic의 Fable 5.2 모델을 조기 이용해, 양자 컴퓨팅 분야에서 18년 된 난제인 Aaronson-Ambainis 추측을 풀었습니다(TechCrunch). 이 문제를 낸 Scott Aaronson은 증명을 완전히 이해하지는 못하지만, Lean으로 자동 형식화되었고 PSI가 공유한 최고 수준 연구자 팀이 설명해 주었기 때문에 맞다고 믿는다고 적었습니다. Turturean 본인의 설명은 겸손합니다. "사람들이 '좋아, 이제 여기는 더 찾아보지 않아도 되겠구나' 하고 알게 해 주는 부정적 결과입니다." 이 해법은 양자 속도 향상으로 가는 길 중 하나를 닫는 것으로 보이며, 전부를 닫는 것은 아닙니다.
저희는 이를 문제를 골라 줄 다른 사람이 필요한, 빠르고 지치지 않는 협력자라고 부르겠습니다. 이것만으로도 대단한 일입니다. 하지만 자율성은 아니며, 회사들의 게시물도 단서 조항까지 읽어 보면 그렇게 말하고 있습니다.
주장 2: 결과는 검증되었다
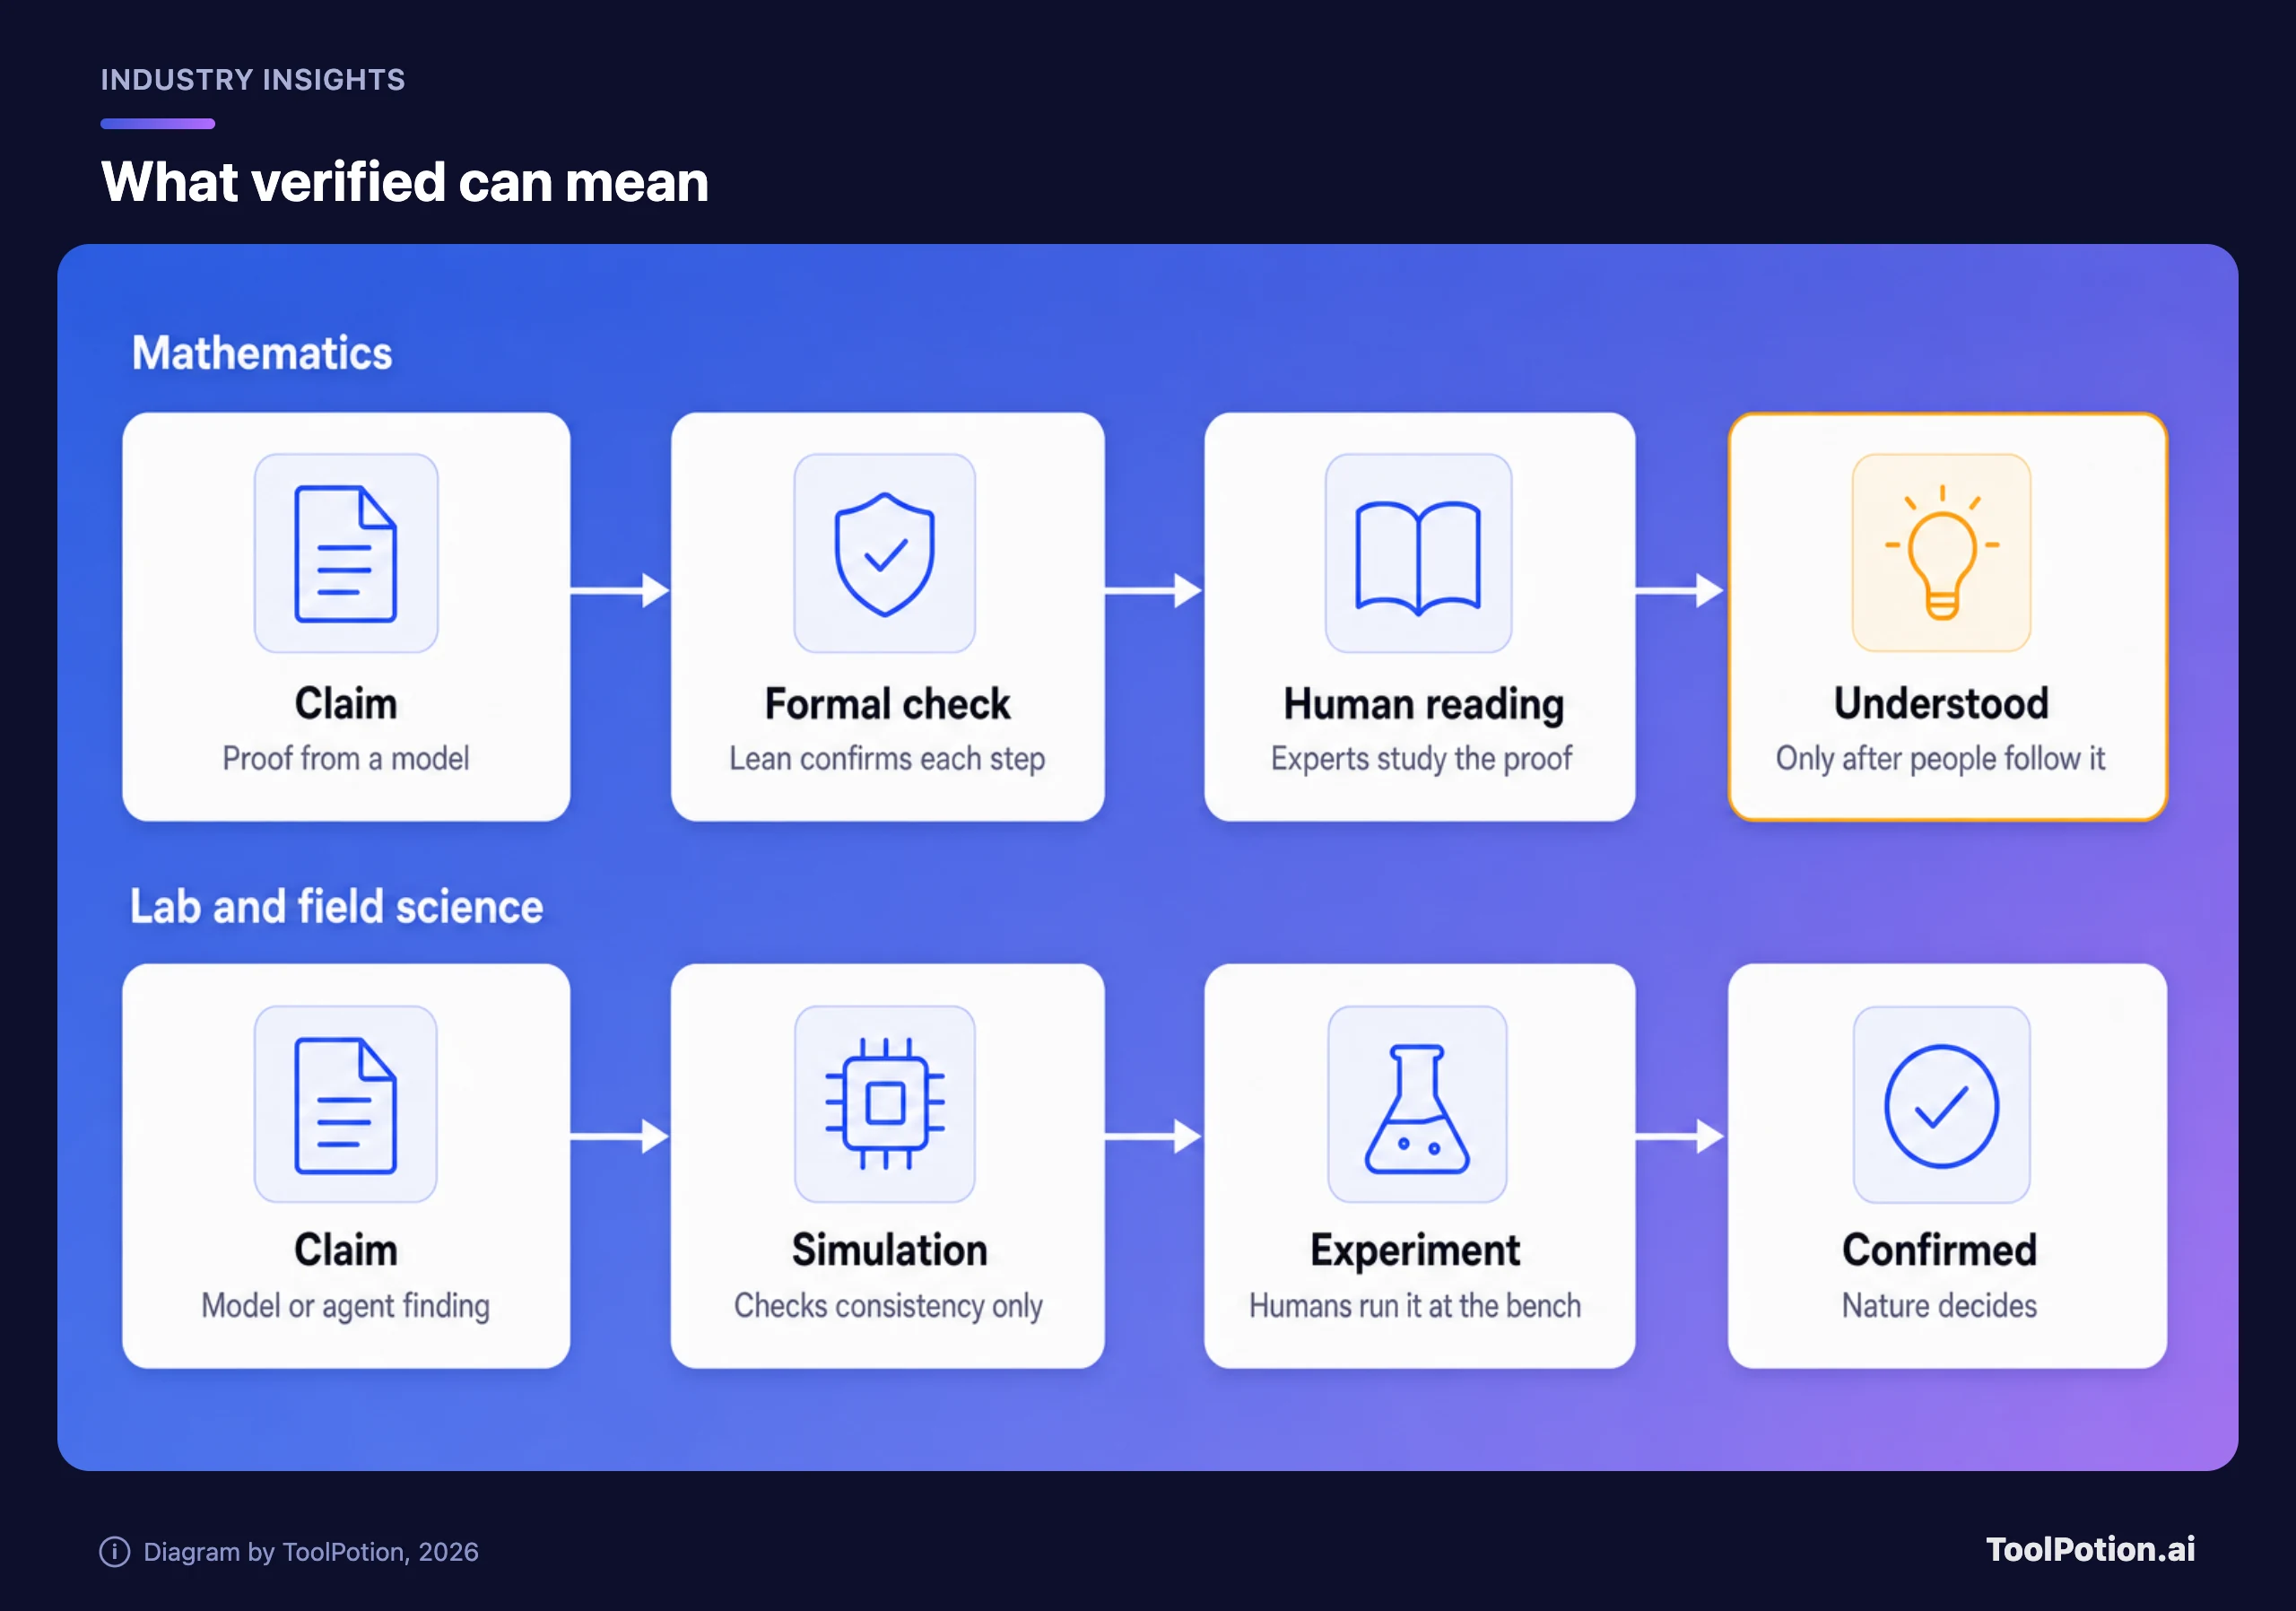
판정: 부분적으로만 그렇습니다. 수학에서는 형식 검증기가 강력한 테스트입니다. 다른 분야에서 "검증"은 시뮬레이션부터 등록부 조회까지 무엇이든 의미할 수 있습니다.
수학에서 Lean은 증명이 주어진 명제로부터 따라 나오는지를 기계적으로 확인할 수 있습니다. 강력한 검증이고, PSI와 OpenAI의 결과가 진지하게 받아들여지는 이유이기도 합니다. 하지만 Scientific American의 보도는 한계를 보여 줍니다. OpenAI의 주장은 Yang-Mills 문제의 존재성 절반에 해당하며, 별개의 질량 간극(mass gap) 절반은 미해결입니다. 위원회는 Lean 코드를 소화하는 데 OpenAI 자체 모델인 Astra의 도움을 받았고, 증명을 아직 이해한다고 주장하지 않는다고 분명히 밝혔습니다.
공개성 문제도 있습니다. Scientific American은 이런 "목자(shepherd)" 방식이 OpenAI 계열 자문 그룹의 투명성 권고와 어긋나며, 이를 게이트키핑으로 보는 일부 수학자들을 화나게 했다고 전합니다. Lean 증명은 이제 공개되었습니다. NYU의 Scott Armstrong은 마침내 공개되어 기쁘다며 이렇게 덧붙였습니다. "이 검토는 공개적으로 하는 편이 더 효율적이고 빠르게 이뤄질 수 있습니다"(Scientific American). 저희도 같은 생각입니다. OpenAI가 지명한 위원회만 본 증명은 검토를 기다리는 주장일 뿐이었고, 이제 비로소 검토를 시작할 수 있습니다.
수학 밖에는 Lean이 없습니다. PSI의 CEO Matt Pines는 TechCrunch에 물리학은 "자연이 현실 모델에 표를 던진다"는 점에서 수학과 다르며, 기계가 주도하는 이론물리학은 "아직 아니지만 가까워지고 있다"고 말했습니다. Schwartz는 "자동화된 검증은 여전히 믿을 수 없다"는 점을 발견했습니다. 그리고 뒤에서 다시 다룰 마야 유적 글에는 공식 답변이 왔습니다. 멕시코 연구소가 보고된 위치에서 등록된 유적을 찾지 못했다는 것입니다. 이는 등록부에 없다는 사실을 확인해 줄 뿐, 유적의 존재를 확인해 주지는 않습니다.
주장 3: 에이전트가 실험실을 운영할 수 있다
판정: 아직은 아닙니다. 계획, 설계, 분석은 할 수 있습니다. 피펫질과 납땜은 여전히 사람이 합니다.
Anthropic의 전자회로 게시물은 최근 사례 중 가장 강력하며, 전문을 읽어 볼 만합니다. 기판 제조업체 Diode(Anthropic은 이 회사와 상업적 관계가 있다고 밝힙니다)와 협력해, Claude(Fable 5.2 모델)는 USB-C 스피커폰, 음성 어시스턴트 허브, 휴대용 가상 펫을 회로도부터 레이아웃, 펌웨어까지 설계했습니다(Anthropic). Claude는 테스트 장비나 회로 기판 제조 장비에 연결되어 있지 않았기 때문에, Diode의 엔지니어들이 Claude의 설계 파일로 기판을 제조하고 프로토타입을 직접 제작해 테스트했습니다. 이 기기들은 전기적 검증, 안테나 튜닝, 열 테스트, 인증을 거치지 않았습니다. 게시물은 벤치마크 향상도 인용합니다(Diode 내부 PCB Gym 레이아웃 테스트에서 이전 모델의 25%에서 69%로 상승). 하지만 이는 Anthropic의 요청으로 진행된 테스트에 대한 Anthropic의 수치이고, 비용은 본문이 아닌 차트 축에만 나와 있습니다.
생물학 쪽에서는 OpenAI가 BioBasicsBench를 공개했습니다. 100개 과제로 구성된 이 벤치마크는 AI 에이전트가 원시 실험 데이터를 얼마나 잘 해석하고 일상적인 웻랩 과학을 얼마나 잘 다루는지 측정한다고 합니다(OpenAI). 벤더가 만든 테스트이고, 벤치마크는 벤더 밖의 사람들이 돌려 보기 전까지는 하나의 주장일 뿐입니다.
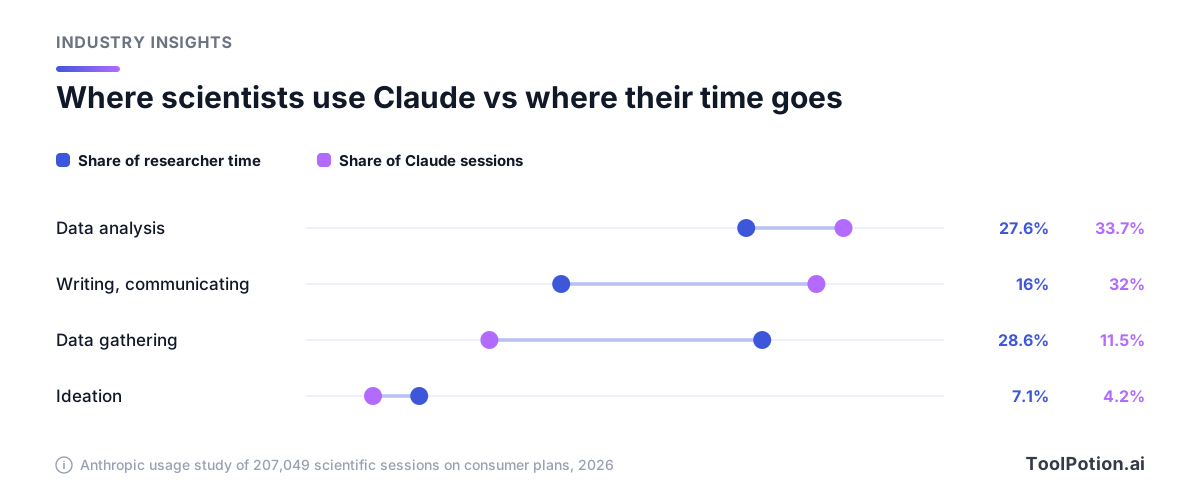
일반 사용자 요금제의 과학 관련 세션 207,049건을 분석한 Anthropic의 이용 연구도 현실에서 같은 양상을 보여 줍니다. 데이터 수집은 연구자 시간의 28.6%를 차지하지만 Claude 세션에서는 11.5%에 불과하며, 임상 또는 생화학 데이터 수집처럼 물리적 장벽이 있는 영역에서 격차가 가장 큽니다(Anthropic). 연구의 표현을 그대로 옮기면 "물리적 병목은 여전히 강력합니다."
주장 4: 이제 누구나 할 수 있다
판정: 누구나 시작할 수는 있습니다. 하지만 살아남는 결과를 얻으려면 해당 분야를 아는 사람이 필요합니다.
마야 유적 이야기가 가장 깔끔한 시험대입니다. 스스로 고고학자가 아니라고 밝힌 Pietro Miotti는 에이전트 48개를 NASA 공개 라이다 약 1,200제곱킬로미터에 투입해, 72시간도 안 되어 광장과 피라미드가 있는 언덕 위 유적을 찾았고 공식 답변까지 받았습니다(그의 글). 방법에 대한 그의 설명은 감탄스러울 만큼 담백합니다. "특별한 모델이나 분류기는 쓰지 않았습니다. 에이전트가 말 그대로 사진을 봤을 뿐입니다."
그다음은 지금 페이지 맨 위에 올라가 있는 정정입니다. "에이전트는 문헌을 훑어보는 과정에서 이를 놓쳤고, 그래서 발견한 것이 아니라 재발견한 것입니다." 이 유적은 이미 2025년 Estrada-Belli 등의 논문에 지도화되어 있었고, 단지 멕시코 등록부에 아직 없었을 뿐입니다. 이 점을 맨 앞에 둔 Miotti는 칭찬받아야 합니다. 그는 또 스페인어를 못해서 보고서의 번역을 에이전트에게 맡겼다고 밝히고, 고전기(Classic period) 이야기는 "에이전트와의 긴 대화에서 나온 추측"이며 복원 이미지는 AI가 생성한 것이라고 말합니다. 현장 지표조사에 대한 설명은 없습니다.
저희의 해석은 이렇습니다. 값싼 스크리닝의 훌륭한 시연이지만 발견의 시연으로는 부족합니다. 이제 들여다보는 일은 거의 공짜입니다. 하지만 전에 누가 들여다봤는지 아는 데는 여전히 전문가가, 최소한 에이전트가 제대로 하지 못한 문헌 검색이 필요합니다. PSI의 방식은 달랐고 시사하는 바가 큽니다. Anthropic 모델의 출시가 가까워질 때까지 결과를 공개하지 않고, 그 시간을 이를 설명해 줄 수 있는 연구자들에게 보여 주는 데 썼습니다. PSI의 자문을 맡은 Northeastern 교수 Jim Halverson은 TechCrunch에 "모범 사례는 아직 만들어지는 중입니다"라고 말했습니다.
주장 5: 과학자는 곧 자동화된다
판정: 입증되지 않았습니다. 그리고 가장 큰 목소리는 이해관계가 걸린 사람들에게서 나옵니다.
Turturean은 TechCrunch에 "이게 제가 내는 마지막 논문일 수도 있다는 생각을 완전히 받아들이고 있습니다"라고 말했습니다. Pines는 6~9개월 전 투자자들에게 이론물리학이 곧 대부분 기계의 영역이 될 것이라고 말할 때는 "다소 무리해서 말해야 했다"며 "아직 아니다"라고 했습니다. Anthropic의 설문에서는 연구자 528명 중 약 40%가 2030년까지 AI가 전체 연구 프로젝트를 스스로 수행하리라 예상한다고 답했지만, 이들은 Anthropic 자체의 AI for Science 지원 프로그램 신청자 중에서 모집되었기 때문에 일반 연구자보다 AI를 더 많이 쓰는 사람들일 가능성이 높습니다(Anthropic).
모델링 수치는 더 작습니다. Anthropic의 모델링에 따르면 현재 역량이 널리 도입될 경우 새 연구에 필요한 연구자 시간의 27~52%를 대신할 수 있고, 이는 산출량이 인문·예술 분야에서 1.35배, 통계 분야에서 2.02배까지 늘어난다는 뜻입니다. AI가 물리적이지 않은 모든 작업을 자동화한다는 보고서의 가상 시나리오에서는 통계와 컴퓨터 과학에서 약 15배에 달하지만, 물리적 단계가 병목으로 남는 생물학과 화학 같은 실험 과학에서는 3~4배에 그칩니다. 이는 측정이 아니라 시나리오입니다. 보수적인 경우라도 한 분야에는 큰 변화입니다. 하지만 대체는 아니며, 보고서도 오늘날 AI 작업은 대부분 보조적이거나 공동 수행 형태라고 짚습니다. 공로를 누가 가져가느냐에 대해서는 Schwartz가 저희보다 더 잘 말합니다. "인간의 기여가 타이핑이었던 척한다고 해결되지 않을 것"이라고 합니다.
주장 6: AI의 모델이 데이터에 들어맞으면 그 시스템을 이해한 것이다
판정: 거짓입니다. 이런 시스템을 만드는 저자들 스스로도 그렇게 말합니다.
과학 모델을 만드는 법을 AI에게 가르치는 일에 관한 튀빙겐 그룹(Jakob Macke, Daniel Gedon, Stefan Wahl. 모두 Anthropic AI for Science 지원 대상자)의 기고문은 이 논점을 신중하게 펼칩니다. 같은 데이터에 들어맞는 모델은 많으므로, 유용한 산출물은 그럴듯한 모델들의 분포와 그 모델들이 공통으로 동의하는 내용의 목록이라는 것입니다(Anthropic). 이들은 이런 시스템이 "대부분 과학자들이 이미 아는 모델을 재발견하는 데 시험되어 왔다"고 인정하며, 알려진 답이 없는 문제에 대한 증거는 드물다고 말합니다. 그리고 이렇게 씁니다. "모델만 건네주는 AI 시스템은 답을 줄 수는 있어도 이해를 주지는 못합니다."
저희는 이 마지막 문장을 모든 실험대 위와 모든 학생의 책상 위에 붙여 놓아야 한다고 생각합니다. 적합도는 숫자입니다. 설명은 사람이 다음에 무슨 일이 일어날지 예측하는 데 쓸 수 있는 것입니다.
연구자와 학생을 위한 루틴
위 내용 중 어느 것도 이 도구를 쓰지 말라는 말이 아닙니다. Anthropic의 이용 데이터를 보면 과학자들은 이미 분석과 글쓰기처럼 도구가 가장 잘 맞는 곳에서 쓰고 있습니다. 앞의 사례들에서 무엇이 잘못됐는지를 토대로 저희가 따를 루틴은 다음과 같습니다.
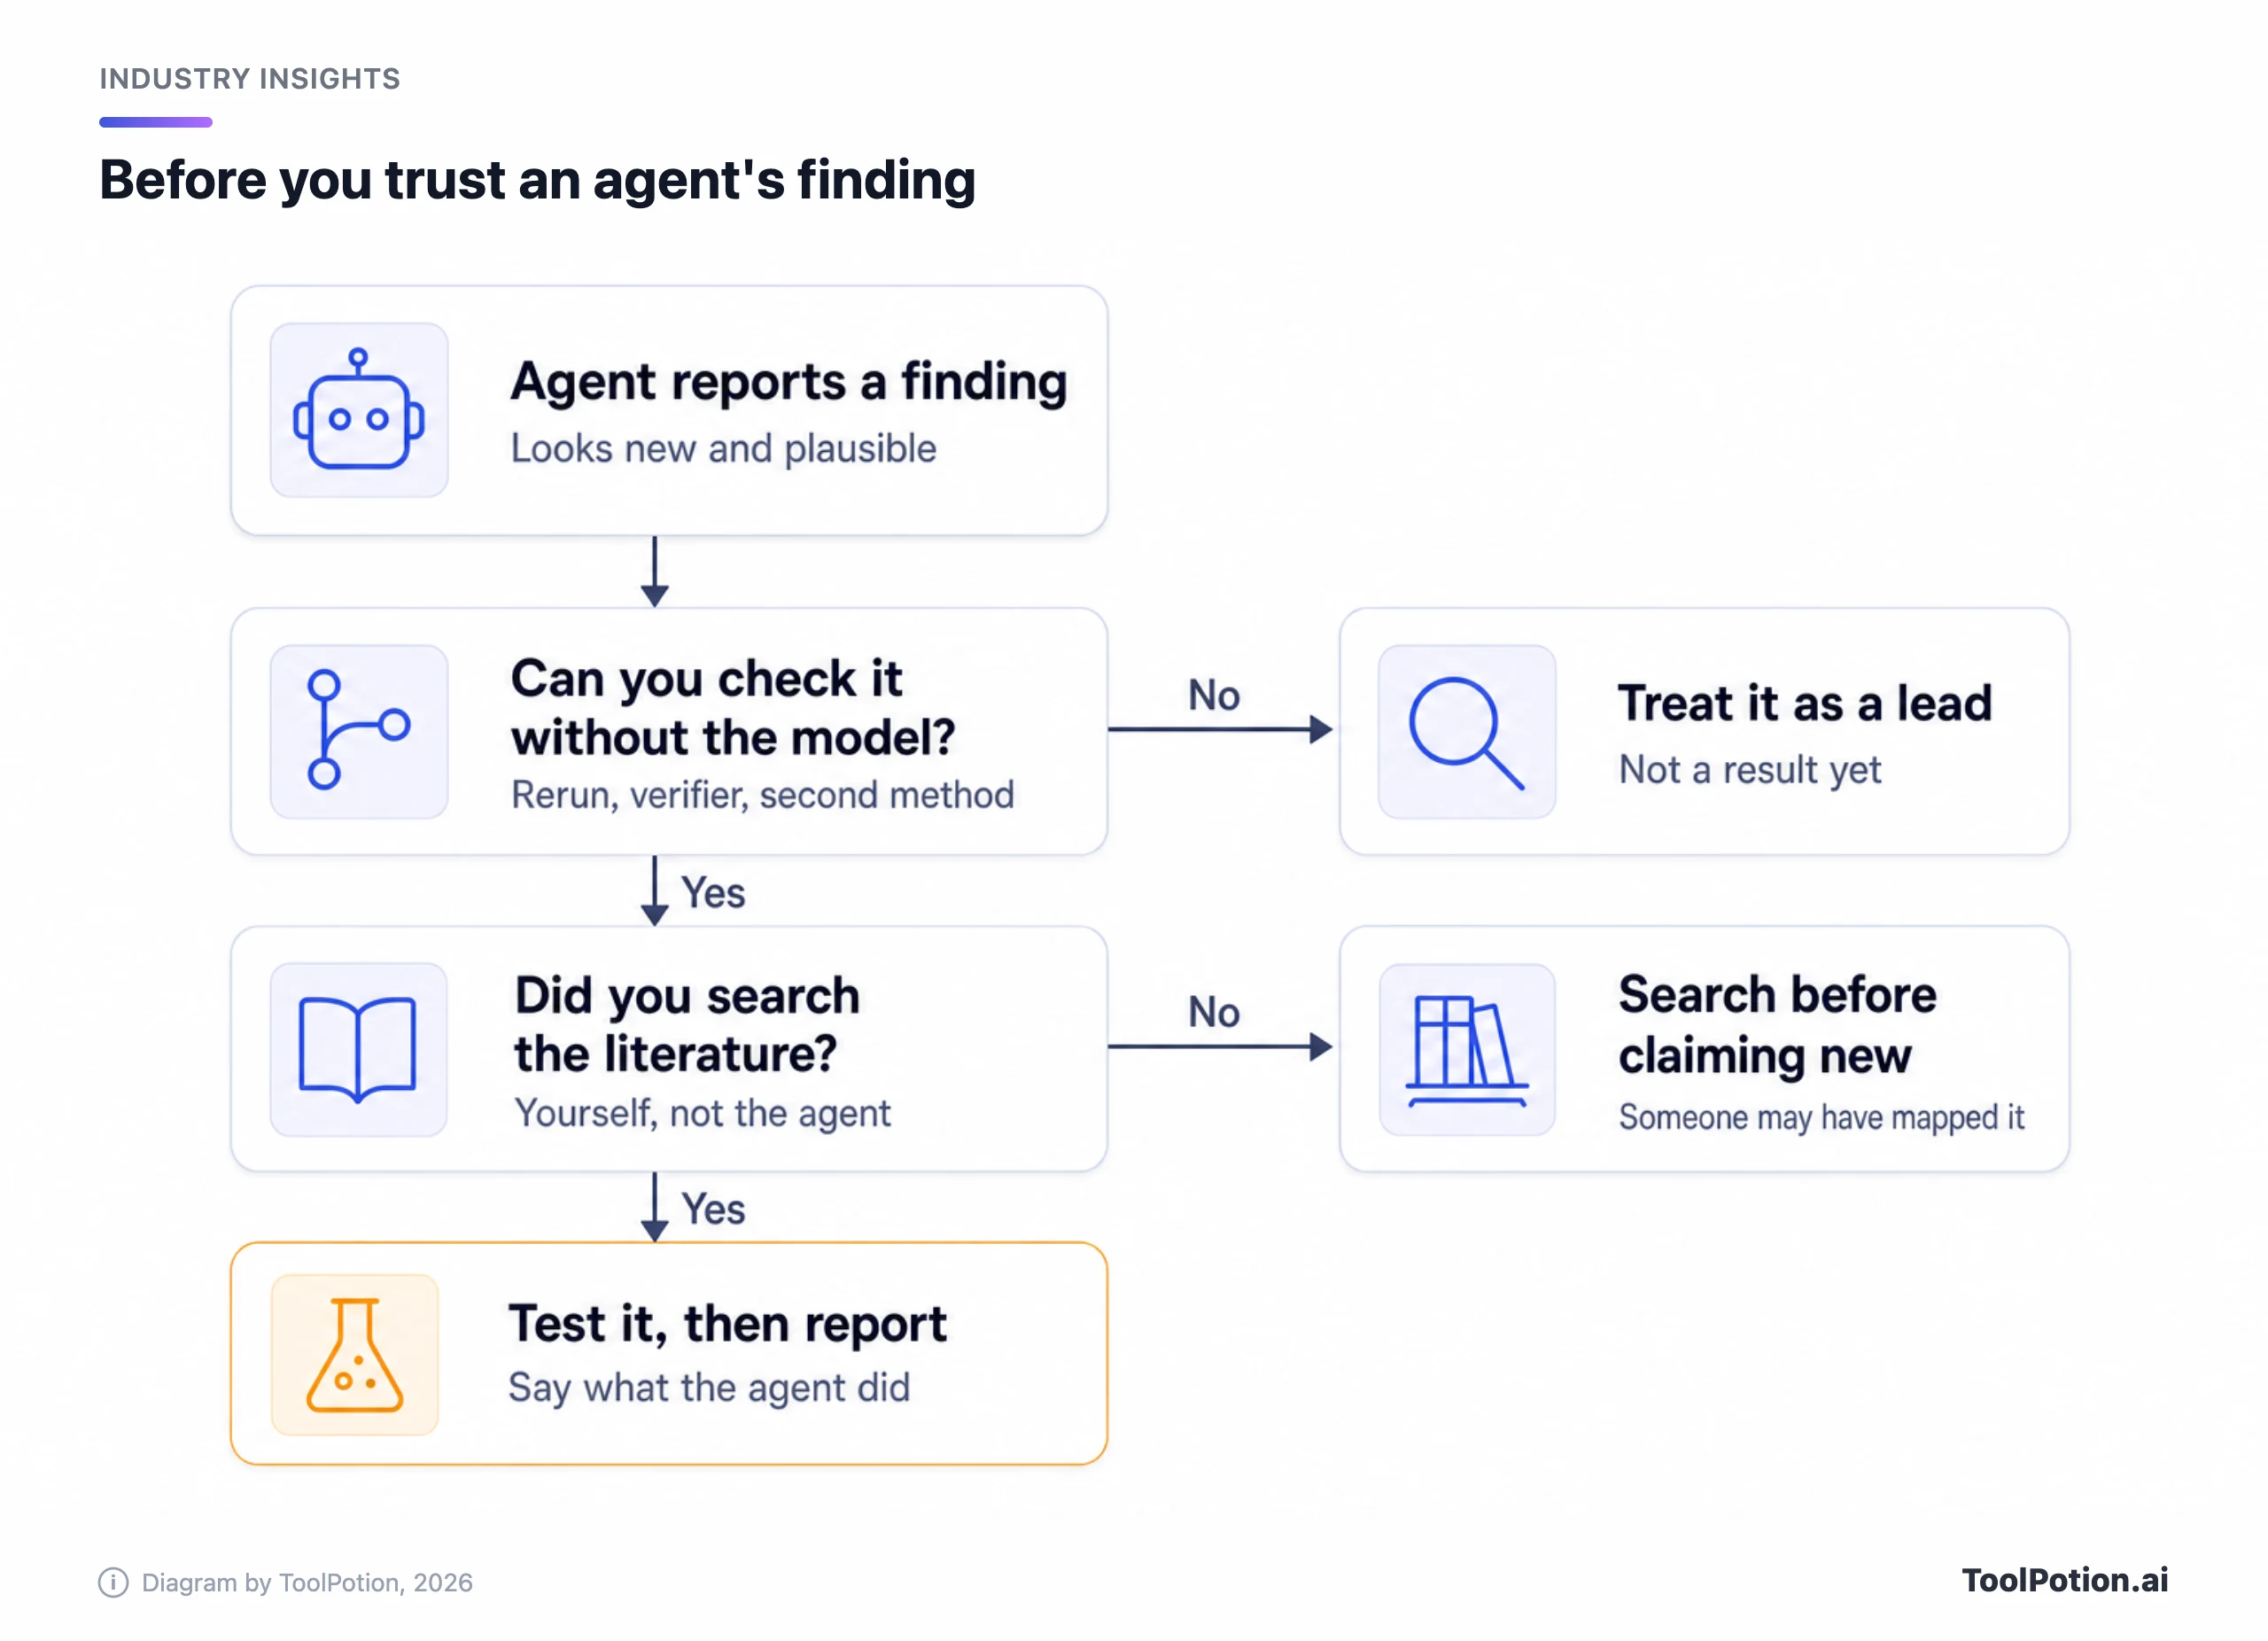
- 직접 확인할 수 있는 결과물을 내는 작업을 에이전트에게 맡기세요. 데이터 분석, 언어 간 코드 이식, 논문이나 이미지 스크리닝 같은 것입니다. Claude Code와 Claude Cowork가 이런 작업용으로 만들어졌고, 터미널 코딩 에이전트 비교에서 이 분야 전반을 다룹니다.
- 시작하기 전에 무엇을 검증으로 칠지, 누가 할지 정해 두세요. 같은 모델은 안 됩니다. 형식 검증기, 두 번째 분석, 실험대 실험, 또는 동료여야 합니다.
- 에이전트가 무언가 새롭다고 하면 문헌은 직접 검색하세요. Elicit, Consensus, SciSpace, ResearchRabbit 같은 전용 도구를 쓰면 몇 분이면 되고, 마야 유적 사례가 이를 건너뛰면 어떤 대가를 치르는지 보여 줍니다. 더 긴 목록은 AI 리서치 어시스턴트 순위에 있습니다.
- 물리적 단계는 사람이 맡고 기록으로 남기세요. 결과가 측정, 시료, 현장 방문에 달려 있다면 바로 그 지점에서 검증해야 합니다.
- 글로 정리할 때 에이전트가 무엇을 했는지, 그리고 본인이 무엇을 확인했는지 밝히세요. Schwartz는 인간의 기여가 타이핑이 아니었다고 단호하게 말합니다.
- 학생이라면 첫 모델은 직접 만드세요. 튀빙겐 저자들은 "통찰을 주는 것은 모델을 구성하는 과정"이라고 씁니다. 에이전트는 모델을 건네받는 용도가 아니라 내 모델을 비평하는 용도로 쓰세요.
AI가 생물학을 해낸 사례 중 더 오래되고 더 많이 검증된 예를 원하신다면 여전히 AlphaFold입니다. 구조를 예측하면 실험실이 이를 테스트합니다. 문헌 작업과 에이전트형 리서치에는 Edison Scientific도 있고, 직접 만든 에이전트를 무장시키는 Scientific Agent Skills, 그리고 연구자를 위한 AI 도구 Top 250 보드도 있습니다. 범용 어시스턴트가 궁금하다면 ChatGPT vs Claude vs Gemini에서 ChatGPT를 두 주요 경쟁자와 비교하고, AI 리서치 어시스턴트와 AI 에이전트 보드에서는 전문 도구의 순위를 매깁니다.
저희의 결론, 그리고 생각을 바꿀 조건
진짜인 것: 에이전트는 이제 지치지 않고 일하는 쓸모 있는 분석가이자 엔지니어입니다. 전자회로 프로토타입은 작동하고, 효소 단서는 흥미로우며, 모델이 낸 Lean 검증 증명은 누가 먼저 이해하게 되든 실제 결과입니다. Schwartz의 새 적분 15개는 좁은 분야에서 나온 진짜 결과입니다.
과장인 것: 자율성, 느슨하게 쓰이는 "검증", 그리고 곧 닥친다는 자동화된 과학자의 물결입니다. 위의 인상적인 결과는 거의 모두 그것이 참인지를 가르는 부분을 사람이 맡고 있고, 그 사람들도 그렇게 말합니다. 또 연구소들이 벤치마크 점수 옆에 달러 비용도 적어 주면 좋겠습니다. 크레딧과 토큰 수는 발견에 드는 비용을 가립니다. 효소 탐색 한 번에 토큰 2억 1,000만 개는 연구실 예산이 신경 쓰는 숫자입니다.
저희 생각을 움직일 만한 것은 두 가지입니다. 하나는 OpenAI 위원회 밖의 수학자들이 Yang-Mills Lean 코드를 읽고 이해했다고 보고하는 것입니다. 다른 하나는 이 시스템이 무엇을 하는지 밝히는, 동료 심사를 거친 효소 연구 버전입니다. 그때까지는 둘 다 유망하지만 미완성으로 보겠습니다.