

2026년 대부분의 사람에게 가장 좋은 AI 리서치 어시스턴트는 Perplexity이고, 답이 내가 가진 파일에서 나와야 할 때는 NotebookLM을 고르면 됩니다. 이 둘을 제외하면 무엇을 조사하느냐에 따라 선택이 달라집니다. 논문인지, 임상 질문인지, PDF 더미인지, 오픈 웹인지에 따라서요. 아래 리더보드에서 상위 25개를 순위로 보여 드리고, 이 가이드에서는 그중 써볼 만한 도구를 다룹니다.
이 카테고리는 복잡해 보여도 깔끔하게 나뉩니다. 웹을 검색하는 도구가 있고, 사용자가 건네준 자료만 읽는 도구가 있습니다. 학술 문헌을 검색하는 도구도 있고, 임상의를 위해 만들어진 유명한 도구도 하나 있습니다. 좋은 선택과 위험한 선택을 가르는 기준은 어디서나 같습니다. 각 주장이 어디서 나왔는지 볼 수 있어야 하고, 직접 확인할 수 있어야 합니다.
아래 내용은 모두 이 문제로 이어집니다. 이 분야의 제품은 곧 인용이고, 인용은 틀릴 수 있습니다.
현재 상위 25개
- # 1최고의 선택Perplexity — AI 답변 엔진AI 앱Perplexity는 정확하고 신뢰할 수 있으며 실시간으로 질문에 대한 답변을 제공하는 무료 AI 기반 답변 엔진으로, 정보 검색을 효율적이고 간단하게 만듭니다.92ToolRank엘리트
- # 22위NotebookLM모바일 앱NotebookLM은 사용자가 다양한 주제를 이해하는 데 도움을 주는 개인화된 AI 연구 도우미입니다. 사용자 친화적인 인터페이스와 강력한 기능을 제공하여 생산성을 향상시키고 연구 프로세스를 간소화합니다.74ToolRank강함
- # 33위OpenEvidenceAI 앱OpenEvidence는 의료 전문가를 위해 설계된 미국의 공식 의료 지식 플랫폼입니다. 이는 주요 의학 저널의 동료 검토 연구에 기반한 증거 기반 답변을 제공하여 임상 의사 결정을 지원합니다.73ToolRank강함
- 4OpenAI PrismAI 앱OpenAI Prism는 과학자를 위해 설계된 무료 LaTeX 편집기이자 AI 기반 작업 공간입니다. ChatGPT와 Codex를 통합하여 과학적 글쓰기와 협업을 향상시키며, AI 지원 교정, 인용 및 형식을 제공합니다.64ToolRank강함
- 5SciSpace AI for ResearchAI 앱SciSpace는 학술 연구를 위해 설계된 AI 연구 도우미로, 2억 8천만 개 이상의 논문에 대한 체계적인 문헌 검토를 가능하게 하고 인용된 출처로 논문 작성을 지원합니다. 전 세계 수백만 명의 학생, 박사 및 연구자들이 신뢰합니다.62ToolRank강함
- 6Google PinpointAI 앱Google Pinpoint는 저널리스트가 AI와 머신러닝을 사용하여 방대한 PDF, 손으로 쓴 문서, 이미지, 이메일 아카이브 및 오디오 파일 컬렉션 내에서 중요한 이야기를 신속하게 찾도록 돕습니다.61ToolRank강함
- 7ConsensusAI 앱Consensus는 동료 검토 문헌을 분석하여 연구를 가속화하는 AI 기반 학술 검색 엔진입니다. 사용자가 과학 논문을 10배 더 빠르게 찾고, 구성하고, 분석하도록 도와 문헌 검토 시간을 며칠에서 몇 분으로 단축합니다. 이 플랫폼은 고급 필터링 및 요약 기능을 통해 엄격한 학술적 조사를 지원합니다.61ToolRank강함
- 8Westlaw Precision AIAI 앱Westlaw Precision AI는 AI와 신뢰할 수 있는 콘텐츠를 활용하여 빠르고 전문적인 통찰력을 제공하는 고급 법률 연구 도구입니다. 이 도구는 법률 전문가들이 연구에서 전략으로 자신 있게 나아갈 수 있도록 도와주며, 포괄적이고 검증 가능한 결과를 보장합니다.60ToolRank강함
- 9ElicitAI 앱Elicit은 과학자 및 연구원이 1억 3,800만 개 이상의 학술 논문에서 데이터를 찾고, 요약하고, 추출하도록 돕는 AI 기반 연구 도우미입니다. 체계적인 문헌 검토를 자동화하고, 연구 보고서를 생성하며, 정확성을 위해 문장 단위 인용을 제공하여 다양한 산업 분야에서 더 빠른 발견과 증거 기반 의사 결정을 가능하게 합니다.60ToolRank강함
- 10제미니 노트북AI 앱제미니 노트북은 구글이 개발한 정보 기반 AI 연구 노트북으로, 빠른 요약 및 메모 작성을 위해 설계되었습니다. 신뢰할 수 있는 정보와 통찰력을 제공하는 가상 연구 도우미 역할을 합니다.59ToolRank견고
- 11PatSnap AI 혁신 플랫폼AI 앱PatSnap은 특허 검색, 작성, 모니터링 및 IP 분석을 제공하는 AI 기반 플랫폼입니다. 20억 개 이상의 전문가 데이터 포인트를 활용하여 R&D 생산성을 75% 향상시키며, 전 세계 15,000명 이상의 혁신가들이 신뢰하고 있습니다.58ToolRank견고
- 12Semantic ScholarAI 앱Semantic Scholar는 과학 문헌을 쉽게 찾을 수 있도록 돕는 무료 AI 기반 연구 도구입니다. 최첨단 AI와 엔지니어링을 활용하여 연구 논문의 의미론을 이해하고, 모든 과학 분야의 학술 콘텐츠를 더 쉽게 찾고 활용할 수 있도록 합니다. 이 플랫폼은 연구 접근성과 맥락을 향상시키는 것을 목표로 합니다.57ToolRank견고
- 13Rayyan AI 검토 플랫폼AI 앱Rayyan은 연구자들이 체계적 문헌고찰 및 문헌 검토를 가속화하도록 설계된 AI 기반 플랫폼입니다. 스크리닝, 중복 제거, 데이터 추출과 같은 주요 작업을 자동화하여 팀이 더 빠르고 효율적으로 증거를 종합할 수 있도록 지원합니다. 전 세계 백만 명 이상의 연구자로부터 신뢰받는 Rayyan은 전체 검토 워크플로우를 간소화합니다.56ToolRank견고
- 14Readwise ReaderAI 앱Readwise Reader는 파워 리더를 위해 설계된 종합적인 나중에 읽기 앱입니다. 기사, PDF 등을 한 곳에 통합하여 강력한 검색 및 하이라이팅 기능을 제공합니다.55ToolRank견고
- 15ResearchRabbitAI 앱ResearchRabbit는 연구자가 관련 논문을 발견하고, 인용 지도를 구축하며, 연구 동향을 추적하는 데 도움을 주어 문헌 검토를 간소화합니다. 학술 문헌 탐색을 지루한 작업에서 호기심 기반의 발견 과정으로 전환하여 연구원과 학생들의 소중한 시간을 절약해 줍니다.55ToolRank견고
- 16SciteAI 앱Scite는 3억 개 이상의 학술 기사를 검색하여 인용 기반의 답변을 제공하는 AI 도구입니다. 이 도구는 연구자들이 주장의 근거를 이해하는 데 도움을 주어 문헌 검색을 보다 효율적이고 신뢰할 수 있게 만듭니다.55ToolRank견고
- 17HebbiaAI 앱Hebbia는 금융 전문가를 위해 설계된 AI 플랫폼으로, 고위험 의사 결정을 지원하는 기관 인텔리전스를 제공합니다. 금융 데이터 소스에 연결하여 사용자가 문서를 분석하고, 통찰력을 발견하며, 워크플로우를 자동화할 수 있도록 합니다. 주요 금융 기관에서 신뢰하는 Hebbia는 투자 프로세스의 속도와 영향력을 향상시키는 것을 목표로 합니다.53ToolRank견고
- 18LinerAI 앱Liner는 웹 브라우징 및 조사를 강화하도록 설계된 AI 기반 도구입니다. 사용자가 웹 페이지의 콘텐츠를 강조 표시하고, 구성하고, 저장하여 개인화된 지식 기반을 만들 수 있습니다. 이 플랫폼은 온라인 데이터를 효율적으로 관리하려는 학생, 연구원 및 전문가를 위한 정보 검색 및 보존을 간소화하는 것을 목표로 합니다.53ToolRank견고
- 19Scopus 데이터베이스AI 앱Scopus는 과학, 기술, 의학 및 사회 과학 문헌에 대한 접근을 제공하는 포괄적인 초록 및 인용 데이터베이스입니다. 연구자들이 트렌드를 식별하고, 협력자를 찾고, 연구 영향을 측정할 수 있도록 고급 검색 도구와 메트릭을 제공합니다.53ToolRank견고
- 20ScholarcyAI 앱Scholarcy는 논문, 기사 및 교과서를 인터랙티브 플래시카드로 요약하여 연구를 간소화합니다. 사용자가 복잡한 연구를 이해하고 지식을 효율적으로 정리하는 데 도움을 줍니다.53ToolRank견고
- 21Dimensions AIAI 앱Dimensions AI는 보조금, 출판물, 데이터 세트, 임상 시험, 특허 및 정책 문서를 연결하는 포괄적인 연구 데이터베이스입니다. 연구 분석 도구를 제공하여 사용자가 전략적 통찰력을 위해 글로벌 연구 데이터를 신속하게 탐색하고 해석할 수 있도록 합니다.52ToolRank견고
- 22InstrumentlAI 앱Instrumentl은 비영리 단체가 보조금을 효율적으로 찾고, 획득하며, 관리할 수 있도록 돕는 AI 기반의 보조금 관리 플랫폼입니다. 포괄적인 데이터베이스, AI 기반의 매칭, 제안서 작성 및 수상 후 관리 도구를 모두 하나의 작업 공간에서 제공합니다.51ToolRank견고
- 23GPT ResearcherGitHub 저장소GPT Researcher는 모든 주제에 대한 심층 연구를 위해 설계된 자율 에이전트로, 인용과 함께 상세하고 사실적이며 편견 없는 보고서를 생성합니다. 플래너 및 실행 에이전트를 활용하여 연구 질문을 생성하고 정보를 수집합니다. 이 도구는 사용자 정의 옵션을 제공하며 로컬 연구를 위해 다양한 파일 형식을 지원합니다.51ToolRank견고
- 24Connected PapersAI 앱Connected Papers는 연구원 및 응용 과학자가 자신의 작업과 관련된 학술 논문을 발견하고 탐색할 수 있도록 설계된 시각적 도구입니다. 유사한 논문의 대화형 그래프를 생성하여 사용자가 특정 분야의 트렌드, 인기 있는 연구 및 역학을 시각적으로 이해하도록 돕고 중요한 연구를 놓치지 않도록 보장합니다.51ToolRank견고
- 25Atlas.tiAI 앱Atlas.ti는 연구자, 학생 및 기업을 위한 AI 기반 도구를 제공하는 질적 데이터 분석을 위한 선도적인 소프트웨어입니다. 다양한 데이터 형식을 지원하며 효율적인 분석 및 협업을 위한 직관적인 기능을 제공합니다.50ToolRank견고





ToolRank 작동 방식
ToolRank는 ToolPotion이 자체 개발한 순위 엔진입니다.
실제 트래픽과 인기, 오디언스와 커뮤니티의 힘, 권위와 지속성, 도입과 참여 등 오픈 웹 전반의 수백 가지 신호를 지속적으로 평가하고, 수백만 개의 데이터 포인트를 처리해 모든 도구를 제자리에 배치합니다.
AI 유형마다 맞춤형 모델로 측정합니다. SaaS 앱의 성장세를 증명하는 기준은 오픈 소스 프레임워크나 크리에이터 채널에는 맞지 않기 때문입니다. 특정 플랫폼에 없다고 해서 불이익을 받는 일은 없습니다. ToolRank는 존재하는 근거만으로 판단합니다.
유료 순위는 없습니다. 자체 신고 수치도 쓰지 않습니다.
빠른 추천
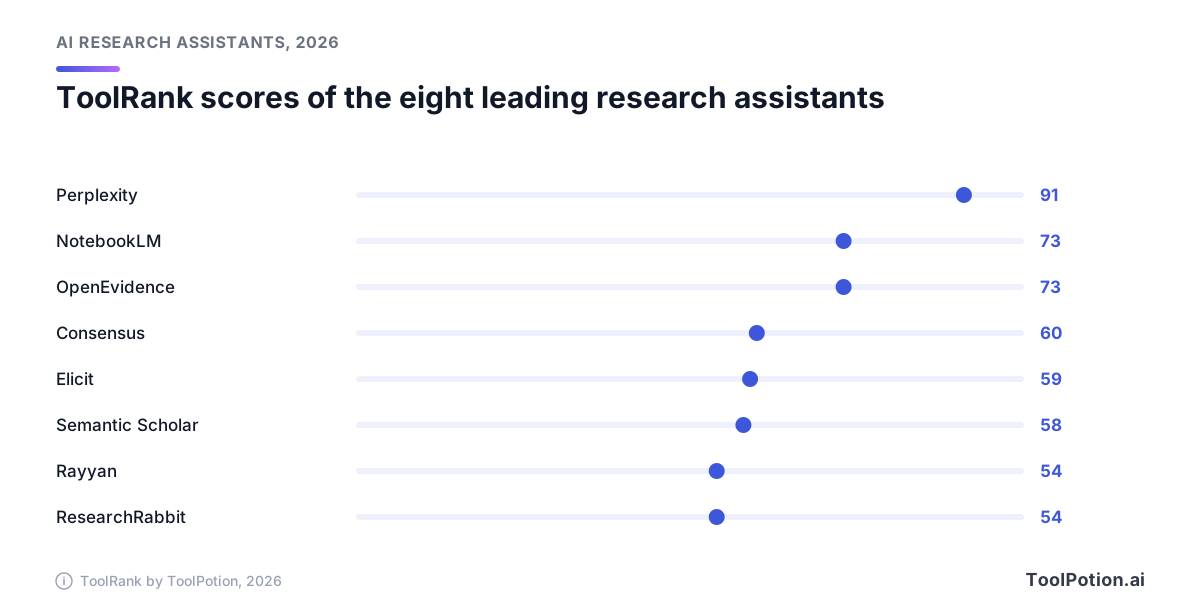
- 종합 1위는 Perplexity입니다. 2026년 순위표에서 엘리트 등급 ToolRank 91점으로 1위를 차지했고, 다음 도구와 18점 차이가 납니다.
- 내 문서 기반 리서치에는 NotebookLM(현재 브랜드명 Gemini Notebook)이 최고입니다. 업로드한 자료만을 근거로 답하기 때문입니다.
- 학술 문헌에는 Consensus가 연구들이 말하는 바를 빠르게 파악하기에 좋고, Elicit은 논문에서 데이터를 뽑아내는 데 좋습니다.
- Semantic Scholar는 무료로 쓸 수 있는 최고의 학술 도구이며, 개발사는 비영리 연구소입니다.
- 임상의라면 의료 질문용으로 만들어진 OpenEvidence를 살펴보세요.
- 체계적 문헌고찰을 진행한다면 Rayyan으로 시작하세요. 지루한 스크리닝 작업을 맡아 줍니다.
이들이 Top 100 AI 리서치 어시스턴트 순위표의 선두 주자입니다. 차트를 보면 중위권이 얼마나 촘촘한지, 그리고 Perplexity가 그 위로 얼마나 앞서 있는지 알 수 있습니다.
2026년에 달라진 점
Google이 2026년에 NotebookLM의 이름을 Gemini Notebook으로 바꿨습니다. Google은 같은 독립 제품이며, 이제 소스를 대상으로 코드를 실행하는 보안 클라우드 컴퓨터가 추가됐고 사용자는 3,000만 명이 넘는다고 밝혔습니다(Google). 저희 순위표에는 아직 NotebookLM이라는 이름으로 올라 있습니다. NotebookLM은 선두권 가운데 가장 크게 도약해, 2026년 순위표에서 10위에서 2위로 올라섰습니다.
OpenEvidence는 제약회사 등의 광고를 재원으로 의료 전문가에게 계속 무료로 제공됩니다. CEO는 이 모델을 바꾸고 싶다고 말한 바 있습니다(NBC News). 그렇다면 누가 대신 비용을 낼지는 아직 아무도 밝히지 않았습니다.
덜 반가운 변화는 논문 쪽에 있습니다. 올해 초 arXiv는 검증하지 않은 AI 출력물이 드러난 논문의 저자에게 1년간 투고 금지 처분을 내리기 시작했습니다. 존재하지 않는 참고문헌도 여기에 포함됩니다(SMU Libraries). 인용한 이상 책임도 본인에게 있습니다. 이것이 새로운 기본선입니다.
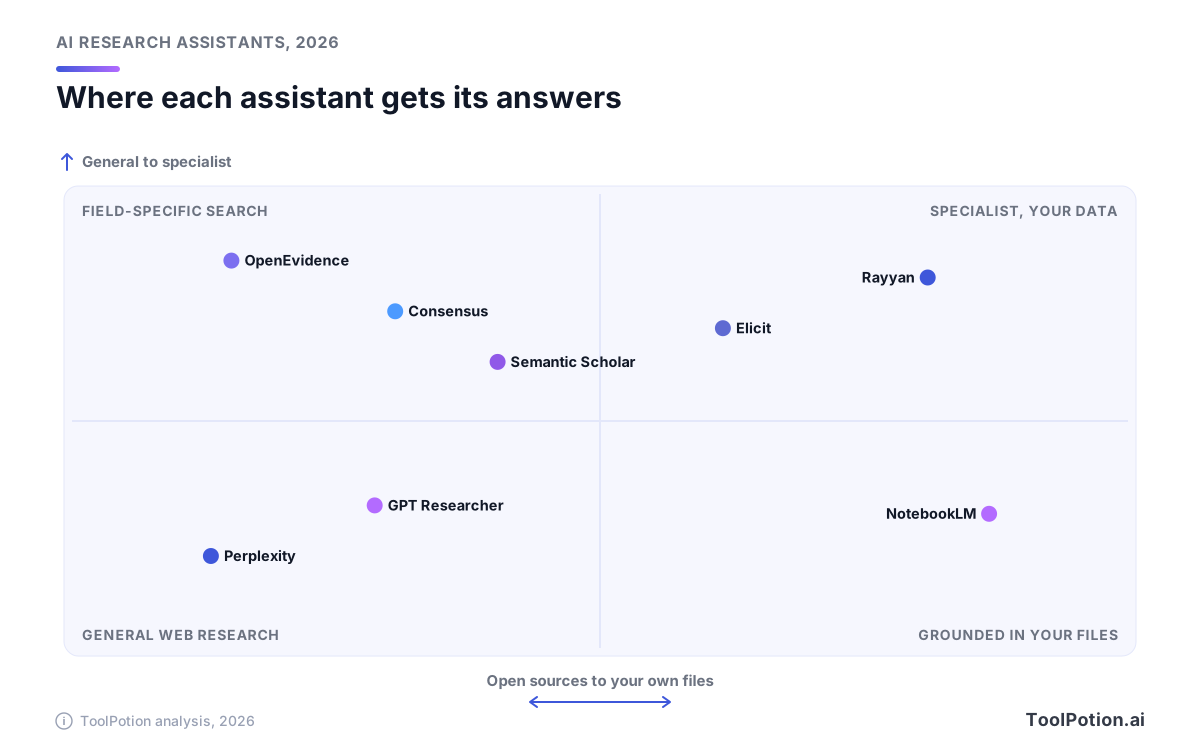
아래 지도는 각 도구가 어디서 답을 가져오는지, 그리고 얼마나 전문화되어 있는지를 기준으로 이 분야를 분류한 것입니다.
신뢰 문제는 곧 인용 문제입니다
근거 기반 답변은 다섯 단계를 거쳐 만들어지고, 오류는 어느 단계에서든 끼어들 수 있습니다.
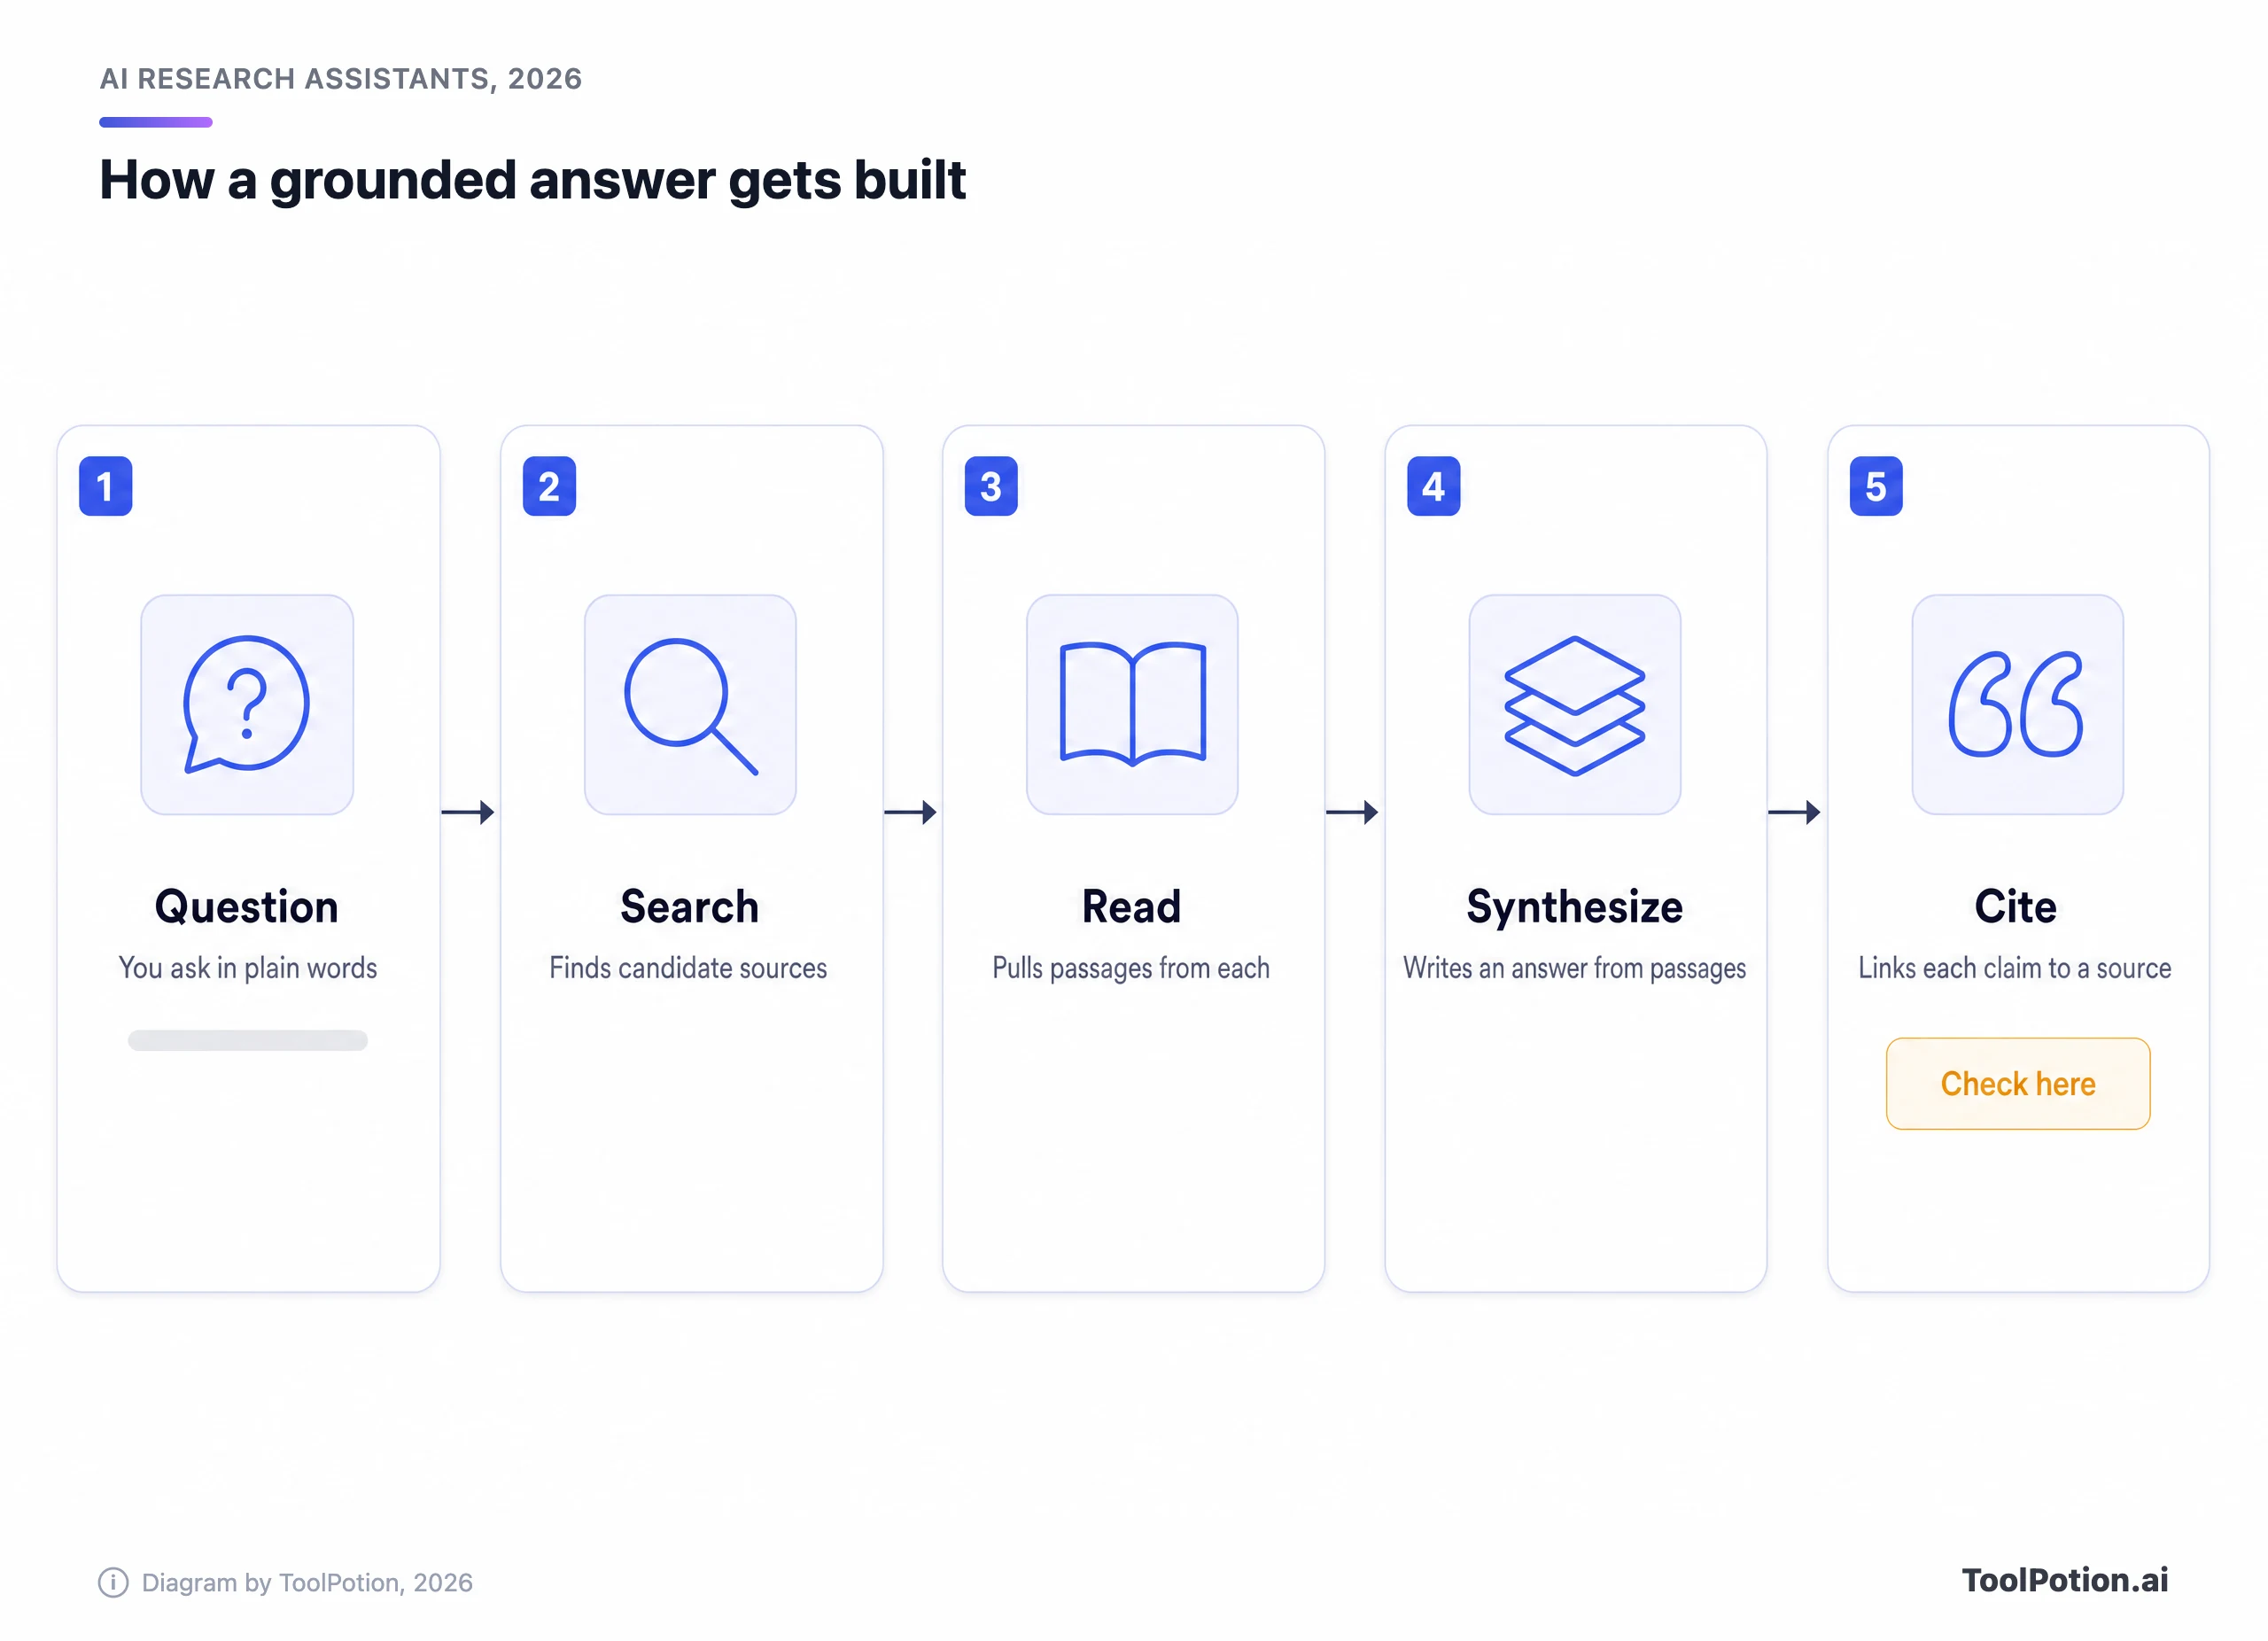
검색은 핵심 논문을 놓칠 수 있습니다. 읽기는 초록에서 멈출 수 있습니다. 글쓰기 단계에서는 내용이 원문 구절에서 벗어날 수 있습니다. 마지막 단계에서는 실제로 존재하는 링크를 그 링크가 뒷받침하지 않는 주장에 붙일 수도 있습니다. HKUST 사서들의 테스트에서는 다른 도구들이 대체로 초록만 가져온 반면 Scite는 전문(全文)을 가져왔습니다(HKUST Library).
가장 잘 알려진 검증은 컬럼비아대 Tow Center에서 나왔습니다. AI 검색 엔진 8개에 뉴스 기사 발췌문을 주고 헤드라인, 발행처, 날짜, URL을 찾아내게 했는데, 전체적으로 60% 넘는 질의에서 틀렸습니다. Perplexity가 오류율 37%로 가장 나았지만, Perplexity와 Grok의 유료 등급은 무료 등급보다 오히려 더 확신에 차서 틀렸고, 여러 도구가 지어낸 링크나 깨진 링크를 인용했습니다(Columbia Journalism Review). 이 테스트는 엔진이 뉴스 발췌문의 출처를 얼마나 잘 찾는지를 측정한 것이지, 학술 논문을 어떻게 인용하는지를 본 것이 아닙니다. 특정 도구에 대한 판정이 아니라 확신에 찬 답변에 대한 경고로 받아들이세요.
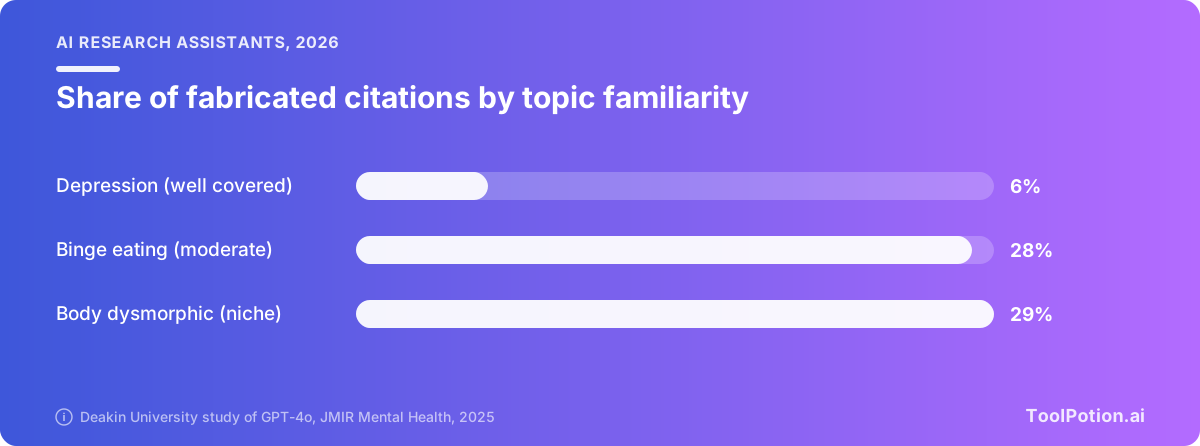
논문과 관련해 가장 날카로운 증거는 일반 챗봇에 관한 것인데, 바로 그래서 근거 기반(grounding)이 중요합니다. Deakin University 연구진은 GPT-4o에게 정신건강 주제로 문헌고찰 6편을 쓰게 했습니다. 생성된 인용 중 19.9%는 지어낸 것이었고, 실제 존재하는 인용의 45.4%에는 잘못된 DOI 같은 오류가 있었습니다(EurekAlert). 유용한 건 그 패턴입니다. 연구가 아주 많은 우울증에서는 날조 비율이 6%였고, 덜 다뤄진 두 주제에서는 28~29%였습니다.
전용 리서치 어시스턴트는 더 낫지만 완벽하지는 않습니다. HKUST 테스트에서 Scite, Elicit, Consensus, Scopus AI는 수면과 체중 증가에 관한 질문에 모두 실제 인용을 반환했습니다. 하지만 각 논거를 출처와 맞춰 보는 일은 또 다른 문제였고, Scopus AI가 가장 약해서 출처가 뒷받침하지 않는 논거를 내놓았습니다. 사서들은 이 결과물을 문헌고찰의 대체물이 아니라 출발점이라고 평가했습니다. 연구가 충분한 주제에 대한 질문 하나였으니, 마이너한 주제에서는 더 거친 결과를 예상해야 합니다.
그래서 실전 원칙은 간단합니다. 주장을 쓰기 전에 출처를 여세요. 중요한 내용은 다시 돌려 보세요. 그리고 새 도구는 이미 훤히 아는 주제로 먼저 테스트하세요.
선두 주자 리뷰
Perplexity: 오픈 웹에서 인용이 달린 답을 빠르게 얻기에 최고
Perplexity는 2026년 순위표 1위이며 ToolRank 엘리트 등급 91점으로, 이 순위표에서 유일한 엘리트 점수입니다. 웹을 검색하고 답변 옆에 출처를 보여 주기 때문에 첫 훑어보기는 빠르고 두 번째 검증도 쉽습니다. 단점은 Tow Center가 찾아낸 그것입니다. 8개 엔진 중 가장 덜 틀렸는데도 뉴스 발췌문의 출처를 찾게 하자 37%는 틀렸습니다. 논문 인용과는 다른 작업이긴 합니다. Pro는 모델 전환 기능과 더 깊은 리서치 실행을 더해 월 $20이고, Max는 $200입니다(CloudZero의 2026년 가격 가이드 기준). 무료 등급도 있습니다.
NotebookLM: 답이 내 파일에서 나와야 할 때 최고
NotebookLM은 73점으로 2위, 강력 등급입니다. 논문, 메모, 녹취록을 업로드하면 그 안에서만 답하므로 지어낸 사실이 끼어들 여지가 줄어듭니다. 반대로 말하면, 추가하는 걸 깜빡한 자료가 있어도 알려 주지 못합니다. 무료 플랜은 노트북 100개, 노트북당 소스 50개, 하루 채팅 50회를 허용하며, 유료 Google AI 플랜은 이 한도를 높여 줍니다(Google Help). 졸업논문 폴더나 보고서 더미를 다룬다면 순위표에서 가장 잘 맞는 도구입니다.
OpenEvidence: 문헌을 확인하는 임상의에게 최고
OpenEvidence는 3위로 역시 73점, 강력 등급이며, 상위권에서 유일한 의료 전문 도구입니다. 임상 질문에 동료 심사를 거친 학술지를 근거로 답하고, 의료 전문가는 무료로 쓸 수 있습니다. 정확도에 대한 근거는 아직 빈약합니다. MedXpertQA 전문의 시험 데이터셋에서 세부 전문 분야 시나리오 100개를 테스트한 프리프린트에서는 빠른 검색의 정확도가 최대 34%, Deep Consult는 41%였고, 저자들은 전문가의 감독이 여전히 필수라고 주장했습니다(medRxiv). 프리프린트이고 문제도 어려웠습니다. 그래도 이런 도구는 임상의를 대체하지 못하며, 의사 대신 쓰면 안 됩니다.
Consensus: 연구들이 말하는 바를 빠르게 파악하기에 최고
Consensus는 60점으로 4위, 강력 등급이며 2026년 순위표에서 6위에서 올라왔습니다. 학술 논문을 검색하기 때문에 예/아니오 질문을 던지면 웹 페이지 더미 대신 연구 요약이 돌아옵니다. HKUST 테스트에서는 각각 인용 10개 안팎이 달린 길고 구조화된 요약을 내놓았습니다. 결제 전에 최신 요금제는 라이브 가격 페이지에서 확인하세요.
Elicit: 여러 논문에서 데이터를 뽑아내기에 최고
Elicit은 8위에서 올라 5위이며 안정 등급 59점입니다. 강점은 추출입니다. 논문 표를 만들고 표본 크기나 결과 같은 같은 항목을 각 논문에서 뽑아 달라고 요청할 수 있습니다. 무료 Basic 플랜은 1억 3,800만 편의 논문을 검색합니다. Pro는 월 $49(연 $588)이며 논문 5,000편을 스크리닝할 수 있는 체계적 문헌고찰 워크플로가 추가되고, Scale은 $169입니다(Elicit 가격). 무료에서 $49로 넘어가는 폭이 크고, 본격적인 기능은 그 뒤에 있습니다.
Semantic Scholar: 무료 학술 검색 최고
Semantic Scholar는 58점으로 6위이고, 2026년 순위표에서 4위에서 내려왔습니다. 어시스턴트라기보다 검색 엔진이며, 비영리 기관인 Allen Institute for AI가 만들었습니다. 2억 편이 넘는 논문을 색인하고 있으며 무료입니다(Semantic Scholar). 대신 생각해 주는 채팅창은 없습니다. 많은 학생에게는 오히려 장점입니다.
Rayyan: 체계적 문헌고찰 스크리닝에 최고
Rayyan은 54점으로 8위입니다. 팀들이 포함 기준에 따라 수천 건의 제목과 초록을 스크리닝하는 데 쓰며, AI가 관련성이 높아 보이는 것을 제안해 줍니다. 무료 플랜은 진행 중인 리뷰 3건과 무료 리뷰어 2명까지 지원하고, Essential은 연간 결제 시 월 $4.99부터 시작합니다(Rayyan). 워크플로 도구이므로 답을 써 주는 질문창을 기대하지는 마세요.
ResearchRabbit: 몇 편의 시드 논문으로 분야를 지도화하기에 최고
ResearchRabbit은 16위에서 9위로 올라섰고 54점을 받았습니다. 신뢰하는 논문에서 출발하면 관련 연구의 컬렉션과 인용 지도를 만들어 줍니다. 논문을 찾아 주기만 하고 요약은 하지 않습니다. 읽기 도구와 함께 쓰면 분야가 어떻게 생겼는지 아직 모르는 프로젝트 초반에 제 몫을 합니다.
Scite: 후속 논문이 주장을 뒷받침하는지 확인하기에 최고
Scite는 54점으로 10위입니다. Smart Citations는 후속 연구가 논문을 지지하는지 반박하는지 보여 주는데, 단순 인용 횟수로는 가려지는 맥락입니다. HKUST 비교에서 네 도구 중 요약이 가장 포괄적이었고, 전문을 가져온 것도 Scite뿐이었습니다. 검색과 어시스턴트는 유료 플랜이며 연간 결제 시 월 $20부터입니다(Scite 가격). 누가 이 주장에 반론을 폈는지 알고 싶을 만큼 중요한 주장이 있을 때 써 보세요.
GPT Researcher: 딥 웹 리서치용 최고의 오픈소스
GPT Researcher는 50점으로 17위이며, 상위 25개 중 유일한 오픈소스 프로젝트입니다. 플래너 에이전트가 리서치 질문을 작성하고, 다른 에이전트들이 자료를 모으며, 퍼블리셔가 인용이 달린 보고서를 조립합니다. 프로젝트는 Apache-2.0 라이선스이고 GitHub 스타가 약 29,900개입니다(GitHub). 직접 실행하고 모델도 직접 제공해야 하므로, 마감에 쫓기는 학생보다는 개발자와 만지작거리기 좋아하는 분께 맞습니다.
점수는 아직 없지만 순위에 오른 도구가 세 개 더 있습니다. Scopus Database(7위)는 인용 데이터베이스, Readwise Reader(11위)는 나중에 읽기 앱, Atlas.ti(15위)는 질적 분석용입니다. 유용하긴 하지만 나머지와는 종류가 달라서 위 차트에서는 빠져 있습니다.
선택 방법
어떤 종류의 리서치를 하는지부터 정하세요. 대부분 그것으로 결정됩니다. 가격은 두 번째, 도구의 완성도는 마지막입니다.
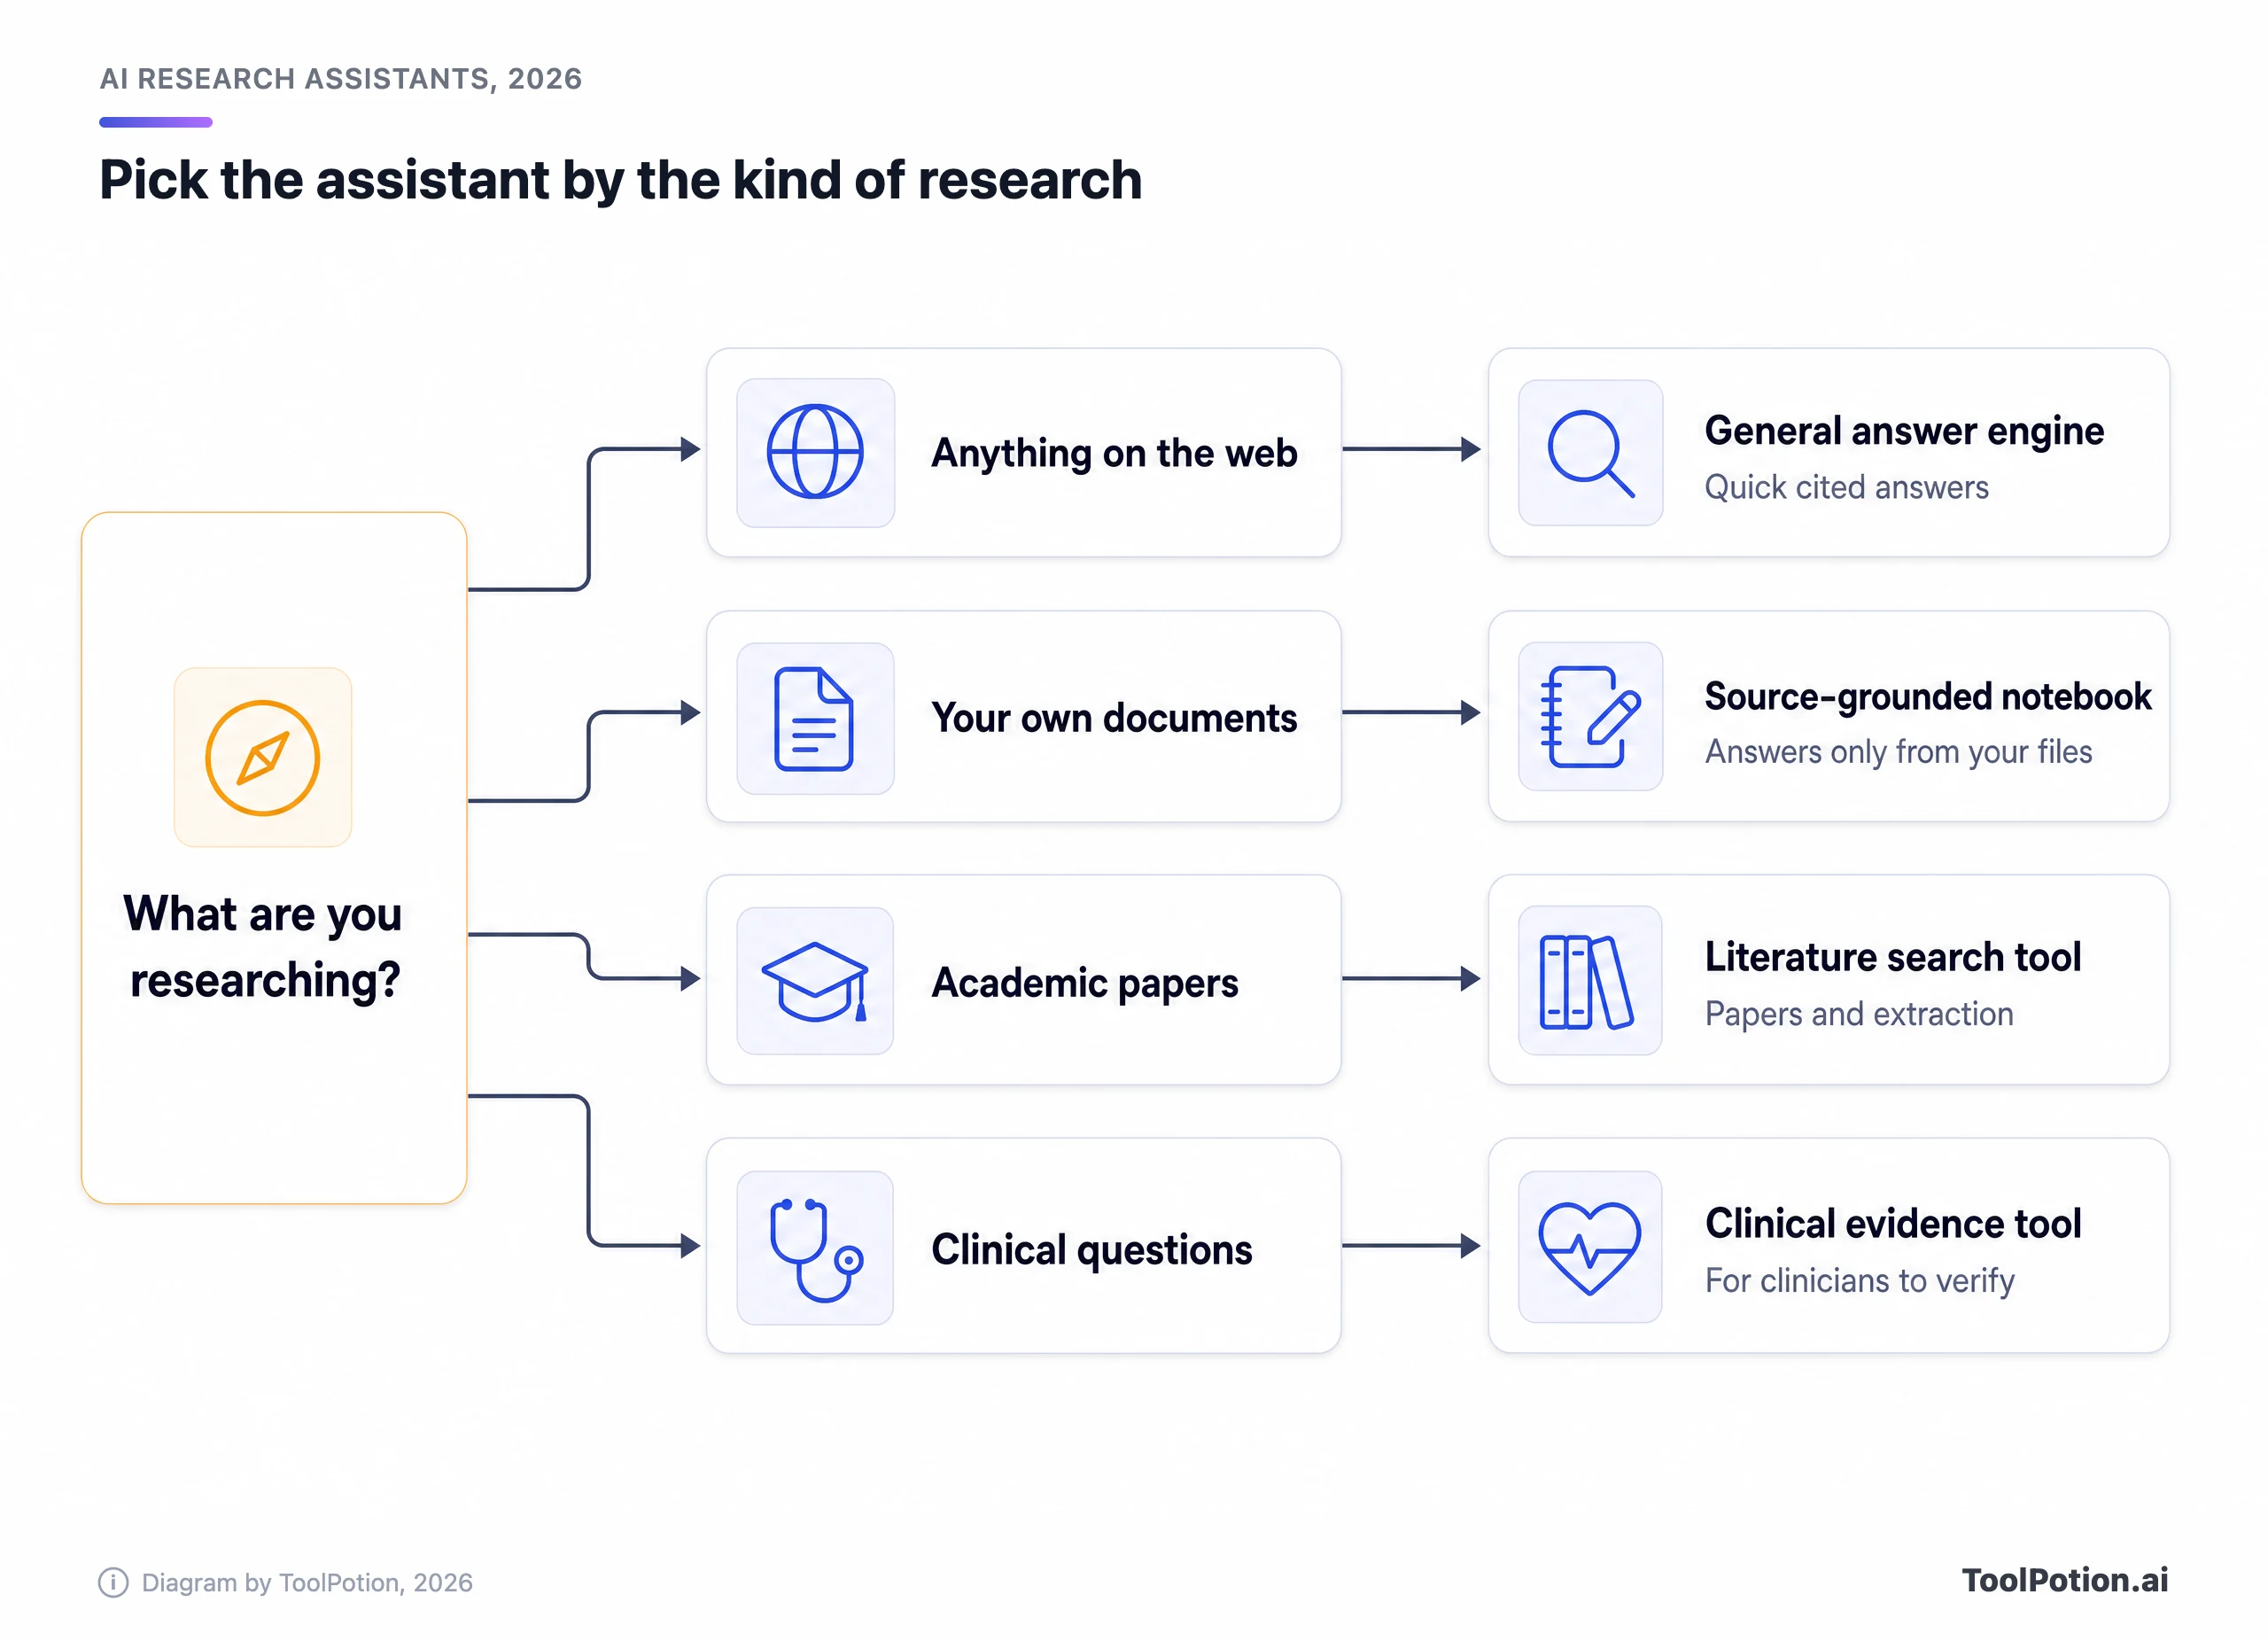
문헌고찰 작성은 대표적인 난관입니다. 어떤 연구가 있는지 찾을 때는 Consensus나 Semantic Scholar, 인용 흐름을 따라가려면 ResearchRabbit, 데이터 추출에는 Elicit, 고찰이 공식적이어야 하면 Rayyan을 쓰세요. 정해진 보고서나 인터뷰 묶음으로 작업한다면 NotebookLM이 모두를 앞섭니다. 직접 검증할 수 있는 주제에 대해 빠른 답이 필요하다면 Perplexity면 충분합니다.
특별히 조심해야 할 상황이 둘 있습니다. 의료와 관련된 것은 전문가를 거쳐야 하며, OpenEvidence는 환자가 아닌 임상의를 위한 도구입니다. 그리고 Deakin 수치가 치솟았던 마이너한 주제는 모든 참고문헌을 직접 열어 봐야 합니다.
가격보다 무료 등급이 더 중요하니 그것부터 써 보세요. 표는 선두 도구 9개를 검색 대상과 가격별로 정리한 것입니다. 확인하지 못한 수치는 그렇다고 표시했습니다.
ToolRank 소개
ToolRank는 ToolPotion이 독립적으로 매기는 AI 도구 랭킹이며, 순위는 돈으로 살 수 없습니다. 모든 순위표에는 점수가 매겨진 항목마다 점수와 등급이 표시됩니다. 전체 순위표는 ToolRank 리더보드 페이지에서 볼 수 있습니다.
연구자의 시간을 낭비하게 하는 실수
가장 흔한 실수는 범용 챗봇으로 참고문헌을 만들어 내는 것입니다. 왜 실패하는지는 Deakin 수치가, 어떤 대가를 치르는지는 arXiv 투고 금지가 말해 줍니다. 검색 과정을 보여 주는 리서치 어시스턴트가 더 안전한 출발점이고, 내 문서만 읽는 도구는 그보다도 안전합니다.
두 번째는 첫날부터 최상위 요금제에 가입하는 것입니다. Perplexity의 Max 등급은 월 $200, Elicit의 Scale 등급은 $169이며, 둘 다 헤비 유저를 위한 것입니다. 대부분의 학생과 분석가는 그 한도 근처에도 가지 못합니다. 무료 등급으로 시작해 한계에 부딪힌 뒤, 실제로 부딪힌 그 한계에 대해서만 비용을 내세요.
세 번째는 요약을 문헌고찰로 착각하는 것입니다. 도구는 초록 열 편이 무슨 말을 하는지는 알려 줄 수 있습니다. 하지만 어떤 연구가 부실한지, 어떤 연구가 오래됐는지, 그 묶음에서 무엇이 빠졌는지는 알려 주지 못합니다. 그건 여전히 여러분의 몫이고, 사람이 읽는 가치가 드러나는 지점입니다.
마지막은 의료 전문이 아닌 도구에 의료 질문을 던지고 매끄러운 답변을 그대로 믿는 것입니다. 그러지 마세요.
주목할 만한 상승세 도구와 신규 도구
Connected Papers는 논문 간 관계를 시각적 지도로 보여 주며 15위에서 13위로 올랐습니다. 상위 25개 바로 뒤에는 몇몇 신생 도구가 따라붙고 있습니다. Ai2 Asta(27위)는 Semantic Scholar를 만든 같은 연구소 제품으로, 문헌 이해와 데이터 기반 발견을 결합합니다. Keenious(34위)는 작성 중인 글에 맞는 논문을 추천하고 Word와 연동됩니다. PapersFlow(32위)는 AI 워크스페이스 안에서 문헌고찰을 제공하고, AnswerThis(40위)는 직접 인용이 달린 답변을 내놓습니다. STORM(33위)은 출처가 달린 위키피디아 스타일 글 초안을 쓰는 Stanford 연구 프로토타입입니다.
나머지는 AI 리서치 어시스턴트 전체 디렉터리에서 확인하세요. 작업 범위가 더 좁다면 관련 순위표가 더 나은 출발점입니다. 학술 문헌 검색용 AI 도구, 연구자를 위한 AI 도구, 학술 글쓰기와 인용, PDF 문서와 대화하는 도구 등이 있습니다. 아니면 맨 위의 실시간 리서치 어시스턴트 리더보드로 돌아가 전체 순위를 확인해 보세요.
자주 묻는 질문
가장 좋은 무료 AI 리서치 어시스턴트는 무엇인가요?
Semantic Scholar는 완전 무료입니다. Perplexity, NotebookLM, Elicit도 무료 등급이 있으며, NotebookLM 무료 플랜은 노트북당 소스 50개를 허용합니다. 비용을 내기 전에 먼저 이쪽부터 시작하세요.
AI 리서치 어시스턴트가 인용을 지어낼 수 있나요?
네. Deakin 연구에서 보았듯 일반 챗봇이 가장 많이 그러고, 근거 기반 도구는 덜합니다. 실제로 존재하는 인용이라도 논문이 하지 않은 주장에 붙을 수 있으니, 매번 출처를 열어 보세요.
NotebookLM과 Gemini Notebook은 같은 건가요?
네. Google이 2026년에 이름을 바꿨으며, 계속 독립 제품이라고 밝혔습니다.
OpenEvidence는 무료인가요?
의료 전문가는 무료로 쓸 수 있고 비용은 광고로 충당됩니다. 의료 전문가를 위해 만들어졌으며 임상의의 판단을 대체하지 않습니다.
문헌고찰에 가장 좋은 도구는 무엇인가요?
하나로 다 해결되는 도구는 없습니다. Consensus나 Semantic Scholar 같은 검색 도구에 지도화용 ResearchRabbit, 추출용 Elicit을 조합하고, 공식적인 체계적 문헌고찰이라면 Rayyan을 더하세요.
AI가 만든 참고문헌은 어떻게 확인하나요?
논문까지 직접 들어가 실제로 존재하는지 확인하세요. 그다음 답변이 주장하는 내용이 논문에 실제로 있는지 확인하고, DOI를 출판사 사이트와 대조하세요. 이렇게 10분 투자하는 편이 철회된 주장을 떠안는 것보다 낫습니다.