

「現行のAIツールが自分の仕事に役立たないなら、それは問題ではなく、一つの発見です」。Amazonはソフトウェアエンジニアに宛てたメモでこう伝えました。CNBCが報じています。AIを他社に販売している企業の一文としては異例で、「Amazon、エンジニアにAIの使用を控えるよう指示」という見出しにまとめられがちです。
ただ、メモ自体はこの見出しよりずっと慎重で、その周辺で交わされている議論のほうが重要です。トークンはいまやエンジニアリング予算の一項目となり、世界中のマネージャーが、Amazonが公に答えたのと同じ問いを突きつけられています。その支出は本当に何かを生んでいるのか、という問いです。以下では、メモが述べていること・述べていないこと、主要4ツールで1シートに実際いくらかかるのか、そして上限設定が効く場面と逆効果になる場面を見ていきます。
tokenmaxxingはリーダーボードの問題です
CNBCはtokenmaxxingを、開発者が「アウトプットをほとんど顧みずにAIを可能な限り使うこと」と定義しています。この言葉はAmazon社内に少し前史があります。CNBCによると、同社は今年初め、社員がランキングを上げるためにtokenmaxxingをしていると判明し、社内リーダーボードを停止しました。Financial Timesの報道をもとにしたI-Programmerの記事によると、このボードはKirorankという名前で、稼働したのはわずか数週間、公式に認められたものでもありませんでした。人々はAIエージェントに実行させるための意味のない作業をひねり出し、そのトークン代をAmazonが払っていたのです。
Amazonだけの話ではありません。同じ記事によれば、Metaも今年初め、社員が作ったボードを閉鎖しました。そこではClaude Codeで消費したトークン数で順位が決まり、Token Legendといった称号を競っていたそうです。また、Amazonのシニアバイスプレジデントであるデイブ・トレッドウェルが「AIを使うこと自体が目的の使い方」をやめるよう社員に求めた、過去の流出メッセージにも触れています。
これが起きるのに、誰かが不正をする必要はありませんでした。画面に数字を出し、その数字で人を順位づけすれば、数字は上がります。
メモが述べていること、述べていないこと
CNBCによると、このメモはAmazonがウェブサイトに掲載する前に社内で回覧されていました。内容は、ソフトウェア開発エンジニアとそのマネージャーの役割についてのAmazonの説明を改めるものです。核心は計測に関する指摘です。トークン使用量、AIツールの導入率、コード変更数やレビュー数はいずれも、チームのAI活用を判断する指標としては「深刻な欠陥がある」ままだとメモは述べています。コストの増大や過度な複雑化を招きかねないからです。
ただし、これらの数字を禁止しているわけではありません。ほかのデータと並べて「注意と判断をもって」読むべきだとされ、メモが推す物差しははっきり書かれています。「長期的な成果で測り、また測られることが最善だと私たちは考えます」。
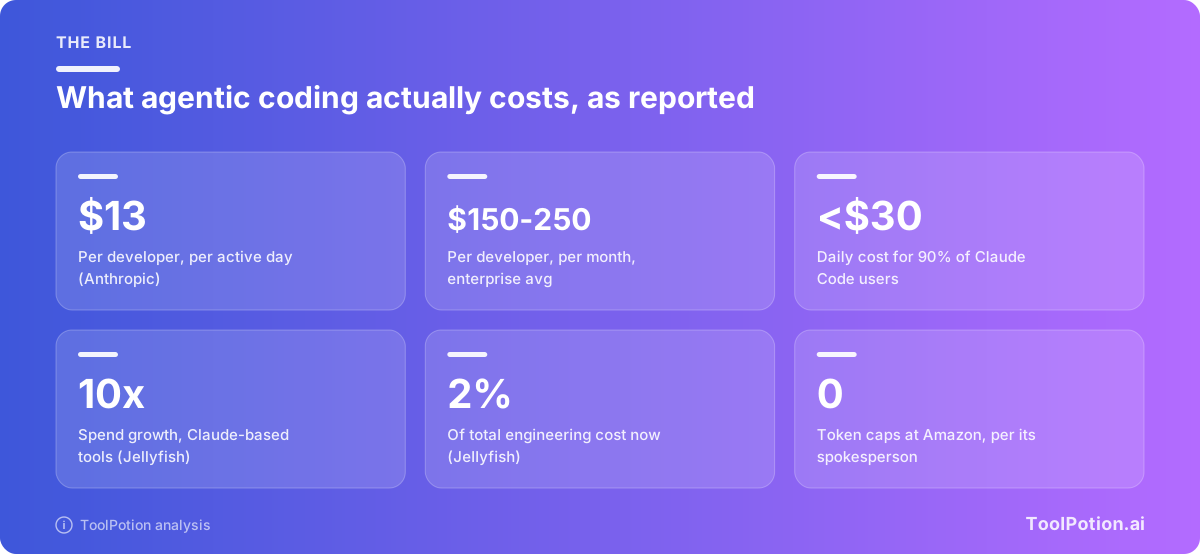
Amazonの広報担当者はCNBCに対し、同社はトークン使用量の上限を設けていないと述べました。これは重要です。「AIの使用を減らせ」という表現は、報じられた内容を超えているからです。私たちが読んだ報道には、クォータもエンジニア1人あたりの予算も、金額も出てきません。Amazonは支出額を明かしておらず、どの報道もそれを伝えられていません。
AWSのバイスプレジデント兼ディスティングイッシュトエンジニアであるマーク・ブルッカー氏は、CNBCに2つの考え方を語りました。同社は機能のベロシティ(リリース数、本番環境での成功した変更の数)のような指標を見ており、支出は投資として扱っています。避けたいのは、重要でない問題に注ぐ「無駄な労力」だと言います。ただ、何が重要でないかを見極めるのは時に難しいと認めており、だから実験への意欲はある程度残されています。
そう読むと、このメモはコスト削減策というより人事評価の方針に近いものです。私たちが線を引きたいのは、冒頭で引用した一文です。AIがまだ役に立たない場面を説明できるエンジニアは、メモの言葉を借りれば「私たちが求める判断力を示している」ことになります。ツールを使わないと決めた人を罰してはいけない、とマネージャーに伝えているわけです。
AIを売る会社がなぜ手綱を締めるのか
素直な答えはコストで、その額は予算よりも速く膨らんでいます。エンジニアリングチーム向けツールを手がけるJellyfishは、エージェント型コーディングツールに関するレポートを公開しており、TechCrunchが取り上げました。Jellyfishの顧客では、Claude CodeをはじめAnthropicのモデルを使うツールへの支出が年初から10倍に増え、いまではエンジニアリングコスト全体の約2%に相当します。2%という数字は小さく見えますが、JellyfishのチーフサイエンティストであるNicholas Arcolano氏はTechCrunchに「その10倍の伸びは、ほとんどのCFOが計画していなかった成長だ」と語っています。
個人レベルの金額についても、Anthropic自身のドキュメントが目安を示しています。エンタープライズ導入全体では、Claude Codeの平均コストは開発者1人あたり、稼働日で約$13、月で$150〜$250で、ユーザーの90%は1日$30未満に収まっています(Claude Codeのドキュメント)。これはベンダー自身の顧客の平均なので、実際の数字は自社のパイロットで確かめてください。
あと2つの理由は私たちの推測で、報道にはどこにも書かれていません。コード変更数やレビュー数に基づく指標は、誰も求めていない大量のアウトプットでレビュアーを埋もれさせかねません。また、利用数値を追いかけるエンジニアには、そのタスクにそもそもモデルが必要だったのかを問う動機がほとんどありません。メモの報道にも周辺の報道にも、セキュリティが理由として挙がってはいないので、そこは理由だったことにはしません。
Microsoftの早期退職募集と、メーターを売るベンダー
Amazonのメモが出たのと同じ週には、企業がAIと帳簿の折り合いをつけようとする話がほかにも出ましたが、同じ話ではありません。Microsoftは、対象となる約6万人(全従業員の約27%)に希望退職を募りました。高額なAIインフラの増強と資本効率のバランスを取るためです。CNBCはこれをインフラとキャッシュフローの話と結びつけており、誰かのトークン使用とは関連づけていません。同じ記事は、Microsoftが顧客に対して実際のAI使用量に応じた課金を試みているとも伝えています。つまり、メーターの向きを逆にしたわけです。
そして、あなたが使えば使うほど得をする会社もあります。Anthropicはレポートツールを公開しました。マネージャーは、指定期間にチームが何を生み出したか、いくらかかったか、ワークフローがどこで行き詰まったかを確認でき、チームがトークン支出を管理できるよう、グループ共通の予算プールも使えます。TechCrunchは、投資対効果を証明しようとする明確な試みだと評しています。動機をどう見るかはともかく、この製品は購入側がいま何を求めているかを示しています。シート単価ではなく、成果あたりのコストです。
1シートの実コストを把握する
まずはパイロットグループとベースラインから始め、上限を書き込む前に行ってください。ベンダーはどこも従量課金に寄ってきており、シートの定価が示す情報は年々減っています。各主要ツールが何を計測しているかを、ベンダー自身のページから整理しました。
| ツール | 計測対象 | 上限を設定する場所 |
|---|---|---|
| GitHub Copilot | トークンを1クレジット$0.01のAIクレジットに換算。Businessは1ユーザーあたり月1,900クレジット、Enterpriseは3,900クレジットをプール | ユーザー、コストセンター、組織単位のドル建て予算 |
| Cursor (Teams) | Cursor独自モデル向けに、有料シートごとの週次プール。サードパーティモデルは共有のプリペイド残高から課金 | チームの月次上限、およびデフォルトとメンバーごとの上限 |
| Claude Code | APIトークン。TeamsとEnterpriseはシート枠から消費 | 管理設定の利用上限、またはConsoleのワークスペース上限 |
| Codex (ChatGPT) | ChatGPT Workと共有の枠、その後はクレジット | 購入するクレジットと、ペースを確認する利用状況ダッシュボード |
料金ページには載っていませんが、ドキュメントで見つけた細かな点をいくつか挙げます。Copilotの有料利用ポリシーはBusinessとEnterpriseで初期状態でオンになっており、管理者が明示的に無効化しない限り、プールされたクレジットを超えた分も課金が続きます(GitHubのドキュメント)。インライン補完は、予算を$0にしても無制限のままです。Copilotのコードレビューは工数レベルで価格が決まり、GitHubの見積もりではLiteが$0.05〜$1、Maxが$1.50〜$25で、平均は約$10、これにActionsの利用分が加わります(GitHubのモデルと料金)。これらはあくまで見積もりで、プルリクエストの大きさで変動するとドキュメントにも書かれています。
エディタ自体を比較したい方は、Cursor vs GitHub Copilot vs Windsurfをご覧ください。CursorのTeamsプランは、Premium、Super、Ultraのシートを月$30、$100、$200で販売しており、それぞれにCursor独自モデル用の週次プールがあって、チームメイト間では融通できません。Claudeを含むサードパーティモデルはこのプールに入らず、共有のプリペイド残高から、APIの定価に100万トークンあたり$0.25のCursor手数料を上乗せして課金されます(Cursorのドキュメント)。ClaudeのEnterpriseプランは1シート月$20に、APIレートで課金される利用分が加わります(Claudeの料金)。Codexの料金ページには、APIのトークン価格はサブスクリプションの利用分とは別で、含まれるタスク数の見積もりには使えないと明記されています。
定型作業は安価なモデルに振り分ける
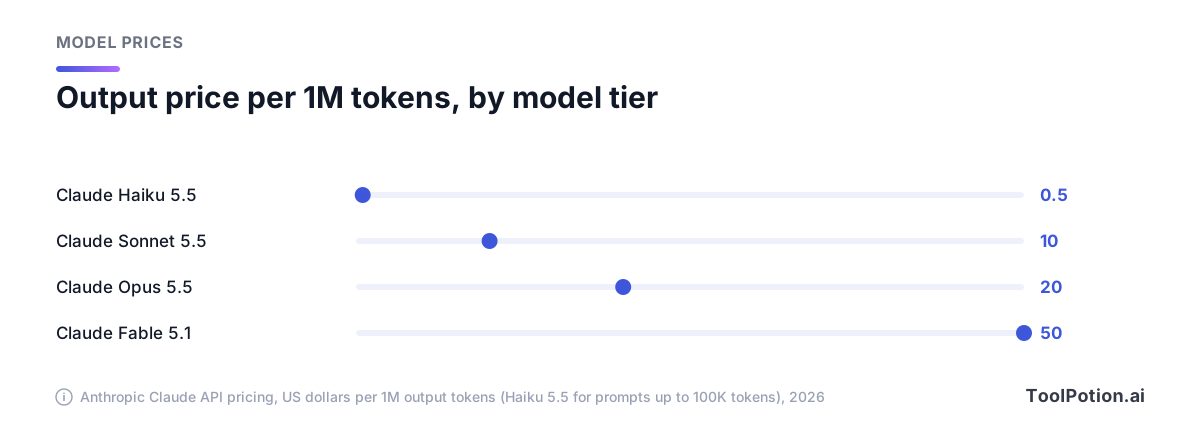
ドキュメントにある最大の手段は、上限ではなくモデルの選択です。Anthropicのapi料金表では、100万出力トークンあたりの料金は、プロンプトが10万トークン以下の場合、Claude Haiku 5.5が$0.50(それを超えると$2.50に上がります)、Sonnet 5.5が$10、Opus 5.5が$20、Fable 5.1が$50です。同じラインナップの下端と上端で100倍の開きがあり、GitHubとCursorの料金表にも同じ出力価格が載っています。
Anthropic自身のコストに関するガイダンスも、この計算と一致しています。Sonnetは「ほとんどのコーディングタスクをうまくこなし、Opusより安い」とされ、Opusはアーキテクチャの判断や複数ステップの推論に回し、単純なサブエージェントのタスクにはmodel: haikuを使うよう勧めています(Claude Codeのドキュメント)。ティアとタスクの対応づけについては、タスク別のAIモデルティアの選び方で詳しく書いており、ターミナル型エージェントはClaude Code vs Codex vs Gemini CLIで比較しています。
定価ベースでの節約額を、小型モデルが担える作業の割合をご自身の見込みとして入れて試算できます。価格はAnthropicの短いプロンプト向け定価です。
出力トークンは請求額の一部にすぎず、小型モデルの担当割合は、自分のタスクで確かめて初めて使える仮定です。変数名の変更やテストの雛形づくりは、おそらく該当します。決済サービスの移行計画は、おそらく該当しません。
上限を設定する順番
- パイロットグループで利用状況レポートを有効にし、数字を決める前に2週間分を読み込みます。
- 先にアラートを設定します。GitHubは予算の75%、90%、100%の時点でメール通知とバナー表示ができます(GitHubのドキュメント)。
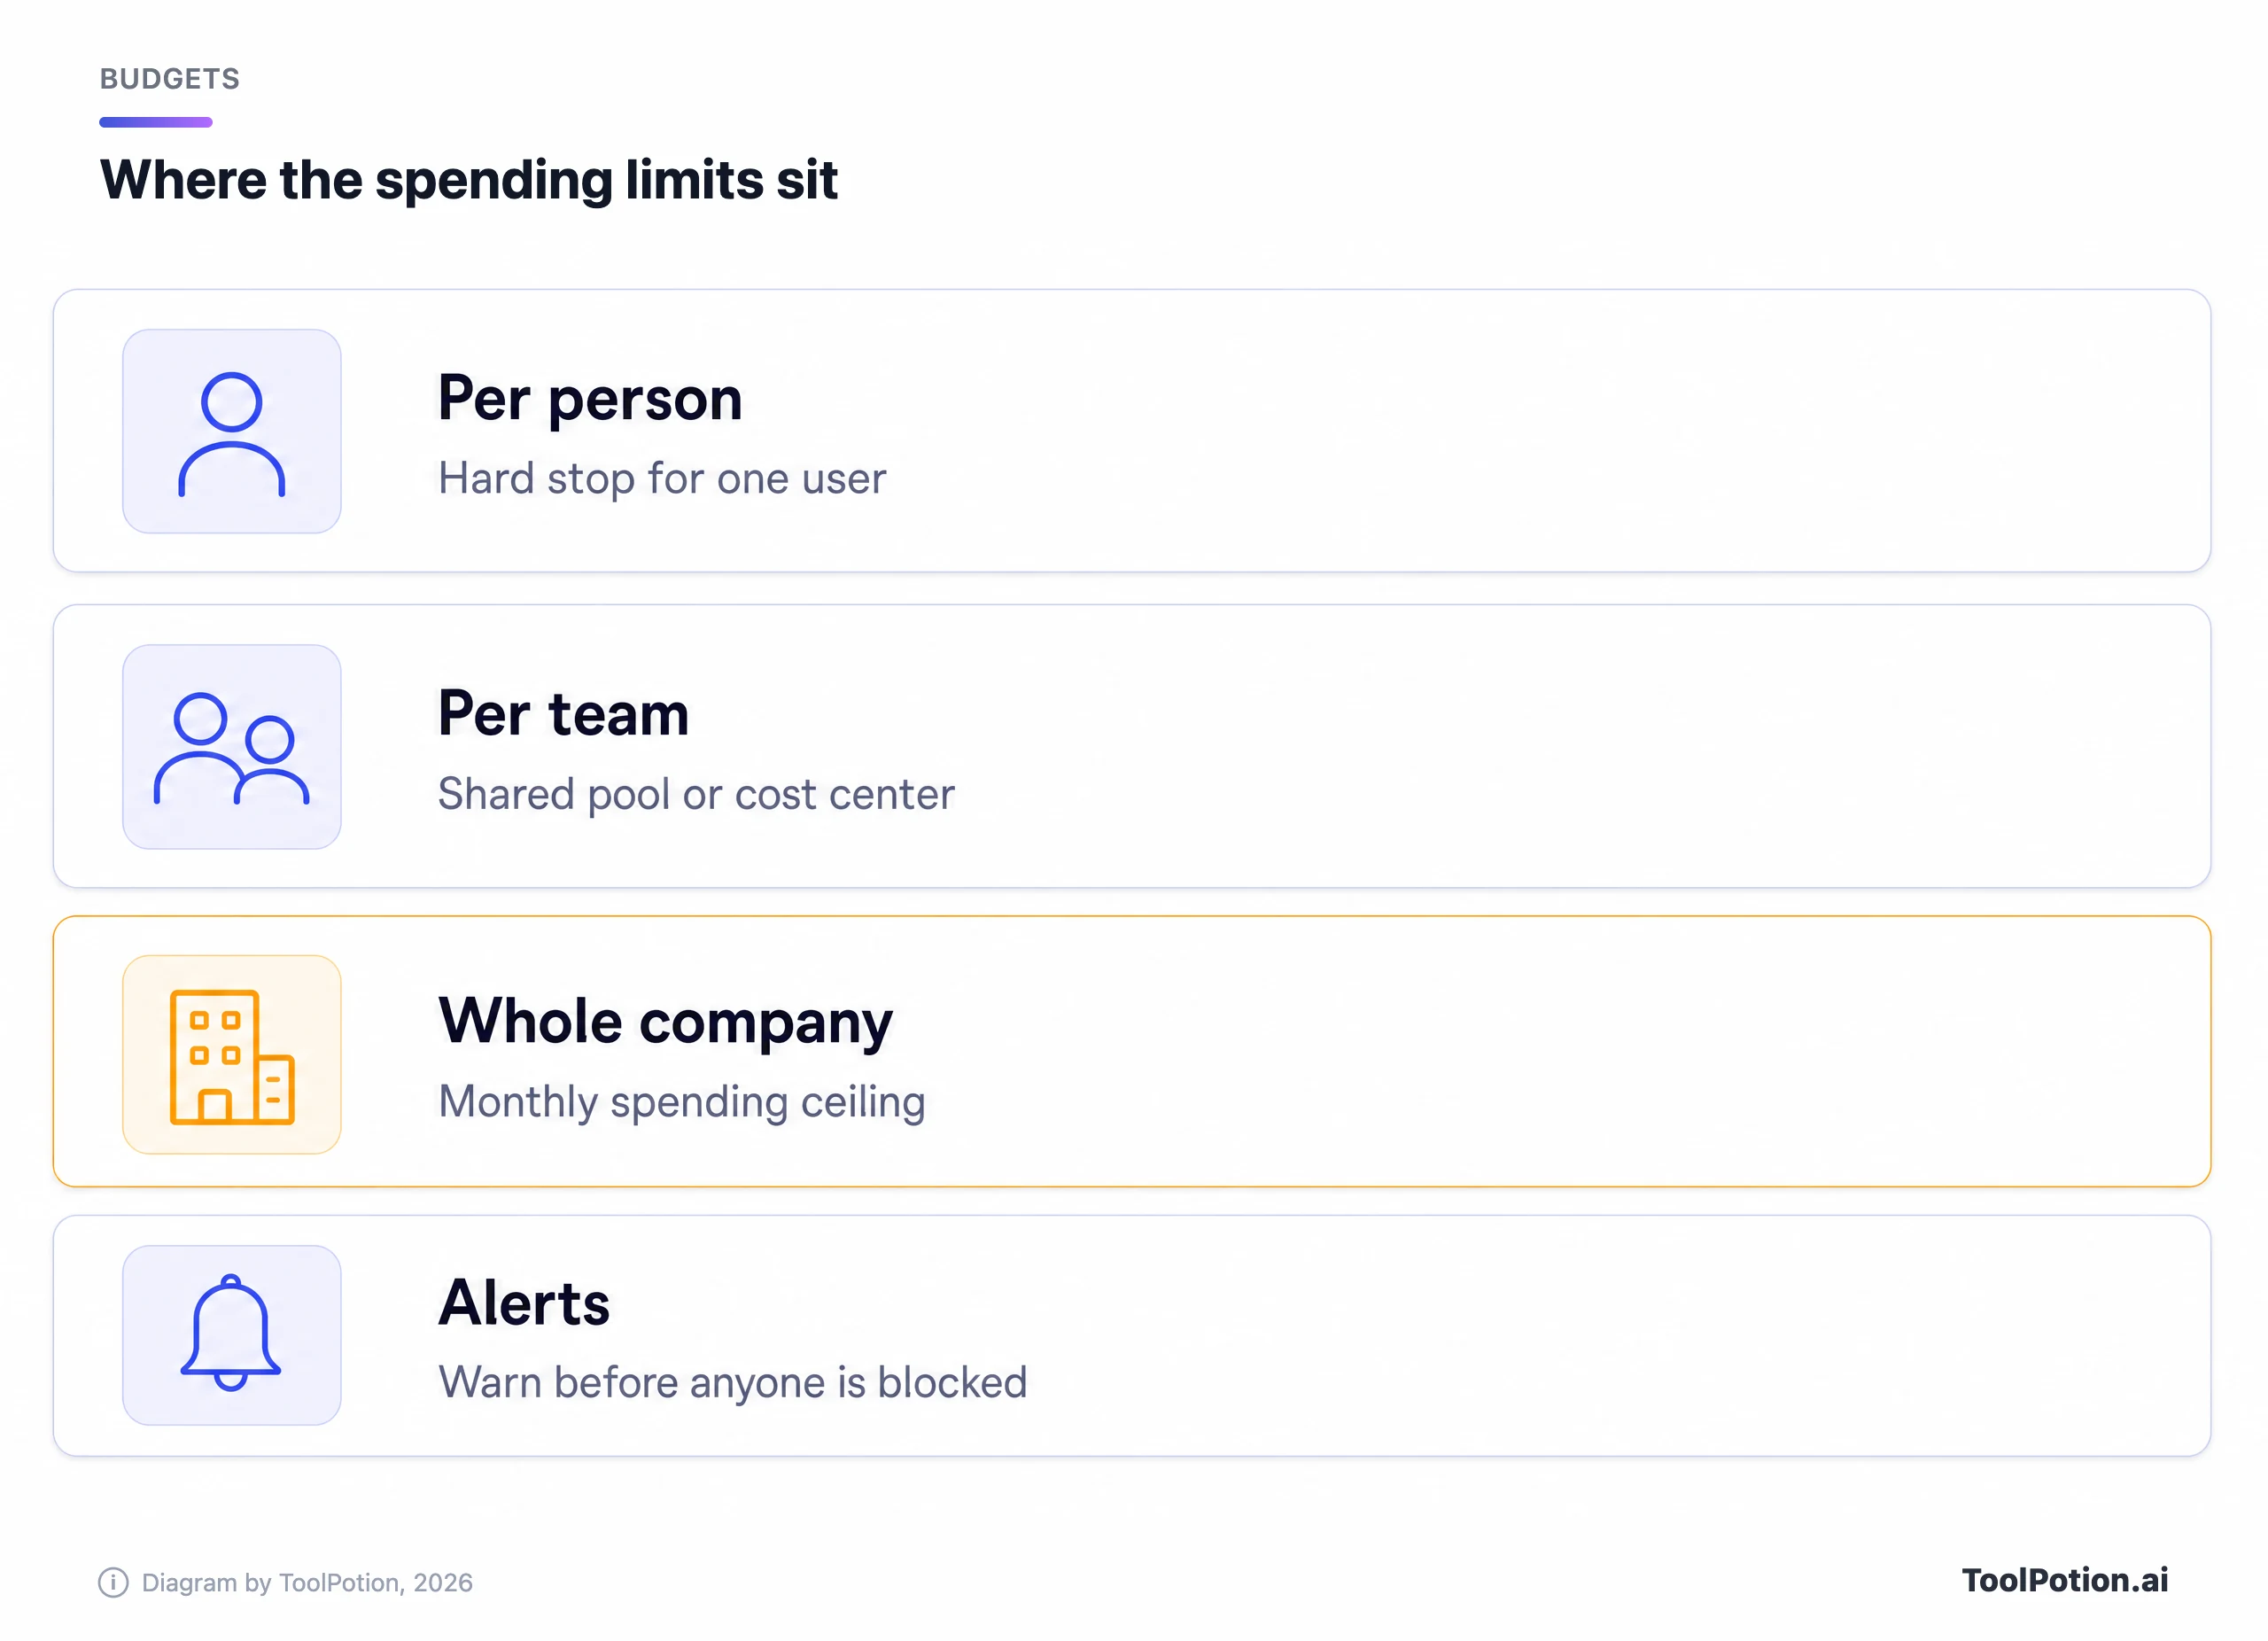
- 全シートが上限まで使われても許容できる、会社全体の月次上限を設けます。暴走したエージェントのループでも、かかる金額が既知の範囲に収まります。
- チームや個人の上限は、その後に追加します。ツールが対応していれば、ソフト上限にしてください。GitHubのユーザー単位の予算は必ずハードストップになり、予算が重複すると、頼っているツールが使えなくなる場合があるとドキュメントでも注意されています。
- 定型作業のデフォルトモデルを一段下げ、上位モデルは意図して選ぶものにします。
Claude Codeのドキュメントには、チーム規模別のユーザーあたりレート制限の出発点も載っています。たとえば100〜500ユーザーなら、1ユーザーあたり毎分15,000〜20,000トークンです。これは予算ではなくスロットルであり、ドキュメントも調整前提の推奨値としています。
節約が賢い場合と、無駄な節約になる場合
私たちは、無駄は節約しても、試行そのものは節約しません。リポジトリ丸ごとを最上位モデルに貼り付ける前に開発者が一呼吸おくようになる上限は、役目を果たしています。一方、同じ開発者がAI生成のテスト実行を飛ばしたり、AIが最も効く難しいリファクタリングでエージェントを避けたりするようになる上限は、節約額より多くのコストを生みます。
数字で確かめましょう。Jellyfishの報告どおりエージェント型ツールがエンジニアリングコストの約2%なら、請求額を半分にしても節約できるのはエンジニアリングコストの1%です。エンジニアの生産性が1%落ちれば、それで帳消しです。節約が割に合うのは、何も生まなかった支出を削る場合だけで、これはまさに無駄な労力についてのAmazonの指摘と同じです。
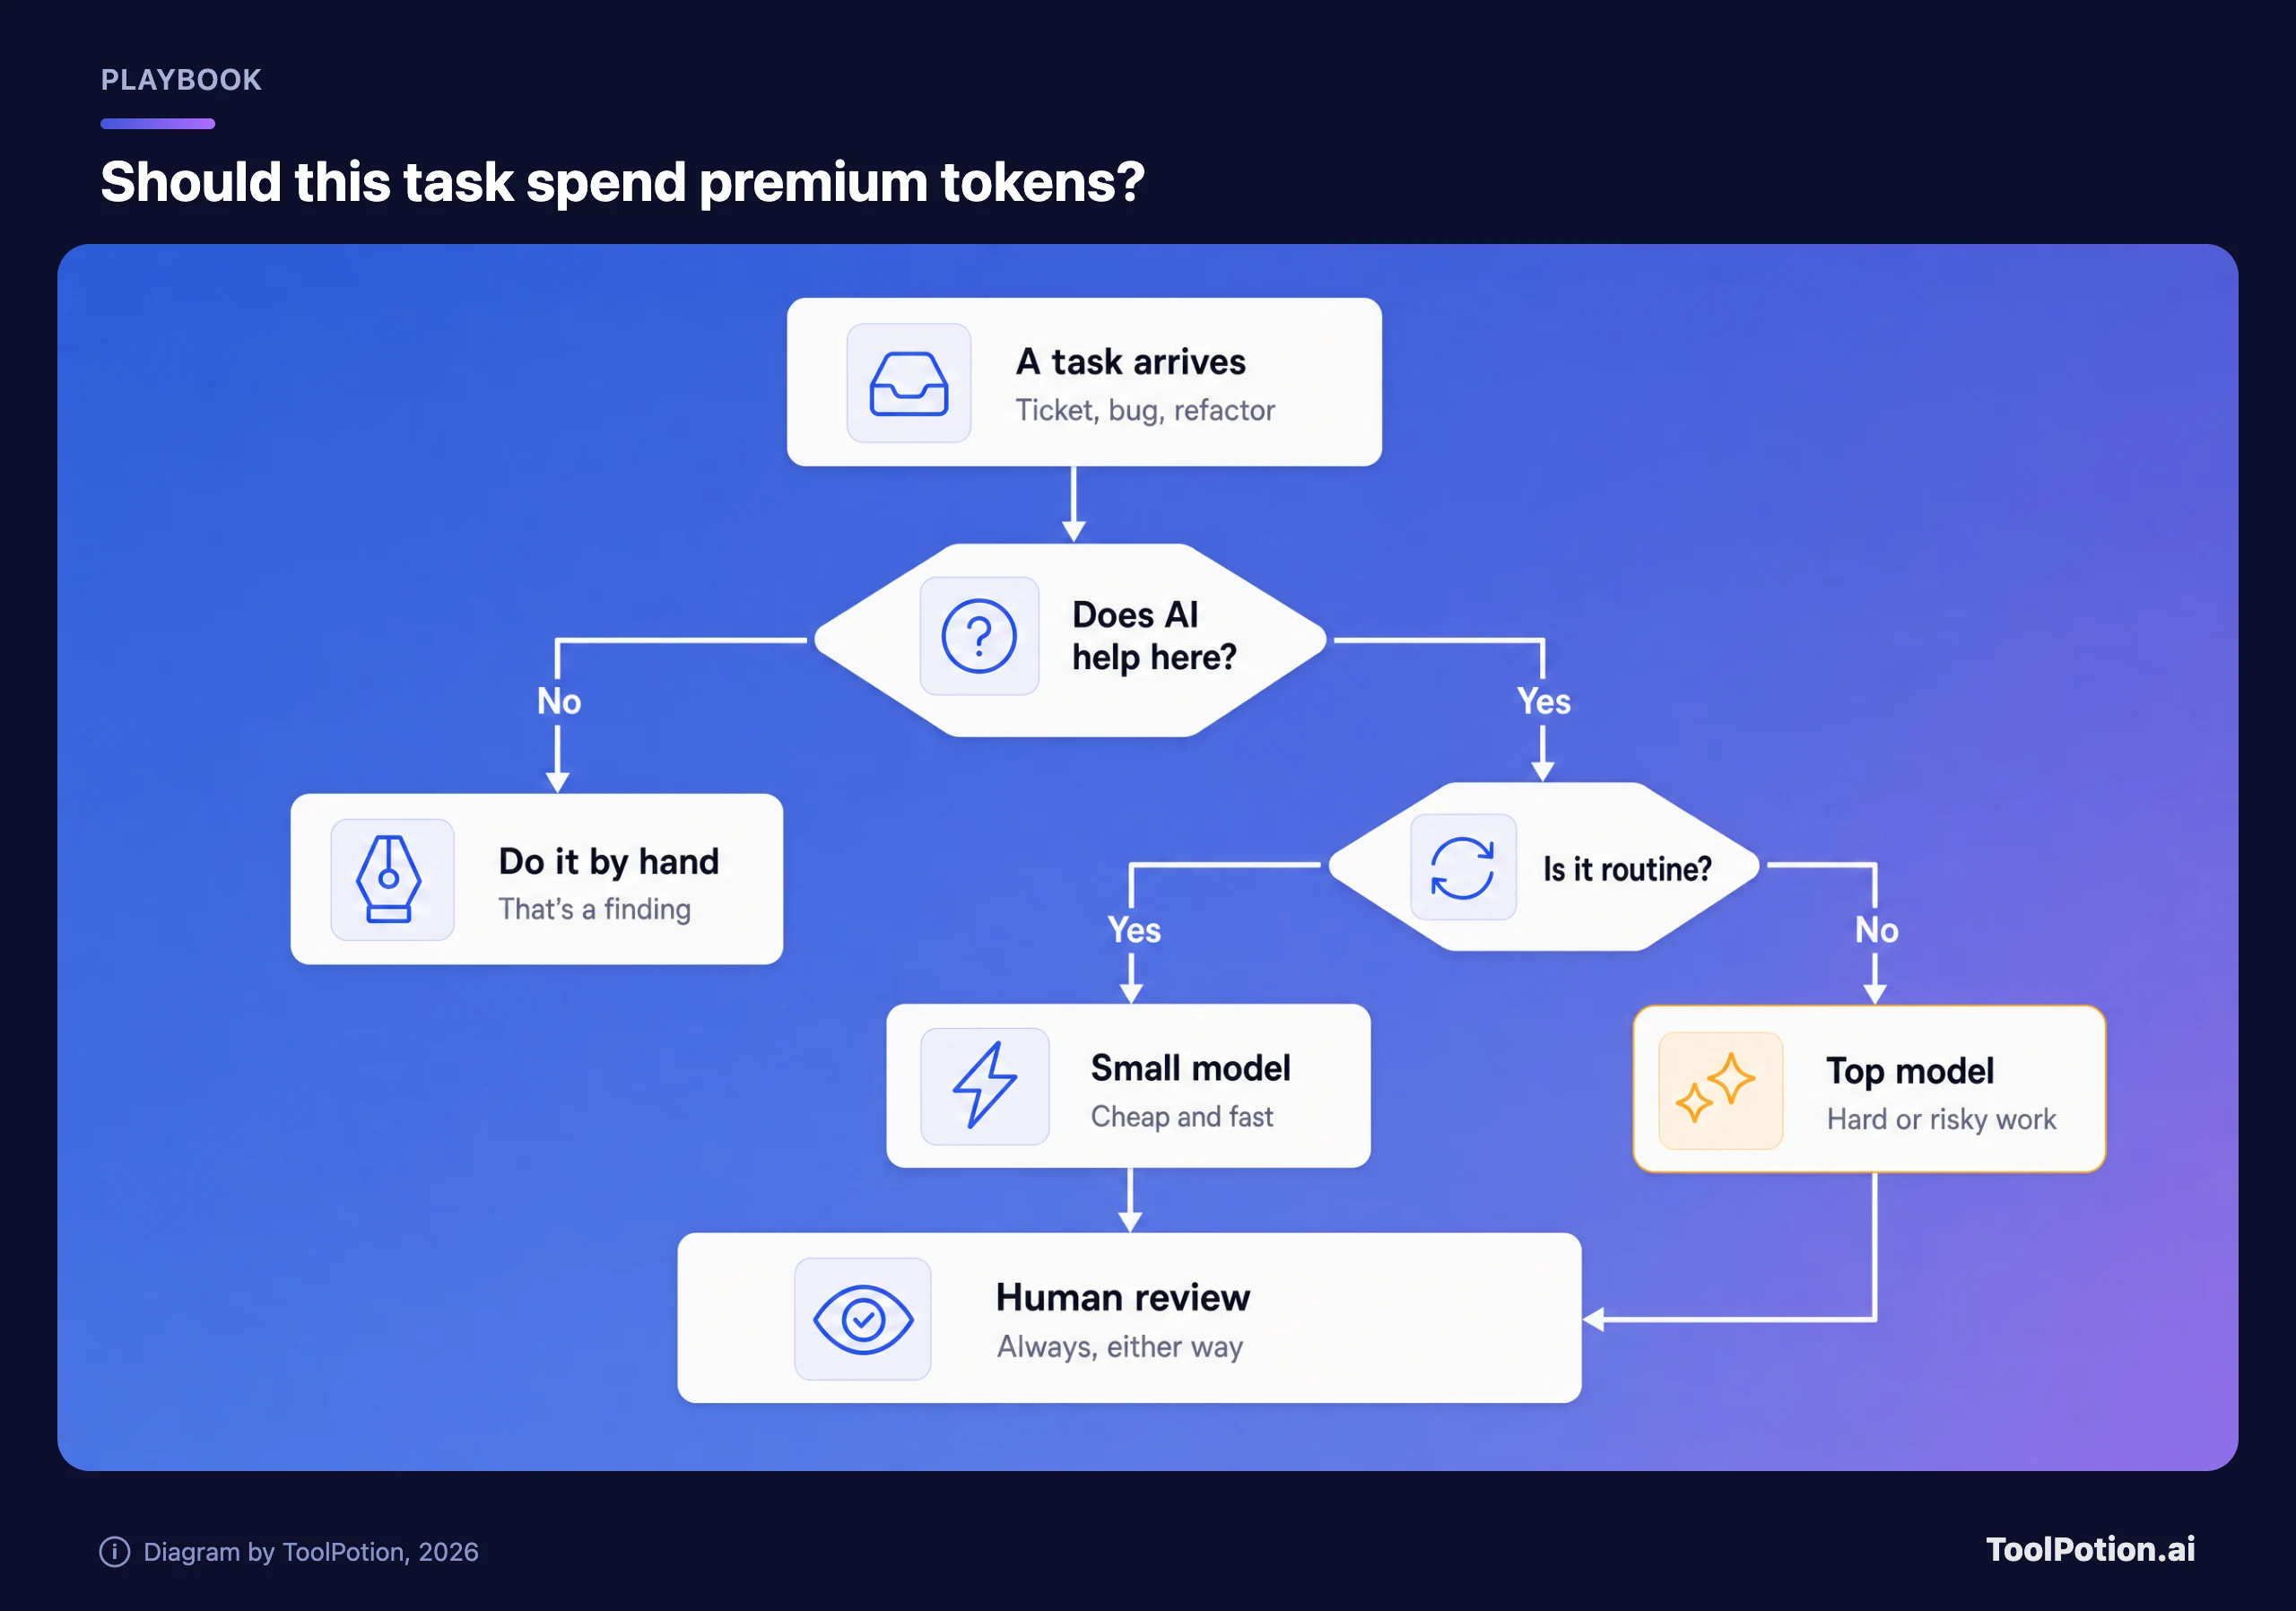
節約が賢いのは、誰も読まないバックグラウンド自動化、定型作業での上位モデル、個人別リーダーボードです。コードレビュー、テスト、オンボーディングでは無駄な節約になります。AIによるレビュー工程が悪いマージを食い止めているなら、それを絞るのは自分たちのセーフティネットに逆張りするようなものです。何かを削る前に、AIコードレビューツールのガイドとレビュー・テスト部門のToolRankボードで、どれだけ代替手段があるかを確認してください。
削らないもの
どのモデルがコードを書いたかにかかわらず、人間によるレビューは残します。Amazonのメモはレビュー数での計測を戒めていますが、レビューを省略しろとは言っていません。トレーニングも残します。安いモデルに切り替えるべき場面を知っているのは、各モデルの用途を教わった人だからです。そして実験も残します。どの問題が重要かは事前に誰にもわからないというのが、ブルッカー氏自身の認識だからです。
メモと同じように、成果は追跡してください。リリース数、本番環境での成功した変更、リクエストからマージまでの時間などです。生のトークン数はコストの欄に置くもので、人事評価には近づけないでください。チームがこれらのツールに何を入力してよいか、いけないかをまだ文書化していないなら、AI利用ポリシーのテンプレートが出発点になります。サブスクリプション側については、料金モデルの解説とスタック監査をご覧ください。
GitHub Copilot、Cursor、Claude Code、Codexの料金ページを読んで、私たちが得た結論は一つです。シート価格は入場料にすぎません。お使いのツールから直近1か月の1人あたり利用量を取り出して並べ替え、上位5行を見てください。それが最も優秀なエンジニアたちなら、そのままにしておきましょう。ループの中で回り続けている一つのスクリプトなら、そこが上限を設けるべき場所です。