

2026年の時点で、多くの開発者にとって実質的な選択肢は Claude Code と Codex の2つです。ターミナル作業を測る最も難しい公開ベンチマークでは、両者は誤差の範囲で並んでいます。昨年の比較記事では必ず3番目に名前が挙がっていた Gemini CLI は、無料ユーザーと個人ユーザーについては終了しました。Google は今年に入り、これをクローズドソースの Antigravity CLI に置き換えています。
これで判断の軸が変わります。上位2つはリリースのたびに首位を入れ替えるため、モデルの品質は決め手として弱くなりました。今、ツールを分けるのは、あなたのマシン上でエージェントが確認なしに何をしてよいか、料金をどう支払うか、そしてその両方をチームリーダーが管理できるかどうかです。Codex は最も安全なデフォルト設定とオープンソースのクライアントを備えています。Claude Code は、スクリプト化や拡張をしたいチーム向けに最も充実したツールキットを持っています。GitHub Copilot の CLI は、すでに GitHub を中心に仕事をしていて、複数のラボのモデルを1つの請求にまとめたい組織に向いています。オープンソースで好きなモデルを使いたいなら OpenCode が選択肢です。
以下の価格と機能はベンダーのドキュメントと料金ページに基づいており、ベンチマークの数値にはすべて出典を明記しています。
今年のターミナルエージェントで変わったこと
1年前にこのカテゴリを見たきりの方は、次の4つの変化を押さえておいてください。
Google は多くの人向けに Gemini CLI を終了しました。Google I/O で、無料ユーザーと Google AI Pro・Ultra の契約者向けに Gemini CLI のリクエスト受付を停止し、IDE 拡張機能も同日に無効にすると発表しています(Google Developers Blog)。後継の Antigravity CLI は Go で書かれており、Google の新しいデスクトップアプリ Antigravity 2.0 と同じエージェント基盤で動きます。Gemini Code Assist の Standard または Enterprise を利用している組織と、Gemini API キーで支払っている開発者は、引き続き Gemini CLI を使えます。
GitHub は Copilot CLI を一般提供(GA)とし、続いてすべての Copilot プランを従量制の AI クレジットに移行しました。ターミナルでのセッションは、1クレジット $0.01 換算の使用枠から差し引かれます(GitHub Docs)。
Anthropic はセッション開始時の挙動を変えました。Claude Code v2.1.283 以降、対話型のターミナルセッションは auto モードで始まります。このモードでは、操作のたびにあなたへ確認する代わりに、Anthropic が「classifier」と呼ぶ2つ目のモデルがアクションを審査します(Claude Code docs)。
OpenAI は今週、Codex CLI を刷新し、音声操作、並列タスクを追跡する /agents ビュー、そして承認済みの設定と権限をチームで共有できる再利用可能なクラウド環境を追加しました(TechCrunch)。一方、オープンソースの老舗である Aider は、今年初めのマイナーパッチ以降リリースがなく、最後の機能リリースは昨年にさかのぼります(PyPI)。
すべてのターミナルエージェントが回しているループ
ブランドの違いを取り除けば、どのツールもやっていることは同じです。やりたいことを自然な言葉で伝えると、エージェントは関連ファイルを読み、計画を立て、必要な数のファイルを編集し、ビルドとテストを実行します。失敗すれば、diff を提示できるようになるまでそれを繰り返します。
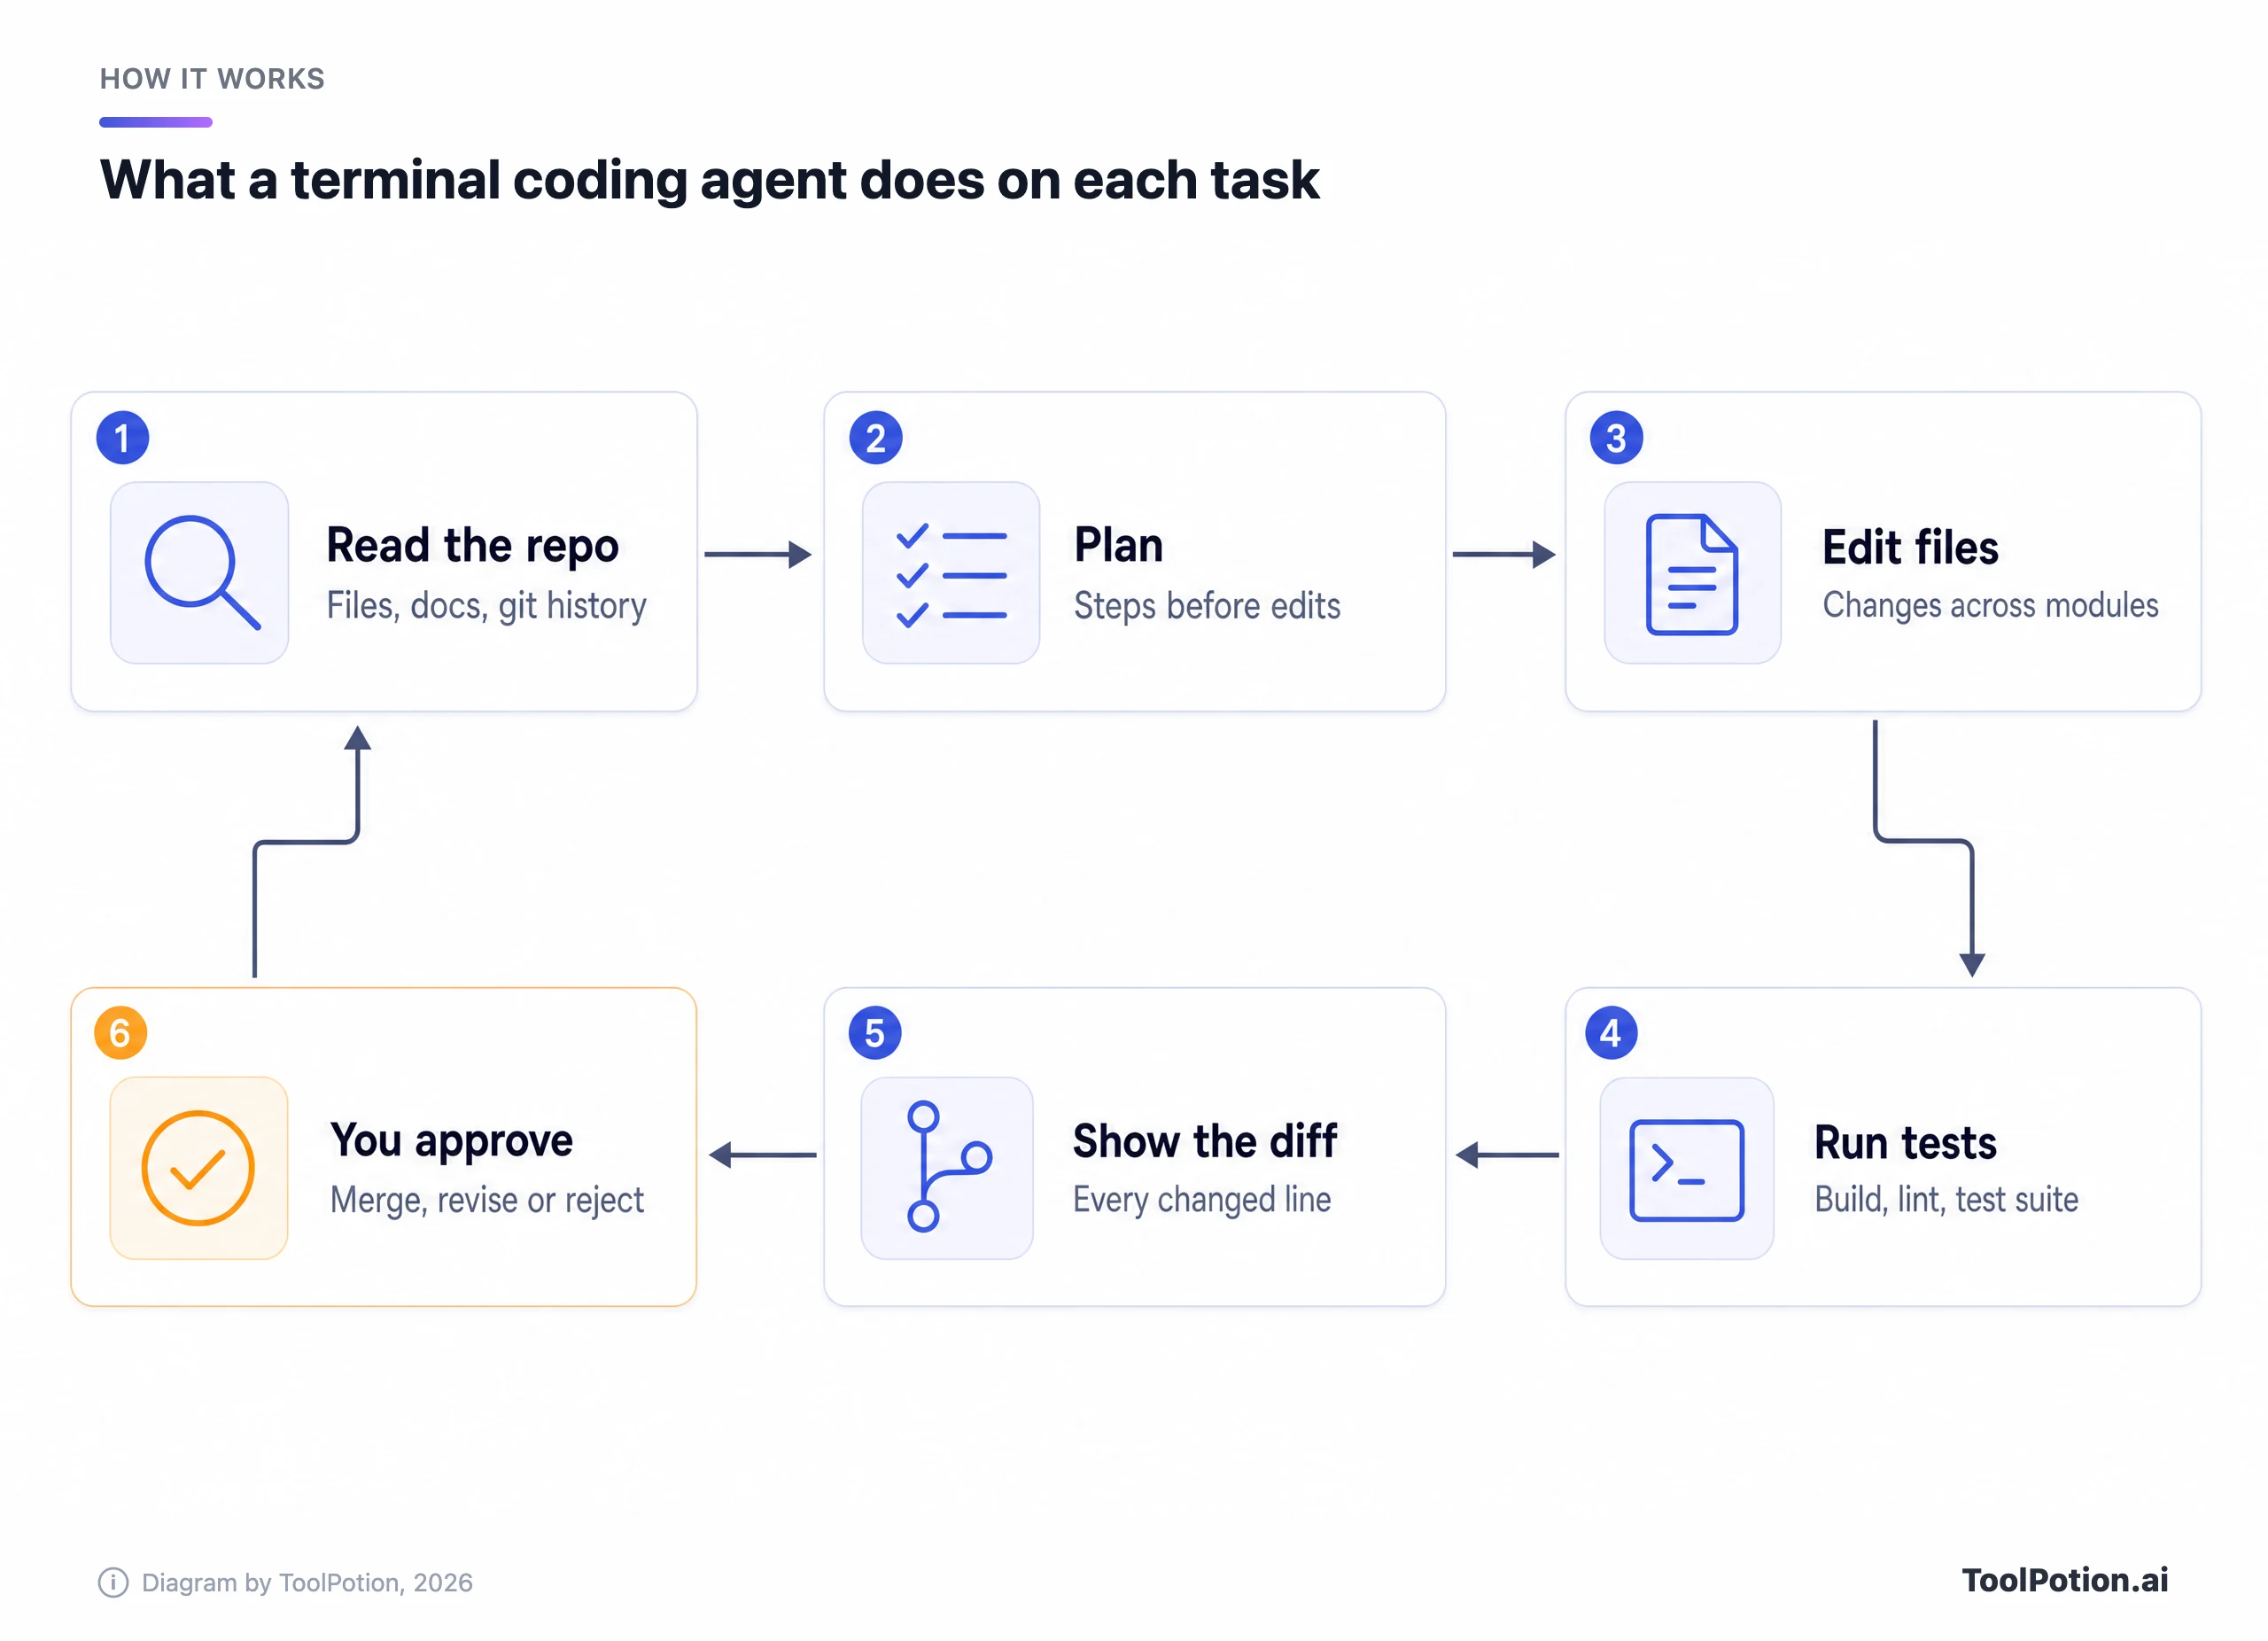
ハイライトされたステップが設計の要です。承認の場面こそ、あなたの判断とセキュリティポリシーが効く場所だからです。ツール間の違いは、このループの周りの3点にあります。どのモデルが動かすのか、承認前にエージェントが何をしてよいのか、そしてどこで動くのか(手元のノートPC、OSのサンドボックス、ベンダーのクラウド)です。話題になるのはモデルですが、チーム全体で使えるかどうかを決めるのは残り2つです。
Claude Code vs Codex 徹底比較
この2つが定番になっているのには理由があります。どちらも macOS、Linux、Windows で動き、AGENTS.md ファイルを読み、MCP サーバー、skills、hooks、プラグイン、サブエージェントに対応し、タスクをクラウドに渡すこともでき、月額 $20 のプランがあります。違いは細部にあります。
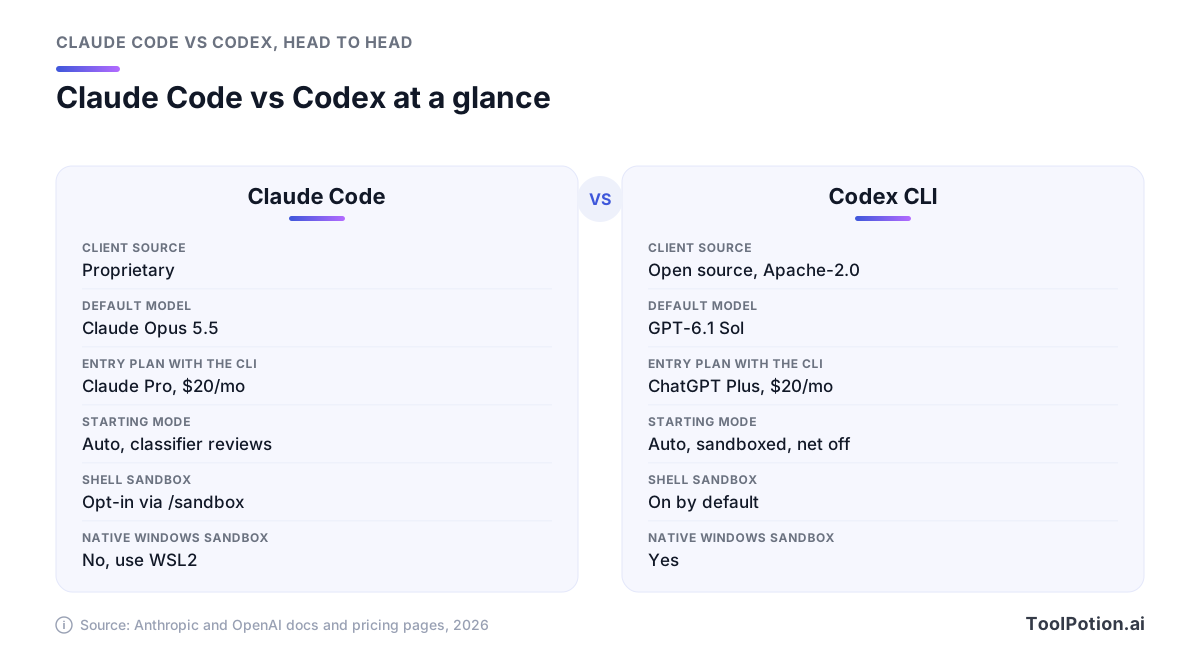
まずモデルです。Claude Code は Anthropic のモデルのみを使い、全プランで Claude Opus 5.5 がデフォルトです。より安価な選択肢として Sonnet 5.5 と Haiku があり、Claude Code で最も高性能な Fable 5.1 は明示的に選ぶオプトインで、プランによっては追加の使用クレジットで課金されます。Codex のデフォルトは GPT-6.1 Sol で、OpenAI によれば、エージェント的なコーディングでは旗艦の GPT-6 Astra にほぼ並び、API 価格は5分の1です。Codex のクライアントは Apache-2.0 のオープンソースで(openai/codex リポジトリは Rust 製)、Claude Code のライセンスは all rights reserved です。
安全面のデフォルトは、さらにはっきり分かれます。git リポジトリの中では、Codex は Auto というプリセットで始まります。ワークスペース内での読み取り、編集、コマンド実行はできますが、あなたが承認するまでは、OS のサンドボックス(macOS は Seatbelt、Linux は bubblewrap と seccomp、Windows はネイティブのサンドボックス)がネットワークアクセスとプロジェクト外へのアクセスを遮断します(OpenAI docs)。git リポジトリの外では読み取り専用になります。
Claude Code は逆のアプローチです。シェルのサンドボックスはデフォルトでオフで、最初の防御線は auto モードの classifier と、どのモードでもブロックする deny ルールです。サンドボックスをオンにした場合も、対象はシェルコマンドだけです。しかも deny ルールを追加するまでは、サンドボックス内のコマンドでも ~/.ssh や ~/.aws/credentials を含むマシンの大半を読み取れます(Claude Code docs)。Windows ネイティブにはサンドボックスがまったくなく、Anthropic は WSL2 を案内しています。
奥行きでは Claude Code が勝ります。プラグインは skills、サブエージェント、hooks、MCP サーバーをまとめて配布でき、管理者が許可リストやブロックリストを設定できるマーケットプレイスからインストールします。Routines は Anthropic のクラウドで定期ジョブを実行し、GitHub Actions と GitLab CI/CD の連携でレビューやトリアージを処理でき、Agent SDK を使えば同じツール群の上に独自のエージェントを作れます。Codex も、より少ない手間で同じ領域の大半をカバーしています(hooks、skills、プラグイン、スクリプト用の codex exec、GitHub Action)。自動コードレビューは GitHub のプルリクエストと GitLab のマージリクエストに対応しています。
では、それぞれの弱点はどこでしょうか。Claude Code は1つのラボに縛られ、設定を変えるまでは OS の境界ではなくモデルの判断に頼る形になります。これを受け入れられないセキュリティチームもあるでしょう。Codex も1つのラボに縛られ、しかも $20 プランでは旗艦モデルの枠がかなり絞られています。OpenAI の見積もりでは、Plus でローカルのメッセージは5時間あたり GPT-6 Astra で 5〜45 件、GPT-6.1 Sol では 15〜160 件です(OpenAI pricing)。
多くの人にとって Gemini CLI は Antigravity CLI に置き換わりました
今 Gemini CLI を検索すると、Apache-2.0 のリポジトリは残っていて、リリースも続いています(今週 v0.62.0 が出ました)。ただしドキュメントには、無料ユーザーと Google One ユーザーに向けて Gemini CLI が置き換えられたと知らせるバナーが表示されています。引き続き使えるのは、Gemini Code Assist の Standard または Enterprise ライセンスを持つ組織と、有料の Gemini または Gemini Enterprise Agent Platform の API キーを持つ開発者です。
Google Antigravity の中で後継となった CLI は、性質の違う製品です。クローズドソースで、Tech Times によると公開リポジトリにはソースコードがまったく入っていません。Google 自身の集計で6,000件のプルリクエストをマージしたプロジェクトとしては、痛いところです。Google も、1対1の機能パリティはまだないと認めています。ただし skills、hooks、サブエージェント、拡張機能(現在の名称はプラグイン)は移行されました。
良い点もあります。Antigravity のモデルメニューには、Gemini 3.8 Flash と Gemini 3.1 Pro に加えて Claude Sonnet 5.5、Claude Opus 5.5、オープンウェイトの GPT-OSS-120b が並びます。Google の1つのサブスクリプションで2つのラボのモデルに届くわけです(提供状況はプランによって異なります)。macOS と Linux のデフォルトプリセットも、書面上は少なくとも Codex と同等に厳格です。ターミナルコマンドはネットワークなしのサンドボックスで実行され、ファイルアクセスはワークスペースと一時フォルダまで、~/.ssh と .env ファイルはブロックされ、MCP とウェブ操作は事前に確認を求めます(Antigravity docs)。Windows ではこのサンドボックスはデフォルトでオフです。
問題は利用枠です。無料の Individual ティアは基本的な週次レート制限が示されているだけで、Gemini CLI が個人アカウントに提供していた1日1,000リクエストの無料枠にはまったく及びません。有料の利用枠は Google AI Pro と Ultra のプランに紐づいており、Google は Antigravity の公開時にこれらのティアを組み替えました。契約前に、必ず Google 自身のプランページで最新の制限を確認してください。Google Cloud を中心に使っている方、別途 Anthropic と契約せずに Claude のモデルを使いたい方、厳格なサンドボックス設定を最初から使いたい方には Antigravity CLI がおすすめです。オープンソースのクライアントが重要なら見送ってください。
Copilot CLI、Cursor、OpenCode、その他
Copilot CLI は、企業向けとして最も過小評価されている選択肢です。Anthropic、OpenAI、Google のモデルを1つの請求で使え、機能も最新です。plan モード、autopilot モード、コードの調査やレビューを行う組み込みエージェント、MCP、プラグイン、skills、hooks、そしてタスクを GitHub のクラウド上のコーディングエージェントに渡す & プレフィックスがあります(GitHub Changelog)。全プランに含まれており、Free、月額 $10 の Pro、$39 の Pro+、$100 の Max、さらに1席あたり $19 の Business と $39 の Enterprise があります(GitHub Docs)。
弱点は権限まわりです。Copilot はまずフォルダを信頼するよう求め、その後ツールを1つずつ、またはセッション全体で承認していきます。GitHub 自身のドキュメントも、セッションで rm を承認すると、そのディレクトリツリー内のあらゆるファイルを確認なしで削除できるようになると警告しています。ローカルのサンドボックスは /sandbox enable で有効にするオプトイン方式で、--yolo フラグを使うとすべてのチェックがオフになります。
ここでは、主要4製品を、宣伝文句ではなくドキュメントやライセンスで確認できる項目で比べます。
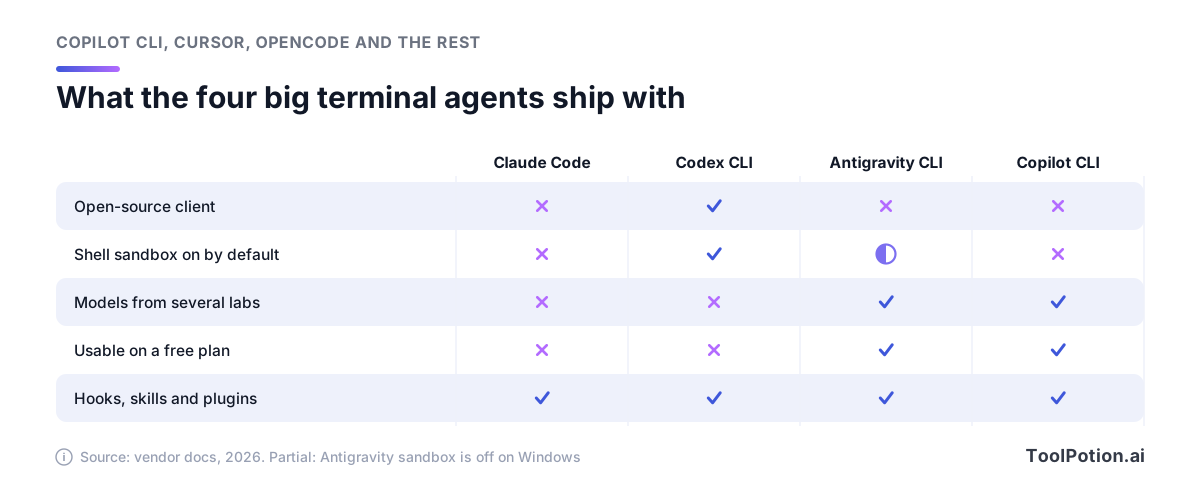
オープンソースのクライアントと、どこでもデフォルトで有効なサンドボックスを兼ね備えているのは Codex だけです。追加の手間なく複数ラボのモデルを混ぜて使えるのは Antigravity と Copilot の2つです。拡張性は収束しており、4製品すべてが hooks、skills、プラグインに対応しています。
Cursor は、エディタのエージェントをターミナルに持ち込んだもので、agent、plan、ask の各モード、スクリプトや CI 向けの print モード、クラウドエージェントへ渡す同じ & のハンドオフを備えています。すでにチームで Cursor を契約しているなら(Individual は月額 $20 から、Teams は1ユーザー $40)自然な追加ですが、そうでなければ勧めにくい選択肢です。
OpenCode はオープンソースの注目株です。MIT ライセンスで、GitHub のスターは211,000を超え、ローカルモデルを含む75以上のモデルプロバイダーに対応しています。GitHub Copilot や ChatGPT の Plus・Pro アカウントでサインインできるので、二重に支払う必要はありません。ただしデフォルト設定には注意してください。OpenCode はルールを書かない限り、確認なしでファイルを編集しシェルコマンドを実行します。OS のサンドボックスもなく、組み込みのガードが守るのは .env ファイル、プロジェクト外のパス、同じ動作を繰り返すループに陥ったエージェントだけです(OpenCode docs)。
あと3つ、ひとことずつ触れておきます。Amp は個人向けにはモデル費用を上乗せなしのプロバイダー価格のまま転嫁し、内部では GPT-5.6 と Claude Fable 5.1 を組み合わせています。無料ティアと $20 のプランがあります。Warp は今や AGPL ライセンスのエージェント型ターミナルで、独自のエージェントを持ち、価格は無料から $20 の Build、$200 の Max まで。MCP に対応したどのコーディングエージェントとも連携できるとしています。Aider は、変更のたびに diff や取り消しができるメッセージ付きでコミットするなど、git まわりの扱いは今でも最も優れていますが、リリースが止まっているので、使いたいモデルに対応しているかを確認してから決めてください。もっと幅広く見たい方は、AI コーディングアシスタントのランキングと AI エージェントのランキングで順位の動きを追えます。
ベンチマークでは Claude Code と Codex が互角
このカテゴリで最も有用な公開指標は Terminal-Bench です。Stanford、Harbor、Laude Institute が運営し、実際のターミナル内の難しいタスクで、エージェントとモデルの組み合わせをスコア化します。現行の 4.0 リーダーボードでは、最大の推論エフォートで動かした Codex と GPT-6 Astra が 58.2% で首位、最大エフォートの Claude Code と Fable 5.1 が 57.9% で続きます(Terminal-Bench)。各エントリーは330試行で、信頼区間は上下およそ3ポイントなので、引き分けと見てよいでしょう。
より重要なのはエフォートの設定です。それぞれの組み合わせを、推論設定が最低の場合と最高の場合で比べてみましょう。
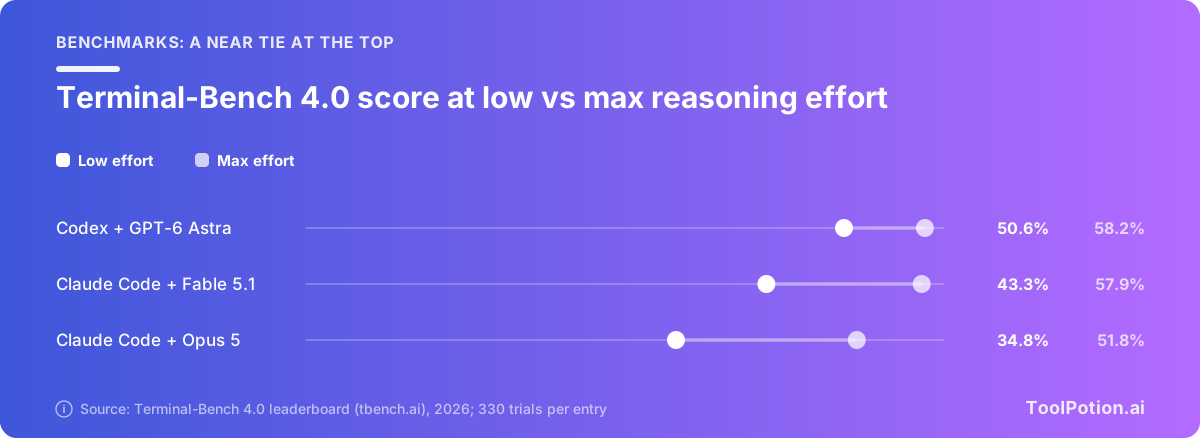
エフォートを max から low に下げると、Astra の Codex は8ポイント未満、Fable 5.1 の Claude Code は15ポイント近く下がります。旧世代の Opus 5 を使う Claude Code は17ポイント下がります。デフォルトのまま放置した設定が、製品名と同じくらい結果を左右することもあります。
コストを見ると、別の側面が見えてきます。リーダーボードには各実行で使った費用が記録されていて、最大エフォートの Codex と Astra は $3,267、Claude Code と Fable 5.1 は $6,244 でした。同じスコアで、1タスクあたりおよそ $9.90 と $18.90 の差です。これは長く難しいタスクの API レートでの費用であり、サブスクライバーが実際に支払う額ではありません。ボードには Google のエージェントがまったく載っておらず、Gemini モデルを動かす最上位のエントリーは、Gemini 3.8 Flash を使うサードパーティ製エージェントの 19.1% です。Sonnet 5.5 が Opus 5.5 をエージェント的なコーディングで上回るという Anthropic の主張のようなベンダーの発表は、ベンダー自身のテストに基づくものです。
権限モード:読み取り専用からフル自動まで
今ではどのツールも、名前こそ違え同じ自律性の段階を備えています。どの段階を選ぶかで、中断される頻度と、誤った指示(または README に仕込まれたプロンプトインジェクション)が引き起こす被害の大きさが決まります。
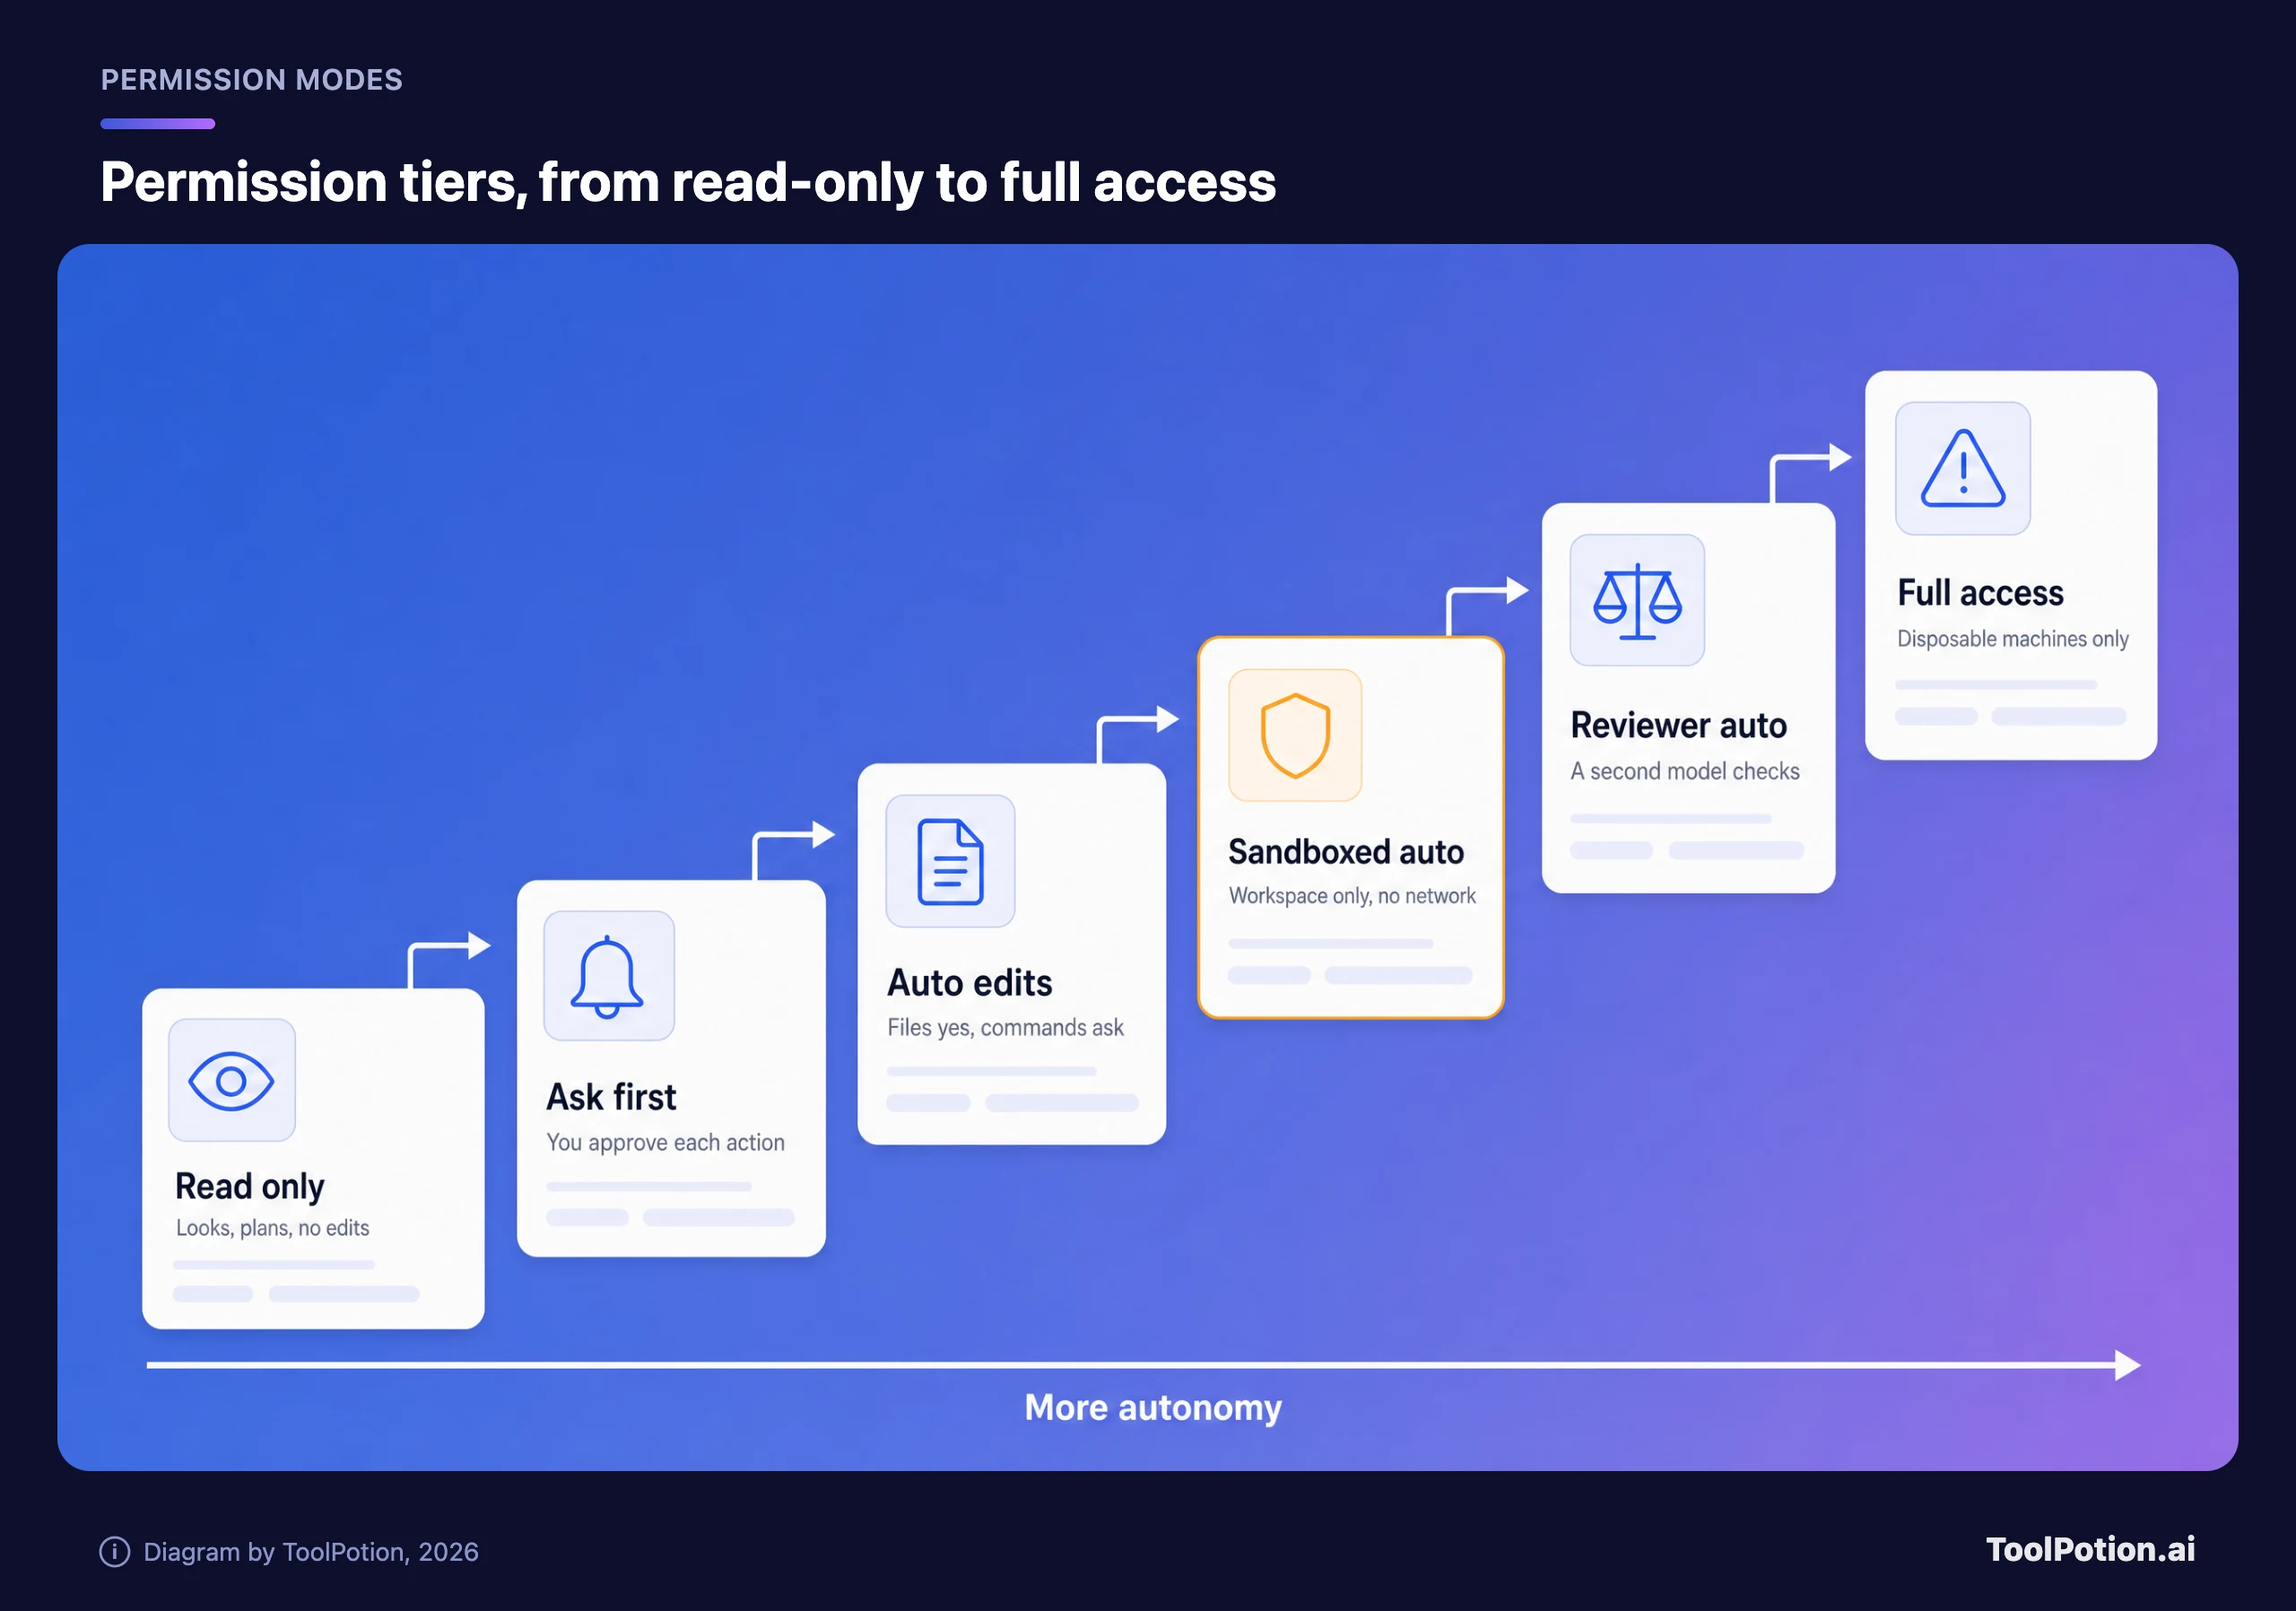
毎日のデフォルトとして適切なのは、サンドボックス付き自動です。エージェントはプロジェクト内ではコマンドを自由に編集・実行できますが、ネットワークには出られず、ホームディレクトリにも届きません。レビュアー自動は確認の回数をさらに減らしますが、モデルの判断を信頼することになります。フルアクセスは使い捨てのコンテナや VM 向けで、これは Anthropic のドキュメントが bypassPermissions について述べていることとも一致します。主要4ツールでの各段階の呼び名は次のとおりです。
| ティア | Claude Code | Codex CLI | Antigravity CLI | Copilot CLI |
|---|---|---|---|---|
| 読み取り専用 | plan | read-only | Plan mode | Plan mode |
| 先に確認 | default (Manual) | Granular approvals | Request Review | ツールごとに確認 |
| 自動編集 | acceptEdits | なし | Accept-Edits | セッション中ツールを承認 |
| サンドボックス付き自動 | /sandbox auto-allow | Auto(git リポジトリ内ではデフォルト) | デフォルトのプリセット | /sandbox enable |
| レビュアー自動 | auto(デフォルト) | Auto-review(オプトイン) | なし | なし |
| フルアクセス | bypassPermissions | danger-full-access | Turbo | --yolo |
目立つデフォルトが2つあります。Codex と Antigravity はサンドボックスの中で始まり、Claude Code と Copilot は、確認プロンプトやモデルによる審査に頼るモードで始まります。Claude Code を使っているなら、サンドボックスをオンにすることが、最も効果的な設定変更です。
プランか API キーか:実際にいくらかかるか
どのベンダーにも入口は2つあります。月額固定のプランは請求額に上限がありますが、5時間ごとと週ごとの制限がかかります。この制限は、トークン数ではなく倍率としてベンダーが説明しています。API キーはすべてのトークンが定価で課金され、上限はありません。
| エージェント | エントリープラン | 上位ティア | チーム向け |
|---|---|---|---|
| Claude Code | Claude Pro、月額 $20(年払いで $17) | Max 5x $100、Max 20x $200 | Team は月額 $25 または $125/席、Enterprise は $20/席 + API レートの従量課金 |
| Codex | ChatGPT Plus、月額 $20(CLI は Free と Go では使えません) | Pro は $100、$200、$500 | Business $20/ユーザー(年払い) |
| Copilot CLI | Pro 月額 $10(Free には少額の枠あり) | Pro+ $39、Max $100 | Business $19、Enterprise $39(1席あたり) |
| Antigravity CLI | 無料の Individual ティア | Google AI Pro と Ultra | Business は Google Cloud 経由で $30/席から |
| Cursor CLI | Individual 月額 $20 | 上位の個人向けティア | Teams $40/ユーザー |
価格は各ベンダーの料金ページに基づいています(Anthropic を含む)。プランの計算がややこしいと感じたら、クレジット、シート、トークンを解説したAIツールの料金モデルガイドをご覧ください。
ヘビーユーザーや CI にとっては、API 経由が最も重要です。Anthropic の料金は、Opus 5.5 が入力100万トークンあたり $4、出力 $20、Sonnet 5.5 が $2 と $10 です。OpenAI は GPT-6.1 Sol が $2 と $10、GPT-6 Astra が $10 と $50 です(OpenAI pricing)。請求額を左右するのは、表向きの単価よりキャッシュです。エージェントのループは同じコンテキストを何度も再送するからです。上の Terminal-Bench の実行では、Codex の入力トークンの約96%がキャッシュ読み取りで、OpenAI はこれを Astra の入力レートの10分の1で課金しています。
下のツールにご自身の数値を入れてみてください。デフォルト値は、ベンチマークのタスク1件分のトークン構成(Astra で1タスクあたり約 $10)を写したものです。ベンチマークの実行は長く難しいものなので、予算を立てる際は、ご自身の利用状況ダッシュボードの数値に置き換えてください。
デフォルト値のまま、開発者が Opus 5.5 でこのタスクを月40件こなすと、API キー経由で約 $126 かかります。そのため、制限が持ちこたえるなら Claude Pro と Max 5x のどちらも、より安く収まります。モデルを GPT-6 Astra に切り替えると、同じ作業量で約 $401 です。この差があるので、Codex では旗艦モデルを必要な難問にだけ使い、残りは GPT-6.1 Sol に任せるのがよいでしょう。
選び方と、安全な導入の進め方
まず、コードや契約がすでにどこにあるかから考え、次に安全面のデフォルトで決着をつけてください。
- すでにチームで ChatGPT を契約している、またはデフォルトでサンドボックスが有効なオープンソースのクライアントが欲しいなら、Codex から始めましょう。
- 最も深いカスタマイズを求めていて、Claude のモデルで満足できるなら、Claude Code を選び、何よりも先にサンドボックスをオンにしてください。
- 組織が GitHub を中心に動いていて、Claude・GPT・Gemini のモデルを、ユーザーごとの上限付きで1つの予算にまとめたいなら、Copilot CLI が最も手間がかかりません。
- Google Cloud を使っている組織は、Antigravity CLI を試してみてください。
- オープンソースで一貫させたい、またはローカルモデルを使いたいなら OpenCode を選んでください。ただし、ガードレールは自分で書くことになります。
まだ迷っていますか?下で重視する項目を調整してみてください。スコアは各ベンダーのドキュメントと料金に対する当編集部の評価であり、テスト結果ではありません。
安全性の重みを最も高くすると、Codex が首位、Copilot CLI が2位になります。チーム管理と支出上限を最優先にすると Copilot がわずかに上回り、モデルの選択肢とオープンソースを最大にすると OpenCode が1位になります。デフォルトの安全性より拡張性が重要になるほど、Claude Code の順位は上がります。
安全なチーム導入
- まず1つのリポジトリで数人の開発者とともに1つのエージェントを試験運用し、ツール同士ではなく成果を比較できるようにします。
- 権限のデフォルトは一元的に設定します。Claude Code ならサンドボックスをオンにし、push やデプロイを deny ルールで禁止する管理設定を使います。管理者は組織全体で auto モードをオフにもできます。Codex では、ネットワークをオフにした workspace-write を維持し、danger-full-access は使い捨ての CI ランナー専用にします。
- シークレットは手の届かないところに置きます。本番の認証情報を持つシェルでエージェントを動かさないこと、~/.ssh、クラウドの認証情報ファイル、.env の読み取りを禁止すること、そして Claude Code の hooks とローカルの MCP サーバーはサンドボックスの外で、あなたの全権限で動くことを忘れないでください。
- エージェントの diff は、新入社員のプルリクエストと同じようにレビューしてください。エージェントはブランチや PR を作れますが、マージするのは人間です。Claude Code Security Review や Codex のコードレビューのような自動レビュアーは二重のチェックであって、代わりにはなりません。
- 拡大する前に支出に上限を設けます。Copilot ではユーザー単位とコストセンター単位の予算を設定でき、追加利用はデフォルトでオンなので、上限を設けるかオフにしてください。Anthropic の Enterprise プランは、シート料金に加えて使用量を API レートで課金します。Antigravity のビジネスプランには、API とサブスクリプションの利用にまたがる支出上限があります。
- プラグインと MCP サーバーは、依存パッケージと同じように審査します。Anthropic のドキュメントによると、インストールしたプラグインはユーザー権限でコードを実行します。各自にマーケットプレイスを追加させず、許可リストで管理してください。
- CI には厳密な許可リストを与えます。Claude Code の dontAsk モードでツールを名前で指定するか、Codex を read-only または workspace-write のサンドボックスで動かすことで、無人の実行が予測可能になります。
すでに社内の他の業務でエージェントを動かしているチームなら、この内容の大半は本番環境のAIエージェントの記事でおなじみでしょう。エディタ中心のツールについては、AIコーディングアシスタントまとめもご覧ください。
よくある質問
Gemini CLI はまだ使えますか?
はい。Gemini Code Assist の Standard または Enterprise を利用している組織と、有料の Gemini API キーを使う開発者は使えます。無料ユーザーと Google AI Pro・Ultra のユーザーは Antigravity CLI に移行されました。Apache-2.0 のコードは GitHub に残っているので、誰でもフォークできます。
ChatGPT のサブスクリプションで Claude Code を、Claude のプランで Codex を使えますか?
いいえ。各プランは、そのベンダー自身のエージェントだけが対象です。ベンダーをまたいで1つのクライアントを使いたい場合、OpenCode は ChatGPT の Plus・Pro と GitHub Copilot のアカウントでサインインでき、Copilot CLI と Antigravity CLI は複数のラボのモデルを1つのサブスクリプションにまとめています。
個人開発者にとって一番安いターミナルエージェントは?
有料で最も安く始められるのは月額 $10 の Copilot Pro です。月額 $8 の ChatGPT Go には Codex CLI が含まれず、Plus から使えます。Copilot Free と Antigravity の無料ティアは無料ですが、利用枠は小さめです。ヘビーに使うなら、$20 の Claude Pro と ChatGPT Plus を、想定される API 料金と比べてみてください。
すべての diff をレビューするなら、サンドボックスは不要ですか?
必要です。diff レビューで見つかるのは悪いコードですが、それはエージェントがすでにコマンドを実行した後のことです。サンドボックスは、コマンドの実行中に触れられる範囲を制限します。シークレットを送ってはいけない場所へ送りかねないネットワーク呼び出しも含まれます。
Terminal-Bench は選定の指標として信頼できますか?
ターミナル作業を測る公開指標としては最良ですが、測っているのは、難しいタスクにおける、固定のエフォート設定でのエージェントとモデルの組み合わせです。数ポイントの差は信頼区間に収まるので、引き分けと見て、ご自身のリポジトリで短い試験運用をしてください。