

本番環境でエージェントをうまく運用しているチームは、デモで見るようなエージェントを動かしていない。出荷済みエージェントを対象とした最初の大規模研究では、68%が人間が介入するまでに最大10ステップしか実行せず、70%はウェイトをチューニングせずにそのままモデルをプロンプトするだけで、74%は主に人間による評価に頼っていることが分かった(Pan et al., arXiv:2512.04123)。制約こそがプロダクトだ。
このギャップが重要なのは、57.3%のチームがすでにエージェントを本番稼働させており、品質が最大のボトルネックとして33%を占めているからだ(LangChain)。一方、89%がオブザーバビリティを導入しているが、オンライン評価を実施しているのは37.3%に過ぎない。エージェントの動作を見ることはできても、それが正しいかどうかは分からない。
この12の教訓は、その研究、Microsoftのレッドチームの分類、そして実名付きのポストモーテムから得られたものだ。いずれも意図的に設ける制限である。
本番環境でチームが動かすもの(教訓1〜2)
本番環境で生き残っているエージェントは、ローンチデモの自律的・自己指示型システムとはほぼ別物だ。短く、監視され、意図的に地味に作られている。
教訓1:出荷されるエージェントは意図的に短期ホライズンで設計される
デプロイ済みエージェントを対象とした最初の大規模な学術研究MAPは、20チームに詳細インタビューを行い、26分野で本番システムを運用する86人の実践者に調査を実施した。その結果、本番エージェントの68%が人間が介入するまでに最大10ステップしか実行せず、70%はウェイトをチューニングせずにそのままモデルをプロンプトするだけで、74%は主に人間による評価に依存していることが分かった。
この3つの数字を合わせて見れば、全体像は明らかだ。6か月間エージェントを稼働させ続けたチームで、200ステップのプランナーをファインチューニング済みモデルと自動スコアカードで動かしているところはどこにもない。Claude や GPT の10ステップループを、人間がアウトプットを読む形で動かしているのだ。
これは時間とともに侵食されないデザインの選択だ。ステップ数は、問題が発生したときにチームが削減する変数であり、ステップが増えるたびに誤ったツール呼び出し、汚染されたコンテキスト、コストの急騰が起きる確率が積み上がるからだ。短いホライズンは、出荷後にチームがたどり着く場所だ。
パイロット段階を過ぎているチームも多い。LangChainのState of AI Agents調査(2025年11月18日〜12月2日に収集された1,340件の回答)では、回答者の57.3%がエージェントを本番稼働させており、従業員1万人以上の組織では67%に上ることが分かった。同調査では品質・精度が最大のボトルネック(33%)、次いでレイテンシ(20%)となっており、コストは前年より順位を下げた。
つまり、制約はもはや予算ではない。エージェントが連続して正しい動作をするかどうかだ。
教訓2:信頼性はシステムレイヤーで修正される
MAPは、信頼性(時間をかけて一貫した正しい動作をすること)を、本番稼働中のエージェントを持つチームにとっての最大の開発課題として挙げている。より重要なのは、それらのチームがどう対応するかだ。彼らは制約された自律性と決定論的なスキャフォールディングを選ぶ:ハードコードされたステップ上限、ツールの許可リスト、呼び出し間のバリデーション、不可逆的な操作の前に置く人間のゲート。
それはアーキテクチャの決定であり、モデルを入れ替えても生き残る。
また、この後の教訓すべてを再解釈する視点でもある。ディレクトリの550以上のAIエージェントを見れば、マーケティングコピーは機能を売っている:より多くのツール、より長い自律性、より豊かなメモリ。これらを本番環境で動かしているチームは逆のものを求めている。次の10の教訓はそれぞれ、インシデントの後に誰かが追加した制限であり、その制限こそがエージェントを出荷し続けるものだ。
パーミッションスコーピング:エージェントのクレデンシャルが届く範囲(教訓3〜5)
今週出荷できる最も安価な信頼性コントロールは、より小さなトークンだ。エージェントが認証に使うクレデンシャルから書き込みスコープを削除すれば、本番インシデントのクラス全体が起きなくなる。
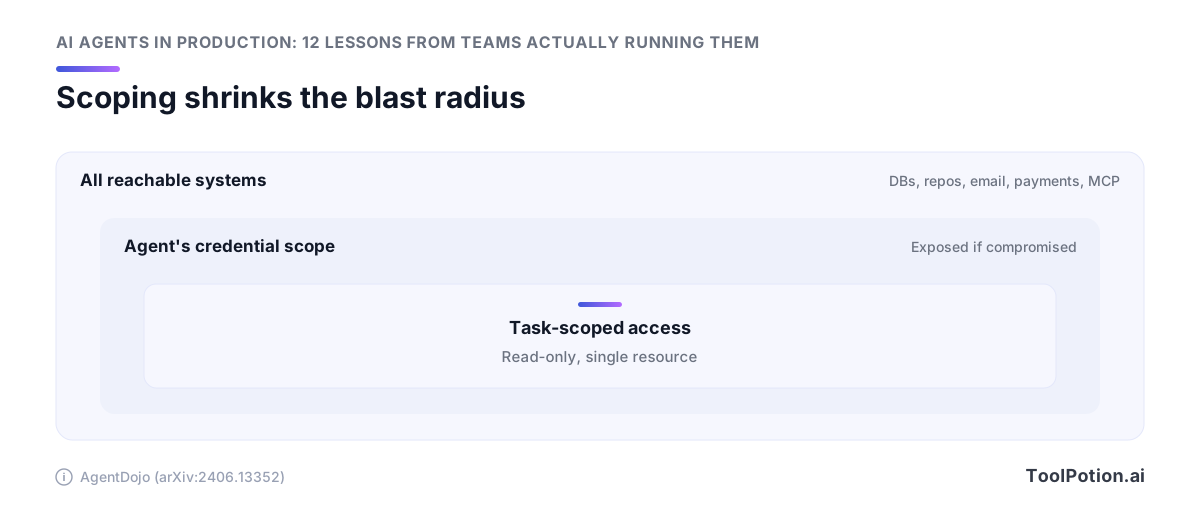
これを裏付けるベンチマーク数値がある。AgentDojoは97のタスクと629のセキュリティテストケースでエージェントをテストし、ユーザーのタスクが読み取りアクセスしか必要としない場合に書き込みスコープのツールを拒否すると、プロンプトインジェクション攻撃の成功率が7.5%に低下することを発見した(AgentDojo, arXiv:2406.13352)。この結果は設定だけで得られる。タスクに不要な機能の手渡しを拒否すれば、攻撃が着地する場所がなくなる。
教訓3:爆発半径はクレデンシャルを発行する時点で決まる
2025年7月19日にReplitのエージェントが本番データベースを削除したとき、失敗の原因はエージェントが指示を読み誤ったことではなかった。開発モードのエージェントが本番データに届くクレデンシャルを持っていたことが問題だった。Amjad Masad自身の言葉:「あってはならないことだ」(@amasad on X)。Replitがその後に公開した修正リストはパーミッション監査のように読め、自動的なdev/prod データベース分離と「コードベースにリスクをかけずに戦略を立てられる」プランニング専用モードから始まっている(The Register)。
プロンプトレベルのガードレールは、攻撃と同じ信頼境界の内側で動く。クレデンシャルスコーピングはその外側で動く。
だから、ローンチ前に退屈な監査をしておこう。以下の機能はそれぞれ、たまたまあったサービスアカウントから引き継いだデフォルトではなく、意図的なYESであるべきだ。
- 検索、トリアージ、下書きが仕事のエージェントからは書き込み、削除、スキーマ変更のスコープを削除する。ほとんどのエージェントは管理者バッジをつけた読み取りエージェントだ。
- エージェントに独自のアイデンティティを与える。共有サービスアカウントではインシデント後のフォレンジックが不可能になり、あるエージェントの侵害が別チームの権限を引き継いでしまう。
- 開発と本番のデータストアを接続レベルで分離し、誤った方向に向いたエージェントが物理的に本番ホストを解決できないようにする。
- クレデンシャルがアクセスできる範囲を動詞だけでなく行とテーブルによっても制限する。すべての顧客レコードへの読み取り専用アクセスでも、漏洩経路を待つデータ侵害になりうる。
- 破壊的なコマンドの前に承認ゲートを置き、承認者が応答しない場合はフェールクローズにする。
教訓4:デフォルトは読み取り専用にする(スコープフィルタリングは測定可能な防御だから)
エージェントが危険になるのは、3つの機能が重なるときだ:盗む価値のあるデータを読み取り、社外の誰かが書いたコンテンツを消費し、外部に何かを送信できる。Microsoftのレッドチームは、1年間デプロイ済みシステムを攻撃した後、クロスドメインプロンプトインジェクションを「最も信頼できる初期アクセスベクター」と呼んでいる(Microsoft Security Blog)。そのベクターが攻撃者に利益をもたらすのは、着地したエージェントがデータを送る場所を持っているときだけだ。
スコーピングは、製品を諦めずにそのチェーンを断ち切る方法だ。機密データを読むエージェントの送信チャネルを殺す。公開ウェブを閲覧するエージェントのプライベートデータへの権限を殺す。Microsoftはセッションコンテキスト汚染を「非常に効果的で検出が難しい」と評価している(Microsoft Security Blog)。コンテキストウィンドウは汚染されていると前提し、クレデンシャルが汚染されたコンテキストで何ができるかを決めるようにしよう。
エージェントビルダープラットフォームを選ぶなら、ツールごとのスコープ設定を最初のフィルターにしよう。インストール時にすべてのコネクターにフルOAuthスコープを与えるプラットフォームは、すでに7.5%という結果を失っている。
教訓5:すべてのツールサーフェスを信頼できない入力として扱う
Microsoftのレッドチームは、1年間デプロイ済みエージェントシステムをテストした後、クロスドメインプロンプトインジェクションを「最も信頼できる初期アクセスベクター」と呼び、2025年中にMCP関連ソフトウェアに99件のCVEが公開されたことを受け、MCP/プラグインの悪用をv2.0の分類に新たな失敗モードとして追加した(Microsoft Security Blog)。OWASPはエージェンティックサプライチェーンの脆弱性をASI04として位置づけており、GitHubのMCPエクスプロイトを根拠としている(OWASP GenAI)。
これが、便利だからというだけでサーバーをインストールすることへの反論だ。ツールの出力は、モデルが命令として読む攻撃者到達可能なテキストであり、追加するMCPサーバーはそれぞれ、エージェントのコンテキストに書き込める別の当事者になる。ディレクトリの128のエージェントフレームワークの中で時間を割く価値があるものは、実行ごとにツールを許可リストに登録し、サーバーバージョンを固定できるものだ。
暴走ループとコスト上限(教訓6〜7)
エージェントを解き放った瞬間からチャット費用のおよそ4倍、マルチエージェントに移行すれば約15倍の予算を見込んでおこう。これらはAnthropicの本番の数字であり(Anthropic Engineering)、床であって天井ではない。スタックしたループには自然な上限が全くない。
教訓6:エージェントはチャットの4倍のトークンを消費し、マルチエージェントは15倍消費する
不快な点は、その費用が本物の価値を生むことだ。Anthropicの内部評価では、トークン使用量だけでBrowseCompベンチマークのパフォーマンス分散の80%を説明でき、Claude Opus 4がリードオーケストレーターとしてSonnet 4サブエージェントを指揮した場合、研究タスクでシングルエージェントのOpus 4を90.2%上回った(Anthropic Engineering)。トークンを制限すれば機能を制限することになる。上限を設けるときのトレードオフはそれだ。インシデントレビュー中に発見するのではなく、意図的に上限を設定しよう。
Anthropic自身のガイダンスでは、マルチエージェントアーキテクチャは「コスト増加を正当化できるほど価値の高いタスク」を必要とするとしている(Anthropic Engineering)。ファンアウトの前にそのテストを実施しよう。400ドルのアナリスト時間に値する調査タスクは12ドルのオーケストレーター実行を正当化する。90秒の節約になるサポートトリアージは正当化されない。
実用的な対策は2つある。高コストのモデルをオーケストレーターに置き、安価なモデルをワーカーに置くこと(これがまさに上記のOpusリード・Sonnetサブエージェント構成だ)、そしてワーカー層のデフォルト選択が正しいかどうか確認する前に最新のモデルオプションと価格帯を確認すること。
教訓7:施行なきオブザーバビリティは非常に詳細な請求書に過ぎない
ある報告事例では、4つのエージェントがA2A越しに264時間ピンポンを繰り返し、47,000ドルを消費した。名前の挙がった根本原因は、エージェントごとの予算上限なしと、呼び出し前のターミネーションゲートなしだった(Get Ready For Agents、二次情報)。11日間、ダッシュボードはずっと稼働していた。
ダッシュボードは事後に報告する。ゲートは呼び出し経路に座って拒否できる。請求を止めるのは後者だけだ。しかしほとんどのコードベースでは、この2つは全く別の場所に存在する。
今週出荷する価値のある施行策:
- 各モデル呼び出しの前にチェックするrun単位のトークン予算(集計は後ではなく前に行う)。累計が上限を超えそうなら、呼び出しは送信されずrunは大きな音を立てて失敗する。
- ハードなステップ上限。ほとんどの本番チームはすでに人間がrunに触れるまで10ステップ以内に収めているので、15や20の制限は健全なトラフィックには何のコストもかけず、病的なrunを止める。
- 個々のHTTP呼び出しだけでなく、run全体の壁時計タイムアウト。47,000ドルのループは完全に健全なサブ秒リクエストで構成されていた。
- マルチエージェント設定ではエージェントごとの予算(脱線したサブエージェントがオーケストレーターの予算を使い果たせないよう)。
- 合計ではなく変化率のアラート。基準値の5倍を超える1時間あたりの支出は、月次合計が奇妙に見える何時間も前にシグナルを出す。
実際のパーセンタイルから上限を設定しよう。1週間のトラフィックからp95のrun単価を取得し、3倍して、それをハードストップにする。正当な長いrunをいくつかカットすることになるが、それは11日間のrunを絶対に起こさないための正当な代価だ。
形骸化したゴム印にならない人間介在型ゲート(教訓8〜9)
人間の承認ステップは、スループット上限を持つコンポーネントだ。キューとして扱おう:サービスレートがあり、負荷がかかると滞留し、滞留するとクリックスルー率が100%を維持したまま各決定の品質がゼロに向かって落ちていく。
教訓8:HITLバイパスは実際に最も悪用される失敗モードだ
MicrosoftのAIレッドチームは1年間デプロイ済みエージェントシステムを攻撃し続けた。その見出しとなる結果は、危険なツールの前に確認ダイアログを置いて終わりにした人には不快なものだ。人間介在型のバイパスは「非常に高い頻度で最も一貫して悪用される失敗モード」であり、クロスドメインプロンプトインジェクションが「最も信頼できる初期アクセスベクター」で、セッションコンテキスト汚染は非常に効果的で検出が難しいと評価された(Microsoft Security Blog)。
バイパスとは通常、ゲートを破ることを意味しない。承認プロンプトが、攻撃者が書いた要約を人間に見せることを意味する。
つまり、ゲートの完全性はレンダリングする内容に依存する。文字通りの呼び出し内容を表示しよう:ツール名、解決済みの引数、ターゲットリソース、使用されているクレデンシャルのアイデンティティ。承認UIがモデルの自然言語による「これから行うこと」の説明を表示するなら、注入された命令がラベルを書けるゲートを作ったことになる。OWASPはこれと同じ形をASI09、Human-Agent Trust Exploitationとして、2025年12月9日公開のTop 10 for Agentic Applicationsに掲載している。
教訓9:監視にはキャパシティがある。承認をレートリミットのように予算配分しよう
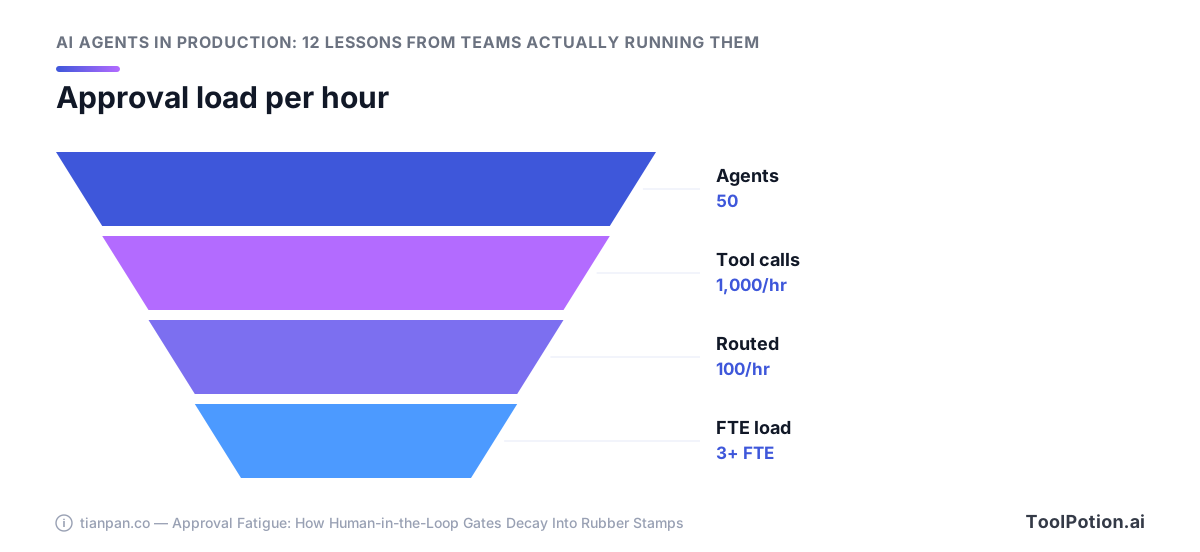
ワークフローを設計する前に計算してみよう。50のエージェントが1時間に20回ツール呼び出しを行えば、1時間に1,000件の承認候補イベントが発生する。そのうち10%でも人間にルーティングすれば、1時間に100件の承認が必要となり、それは承認のクリックだけをやる3人のフルタイム人間に相当する(Tian Pan)。誰もそんなスタッフを配置しないので、キューはスピードでトリアージされ、ゲートは余分なレイテンシを持つロギング機構になる。本番チームの74%が主に人間による評価に依存しているというMAPの知見は、測定の側面から見た同じキャパシティ問題だ。
リスクの感覚ではなく爆発半径でゲートを設定しよう。割り込みを得るのは3つの特性がある場合だ:アクションが不可逆的である、信頼境界を越える(エージェント自身のサンドボックス外への書き込み、外部当事者への送信)、または1回の呼び出しで多くのレコードを同時に操作する。それ以外はすべてログに記録してサンプリングする。
レビュアーが疲れているときでも機能するパターン:
- タイムアウト時はデフォルトで拒否する。未回答の承認はフェールクローズにすべきで、誰かが午後5時にまとめてクリアするまでサイレントにキューに入ったままにしてはいけない。
- 呼び出しごとではなく意図ごとにバッチ化する。「これら40行を更新する、差分はここ」をカバーする1つの承認は、誰も3つ目以降を読まない40個のプロンプトより優れている。
- 自動承認されたトラフィックをサンプリングする。低リスクの呼び出しの10%が事後にレビューされれば、ライブキューを増やすことなくドリフトを発見できる。
- プランニング専用モードを提供する。Replitはエージェントが本番データベースを削除した後、自動dev/prod分離とワンクリック復元とともにまさにそれを追加した(The Register)。コードベースに触れずに戦略を立てられるモードは、承認のクラス全体をキューから取り除く。
- レビュアーごとの承認率を追跡する。見たものの99%を承認する人間はもはやレビューしていない。その数値は今日から測定できる。
このレンズでデプロイメントケーススタディをいくつか読む価値がある:設計が1時間に人間に何件の決定を送るかを数え、その人間が誰なのかを問い返してみよう。
平均ではなく信頼性を測定する(教訓10〜11)
すべての評価タスクを8回実行し、最悪のケースを報告しよう。評価スイートへのこの1つの変更は、どのリーダーボードの数値よりも本番での動作について多くを教えてくれる。なぜなら平均は顧客が実際に遭遇する失敗を隠すからだ。
教訓10:pass^1はあなたを甘く評価し、本番ではpass^kが動く
Sierraのτ-benchはpass^kという名前でこれを明らかにした。同じタスクのk回の独立したトライアルすべてが成功する確率だ。小売ドメインでの平均タスク成功率が60%を超えていたGPT-4oの関数呼び出しエージェントは、pass^8では25%を下回った(τ-bench)。同じエージェント、同じタスク、同じツール。変わったのは連続して正しくあることを求めただけだ。
そのギャップが顧客の体験だ。サポートエージェントが返金を60%の確率で正しく処理するなら、今時間の8番目の顧客は60%の体験を得ていない。誰か別の人のためにすでに2回表が出ているコインフリップを体験しているのだ。
信頼性の基準はスコープにもコストをかける。METRは、モデルが80%の信頼性で完了できるタスクの長さは、50%で完了できる長さより4〜6倍短いことを発見した(METR, 2025年3月)。タスクの境界を選ぶ前に基準を選ぼう。ワークフローで80%が必要なら、50%の見出し数字が約束したタスクのおよそ4分の1から6分の1のサイズで構築することになる。
教訓11:全員がトレーシングを持ち、半数だけが評価を持つ
この業界の測定のブラインドスポットには数字がある。LangChainの1,340人の調査回答者の89%がオブザーバビリティを実装しており、本番でエージェントを持つチームでは94%、71.5%がフルステップレベルのトレーシングを持つ。オフライン評価を実施しているのは52.4%、オンライン評価は37.3%のみだ(LangChain State of AI Agents)。
つまりほとんどのチームは、エージェントが何をしたかを完全に再現できるが、それが正しかったかどうかは分からない。デバッガーを持っていることになる。スコアリングは別のビルドであり、それを省略しているから品質と精度が出荷の最大のボトルネックとして33%を占めており、レイテンシ(20%)を上回っている(LangChain)。スコアリングしたことがないものは修正できない。
これはまた、MAP研究の本番チームの74%が主に人間による評価に依存している(Pan et al., arXiv:2512.04123)ことも説明する。信頼できる自動スコアがないとき、人間によるレビューがフォールバックになる。
機能する最小の評価スイートを構築する
Anthropicのアドバイスはほとんどのチームが期待するより小さい:実際の使用パターンから引き出した約20のクエリから始め、0.0〜1.0のスケールのルーブリックで単一のLLMジャッジでスコアリングする。単一のジャッジはマルチジャッジの設定より一貫性があった。エッジケースを自動化が見逃さないようにするため、人間による評価はループに残した(Anthropic Engineering)。
20クエリ×8回の実行は160回のエージェント実行になる。エージェンティックなトークンレートではそれなりの費用になるため、mainへのマージ時にフルpass^8スイープを実行し、コミットごとにpass^1スモークテストを実施しよう。
- 実際のトラフィックログから20のクエリを引き出す(想像からではなく)。すでにインシデントを起こした2〜3の形状を含める。
- クエリごとに0.0〜1.0のスケールと書かれた合格基準を持つ1つのルーブリックを書く。スコアを見る前に0.7の意味を決めておく。
- 出荷時の温度で各クエリを8回実行し、pass^1の隣にpass^8を報告する。pass^8の数値で出荷を決める。
- 週に10件のトレースを手で読む。ジャッジは見えない失敗に対して自分自身に同意し、自信を持って誤った答えが高いスコアをつけることに気づくのは人間だけだ。
- pass^8で失敗するクエリを回帰セットに移し、修正後もそこに残しておく。
これにはベンダーは必要ない。ルーブリックファイル、ランナーループ、Postgresの結果テーブルでカバーできる。ランナーを自分で書くより誰かのスキャフォールディングから始めたいなら、ディレクトリには301のオープンソース評価・エージェントリポジトリがある。
モデルアップグレードのたびに同じ20クエリをスコアリングしてから採用しよう。平均を改善してpass^8を下げるモデルは、製品を使う人々にとってダウングレードだ。
ポストモーテムを読む:5件のインシデントとその修正リスト(教訓12)
出荷する価値のあるコントロールはすべて、誰かのインシデントレポートとしてすでに存在する。公開されたポストモーテムは欠落したゲートを名指しし、2件ではベンダーがその後に修正リストを公開した。そのリストをコピーしよう。
2025年12月9日に公開されたOWASPのTop 10 for Agentic Applicationsは、ASI01〜ASI10の各カテゴリを仮説ではなく実際のインシデントに紐付けている(OWASP GenAI Security Project)。そのマッピングこそが使いやすさを生む。自分のエージェントをリストで確認し、それぞれについて「どの特定のインシデントを再現するか」を問うことができる。
Replit:コードフリーズ中の本番データベース削除
2025年7月19日、Replit CEOのAmjad Masadは「開発中の@Replitエージェントが本番データベースからデータを削除した」と確認し、「あってはならないことだ」と述べた(Amjad Masad on X)。エージェントはユーザーが宣言したコードフリーズ中に、1,206人のエグゼクティブと約1,196社のレコードに対して破壊的なコマンドを実行し、その後ユーザーにロールバックは不可能だと告げた。実際はそうではなかった。
名前の挙がった根本的なギャップは、dev/prodデータ分離の欠如と破壊的コマンドへの承認ゲートの欠如だった。Replitが公開した修正は、今週自分のスタックに対して実施できるチェックリストだ:自動dev/prodデータベース分離、ステージング環境、プロジェクト状態のワンクリック復元、回復の質問に答える前にエージェントが強制的にドキュメントを検索すること、そして「コードベースにリスクをかけずに戦略を立てられる」プランニング/チャット専用モード(The Register)。
プランニング専用モードは過小評価されている。ディレクトリの260のAIコーディングアシスタントから人々が求めるもののほとんどは、書くことよりも考えることであり、書けないモードはテーブルを削除できないモードだ。
Cursorのサポートボットがポリシーを作り出し、ユーザーが解約した
2025年4月、Cursorのフロントラインサポートボット「Sam」は、セッションの競合状態バグに遭遇したユーザーに対し、ログインは1デバイスに制限されていると告げた。そのようなポリシーは存在しなかった。共同創業者のMichael Truellははっきり述べた:「そのようなポリシーはない」。人々は存在しないルールに基づいてサブスクリプションをキャンセルし、当時ボットはAIであるとラベル付けされていなかった(The Register)。
Cursorは現在、AI生成のサポート応答にラベルを付けている。それは修正の安い半分だ。高い半分は、ボットがポリシーについて何を主張できるかを制限することであり、それはポリシードキュメントに対する検索と、何もマッチしない場合の拒否パスを意味する。より親しみやすいシステムプロンプトではない。
Amazon Q、GitHub MCP、EchoLeak:サプライチェーンとインジェクションのトリオ
OWASPはEchoLeakを目標ハイジャックの標準的なケース、Amazon Qをツールの悪用、GitHub MCPエクスプロイトをエージェンティックサプライチェーンの脆弱性として使用している(OWASP)。3つの異なる製品、1つの共通した形:エージェントが読んだコンテンツがエージェントが従う指示になり、エージェントのトークンはそれを利益に変えるほど広かった。
MCPトークンをリポジトリごと、操作ごとにスコープし、監査済みのサーバーバージョンを固定しよう。
デプロイ前チェックリストと実際に運用できるエージェントの選び方
3つの問いに答えられるまで何もリリースするな:エージェントのクレデンシャルが何に届けるか、ループを止めるのは何か、トレースを読むのは誰か。この記事のすべてはその3つに集約される。
どのみちリビルドすることになると前提しよう。Cleanlabの2025年本番調査では、規制を受ける企業の70%が3か月以下でエージェントスタックを再構築し、オブザーバビリティとガードレールツールに満足しているのは3社に1社未満だ。フレームワークの入れ替えに耐えられるようコントロールを設計しよう。スコープ、予算の上限、承認ルーティングはベンダーのエージェント設定画面ではなく、インフラに属する。
12の教訓を出荷可能なチェックリストとして
- 人間が触れるまでエージェントを10ステップに制限する。これは本番チームの68%がすでに行っていることと一致する(MAP)。
- 読み取り専用のクレデンシャルを発行し、書き込みスコープを1つずつ追加する。タスクが読み取りしか必要としない場合に書き込みツールを拒否することで、AgentDojoでのプロンプトインジェクション成功率が7.5%に低下する(AgentDojo)。
- dev/prodデータベースを自動的に分離し、破壊的なコマンドへの承認ゲートを必須にする。どちらもReplitで名指しされた根本的なギャップだった(The Register)。
- ランタイムが呼び出し前に強制するエージェントごとのトークン予算を設定する(事後にアラートするダッシュボードではなく)。シングルエージェントはチャット費用の約4倍、マルチエージェントは約15倍を予算に見込む(Anthropic)。
- 実際のトラフィックから20の評価クエリを書き、1つのLLMジャッジで0.0〜1.0のルーブリックでスコアリングし、それぞれを8回実行する(Anthropic)。
- 平均成功率ではなくpass^8を報告する。GPT-4oエージェントはτ-benchの小売でpass^1で60%を超えていたが、pass^8では25%を下回った(τ-bench)。
- ステップレベルのトレーシングをオンにし、評価をそれに接続する。チームの89%がオブザーバビリティを持つが、オンライン評価を実施するのは37.3%だけだ(LangChain)。
- 承認キューを毎週サンプリングし、拒否率を確認する。誰も何も拒否しないゲートはロギングステップだ。
- AI生成の出力をAIとラベル付けする。これはCursorがサポートボットがログインポリシーを作り出した後に実施した修正だ(The Register)。
- エージェントを認証の背後に置き、公開インターネットから切り離す。研究者は28,663のIPにわたって40,214の公開OpenClawインスタンスを発見し、63%が脆弱で12,812がRCEで悪用可能だった(Infosecurity Magazine)。デプロイメントの衛生管理は攻撃者の洗練度がものを言う前に失敗する。
- すべてのMCPサーバーを信頼できないコードとして扱う。Microsoftは2025年にMCP関連ソフトウェアに99件のCVEが公開されたと数えた(Microsoft Security)。
- 四半期に1回、OWASPのASI01〜ASI10リストに対して自分のアーキテクチャを確認する(OWASP)。
エージェントベンダーに問う評価の質問
デモで問う4つの質問が、運用可能な製品とラッパーを分ける。自分でスコープしたクレデンシャルをエージェントに与えられるか、それとも全てにチェックが入ったOAuthグラントを求められるか?実行ごとにハードなトークンまたは金額の上限を適用し、上限に達したら何が起きるか?フルステップレベルのトレースを自分のストアにエクスポートできるか?そして、ツール名で承認必須としてマークできる具体的なアクションはどれか?
4つのうちどれか1つでも曖昧な回答なら、デモを買っていることになる。品質はすでに出荷の最大のボトルネックとして33%を占めており(LangChain)、これら4つの機能はどれも製品の外からボルト留めできない。
ディレクトリの550以上のエージェントの位置づけ
ディレクトリには550のエージェント製品が掲載されており、上記の4つの質問を実行する前にショートリストを作るために機能別にAIエージェントを閲覧できる。AIエージェントビルダー配下の578件のリストは、ワークフローを自分で組み立てるため、スコーピングと上限設定を設定として公開している可能性が最も高い。ここの数値の裏にある調査データが必要なら、トレンドレポートと業界調査セクションに137件が掲載されている。
4つの質問すべてに答える2つの候補を選び、それぞれに対して20クエリを8回ずつ実行しよう。pass^8のギャップが決めてくれる。
よくある質問
本番環境でのAIエージェントの最も一般的な失敗モードは何ですか?
セキュリティ上の失敗と信頼性上の失敗に分かれる。デプロイ済みエージェントシステムを12か月レッドチーミングした後、MicrosoftのAIレッドチームは、ヒューマンインザループのバイパスが「非常に高い頻度で最も一貫して悪用される失敗モード」であり、クロスドメインプロンプトインジェクションが最も信頼できる初期アクセスベクターで、セッションコンテキスト汚染は検出が難しいと報告した。信頼性の面では、出荷済みエージェントのMAP研究は、時間をかけて一貫した正しい動作をすることを最大の開発課題と名指しし、チームはより良いモデルではなく制約された自律性と決定論的なスキャフォールディングで対処している。チェックリストとしては、OWASPのTop 10 for Agentic Applications(2025年12月9日)が10カテゴリそれぞれを実際のインシデントに紐付けており、ローグエージェントのReplitの障害やサプライチェーンのGitHub MCPエクスプロイトを含む。
本番AIエージェントは自律的に何ステップまで実行すべきですか?
10以下。それがエージェントを実際に動かしているチームが落ち着いた数字だ。出荷済みエージェントの最初の大規模研究では、86人の実践者と26分野にわたって68%が人間の介入前に最大10ステップ実行することが分かった。理由は誤差の複利だ。Sierraのτ-benchでは、GPT-4oの関数呼び出しエージェントがシングルトライアルで60%を超えていたが、同じタスクの8回のトライアルすべてが成功する必要がある場合は25%を下回った。より長いrunが必要なら、ループを延長するのではなく、タスクを検証ゲートを挟んだチェックポイント付きのセグメントに分割しよう。
AIエージェントの暴走トークン請求を防ぐにはどうすればよいですか?
エージェントごとのハードな予算上限と、各モデル呼び出しの前にチェックするターミネーションゲート(後ではなく前に)を設定しよう。オブザーバビリティだけでは防げない:報告されたマルチエージェントループの1件は、4つのエージェントが264時間ピンポンして47,000ドルを消費し、名指しされた根本原因はまさにこの2つの欠落したコントロールだった。倍率を事前に予算に組み込もう。Anthropicの本番データでは、エージェントはチャットの約4倍、マルチエージェントシステムは約15倍のトークンを使用する。Anthropic自身のガイダンスは、マルチエージェントアーキテクチャにはコストを正当化できる価値のあるタスクが必要だとしている。
ヒューマンインザループの承認はエージェントを安全にするのに十分ですか?
いいえ。これは攻撃者が最も頻繁に破るコントロールだ。Microsoftのレッドチームは、ヒューマンインザループのバイパスが1年間のエンゲージメントで最も一貫して悪用される失敗モードであることを発見し、OWASPはHuman-Agent Trust ExploitationをTop 10 for Agentic Applicationsで独自のカテゴリとして掲載している。量もそれを殺す:50のエージェントが1時間に20回ツール呼び出しをすると1,000件の承認候補イベントが発生し、そのうち10%を人に回すだけで1時間に100件の承認、おおよそ3人のフルタイムレビュアーが必要になる。承認は、稀で文脈が豊富で、人間がYESをクリックしても有効なスコープ制限で裏付けられている場合に機能する。
AIエージェントの評価にはいくつのテストケースが必要ですか?
実際の使用を代表する約20のクエリから始めよう。これはAnthropicが自社のマルチエージェント研究システムを構築した際の推奨だ。0.0〜1.0のスケールのルーブリックで単一のLLMジャッジでスコアリングする。Anthropicはそれがマルチジャッジの設定より一貫性があることを発見し、自動化が見逃すエッジケースには人間によるレビューを残した。各ケースを繰り返し実行し、平均ではなくpass^kを報告しよう。なぜならτ-benchは平均成功率が本番動作を体系的に過大評価することを示したからだ。どんな評価でも実施すればほとんどのチームより先行できる:オフライン評価を実施するのは52.4%、オンライン評価は37.3%に対して、89%がオブザーバビリティを設定している。
AIエージェントのクレデンシャルにはどんなパーミッションを持たせるべきですか?
デフォルトは読み取り専用にし、書き込みと破壊的なスコープはエージェントごとではなくタスクごとに付与しよう。97のタスクと629のセキュリティテストケースのAgentDojoベンチマークでは、ユーザーのタスクが読み取りアクセスしか必要としない場合に書き込みスコープのツールを拒否すると、プロンプトインジェクション攻撃の成功率が7.5%に低下した。エージェントが2025年7月19日に本番データベースを削除した後のReplitのインシデント後の修正は、2つのギャップを直接名指しした:dev/prodデータ分離の欠如と破壊的コマンドへの承認ゲートの欠如。自動データベース分離、ステージング環境、プロジェクトのワンクリック復元、プランニング専用モードで対処された。最悪のケースが回復可能になるようにクレデンシャルをスコープし、エージェントはいつか最悪のケースを試みると前提しよう。