

GitHubは、Artificial Analysis Coding Agent Indexで Copilot Fusion Max が「60点を記録し、Claude Code with Opus 5.5 Maxとの差は2ポイント以内」だったと説明しています(GitHub changelog)。ところがThe New Stackの見出しでは、これが「APIコストが半分でClaude Codeに勝つ」システムになっていました(The New Stack)。この2つは別の主張であり、チームが考えるべきなのはその差の部分です。
FusionはGitHub Copilotのモデルピッカーに加わった新しい選択肢として、一般提供が始まっています。モデルを選ぶのではなく、エフォートレベルを選びます。どのモデルをどの順番で動かすかは、プロンプトごとにCopilotが決めます。アイデアは優れていますが、裏付けとなる根拠はまだ薄いです。まずはコスト管理の機能として捉え、品質面の主張は二の次にするのがよいと考えます。
60点は62点ではない
GitHub自身の表現をもう一度読んでみましょう。Fusion Maxは、Opus 5.5 MaxのClaude Codeと2ポイント以内の差で、タスクあたりの平均APIコストは約半分、トークン数も約半分、所要時間は約40%短縮されたとのことです(changelog)。十分に立派な結果で、売り文句としても妥当です。ただし「勝った」わけではありません。The New Stackも見出しでは「beats」と言いながら、本文では「comparable」と書いています。GitHubはUniverseのまとめ記事でも同じ主張を繰り返しており、広まっているのは「コスト半分」という言い方です。
GitHubが引用している指標は、Artificial Analysisが公開しているものです。FrontierCode、Terminal-Bench 4.0、SWE-Atlas-QnA-AAの3つのベンチマークを同じ重みで合成しています(Artificial Analysis)。このページの初期表示では、Opus 5.5 MaxのClaude Codeが62点で、Fusionの項目はありません。「Router models」のトグルをオンにすると、GitHub Copilot - Copilot Fusion (Max)が60点で現れるので、数字は本物で、GitHubの説明どおりの位置にあります。同じトグルでは、Opus 5.5 MaxとGPT-6 Lunaを組み合わせたCognitionのDevin Fusion CLIも表示され、Claude Codeと並ぶ62点です。ルーターというカテゴリー全体が追いついてきているということであり、GitHubのものが抜きん出ているわけではありません。ページのコスト列とGitHubの「コスト半分」という数字は突き合わせていないので、その部分はGitHubの言い分のままです。
1つのメニューの裏にある3つの経路
ドキュメントはFusionを「インテリジェントなランタイムのモデルルーター兼オーケストレーター」と説明しています(GitHub Docs)。プロンプトごとに3つの実行パターンから1つを選び、同じセッションでもプロンプトによって経路が変わることがあります。
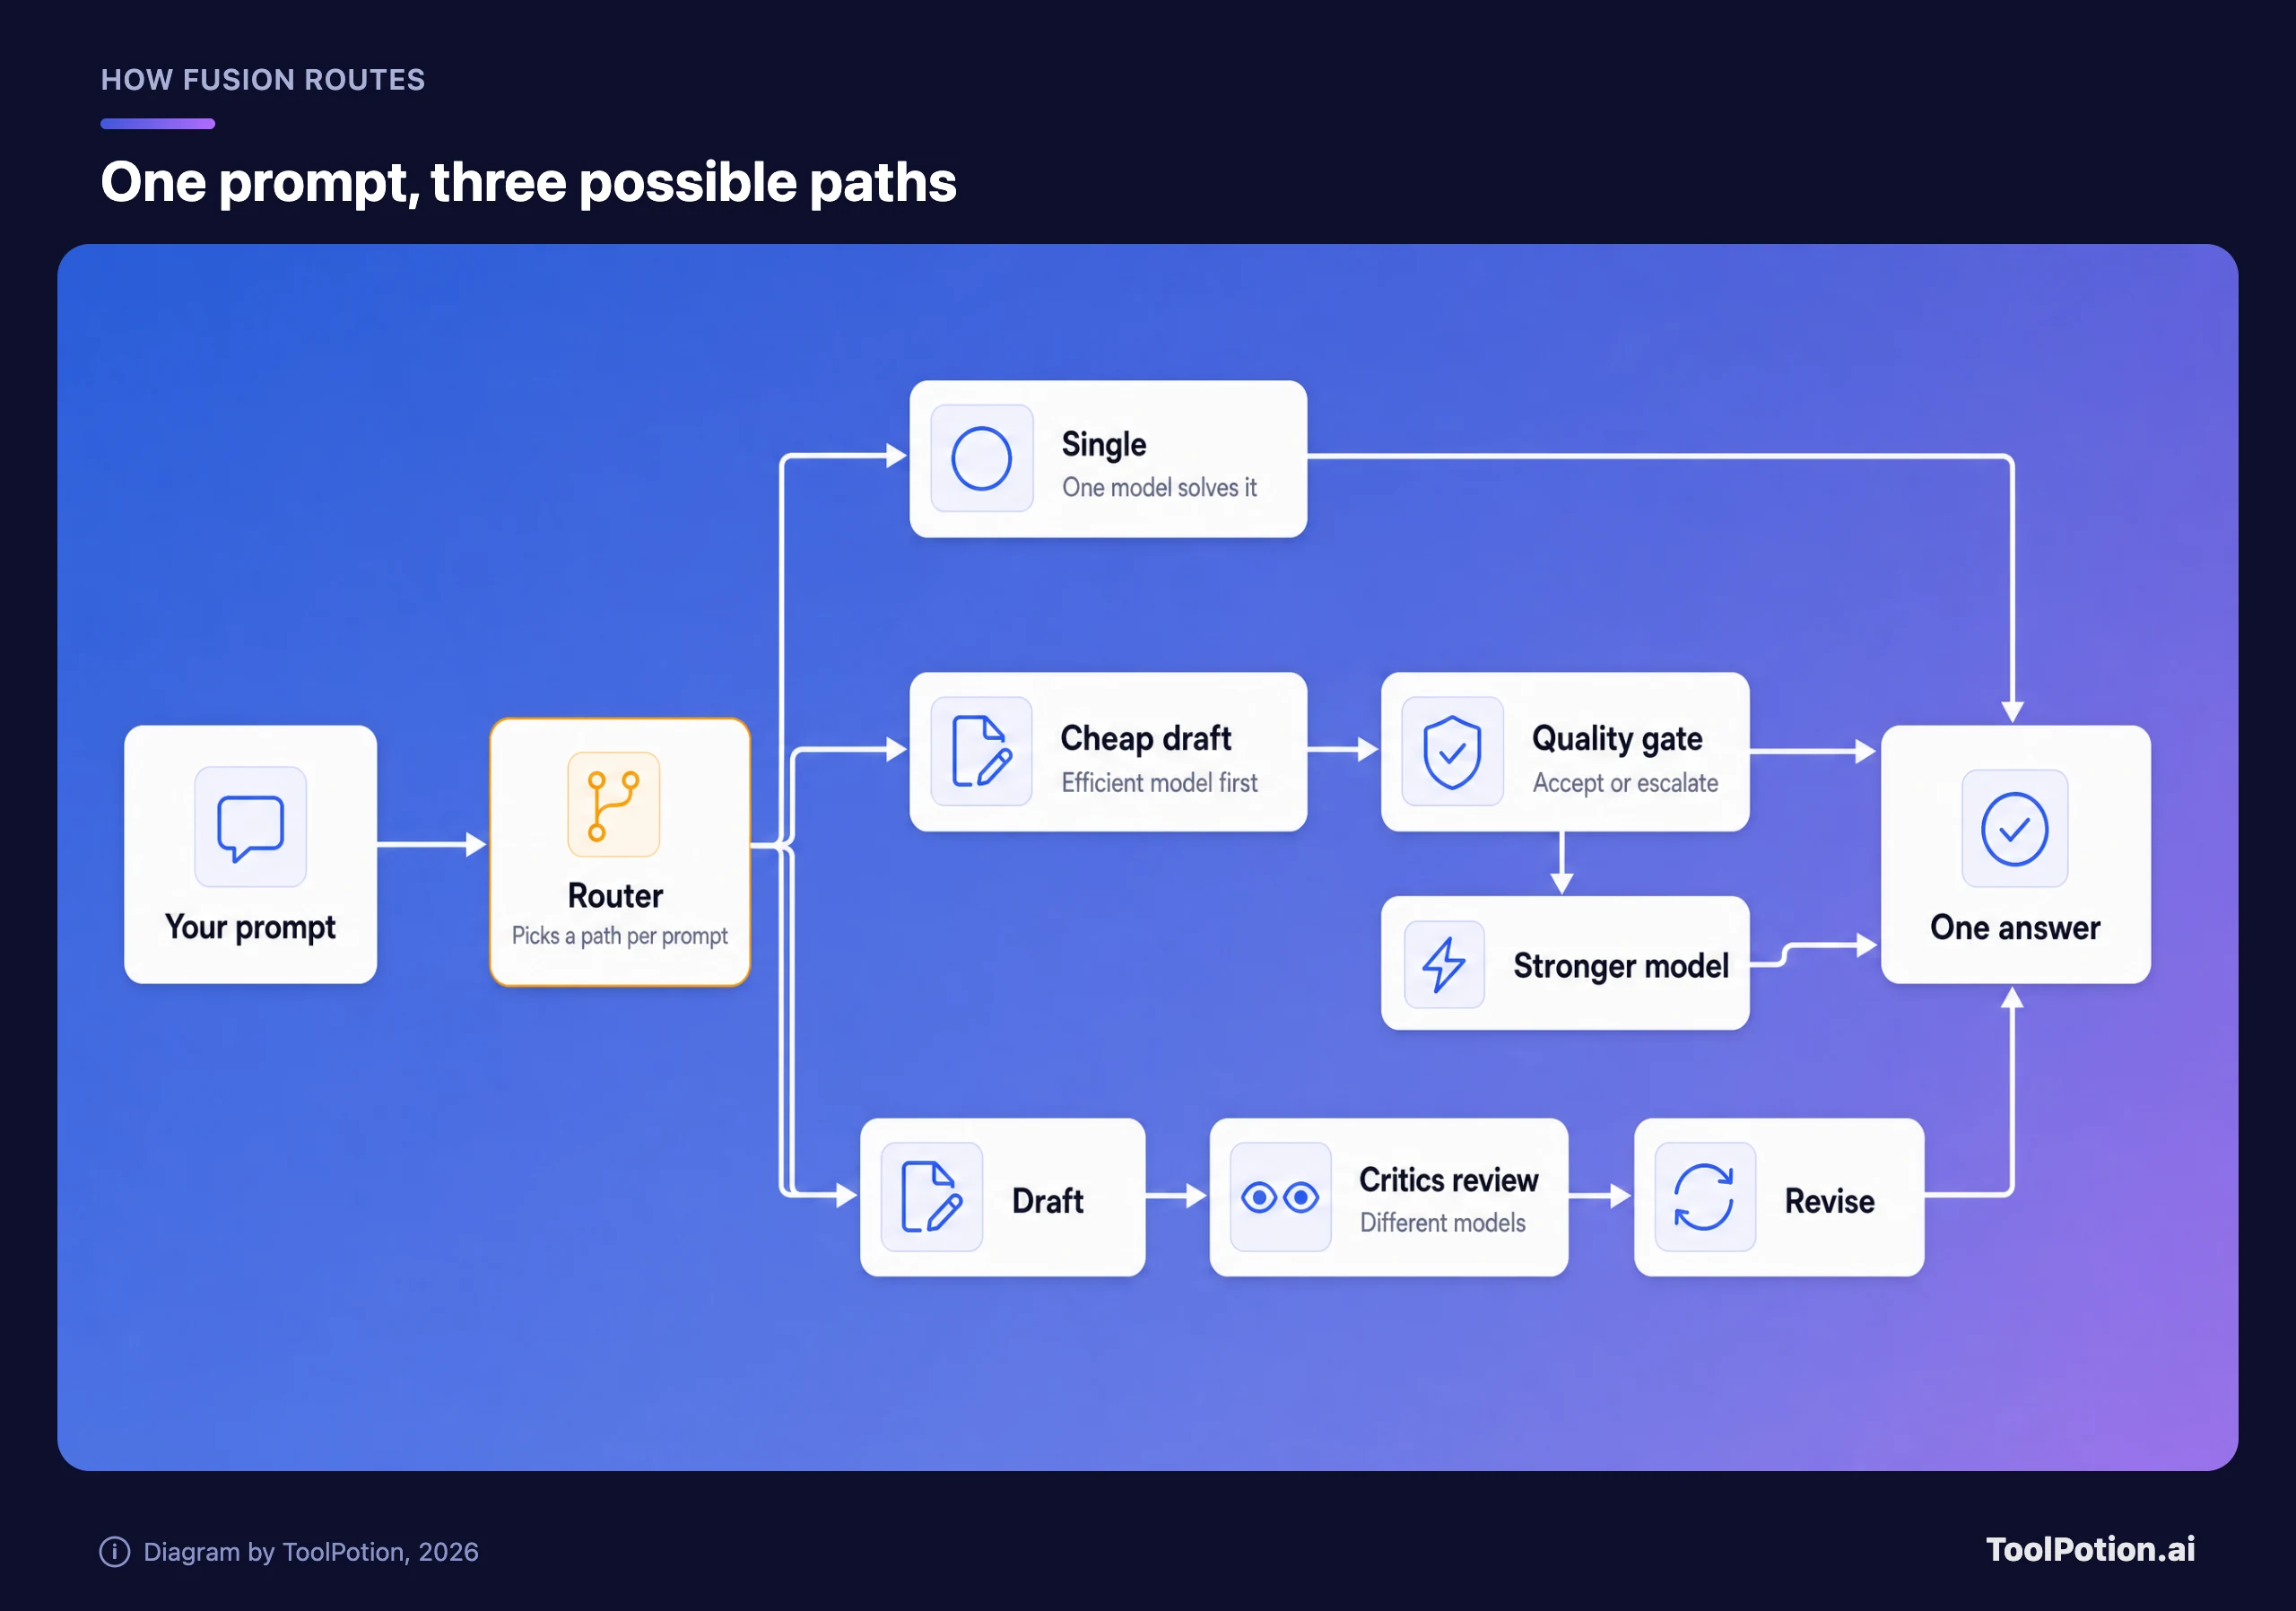
Singleは、1つのモデルが直接回答するパターンです。Cascadeでは、効率の良いモデルが下書きを作り、判定役がそれを採用するか、上位モデルにエスカレーションするかを判断します。Critiqueでは、1つのモデルが下書きを書いている間に他のモデルがレビューし、下書き担当が修正します。エフォートレベルはルーティングの積極度を決めるもので、日常的な作業にはStandard、重めのタスクにはHigh、最も難しい推論にはMaxを使います。
プレビューから正式版にかけて、1つ変わった点があります。GitHubの以前のリサーチプレビュー記事では、「別のモデルファミリーによる、独立した読み取り専用の批評役」と説明されていました(GitHub blog)。正式版のchangelogは「別のモデルがレビューする」と書き、ドキュメントは複数のモデルが並列で批評してそのフィードバックを集約するとしています。批評のステップがレビュアー1人から複数に増えたというのが私たちの読みですが、GitHubはそうとは述べておらず、changelogも違いを明示していません。
全プランで使えて、課金はモデルごと
changelogによると、FusionはVS Code、Copilotアプリ、Copilot CLI、JetBrains IDEのすべてのCopilotプランで利用でき、対応クライアントは今後増える予定です。課金は、使用した各モデルをそのモデルの通常料金で計算する方式で、Fusion専用の料金はありません。有料プランでは期間限定でモデルコストが30%割引になり、ドキュメントでは割引の終了は今年後半とされています(docs)。
気になる点が2つあります。Fusionのドキュメントには「すべてのGitHub Copilotプランで利用可能」とあります。一方、プランのページには、FreeとStudentではモデルへのアクセスはオートモデル選択のみとあります。GitHubはこの2つの食い違いを説明していません。ドキュメントにあるプラン別のエフォートレベル表は、対応状況をアイコンで示していますが、私たちが確認した時点では空白のセルとして表示されました。そのため、FreeとStudentのシートでどのレベルが使えるのかはわかりません。ご自身のピッカーで確認してください。また、HighとMaxは複数のモデルを呼び出す可能性があるため、Standardより多くのAIクレジットを消費することがあると、ドキュメント自身が注意しています。タスクあたりのコストが半分というのは、MaxとClaude Codeを比べた場合の話であり、クレジット残高について約束するものではありません。
ベンチマークはGitHubによるGitHubの採点
以前のHydraFusionの記事は、正式版の発表よりも率直です。テストはすべてのモデルで同じmediumの推論レベルで実施され、コストは共通の料金前提に基づく推定値で、比較対象はOpus 5とGPT-5.6 Solでした。さらにGitHubは、報告した3つのベンチマークと同じものを使い、ビームサーチでルーティングポリシーをチューニングしたとも述べています(GitHub blog)。
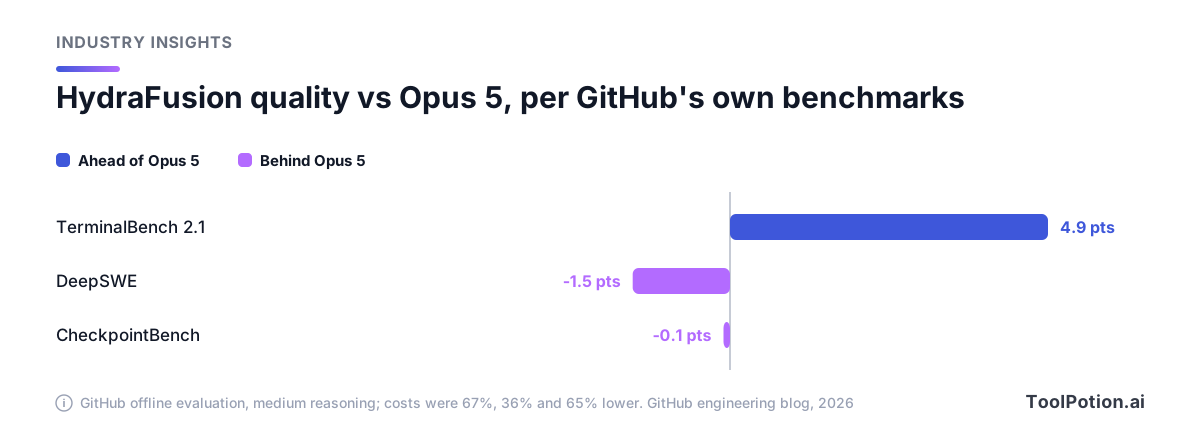
結果の形に注目してください。1つのベンチマークでは4.9ポイント向上しています。残り2つはわずかに下がり、コストは36%から67%低くなっています。品質をほぼ横ばいに保ったままコストを下げる話であり、これは正式版の宣伝文句が最終的に言っている内容とも一致します。
Hacker Newsの開発者たちは、比較対象に疑問を向けました。あるコメントは「Opus 5は(実際には)比較対象として適切ではない」と書いています(HN)。別のコメントは結果自体を疑い、「モデルとハーネスの間に余分なソフトウェアを挟めば、個別のベンチマークでフロンティアモデルを上回るのは難しくない」と述べました(HN)。同じスレッドでCopilot CLIを使っている人は、オートモードは「セッション開始時かコンパクション後にしかモデルを切り替えない」と書き(HN)、別の人はオート選択を自分にとっては「ほぼ使い物にならない」と評しています(HN)。いずれも個人のコメントであり、調査ではありません。ただ、懐疑的な声がどこにあるかはよくわかります。
課金体系のずれにも注意が必要です。指標とGitHubの比較は、トークン従量課金のAPIコストを使っています。Claude Codeを定額のサブスクリプションで使っている開発者には、その数字は見えません。そのため「コスト半分」は、APIの支出を計測しているチームと個人利用者とでは受け取られ方が違います。Artificial Analysis自身も、多くのユーザーはこれらのツールを従量課金ではなくサブスクリプションで利用していると注記しています。この結論はGitHubの主張ではなく私たちの推測ですが、見出しが誰に向けたものなのかが変わってきます。
GitHubが挙げている顧客の声は、AT&TのHari Pokhrel氏のものだけで、GitHub自身のchangelogに引用されています。「これまで開発者は、複雑なタスクではより強力なモデルを選び、日常の作業では切り替えるのを忘れがちでした」。これがFusionの正直な存在意義でしょう。日常的な作業で高価なモデルを使いっぱなしにしてしまうのを防いでくれます。
誰があなたの差分を読むかはポリシーで決まる
ベンチマークより先に読んでおきたいのがこの部分です。Fusionは、エンタープライズや組織のポリシーで有効になっているモデルしか使いません。管理者は、他の場所では無効にせずに、Fusionでのみ特定のモデルを無効にできます。データレジデンシーやFedRAMPのポリシーで除外されるモデルも、対象から外れます(docs)。
別のモデルによるレビューが設計上の賭けであり、プレビュー記事ではそのレビュアーは別のモデルファミリーから来るとされていました。それが別のベンダーを意味するなら、そのベンダーのモデルがあなたの差分を見ることになります。これはデータの取り扱いに関する判断なので、チームの誰かが意図的に決めるべきです。回答のあとでエフォートのラベルにカーソルを合わせると、どのモデルが動いたかを確認できます。
制限事項のセクションも重要です。Fusionが下書きを破棄しても、その下書きがすでに行ったファイル編集は自動では元に戻りません。コミットの前に差分を確認してください。また、Fusion自体にはコンテキストウィンドウがなく、表示される値は組み込まれたモデルの中で最小のものです。
チームでのトライアルならどこに置くか
Copilotを使うチームなら、デフォルトはFusion Standardにして、Maxはデフォルトにしません。独立した指標での60点は立派ですが、Maxは最も多くのモデルを呼び出し、最も多くのクレジットを使うレベルです。AT&Tの事例が当てはまるのはStandardで、ルーティングによる節約が最も大きいのもStandardです。すでにClaude CodeやCodexを使っているチームでは、ロックインの問題は逆向きになります。これらのツールは1社のモデルに縛られていますが、Fusionは GitHubが管理するルーターで、GitHubの判断で組み替えられます。どちらも依存関係から自由ではありません。
ツールそのものの比較は、これまでの記事で扱っています。ターミナル型コーディングエージェント、CursorとCopilot、Windsurfの比較、タスクに合わせたモデルティアの選び方、そしてより幅広いコーディングツール一覧です。Fusionが変えるのはそれらのコスト欄であって、選ぶべきツールではありません。Cursorユーザー向けの同等の評価はまだありません。現在の勢力図はToolRankのコーディングアシスタントボードで確認できます。
決着をつけるテストは安上がりです。実際のチケットを10件選び、Fusion Standardと現在の環境で処理して、採用された変更の数と消費したクレジットを数えてください。GitHubの割引は今年後半に終わるので、それまでに測っておきましょう。そのあとArtificial AnalysisのRouter modelsビューをもう一度確認してください。動く可能性が高いのは、そこにあるルーターの項目です。