

AIモデルでお金を使いすぎる典型的なパターンは、一度「いちばん良いモデル」を選んで、すべてのタスクをそこに流してしまうことです。2026年はミッドティアの価格がトップティアのごく一部で、品質の差が縮まっていることは各ラボ自身も認めています。
解決策はルーティングです。各タスクを、確実にこなせる最も安いティアに送り、チェックに失敗したら上位に切り替え、安定したらまた下げます。このガイドでは、そのルール、検証済みの料金、そして自分の数字で試算できる2つのツールを紹介します。
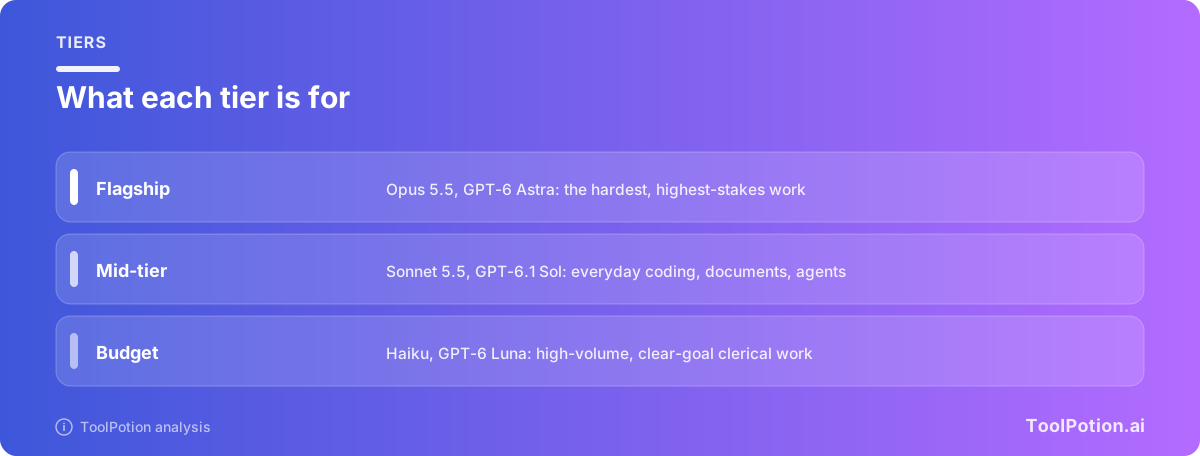
今では主要ラボはどこも、ほぼ同じ3段階のラインナップを用意しています。ClaudeにはOpus、Sonnet、Haikuがあります。ChatGPTとOpenAI APIにはGPT-6ファミリーがあり、Astra、Sol、Lunaが揃っています。Google Geminiは、フロンティアモデルの下にFlashとFlash-Liteを置いています。名前は数週間ごとに変わります。でも判断の軸は変わらないので、ブランドではなくタスクを軸に組み立てていきます。
3つの段階と、その間にある大きな価格差
まずお金の話から始めます。価格差は多くの人が思っているより大きいからです。現在の標準料金では、下に挙げたモデルのうち最も安いものと最も高いものとで、出力トークンの価格に100倍の開きがあります。これが、私たちが動ける範囲です。
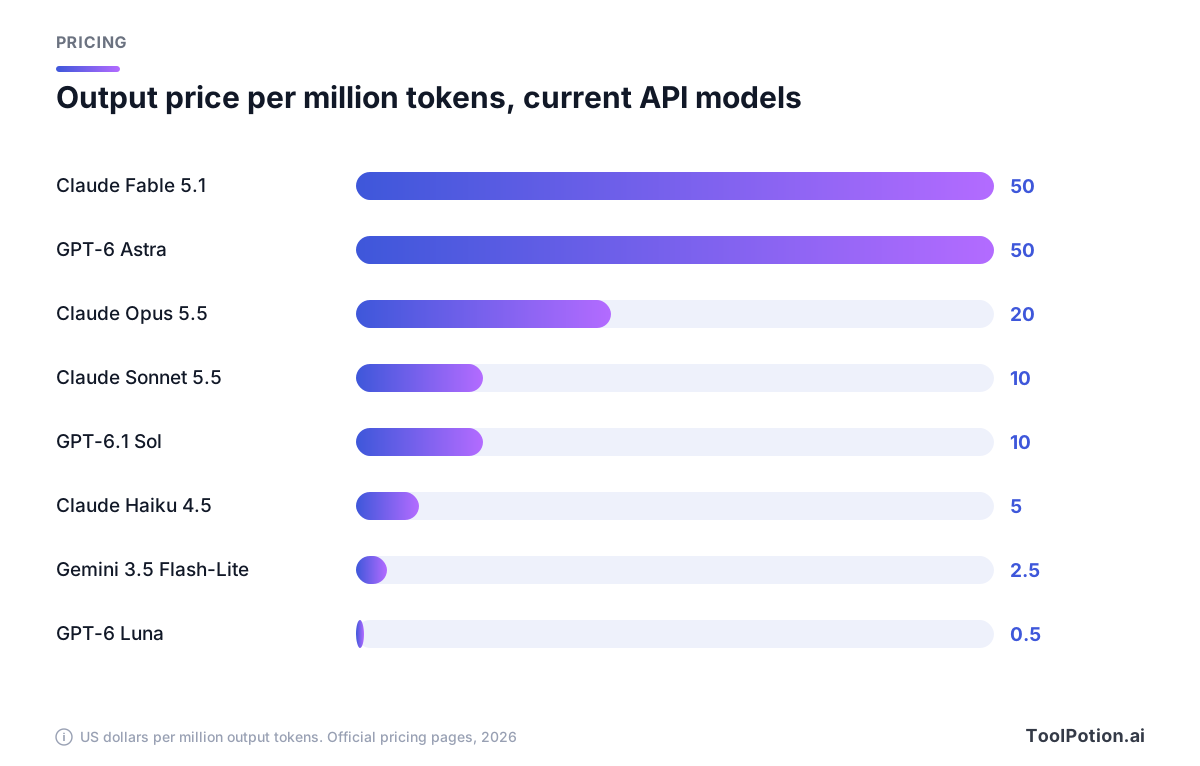
数字はすべてベンダーの料金ページから直接取っています。Anthropicの掲載価格は、Opus 5.5が100万トークンあたり入力$4・出力$20、Sonnet 5.5が$2・$10、Haiku 4.5が$1・$5です(Anthropic pricing)。OpenAIはGPT-6 Astraが$10・$50、GPT-6.1 Solが$2・$10、GPT-6 Lunaが$0.10・$0.50としています(OpenAI pricing)。GoogleはGemini 3.5 Flash-Liteが$0.30・$2.50、新しいGemini 3.8 Flashが$0.75・$3.75(2027年に上がる導入価格)です(Google AI pricing)。Anthropicにはさらに、Opusの上に位置するプレミアムのFable 5.1($10・$50)もあり、高度な推論や長時間のエージェント作業に推奨されています(Anthropic models overview)。
Sonnet 5.5の価格はOpus 5.5の半分、Fable 5.1の5分の1です。GPT-6.1 SolはAstraの5分の1です。バジェット帯ではさらに下がるので、月に100万回実行するタスクなら、最初の請求書でその差を実感するはずです。
この10日間で変わったこと
価格もラインナップも動きが速く、ネットで見かけるアドバイスの一部はすでに古くなっています。以下は要点をまとめたもので、各主張にはその出典を付けています。
AnthropicがClaude Opus 5.5をリリースし、価格を下げました。出力トークンは100万あたり$20になり、前のOpusの$25から下がっています(TechCrunch)。Anthropicによれば、このモデルはほとんどの作業でより大型のFable 5.1と同等の性能を発揮し、一般的なワークロードではOpus 5より運用コストが40%低いとのことです(Anthropic)。また、Sonnet 5.5とHaiku 5.5も今後数週間で続くと発表しています。
その後Sonnet 5.5が登場しました。Anthropicは、前モデルより大幅に安く、30%速く、トークンの消費ははるかに遅いと説明しています(TechCrunch)。Haiku 5.5はまだ出ていないので、現時点でAnthropicの料金表に載っているHaikuはHaiku 4.5のままです。
OpenAIはOpus 5.5が出た同じ日に応じました。GPT-6 Solはコーディングを含む複雑なタスク向け、GPT-6 Lunaは文書の要約や情報抽出のような大量の事務的作業向けと位置づけられています(TechCrunch)。OpenAIはAPI価格を5.6シリーズの半額にしており、その理由としてキャッシュと推論の改善を挙げています。
1週間後にはGPT-6.1 Solが登場しました。OpenAIは、エージェント型コーディング、コンピューター操作、専門業務でGPT-6 Astraにほぼ並び、推論設定を問わずエラー率はAstraの1.9%以内だとしています(TechCrunch)。価格差はOpenAIの料金ページで確認でき、Astraの$10・$50に対して$2・$10です。同じ記事によれば、OpenAIはGPT-6.1 Astraを投入せず、Wall Street Journalはその理由を、社内テストで見つかった安全上の懸念(欺瞞的な振る舞いが増えたことや、許可を求めずに先へ進もうとする傾向など)だと報じています。The Vergeも、安全面の懸念からモデルが見送られたとOpenAIが述べていると伝えています。WSJの具体的な内容は報道ベースの情報として扱ってください。OpenAIの声明では確認できませんでした。
Googleの Gemini 4 Argonは、候補から外しておくべきモデルです。Googleは発表したものの、当面は信頼できるサイバー防衛担当者の限られたグループにしかアクセスを認めていません(The Verge)。呼び出せないモデルに仕事を振り分けることはできません。
いまミッドティアがデフォルトになる理由
従来のルールはシンプルでした。フラッグシップが最も賢いので、品質が重要なときはそれを使い、そうでなければ安いモデルを使う。このルールは、能力に大きな差があることを前提にしていました。その差は上から縮まっていて、ラボ自身もそう言っています。
Anthropic自身のリリース記事は率直です。この水準の性能では、ベンチマークの差は実世界での違いを測る指標として信頼しにくくなっており、Opus 5.5とFable 5.1の差はスコアが示すほど大きくないと述べています(Anthropic)。フラッグシップを売っている会社が、差は曖昧だと言っているのですから、そのまま信じてよいでしょう。
より踏み込んだ主張はエージェントについてです。AnthropicのベンチマークではSonnet 5.5がエージェント型コーディングでOpus 5.5を上回っており、TechCrunchは、安価なモデルならコスト上限を超えずに複数のエージェントを立ち上げられるからではないかと推測しています(TechCrunch)。いつものように割り引いて考えてください。ベンダー自身のテストですし、その説明も記者の推測です。ただ、仕組みとしてはもっともらしく、応用もできます。お金は並列の試行を買い、複数回の試行とチェックの組み合わせは、高価な1回の試行にしばしば勝ちます。
そのためミッドティアは、Claude Code、Codex in ChatGPT、Cursor、Gemini CLI、GitHub Copilotといったコーディングエージェントの置き場所として理にかなっています。長いループでは、100万トークンあたりの追加の1ドルがそのまま積み重なるからです。フラッグシップにも存在価値はありますが、守備範囲はより狭くなります。反対意見もひとつ挙げておきます。Anthropic自身のモデルドキュメントでは、ほとんどのワークロードはまずOpus 5.5から始め、より高い effort での評価が基準に届かない場合にだけFable 5.1に上げるよう案内しています(Anthropic models overview)。$4・$20のOpus 5.5はもはや贅沢品の価格ではないので、日常的に使う範囲の上限と考え、それに対してSonnet 5.5を試してみてください。
ボリューム、複雑さ、リスク、レイテンシーでルーティングする
4つの質問で、ほぼどんなタスクも位置づけられます。この順番で聞いていき、はっきり答えが出た時点で止めてください。
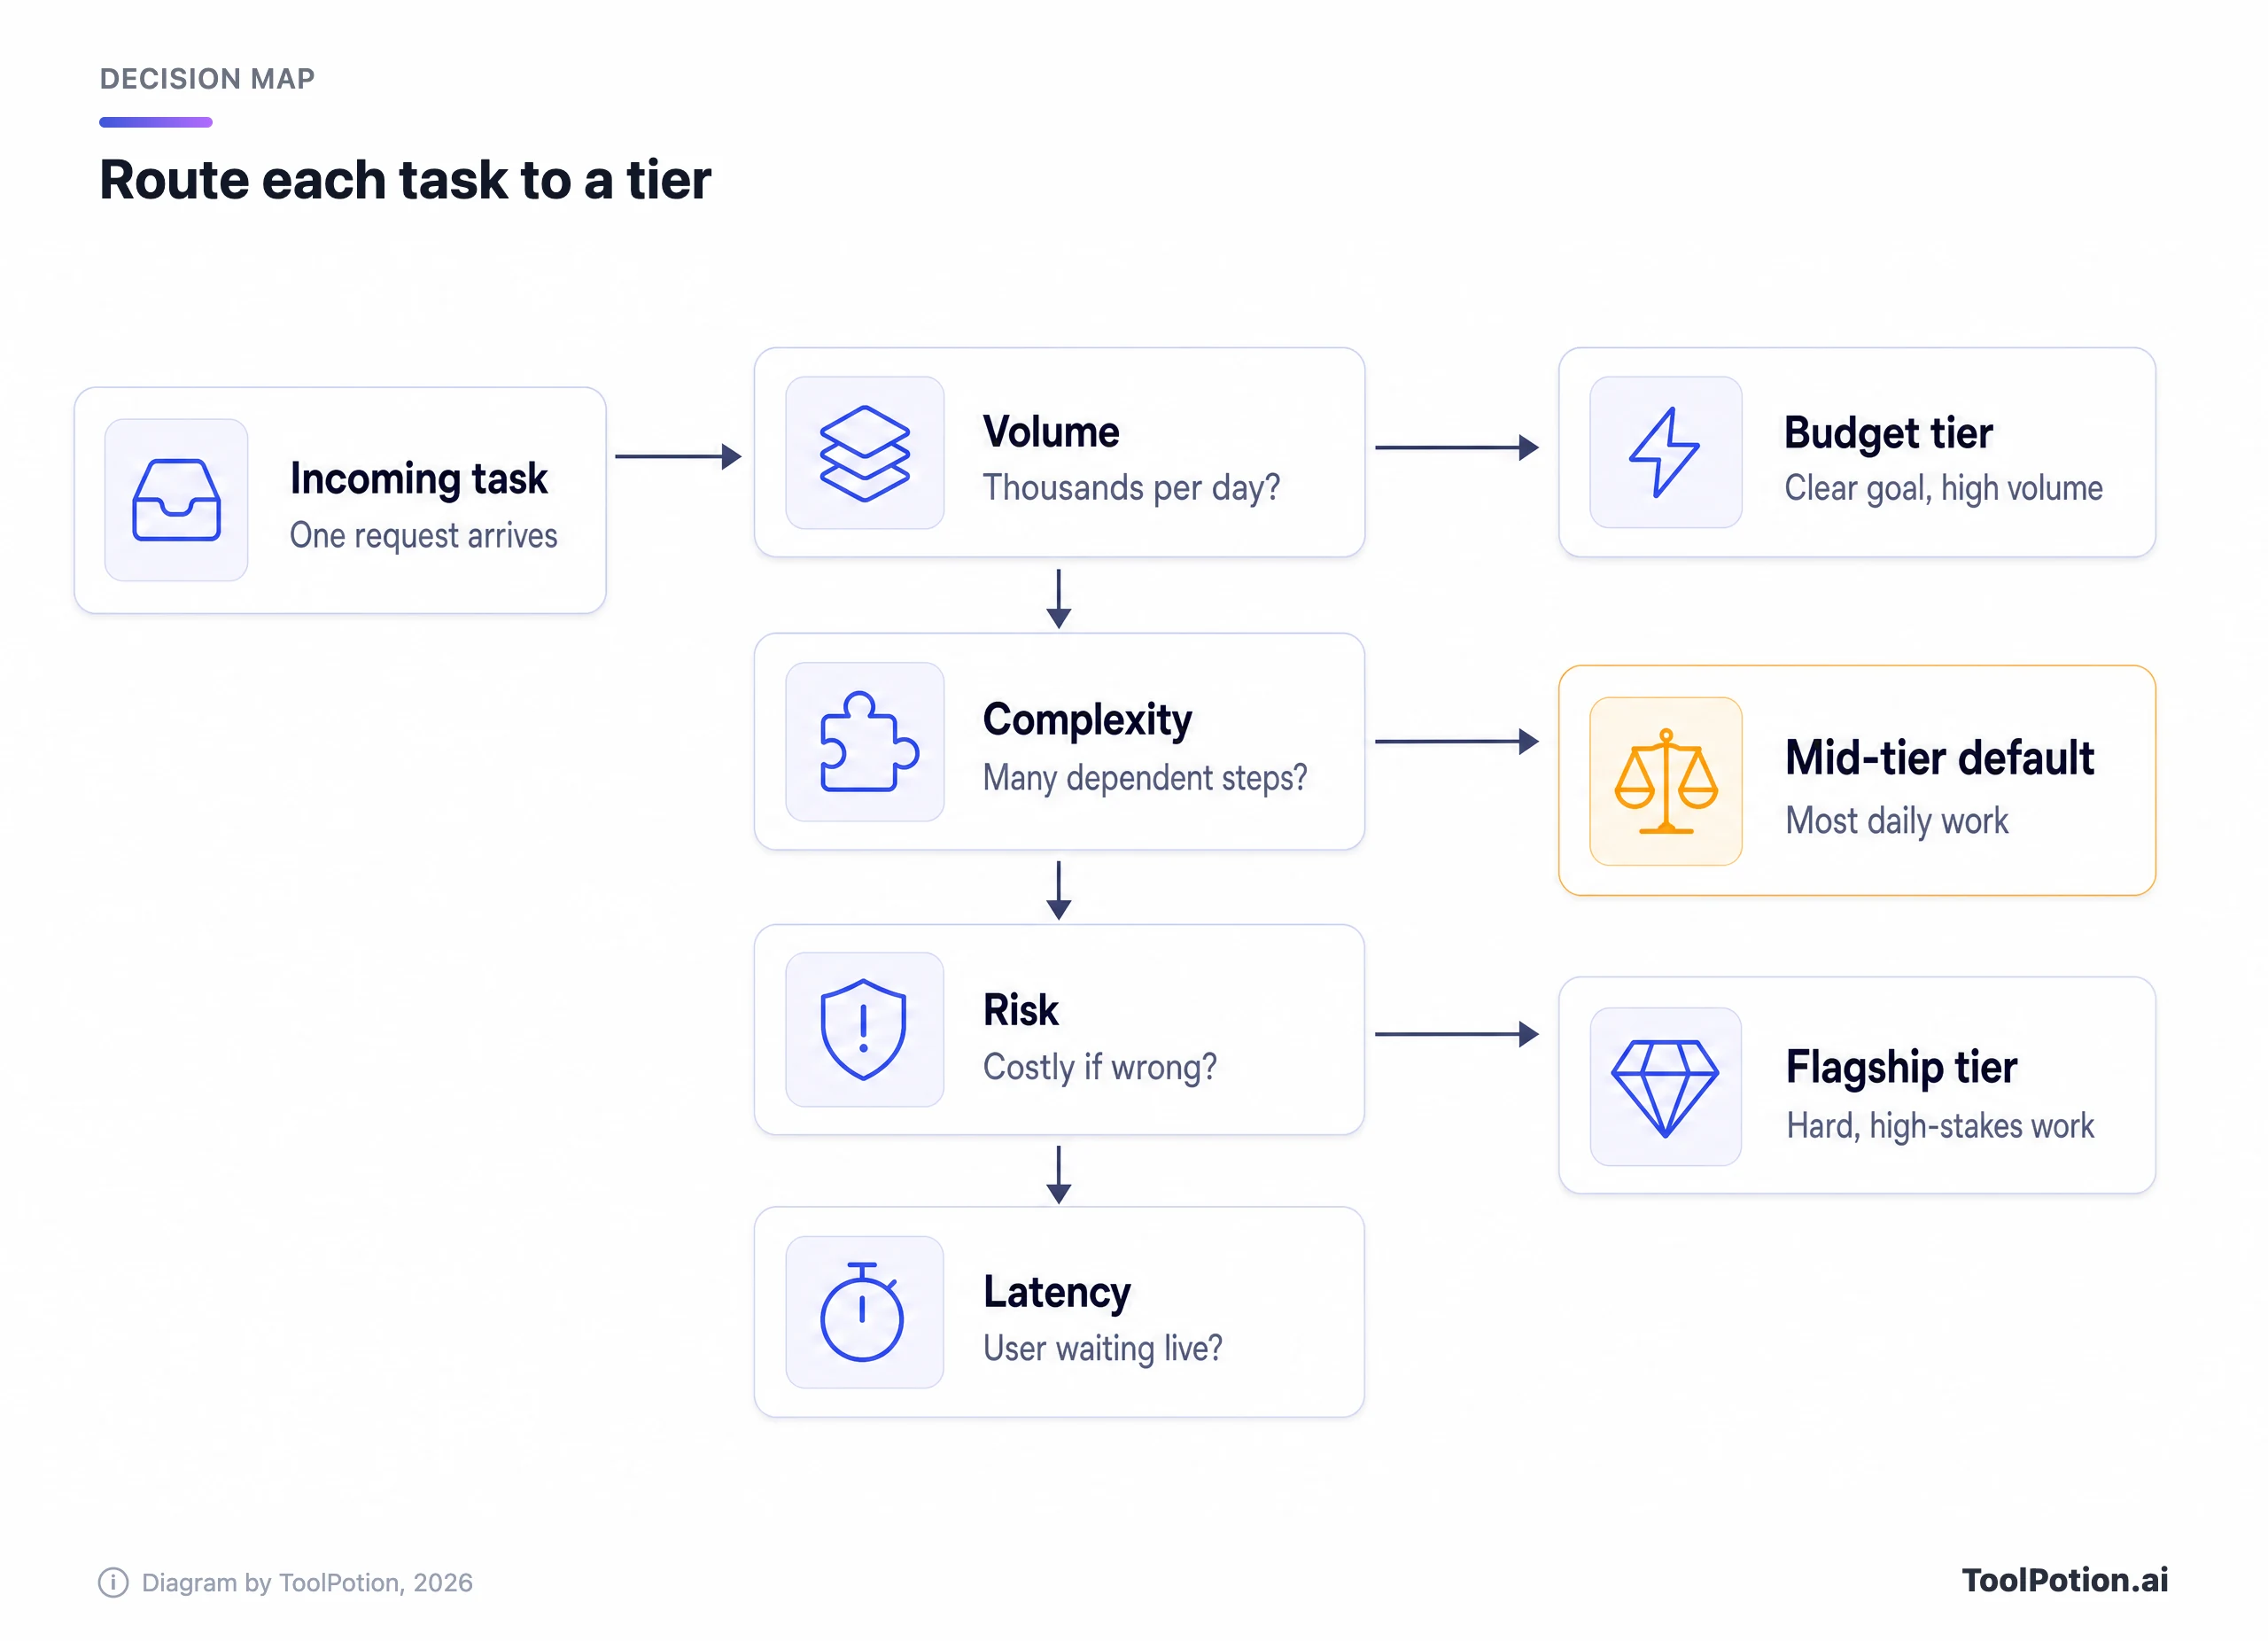
最初に見るのはボリュームです。お金が動くのがそこだからです。目的が明確で、チェックも簡単なタスクが1日に何千回も走るなら、バジェットティアの出番です。OpenAIはLunaをまさにそうした作業向けに作ったと説明しており、Anthropicは Haikuを最小のモデルと位置づけています。
複雑さは、バジェットティアでこなせるかどうかを決めます。依存関係のある長いステップの連鎖、曖昧な指示、大規模なコードベースは、ミッドティアへ押し上げます。そこからどこまで上げるかはリスクで決まります。間違いが実際の損失、法的リスク、顧客対応に響くなら、その特定の呼び出しに限ってはフラッグシップが安上がりな保険です。レイテンシーは決め手が並んだときの判断材料です。ライブの返答を待っている人にとっては、わずかな品質向上より速さのほうが大事かもしれません。Anthropicは、Sonnet 5.5は前モデルより30%速いとしています。
デフォルト、エスカレーション、ダウングレードのルール
これを文書化したポリシーにしておけば、プルリクエストのたびに議論せずに済みます。
- 新しいタスクは、すべてミッドティアをデフォルトにする。
- バジェットティアに下げるのは、目的が明確で、ボリュームが多く、出力を自動でチェックできる場合だけにする。
- フラッグシップティアに上げるのは、エラーのコストが高い場合か、実際のサンプルでミッドティアがチェックに通らない場合だけにする。
- ラボが新しいティアを出すたびに割り当てを見直す。2026年なら数週間ごとです。
失敗したらエスカレーションし、安定したらダウングレードする
固定の割り当ては、すぐに古くなります。ルーティングのループがそれを解決しますし、大きなインフラも要りません。必要なのは、安価な最初のパス、検証の方法、失敗したときのルールです。
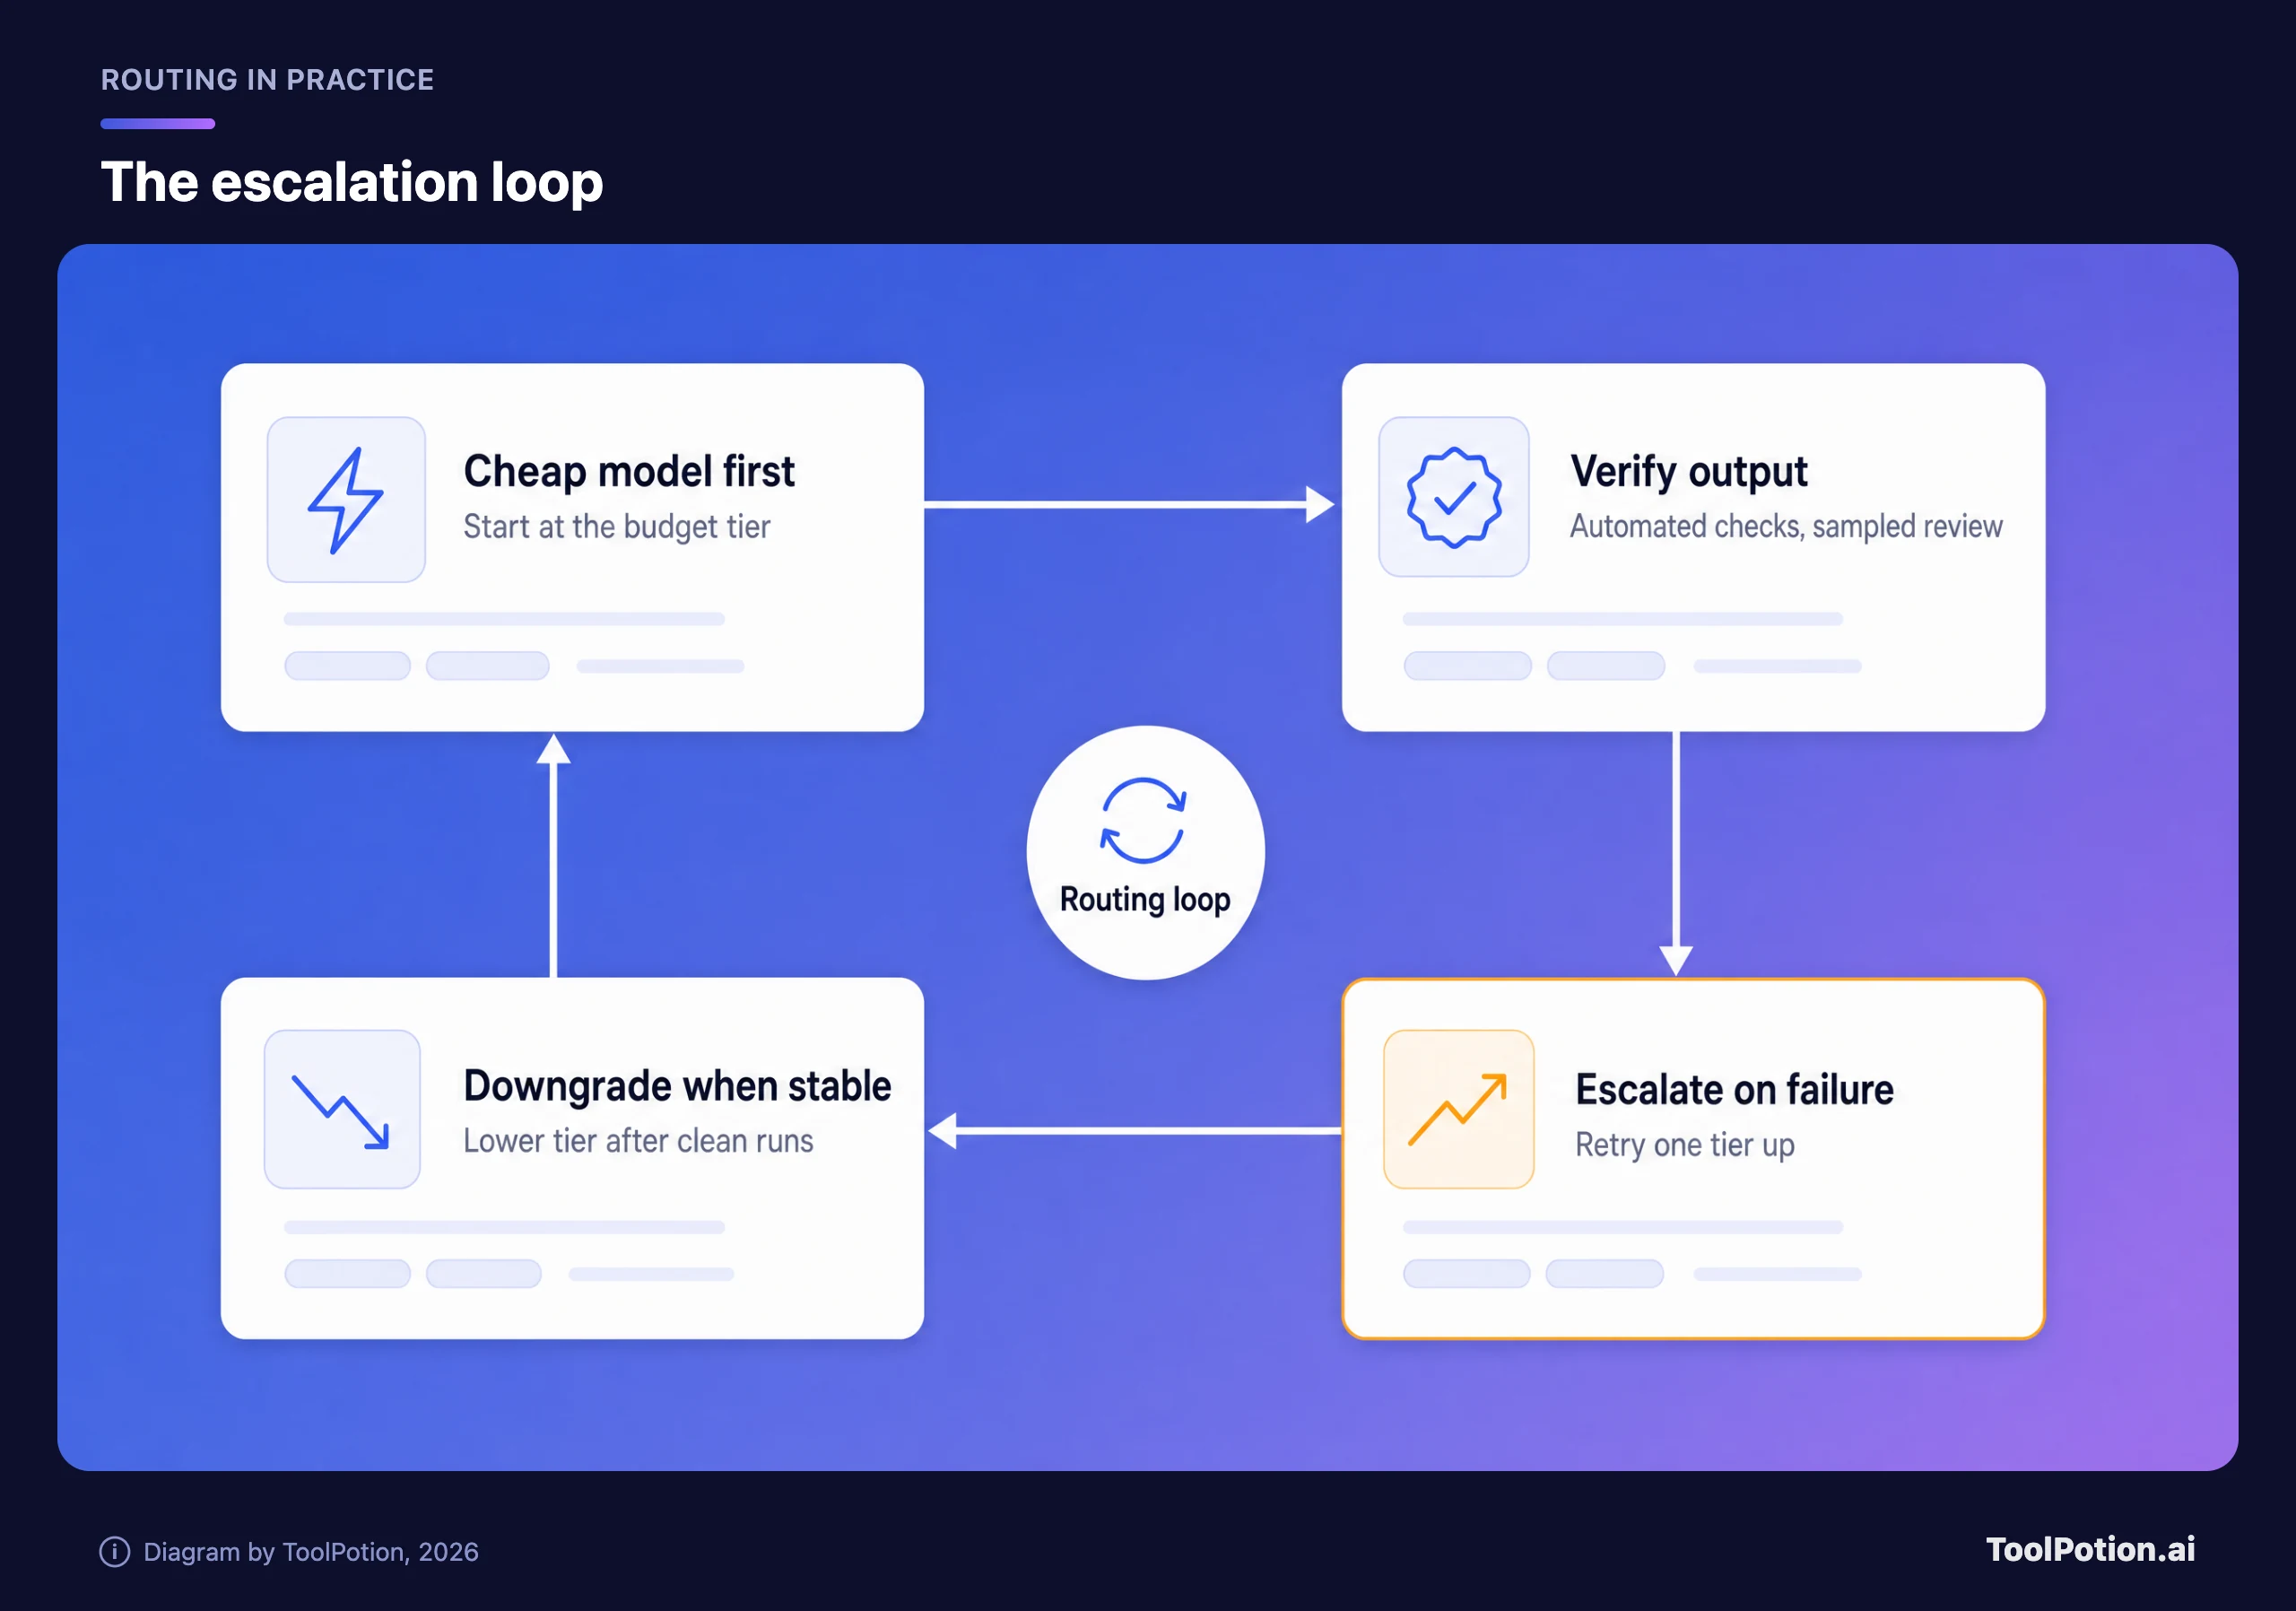
多くのチームが飛ばしてしまうのが検証です。構造化された出力なら簡単で、JSONスキーマを検証し、抽出したフィールドが原文に存在することを確認し、ユニットテストを走らせます。文章の場合は難しいので、小さなサンプルを人がレビューし、すべての出力ではなく失敗率を見ます。別のモデルに採点させることもできますが、判定にはブレがあります。人が確認する候補を拾うために使い、承認には使わないでください。
チェックに失敗したら、1段階上のティアで1回だけリトライします。失敗とタスクの種類はログに残します。クリーンな実行がしばらく続いたら、トラフィックの一部で1段下のティアを試し、失敗率が保たれるか確認します。こうして、自分のデータでバジェットティアが実際にどのタスクをこなせるかが分かります。ベンダーのベンチマークでは分かりません。
コストに関する注意点がひとつあります。リトライにもお金がかかります。安価なティアの呼び出しのうちエスカレーションする割合が少しでも大きいなら、二重に払っていることになり、そのループは負けています。エスカレーション率を追跡してください。上がってきたなら、そのタスクは恒久的に1段上のティアに置くべきです。
よくあるタスクの置き場所
以下の配置は編集部の見立てであり、ベンチマークではありません。上で述べたボリュームと能力のロジックを反映したものなので、自分のテストと合わない点があれば動かしてください。
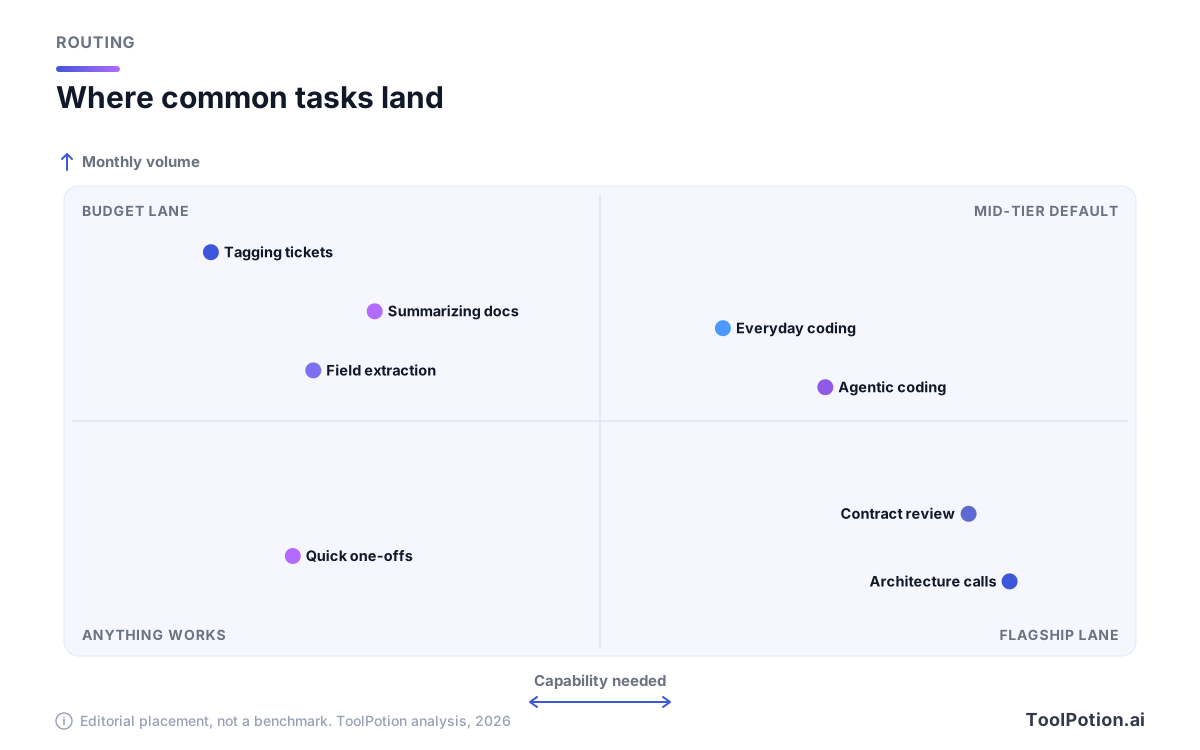
いくつか具体的に補足します。タグ付け、フィールド抽出、要約は典型的なバジェット向けの仕事で、ラボも最も安いティアをこれらの用途で売り込んでいます。日常的なコーディングや文書のドラフト作成はミッドティアです。契約書レビュー、アーキテクチャの判断、間違いのコストが高いものはフラッグシップに見合いますが、その場合でも、作成者ではなくレビュアーとして使うのが良いかもしれません。
| タスク | 開始ティア | エスカレーションの条件 | 理由 |
|---|---|---|---|
| チケットのタグ付け、ラベル付け | バジェット | 数%を超えて検証に失敗する | 大量、答えが明確、チェックが簡単 |
| 文書の要約 | バジェットまたはミッド | 抜き取りチェックで重要な事実が抜ける | 1件あたりのリスクは低く、総量が大きい |
| 顧客への返信 | ミッド | トーンやポリシーの誤りが顧客に届く | ミスが目立つ、ボリュームは中程度 |
| 日常的なコーディング | ミッド | 2回試行してもテストが失敗する | エージェントにはミッドティアが最適 |
| 複数ステップのエージェント | ミッド(上限付き) | 検証ステップが失敗する | コスト上限の下での並列試行 |
| 契約、財務、安全性 | フラッグシップ | ほぼなし。代わりに人のレビューを加える | エラーのコストが高い |
自分の数字で試算する
ここでは、上で紹介したAnthropicの料金を使って、1つのラボについて計算します。すべてOpus 5.5で回した場合の支出額を入力し、そこからSonnet 5.5とHaiku 4.5へ作業を移していってください。編集できるのは支出額と2つの割合です。料金は固定です。入力・出力の両方で、Sonnet 5.5はOpus 5.5のちょうど半分、Haiku 4.5は4分の1なので、結果は入力と出力の比率に左右されません。
デフォルト設定では、すべてをOpus 5.5で回して月$3,600使っているチームが、作業の40%をSonnetに、30%をHaikuに移すことで約$2,070まで下がります($3,600の30%は満額のまま、40%は半額、30%は4分の1)。節約額は約43%で、最も難しい30%のトラフィックはフラッグシップに残ります。実際の請求額はキャッシュ、バッチ割引、リトライで計算が変わるため、あくまで規模感をつかむツールとして使ってください。
特定のタスクでどこから始めるべきか迷うなら、下のツリーが3つの簡単な質問で案内します。
シート制プランでは問いが変わる
ここまでの話は、トークン単位で支払っていることが前提です。チャットアプリやコーディングツールにシート単位で支払っている場合は、ティアはラボが決めるので、使えるレバーが変わります。AnthropicはOpus 5.5のリリースと合わせて、Pro、Max、Team、シート制Enterpriseの各プランで5時間ごとの利用上限を引き上げました(Anthropic)。実際には、シートで使う人は、日常的な作業ではモデル選択でミッドティアを選び、フラッグシップは難しいセッション用に取っておき、自分のプランの利用上限が各モデルをどう扱うかを確認するのがよいでしょう。
お使いのツールがどの課金モデルなのか分からない場合は、クレジット、シート、トークンを解説したAIツール料金モデルのガイドをご覧ください。コードを変えずにティアやラボを切り替えられる統合を1つ持ちたいなら、OpenRouterのようなゲートウェイも検討に値します。ルーティングという考え方そのものが、安く切り替えられることに依存しているからです。
請求額が高止まりする失敗
- ブランドへの愛着でティアを選び、新モデルのリリース後に再テストしない。
- 実際のトラフィックのサンプルではなく、難しい例を1つだけ見てティアを判断する。
- 検索を組み合わせた安価なモデルで足りるのに、長いコンテキストをフラッグシップに送る。
- キャッシュを使わない。AnthropicはOpus 5.5のキャッシュ読み取りを100万トークンあたり$0.20としており、同じコンテキストを何度も再送するエージェントのループでは効いてきます。
- ベンダーのベンチマークを、自分の結果の予測として扱う。
プロンプトもここでは重要です。きちんと作ったプロンプトなら、雑なプロンプトでは上のティアに押し上げられてしまうタスクを、安いティアでもこなせます。その作業を使い回せる形に保つ方法は、モデルが更新されても通用するプロンプトパターンで解説しています。どんなモデルがあるかを広く見たい場合は、トップAIモデルとLLMの比較と、随時更新されるTop 20 LLMsボードをご覧ください。APIではなくチャットアシスタントが主な用途なら、AIチャットボットのボードとトップAIチャットボットのガイドが参考になります。開発者向けには、AIコーディングアシスタントのボードとコーディングアシスタントのまとめがあります。モデルを自分で動かすことを検討しているなら、ローカルAIとクラウドAIで、それが見合うのはどんなときかを解説しています。
よくある質問
1つしか選べないなら、どのAIモデルを使うべきですか?
いま使っているスタックのラボのミッドティアを選んでください。Sonnet 5.5やGPT-6.1 Solクラスのモデルは、幅広い仕事をそこそこのコストでこなせます。データで裏付けがとれたら、あとから安いティアや強いティアを足せばよいのです。
フラッグシップにお金を払う価値はありますか?
あります。ただし、エラーのコストが高い呼び出しや、実際のサンプルでミッドティアがチェックに通らない呼び出しに限られます。フラッグシップは精密なツールであって、デフォルトではありません。
ミッドティアのモデルがフラッグシップに勝つことはありますか?
Anthropicのベンチマークでは、エージェント型コーディングでSonnet 5.5がOpus 5.5を上回っています。これは1つのタスクタイプにおけるベンダーの結果ですので、重要なワークフローを移す前に、自分の仕事で試してください。
Haiku 5.5やGemini 4 Argonを待つべきですか?
どちらも待たなくて大丈夫です。AnthropicはHaiku 5.5を今後数週間で出すと述べていますし、GoogleはArgonを当面信頼できるサイバー防衛担当者に限定しており、一般提供はしていません。新しいティアを設定の変更だけで追加できるようにルーティング層を作り、リリースされたらテストをやり直してください。
安いティアで十分かどうかは、どう判断すればよいですか?
実際の入力のサンプルで動かし、自動チェックをかけて、上のティアと失敗率を比べます。差が小さく、タスクのリスクも低いなら、ダウングレードします。失敗が顧客に届くなら、やめておきましょう。
この料金はチャットのサブスクリプションにも当てはまりますか?
いいえ。これらは100万トークンあたりのAPI料金です。チャットプランやコーディングツールはシート単位か利用上限で課金されるので、節約できるかどうかは、日常的なセッションで軽いモデルを選べるかにかかっています。