

モデル更新を生き抜くプロンプトエンジニアリングパターンは、モデルが推論できない情報を運ぶものだ:読み手を設定するロール、モデルが持っていないコンテキスト、判断ルールを持つタスク、そしてプロンプトの外で強制される出力コントラクト。それ以外はすべて、賞味期限付きの慣習にすぎない。
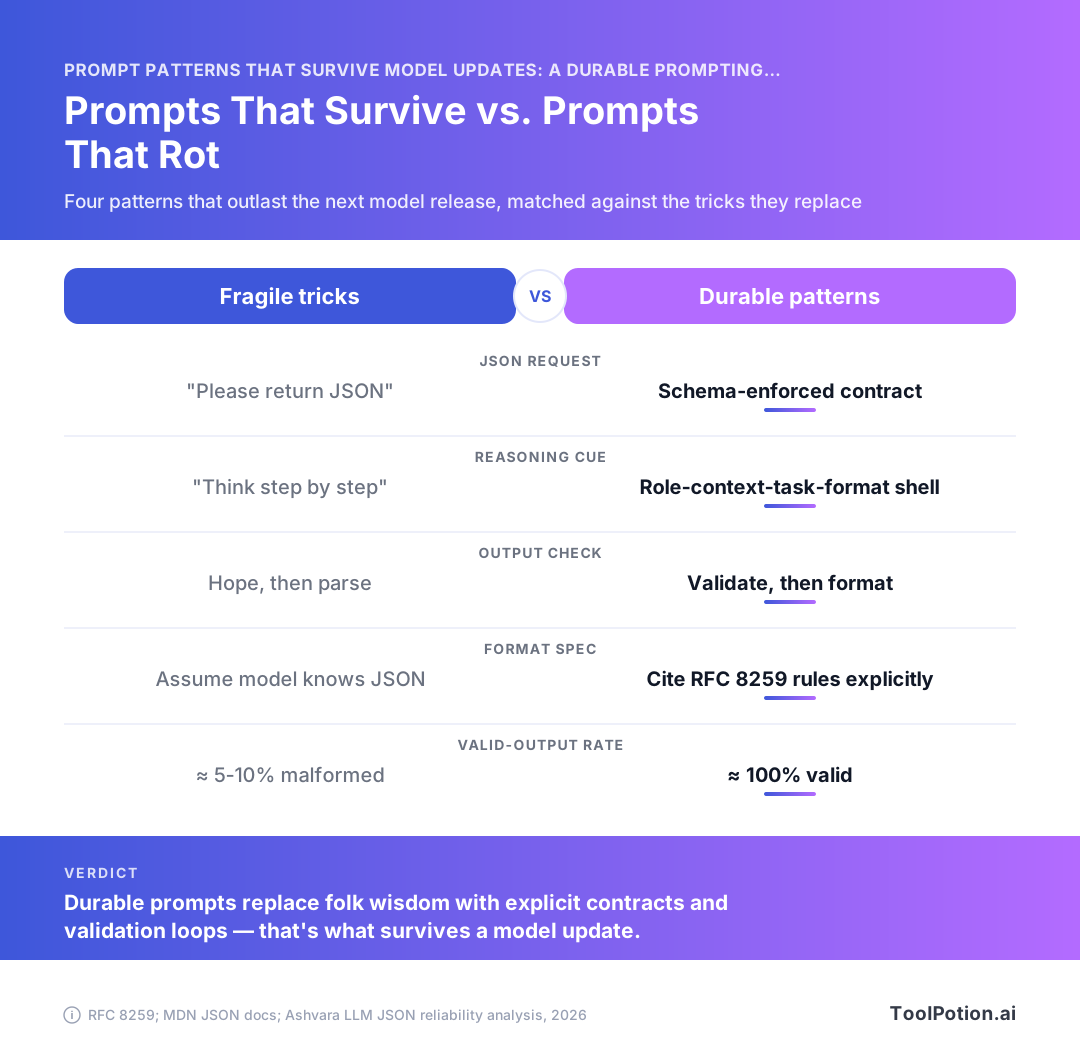
この差はJSONで最もよく見える。モデルにJSONを丁寧にお願いすると、約5〜10%の出力が不正な形式になる。JSONモードを使えば約95〜99%の有効率に達し、スキーマ制約付きデコーディングは実質100%だ(Ashvara)。同じ意図でも、3つの強制レイヤーによってリリース日の失敗率が大きく異なる。
このプレイブックでは、Claude、GPT、Gemini全体で機能し続ける4つのパターン、ライブラリから削除すべき脆いトリック、そして次のモデルリリースをインシデントではなくdiffにする小さな評価スイートを取り上げる。
プロンプトが腐る理由:誰もバージョン管理しない失敗モード
プロンプトはランダムに劣化しない。予測可能な継ぎ目に沿って劣化する:特定モデルの振る舞いに依存した部分は次のチェックポイントで無効化され、欲しいものを明示した部分はそれを生き延びる。
2種類のプロンプト:意図を記述するものとクセを利用するもの
意図プロンプトは、出力がどうあるべきか、誰が読むか、何が間違いかを述べる。クセプロンプトは、先週火曜日にたまたまうまくいったことを述べる。大文字の「ONLY RETURN JSON」。2回では足りなかったからと同じ指示を3回繰り返すこと。フォーラムのスレッドからコピーした魔法の前置き。これらのトリックは特定のチェックポイントのデコーディング動作に合わせてチューニングされており、将来のモデルが実際に何を必要としているかは何も伝えていない。
「JSONを返してください」という素朴なプロンプティングは、推定5〜10%の不正な出力を依然として生む(Ashvara)。この数字はプロンプトではなくモデルの特性だ。モデルを交換すれば数字が変わる。コントラクトを記述していないから、新しいモデルに要求するものが何もない。
リリース日に実際に壊れるもの
破綻は滅多に大きな音を立てない。末尾のカンマでパーサーが例外を投げ始めたり(あるJSONエラー分析でその約40%がまさにこれに起因している、Flying Fish Space)、モデルがより会話的になってクリーンな出力を前置き文で包み込んだりする。一方で新モデルリリースのペースを考えると、チューニングしたチェックポイントが来四半期にトラフィックを処理しているとは限らない。
スキーマ制約付き呼び出しと比較してみよう。生成が指定したシェイプに制限され、構文的有効性は実質100%だ(Ashvara)。強制はプロンプトテキストの外に存在する。モデルの更新がトーン、冗長性、推論の深さを変えても、それには触れない。
耐久性テスト:より賢いモデルにもこのプロンプトは意味をなすか?
所有する全プロンプトに対して一つの問いを立てよ:もしモデルが一晩で2倍の能力になったとしたら、この指示はまだ有用な仕事をしているか?
「id、status、confidenceをキーとするオブジェクトを返せ。statusは3つのリテラル値のいずれかであること」は合格だ。RFC 8259はすでに借用している語彙を固定している:4つのプリミティブ型、2つの構造型、そして正確に3つの小文字リテラル名(RFC 8259)。その指示は今も将来もどんなモデルにも読める。「深呼吸してステップごとに考えて」は不合格だ。次のリリースでは存在しないかもしれない弱点を補っているからだ。補完を削除し、コントラクトを残せ。
転用できるプロンプトエンジニアリングパターン:ロール・コンテキスト・タスク・フォーマット
すべてのアドホックなプロンプトを4つのスロットに再構成し、モデルが推論できない情報だけをそれぞれに入れよ。ロール、コンテキスト、タスク、フォーマット。シェルはモデル更新を生き延びる。なぜなら各スロットにはあなたの問題に関する事実が含まれ、先四半期のチェックポイントがお世辞にどう反応したかという慣習ではないからだ。
4つのスロットとそれぞれに属するもの
ロールは出力が誰のためのものか、答えがどのような専門知識を前提とするかだ。「あなたは世界クラスの専門家です」はムードを設定するが情報は何も運ばない。「あなたはべき等キーとは何かをすでに知っている決済エンジニア向けに書いています」は、どの説明を省略できるかをモデルに伝える。
コンテキストはモデルが知り得ない全情報だ:スキーマ、上流システム、本番環境で既に遭遇したエッジケース、パーサーがUTF-8 BOMを拒否するという事実。タスクは単一の動詞とその目的語。フォーマットは出力コントラクトであり、機械的に検証できるほど具体的であるべきだ。
「JSONを返す」というフォーマットスロットは願望だ。キー、その型、値が不明な場合の動作を明示するフォーマットスロットはテスト可能なコントラクトだ。JSONは4つのプリミティブ型(文字列、数値、ブール値、null)と2つの構造型(オブジェクトと配列)を提供し(RFC 8259)、正確に記述できる有限の語彙がある。「空白にしておく」ではなくnullと言え。リテラル名true、false、nullは小文字であり、それ以外は合法ではないからだ(RFC 8259)。
シェルがClaude・GPT・Geminiを横断して転用できる理由
4つのスロットのどれも、トークナイザー、システムプロンプトのクセ、プロバイダーの機能フラグに依存しない。どのモデルも、どのフィールドが欲しいか、下流コードがそれで何をするかを教えてもらう必要があるため、同じシェルはClaude、GPT、Geminiに書き換えなしで適用できる。その移植性がアップグレード可能性でもある:新しいチェックポイントがリリースされると、コンテキストスロットはまだ正しく、フォーマットスロットはバリデーターが強制するコントラクトのままだ。モデルを交換し、評価を再実行し、diffは空になる。
私たちのディレクトリでこの構造をテンプレート化している212のプロンプトエンジニアリングツールのほとんどは、スロットをフォームとして販売している。同じ効果はheredocと4つのコメントで得られる。
制約を呪文ではなく事実として書く
プロンプトの一行が属するかどうかのテストがある:有能な請負業者がフォローアップの質問なしにそれに従えるか?「徹底的に」は不合格。「プロパティ名はダブルクォート、最後の要素の後にトレーリングカンマなし」は合格だ。そして実際の失敗モードに対応している。あるJSONエラー分析では、トレーリングカンマだけで約40%を占めている(Flying Fish Space)。
呪文は静かに失敗しながらトークンを消費し続けるが、述べられた事実はどのチェックポイントに向けても意味を保ち続ける。
実際の書き直し前後の例
| 変更前(アドホック) | 変更後(4スロット) |
|---|---|
| 「あなたは熟練したデータアナリストです。請求書の詳細を丁寧に抽出してJSONを返してください。正確に!」 | ロール: 出力はPythonのjson.loads呼び出しが消費し、人間は読まない。コンテキスト: 請求書はOCR処理されたPDF;ベンダー名は切り捨てられることが多い;金額には通貨記号が含まれる場合がある。タスク: vendor、invoice_number、total_cents、issued_dateを抽出する。フォーマット: 1つのJSONオブジェクト、キーは記載通り、total_centsは先頭ゼロなしの整数、不明な値はnull、前後に散文なし。 |
変更後はモデルの個性について何も言わず、データについてすべてを言っている。nullと{}はどちらも有効なJSONだが異なる意味を持つことに注意(Jsonic)。どちらかを選んで書き留めよ。JSON数値では先頭ゼロも合法ではなく(MDN)、これがフォーマットスロットが文法をモデルの記憶に委ねずに整数ルールを明示する理由だ。
転用のためにチューニングされたfew-shotスキャフォールド
解消する曖昧さのために例を選べ。人間が迷う4つのケースを示すfew-shotブロックは、次のモデルがまだ必要とするものを教える。ハウススタイルの4つの簡単なケースを示すブロックはトーンを教えるが、トーンはすべてのチェックポイントが自力で推測するのが上手くなるものだ。
語彙ではなく判断境界を教える例
例を貼り付ける前に、それを削除したら何が変わるかを問え。答えが「出力が少し私たちらしくなくなる」なら、削除せよ。答えが「モデルが返金・部分出荷を返品ではなく紛争として分類してしまう」なら、残せ。その判断はタスクの説明から導き出せないからだ。
同じテストが出力形状にも当てはまる。空の結果をnullではなく[]として示す1つの例は、5つの結果が入った例より価値がある。空の配列とnullはどちらも有効なJSONだが異なる意味を持ち(Jsonic)、モデルはそれを違う方法で推測する。1つの例がそれを永遠に解決する。
エッジケースと否定例はトークンコストを正当化する
2〜3ショットは本番環境で間違えたケースにすべきだ。欠落フィールド。すでにターゲットフォーマットにある入力。正しい答えが「データ不足」なのに親切なモデルが値を捏造するケース。
否定例は禁止を述べるのではなく、訂正とペアにすることで機能する。不正な出力と修正後のものを並べて示せば、境界が具体的になる。「シングルクォートを使うな」という素の指示は早々に陳腐化する。シングルクォートはトレーリングカンマとともに不正なJSONの繰り返し犯の一つで、あるJSONエラー分析ではトレーリングカンマが約40%を占める(Flying Fish Space)。
ショット数と、ゼロにすべきタイミング
ゼロから始めよ。評価ケースが失敗したときだけショットを追加し、そのケースを修正する最小の例を追加せよ。ほとんどの分類・抽出プロンプトは3〜6で安定する。8を超えたら、たいていは適切に書いていなかったタスク説明を補っているだけだ。
スキーマで十分な場合はゼロにせよ。供給したスキーマに対する制約付きデコーディングは実質100%の構文的に有効なJSONを得られる(Ashvara)。そこではフォーマット例は不要な重荷だ。判断のためにショットを残し、構造のためにスキーマを使え。
過学習の臭い:次のモデルが文字通りに模倣する例
表面的な特徴が偶然なショットに注意せよ。すべての例の入力が約40語なら、より強力なモデルは長さをシグナルとして扱うかもしれない。4つの例すべてが同じラベルに落ちるなら、事前確率に偏りが生じている。例がAcme Corpのようなプレースホルダー名を使っているなら、それらの名前がいずれ実際の出力に現れると覚悟せよ。
新しいチェックポイントがリリースされた週に、few-shotセットをそのチェックポイントに対して再実行し、例がカバーしないケースで出力をdiffせよ。そこで模倣が漏れる。実際のデプロイメントの記録を公開しているチームは、まさにこの理由から例セットをバージョン管理下に置く傾向がある:diffできない例はリタイアもできない。
モデルを超えて生き残る出力コントラクト
フォーマットがその日のチェックポイントの気分に依存しなくなるまで、スタックの下に強制を押し込め。JSONを丁寧に求めることは最も弱い層で、ほとんどの本番コードがまだそこで動いている。
3段階の信頼性:散文リクエスト、JSONモード、制約付きデコーディング
| 段階 | 要求方法 | 返ってくるもの |
|---|---|---|
| 1 | プロンプトテキスト内の「JSONを返してください」 | 推定5〜10%の出力が不正な形式(Ashvara) |
| 2 | プロバイダーのJSONモードを有効化 | 本番観測では約95〜99%の構文的有効性(Ashvara) |
| 3 | 提供したスキーマに対して生成を制約 | 実質100%の構文的有効性(Ashvara) |
プロバイダーがサポートしている場所では段階3を選べ。有効性はウェイトではなくデコーダーから来るので、モデルを交換しても回帰しない。それでもプロンプトレベルのコントラクトは維持せよ。制約付きデコーディングは形状を保証するが、値が正しいかどうかは何も言わない。プランビングを書きたくなければ、私たちのディレクトリでスキーマ強制をラップするフレームワークは128件ある。
「JSONを返す」を超えてコントラクトが指定すべきもの
キー、各キーの型、モデルにそこに入れるものがない場合の動作を明示せよ。
- パーサーが期待する通りに正確にスペルされた全キー。型は6つのJSON型から:4つのプリミティブ型(文字列、数値、ブール値、null)と2つの構造型(オブジェクトと配列)(RFC 8259)。
- 小文字リテラルのみ。文法が許可するのは正確に3つ:false、null、true(RFC 8259)。
- 各オブジェクト内でユニークなキー名。RFC 8259がこれを推奨するのは、すべてのパーサーが同じ名前と値のマッピングで合意するためだ。
- オプションキーが省略されるかnull値で出力されるかの指定、および期待するenumがあればリテラル文字列として書き出したもの。
エンコードする価値のある失敗モード:トレーリングカンマ、シングルクォート、エスケープされていない文字列
あるJSONエラー分析では、トレーリングカンマが全エラーの約40%を占め、シングルクォート、文字列内のエスケープされていないクォート、欠落カンマ、隠れたUTF-8 BOM文字が残りのほとんどを占める(Flying Fish Space)。これら5つの失敗をフォーマットスロットで明示的に禁止するのに約25トークンかかるが、禁止はどのモデルに向けても正しいままだ。プロンプト側の文字列を信頼するのではなく、自分側で検証してからフォーマットするステップとペアにせよ(QuickTinyData)。
空オブジェクト、空配列、null:3つの異なる答え
ここはコントラクトがモデルバージョン間で誰も気づかないまま漏れる場所だ。空オブジェクトと空配列はどちらも有効なJSONで、nullとは異なる意味を持つ(Jsonic)。あるチェックポイントはマッチなしに[]を返し、次はnullを返す。下流コードはその一方をエラーとして扱う。
表現を選び、コントラクトに記述し、そのためにバリデーションせよ。パーサーはトップレベルの単独値も受け入れる必要がある。どんな単一のJSON値も完全なドキュメントとして有効で、スタンドアロンの文字列や数値42も含む(Jsonic)。
リリースのたびに死ぬ脆いトリック
プロンプトライブラリを開いてこれら4つのパターンを検索せよ。すべてのヒットは削除の候補だ。それぞれが、修正されたかどうかわからないモデルの弱点を補っているからだ。
後付けの汎用的な「ステップごとに考えて」
「ステップごとに考えて」をプロンプトに追加することは、モデルが即座に答えに飛びついていた時代には意味があった。現在の推論モデルはすでにデフォルトで分解するので、このフレーズはトークンを追加し、短い分類タスクを3段落の語りに引き込んで、その後ストリップする必要が生じることさえある。
推論の指示は、タスク固有の場合にのみ維持せよ:「一つを選ぶ前に相反する条項をリストせよ」は、何について推論するかをモデルに伝える。耐久性のある代替品はロール・コンテキスト・タスク・フォーマットシェルのタスクスロットで、欲しい中間成果物を明示することだ。汎用的な呪文はゴミ箱へ。
脅し、賄賂、ロールプレイの圧力
「これを間違えたら解雇される。」「$200チップを渡す。」「あなたは世界最高のアナリストです。」これらは特定のRLHFチェックポイントのクセに依存しており、クセは再トレーニングを生き延びない。さらに悪いことに、これらは反証不可能だ:チップが出力を修正したことを証明するテストを書けないので、その行は永遠にプロンプトに留まり、異議を唱えられない。
圧力を制約に置き換えよ。モデルが自己採点するルーブリック、または何が失敗とみなされるかの明示的なリストは同じ仕事をし、チェックポイントが変わっても機能し続ける。
トークナイザーと戦うフォーマットハック
ALL CAPSの要求、三重感嘆符、#####のような長い区切り文字の連続でプロンプトを埋めることは慣習に過ぎない。区切り文字の部分には核心があった(明確なセクション境界は役立つ)が、エスカレーションは不要だ。2つの改行とXML風タグは40個のハッシュに勝る。
「コードフェンスなし、前置きなし、説明なし、JSONのみを出力せよ」を3回重ねることも同様だ。フォーマットスロットで一度述べ、保証を実際に保証が存在する場所に置け:提供したスキーマに生成を制約することが実質100%の構文的有効なJSONを実現し(Ashvara)、プロンプト側の禁止をいくら積み重ねてもその数字には近づけない。
パーサーが必要な場所でのプロンプトレベルの懇願
失敗モードは退屈で構造的だ:最後のアイテムの後のトレーリングカンマ、クォートされていないキー、不正なクォート文字、欠落カンマ、不一致の括弧(QuickTinyData)。トレーリングカンマだけで、あるJSONエラーデータセットの約40%を占め(Flying Fish Space)、フォーマット自体が禁じている(MDN)。丁寧にお願いしてもそのギャップは埋まらない。
懇願を削除せよ。代わりにスキーマとバリデーターを置き、プロンプトにはフィールドの意味を語らせよ。
評価ループはプロンプトをバージョン管理された成果物として扱う
賢いものを作る前に20のテストケースを作れ。評価セットのないプロンプトはアップグレードできないプロンプトだ。新しいモデルがそれを改善したか、最も重要な顧客にとって重要な1件を黙って壊したかを知る方法がないからだ。
20は妥協の数字ではない。既知の失敗クラスを捕捉するのに十分で、午後に書き上げられるほど小さく、請求を気にせず全チェックポイントで再実行できるほどコストが低い。
最小限の実行可能評価:20ケース、各1アサーション
ケースごとに1つのアサーション、そしてブール値にせよ:出力はパースできたか、必須フィールドは含まれていたか、すべき時に拒否したか。ルーブリック、審判モデル、類似スコアはブール値がグリーンになってから来る。3つのアサーションを持つケースはデバッグできないケースになる。赤い実行は3つのうちどれが壊れたかを何も教えない。
20件は実際のトラフィックから、醜い端に重みをかけて選べ。5つのハッピーパス、5つの曖昧な入力、5つの敵対的または空のもの、5つはどこかの時点で本番で壊れたもの。同じリポジトリ、同じコミットで、プロンプトの隣に保存せよ。プロンプトが変わってケースが変わらなければ、それはレビューコメントだ。
まず検証してからフォーマット:JSONデバッグワークフローを借用する
JSONの世界はこの議論を何年も前に解決した。QuickTinyDataのトラブルシューティングガイドは、まず検証してからフォーマットすることを推奨している。壊れたドキュメントを整形すると、探しているまさに構造的なエラーが隠れてしまうからだ:トレーリングカンマ、クォートされていないキー、不正なクォート文字、欠落カンマ、不一致の括弧(QuickTinyData)。
評価も同じ方法で実行せよ。品質の前に有効性をアサートせよ。json.loadsに失敗するモデル出力はセマンティックチェックに進んではならず、部分点も得てはならない。評価スイートには2列が必要だ:パース率と合格率。2列目は1列目が成功した行のみカウントする。
エラーの分布を知ることで何をアサートすべきかがわかる。あるJSONエラー分析ではトレーリングカンマが約40%を占め、シングルクォート、文字列内のエスケープされていないクォート、欠落カンマ、隠れたUTF-8 BOM文字が残りの大半を占める(Flying Fish Space)。そのBOMは専用のアサーションに値する。出力を検査するすべてのエディターで不可視だからだ。
リリース日のリグレッション実行
新しいチェックポイントがリリースされた。20を実行し、diffを得て、判断する。これが全手順であり、スイートを正しく構築していれば約4分かかる。
- 旧モデルをピンして、ベースラインが再現されることを確認するためスイートを再実行せよ。再現しなければ、問題はリリースではなくテストセットアップにある。
- 新しいチェックポイントに対してスイートを実行し、パース率と合格率を別々に記録せよ。
- 両方向でフリップしたすべてのケースを読め。合格し始めたケースはラッキーかもしれず、リグレッションと同じ注意を払う価値がある。
- リリース、ロールバック、またはプロンプトにパッチを当てよ。そしてプロンプトファイルの隣に新しいベースライン数値をコミットせよ。
これは単一の不正なパースがカスケードするエージェントスタックで最も重要だ。3つのツール呼び出し下流で、フォーマットバグとは何も似ていないものとして障害が表面化するからだ。
バージョンのピンとピンできない場合の対処
可能な限り日付付きモデルIDにピンし、エイリアスはロックしないことを選んだフローティング依存関係として扱え。一部のプロバイダーはピンを提供しないか、短いウィンドウでピン中のものを非推奨にする。その場合、評価スイートが暗黙の動作変更と再現できないサポートチケットの間に立つものだ。
ピンされていないエンドポイントに対してスケジュール実行せよ。週1回で十分だ。ユーザーがバグレポートで語る前に、ドリフトを発見できる。
Claude・GPT・Gemini間でプロンプトを移植する
十分に構築されたプロンプトの約80%は変更なしで移植できる。残りはプロバイダーごとに一度書けば後はほぼ忘れられるアダプタ層だ。ベンダーごとにすべて書き直しているなら、プロンプトが必要のないプロバイダー固有の動作を運んでいた。
同一のままにするもの:シェル、例、コントラクト
4スロットシェルはゼロ編集でベンダー間を移動する。ロール、コンテキスト、タスク、フォーマットはジョブを説明し、ジョブはチェックポイントを交換しても変わらない。few-shotブロックも同様だ:ドメインの本物の曖昧さを解消する例はすべてのモデルに同じことを教える。曖昧さはデコーダーではなくデータにあるからだ。
出力コントラクトも同一のままにする必要があり、そうしなければならない。プロバイダーが返すものは何であれ、同じパーサーを満たさなければならない:ダブルクォートのプロパティ名、トレーリングカンマなし、NaNやInfinityなし、4つの合法なホワイトスペース文字のみ(スペース、タブ、ラインフィード、キャリッジリターン)(MDN)。スキーマは一度書け。3つの出力すべてを同じバリデーターで検証し、失敗をdiffせよ。
評価セットもベンダーニュートラルに保て。ClaudeでパスしてGeminiで失敗する20ケースは有用な情報を伝える。Claudeのクセに合わせて書かれた20ケースは何も伝えない。
プロバイダーごとに再調整するもの:システムメッセージの重み、区切り文字、強制API
3つのものにアダプタが必要だ。どれだけの指示をシステムメッセージ対ユーザーターンに入れるか(プロバイダーによって重み付けが異なる)。ブロックを囲むのに何を使うか(XML風タグかマークダウンヘッダー)。そしてどの強制APIを呼び出すか。
最後のものが厄介な部分だ。いかなる種類のJSONモードも構文を提供してそこで止まる:本番観測ではそれが約95〜99%の構文的有効性で、スキーマに対して生成を制約することが実質100%だ(Ashvara)。どちらの層も、キーが求めたものかどうかについては何も言わないため、スキーマチェックはどのベンダーでもコードに残る。ターゲットを選ぶなら、コミットする前にモデル自体を比較することが価値ある、そして私たちのディレクトリのマルチプロバイダープラットフォームがこのアダプタ作業の一部を吸収する。
リリース前のポータビリティチェックリスト
- モデル名、バージョン、またはあるモデルの既知の動作に言及するすべての文を削除せよ。それらが最初に壊れる行だ。
- 3つのプロバイダーすべてに対して同じ評価セットを実行し、平均ではなくケースごとの合格率を記録せよ。
- プロバイダーが制約付きデコーディングを主張するかどうかに関わらず、スキーマバリデーターがすべてのレスポンスに対して実行されることを確認せよ。
- アダプタを配線する際に各プロバイダーの強制ドキュメントを再読み、必要なフレーズやフラグをプロンプト共有部分ではなくアダプタ内に保持せよ。
- どのアダプタが発火したかをログに記録せよ。チェックポイントがリリースされて品質が動いたとき、プロンプトとアダプタのどちらが変わったかを知りたい。
プロンプトが1つのベンダーのみでこのチェックリストに失敗するなら、バグはほぼ常にシェルではなくアダプタにある。
よくある質問
新しいモデルがリリースされるたびにプロンプトを書き直す必要があるか?
不要だ。書き直しているなら、プロンプトが指示ではなくモデル固有のハックを運んでいた可能性が高い。更新を生き延びる部分はモデルの外にあるものに結びついた部分だ:タスクの説明、入力データ、JSONスキーマのような出力コントラクト。提供したスキーマに対する制約付きデコーディングは、どのモデルが裏にいても実質100%の構文的に有効なJSONを生成する。制約はデコーダーにあるからだ。モデル変更で書き直すべきものは何もない。再実行すべきは評価セットだ。
「ステップごとに考えて」は現在のモデルでもまだ機能するか?
ほとんど不要な重荷になった。そのフレーズは即座に答えに飛びつくモデルの回避策で、現在のモデルはすでに言われなくても複数ステップの作業を分解する。さらに悪いことに、厳密なJSON出力を要求するプロンプトに追加すると、モデルがオブジェクトの周囲に推論の散文を出力するよう誘い込む。これはまさに、素朴なプロンプティングが推定5〜10%の不正なJSONレートに至る失敗クラスだ。推論が必要なら、スキーマに名前付きフィールドを与え、パーサーにペイロードから分離させよ。
JSONモードで十分か、それともスキーマが必要か?
スキーマを使え。JSONモードは約95〜99%の構文的に有効な出力まで到達できる。1日1万件の呼び出しを実行して100件の失敗を食らうまでは、それで十分に聞こえる。スキーマ制約付きデコーディングは構文の有効性を実質100%に引き上げ、キー名もピン留めする。RFC 8259がJSONオブジェクトを名前と値のペアの順序なしコレクションとして扱い、ユニークな名前のみを推奨しているためこれは重要だ。構文の有効性はセマンティックな正確さではないため、いずれにせよ自身のルールに対してパースされたオブジェクトのバリデーションを続けよ。
耐久性のあるプロンプトにはfew-shotの例をいくつ含めるべきか?
2〜4、そして量ではなくエッジカバレッジのために選べ。同じハッピーパスを繰り返す例はモデルがすでにできることを教えない。厄介なケースをピン留めする例がモデル間を転用できる。構造化出力では、空のコンテナと欠落した値の区別を示すために少なくとも1つの例を使え。[空オブジェクト{}と空配列[]はどちらも有効なJSONだがnullとは意味的に異なる](https://jsonic.io/guides/json-examples)からだ。例が厳格なパーサーが拒否するフォーマットを含んでいたら、失敗を教えていることになる:トレーリングカンマだけであるJSONエラー分析の約40%を占める。
プロンプトの評価セットはどのくらい大きければ有用か?
30〜50のラベル付きケースがほとんどのリグレッションを捕捉し、ほとんどのチームが実行するゼロよりも20が優れている。サイズよりも構成が重要だ:クォートされていないキー、シングルクォート、文字列内のエスケープされていないクォート、欠落カンマ、隠れたUTF-8 BOM文字など、本番で実際に見た失敗モードにセットを傾けよ。これらはすべて文書化されたJSONエラーの内訳に現れる。構造的な破綻を見つけてマスクしないよう、フォーマットの前に検証を実行せよ。これはQuickTinyDataが推奨するワークフローだ。プロンプトと並べてセットをバージョン管理し、新しいモデルがリリースされた日に再実行せよ。
同じプロンプトがClaude・GPT・Geminiで変更なしで動くのか?
指示の本体はきれいに移植できる。出力強制レイヤーはできない。JSONモードとスキーマ制約付きデコーディングはプロバイダーごとに異なる設定が必要なため、1つのプロンプトと3つの薄いアダプタを計画せよ。すべてのプロバイダーがすでに同意しているフォーマットでコントラクトを維持すれば助かる:RFC 8259は言語非依存で、4つのプリミティブ型とオブジェクト・配列を定義し、小文字のtrue、false、nullのみをリテラル名とする。プロバイダー間のプロンプト管理ツールを探しているなら、私たちのディレクトリには212のプロンプトエンジニアリングツールとAIモデルの324エントリがある。