

2026年に基準を満たす財務AIワークフローは4つある:照合、予測、経費分類、監査準備だ。それ以外はすべて、デモが見栄えするだけのパイロットにすぎない。
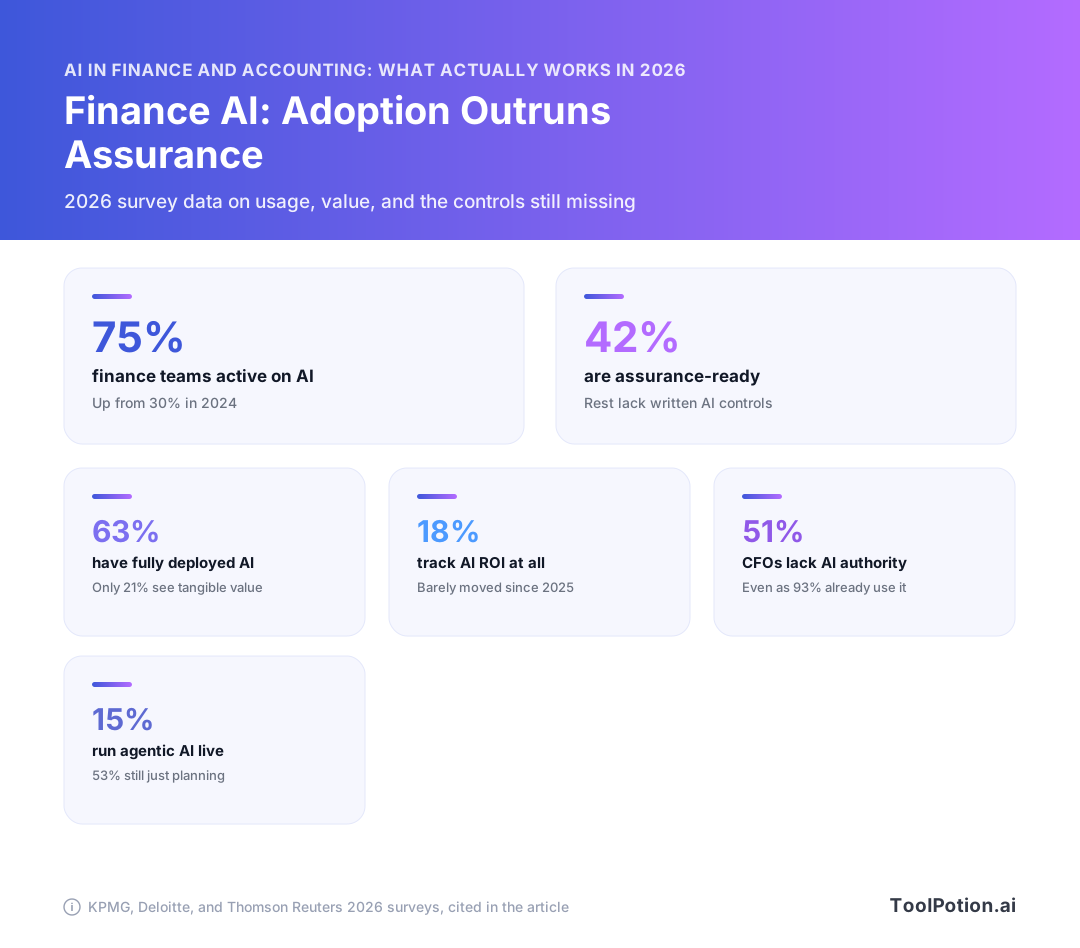
採用率の数字は判断の助けにならない。KPMGによれば、財務部門でのAI活用は2024年の30%から2026年には75%へと倍増した。Deloitteが1,326人のリーダーを対象に実施したFinance Trendsサーベイでは、63%が完全展開済みであるが、実質的な価値を実感しているのはわずか21%という結果が出た。Thomson Reutersの調査ではROIを何らかの形で追跡している組織はわずか18%にとどまる。これらは矛盾ではなく、「採用」という言葉の定義が三者三様なのだ。
そのため本稿ではコントロールを軸に絞り込む:COSOの2026年2月GenAIガイダンスが求めるもの、ベンダーの精度注釈が実際に測定したもの、そして当ディレクトリに掲載された309の財務・バンキングツールのうち両方のテストをクリアするものを検討する。
2026年の採用率の数字は矛盾しているため、定義ごとに読み解く必要がある
あるサーベイが93%と言い、別のサーベイが14%と言う場合、どちらも正しいことがある。それぞれ異なるものを測定しているのであり、ほぼすべてのケースでそれをヘッドラインに明記していない。
パイロット利用、展開済み利用、コアワークフロー利用は三つの異なる問いだ
KPMGのGlobal AI in Finance 2026では、財務部門でのAI活用が2024年の30%から2026年には75%へと2倍以上に増加したとされており、財務リーダーの71%がAIはROI期待に応えているか、それを上回っていると回答している。ここでの「活用」には、コントローラーが差異コメントをチャットウィンドウに貼り付けるだけの作業も含まれる。Thomson Reutersは組織全体でのGenAI利用について調査し、40%という結果を得ており、前年の22%から増加した。エージェント型AIについては15%にとどまり、53%が検討中・計画中だ。同じ年、同じ業界でも3倍の開きがある。これは市場ではなく、設問文の違いが生んだ結果だ。
数字を引用する前に定義を確認しよう:ツールを試した人全員を数えているのか、会社がツールを購入した人を数えているのか、それとも監査人が確認する月次決算を乗り越えたワークフローを数えているのか。自社のロードマップに意味をもたらすのは第三の定義だけだ。
誰も照合しない展開から価値へのギャップ
Deloitteの2026 Finance Trendsサーベイ(1,326人の財務リーダーを対象)は必携の資料だ。なぜなら両面を問うているからだ。63%が財務でAIを完全展開済みであり、21%がその投資に実質的な価値があると信じており、14%がAIエージェントを完全統合済みだ。展開が価値の約3倍になっている。このギャップが2026年の財務AIの実態であり、ベンダーとの打ち合わせに持ち込むべき数字だ。
そもそもROIを測定していない組織がほとんど
採用グラフをいっそう不確かにしている点がある:何らかの形でAI ROIを追跡していることを把握している回答者はわずか18%であり、前年とほぼ変わらず、追跡している組織のほとんどがビジネス成果ではなく内部業務指標を測定している。測定されていない支出に対する自己申告の満足度は気分であって、証拠ではない。
二つの習慣が役に立つ。数字を繰り返す前にサーベイ自体の定義と照らし合わせること、そしてベンダーのスポンサード調査の数字は脚注を確認するまでマーケティングの主張として扱うこと。当ディレクトリの309の財務・バンキングAIツールにも、私たちが追跡するAIトレンドレポートにも同じフィルターを適用している。だからこそ、次のセクションのショートリストは短いのだ。
照合:実際に得られる自動マッチ率
口座の60%〜80%が自動認証されることを前提に、その下限でビジネスケースを組み立てよう。デモで聞く数字は「最大98%」の自動認証と99%のマッチ精度だ。実際の顧客展開では43%〜85%に落ち着くため、60〜80%が誠実な計画上の前提となる(Numeric)。決算体制が90%でしか成立しないなら、最初の月次決算を迎える前にプロジェクトは失敗する。
マーケティングの上限値と実際の顧客実績レンジ
43%という下限と85%という上限は同じソフトウェアの話だ。この開きはベンダーのモデルではなく、あなたのデータによるものだ。
98%という数字は狭い範囲では達成可能だ:銀行現金やクレジットカード清算のような取引量が多く差異の少ない口座に限定し、クリーンな一対一マッチングと寛大に設定した重要性基準が前提となる。同じツールを前払費用、会社間取引、発生負債、在庫に拡張すると、認証率は急落する。これらの口座は一致ではなく判断を必要とするからだ。ベンダーに「参照顧客の割合はどの口座タイプを対象としているか」を必ず確認しよう。「現金とAR」という答えなら、その数字はポートフォリオ全体ではなく一部の割合だとわかる。
ギャップを生む要因:データ品質、補助元帳のカバレッジ、重要性基準
落としどころを決める要因は三つあり、契約前にすべて自分でコントロールできる。まず補助元帳のカバレッジ:サポート詳細がスプレッドシートやAPIのないシステムに存在する口座は、どれほど精度が高くても自動認証できないため、それを数えて今すぐ分母から差し引こう。次にデータ品質:一貫した参照ID、安定したベンダー名称、前期を修正しない銀行フィードが必要だ。三番目が重要性基準であり、ダッシュボードを見栄えよくするために人々が密かに操作するレバーだ。
自動認証の閾値を500ドルから5,000ドルに引き上げると、マッチングの根本的な改善なしに率が跳ね上がる。監査人はそれに気づく。既存のSOX文書から閾値を設定し、パイロット期間中はそれを固定して測定しよう。当ディレクトリの開示済み成果を持つAIケーススタディも同じフィルターで読む価値がある:報告された率が口座タイプと閾値を明記しているか確認しよう。ほとんどは明記していない。
パイロットに盛り込む受入基準
キックオフ資料ではなく注文書に記載しよう。実際の口座ポートフォリオ全体で、3か月にわたる四半期末クローズを1回完全に実施すること。
- 対象となるすべての貸借対照表口座で少なくとも65%の自動認証率を達成すること。重要性基準はパイロット期間中に凍結した現行水準で測定する。
- 重要性基準を超える口座での虚偽認証率はゼロであること。虚偽認証とは、ツールが認証した残高を後から審査者が再開する必要があった場合を指す。マッチ率ではなく、これがパイロットを終了させる数字だ。
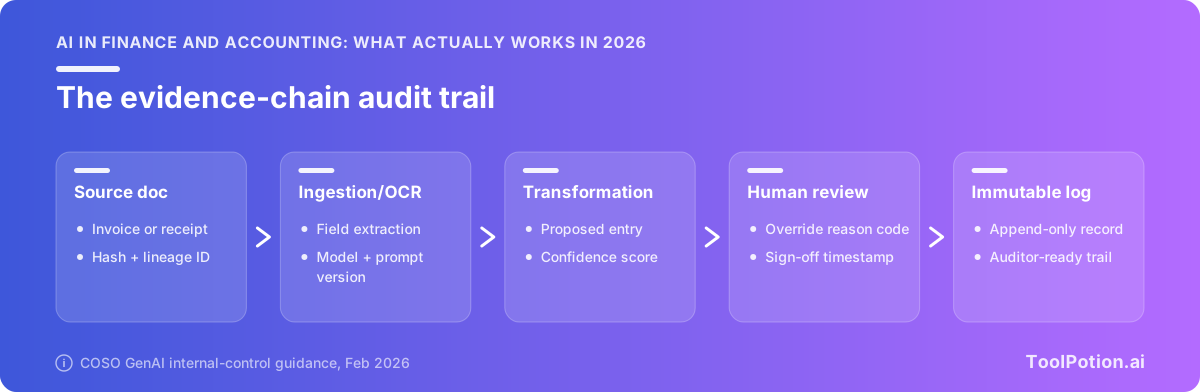
- すべての認証において、マッチしたソースレコード、適用したルールまたはモデルバージョン、例外キューを承認した担当者を示すエクスポート可能な監査証跡が生成されること。
- オーバーライド率を毎月追跡し報告すること。監査人より先にドリフトを把握できるよう。
ベンダーが自社データでの測定率にコミットしない場合、43%が得られる前提で取引を価格設定しよう。
予測:スピード向上は確実、精度向上は非常に不均一
FP&A AIはより良い数字のためではなく、サイクルタイム短縮のために導入しよう。KPMGが20か国の1,013人のシニア財務リーダーを対象とした2026年3月のサーベイでは、意思決定スピードが71%、意思決定品質が70%で改善した一方、予測精度が改善したのは64%だった(KPMG)。この64%は三つの中で最も軟弱な数字であり、ビジネスケースを崩すほど幅のある開きを隠している。
予測精度よりも意思決定スピードの方が安定して改善する
スピードと品質の向上は、AIが得意な作業から生まれる:四つのシステムから実績を一つの差異ビューにまとめ、コメントを下書きし、シナリオを1日かかるところを数分で再実行する。これらはいずれもモデルに予測を求めない。アセンブルして説明することを求めており、それがモデルの得意分野だ。
だから成功基準は基点ではなく日数で定義しよう。クローズから予測のターンアラウンド、1サイクルあたりのシナリオ実行数、アナリストがデータ収集に費やす時間。受入テストが予測誤差だけなら、KPMGの三つの測定成果のうち最も弱いものに賭けることになる。
銀行が71%でヘルスケアが44%の理由
同じKPMGデータで、予測精度の向上は銀行の71%からヘルスケアの44%まで幅があった(KPMG)。このギャップはそのセクターが持つクリーンで高頻度な構造化履歴データの量を反映している。銀行は数十年分の日次取引データを持ち、価格と日時が付与されている。ヘルスケアの予測は支払者ミックス、契約条件、償還タイミングに依存しており、それらはテキストに存在し契約ごとに変わる。
ベンダーに「参照顧客がどちらの世界から来ているか」を確認しよう。データリッチなセクターでの71%という結果は、自社の入力データが契約PDFである場合の収益予測についてはほとんど何も教えてくれない。
FP&Aコパイロットの限界:前提レイヤーは人間が担う
モデルは受注トレンドを外挿できる。しかし、新しい価格帯が解約率を変えること、Q3の採用計画が6週間遅れること、11月に再交渉中の顧客を30%ヘアカットすべきことは判断できない。こうした前提が予測を動かすのであり、それはセールスや業務と対話する人々から生まれる。
前提ライン以下のすべてにツールの範囲を絞り、前提は担当者と日付を付けて確認可能なレジスターに保持しよう。
経費分類:解決済みに最も近いワークフロー
今四半期に一つの財務AIワークフローをパイロットするなら、取引コーディングと経費ポリシーレビューにしよう。タスクは狭く、正解は自社のポリシー文書に記述されており、エージェントが下す判断はすべて確認可能な証跡を残す。
ポリシーチェックが判断よりエージェントに向いている理由
ポリシーチェックとは、自分が書いたルールに照らした検索だ。この340ドルのディナーには領収書、業務目的、一人当たり上限以下の参加者がいるか?これは構造化フィールドと領収書画像に対する決定論的な推論であり、失敗モードは審査者が数秒で確認できる。予測と比べてほしい。四半期が終わるまで数字が間違っていたかどうかはわからない。コーディングはポリシー側に近い:加盟店、金額、部門、勘定科目に、過去のコーディングをラベルセットとして使う。
取引量も助けになる。毎月ほぼ同一の判断が何千件も発生するため、精度率が逸話的ではなく意味のあるものになる形状だ。
ベンダー自身の精度定義が実際に測定するもの
Rampはポリシーエージェントについて、99%以上の精度で手動レビューを約85%削減したと公表しており、精度を脚注で定義している:エージェントが推奨した承認のうち人間の審査者も承認したもの、2025年7月1日付けの内部分析より(Ramp Support)。ビジネスケースに使う前にその定義を二度読もう。承認パスでの一致を測定しているため、エージェントが誤ってフラグ立てした経費についても、審査者がそのまま通過させた違反についても何も語っていない。開示された方法論はRampを競合他社のほとんどより先に置いている。競合のほとんどは分母なしの割合を公表しているだけだ。ショートリストのすべてのベンダーに同じ脚注を求め、拒否された場合はそれ自体を回答と受け取ろう。
残る例外に対するヒューマン・イン・ザ・ループ設計
エージェントが処理できない15%を指名された審査者にルーティングし、オーバーライド率を記録し、オーバーライドが増加したときに再トレーニングをトリガーする閾値を設定しよう。このオーバーライド率は、COSOが2026年2月のGenAIガイダンスで求めるドリフトKPIの一つだ(Deloitte Heads Up)。当ディレクトリに掲載された550のAIエージェントのうち、時間をかける価値があるのは、サポートチケットなしにそのログを提供してくれるものだ。
監査準備:監査人が実際にテストできるエビデンス
監査準備ベンダーのデモを見る前に一つだけ聞こう:担当チームが「この数字はどうやって算出されたか」と尋ねたとき、エクスポートはどのような形になるか?答えがチャット履歴なら、それは監査準備ツールではなく生産性向上ツールを購入しようとしている。
GenAI専用のPCAOB基準はないが、AS 1105とAS 2301はすでに適用される
生成AIのためのPCAOB基準は存在しない。だからといって、その空白に座り込む余地はない。監査証拠とリスク評価に関する既存基準が、すでにAI支援作業のバーを設定している(Fieldguide)。つまり、AIが作成したスケジュールは、スタッフが手作業で作ったスプレッドシートと同様に、十分性と適切性の観点から評価される。監査人はそれを拒否するために新しいルールを必要としない。
COSOは2026年2月23日に内部統制フレームワークをAIへ正式に拡張し、ガバナンス面を補完した。GenAIのユースケースを取込み、変換、転記、オーケストレーション、判断などを含む8つの能力タイプに分類した(Journal of Accountancy)。取込みと変換は守りやすい。判断は質問が長くなるところだ。
モデルが生成したエビデンスにおける「十分かつ適切」の意味
アウトプットが監査人が開くことのできるソース文書まで遡れることを意味する。これが最もうまく機能するワークフローは抽出だ。なぜなら基礎となるPDFや請求書が依然としてエビデンスであり、モデルはその上で作業する高速な補助者に過ぎないからだ。このレイヤーを検討しているなら、当ディレクトリには217の文書・PDF抽出ツールが掲載されており、時間をかける価値があるのは、要約した回答ではなく、抽出したフィールドごとにページと座標の参照を示してくれるものだ。
KPMGインターナショナルのグローバル監査イノベーション&AIヘッド、Sebastian Stöckleは端的に述べた:「AIは説明でき、かつコントロールできる場合にのみ真の価値をもたらす」(KPMG)。
事前に明記すべき保存、ログ、再現性
これらは契約に記載しよう。展開後に後付けするのはコストがかかる。すべての実行にスタンプされるモデルとバージョンの識別子、使用したプロンプトまたは設定、アウトプットフィールドからソース文書とページへの不変のリネージ、各アイテムを審査・承認した担当者とタイムスタンプのエクスポート可能なログ、そしてベンダーのデフォルトではなく自社の監査保存ポリシーに合わせた保存期間を要求しよう。ベンダーが年途中に基盤モデルをアップグレードしたとき、ログはどうなるかも確認しよう。
そして継続的に監視し続けよう。COSOのガイダンスは、取引量、取引規模、オーバーライド率といったKPIを用いたモデルパフォーマンスの継続的なモニタリングを求めている。設定したまま放置するコントロールではドリフトを検知できないからだ(Deloitte)。ダッシュボードに表示すべきはオーバーライド率だ。審査者がアイテムの30%をひっそりと修正しているなら、コントロールの問題が発生しており、ビジネスケースは成立していない。
ショートリストを絞り込むコントロールチェックリスト
2回目のデモの前にすべてのベンダーに渡そう。その大部分はCOSOの「Achieving Effective Internal Control Over Generative AI」から直接引用している。同書は2026年2月23日に、内部統制フレームワーク(2013年版)のAIガバナンスへの最初の正式拡張として公表された(Journal of Accountancy)。これが現在持てる成文基準に最も近いものであり、財務市場に販売するベンダーはすでに知っているべきだ。
COSOの8つのGenAI能力タイプと、自社のユースケースが関係するもの
COSOはGenAIのユースケースを8つの能力タイプに分類している:取込み、変換、転記、オーケストレーション、判断、モニタリング、規制インテリジェンス、人間とAIの相互作用だ(Journal of Accountancy)。ベンダーに、自社製品が実行するものを書面で回答させよう。
重要なラインは転記と判断だ。文書を取り込んでドラフトに変換するだけのツールは、台帳に書き込んだり例外が許容可能かを判断したりするツールとは異なるコントロールの問題を持つ。経費コーディングは通常、取込み、変換、判断に触れる。照合の自動認証は転記に触れる。ベンダーの答えが「全8つ」なら、そのベンダーも読んでいない。
ポイントインタイムの保証から継続的なモニタリングへ
従来のSOCウォークスルーは四半期間でドリフトするモデルには対応していない。COSOのガイダンスは、静的なポイントインタイムの保証ではなく、モデルパフォーマンスの継続的なモニタリングを求めており、ドリフト検知のためのKPIとして取引量、取引規模、オーバーライド率を優先している。設定したまま放置するコントロールは明示的に不十分だとされている(Deloitte Heads Up)。
契約で要求すべきオーバーライド率とドリフトKPI
- ユーザー別・取引タイプ別のオーバーライド率。ダッシュボードに表示されるだけでなく、毎月エクスポート可能であること。
- 日付付きのモデルバージョン履歴。これにより、エラー率の変化を推測ではなく特定のリリースに結びつけることができる。
- 自分が定義したパラレルラン期間中の自社データに基づいた精度測定。分母を書面化すること。
- レビューをトリガーする指定された閾値。今すぐ数値を決めて(例:任意の月でオーバーライド率8%超)、契約に盛り込むこと。
保証準備が結果を予測する変数
KPMGによれば完全な保証準備ができている組織は42%にとどまり、成果の差は顕著だ:準備できている企業はエラー削減改善を33%と報告しているのに対し、未準備の企業は6%であり、AIのスケール化への自信は42%対14%となっている(KPMG)。
AIは説明でき、かつコントロールできる場合にのみ真の価値をもたらす。保証準備が持続的なパフォーマンスと隠れたリスクを分かつ。— Sebastian Stöckle、グローバル監査イノベーション&AIヘッド、KPMG International
ショートリストを作る前にチェックリストを実行しよう。当社の財務・バンキングカテゴリには309の掲載があり、チェックリストはどんな機能比較よりも速く絞り込める。
すべての精度の主張をその脚注と照らし合わせて読む
財務AIデモのすべてのパフォーマンス数値は測定値であり、母集団・正解の定義・日付がない測定値はマーケティング資料だ。脚注は通常公開されている。ほとんど誰も読まない。
ほとんどの数値を無効化する三つの質問
2回目のデモの前に、この順番で書面により質問しよう。
- どの取引が計算に含まれているか?全取引量ではなく、数値を算出したサブセットを確認しよう。
- 何をもって正解とするか?誰かが正解を定義した。その定義をそのまま入手しよう。
- いつ、誰のデータで測定されたか?去年の単一の内部分析はサービスレベルではない。
分母、日付、自己選択した比較
Rampのポリシーエージェントは手動の経費レビューを約85%削減し、99%以上の精度を実現したと公表している。自社のドキュメントでは、その精度をエージェントが推奨した承認のうち人間の審査者も承認したもの、2025年7月1日付けの内部分析として定義している(Ramp Support)。これは承認パスでの一致の測定だ。エージェントが誤ってフラグ立てし、審査者が解除しなければならなかった経費については何も言っていない。それはコントローラーが気にするエラータイプだ。
照合の主張は異なる形で失敗する。自動認証率は上限値「最大98%」として示されているが、実際の顧客展開は43%〜85%の範囲に収まる(Numeric)。上限値とは最良の口座における最良の月の最良の顧客での数字だ。
信頼できる開示の形
Rampのように、サンプルサイズ、スコアリングルール、日付を明記し、精度率と並べて虚偽承認率も報告していることが条件だ。パイロット期間中に自社の直近1四半期のデータで計算した数値を求めよう。そのテストを実行しないベンダーは、脚注に何が書かれるかを教えてくれている。
デモが月次決算で機能しなくなる理由と、それを防ぐパイロット設計
デモはキュレーションされたデータで動く。前四半期のクリーンな補助元帳、整った請求書が十数枚、会社間取引なし、深夜11時に税務チームが手動で投稿したジャーナルエントリなし。決算はその正反対の母集団であり、セールスエンジニアが電話から排除するあらゆる失敗モードが、締め切りの中でコントローラーの前に一度に現れる。
精度を左右するのはモデルの選択よりも検索の構築
同じ財務の質問セットで一つのフロンティアモデルを別のモデルに入れ替えると、回答は少し変わる。文書のチャンク方法、どの期間のファイルが引き出されるか、脚注が表とともに渡されるかを変えると、回答は大きく変わる。財務Q&Aのほとんどの誤回答は流暢な文章に包まれた検索の失敗だ:FY25を尋ねたのにFY24のスケジュールを見つけ、散文はどちらでも完璧に読める。
COSOの2026年2月ガイダンスは、取込みと変換を判断とは別の能力タイプとして扱い、それぞれに固有のコントロールを課している(Journal of Accountancy)。自社の醜いソースファイルでパイプラインをテストしよう。ベンダーのサンプルセットはほとんど何も教えてくれない。
経験豊富な審査者がゲインの大部分を獲得する
スタッフに展開する前に、最も優秀なシニア担当者二人にツールを使わせよう。CPAのAIによる時間節約を定量化した実地調査も同じ方向を示している:時間の節約は、正解がどのようなものかを既に知っており、数秒で誤りを見抜けるベテランの元に集まる(Journal of Accountancy)。
レビューレイヤーをスキップすると、Deloitteの結果が待っている:AIが生成したエラーを含むレポートをめぐり、オーストラリア政府に6万ドル以上を返金した(CFO Dive)。
コスト、不明確な価値、脆弱なリスクコントロールがエージェントプロジェクトを頓挫させる
モデルの能力がこれらのプログラムを停滞させることはほぼない。Deloitteが1,326人の財務リーダーを対象に実施したFinance Trendsサーベイでは、63%が財務でAIを完全展開済みだが実質的な価値を見出しているのは21%にとどまり、14%がエージェントを完全統合済みだ(CFO Dive)。Thomson Reutersはエージェント型AIの採用が15%で、53%が検討中・計画中としている(Thomson Reuters)。DeloitteのQ2 2026 CFO Signalsでは、CFOの59%がリスクとの均衡を最大の課題に挙げ、51%がガバナンスの権限が不足していると答えている(Deloitte)。
開始前に数字を書き留めた90日間のパイロット
- ワークフロー一つとエンティティ一つを選ぼう。単一子会社の照合は、測定できない全社展開より優る。
- ツールが何も触れる前に2クローズ分のベースラインを測定する:費やした時間、例外件数、手戻り率、認証までの日数。
- コントローラーと外部監査人のエンゲージメントパートナーと書面で受入基準に合意し、日付を付ける。
- 週次でオーバーライド率を監視し、取引量と取引規模も監視する。これがCOSOの継続的モニタリング期待の中心にあるドリフトシグナルだ(Deloitte Heads Up)。
- 初日に終了基準を書いておく。例えば:90日時点で自動認証率が55%未満、または審査者のオーバーライドが3週連続で15%を超えた場合は停止し再交渉する。
その結果を数字とともに社内に公開しよう。実際の展開を文書化するチームのやり方で当ディレクトリが行っているように。AI ROIを何らかの形で追跡している組織はわずか18%だ(Thomson Reuters)。書面化したベースラインを一つ持つだけで、更新契約時に5人に4人の購入者より先を行くことができる。
よくある質問
2026年、AIは人間の審査者なしで記帳を行えるほど信頼できますか?
いいえ。現行のコントロールフレームワークは審査者を維持することを前提としている。KPMGは2026年の財務部門でのAI活用を75%(2024年は30%)としているが、完全な保証準備ができている組織は42%にとどまり、準備ができている企業はエラー削減改善を33%と報告、未準備の企業は6%だ(KPMG、2026年5月11日)。COSOの2026年2月ガイダンスは「設定したまま放置する」コントロールを明示的に不十分とし、代わりにモデルパフォーマンスの継続的なモニタリングを求めている(Deloitte Heads Up)。審査なしのアウトプットにはすでに価格がついている:DeloitteはAIが生成したエラーを含むレポートをめぐり、オーストラリア政府に6万ドル以上を返金した(CFO Dive)。
AI照合ソフトウェアからどのくらいの自動マッチ率が期待できますか?
スライドの数字ではなく、60%〜80%の自動認証を前提に計画しよう。照合ベンダーは「最大98%」の自動認証と99%のマッチ精度をマーケティングしているが、実際の顧客実績は43%〜85%の範囲に収まる(Numeric)。その率を受入基準に記載し、デモデータではなく自社の過去の台帳でパイロット中に測定し、取引ミックスが変化するにつれてマッチ品質もドリフトするため、3クローズ後に再測定しよう(COSOに関するDeloitte Heads Up)。
2026年2月のCOSOガイダンスは、財務報告で使用されるAIに何を求めていますか?
COSOは2026年2月23日に「Achieving Effective Internal Control Over Generative AI」を発行した。これは2013年の内部統制フレームワークをAIガバナンスへ正式に拡張した最初のものであり、GenAIのユースケースを8つの能力タイプ(取込み、変換、転記、オーケストレーション、判断、モニタリング、規制インテリジェンス、人間とAIの相互作用)に分類している(Journal of Accountancy)。運用上の要求は、ポイントインタイムの保証から継続的なモニタリングへの移行であり、モデルのドリフト検知のために取引量、取引規模、オーバーライド率などのKPIを使用する(Deloitte Heads Up)。実行するすべてのツールを能力タイプで分類し、各KPIの閾値を設定し、初日からオーバーライドをログに記録しよう。転記または判断のツールは、取込みツールよりはるかに重いコントロールの期待を担うからだ。
監査人は生成AIで作成したワーキングペーパーを受け入れますか?
アウトプットがどのように生成され、誰が確認したかを示せれば、受け入れてもらえる。PCAOBは生成AI基準を発行しておらず、監査証拠とリスク評価に関する既存基準がすでに十分性、適切性、レビュー可能性のバーを設定している(Fieldguide)。プロンプト、ツールが検索したソース文書、モデルとバージョン、日付、作成者と審査者の承認を保持し、モデルを再実行しなくてもワーキングペーパーが自立するようにしよう。質問はより厳しくなると予想される:PwCはPCAOBに対し、監査でのAIを最優先課題にするよう求めている(Big4 News)。
18%の組織しかROIを追跡していない中、AI財務ツールのROIをどう計算すればよいですか?
パイロット開始前にベースラインを取得しよう。後から再構築することはできない。2026年、何らかの形でAI ROIを追跡していることを把握していた専門家はわずか18%であり、2025年からほぼ変わらず、追跡している組織のほとんどがビジネス成果ではなく内部業務指標を測定している(Thomson Reuters、2026年2月9日)。そのギャップはDeloitteのFinance Trendsサーベイに現れている:1,326人の財務リーダーのうち63%が財務でAIを完全展開済みで、21%が実質的な価値をもたらしたと信じている(CFO Dive)。固定の期間で4つの数値を追跡しよう:クローズまでの時間、例外率、取引当たりのサイクルタイム、ツールが生み出すレビュー時間を含む完全コスト。KPMGの「財務リーダーの71%がAIはROI期待に応えているか上回っていると回答」という調査結果は期待値を測定しているため、自社の数字の代替にしないよう(KPMG)。
最初に自動化すべき財務ワークフローはどれですか?
経費分類とポリシーレビューだ。主な理由は、ベンダーが精度の数字の意味を公表している唯一のワークフローだからだ:Rampは99%以上の精度で手動レビューを約85%削減したと報告しており、精度をエージェントが推奨した承認のうち人間の審査者も承認したもの、2025年7月1日付けの内部分析として定義している(Ramp)。照合は2番目だ。達成可能なマッチ率はマーケティングの数値を大きく下回り、自社データでの有償パイロットが必要だ(Numeric)。予測は後回しにしよう:1B+ドル企業のCFOの44%がすでに計画・予算編成にAIを利用しているが(Deloitte Q2 2026 CFO Signals)、精度向上はセクターによって大きく異なり、銀行の71%からヘルスケアの44%まで幅がある(KPMG)。デモを見る前に絞り込もう。当ディレクトリだけで550のAIエージェントを掲載しており、コントロールされた決算のために設計されたものはほとんどない。