

出力が凡庸なのは、入力が肥大化・陳腐化しているか、順序が悪いからです。プロンプトの言い回しの問題ではありません。Anthropic自身のドキュメントにも明記されています:「コンテキストが多ければ自動的に良くなるわけではない。トークン数が増えると精度と再現率が低下する——これはコンテキスト腐食と呼ばれる現象だ」(Claude Platformドキュメント)。コンテキストエンジニアリングはその解決策であり、Anthropicはそれを「LLL推論時にトークン(情報)の最適なセットをキュレーションすること」と定義しています(Anthropic Engineering)。
数字は最大化主義的な習慣に厳しい。NoLiMaベンチマークでは、128K以上のコンテキストを公称している13モデル中11モデルが、32Kトークンで短コンテキストスコアの半分以下に落ちました(arXiv:2502.05167)。
これは、エージェントフレームワークを構築するのではなく、ChatGPT、Claude、Gemini、Copilotを使う人向けのプレイブックです:どのツールで、どのノブを回せばよいか、そしてその効果について解説します。
コンテキストエンジニアリングがプロンプトマジックに取って代わった
出力が凡庸なら、プロンプトの言い回しが原因であることはほとんどありません。コンテキストエンジニアリングはこれを解決する実践であり、Anthropicはそれを「LLM推論中に最適なトークン(情報)のセットをキュレーション・維持するための戦略群(プロンプト以外からウィンドウに入る情報も含む)」と定義し、プロンプトエンジニアリングの自然な発展形と位置づけています(Anthropic Engineering)。問いは「どう言葉にするか」から「どんなコンテキスト構成がモデルの望ましい動作を最も引き出しやすいか」へと移りました。
「どう言葉にするか」から「ウィンドウに何を入れるべきか」へ
言い回しは細部では依然として重要です。ただし、それがレバレッジを持つ場所ではなくなっています。肥大化した半関連ウィンドウに対する完璧な言い回しの質問は、クリーンなウィンドウへの直截的な質問に負けます。この記事の残りはほぼその主張の証拠です。
私たちが追跡している212のプロンプトエンジニアリングツールのほとんどは、あなたが入力する文章を最適化します。ウィンドウを共有している他の5つの要素に触れるものはほとんどありません。
実際にコントロールできる5つの入力
すべてのリクエストは、見える・変更できる部品からウィンドウを組み立てます:
- システム指示:カスタムGPTのinstructionsフィールド、ClaudeプロジェクトのDescription、リポジトリのCLAUDE.mdファイルなど。
- メモリ:製品がセッションをまたいであなたについて保存した内容(通常、全文は表示されない)。
- 添付ドキュメントとそのパース品質。これがスタック全体で最も過小評価されている変数です。
- 取得チャンク(ツールが取得を行う場合)、および取得器が関連性ありと判断したもの。
- 会話の過去のターン(20メッセージ前に放棄したすべての行き詰まりを含む)。
- ツール定義:ツールが呼ばれるかどうかにかかわらずトークンを消費します。
これで6つになりますが、すべて製品UIからコントロールできます。フレームワークもAPIキーも不要です。
つまりこれは入力側のプレイブックです。ChatGPT、Claude、Gemini、Copilotをエージェントシステム構築ではなく利用する人向けに書かれています。どのツールで、どのノブを回すか、そして2026年の数字がそれをどの程度価値あるものと示しているかを解説します。
AIコンテキストウィンドウの解説:公称サイズと実際に使えるサイズ
スペックシートの数値はストレージ制限であり、パフォーマンス保証ではありません。100万トークンを受け付けるモデルは喜んでそれを受け取り、3,000トークン時より悪い回答をします。公称ウィンドウは部屋の天井であって、作業できる机のサイズではありません。
実際にウィンドウを消費するもの
思っている以上に多くあります。APIリクエストのあらゆる部分が同じバジェットを占有します:システムプロンプト、ツール結果を含むすべてのメッセージ、画像やPDF、ツール定義そのもの、そして拡張思考を含むモデル自身の出力(Claude Platformドキュメント)。キャッシュされたプレフィックスもウィンドウを占有します。プロンプトキャッシュはそれらのトークンに対する支払いを変えるだけで、カウントされるかどうかは変わりません。
つまり、短く感じる会話でも、見えない添付PDF・ツールスキーマ・過去の推論で40,000トークンを抱えている場合があります。これが百科事典のページが省略している部分です。
スペックシートに載らない32Kの崖
NoLiMaベンチマークは、質問と答えの間の文字通りの単語の重複を排除してから、128K以上のコンテキストを公称する13モデルを実行しました。1K未満のトークンでは問題なかったものの、32Kでは13モデル中11モデルが自身の短コンテキストベースラインの半分以下に落ち、Llama 3.1 70Bは94.3%から42.7%に低下しました(NoLiMa、arXiv:2502.05167)。このプレプリントは2025年2月のものであり、下の表のすべてのモデルより前のものです。この発見の形は新しい研究でも維持されていますが、具体的なパーセンテージは現在のスコアカードではなく古い証拠です。
現在のウィンドウの実態(2026年の数値)
| モデル | コンテキストウィンドウ | 最大出力 | リクエストあたりの画像/PDFページ数 |
|---|---|---|---|
| Claude Fable 5.1、Opus 5、Sonnet 5(およびMythos 5.1、Opus 4.8/4.7/4.6、Sonnet 4.6) | 1Mトークン、デフォルト、標準料金 | 128k | 600 |
| Claude Sonnet 4.5以前 | 200k | — | 100 |
| OpenAI GPT-5.4 | 1,050,000トークン | 128,000 | — |
Anthropicは1Mウィンドウをベータヘッダーなし・追加料金なしで提供しています(Claude Platformドキュメント)。OpenAIは名目上より大きく、異なる料金体系です:GPT-5.4で272Kの入力トークンを超えると、セッション全体が入力2x・出力1.5xで請求されます(OpenAI APIドキュメント)。肥大化は品質の問題だけでなく、請求書の項目になります。
ベンダー間でキャパシティを比較する場合は、まとめ記事ではなくモデル自身のスペックページを確認してください:ウィンドウは2026年だけで2回変更されており、古い表はあちこちにあります。当ディレクトリの324のAIモデルが適切なページを見つける出発点になります。
コンテキスト腐食:増やすほど出力が悪化する理由
劣化にはメカニズムがあり、謎ではありません。トランスフォーマーはnトークン全体でn²のペアワイズ関係をモデル化する必要があるため、トークンを追加するごとに他のすべてのトークンがモデルのアテンションをより激しく奪い合います。Anthropicのエンジニアリングチームはこれを有限なアテンションバジェットと呼び、人間のワーキングメモリに例えています。コンテキストが増えるとアテンションが「薄く引き伸ばされる」と述べています。彼らの処方は明快です:「望む結果の可能性を最大化する、最小限の高シグナルトークンのセットを見つけること。」
アテンションバジェットの問題
Anthropic自身のプロダクトドキュメントは、取り繕わずにこの点を認めています。「コンテキストが多ければ自動的に良くなるわけではない」とプラットフォームドキュメントは述べています。「トークン数が増えると、精度と再現率が低下する——これはコンテキスト腐食と呼ばれる現象だ。」1Mトークンウィンドウを売っているベンダー自身が、それを埋めないように言っているわけです。
同じ質問、同じ答え、375倍のノイズ
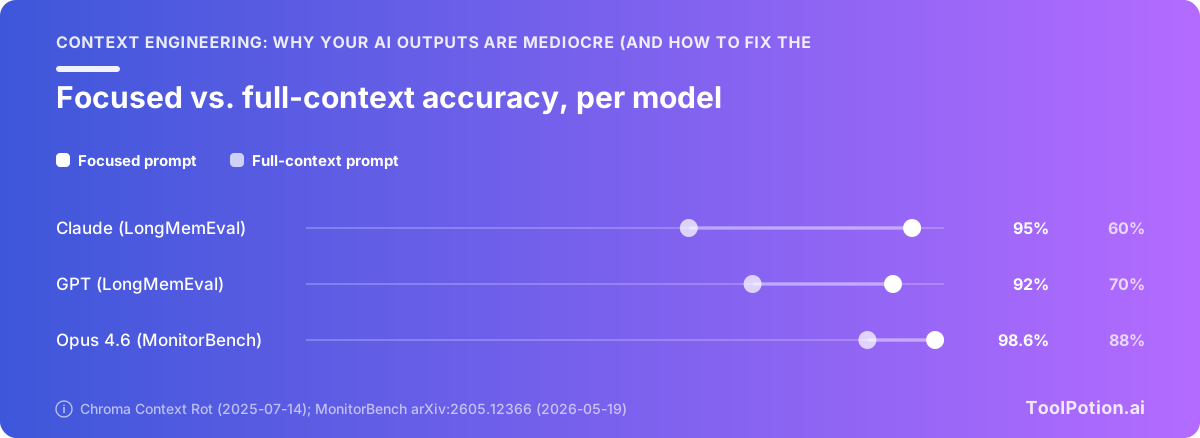
ChromaはGPT-4.1、Claude 4、Gemini 2.5、Qwen3を含む18モデルをテストし、取得や単語の複製といった単純なタスクでも、入力が長くなると信頼性が低下することを発見しました(Chroma)。LongMemEvalの実行が最も記憶に値します。すべてのモデルファミリーが、全会話履歴を持つ約113kトークンのフルプロンプトよりも、関連するターンだけを含む約300トークンの集中したプロンプトで大幅に良い結果を示し、Claudeモデルが最も大きな差を見せました。同じ質問。同じ答えが両方のコンテキストに存在していました。唯一の変数は、その周囲にある無関係な素材の量でした。
Chromaはさらに、モデルが論理的に一貫したドキュメントよりシャッフルされたヘイスタックでより良いスコアを出すことを発見しました(18モデル全体で)。一貫した周辺テキストはモデルに、もっともらしく見える着地点をより多く与えます。このレポートは2025年7月14日に公開されており、1年以上前のもので、現在のモデル世代より前です。
この効果は時代遅れではありません。MonitorBenchでは、800kトークンの無害で無関係なアクションを先頭に付加することで、Opus 4.6の再現率が98.6%から88%に低下しました(arXiv:2605.12366)。タスク自体は何も変わっていません。パディングだけが変わりました。
通常の使用でどこに問題が出るか
これはすでに名前をつけずに経験しているはずです。メッセージ12であなたのブリーフを完璧にこなし、メッセージ90では当たり障りのない内容を生成するチャット——ブリーフが78のメッセージの下に埋もれているからです。徹底さのために40のソースを追加したNotebookLMノートブックで、8つの時よりも曖昧な答えが返ってくる場合。1時間前に述べた制約をモデルが忘れ、自信を持って書き直してしまうコーディングセッション。
それはモデルが怠惰になっているわけではありません。あなたがアテンションバジェットを、居場所を稼げないトークンに費やしているのです。
ドキュメント準備:ほぼ全員がスキップするステップ
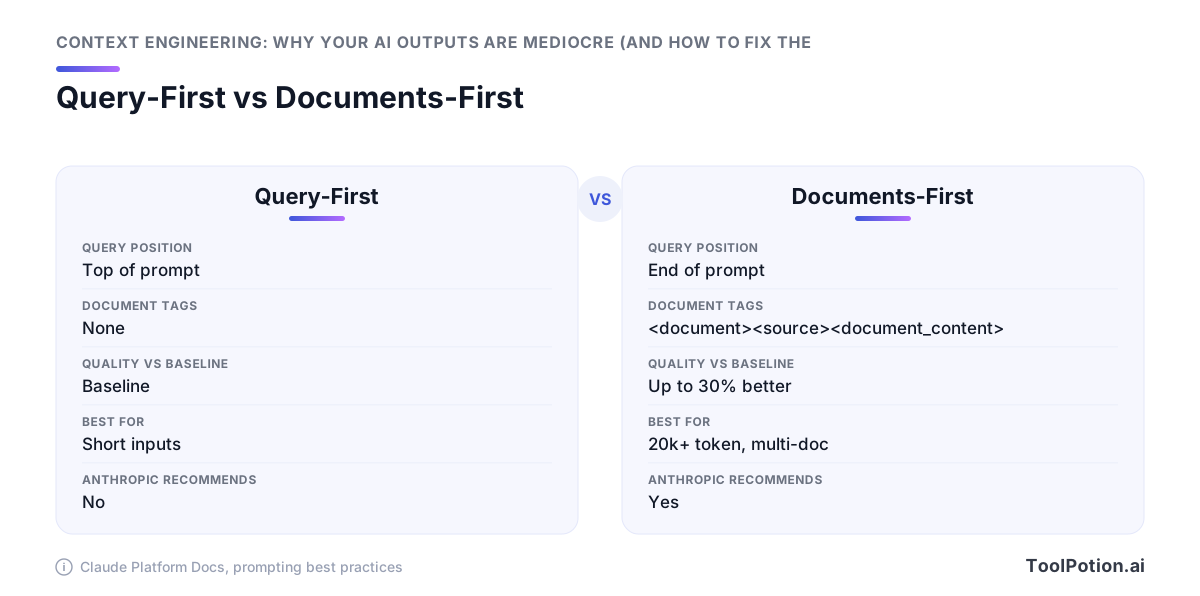
プロンプト内のどこにドキュメントを置くかで、返ってくる答えが変わります。20,000トークンを超える入力に対して、Anthropicのプロンプトドキュメントでは、クエリ・指示・例の上に長いデータを置くよう指示しています:「最後にクエリを置くと、特に複雑な複数ドキュメントの入力において、テストで最大30%の応答品質向上が見られた」(Claude Platformドキュメント)。ほとんどの人は逆をやっています:質問を入力してから、その下にレポートを貼り付ける。
長いものは上に置く
同じドキュメントでは、そのまま使える足場が示されています:各ドキュメントを<document>タグで囲み、<source>と<document_content>のサブタグを使うことで、モデルが一つのファイルの終わりと次のファイルの始まりを判別できます(Claude Platformドキュメント)。そして答える前に関連する箇所を引用するよう指示します。この一行によって、モデルは半分覚えている内容を再構成するのではなく、テキスト内の証拠を見つけることを強制され、答えが間違っているように見えた場合に確認できるものが得られます。
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
ソースにタグをつけてモデルが引用できるようにする
これを標準化する前に一つ注意点があります:ベンダーの意見は一致していません。Anthropicは長いデータを先に置きますが、Googleのガイダンスは反対で、指示を最後に置くよう指示しています。そのため、GeminiチュートリアルからコピーしてClaudeに貼り付けたプロンプトテンプレートは、壊れて見えずにパフォーマンスが低下することがあります。実際に支払いをしているモデルに対して、同じドキュメントセットを両方の順番で10問ずつ試し、勝った順番を採用してください。主張されている30%の差に対して、20分の作業です。
パーサーの選択がモデルの見るものを決める
これはいずれも、壊れた抽出を救いません。1行のランダムな文字列として出力されたスキャンした請求書のテーブル、行ごとに混在する2段組みの論文、文の途中に挿入された脚注:モデルはそのゴミを忠実に読んで、それを基に回答します。あなたの抽出ステップが精度の上限を決め、その後のすべてはそれによって制限されます。パーサーを品質の決定として扱い、確定する前に最も読みにくい実際のファイルで2〜3つテストしてください。当ディレクトリには217のAIドキュメント・PDFツールが掲載されており、良いものと悪いものの差はあなたの出力に現れます——マーケティングページではなく。
取得の品質管理:少数の良質なチャンクが多数のチャンクに勝る
取得レイヤーを構築する前に、本当に必要かどうか確認してください。Anthropic自身のガイダンスでは、ナレッジベースが200,000トークン(約500ページ)未満であれば、取得なしでプロンプトに全体を含めるだけで良いとしています(Anthropic Engineering)。ほとんどの社内wiki、製品ハンドブック、ポリシーセットはこの範囲に収まります。
そもそも取得が必要か?
コーパスが収まるなら、ベクターデータベースをスキップしてください。チャンキングの決定、埋め込みのドリフト、適切な段落がプロンプトに入らないというサイレントな失敗のクラス全体を避けられます。同じ200kトークンを毎回フル料金で支払わないよう、プロンプトキャッシュと組み合わせてください。
このサイズを超えると取得は必須になり、品質は積み重なる小さな修正のスタックになります。
積み重なる3つの修正
Anthropicはそれぞれを個別にベンチマークしました。埋め込み前に各チャンク固有のコンテキストを先頭に付加することで、上位20の取得失敗が5.7%から3.7%に減少し、約35%の削減となりました。コンテキスト対応BM25ハイブリッド検索を追加すると失敗が2.9%になり、49%の削減。さらにリランクパスを重ねると1.9%になり、67%の総削減となりました(Anthropic Engineering)。各ステップは単独では地味ですが、3つ合わせると最初の改善の約3倍の効果があります。
ツール定義のトリミングも重要
ツールスキーマはコンテキストです。40のツール定義をモデルに渡して2つしか必要ない場合、38の気散らしの対価を払っています。RAG-MCPの研究では、全ツールを列挙する代わりに関連するスキーマだけを取得し、プロンプトトークンを半分以上削減しながら、ツール選択の精度が13.62%から43.13%に向上しました(arXiv:2505.03275)。これはチャンク選択と同じ規律を、1層上に適用したものです。
Anthropicのサブエージェントパターンはさらにそれを拡張します:専門エージェントが調査を行い、約1,000〜2,000トークンの凝縮されたサマリーを調整エージェントに返すことで、メインのコンテキストが生の検索トランスクリプトを見ることがなくなります(Anthropic Engineering)。コンポーネントを選ぶ段階であれば、当ディレクトリには550のAIエージェントと、これらのパターンをすぐに実装できる取得・エージェントフレームワークのセットが掲載されています。
メモリ機能:各ツールで回すべきノブ
すべての消費者向けAI製品は、あなたが入力しなかったものをコンテキストに注入するようになっています。保存された事実、過去のチャット、アプリのアクティビティ、アップロードされたプロジェクトファイル。チャットアプリでコンテキストエンジニアリングを行うには、最初の言葉を入力する前にウィンドウに何が既に入っているかを把握する必要があります。
誤ったメモリはメモリなしよりも高コストです。モデルが事実として扱う、高シグナルに見えるテキストであり、アテンションが最も強い指示の近くに位置します。古い肩書き、旧クライアント名、一度限りのタスクのために設定した好み:それぞれがその後のすべての回答を静かに偏らせます。
ChatGPT:独立した2つのトグル
ChatGPTのメモリは1つのメカニズムではなく2つです。保存されたメモリは個別に読み取り・削除できる離散した保存された事実であり、チャット履歴参照は別の取得パスを通じて過去の会話から引き出します(Embrace The Red)。一方をオフにしてももう一方は動き続けます。保存されたメモリをクリアした後も出力が先月のプロジェクトの匂いがするなら、見逃していたのは履歴のトグルです。
Claude:プロジェクトナレッジと会話中のメモリ書き込み
2026年8月25日のCowork統合以降、Claudeはセッション境界だけでなく会話中にもメモリを書き込むようになりました。つまり、チャットでのさりげない一言が後のセッションに持ち込まれます(TechCrunch)。
プロジェクトナレッジの方が優れたレバーです。なぜなら、あなたが選んだコーパスだからです。Anthropicの目安である200,000トークン(約500ページ)以下に抑えれば、どのチャンクが重要かを推測する取得レイヤーなしに全体を含められます(Anthropic)。アーカイブとしてではなく、読書リストとして整理してください。
Gemini:「オフ」が「削除」ではない3つの重複するシステム
Geminiは個人コンテキスト、自分で書いた保存情報、接続されたGoogleアプリのアクティビティを重ねています。ソースを無効にすると新しい書き込みが止まります。既に保存されているものは削除されないため、監査は各コントロールを個別に訪問して削除することを意味します——単にオフにするだけではありません。
NotebookLM:ソース制限のある代替手段
NotebookLMはノートブックが保持できるソース数を制限しており、この制限はあなたに有利に働きます。他の3つが省略させるキュレーションを強制することで、Anthropicが規定するのと同じ規律が実現します:望む結果を得る最小限の高シグナルトークンのセットを見つけること(Anthropic)。質問に必要なのが80でなく8つのドキュメントであれば、そこから始めてください。
メモリを持つアシスタントとして1つのツールを選び、残りはクリーンに保ってください。当ディレクトリの13,174のAIアプリの中で、メモリを項目ごとに監査できるものは、すべてを覚えると約束するものよりも価値があります。
プロジェクトレベルの指示は再利用可能なコンテキスト
あなたが書く中で最もコスト効率の良いコンテキストは、一度だけ書くコンテキストです。すべての本格的なAIツールには、すべてのセッションに注入される常設指示のスロットがあります:リポジトリのAGENTS.mdとCLAUDE.md、Claudeプロジェクト、ChatGPTカスタム指示、Copilotの指示ファイル。ほとんどの人はそれらのスロットを空のままにして、毎回の新しいチャットで同じ3段落の背景情報を再入力しています。
常設指示ファイルが再説明に勝る理由
10のリポジトリと124のプルリクエストにわたる研究が、リポジトリレベルのAGENTS.mdファイルがエージェントの動作に何をするかを測定しました。結果は正確さだけの話ではありません。中央実行時間が28.64%短縮し(98.57秒から70.34秒へ)、同等の完了率で出力トークンが16.58%減少しました(arXiv:2601.20404)。エージェントはあなたがすでに知っていることを把握するための探索をしなくなりました。
これが一言での論拠です。良い常設コンテキストはモデルを正確にするだけでなく、速くてコスト効率の良いものにします。エージェントがトークンを費やすことの大半は、あなたの慣習を再発見することだからです。当ディレクトリの260のAIコーディングアシスタントの中から選ぶなら、ツールがプロジェクト指示ファイルを読むかどうかは、ほとんどの機能比較よりも良いフィルターです。
実際に含めるべきもの
自分で読もうと思えるくらい短くしてください。5つのことが居場所を稼ぎます:
- コードが明示しない慣習:どのテストランナーが実際に使われていて、どれが使われていないか。
- あなたのボキャブラリー。「account」と「tenant」がここでは異なる意味を持つなら、一度明記してください。
- 欲しい出力の形式:diff、テーブル、5箇条書きなど、望む形式で。
- 短い禁止リスト。生成されたファイルには触れない、依存関係は聞かずに追加しない。
- 真実のソースがどこにあるか——エージェントが推測する代わりにそこを参照できるように。
ツール自身が読める情報は省いてください。ディレクトリツリー、ファイル一覧、関数シグネチャの再記述、READMEのサマリー。これらはエージェントが1回の呼び出しで取得できるものを複製するために費やされるトークンであり、重要な指示とアテンションを奪い合います。無視され始めたらファイルを書き直してください——通常それは長くなりすぎたことを意味します。
コンテキストの肥大化には価格がついている
雑なコンテキストは出力品質だけでなく、請求書にもコストをもたらします。2つの料金体系がそれを具体化しており、どちらも同じ規律を報います:安定した小さな順序付けされたプレフィックス。
GPT-5.4の272Kステップ関数
OpenAIのGPT-5.4は1,050,000トークンのコンテキストウィンドウと最大128,000出力トークンを持ちますが、272Kの入力トークンを超えるプロンプトは「セッション全体が入力2x・出力1.5xで請求される」と規定されています(OpenAI APIドキュメント)。これを慎重に読んでください。ラインを一度越えると、超過分だけが少し高くなるのではありません。セッション全体が再価格設定され、出力も含まれます。そのため、300Kトークンのダンプを不注意に1度貼り付けると、その後のすべてのターンで入力代金が倍になります。
最も答えを劣化させているトークンに、倍の料金を支払うことになります。
キャッシュは安定したプレフィックスを報いる
Claude APIはキャッシュ読み取りを基本入力の0.1xで価格設定しており、90%の割引となります。一方、キャッシュ書き込みは5分TTLで1.25x、1時間TTLで2xのコストがかかります(Claude Platformドキュメント)。計算例:10万トークンを10回再利用すると$1.075で、キャッシュなしの$5.00に対して78.5%の節約になります。
この割引はプレフィックスがバイト単位で一致する場合にのみ適用されます。キャッシュは正確なプレフィックスをキーにするため、ドキュメントの順序を変えたり、システムプロンプトにタイムスタンプを追加したり、ターン間でツール定義をシャッフルしたりすると、読み取り価格の代わりに書き込み価格が再度かかります。キャッシュを温かく保つ習慣は、再現率を高く保つ習慣と同じです:安定した素材を固定された順序で先頭に置き、クエリだけを最後に変える。
今週実施できるコンテキスト監査
ここに挙げるものはAPIキーもエンジニアリングチケットも必要ありません。すべてあなたが既に持っているノブです。
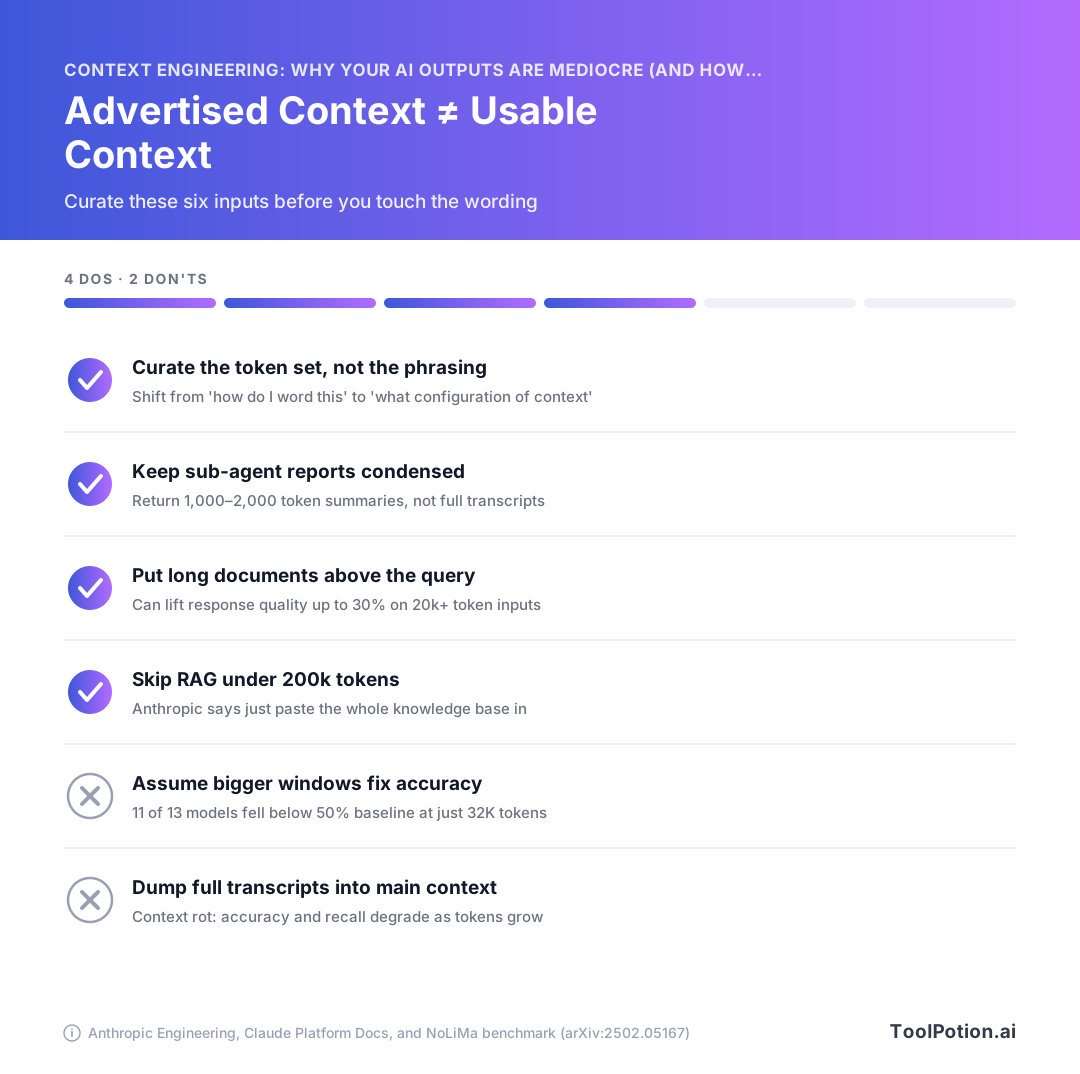
次の長いセッションの前に行う6つのチェック
- 昨日のチャットを延長するのではなく、新しいチャットを開く。Chromaの集中したプロンプト(関連するターンの約300トークン)は、テストしたすべてのモデルファミリーで113kトークンの全履歴を上回り、Claudeが最も大きな差を示しました(Chroma)。
- 保存されたメモリを読んで、古くなったものを削除する。保存された事実は、役立つかどうかにかかわらず注入されます。
- 12の粗悪なドキュメントではなく、3つの良質なドキュメントを添付し、各ドキュメントを
<document>タグと<source>サブタグで囲んでモデルが区別できるようにする(Claudeドキュメント)。 - 長い素材をクエリの上に置く。20k以上のトークン入力では、Anthropicのテストでその順序付けが最大30%良い応答をもたらします(Claudeドキュメント)。
- 常設指示を一度書き留める。リポジトリレベルのAGENTS.mdは124のPR全体で中央実行時間を28.64%、出力トークンを16.58%削減しました(arXiv)。
- そのプレフィックスをターン間で同一に保つ。安定したプレフィックスは入力価格の0.1xでキャッシュにヒットします(Claudeドキュメント)。
ほとんどの悪い出力を改善する1つの習慣
プロンプトを書き直す前に、ウィンドウに既に何が入っているかを見て、何かを取り出してください。Anthropic自身のドキュメントにも書かれています:「コンテキストが多ければ自動的に良くなるわけではない」(Claudeドキュメント)。尋ね方を変える前に、モデルに何を与えるかを変えてください。
よくある質問
コンテキストエンジニアリングとは何ですか?プロンプトエンジニアリングとどう違いますか?
Anthropicはコンテキストエンジニアリングを「LLM推論中に最適なトークン(情報)のセットをキュレーション・維持するための戦略群(プロンプト以外からウィンドウに入る情報も含む)」と定義しています(Anthropic Engineering)。プロンプトエンジニアリングはリクエストをどう言葉にするかを問います。コンテキストエンジニアリングは、望む動作を最も引き出しやすいコンテキストの構成を問い、ウィンドウを占有するすべてをカバーします:システムプロンプト、ツール結果を含むすべてのメッセージ、画像やPDF、ツール定義そのもの、拡張思考を含むモデル自身の出力(Claude Platformドキュメント)。Anthropicはこれをプロンプトエンジニアリングの代替ではなく、自然な発展形として位置づけています。
コンテキストウィンドウが大きいほど、AIの出力は常に良くなりますか?
いいえ。公称コンテキストと使えるコンテキストは異なる数値です:NoLiMaベンチマークは128K以上のサポートを公称する13モデルをテストし、32Kトークンで13モデル中11モデルが自身の短コンテキストベースラインの半分以下になり、Llama 3.1 70Bは94.3%から42.7%に落ちました(arXiv:2502.05167、2025年2月)。Anthropic自身のプラットフォームドキュメントも率直に述べています:「コンテキストが多ければ自動的に良くなるわけではない。トークン数が増えると精度と再現率が低下する」(Claude Platformドキュメント)。ウィンドウを埋めることは直線的ではなくステップ的にコストを増加させます。OpenAIはGPT-5.4で272Kの入力トークンを超えるプロンプトをセッション全体で入力2x・出力1.5xで請求するからです(OpenAI APIドキュメント)。
コンテキスト腐食とは何ですか?どうすれば避けられますか?
コンテキスト腐食は、リクエスト内のトークン数が増えるにつれて精度と再現率が低下することであり、Anthropicが自社ドキュメントで名付けています(Claude Platformドキュメント)。ChromaのContext Rot研究はGPT-4.1、Claude 4、Gemini 2.5、Qwen3を含む18モデルをテストし、取得や単語の複製といった単純なタスクでも入力が長くなると信頼性が低下することを発見しました。LongMemEvalテストでは、すべてのモデルファミリーが約113kトークンの会話履歴に埋もれた同じ質問よりも、約300トークンの集中したプロンプトで良い結果を出し、Claudeモデルが最も大きな差を示しました(Chroma、2025年7月)。回避するには、重要な部分だけを貼り付け、新しいトピックには古いチャットを延長するのではなく新しいチャットを開始し、専門エージェントに全トランスクリプトではなく凝縮された1,000〜2,000トークンのサマリーを調整エージェントに返させてください(Anthropic Engineering)。
ChatGPT、Claude、Geminiのメモリをオフにすべきですか?
タスクによります。メモリはあなたが選ばなかったトークンをウィンドウに注入するからです(Claude Platformドキュメント)。モデルがあなたの役割・スタイル・スタックを知っていることで再入力の手間が省ける日常的な下書きには、オンのままにしてください。特定ドキュメントの高度な分析には、メモリをオフにして新しいチャットを開始してください。Chromaはすべてのモデルファミリーが約113kトークンの無関係な履歴に囲まれた同じ答えよりも、約300トークンの集中したプロンプトから良い答えを出すことを発見しました(Chroma)。メモリをすべてのターンで支払いをしている常設プロンプトとして扱い、システムプロンプトを整理するように整理してください。
RAGが必要ですか?それともドキュメントをプロンプトに貼り付けるだけで良いですか?
Anthropicのガイダンスでは、小規模では取得は不要なことが多いとされています:「ナレッジベースが200,000トークン(約500ページ)未満であれば、ナレッジベース全体をプロンプトに含めるだけで良い」(Anthropic Engineering、2024年9月)。それを超えると、取得の品質管理がAnthropicのベンチマークで積み重なります:埋め込み前にチャンク固有のコンテキストを先頭に付加すると上位20の取得失敗が5.7%から3.7%に削減され、コンテキスト対応BM25ハイブリッド検索を追加すると2.9%に、リランクパスを加えると1.9%と67%の総削減になります。コーパスが収まるなら、貼り付けがより良いデフォルトであり、プロンプトキャッシュにより再利用が基本入力の0.1xのキャッシュ読み取り価格で安くなります(Claude Platformドキュメント)。
プロンプト内の長いドキュメントはどこに置くべきですか——質問の前ですか後ですか?
Claudeでは、長いデータをクエリ・指示・例の上に置いてください。Anthropicのプロンプトドキュメントでは、これを20k以上のトークン入力に対する具体的なルールとして挙げており、「最後にクエリを置くと、テストで特に複雑な複数ドキュメントの入力において最大30%の応答品質向上が見られる」と述べています(Claude Platformドキュメント)。同じドキュメントでは、各ドキュメントを<document>タグと<source>・<document_content>サブタグで囲み、答える前に関連する箇所を引用するようモデルに指示することを推奨しています。ベンダーは順序について一致していないため、あるプロバイダーのクックブックからコピーしたテンプレートは別のモデルでパフォーマンスが低下することがあります。自分のタスクで両方の順序を一度試す価値があります。