

マルチモーダルパイプラインが失敗するのは、モデルが幻覚を起こすからではありません。SoraのダウンロードURLがレンダリング完了から61分後に期限切れになるか、90分間のポッドキャストがOpenAIの25MBの文字起こし上限に引っかかるからです。一方、AssemblyAIなら最大5GBのファイルを一回のリクエストで処理できます。
モデル間の各ホップには契約が存在します:正確なファイル形式、それを解放するプランティア、有効期限、そしてベンダーがモデルを廃止したときのフォールバックです。多くのガイドはこの四つをすべて省略しています。
本記事では、その契約、三つの実際のパイプライン、そしてOpenAIがVideos APIと両Sora 2モデルを2026年9月24日に後継モデルなしでシャットダウンする前に必要なスワッププランを提供します。あと19日です。
マルチモーダルパイプラインがモデルではなくハンドオフで壊れる理由
チェーン内の各モデルは正常に動作しています。文字起こしは正確で、画像は正しく、音声は人間らしく、動画はレンダリングされます。壊れるのは、あるモデルの出力が次のモデルの入力になる瞬間です。その出力がどんな形式であるべきかを誰も書き留めていないのです。
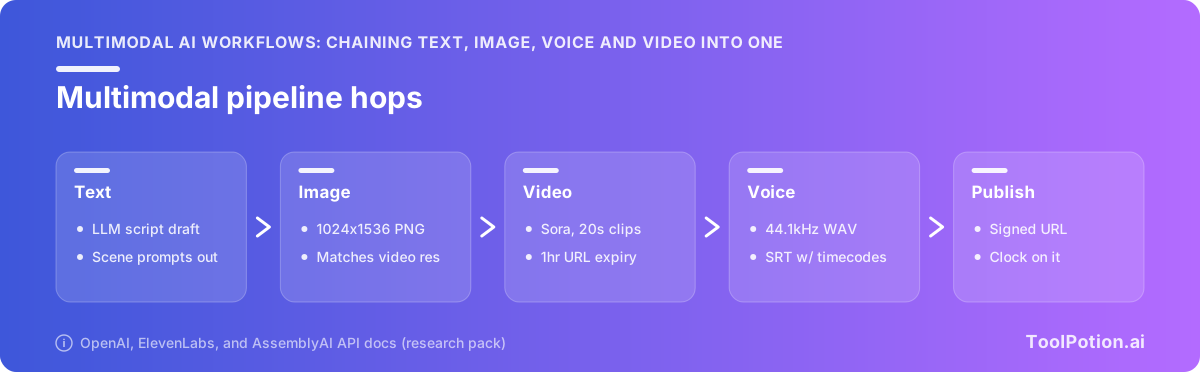
具体的な例として:Soraが生成したアセットのダウンロードURLは生成後最大1時間しか有効ではなく、出力はMP4にWebPサムネイルとJPGスプライトシートが付いて届きます(OpenAI)。パイプラインがレンダリングをキューに入れ、90分後にコピーステップに到達したとき、レンダリングはすでに消えています。モデルは完璧に仕事をしていたのです。
ハンドオフ契約:形式・ティア・有効期限・フォールバック
各ホップを、構築前に書き留める四つの条件を持つ契約として扱ってください。
「形式」とは、次のホップが要求する正確なファイル仕様です。アスペクト比と期待だけでなく、サンプリングレートやピクセル寸法まで含みます。「ティア」とは、その形式を解放するプランレベルまたは単一のAPIパラメーターです。必要な形式の多くは有料サブスクリプションや旧モデル名の背後にゲートされています。「有効期限」とは、損失があなたの責任になる前に、ベンダーからアーティファクトを取得できる期間です。「フォールバック」とは、ベンダーがモデルを廃止したときに差し替えるものです。これは今や仮定の話ではありません。
ホップごとにこの四行を書けば、デバッグの大半は開始前に消えます。
パイプラインを実行中に止める四つの障害モード
- 上流ホップが、下流ホップがサイレントにダウングレードするか完全に拒否する形式を出力する。
- APIにあると思い込んでいた機能が、上位プランティアや旧モデルバージョンの背後に隠れている。
- ジョブがキューに入っている間に、ベンダーのストレージでアーティファクトが期限切れになる。
- 構築したモデルにシャットダウン日が設定され、ベンダーが推奨代替モデルを挙げていない。
以下に示す三つのパイプラインは、すべて同じ契約のインスタンスです:ポッドキャストからショーノート、スクリプトからナレーション付き動画、製品写真からキャンペーンセット。それぞれが各ホップで形式・ティア・有効期限・フォールバックを明示しています。
これは成果物を出荷する人のために書かれており、フュージョンアーキテクチャを比較するためではありません。個々のツールはディレクトリ内の18,982のアクティブなAIツールから選べます。それらを接続する部分が誰も文書化しない箇所です。
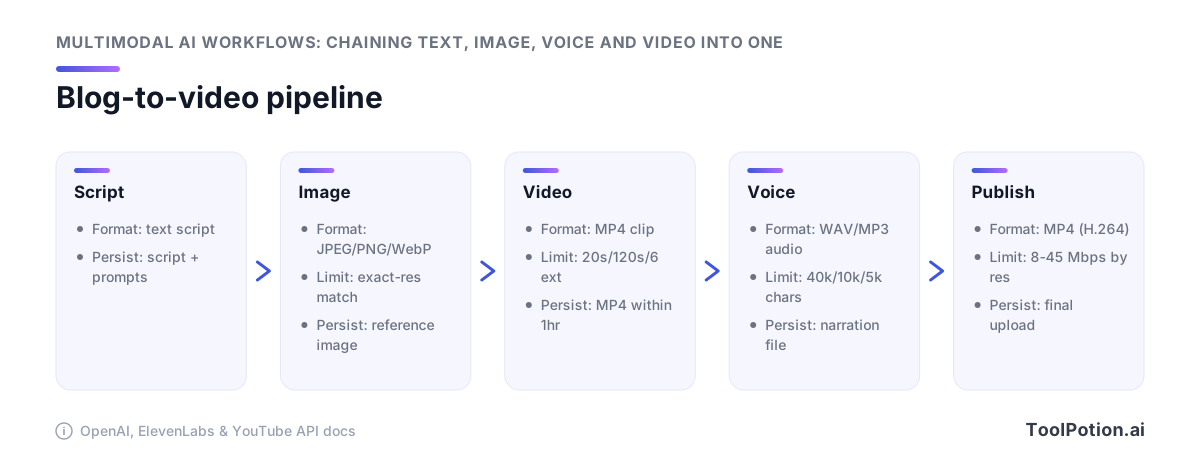
パイプライン1:ブログ記事からナレーション付き動画へ
1,200語の記事から2分間のナレーション付き動画を生成します。四つのホップ:テキストの分割、静止画の生成、アニメーション化、ナレーションの追加。これらのホップには、前のホップが満たすべき仕様があり、そのほとんどはAPIコールを一つも行う前に設定します。
生成コールの前のスクリプトセグメンテーション
セグメンテーションは最後に行うフォーマットステップではありません。選択した音声モデルがリクエストごとに送信できる量を制限するため、下流のすべてに継承されるパラメーターです。Eleven Flash v2.5は40,000文字、Multilingual v2は10,000文字、v3は5,000文字で停止します(ElevenLabs)。表現力豊かなナレーションのためにv3を選ぶと、1,200語のスクリプトは一回のコールで収まります。9,000語の解説動画で選ぶと、二つにチャンクし、隠さなければならない継ぎ目ができます。
シーンの境界でセグメント化してください。文章の数ではありません。各セグメントには一つの視覚的なアイデア、秒単位の目標デュレーション、そしてメタデータとして付与する目標ピクセル解像度が必要です。この最後のフィールドを画像ホップが読み取ります。
画像ホップ:動画ホップの正確なピクセル寸法に合わせる
Soraの画像から動画へのパスでは、参照画像がターゲット動画解像度に正確に一致し、image/jpeg、image/png、image/webpのいずれかである必要があります(OpenAI)。「正確に」とはピクセルのことであり、「16:9」ではありません。ワイドスクリーンの静止画を生成するよう指示された画像ジェネレーターは、動画コールが1280x720を要求しているときに1792x1024を喜んで返し、ジョブはレンダリング時ではなくサブミット時に失敗します。そのため、画像プロンプトテンプレートには動画ホップの設定から取得したリテラル整数として幅と高さが含まれており、他のものをキューに入れる前に返されたファイルの寸法とMIMEタイプを検証します。ディレクトリで追跡されている324のAIモデルの中で、名前付きプリセットではなく任意のピクセル寸法を指定できるものが、ここで接続する価値のあるモデルです。
動画ホップ:16秒と20秒のクリップをチェーン化
sora-2とsora-2-proはどちらも16秒または20秒のクリップを生成します。各拡張で最大20秒が追加され、最大6回の拡張で合計120秒が上限です(OpenAI)。2分のセグメントは6回のチェーン化されたコールになります。
この六つにわたる連続性はあなたの責任です。モデルは拡張3と拡張4の間のナラティブの流れを記憶していないため、各コールのプロンプトには設定・対象・カメラの動作を再度記述する必要があります。継ぎ目のリトライにかかるコストも見込んでおいてください。
音声ホップとミックスダウン
動画ごとではなく、セグメントごとにナレーションを生成してください。そうすれば失敗したテイクのコストは一回のコールで済みます。次にアライン:セグメント4の音声はセグメント4でレンダリングした20秒のクリップに収まる必要があり、通常はオーディオをタイムストレッチするのではなくスクリプトのコピーをトリミングすることを意味します。ffmpegで一セグメントずつミックスし、その後コンカテネートします。
パイプライン2:ポッドキャストエピソードからクリップとショーノートへ
58分のWAVが入力されます。出力はトランスクリプト、タイムスタンプ付きチャプター、字幕焼き込みの縦型クリップ6本、そしてショーノートページです。最初のホップ以降、オーディオは形式が変わりません。これがこのパイプラインを動画のものより簡単にする理由です。機能するかどうかを決めるのは、どの文字起こしベンダーにルーティングするか、そしてリクエストにどの三つのパラメーターを設定するかです。
25MBの壁と回避ルート
OpenAIの文字起こしエンドポイントはアップロードを25MBまでに制限し、mp3、mp4、mpeg、mpga、m4a、wav、webmを受け付けます(OpenAI)。58分間の48kHz WAVは約300MBです。したがって、低ビットレートのMP3にトランスコードして賭けに出るか、ファイルを分割するかのどちらかですが、任意のバイト境界でオーディオを分割すると単語が半分に切れ、継ぎ目以降のタイムスタンプがすべてずれます。
AssemblyAIは/v2/transcriptで1リクエストあたり最大5GBを受け付け(ローカルファイルを/v2/uploadでアップロードする場合は2.2GB)、160ミリ秒から10時間のファイルを処理します(AssemblyAI)。これはOpenAIの上限の約200倍です。長時間のオーディオはそちらに丸ごと送り、LLMベンダーは下流の推論ホップに使ってください。
単語レベルのタイムスタンプがクリップカットの基本単位
段落境界しかないトランスクリプトからクリップを自動カットすることはできません。「anyway」という単語が00:41:12.340から始まることを知る必要があります。そうすればカットがその前に入り、単語を途中で切ることがありません。
OpenAI側の二つの注意点。SRTおよびVTT出力とtimestamp_granularities[]パラメーターはwhisper-1でのみ動作し、gpt-transcribeやgpt-4o-transcribeでは動作しません(OpenAI)。パイプラインが字幕を焼き込むかタイムコードでカットする場合、古いモデルをチェーンに意図的に残しておき、技術的負債として扱うのをやめてください。ElevenLabs Scribe v2は90以上の言語にわたって、単語レベルのタイムスタンプ・話者識別・エンティティ検出を一つのレスポンスで提供します(ElevenLabs)。TTSホップですでに料金を払っているなら、こちらの方がよりクリーンな選択です。
話者識別は明示的に要求しなければ機能しない
話者ラベルには、30秒を超えるオーディオに対してchunking_strategyをautoに設定する必要があり、gpt-4o-transcribe-diarizeは話者識別のみを行います(OpenAI)。パラメーターを省略するとリクエストは成功します。返ってくるのは、きれいで流暢な、完全にラベルなしのテキストの壁です。二人のホストによるインタビューが一つの声に折りたたまれても、レスポンスには何も示されません。話者フィールドを目で確認するのではなく、バリデーションステップで確認してください。
トランスクリプトからショーノート・チャプター・ソーシャルコピーへ
単語タイミング付きの一つのトランスクリプトから、追加のオーディオ処理なしに四つのアーティファクトが展開されます:トピックの転換からのチャプターマーカー、ショーノートページ用のサマリー段落とリンクリスト、引用密度でスコアリングされたクリップ候補のランキング、そしてそのインポイントとアウトポイントからレンダリングされた縦型カット自体。同じトランスクリプトを、異なるプロンプトで並列にそれぞれに渡してください。構築前に形式の参考を探しているなら、ディレクトリには201のAIポッドキャストがほぼ同じスタックで公開しています。
パイプライン3:製品写真から広告バリエーションへ
靴のスタジオ写真一枚が、ブランドに合った静止画12枚、そしてペイドソーシャル用の8秒モーション広告4本になります。ホップは画像入力、画像出力、動画出力で、面白いエンジニアリングはホップ2と3の間にあります。そこではビジョンモデルが画像ジェネレーターの出力を確認し、出荷するかどうかを判断します。
QAゲートとしてのビジョンモデルレビュー
生成された製品静止画は退屈な方法で失敗します。ロゴの位置が間違っている、ハトメが5つのところ6つある、キーライトと矛盾する影がある。120のバリエーションを人間が目で確認したくないので、ソースショットと書面によるブランド仕様を添えてビジョンモデルに送り、合格/不合格と理由文字列を求めます。
Claudeは200kコンテキストモデルでは1リクエストあたり最大100枚、他のモデルでは600枚、claude.aiでは1メッセージあたり20枚の画像を受け付け、画像ごとに8000x8000pxおよび10MBが上限です(Claude Docs)。これらの数字が問題になるわけではありません。
問題になるのは32MBの標準リクエストサイズ上限です。12枚の4K PNGは100枚の上限に近づくずっと前にこれを超えます。そのため、AnthropicはFiles APIを通じてアップロードし、base64をインラインにするのではなくfile_idで各画像を参照することを推奨しています(Claude Docs)。最初からこの方法でレビューホップを構築してください。バッチサイズが増えた後に後付けすると、リクエストビルダーとリトライロジックを同時に書き直すことになります。
フレームサンプリングは直接的なコスト調整手段
Claudeは画像を28x28ピクセルのビジュアルトークンとして請求し、⌈width/28⌉×⌈height/28⌉で計算されます。3840x2160フレームは高解像度ティアで4,784ビジュアルトークン、標準ティアでダウンスケール後1,560トークンとなり、Claude Opus 5の$5/M入力レートで1,000枚の4Kフレームあたり約$23.92です(Claude Docs)。ステッチや細かい文字など、QAチェックが細部に依存しない限り、送信前にダウンスケールしてください。
同じ計算が動画分析ホップにも適用されます。24fpsの8秒広告4本をレビューすると、単純に考えると768フレームになります。2fpsでサンプリングして64フレームを確認すると、シーンチェンジを一つも見逃さずにレビューコストが12分の1になります。
リクエスト上限を超えずに画像をバッチ処理する
画像数ではなく、ペイロードバイト数でチャンクしてください。バリエーションを約25MBの参照以下に収まるグループに分類し、比較アンカーとしてソース写真をすべてのバッチに含め、失敗したものは個別に完全な解像度で再送して理由文字列が読む価値のあるものにしてください。ディレクトリのAI画像・写真ツールの中には727の画像ジェネレーターと342の写真エディターがありますが、ここで必要なバッチメカニズムを公開しているものはほとんどありません。その部分はあなたのコードの責任です。
ハンドオフ仕様書:各ホップで要求すべきこと
コードを書く前に契約を書いてください。チェーンの各ホップには三つの確定事項があります:要求する正確な出力形式、それを解放するプランティアまたはパラメーター、そしてアーティファクトが消える前の有効期間。これらを間違えると、失敗は二ホップ後に誰もトレースできない品質クレームとして現れます。
オーディオ:ブロードキャスト品質の出力をゲートするティア
ElevenLabsはpcm_44100、pcm_48000、wav_44100、wav_48000をProサブスクリプションの後ろに、mp3_44100_192をCreatorの後ろに置いています(ElevenLabs APIリファレンス)。つまり、無料または入門プランでは、音声モデルがどれほど優れていても、動画エディターは128kbps以下のロッシーMP3を受け取ります。これは推論ではなく課金によって設定された品質の上限です。
納品物が-16 LKFSで真のピークが-1 dBFS以下に収まる必要があるポッドキャストの場合(Apple Podcasts)、ロスレスを入力として最後に一回エンコードしたいところです。128kbps MP3をノーマライズして再エンコードすると、二つのロッシー生成がスタックされます。Proティアを制作コストとして予算に含め、アップグレードとして扱わないでください。
動画:有効期限付きURLとサイドカーアセット
Soraは一つのファイルを渡してくれません。完成したレンダリングにはMP4、WebPサムネイル、JPGスプライトシートがあり、ダウンロードURLは最大1時間有効です(OpenAI動画ガイド)。そのホップでのあなたの仕事は、夜間バッチではなく完了イベントをトリガーとして、自分のオブジェクトストアにコピーすることです。ウィンドウを逃すとレンダリングは回収不能です。
テキストとタイミング:下流ステップが必要とするフィールド
下流ステップは特定のフィールドを厳密に要求し、タイミングが必要なものがサイレントに壊れます。SRTおよびVTT出力とtimestamp_granularities[]はwhisper-1でのみ動作し、新しい文字起こしモデルでは動作しません(OpenAI音声テキスト変換)。クリップをカットするか字幕を焼き込むものは、契約に単語レベルのタイムスタンプが必要です。
| ホップ | この出力を要求する | 解放するもの | 有効期限 |
|---|---|---|---|
| テキスト読み上げ | wav_48000またはpcm_44100 | Proティア;mp3_44100_192はCreator | 有効期限なし、書き込み時に保存 |
| 音声テキスト変換 | 単語レベルのタイムスタンプ、話者ラベル | SRT/VTTにはwhisper-1;30秒超の話者識別にはchunking_strategy: auto | 有効期限なし |
| 画像から動画 | MP4にサムネイルとスプライトシート | 参照画像が動画解像度と完全一致 | ダウンロードURLは1時間 |
| 動画からテキスト | 固定レートでサンプリングされたフレーム | 標準対高解像度ティアでビジュアルトークンコストが約3倍変わる | 有効期限なし |
ディレクトリ内の128のAIフレームワークからどのオーケストレーターを選んでも、まずバイナリホップに対してテストしてください。モデル間でJSONを渡すのは簡単な部分です。
オートメーションプラットフォームか手動グルーコードか
ルールはシンプルです:何が起きるかとタイミングはプラットフォームに任せ、バイトの移動は自分のコードに任せる。大きなファイルを扱うか有効期限ウィンドウと競うものは、背後にオブジェクトストレージを持つスクリプトに属します。
プラットフォームが勝る場面
トリガー、安価なステップのリトライ、承認ゲート、そして最後のファンアウト。Zapierは9,000以上のアプリ統合をZaps、Tables、Forms、Zapier MCPに接続していることを謳っており、そのカタログが実際に使う理由です。完成したショーノートをCMSに入れ、クリップリンクをコンテンツカレンダーに載せるのはコネクター作業であり、そのコネクターを自分で書いても何も得られません。
ヒューマンインザループもここに属します。4つの広告バリエーションをSlackに投稿し、サムズアップを待ち、公開ステップを解放するZapは20分のセットアップで、幻覚した製品クレームとペイドソーシャル予算の間に立つ唯一のものです。
バイナリメディアがプラットフォームを打ち負かす場面
ノーコードのノードはJSONをうまく渡せますが、ファイルは苦手です。58分のWAVは、OpenAIの文字起こしエンドポイントが受け付けるには25MB以下のチャンクに分割する必要があります(OpenAI)。2分間のSoraレンダリングは各20秒の最大6回のチェーン化された拡張コールです(OpenAI)。そしてダウンロードURLは生成後最大1時間有効です(OpenAI)。アーティファクトのカウントダウンが動いている状態で6回のコールにわたるリトライロジックはプログラムであり、キャンバスではありません。
メディアを扱える二つのプラットフォームがあります。n8nはbase64のラウンドトリップを強制せず、ノード間でファイルをバイナリデータとして保持し、コードノードがエージェントノードの隣にあります(n8n)。DescriptはGUIではなくAPIを通じて文字起こし、クリップ、字幕を公開しています(Descript)。
中間の道:制御フローにプラットフォーム、バイト移動にコード
各ホップは自分のバケットに書き込み、キーを返します。プラットフォームはキーとステータスコードを渡し、ファイルは渡しません。この方法で作業をステージングすると計算量も削減されます:OnePieceシステムは、モノリシックなパイプラインをステージ化されたサービスに分解した後、Wan2.1の画像から動画でGPU消費量が16倍減少したと報告しています(arXiv)。
コンポーネントを選ぶなら、ディレクトリは550のAIエージェントとオーケストレーションツールと301のオープンソースAIリポジトリを追跡しています。バイト移動のグルーコードは通常リポジトリにあります。ベンダーはその部分を販売していないからです。
配信仕様:プラットフォームが公開する場所に合わせる
最後のホップはレンダリングではありません。アップロードであり、アップロードにも仕様書があります。
動画:アップロードのビットレートとオーディオターゲット
YouTubeは解像度別の推奨配信ビットレートを公開しています:1080p SDRで8 Mbps、1440pで16 Mbps、4Kで35〜45 Mbpsで、オーディオは48kHz、384kbpsステレオのAAC-LC、Opus、またはEclipsaで配信します(YouTubeヘルプ)。動画ホップがその数字をかなり下回るファイルを渡した場合、エクスポートでビットレートをアップスケールしないでください。エンコード時間を費やして圧縮アーティファクトを水増しすることになります。すべきことは、エンコードステップにソース解像度を読ませて対応するターゲットを選ばせることです。6ヶ月前に設定にハードコードされたせいで1080pのSoraレンダリングに4Kラダーが強制されないように。
ナレーション付きコンテンツでは、動画よりオーディオターゲットの方が重要です。44.1kHzのソースからの48kHz 384kbps AACトラックはどこかでリサンプルが発生することを意味し、そのリサンプルを一度だけ、自分のffmpegコールで、目の届く場所で行いたいところです。
オーディオ:エンコード前のラウドネス前処理
Apple Podcastsは、ITU-R BS.1770-5で測定した-16 dB LKFS ±1 dBで真のピークが-1 dB FS以下を要求し、エンコード前にオーディオをそのターゲットに前処理すべきと明示しています(Apple Podcasts for Creators)。好みではなく、操作の順序です。完成したMP3をノーマライズするということは、別のレベルでベイクされたロッシーアーティファクトにゲインを押し込むことになり、デコードされたMP3の真のピークはすでにエンコーダーが見た値を超えることがあります。WAVにラウドネスパスをかけてからエンコードしてください。
これが、チェーンの前半のTTS形式ティアが引き続き重要な理由です。ノーマライザーに128kbps MP3を渡すことは、PCMを渡すより悪いスタート地点であり、どれだけ下流で気をつけても修正できません。
生成アセットの出処と表示
プラットフォームが求めた後ではなく、パイプラインを設計している段階で出処を決めてください。GoogleのSynthIDは生成メディアに作成時にウォーターマークを付けます。つまり、パイプラインがそれを剥ぎ取ったり再エンコードしたりしない場合にのみ、アセットと一緒に移動します。生成からアップロードまでの間のすべてのffmpegパスは、その信号を失う機会です。そのため、どのホップがファイルを導入したかを追跡し、コンテナがそれを運ぶことを信頼するのではなく、モデル・プロンプト・タイムスタンプの記録を自分のメタデータストアに保持してください。
スワップに備えてビルドする:すべての動画ホップの下に潜む廃止の崖
動画ホップがSoraを呼び出している場合、残り19日です。OpenAIは2026年3月24日に、Videos APIとsora-2およびsora-2-proモデル(スナップショットsora-2-2025-10-06、sora-2-2025-12-08、sora-2-pro-2025-10-06を含む)が2026年9月24日にシャットダウンすると発表し、推奨代替モデルを一つも挙げていません(OpenAI廃止情報)。代替欄が空ということは、後継モデルを自分で選ぶことを意味します。締め切りの後ではなく前に選んでください。
スワップが設定変更で済むようにホップを抽象化する
解決策は、生成ホップごとに薄いアダプターを用意することです。パイプラインはアダプターに標準化されたジョブを渡します:プロンプト、参照画像パス、ターゲット解像度、秒単位のデュレーション、出力バケットキー。アダプターはすべてベンダー固有の部分を担当します。Soraの参照画像が動画解像度と完全一致しなければならないルール、20秒ステップで最大120秒の上限まで拡張される16秒と20秒のクリップ、1時間のダウンロード有効期限(OpenAI動画生成)。これらはオーケストレーションコードに漏れ出しません。
プロバイダーのスワップは設定値の変更であり、書き直しではありません。今すぐRunwayのモデルドキュメントURLで第二のアダプターを検証し、同じ10個のプロンプトで両方を実行し、負けた方をウォームな状態で維持してください。
画像と音声ファミリーにも独自の廃止日があるので、これを一度限りの取り組みではなく定期的なメンテナンスとして扱ってください。ディレクトリは324の登録モデルにわたってモデルのリリースと廃止を追跡するために一部存在しています。
今日実行中のパイプラインの移行チェックリスト
- すべてのリポジトリとワークフローJSONで
sora-2、sora-2-pro、Videos APIベースパスをgrepしてください。忘れられたコールが潜むcronジョブと一回限りのスクリプトも含めて。 - プロバイダーを変更する前に、各ヒットを自分のジョブスキーマを持つアダプターでラップしてください。スワップとリファクタリングが同じコミットにならないように。
- 代替プロバイダーで10個の実際のプロンプトを実行し、解像度・クリップの長さ・モーション品質の出力を比較してください。
- ベンダーごと、モデルファミリーごとに、公表されたサンセット日の2週間前にカレンダーリマインダーを設定してください。
- モデルIDとスナップショットをすべてのレンダリングに記録し、モデルが廃止された後に「このアセットを生成したのは何か」に答えられるようにしてください。
よくある質問
マルチモーダルAIワークフローとは、実際にはどういうものですか?
あるモデルの出力ファイルが次のモデルの入力ファイルになるAPIコールのチェーンであり、各ホップには満たさなければならない形式の契約があります。典型的なチェーンは、トランスクリプト→スクリプト→静止画→動画→ボイスオーバー→最終レンダリングと進み、各矢印は解像度やコーデックが間違うと実行が壊れる場所です。Soraの画像から動画へのホップは、その契約がどれだけ文字通りのものかを示す良い例です:参照画像はターゲット動画解像度と完全一致し、image/jpeg、image/png、image/webpのいずれかである必要があるため、上流の画像ステップは動画ステップのピクセル寸法を必要とし、アスペクト比だけでは不十分です(OpenAI動画生成ドキュメント)。パイプラインをツールのセットではなく、ハンドオフのセットとして考えてください。
ステップ間で品質を失わずにAIツールを連結するにはどうすればよいですか?
各ホップの出力仕様をチェーンの最後のステップが必要とするものに固定し、逆算して作業してください。品質の低下は通常、モデルではなく価格ティアやデフォルトパラメーターから来ます:ElevenLabsはpcm_44100、pcm_48000、wav_44100、wav_48000をProサブスクリプションの後ろに、mp3_44100_192をCreatorティアの後ろに置いているため、入門ティアのアカウントは意図しなくても編集者にロッシーMP3を渡します(ElevenLabsの音声生成リファレンス)。Soraのダウンロードスクリプトは生成後最大1時間有効なので、すべての生成アーティファクトをすぐに自分のオブジェクトストアにコピーしてください(OpenAI動画生成ドキュメント)。サンプリングレートはコストのレバーでもあります:Claudeは高解像度ティアで4Kフレームを4,784ビジュアルトークンで、標準では1,560トークンで価格設定し、Opus 5の$5/M入力レートで1,000枚の4Kフレームあたり約$23.92です(Claudeビジョンドキュメント)。
テキスト読み上げステップから動画エディターにどんなオーディオ形式を渡すべきですか?
非圧縮の48kHz WAVまたはPCM。ElevenLabsではwav_48000またはpcm_48000、Proサブスクリプション以上が必要です(ElevenLabsの音声生成リファレンス)。エディターに128kbps MP3を渡すと、後のすべてのエンコードを生き残る圧縮アーティファクトが焼き付けられます。配信先がYouTubeなら最終配信ターゲットはAAC-LC、Opus、またはEclipsaで48kHz、384kbpsステレオです(YouTubeアップロードエンコード設定)。ポッドキャストフィードなら、Apple Podcastsはエンコード前にITU-R BS.1770-5で測定した-16 dB LKFS ±1 dBで真のピークが-1 dB FS以下への前処理を要求します(Apple Podcastsオーディオ要件)。ロッシーの中間ファイルからどちらのターゲットも確実に達成することはできません。
なぜポッドキャストの文字起こしがフルエピソードで失敗するのですか?
OpenAIの文字起こしエンドポイントはアップロードを25MBまでに制限し、mp3、mp4、mpeg、mpga、m4a、wav、webmを受け付けるため、適切なビットレートで30分超のものはすべて25MB以下のチャンクに分割する必要があります(OpenAI音声テキスト変換ドキュメント)。それが長時間パイプラインが通常LLMベンダーから文字起こしをルーティングする理由です:AssemblyAIは/v2/transcriptで1リクエストあたり最大5GB(ローカルアップロードは2.2GB)を受け付け、160ミリ秒から10時間のファイルを処理します。OpenAIの上限の約200倍です(AssemblyAI録音済み音声ドキュメント)。成功に見える二つの障害モードがあります:話者識別は30秒を超えるオーディオに対してchunking_strategyをautoに設定しないとラベルなしのテキストをサイレントに返し、SRT/VTT出力とtimestamp_granularities[]はwhisper-1でのみ動作し、gpt-transcribeやgpt-4o-transcribeでは動作しません(OpenAI音声テキスト変換ドキュメント)。自動クリップカットのための単語レベルのタイムスタンプが必要なら、ElevenLabs Scribe v2が90以上の言語で話者識別とともに提供しています(ElevenLabsモデル)。
n8nかZapierでAIコンテンツパイプラインを構築すべきですか、それとも自分でコードを書くべきですか?
バイナリメディアを移動するホップはコードを書き、その周りのトリガー・承認・通知にはオートメーションプラットフォームを使ってください。Zapierの強みは幅広さです。ベンダーが謳う9,000以上のアプリ統合にZaps、Tables、Forms、Zapier MCPが加わります(Zapierデベロッパープラットフォーム)。「Airtableに新しい行が追加されたらレンダリングを開始し、Slackにリンクを投稿する」というのには最適です。1時間で期限切れになるURLを持つ200MBのMP4には適切なレイヤーではありません。n8nはその間に位置します。エージェントノードとバイナリパススルー処理でワークフロー内にファイルを保持できます(n8n Tools Agentドキュメント)。また、チェーンをステージに分割することには実際のインフラの議論があります:OnePieceの論文は、Wan2.1の画像から動画のAIGCパイプラインをステージ化されたマイクロサービスに分解することでGPU消費量が16倍減少したと報告しています(arXiv)。
2026年9月のシャットダウン後、動画パイプラインでSoraの代わりになるものは何ですか?
OpenAIは2026年3月24日に、Videos APIとsora-2およびsora-2-proモデル(スナップショットsora-2-2025-10-06、sora-2-2025-12-08、sora-2-pro-2025-10-06)が2026年9月24日にシャットダウンすると発表し、推奨代替モデルを一つも挙げていません(OpenAI廃止情報)。2026年9月5日時点であと19日です。実際的な対応は、今日のうちに動画ホップを薄いインターフェースの背後に置き、別のベンダーに向けることです。最も直接的なスワップとして評価するのはRunwayのAPIです(Runwayモデルドキュメント)。チャンキングロジックの書き直しも予算に含めてください。Soraの制限が多くのパイプラインを形作っているからです:16秒と20秒のクリップ、拡張ごとに最大20秒追加、最大6回の拡張で120秒の最大値。これにより2分間のナレーションセグメントが6回のチェーン化されたコールになっていました(OpenAI動画生成ドキュメント)。代替を探しているなら、ディレクトリには現在452のAI動画ジェネレーターツールが登録されています。