

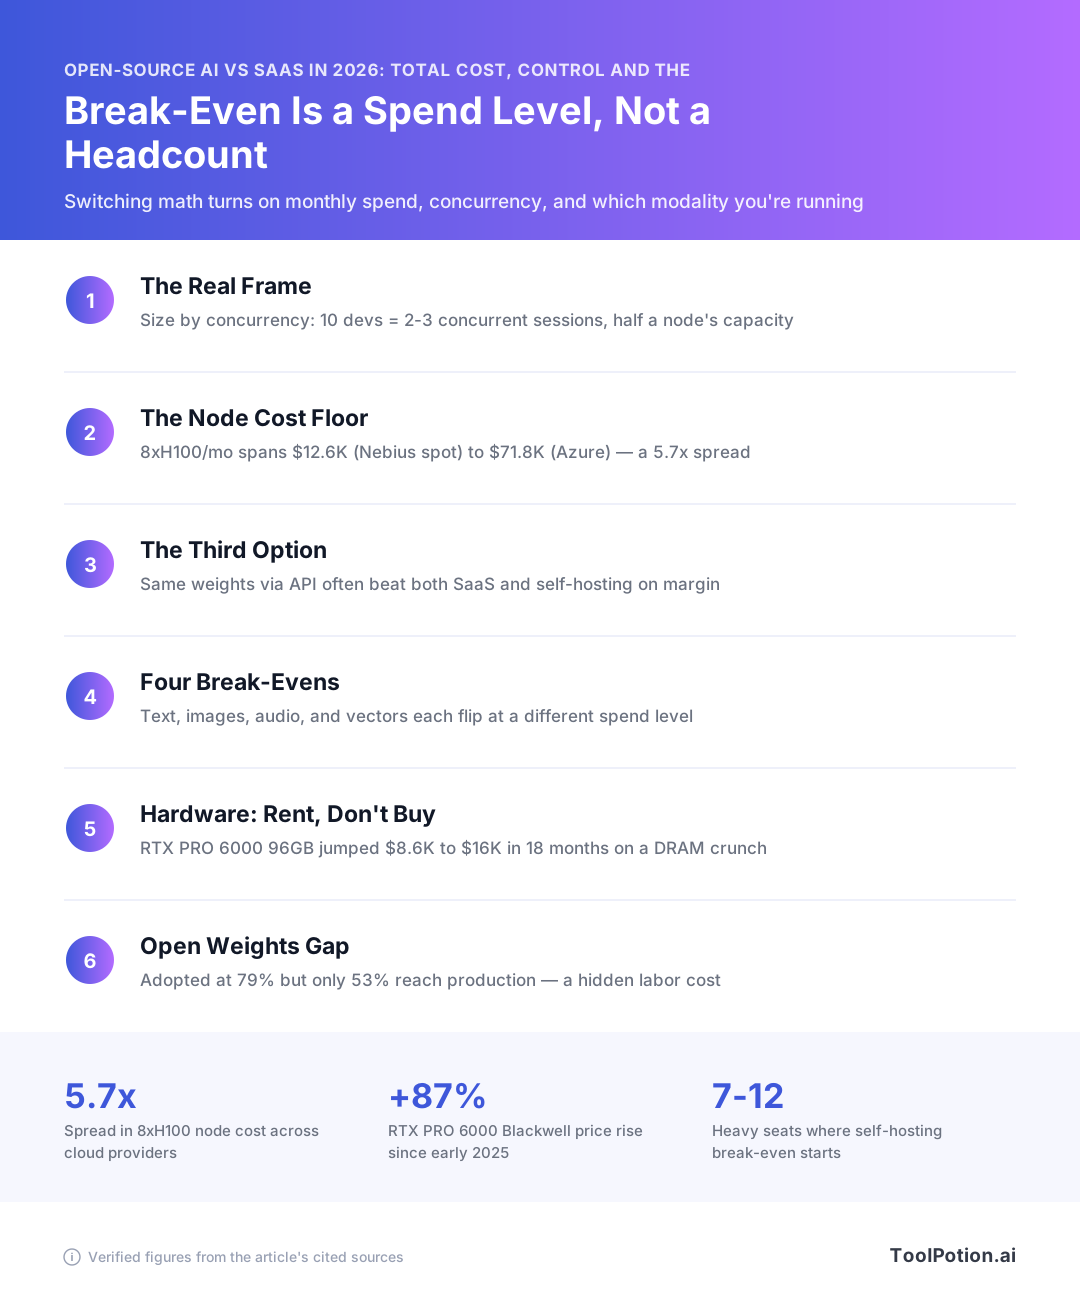
オープンソースAIとSaaSの選択は2つの数字に集約されます:月間支出と同時接続数のプロファイルです。人員数はどちらの指標としても不適切です。DoiTのエンジニアは使用量ベースのClaude Code Enterpriseで開発者1人あたり月平均2,200ドルを費やしており、これはおよそ7〜12人のヘビーユーザーで月15,000〜25,000ドルのノードが検討対象になることを意味します。しかし、チームの同時リクエスト率は10〜20%に過ぎないため、開発者10人でも同時セッションは2〜3件に相当し、ノードの半分がアイドル状態になります。
GPU価格を検討する前に、誰もベンチマーク対象にしない第3の選択肢を確認してください:DeepInfraはLlama-3.3-70Bを入力100万トークンあたり0.10ドル、出力0.32ドルで提供しています。同じ重みで、自前では到底かなわないマルチテナントの利益率です。以下の計算はテキスト、画像、文字起こし、ベクトル層の4つのモダリティにわたって実施します。
損益分岐点は支出水準と同時接続プロファイルで決まる
自己ホスティングすべきかどうかを決める2つの数字があり、チームサイズはそのどちらでもありません。1つ目は現在のAI月間支出額です。2つ目は同時に処理中のリクエスト数です。モデルの選択を含む他のすべての要素は、この2つの数字の後続になります。
モデル選択より先に答えを出す2つの数字
GPUノードは、フルに稼働させても深夜3時にアイドル状態でも同じコストがかかります。これが比較全体を支える非対称性です:SaaSはトークンごとに課金し、ノードは時間ごとに課金されます。つまり、月間請求額が、常に稼働させられるボックスの固定費を超えているかどうかが問題です。
DoiTのエンジニアチームは使用量ベースのClaude Code Enterpriseで開発者1人あたり月平均約2,200ドルを費やしており、月15,000〜25,000ドルの自己ホスティング損益分岐点はヘビーユーザー7〜12人程度に相当します。これはほとんどのTCOガイドが繰り返す「数百人のエンジニアが必要」という基準よりもはるかに低い閾値です。これは人数の閾値ではなく支出の閾値です。アシスタントをほとんど使わない開発者12人では到達できませんが、エージェントを一日中動かす7人なら十分です。
2つ目の数字は同時接続数で、チームが最も見誤りやすい部分です。DoiTの主張では、任意の時点でリクエストを処理中の開発者は10〜20%に過ぎないため、開発者10人は同時セッション2〜3件に相当し、せいぜいノードキャパシティの半分です。H100を8枚払っているのに3〜4枚しか使っていないことになります。ピーク時の同時リクエスト数と目標トークンスループットでサイズを決め、その後で価格を検討してください。
「エンジニアが50人います」が間違ったトリガーである理由
人員数が支出と相関するのは1人あたりの使用量が均一な場合に限られますが、それは決して起こりません。コーディングエージェントを常時実行する8人と、時々チャットを使う42人で構成される50人チームは、8人のヘビーユーザーチームと同じノード要件を持ち、請求額もほぼ同じです。ヘビーユーザーをカウントしてください。
ディレクトリに掲載されたオープンウェイトモデルと比較する前に、この2つの数字を算出してください。ノードを常に稼働できるかどうかを確認してからモデルを選択しましょう。フロンティアより6ポイント劣るモデルも、飽和稼働しているボックスでは良いトレードオフですが、25%の負荷で動いているボックスでは高コストな失敗です。
オープンソースAI vs SaaS:2026年の自己ホスティングコスト
レートカードから始めましょう。それが唯一参照できる数字です。自己ホスティング予算の他のすべてはスプレッドシートで説明が必要な見積もりです。
レンタルGPUのレートカード:推論対応シリコンで約7倍の価格差
RunPodの公開価格では、H100 SXM 80GBがSecure Cloudで3.29ドル/時、Community Cloudで2.69ドル/時、H200 141GBが4.59/3.59ドル、A100 PCIe 80GBが1.39/1.19ドル、L40S 48GBが0.99/0.79ドル、B200 180GBが6.79/5.98ドルとなっています(RunPod)。推論を提供できる最安と最高価格のカードで約7倍の差があります。ワークロードが7Bまたは8Bモデルで中程度のコンテキストであれば、L40Sラインを価格比較の対象にすべきで、ほとんどのTCO記事がこれに触れていません。
LambdaはシングルオンデマンドのH100 SXMで4.29ドル/時、8xノードでGPU1枚あたり3.99ドル/時、H100 PCIeで3.29ドル/時、B200 SXM6で6.69〜6.99ドル/時を請求します(Lambda)。そのレートの8xH100ノードは時間あたり約31.92ドル、100%稼働での730時間月で約23,300ドルです。誰も100%稼働では運用しません。これが次の数字の意義です。
コミットメント割引は自分でコントロールできる最大のレバーです。Together AIはHGX H100をオンデマンドで3.99ドル/GPU時、7〜180日以上の予約条件で3.19〜3.69ドル/GPU時で請求します(Together AI)。約20%オフで、負荷に自信があって期間契約できる場合のみ利用できます。
プロバイダー乗数:同じ8xH100月間コストが12,600〜71,800ドルの幅
DoiTは730時間月の同一8xH100ノードをプロバイダー別に価格算出しました:Nebiusスポットで約12,600ドル、Nebiusオンデマンドで22,500ドル、AWSで40,200ドル、GCPで64,100ドル、Azureで71,800ドルです(DoiT)。同じシリコンで5.7倍の差があります。プロバイダーの選択はモデルの選択より乗り換えの計算に大きく影響します。コミット済み支出があるのでハイパースケーラーの表示価格でこの評価を実施している場合、SaaSと最悪バージョンの自己ホスティングを比較していることになります。
| プロバイダー / カード | 時間単価 | 備考 |
|---|---|---|
| RunPod L40S 48GB | $0.99 / $0.79 | Secure vs Community Cloud |
| RunPod H100 SXM 80GB | $3.29 / $2.69 | Secure vs Community Cloud |
| Lambda H100 SXM (8xノード) | GPU1枚あたり$3.99 | 〜$23,300 / 730時間月 |
| Together AI HGX H100 | オンデマンド$3.99、予約$3.19〜$3.69 | 7〜180日以上の条件 |
誰も計上しない費用項目:アイドル時間、冗長性、メンテナンス人件費
レンタルノードは実時間で課金されます。APIの請求はトークンを追跡し、GPUの請求は使用しない可能性のある時間を追跡します。トラフィックが営業時間・平日のみであれば、730時間のうち有効な容量は約168時間で残りは無駄になります。つまりAPIの請求と比較する前に、実効トークンコストを4倍にする必要があります。サービスが顧客向けであれば2台目のノードまたはフォールバックAPIキーを追加してください。単一ノードにはフェイルオーバーがないためです。vLLMにパッチを当て、モデルバージョンをローテートし、KVキャッシュの圧迫を監視し、深夜2時にアラートを受け取るエンジニアも必要です。機械学習プラットフォームディレクトリのベンダーがマージンを取りつつその一部を管理してくれますが、それは通常、他の方法で費やす半人前の人件費より安いです。
つまり、妥当な月間コストは:プロバイダーの実レートでのノード時間を実稼働率で割り、冗長性と人件費の実コストを加えたものです。比較の前に4つすべてを算出してください。
ほとんどの自己ホスティングケースを潰す第3の選択肢
オープンソースとSaaSを比較するほぼすべての記事は、GPUの請求書とフロンティアAPIの請求書を並べて勝者を宣言します。その比較が飛ばしているのは、ほとんどのチームが選ぶべき選択肢です:誰かが代わりにオープンウェイトを実行してくれるマルチテナントのトークン課金型サービスです。
DeepInfraはLlama-3.3-70B-Instruct-Turboを入力100万トークンあたり0.10ドル、出力0.32ドルで、Meta-Llama-3.1-8Bを0.02/0.04ドルで提供しています(DeepInfra)。ダウンロードするものと同じチェックポイントで、ライセンス条件も同じです。違いは、彼らのH100が数千の顧客間でほぼ満杯で稼働しているのに対し、あなたのH100は日曜深夜3時のトラフィックに合わせて稼働する点です。
同じオープンウェイト、他者の稼働率カーブ
DeepInfraの専用ティアと比較すると差は歴然です。専用H100 80GBは同社で2.20ドル/時(DeepInfra)、つまり730時間月で1,606ドルです。出力100万トークンあたり0.32ドルで、同じ1,606ドルがサーバーレスエンドポイントで約50億の出力トークンを購入します。その月の43,800分に均すと、単一H100は価格でAPIに匹敵するだけで毎分約115,000の出力トークンを維持し続ける必要があります。実際の展開では、その多くの分がアイドル状態です。
専用容量を購入するのは単価以外の理由があります:データレジデンシー、第三者保持なし、自分でコントロールするレイテンシーフロア、カスタムLoRA、誰もホストしていないモデルです。これらは本物の理由です。スプレッドシートの理由ではなく調達上の理由であり、提案する際にはそう明言すべきです。
ウェイトのレンタルが安くなくなるとき
小型モデルの市場は収縮しています。GPT-5-nanoは100万トークンあたり0.05/0.40ドル、GPT-5は1.25/10.00ドルで動作しており(OpenAI)、独自モデルが自前のハードウェアで8Bのオープンモデルを温め続けるコストを下回っています。安価なオープンウェイトAPIと安価な独自APIが同じ軸で競合しており、自己ホスティングは両方に負けています。
ベンチマークの選択が答えを左右します。Anthropicのレンジは100万トークンあたりFable 5.1の10/50ドルからHaiku 4.5の1/5ドルまでです(Anthropic)。そのレンジの上位と自己ホスティングを比較すれば割安に見えます。Haiku、またはDeepInfraのLlamaと比較すれば、GPUノードはコストではなくコントロールで正当化する必要があります。
4つのモダリティ、4つの全く異なる損益分岐点
文字起こしを自己ホスティングするチームがテキスト推論を自己ホスティングすることはほぼありません。その理由は計算にあります。各ワークロードには独自のSaaS下限価格、独自のGPU負荷パターン、独自のライセンスルールがあります。4つすべてに1つの損益分岐点モデルを適用すると、3回は間違った答えが出ます。
テキスト推論:最も幅広く予測困難な分岐点
これは分岐点が最も動くモダリティです。比較対象のAPI価格が1桁分異なるためです。AnthropicはSonnet 5を入力/出力100万トークンあたり2/10ドル、Haiku 4.5を1/5ドルで提供しています(Claude pricing)。一方、OpenAIはGPT-5-miniを0.25/2.00ドル、GPT-5-nanoを0.05/0.40ドルで提供しています(OpenAI API pricing)。ベンチマーク対象のティアを選べば、損益分岐点は月数億トークンから数十億トークンの範囲で変動します。
DeepInfraの専用H100は2.20ドル/時で、フルタイム稼働で月約1,606ドルかかります(DeepInfra pricing)。GPT-5-nanoのブレンドレートと比較すると、ほとんどのチームが到達しないボリュームが必要です。Fable 5.1の100万トークンあたり10/50ドル(Claude pricing)と比較すれば、同じノードははるかに早く元が取れます。ワークロードに必要なティアを決めてからモデルを検討し、オープンウェイトを選定中であればモデルとLLMのリストを参照してください。
画像生成:GPUより先にライセンスが決め手になる
ここではGPUの計算は簡単な部分で、ライセンスが落とし穴です。FLUX.1 [dev]の重みは非商用ライセンスで提供されているという報告が多く、商業製品にはBlack Forest Labsの有料ライセンスが必要になる可能性があります。ハードウェアの予算を立てる前に必ず条件を確認してください。オープン画像モデルとMidjourneyを比較する記事でこれに触れているものはなく、それが決定を覆しかねない費用項目です。
断続的な画像生成がテストに失敗するパターンです。火曜日にまとめて生成するマーケティングチームは週の残りをカードをアイドル状態にしておき、アイドル時間も稼働時間と同じレートで課金されます。RunPod Community CloudのL40Sは0.79ドル/時(RunPod pricing)と安価なので、安定した継続バッチジョブであれば基準を十分に超えます。これがスケジュール済みパイプラインがうまく機能する理由です。ディレクトリには727の画像生成ツールがあり、ライセンス条件は出力品質よりも多様です。
文字起こし:最も早く損益分岐点を超えるモダリティ
実際にはそうならないことが多く、その理由はAssemblyAIにあります。OpenAIはWhisperとgpt-4o-transcribeに1分あたり0.006ドル、gpt-4o-mini-transcribeに0.003ドル、つまり音声1時間あたり0.36ドルと0.18ドルを請求します(OpenAI API pricing)。0.36ドル/時に対して、0.79ドル/時のL40Sは月数百時間の音声で損益分岐点を超えます(リアルタイムより高速なバッチスループットを前提)。それは本当に低い閾値です。しかしAssemblyAIがUniversal-2を0.15ドル/時、Universal-3.5 Proを0.21ドル/時で提供しており(AssemblyAI pricing)、損益分岐点は2倍以上に上がります。
自己ホスティングが明確に勝る唯一の場面はストリーミングです。AssemblyAIはWebSocketセッション継続時間(人が話していないアイドル接続時間を含む)で課金します(AssemblyAI pricing)。会議で誰も話していない間もソケットを開いたままにしていると、沈黙の分も支払うことになります。自己ホスティングのエンドポイントはウォールクロックではなくGPU秒で課金されます。
RAGとベクトル層はクエリ量で決まる
ベクトル検索の損益分岐点は月間クエリ数で計られ、自己ホスティングがマネージド価格を上回るのは月6,000〜8,000万クエリ前後という数字がよく使われます。ただし、インデックスサイズ、レプリカ数、許容レイテンシーによって変動するため、具体的なレートカードではなく目安として扱ってください。その範囲を下回る場合、マネージドサービスがエンジニアの給与より安くインデックスを運用してくれる一方、エンジニアにインデックスの管理を任せていることになります。埋め込み生成は別の計算で、ここで議論するすべての中で最も安く自己ホスティングできます。モデルが小さくバッチ処理が完璧にできるためです。
4つのワークロード、4つの閾値、それらをすべて同時に移行する理由はありません。
ハードウェアを購入すべきか?2026年のメモリ危機はレンタルを示唆する
2026年中頃より前に書かれた回収計算は、もはや存在しない価格で実行されています。当時のアドバイスは合理的でした:ボックスを購入し、3年で償却し、14ヶ月目でレンタルレートを上回る。それからメモリ市場が崩壊しました。
変わらないGPUで約87%の価格上昇
NVIDIA RTX PRO 6000 Blackwell 96GBが最も明確な例です。製品は変わっていません。2025年初頭に小売店で8,565ドル(事前注文最安値7,673ドル)だったものが、2026年6月に13,250ドル、2026年8月には16,000ドルに達しました(igor'sLAB)。約18ヶ月で約87%上昇し、NVIDIAは公式説明を一切公開していません。
2025年版のスプレッドシートで計算すると回収月は約2倍になります。12,000ドル全込みで見積もったシングルカードワークステーション構築は、RAMを購入する前から20,000ドルに近づいています。
HBMがDRAM供給を食い荒らした理由
GPU需要は話の半分に過ぎません。重要なのは、その需要がメモリファブに何をしたかです:高帯域幅メモリが現在、世界のDRAMウェーハキャパシティの推定23%を占めており、2024年の8%から増加しています。HBMは従来のDDR5の3〜5倍の収益をウェーハ当たりで生み出すためです(DatacenterDisk)。ファブはお金になる方向にウェーハを移動させました。結果として、サーバーDDR5 ECC RDIMMの価格は2025年Q1から2026年Q1の間に約100〜116%上昇し、GPUの周りのホストメモリはアクセラレーター本体と同様に打撃を受けました。1つのビルドで2回感じることになります:カードと、その下にある1TBのシステムRAMです。
2026年に書く減価償却スケジュールが前提とすべきこと
この歪みが購入決定より長続きすることを前提にしてください。Goldman Sachsは2026年5月に、2026年のグローバルDRAM不足率4.9%(15年間で最大の不足)、HBM供給ギャップ5.1%を予測し、ほとんどのアナリストは2027年後半まで顕著な改善を見込んでいません(Wccftech)。今日開始した3年の減価償却スケジュールは最初の2年間を不足の中で過ごすことになります。
ランキングページにまだ残っている2025年の数字ではなく、2026年8月の取得コストで購入ケースを計算してください。2年目の安価な更新も前提にしないでください。2025年のハードウェア価格でのみ成立する計算であれば、レンタルにしてください。レンタルは2028年に購入するオプションを残す方法です。
コントロールとコンプライアンス:スプレッドシートが見逃す部分
一部の保証は重みを自分で実行することでのみ得られます。チームが自己ホスティングの理由として挙げることの多くは、今では購入できるものです。
自己ホスティングが本当に提供するものと、提供するように見えるだけのもの
自前の推論を実行することで、どんな契約条項も代替できない4つのことが得られます:ベンダーの廃止スケジュールで変更されない重みのモデル、リクエストごとのデータがVPCから出ない保証、他者のキャパシティ計画によるレート制限なし、許可を求めずにファインチューニングまたは量子化できる能力です。リスク台帳にモデルバージョンが監査の途中で廃止されるという記載があれば、アーティファクトを所有することへの本物の論拠になります。
自己ホスティングが提供するように見えるだけのものリストはより長いです。データレジデンシー、保存時の暗号化、データでトレーニングしないというコミットメント、SOC 2の証拠、監査ログ、地域処理:これらはすべて契約条項と地域セレクターとして購入可能であり、しばらく前からそうなっています。それらのためにGPUプレミアムを払うのは二重払いです。これらの議論を駆動するリスクはペナルティの計算で、ペナルティの計算はハードウェアを誰がラックに収めるかを気にしません。規制当局は2026年初頭までに2,245件のGDPR違反で71億ユーロを課徴金として科しており、GDPRのリスクは世界売上高の4%、AI法のリスクは最大7%に達します。設定が誤った自己ホスティングモデルは、ホスティング型と全く同じ速さで監査に失敗します。
2026年の規制リセットが計画している期限を変えた
チームが参照しているコンプライアンスタイムラインの日付を確認してください。EU AI法のハイリスク義務は2026年デジタルオムニバスにより延期されました。多くの広く引用される比較ページがまだ掲載している2026年8月2日の期限は変更済みで、それを予算に反映させる前に自社の顧問弁護士に現在の日付を確認すべきです。その期限に間に合わせるために2026年初頭に自己ホスティングの予算を承認した場合、構築の根拠だった緊急性は消えており、支出は再検討に値します。
これは規制対象の業界で最も重要です。ヘルスケアとライフサイエンスのAIツールを検討しているチームが、移動した期限に対してプライベート展開の価格を設定している可能性が最も高いです。
ソブリンマネージドクラウドは中間の道
レジデンシーの論拠は2026年を通じて弱まっています。EU内でスタッフが配置・管理されるソブリンクラウドリージョンが現在、現存するオープンソース対SaaS比較のほとんどが書かれた当時には存在しなかったマネージドオプションとして利用可能になっています。ノードの価格を算出する前に、希望するハイパースケーラーが地域内で提供するものを確認してください。深夜2時にvLLMの管理者を雇わなくても、EU専用のデータ処理を得ることができます。
成立する順序はこうです。要件がレジデンシーであれば、ソブリンマネージドを購入する。要件がウェイトの永続性や制限のないファインチューニングであれば、自己ホストする。要件がアンケートの「データが当社の管理外に出てはならない」という項目であれば、ノードを契約する前に監査人が何を受け入れるかを確認する。
オープンウェイトはどれだけ遅れているのか?
4ヶ月です。これが測定された遅れで、オープンモデルが1世代後れているという現在の認識に代わるべき数字です。
4ヶ月と6インデックスポイント
Epoch AIは2026年1月1日から5月28日の間のEpoch Capabilities Indexにおける最良のオープンウェイトリリースとクローズドフロンティアを追跡して数値化しました:4ヶ月の遅れ、または90%信頼区間7〜11のECIポイントで8ポイントです。Artificial AnalysisはIntelligence IndexでGPT-5.5の60に対してオープンリーダーは52〜54という、12ヶ月前の13ポイント差から縮まった6ポイント差で同じ結論に達しています。
つまりギャップは実在し、縮まっています。ほとんどの本番ワークロード(分類、抽出、要約、検索拡張回答、初稿コード)では4ヶ月古いフロンティアで十分です。難解な推論の末尾では不十分で、どんなプロンプトエンジニアリングも8 ECIポイントを埋められません。議論のどちら側につくかを決める前にワークロードを選んでください。ディレクトリで追跡されているオープンウェイトリリースは3月にベンチマークしたモデルが今日デプロイするものではないほど速くターンオーバーします。
チームに実際のコストをかける採用から本番化へのギャップ
オープンモデルは能力ではなく出荷で負けています。2026年オープンソースAI現状調査(N=1,410)によると、AIデベロッパーの79%がオープンモデルを採用しているが本番化できるのは53%のみで、クローズドモデルは採用率71%に対して本番化率63%でした。より多く試され、より少なくリリースされています。
この26ポイントの落差はTCOシートに計上していないエンジニアリング時間です。また、規模が大きくなるほど改善するのではなく悪化します:クローズドモデルの本番化率は小規模企業の54%からエンタープライズの73%に上がるのに対し、オープンは53%から57%でほぼ横ばいです。最もプラットフォームエンジニアを持つ組織が最も頻繁にオープン展開を断念しており、これは自己ホスティングの提案が予測するものの逆です。リリースしない試みの予算も確保してください。
移行パス:乗り換えに実際かかること
スワップ自体は安いです。コストがかかるのは、スワップ前にスキップした評価作業で、それを本番インシデントで払うことになります。
ベースURLのスワップと、名前を挙げる価値のある文書化された例外
vLLMはOpenAI互換サーバーを同梱しているため、プレーンなチャット補完の場合、移行はベースURLとモデルエイリアスで完了します。既存のクライアントをエンドポイントに向け、modelをgpt-5-miniからサービスしているものに変更し、残りのコードはそのまま。これがすべての競合が当然視している部分で、正直なところ簡単な半分です。
チームが1週間を失う例外があります。構造化出力と厳密なJSONスキーマ実施はサービングスタック間で動作が異なるため、保証された有効な関数引数に依存するものはスモークテストではなく実際のペイロードでテストする必要があります。並列ツール呼び出しはよくあるギャップです。プロンプトキャッシングはプロバイダー固有であり、コストモデルがSaaS側のキャッシュ入力レートを前提としていた場合、その割引はついてきません。ロングコンテキストの動作はコンテキストウィンドウが広告する位置とは異なる地点で劣化し、トークナイザーも異なります。つまりトークン数ベースの予算と切り捨てロジックの両方を再調整する必要があります。
カットオーバー後ではなく前に評価ハーネスを構築する
自分のトラフィックで品質を測定できなければ、4ヶ月の能力ギャップがユースケースにとって重要かどうかを判断できません。数百件の実際の本番リクエストとその出力、ビジネスが評価するシグナルを記録し、候補のオープンモデルを同じセットで実行してください。GPUをプロビジョニングする前にこれを実施してください。
- 200〜500件の実際のリクエストと回答、および既に追跡しているダウンストリームシグナル(いいね、編集、リトライ、エスカレーション)を記録する。
- ベースラインを確立するために現行のSaaS出力をスコアリングする。守るべき数字が必要で、なんとなくの感覚では不十分。
- まずAPIでオープンウェイト候補を実行する。DeepInfraはLlama-3.3-70Bを入力0.10ドル、出力0.32ドル/100万トークンで提供しており(DeepInfra)、インフラコストなしでテストできる。
- 品質が維持され、ボリュームが正当化する場合のみ、専用容量に移行する。
デフォルトのハイブリッド:全面置き換えではなくリクエストクラス別ルーティング
各リクエストの価値に応じてトラフィックを分割してください。分類、抽出、要約、検索再構成は8Bモデルで100万トークンあたり0.02/0.04ドル(DeepInfra)で十分機能し、難解な推論の末尾はSonnet 5の2/10ドル(Anthropic)に送ります。呼び出しの80%が安価なクラスであれば、単一モデルに品質を賭けずに請求額の大部分を削減できます。
ルーティングはフォールバックパスも提供しますが、全面置き換えでは得られません。サービングスタックとルーターはディレクトリの128 AIフレームワークの大部分を占めており、始めるべきオープンソースAIリポジトリはOpenAI互換サーフェスを持つものです。それがロールバックを1つのコンフィグ変更に留める方法です。
2026年に乗り換えるべき人と、すべきでない人
3つのプロファイルは計算が有利に働きます。3つはそうでなく、プラットフォームチームの熱意がどれだけあっても修正できません。
自己ホスティングが明確に勝る3つのプロファイル
安定した負荷での大量文字起こし。スケジュール通りに動くパイプラインで月数千時間以上の音声を処理している場合、カードを忙しく保ちAssemblyAIの0.15ドル/時の下限(AssemblyAI)を上回れます。キューをいつ消化するかをコントロールできるバッチ作業が理想的な形で、カードをフィードし続けることがスケジューリングの問題になります。
好みではなく契約上の要件として、データが境界から出てはならない規制対象データ。その場合、コスト最適化は目的ではありません。監査の回答を購入しており、GPU代がその価格です。
使用量ベースのコーディングアシスタントを使う50人以上のデベロッパー。約50人では請求額がノードを飽和させ続けられる額に対して月約110,000ドルになり3〜9倍のプレミアムとなり、約100人(約220,000ドル/月)では所有ハードウェアが約1年で元が取れます(DoiT)。
計算だけで負ける3つのプロファイル
開発者10人未満のチーム。月約22,000ドルでアシスタントの請求額と10人では稼働させ続けられないノードが拮抗し(DoiT)、拮抗はオンコールローテーションに値しません。
ワークロードがバースト型のコンシューマートラフィックである場合。アイドルGPUはフルレートで課金され、ピーク時の急激な日次カーブはピーク分を払いながら平均して約20%しか使用しないことを意味します。サーバーレスのオープンモデルAPIがこのプロファイルを圧倒します。
品質基準がフロンティアにあるチーム。評価がFable 5.1の100万トークンあたり10/50ドル(Anthropic)でのみ通過するなら、自己ホスティングのオープンモデルは異なる品質レベルの別製品であり、節約によりダウングレードが購入されることになります。
資本投資を決める前に実施する90日間テスト
- 1〜2週目:支出ではなく同時接続数を計測する。リクエストの同時処理数を分単位で記録し、p95を求める。4未満であればここで止める。
- 3〜6週目:トラフィックの10%をDeepInfraのオープンウェイトエンドポイントに向け、既存の評価スイートを実行する。ほとんどのスタックではベースURLとモデルエイリアスの変更のみ。
- 7〜12週目:購入ではなくレンタル。DeepInfraの2.20ドル/時の専用H100(DeepInfra)で月1,700ドル未満で実際の利用率数値が得られます。これがCFOが求める数字です。
その後カードが60%以上アイドル状態であれば、答えはマネージドオープンウェイトAPIで、3年間の償却ではなく1四半期でそれを学んだことになります。
よくある質問
オープンソースAIの自己ホスティングはChatGPT BusinessやClaude Teamの座席より実際に安いですか?
表示価格では、ノーです。Claude Teamは年間契約で月20ドル(月払いで25ドル)、プレミアムシートは100/125ドル、Enterpriseは年間で1シートあたり20ドルにAPIレートでの使用料が加算されます(Anthropic pricing)。レンタルGPUは1人あたり20ドルに近づけません。そのため定額サブスクリプションはAIの中で最も自前ハードウェアで勝ちにくいものです。自己ホスティングが競争できるのは使用量ベース課金の場合のみで、DoiT自身のエンジニアは開発者1人あたり月平均約2,200ドルを費やしています(DoiT)。
2026年にLLMを自己ホスティングする場合、月間いくらで損益分岐点になりますか?
使用量ベースのAPI支出で月約15,000〜25,000ドルで、DoiTの観測した1人あたり月2,200ドルで換算すると約7〜12人のヘビーユーザーになります(DoiT)。この数字はモデルよりクラウドプロバイダーの選択によってより大きく変動します:730時間月の同じ8xH100ノードが、Nebiusスポットで約12,600ドル、Nebiusオンデマンドで22,500ドル、AWSで40,200ドル、Azureで71,800ドルになります(DoiT)。人員数はそもそも間違った単位です。任意の時点でリクエスト処理中の開発者は10〜20%に過ぎないため、開発者10人は同時セッション2〜3件、せいぜいノードキャパシティの半分です(DoiT)。
Whisper APIの1音声時間あたり0.36ドルを上回るには何GPU時間必要ですか?
スループットが答えを出し、時間はそれが課金されるレートを通じてのみ重要です。OpenAIはWhisperとgpt-4o-transcribeを1分あたり0.006ドル(音声1時間あたり0.36ドル)、gpt-4o-mini-transcribeを0.003ドル(0.18ドル/時)で請求します(OpenAI)。RunPod Community CloudのL40S 48GB(0.79ドル/時)(RunPod)で0.36ドルを上回るには約2.2倍以上のリアルタイムスループット、miniティアを上回るには約4.4倍、AssemblyAIのUniversal-2(0.15ドル/時)を上回るには約5.3倍が必要です(AssemblyAI)。アイドルGPU時間はコストとして積み上がるため、展開はバースト型の日中トラフィックではなく安定したキューでのみ機能します。
オープンソースAIは商用利用が無料ですか?
ノーです。チームが引っかかるのは画像モデルです。FLUX.1 [dev]の重みは非商用ライセンスを持つと報告されており、商業展開にはBlack Forest Labsの有料ライセンスが必要になる可能性があります。計画を立てる前に条件を確認してください。完全に許容的な重みであっても、コンピュートは無料ではありません:DeepInfraはLlama-3.3-70B-Instruct-Turboを入力0.10ドル、出力0.32ドル/100万トークン、Meta-Llama-3.1-8Bを0.02/0.04ドルで提供しており(DeepInfra)、ほとんどのチームが2.20ドル/時の専用H100で同じ重みを自前で動かすより安価です。
GDPRとEU AI法に準拠するために自己ホスティングが必要ですか?
ノーです。コンプライアンスはデータの場所、処理契約、文書化に関するものであり、推論スタックを所有する必要はありません。リスクは実在します(規制当局は2026年初頭までに2,245件のGDPR違反に71億ユーロを課金しており、GDPRでは世界売上高の4%、AI法では最大7%のリスクがあります。Kiteworks参照)。しかし、EUリージョンのマネージドおよびソブリンホスティングオプションが今やデータ保護責任者が求めるほとんどをカバーしています。契約または規制当局が第三者処理を明示的に禁止している場合に自己ホスティングし、一般的なヘッジとしては利用しないでください。
2026年のメモリ不足の中でGPUを購入すべきか、レンタルすべきか?
カードを常時稼働させる複数年のワークロードがない限り、レンタルです。NVIDIA RTX PRO 6000 Blackwell 96GBは2025年初頭の8,565ドルの小売価格から2026年6月に13,250ドル、2026年8月には16,000ドルに達しており、変わらない製品で約87%の上昇です(igor'sLAB)。原因はメモリです:HBMが現在、2024年の8%に対して世界のDRAMウェーハキャパシティの推定23%を占め、サーバーDDR5 ECC RDIMMの価格は2025年Q1から2026年Q1の間に約100〜116%上昇しました(DataCenterDisk)。Goldman Sachsは2026年のDRAM不足率4.9%(15年間で最大)を予測し、2027年後半まで改善は見込めないとしています(Wccftech)。高い購入価格を前提に計画し、レンタル市場の幅(DeepInfraの専用H100の2.20ドル/時からLambdaの4.29ドル/時まで)を活用してください。