

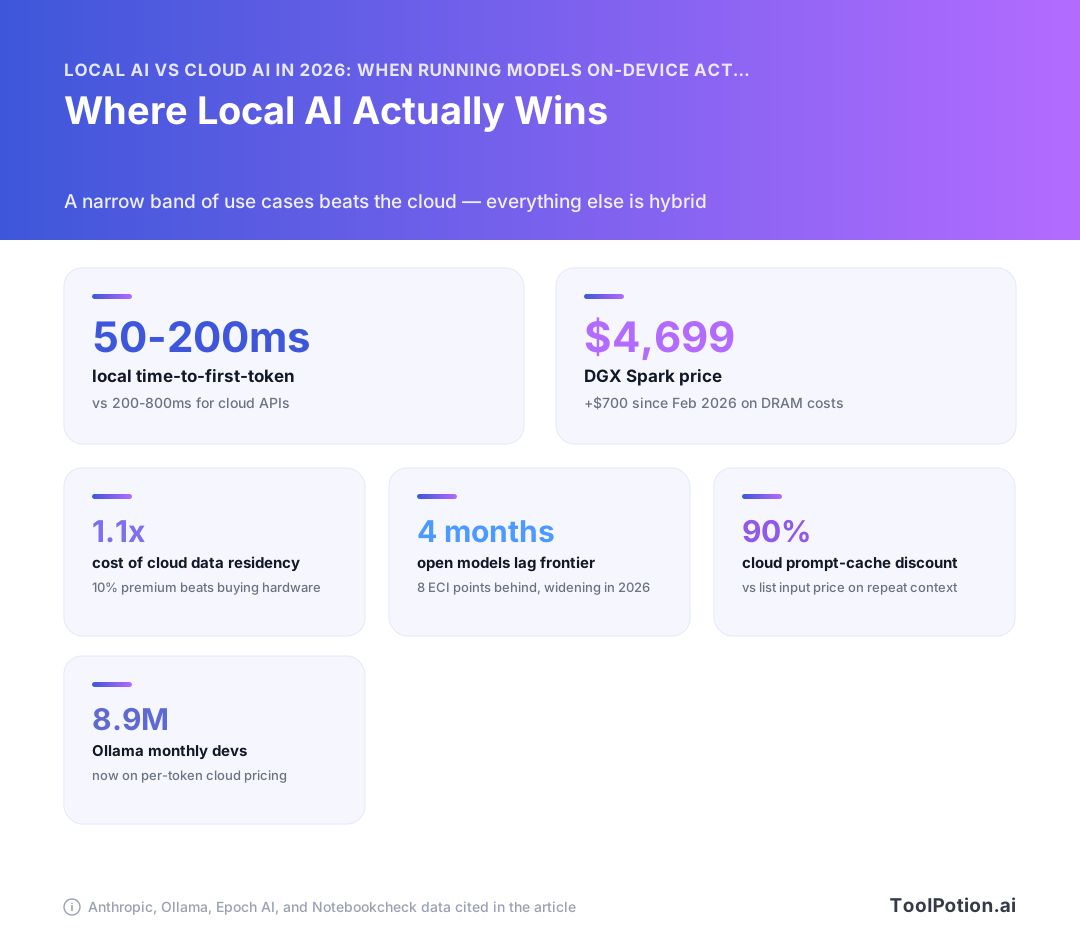
GPUを買うなら、フル稼働させられる場合に限る。ローカルAI vs クラウドAIの2026年版における短い答えはこれだ:1日の持続稼働率が概ね26%を超えれば、ローカル環境はトークン課金より有利になる。それを下回ると、2026年のメモリ価格でアイドル状態のシリコンに資金を投じることになる——そしてその価格は厳しい。NVIDIAはDGX Sparkを2026年2月に$3,999から$4,699へ$700値上げし、DRAMとストレージコストの高騰を理由に挙げた(Notebookcheck)。
一方、クラウド側はほとんどの比較記事が見落とす形で安くなった。プロンプトキャッシュの読み取りは入力価格の0.1倍で請求され、50%のバッチ割引も積み重なり、Claude Haiku 4.5は100万トークンあたり入力$0.50・出力$2.50になる(Anthropic)。
その計算の内訳、24GBで動くモデルの実態、そしてあなたにとっての損益分岐点がどこに来るかを解説する。
ローカルAI vs クラウドAI:2026年版の定説が崩れた4つのポイント
これまで読んできた損益分岐点の計算は間違っている——しかも丸め誤差の話ではない。ハードウェアが高くなり、性能の数値が誤読され、ツールが立場を変え、クラウドの料金表が誰のスプレッドシートにも気づかれないまま静かに下がったことが原因だ。
あらゆる比較が今でも前提としている3つの仮定
検索結果の1ページ目に出てくるローカル vs クラウドのガイドはほぼすべて、同じ3つの主張を根拠にしている——いずれも2024年のデータだ。1つ目:ハードウェアは固定かつ下落するコストであるため、$1,999のGPUを18ヶ月で償却してトークン単価と比較できる。2つ目:オープンウェイトモデルはクローズドのフロンティアモデルより3〜6ヶ月遅れているため、自宅で動かすモデルは数四半期分後ろにいる。3つ目:「ローカル」とは自分のマシンでのOllamaを、「クラウド」とはフロンティアAPIを意味するという、すっきりした二択だ。
これらは2024年には妥当な前提だった。2026年には一つも通用しない。
2024年から現在にかけて何が変わったか
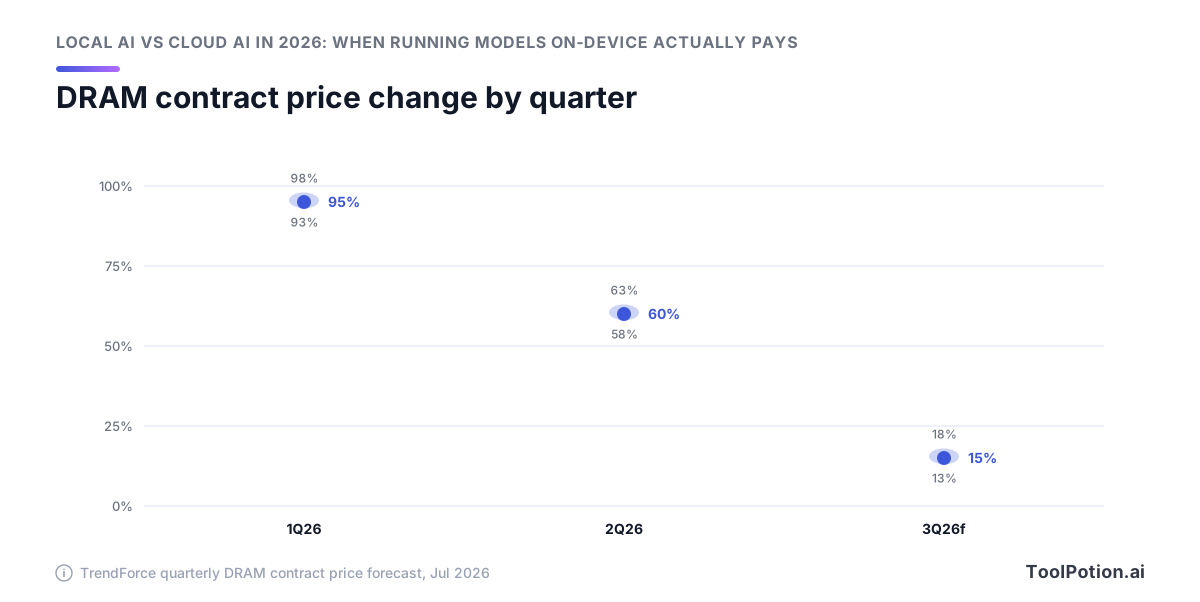
まずハードウェアの底値から始めよう——それが間違った方向に動いたからだ。NVIDIAは2026年2月にDGX Sparkを$3,999から$4,699へ$700値上げし、DRAMとストレージコストの急騰を理由に挙げた。コンベンショナルDRAMの契約価格は1Q26に前四半期比で約93〜98%上昇し、3Q26でも13〜18%上昇する見込みで今も上がり続けている。MSRPを引用しているどの試算も、CapExを4桁過少に見積もっている。
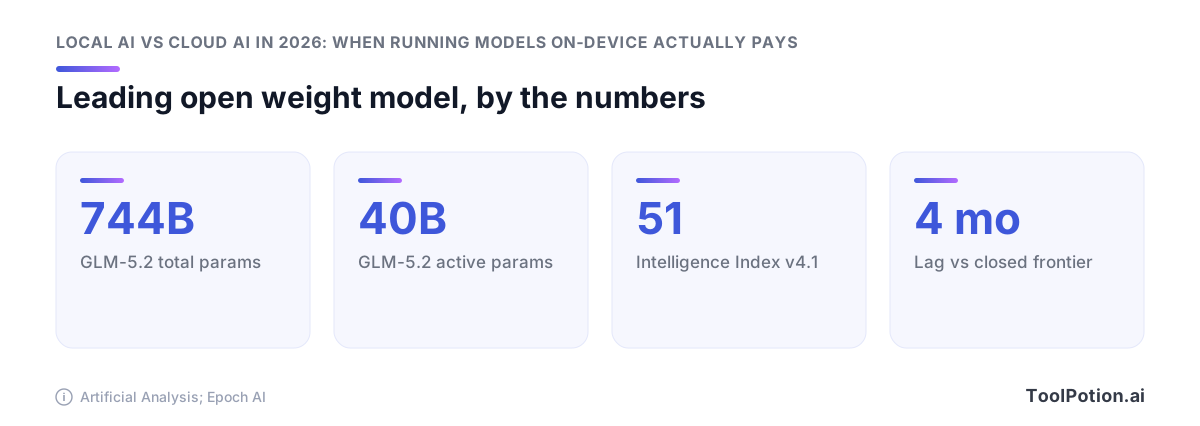
次に性能格差。Epoch AIはオープンモデルのクローズドフロンティアモデルへの遅れを、2026年1月以降4ヶ月・8 ECIポイントと測定しており、2023年1月〜2025年10月の平均3ヶ月より広がっている。誰も引用しない部分:その主張を担っているモデルGLM-5.2は、総パラメータ数744B・アクティブパラメータ数40Bだ。ラックサーバーの規模であり、ラップトップではない。
3つ目の崩壊は最も奇妙だ。2026年8月31日、Ollamaはチームの Pro・Max・Team をトークン単位のクラウド課金(月$20・$100・$500)に移行した。デフォルトの「ローカルで動かす」ツールが今やトークンを売っており、比較はGPU・安価なホスト型オープンウェイト・フロンティアAPIの三つ巴になっている。当サイトが追跡するAIモデルの選択肢を検討しているなら、まず真ん中の選択肢から価格を当たるべきだ。
そしてクラウド側は、いかなる公開の試算も織り込んでいない形で安くなった:基本入力価格の0.1倍でのプロンプトキャッシュ読み取り、さらに重なる50%のバッチAPI割引、そして米国限定推論を1.1倍の乗数で提供するオプション。最後のものは、人々がハードウェアを買う理由であるデータ居住性という特性を、$4,699の代わりに10%のプレミアムで提供してくれる。
2026年においてローカルモデルが本当に処理できること
2026年に24GBのカードで動くのは、質の高い20〜30B規模の混合エキスパート(MoE)モデルだ。そのモデルは、ほとんどのチームが許容できる品質で、構造化された問題の下書き・要約・分類・推論を行う。また、学習データ外の事柄については自信を持って事実を捏造する。この2文が性能マップであり、ほとんどの損益分岐点ガイドは2文目を省く。
コンシューマーハードウェアの上限は20〜30B MoEクラス
gpt-oss-20bとQwen3-30B-A3Bが、コンシューマーGPU1枚の実質的な上限だ。どちらもスパースなMoE設計のため、アクティブパラメータ数は24GBカードがウェイトを保持してもコンテキスト用の余裕が残る程度に小さい。その下には7〜14BのDenseなLlama・Mistral・Phiクラスのモデルがあり、より快適に収まるが性能を犠牲にしている。当サイトのオープンウェイトLLMリストはこのバンドに強く偏っている——自宅で動かせる規模だからだ。
推論は得意、世界知識は苦手
ローカルの30Bモデルにドキュメントを渡してフィールド抽出・スキーマ遵守・一連の推論ステップを依頼すれば、十分こなす。2024年に誰が誰を買収したか尋ねれば、もっともらしいフィクションが返ってくる。
記憶された事実を買うのはパラメータ数であり、コンシューマーサイズのモデルはそのパラメータのほとんどを捨てている。検索で格差を埋めることはできる:事実をコンテキストに入れて、ローカルモデルに構造的な部分だけを担当させればよい。検索レイヤーなしで広範な想起が必要なものは、フロンティアAPIに任せるべきだ。
「オープンモデルが追いついている」という見出しは、あなたが持っていないハードウェアの話
Epoch AIは格差を、2026年1月以降4ヶ月・8 ECIポイントとしており、2023年1月〜2025年10月に測定した平均3ヶ月よりわずかに広い(Epoch AI)。この数値は正確だが、あなたのラップトップについては何も語っていない。オープンウェイトの首位モデルGLM-5.2は、Artificial AnalysisのIntelligence Index v4.1でスコア51を記録し、総パラメータ744B・アクティブ40Bだ(Artificial Analysis)。データセンター向けのハードウェアだ。同じ測定でGLM-5.2はタスクごとに43,000出力トークン(うち37,000が推論トークン)を消費しており、タスクあたり約$0.46、MiniMax-M3の$0.18と比較される。
量子化のコスト
Q4_K_Mがデフォルトである理由がある。Apple M1 Proのllama.cpp上でMistral-7B-Instruct-v0.2に適用したところ、モデルサイズは7.2GBから4.1GBへ43.1%削減され、パープレキシティの低下は0.51%にとどまった(dasroot)。Q2_Kはパープレキシティ損失が7.94%と曲線が折れ、ベンチマークに現れる前に指示追従の場面で体感できる。4bitまで量子化したら止めて、節約したメモリはコンテキスト長に回すべきだ。
ハードウェアの底値が動いた——間違った方向へ
見つかる損益分岐点の計算はすべて、定価でハードウェアを買えることを前提にしている。2026年においてそれはほぼ不可能であり、定価自体も上がった。
メモリ危機——確認できる価格データで
コンベンショナルDRAMの契約価格は1Q26に前四半期比約93〜98%上昇し、2Q26にさらに58〜63%、TrendForceは3Q26にさらに13〜18%を予測している(TrendForce)。これは減速であり、下落ではない。価格はすでに2倍になった基準値からさらに上がり続けている。需要はあなたから来ているわけではない:データセンターが2026年に世界のメモリ生産の最大70%を吸収しており、2022年の約20〜30%から大きく増えた。HBMだけで今年のDRAMウェハーの23%を占め、2024年の8%から急増している(IDC)。ローカル推論はメモリ容量の購入であり、回避しようとしているクラウドを構築している人々と競合している。
DGX Spark・RTX 5090、そしてMSRPと実売価格の乖離
NVIDIAは2026年2月にDGX Sparkを$3,999から$4,699へ$700値上げし、DRAMとストレージコストの急騰を理由に挙げた(Notebookcheck)。128GBのLPDDR5Xがローカルモデル用途として魅力的な理由であり、同時に価格がコントロールできないコモディティ市場に連動する理由でもある。
比較記事で引用されている2025年のMSRPはいずれも参考程度に扱うべきだ。今週その部品がいくらで売れているか確認してから、その数字で計算を回すこと。
誰もが忘れている電気代という費目
GPUは一度の購入で毎月請求書が届く。米国の住宅用電力は2026年6月に平均18.34¢/kWhで、前年比5.0%上昇。州によってニューメキシコの8.96¢からカリフォルニアの28.50¢まで3倍以上開きがある(EIA)。同じ構成でも、どこに設置するかで電力コストが3倍以上変わる。カリフォルニアならば、電力代だけで同等のホスト型トークンのコストに匹敵しかねない。ニューメキシコでは計算が変わり、答えも変わる。
2026年において合理的な構成を組むのにかかるコスト
現在の実売価格でハードウェアを予算に計上し、実際の電力料金での電力消費を加え、ホスト型エンドポイントでは不要なローカル推論フレームワークのセットアップや量子化チューニングに費やす時間コストも加える。4桁のCapExに3桁の年間OpExが続くのが正直な出発点であり、どちらもモデルの品質とは無関係な理由で今年は悪化した。
Ollama vs クラウドAPIのコスト:比較は今や三つ巴
今や3つの価格が重要だ:買うGPU、ホスト型オープンウェイト、そしてフロンティアAPI。ほとんどのワークロードで真ん中の選択肢が勝ち、公開されている損益分岐点の計算式にはほぼ含まれていない。
Ollama自体が2026年8月31日にクラウドAPIになった
一世代の開発者に自分のマシンでモデルを動かすことを教えたあのツールが、今やトークンを売っている。2026年8月31日、OllamaはPro・Max・Teamをトークン単位のクラウド課金に移行した:$20/月($60の利用枠込み)、$100/月($300込み)、$500/月(無制限ユーザーで共有の$1,000込み)で、データ保持ゼロ・米国およびヨーロッパでのホスティング(Ollama)。つまり「Ollama vs クラウド」はもはや実際の選択肢の対比を指していない。
ホスト型オープンウェイト:誰も試算しない中間の選択肢
| モデル | 入力 / 出力(100万トークンあたり) | 出典 |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
これらの数値を基に予測を構築する前に細則を読むこと。Ollama Cloudのほとんどの料金は平日の12:00〜18:00 UTC(ピーク時)に2倍になり(Ollama)、請求額はスケジューリングの問題になる。バルクジョブを夜間や週末に回せば表示料金を維持できる。欧州の午後のユーザー向けにインタラクティブな製品を運営するなら、毎営業日2倍の料金を払う。このタイミング変数は、似たような料金の2つのホスティングプロバイダー間の選択よりも注目に値する。
フロンティアAPIは定価より安い
キャッシュ読み取りは基本入力価格の0.1倍で請求され、バッチAPIは入出力両方を50%削減し、2つの割引は重なる(Anthropic)。バッチ処理のHaiku 4.5は入力$0.50・出力$2.50/100万トークンとなり、Sonnet 5は2026年9月1日の予定価格$3/$15への移行なしに導入時の$2/$10を維持した(Anthropic)。非同期バルク処理はまさにローカル環境が売り込まれるユースケースであり、クラウド割引が最も効くワークロードでもある。
逆方向に働くトークナイザーの注意書き
Claude 4.7以降は同じテキストに対して約30%多くのトークンを生成する新しいトークナイザーを使用する(Anthropic)。固定コーパスでの実際のSonnet 5の請求額は、古いトークナイザーを持つローカルモデルと比較したとき、$2/$10の料金表が示す額より約30%高くなる。コミットする前に、自分のテキストで両方のトークン数を計測すること。
損益分岐点を計算する:どのボリュームでGPUが有利になるか?
所有ハードウェアがホスト型オープンウェイトに勝ち始めるのは、持続的なGPU日次稼働率が約26%、つまり毎日約6時間の実稼働を2026年のハードウェア価格と地元の電力料金で償却した場合だ。その閾値を下回ると、カードはアイドル状態のまま減価償却が進む。購入前に自分のボリュームをホスト料金と照らし合わせること:deepseek-v4-flashはOllama Cloudで入力$0.22・出力$0.66/100万トークンで動く(Ollama)。
ローカルが有利な場面(短く名指しできるリスト)
精査に耐えるケースは4つ。それ以外はすべて、簡単なクエリをローカルモデルに振り、残りをエスカレーションするハイブリッド構成になる。
カードを稼働させ続ける持続的な高ボリュームのバッチ処理
GPUが1日の90%アイドル状態なら、電気ストーブを買ったも同然だ。購入が正当化されるには、カードが毎日4分の1以上稼働し、しかも入出力トークンを50%カットしてプロンプトキャッシュと重なるClaude Batch APIとの比較に勝つ必要がある(Anthropic)。それによってHaiku 4.5のバッチ処理は入力$0.50・出力$2.50/100万トークンになる。ローカル環境はそれを、償却済みハードウェアプラス電力で下回らなければならない。2026年6月の米国住宅用電力平均18.34¢/kWhで(EIA)、実負荷で稼働するカードも安くはない。スペックシートではなく、実際のトークンボリュームで計算を回すこと。
厳格なデータ主権要件、CLOUD Actへの対応——GDPRだけではない
ここには本物のカテゴリーが存在するが、多くの人が主張するより狭い。GDPRコンプライアンスは契約の問題だ。米国管轄の企業がデータの提出を強制されないという要件は物理的な問題であり、物理的な問題は自分でコントロールするハードウェアで解決される。
タイム・トゥ・ファースト・トークンが製品価値を左右するインタラクティブループ
ローカル推論はクラウドの200〜800msに対して50〜200msのタイム・トゥ・ファースト・トークンを実現し、Claude Haiku 4.5は597ms・GPT-4.1 Miniは約2,400msと測定されている(Eden AI)。チャットウィンドウではほぼ気づかない差だ。しかしインラインコード補完や8回のAPIコールを連鎖させるマルチステップエージェントでは、この差がユーザーが体感できるものに積み重なる。その形で構築しているなら、ディレクトリのAIエージェントを参照して、キーストロークごとにラウンドトリップが発生するものがいくつあるか確認してほしい。
オフラインおよびエアギャップ環境での運用
議論の余地はない。ネットワークがあるかないか、それだけだ。
クラウドが今や売り返すプライバシーの論拠
ケース2への最強の反論は、Anthropicがその特性を直接売ってくれるということだ。Claude 4.6以降、inference_geo: "us" で推論を米国限定に固定すると、全トークンカテゴリーに1.1倍の乗数がかかる(Anthropic)。DGX Sparkの$4,699の代わりに10%のプレミアムだ。OllamaのPaidプランは2026年8月31日時点でデータ保持ゼロ・米国およびヨーロッパでのホスティングを謳っている(Ollama)。プライバシー要件が契約上の保証と地理的固定で満たされるなら、ハードウェア要件はない。
多くの実務者が行き着くハイブリッド構成
原則ではなく難易度でルーティングする。自分のカード上の20〜30B MoEモデルが、一般的なアシスタントや文書処理ワークロードの約7割のクエリを処理し、残り3割がフロンティアAPIへ。この分割がアーキテクチャだ。あとはすべてチューニングだ。
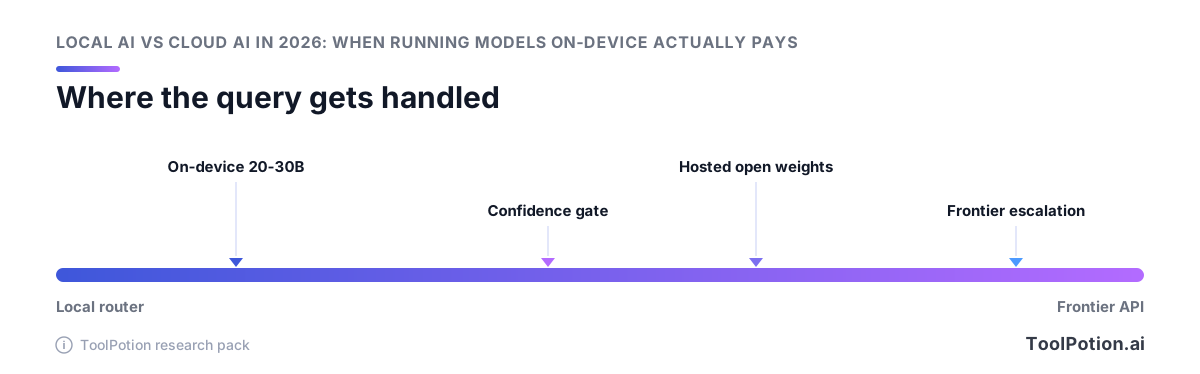
エスカレーションを決める3つのシグナルはローカルモデルが終わる前に計算できる:モデル自身のコンフィデンス(対数確率のマージンや安価な自己チェック)、クエリがローカルウェイトにない世界知識を必要とするか、そしてコンテキスト長。知識に関するものがほとんどの失敗を捕捉する。24GBクラスのモデルは推論は得意で事実想起は苦手なので、「2025年に誰が誰を買収したか」のようなクエリはローカルを完全にスキップすべきだ。
機能するコンクリートなスタック
前段にOllamaまたはLM Studio、後段に1つのフロンティアAPI、その間にすべての判断をログに残す薄いルーターを置く。
エスカレーションされたトラフィックはまずClaude Haiku 4.5(入力$1/MTok・出力$5/MTok)に送り、Haiku の回答がチェックを通らない時だけSonnet 5($2/$10)に進む(Anthropic料金)。エスカレーションされた処理が非同期ならバッチ化する:バッチAPIは両方を半額にするため、Haikuは$0.50/$2.50になる。ほとんどのチームはこれをスキップして、20分待てばよかった処理に定価を払っている。
エスカレーション率を計測しなければ、手探り状態のまま
リクエストごとに4つの数値をログに残す:どの層が処理したか、ローカルモデルのコンフィデンス、トークン数、そして人間が回答をリトライしたかどうか。リトライ率が本当の品質シグナルだ。エスカレーション率が約20%を下回ると、ローカルモデルが処理すべきでないものを答えており、リトライに現れる。45%を超えるとGPUが減価償却に見合っていない。
境界が四半期ごとに動く理由
両側の価格はアーキテクチャより速く動く。Ollamaは2026年8月31日にPro・Max・Teamをトークン単位のクラウド課金に移行し(Ollama)、Ollama Cloudの料金は平日12:00〜18:00 UTCに2倍になり(Ollama料金)、オープンウェイトの性能は2026年1月以降平均約4ヶ月クローズドフロンティアに遅れている(Epoch AI)。四半期に一度、最新の数値でルーティング閾値を再計算すること。カレンダーに入れておくべきだ。
ツールレイヤーは十分安定して構築できる
Ollamaは14名のチームで月間890万人のアクティブ開発者を抱え、Fortune 500の85%で使われており、2026年7月にTheory Ventures主導で$65Mを調達した(TechCrunch)。来年消えるようなプロジェクトではない。その周りのルーターのグルーコードは自分が所有する部分であり、すでにこのパターンを公開しているオープンソースAIリポジトリから大半を借用できる。
5つの質問で決める
順番に答えよう。最初に明確なYesが出た質問があなたの構成を決める——そこで止めてよい。
厳格な主権要件はあるか?
「厳格」とは、エアギャップ、法務が書面化したCLOUD Act上のリスク、またはマシンを名指しする契約を意味する。該当するなら、ハードウェアを買ってコストの節を読むのをやめる。要件がそれより緩いなら、AnthropicはClaude 4.6以降で inference_geo: "us" により推論を米国限定に固定でき、全トークンカテゴリーに1.1倍の乗数がかかる(Anthropicの料金ドキュメント)。OllamaのPaidプランも米国およびヨーロッパでデータ保持ゼロで動く(Ollama)。10%のプレミアムはほぼ全員にとって$4,699のハードウェアより有利だ。
作業はレイテンシ依存か、スループット依存か?
人がトークンごとに待つインタラクティブループはローカルが有利:クラウドの200〜800msに対して50〜200msのタイム・トゥ・ファースト・トークン。Claude Haiku 4.5は597msと計測されている(Eden AI)。スループット作業は逆だ。バッチ化して50%割引を受ければ、Haiku 4.5は入力$0.50/MTok・出力$2.50になる(Anthropic)。
GPUは毎日4分の1以上稼働し続けるか?
その閾値を下回るとカードはアイドル状態で減価償却が進み、ホスト型オープンウェイトがコストで勝つ。それを超えるとローカルの計算が成立し始める。分母に正直になること——夜間や週末もカウントされる。
タスクには世界知識が必要か、それとも推論だけでよいか?
供給するテキストに対する推論は20〜30B MoEモデルで問題なく動く。モデルがあらかじめ知っている必要のある事実に依存するクエリは、フロンティアAPIか、総パラメータ744Bで決してラップトップに収まらないホスト型GLM-5.2に任せる(Artificial Analysis)。
四半期ごとの再調整に耐えられるか?
オープン・クローズドの格差は4ヶ月で、3ヶ月平均から動いている(Epoch AI)。つまりルーティング閾値には賞味期限がある。見直しをしないチームはキャッシュを有効にしたフロンティアAPIをデフォルトにして何もルーティングしないほうがよい。見直しができるチームは、他者の閾値がどうなったかを実際のデプロイ事例で確認できる。
2027年にこの評価を変えること
このアドバイスには有効期限があり、それを決める特定の数値が3つある。
メモリ価格は減速しているが、下落していない
コンベンショナルDRAMの契約価格は1Q26に前四半期比約93〜98%上昇し、2Q26に58〜63%、3Q26には13〜18%の予測。曲線は平坦化している。まだ上を向いている。上昇率の減速は、2026年2月にNVIDIAがDGX Sparkに加えた$700の値上げを取り戻してくれるわけではないし、来年実売価格が下がるとも予測されていない。データセンター需要が緩むまでは、2027年を通じてハードウェアの論拠は弱いままと見ておくべきだ。
見るべきはオープン・クローズドの格差であり、トップライン指標ではない
どのリーダーボードの順位よりも重要なシグナルが2つある。1つ目はEpoch AIのECIギャップで、2026年1月以降4ヶ月・8ポイント。2つ目はアクティブパラメータ数:GLM-5.2はオープンウェイトの先頭に立つが744B総数のうち40Bがアクティブであり、アクティブ30B未満のモデルがフロンティアのECIポイントに近づく日が来れば、24GBカードが再び面白くなる。OllamaのピークアワーでのDouble(12:00〜18:00 UTC平日)が定着するか正常化するかも注目だ。AIトレンドレポートではこれらのいずれかを動かすモデルリリースを追跡している。
よくある質問
2026年においてLLMをローカルで動かすのとクラウドAPIを使うのとでは、どちらが安いか?
ほとんどの人にとってはクラウドであり、2026年にその差は広がった。Claude Haiku 4.5の定価は入力$1/100万トークン・出力$5で、バッチAPIで$0.50/$2.50に下がり、プロンプトキャッシュヒットは基本入力料金の0.1倍で請求される(Anthropic料金)。一方、NVIDIA DGX SparkはDRAMとストレージコストにより2026年2月に$3,999から$4,699へ値上がりし(Notebookcheck)、2026年6月の米国住宅用電力平均18.34¢/kWhでの電力料金も別途かかる(EIA)。ローカルがペイするのは、カードを毎日大部分の時間稼働させ続ける持続的な高ボリュームのバッチ処理、エアギャップ運用、レイテンシに敏感なループの場合だ。
2026年においてLLMをローカルで動かすのに必要なハードウェアは?
実用的なコンシューマーの最低ラインは24GB GPUで、オープンウェイトのフロンティアには遠い20〜30B MoEクラスに制限される。それ以上になると、現在$4,699のDGX Sparkのような128GB LPDDR5X搭載のボックスを購入することになる(Notebookcheck)。上昇し続けるメモリ価格も予算に入れること:コンベンショナルDRAMの契約価格は1Q26に前四半期比約93〜98%、2Q26に58〜63%上昇し、3Q26にさらに13〜18%が予測されている(TrendForce)。量子化で収まるサイズを伸ばせる。4bitはほぼ無コストに近い:Q4_K_MはMistral-7B-Instruct-v0.2を7.2GBから4.1GBに圧縮してパープレキシティ損失はわずか0.51%、Q2_Kは7.94%で急激に劣化した(量子化のトレードオフ)。
ローカルモデルはClaudeやGPTと比べてどれほど優秀か?
よく引用される格差は本物だが、あなたが持っていないであろうハードウェアの話だ。Epoch AIは2026年1月以降、オープンウェイトモデルがクローズドフロンティアより平均4ヶ月・8 ECIポイント遅れていると測定しており、2023年1月〜2025年10月の平均3ヶ月よりわずかに広い(Epoch AI)。この主張を担っているモデルGLM-5.2はArtificial AnalysisのIntelligence Index v4.1でスコア51を記録し、総パラメータ744B・アクティブ40Bで、データセンターのハードウェアだ(Artificial Analysis)。ラップトップや1枚のGPUに実際に収まるのは、構造的な推論は得意で世界知識は苦手なモデルだ。4ヶ月という数値は、自宅では届かない上限として扱うべきだ。
Ollamaはまだ無料か?Ollama Cloudの価格はフロンティアAPIとどう比べるか?
ローカル対Ollamaという構図は、2026年8月31日にOllamaがPro・Max・TeamをトークンごとのクラウドAPIに移行した時点で意味をなさなくなった:$20/月($60利用枠込み)、$100/月($300込み)、$500/月(無制限ユーザー共有の$1,000込み)、データ保持ゼロで米国およびヨーロッパでのホスティング(Ollamaブログ)。そこでのホスト型オープンウェイトは安い:deepseek-v4-flashは入力$0.22・出力$0.66/100万トークン、nemotron-3-superは$0.015/$0.60、qwen3.5:397bは$0.60/$3.60。ただし平日12:00〜18:00 UTCのピーク時間帯はほとんどの料金が2倍になる(Ollama料金)。Claude Haiku 4.5の$1/$5(Anthropic料金)と比べると、本当の判断は三つ巴であり、ほとんどのワークロードでホスト型オープンウェイトがコストで自分のGPUに勝る。Ollamaは月間890万人のアクティブ開発者とFortune 500の85%というスケールで、どちらの選択にも真剣に向き合える存在だ(TechCrunch)。
モデルをローカルで動かすことは、クラウドAPIよりデータをプライベートに保つか?
それが与えてくれる特性は、他の何も提供しないものが1つある——バイトが自分のマシンから出ない、ということだ。エアギャップ作業やCLOUD Actのようなハードなデータ主権要件にはそれが重要だ。それより緩い要件については、プロバイダーが今や同じ保証を安価に売っている。Claude 4.6以降で inference_geo: "us" で推論を米国限定に固定すると、全トークンカテゴリーに1.1倍の乗数がかかる(Anthropic料金)。OllamaのPaidプランは米国およびヨーロッパでデータ保持ゼロで動く(Ollamaブログ)。10%のプレミアムは$4,699のハードウェアよりはるかに小さいコミットメントだ(Notebookcheck)。
24GB GPUでどのローカルモデルから始めるべきか?
Qwen3-30B-A3BやGPT-OSS-20BなどQ4_K_M量子化の20〜30B MoEモデルから始めること。このクラスはRTX 5090 1枚でAIME 2024を73〜87%スコアするため推論はしっかり機能するが、世界の事実想起は苦手な部分だ。Q4_K_Mが適切な量子化の停止点だ:7.2GBのモデルを4.1GBに圧縮してパープレキシティ損失はわずか0.51%、Q2_Kは7.94%で急激に劣化した(量子化のトレードオフ)。最初のホップとして動かし、知識負荷の高いクエリはクラウドモデルにエスカレーションすること。