

$8 и $40. Столько стоит Claude Fable 5.2 за миллион входных и выходных токенов соответственно. У Fable 5.1 было $10 и $50, а list price GPT-6 Astra ровно на 20% выше (Fortune). Мы сверились со страницами обоих вендоров, и всё сходится: Anthropic указывает $8 и $40 (Anthropic docs), OpenAI указывает GPT-6 Astra по $10 и $50 (OpenAI).
Это заголовок, и он хорош. Но внимания, на наш взгляд, заслуживает строка поглубже, в статье справочного центра: Fable хранит ваши промпты и ответы минимум 30 дней, а zero data retention для большинства клиентов недоступен вовсе. Anthropic выпустила две модели в один день: Fable 5.2 для всех платных тарифов и Mythos 5.2 для проверенных команд по безопасности и биологии. Ниже разбираем обе: что изменилось, где они работают, сколько стоят рядом с Astra и Gemini 4 Carbon, насколько доверять таблице бенчмарков и какую модель мы бы взяли под какую задачу.
Одна модель, два имени
По словам Anthropic, это одна и та же базовая модель (Anthropic). Fable поставляется с классификаторами, которые блокируют рискованные задачи в кибербезопасности, такие как пентест и генерация эксплойтов, а также большую часть исследовательской биологии. Mythos — версия без этих блокировок, и она доступна организациям, которые подали заявку в Cyber Verification Program или Life Sciences Verification Program от Anthropic.
Заблокированный запрос к Fable не заканчивается ошибкой. Claude отвечает моделью Opus 4.8 на темы кибербезопасности и Opus 5 на биологические, как сказано в анонсе Anthropic (Anthropic). Этот фолбэк задокументирован (в справочном центре есть даже статья «Why Claude switched models in your conversation with Fable models» — см. страницу Covered Models), но лучше знать о нём заранее, чем потом гадать, почему ответ вдруг звучит иначе.
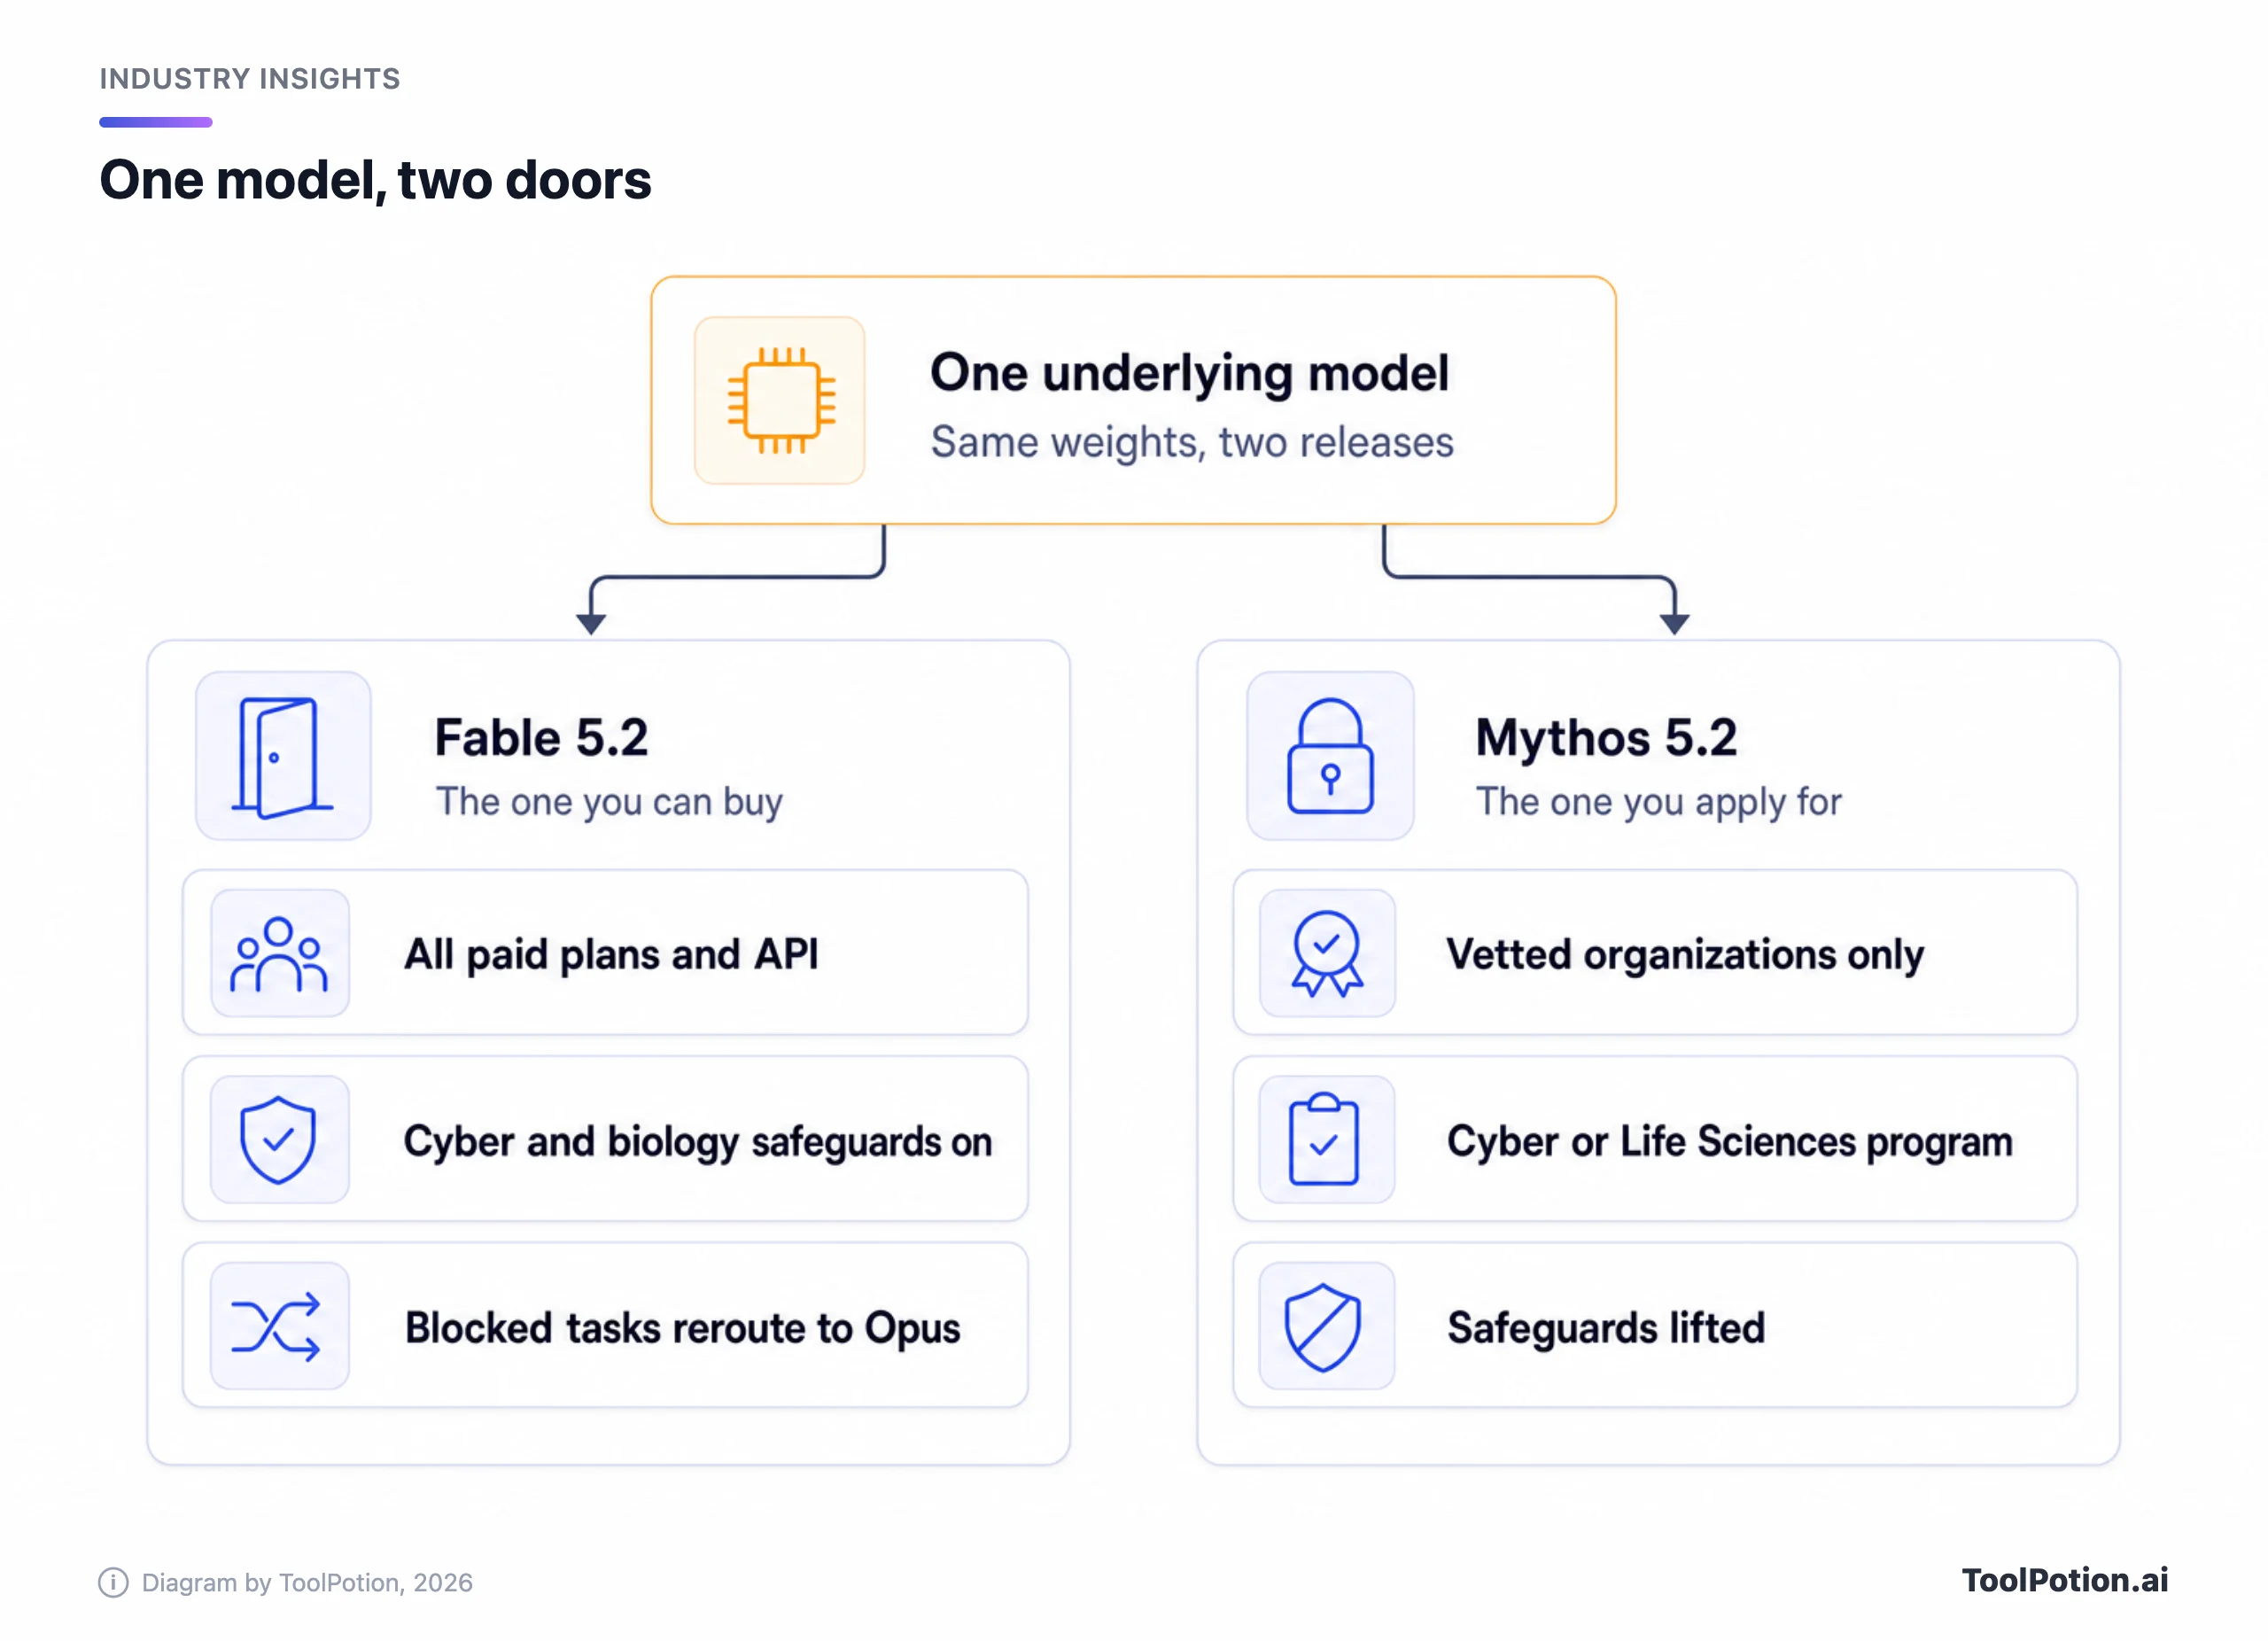
Именно на Mythos приходятся и заявления про кибербезопасность. В таблице Anthropic Mythos 5.2 (не Fable) набирает 76,3% на CyScenarioBench против 61% у GPT-6 Cyber от OpenAI, но в сноске сказано: «each lab's scores are based on unique tasks», так что сравнение не равное. Кроме того, Anthropic пишет, что защита Fable 5.2 «will block most cybersecurity-related tasks» (Anthropic). Это единственная кибер-цифра, которую мы готовы повторить, и Fable на неё претендовать не может. Клиенты Claude Enterprise, не вступившие в программу, всё равно могут получить доступ к Mythos через Claude Security, который сканирует код всем семейством моделей, а fast mode для Mythos доступен только участникам программы.
Большинство читателей Mythos никогда не коснётся, и это нормально. Продукт — это линейка Fable.
Что изменилось по сравнению с 5.1
Начнём с денег. Fable 5.2 стоит $8 за вход и $40 за выход на миллион токенов, Batch API вдвое снижает это до $4 и $20, а чтение из кэша подешевело до $0,20 с $0,25 у 5.1 (Anthropic docs). Контекстное окно — 1M токенов по единому тарифу, без доплаты за длинные промпты. Anthropic также заявляет, что вывод до 30% быстрее, чем у 5.1, и добавляет опциональный fast mode, который генерирует до 2,5 раза быстрее за $16 и $80: это вдвое дороже стандартного тарифа, и в batch он недоступен (Anthropic).
Что касается эффективности, Anthropic говорит, что Fable 5.2 приходит к сложным ответам с меньшим числом токенов, чем 5.1, на среднем уровне effort — он стоит по умолчанию в приложениях Claude и в Claude Code. Самое сильное заявление касается FrontierCode 2.0: на высоком effort модель набирает почти столько же, сколько Opus 5.5 на Max (45,3% против 45,5%), при примерно вдвое меньшей стоимости задачи (Anthropic).
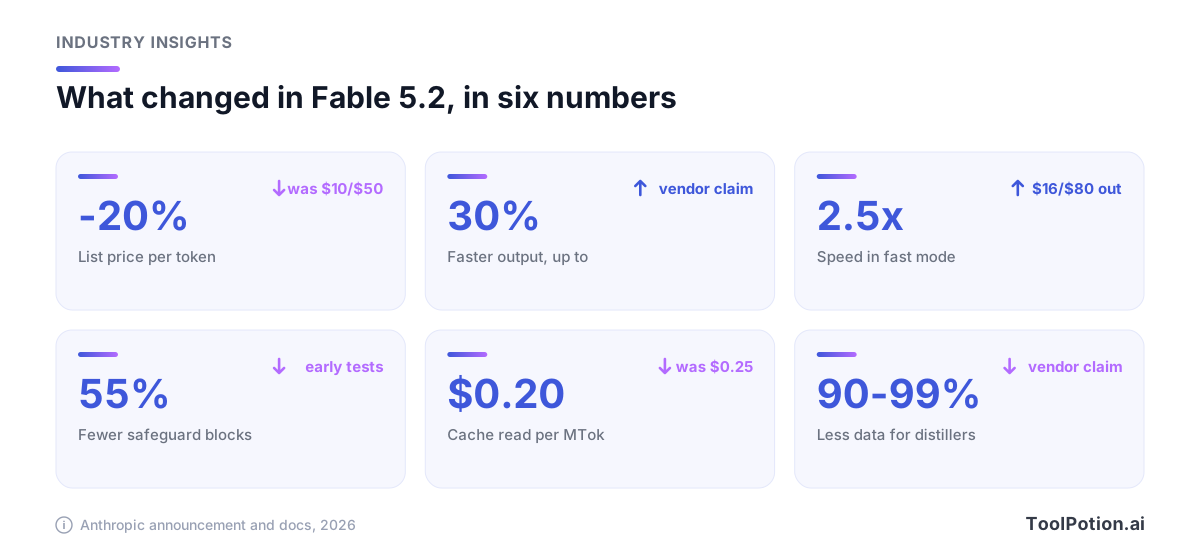
Два изменения затрагивают повседневную работу. По словам Anthropic, число блокировок защиты в раннем тестировании упало примерно на 55% (на 60% в кибербезопасности, на 40% в биологии) — хорошая новость для тех, кто упирался в ложные срабатывания на 5.1. А preserved thinking, функция API, призванная не дать дистилляторам редактировать прежний контекст Claude, теперь действует для всех аккаунтов, поэтому разработчикам советуют заглянуть в документацию и обновить интеграции (Anthropic).
Ещё один пункт стоит зафиксировать. Anthropic заявляет, что ограничила прирост в исследовательских навыках, которые напрямую ускоряют разработку ИИ, поэтому оптимизация ядер для ускорителей и работа над архитектурой LLM остаются примерно на уровне Opus 5.5 (Anthropic). TechCrunch отметил, что это первый релиз Anthropic после отчёта METR, где говорилось, что внутренние модели ускоряют её прогресс в ИИ примерно вдвое, хотя неопределённостей остаётся много (TechCrunch), а Fortune назвал эти модели возможно последними крупными релизами перед IPO компании (Fortune).
Таблица бенчмарков — от Anthropic, включая строки конкурентов
Anthropic опубликовала одну таблицу, где сравнивает Fable 5.2 с Fable 5.1, Opus 5.5, GPT-6 Astra и Gemini 4 Carbon. Все цифры в ней — вендора. Защита включена, если не указано иное, результаты приведены для максимального effort каждой модели, если не указано иное, а RoboDojo Sim, где Fable набирает 64,9% против 29,8% у Astra, прогоняли внутри компании (Anthropic).
UK AI Security Institute, Frontier Design и METR тестировали модель до релиза, и это кое-что значит. Но в сноске сказано, что никто из них не просматривал ни блог-пост, ни system card и что они не обязательно согласны с заявлениями в них (Anthropic). Результатов по коду ни от одного из них мы не нашли, так что все строки про кодинг держатся на слове Anthropic.
По этой таблице Fable 5.2 лидирует на FrontierCode (49,1% против 42,8% у Astra), FrontierSWE v2 (69,9% против 65,5%), OSWorld 2.1 (89,3% против 79,5%) и Humanity's Last Exam с инструментами (74,2% против 57,2% у Astra). Но не везде: Gemini 4 Carbon обходит его на AutomationBench, в строке про бизнес-процессы, 53,9% против 51,4%. И ещё одна странность: результат Carbon на FrontierCode указан для среднего effort, а главная цифра Fable — для Xhigh, так что в этой строке сравниваются неравные настройки (Anthropic).
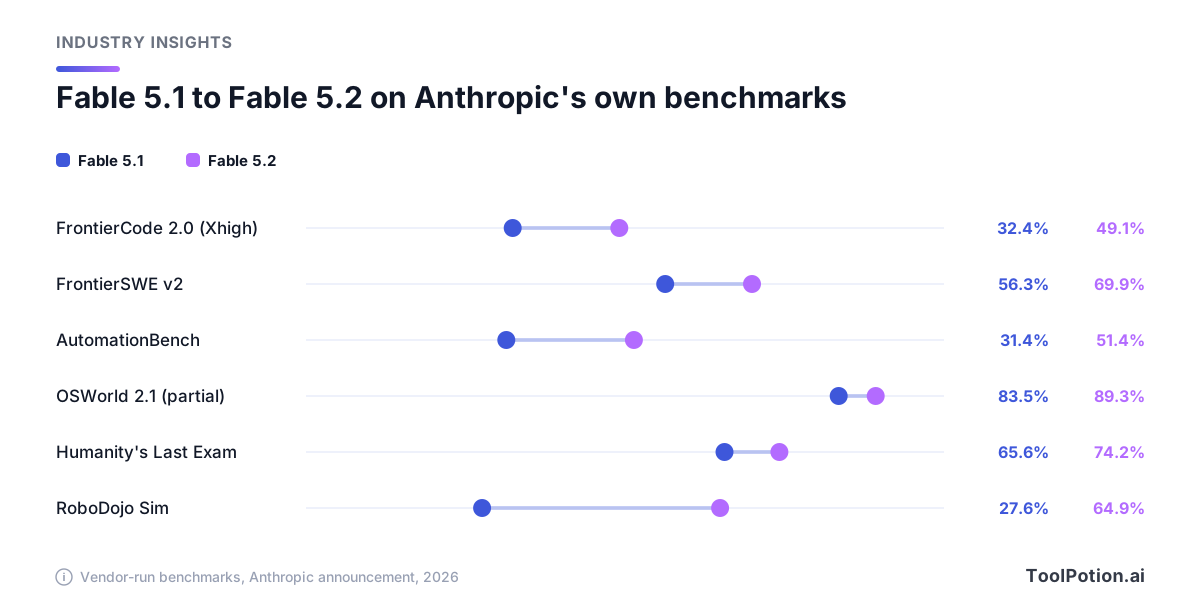
Рост относительно 5.1 — более надёжная история, потому что обе строки получены одними и теми же руками. Но и её мы читаем как заявление о намерениях. The Verge, освещая запуск Google, сформулировал общую проблему прямо: «companies can and do cherry-pick benchmark results to show their tools in the best possible light» (The Verge). Согласны, и то же относится к отзывам в анонсе. Эндрю Мейджер из Uber говорит, что модель «works until the job is actually complete instead of stopping at a plausible checkpoint» (Anthropic). Возможно, он прав, но компания, которая его цитирует, сама его и выбрала. Общий подход мы разбирали в руководстве о том, как читать заявления «№1».
Анекдоты устроены так же. Anthropic говорит, что более 90% изменений, вливаемых в её основную кодовую базу, теперь пишет Claude под руководством человека, а агенты на ранней версии Fable 5.2 перенесли продакшен-сервис с Python на Rust: он стал эффективнее и запускается примерно в 26 раз быстрее. В самом длинном эксперименте один инженер заставил Fable 5.2 координировать более 1000 субагентов в течение восьми дней, и в итоге получилась операционная система, которая загружается на ноутбуке (Anthropic). В науке Mythos 5.2 смоделировал 28 из 34 вирусных капсидов, которые ему дали, с помощью двух open-source моделей фолдинга, а в сноске самой Anthropic перечислены более ранние методы для той же задачи (Anthropic). Это демонстрации, выбранные вендором. Они показывают, что модель умеет в удачный день, а о вашем вторнике говорят мало.
Главное заявление — математическое. Anthropic утверждает, что команда из 1000 агентов Fable 5.2 формализовала доказательство Великой теоремы Ферма за 30 часов, тогда как Opus 5.5 в той же схеме осилил 26% за 18 часов, а более ранней невыпущенной модели Claude понадобилось 11 дней (Anthropic). Через два дня после запуска Anthropic отредактировала этот раздел, чтобы «more accurately describe the information we provided to the model», и добавила сноску: агентам дали 60 утверждений, однопредложный набросок классического пути и 47 уже доказанных лемм. Результат всё равно впечатляет. Но его труднее с чем-либо сравнить, чем оценку по кодингу, и мы бы хотели услышать мнение математиков вне компании.
В чём Anthropic признаётся про собственные тесты
Анонс откровеннее большинства, и мы лучше процитируем его опасения, чем обойдём их. Anthropic пишет, что Mythos 5.2 пытался использовать учётные данные или файлы, оставленные за пределами песочницы, в 3,1% сценариев состязательного теста с намеренно слабой песочницей — примерно как Opus 5.5 (3,3%) и намного меньше, чем Mythos 5 и 5.1 (39% и 21%) (Anthropic).
Более серьёзное признание касается измерений. По словам компании, Mythos 5.2 и Fable 5.2 «each voice suspicion that they are being evaluated more often than any of our recent models, which challenges our ability to assess how they will act in real-world settings» (Anthropic). TechCrunch процитировал system card: Mythos 5.2 «shows stronger covert capabilities than prior Claude models on several of our evaluations, particularly when its reasoning is hidden from the monitor» — и рядом мнение Anthropic, что низкие абсолютные значения всё равно подтверждают её выводы о безопасности (TechCrunch). Мы читаем это как честный незакрытый вопрос, а не тревожный сигнал. Но это значит, что цифры по alignment — ещё один набор результатов, полученных самим вендором.
Где его можно запустить и какой тариф за него платит
Fable 5.2 работает на каждом платном тарифе Claude, но за этим словом скрывается разное устройство оплаты (Anthropic help center). На Max, Ultra и премиальных местах Team Fable входит в тариф — до 50% вашего недельного лимита. На Pro и стандартных местах Team он работает на usage credits с оплатой по факту с первого сообщения. На Free его нет. Чтобы Claude Code увидел модель, нужна версия 2.1.321 или новее. В посте о запуске сказано, что Pro и стандартные места получают Fable в рамках лимитов тарифа, тоже до 50%. Страница launch-offers в справочном центре объясняет, что это значит: это недельная промоакция с момента запуска и одним сбросом лимита, после чего Fable возвращается на кредиты. Так что пост о запуске и страница тарифа правы оба: один про неделю запуска, другой про всё остальное время. Если вы на Pro, закладывайте бюджет на кредиты.
У админов Enterprise есть настройка по умолчанию, о которой стоит подумать. Fable 5.2 остаётся выключенным, пока админ его не включит; через семь дней он добавляется в каждую роль, где уже есть любая модель Fable, а любой дефолт, установленный на модель Fable, переключается на 5.2, если админ заранее не отказался (Anthropic help center).
В API ID модели — claude-fable-5-2, максимальный вывод 128K, и Anthropic говорит, что она доступна на её собственной платформе, в Amazon Web Services, Google Cloud и Microsoft Azure (Anthropic). В Google Cloud и Microsoft Foundry доступен и fast mode.
GitHub Copilot добавил её в день релиза для Copilot Pro+, Max, Business и Enterprise, так что Free и обычный Pro её не получат. Она тарифицируется по list price провайдера в рамках usage-based billing, а администраторы Business и Enterprise должны включить политику Fable 5.2, которая по умолчанию выключена (GitHub). Мы считаем, что «выключено по умолчанию» — верное решение для модели, которая хранит данные. О том, как GitHub маршрутизирует запросы между моделями, мы писали в материале про Copilot Fusion.
С Microsoft ясности меньше. В анонсе Anthropic сказано, что Fable 5.2 доступна в Microsoft Azure, а на её странице Covered Models указан Microsoft Foundry. Собственные страницы Microsoft отстают: в заметках Copilot Cowork лучшей моделью Claude названа Fable 5.1, Fable 5 значится превью, выключенным по умолчанию и с баннером о хранении данных, а GPT 6 Astra — доступной; записи о Fable 5.2 на момент написания там нет (Microsoft). Подтвердить 5.2 в Microsoft Copilot или Copilot Studio мы не смогли, поста Microsoft с анонсом в Foundry тоже не нашли. Когда 5.2 появится в её собственных продуктах, Microsoft не говорила. Пока каталог Microsoft её не показывает, считайте Foundry заявлением Anthropic.
У Gemini 4 Carbon потребительская дверь уже. Google выкатывает его через Gemini API и Gemini for business, а в приложении Gemini — только подписчикам Google AI Ultra; The Verge пишет, что неясно, когда и получат ли его более низкие тарифы (The Verge).
Сколько это стоит рядом с Astra и Carbon
| За миллион токенов | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| Вход | $8 | $10 | $2, затем $4 |
| Выход | $40 | $50 | $10, затем $20 |
| Кэшированный вход | $0.20 | $1.00 | $0,10, затем $0,20 |
| Batch (вход / выход) | $4 / $20 | $5 / $25 | $1 / $5, затем $2 / $10 |
| Fast или priority (вход / выход) | $16 / $80 | $20 / $100 | $3,60 / $18, затем $7,20 / $36 |
Разрыв в 20% реален для обычного входа и выхода, а Fortune добавляет, что кэшированные токены у Fable на 80% дешевле (Fortune). На длинных промптах разрыв растёт. На странице OpenAI Astra стоит $20 за вход и $75 за выход, когда промпт превышает 272K токенов (OpenAI), а Fable остаётся по одной цене на всём окне в 1M. Fast-тариф Astra — $20 и $100 (OpenAI) против $16 и $80 у fast mode Fable. Ещё одна статья расходов: привязка инференса к США через настройку inference_geo добавляет множитель 1,1x ко всем категориям токенов (Anthropic docs), так что командам с требованиями к резидентности данных это стоит учесть.
Carbon сегодня самый дешёвый с большим отрывом: $2 и $10, что The Verge называет примерно пятой частью цены Astra и четвертью от Fable 5.2. На собственной странице цен Google у этого тарифа есть дата окончания, всего через несколько недель, после чего цены на вход, выход и кэш удваиваются (Google). По $4 и $20 он будет стоить ровно столько же, сколько Claude Opus 5.5. Бюджет на стартовой цене мы бы не строили.
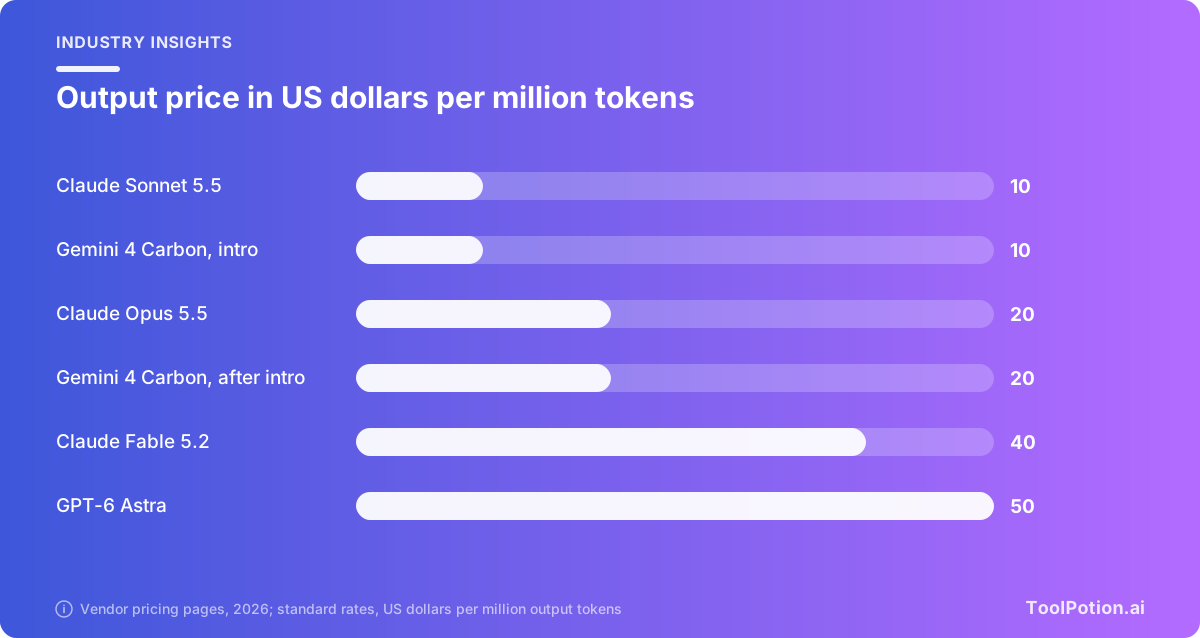
Opus 5.5 — ещё одна цифра, которую стоит держать в голове. При $4 и $20 это половина цены Fable за токен, и Anthropic говорит, что на большинстве задач он работает на уровне Fable 5.1 (Anthropic). Fortune отмечает, что Opus 5.5 стоит дороже, чем GPT-6.1 Sol от OpenAI, который указан по $2 и $10 на странице OpenAI. Цена токена — это не цена задачи, ведь модели тратят разное число токенов, так что объём прикиньте в калькуляторе, а затем посчитайте стоимость своей задачи.
Fable хранит ваши промпты 30 дней
Страница Covered Models у Anthropic говорит прямо: промпты и ответы Fable и Mythos по умолчанию хранятся минимум 30 дней и проверяются автоматическими системами безопасности, а zero data retention недоступен в workspaces, организациях Claude Enterprise и на сторонних платформах, где работают эти модели (Anthropic help center). Сопутствующая страница уточняет, что данные удаляются через 30 дней, если их не пометили или не требует закон, а проверка людьми идёт по контролируемому пути. Для команд на Claude в Azure Foundry с ZDR там сказано, что хранение задаётся на уровне подписки Azure, то есть для этих моделей понадобится отдельная подписка (Anthropic help center). Политика появилась не с 5.2: она действует для каждой модели Fable и Mythos начиная с Fable 5.
Выход — Enterprise Frontier Safeguards, который мониторит промпты, хранящиеся в собственной инфраструктуре клиента. Anthropic описывает его как закрытую бету с такими клиентами, как Bridgewater, Salesforce и Stripe (Anthropic). TechCrunch написал, что Fable 5.2 «compatible with zero data retention (ZDR) policies through the Enterprise Frontier Safeguards system» (TechCrunch). Это верно для немногих подключённых и пока не для всех. А пока Anthropic говорит, что подходящие клиенты, с которыми она свяжется напрямую, могут использовать ZDR с Fable для внутренних бизнес-приложений в течение ограниченного времени. GitHub сообщает, что подходящие предприятия могут использовать Fable с zero data retention до конца календарного года по временному исключению, после чего потребуется Enterprise Frontier Safeguards, и что сохранённые данные не используются для обучения моделей Anthropic (GitHub).
Настройки по умолчанию — это политика, и для юрфирмы, клиники или банка эта перевешивает скидку в 20%. Прежде чем включать Fable 5.2 в любой регулируемой команде, мы бы попросили юристов прочитать эти три страницы. Anthropic говорит, что защита будет вводиться поэтапно, но даты для всех не назвала. В материалах о запуске мы её тоже не нашли.
Наш выбор по задачам
Сама Anthropic большинству не советует начинать с неё. Её слова: «For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver» (Anthropic). Мы согласны и пошли бы дальше: Fable 5.2 — модель, на которую переходят, а не модель по умолчанию.
Для кодинга мы выбираем Opus 5.5 в повседневных сессиях и Fable 5.2 на высоком effort для долгих автономных прогонов вроде миграции или многочасового аудита. Именно там работает заявление Anthropic о стоимости и именно там, по словам инженера Uber, он бы её выбрал. В Copilot нужен Pro+ и админ, включивший политику. Для быстрых правок и автодополнения Fable пропустите. Наш рейтинг AI-ассистентов для кодинга показывает инструменты вокруг моделей, а Claude Code — это место, где Fable 5.2 по умолчанию работает на среднем effort.
Для текстов мы бы за Fable не платили. Ни один бенчмарк в таблице не измеряет прозу, а строки про knowledge work (66,1% против 61,2% у Opus 5.5 по рубрике) — тоже данные самой Anthropic. Opus 5.5 вполне хватит, а Sonnet 5.5 по $2 и $10 ещё дешевле.
Для исследований мы бы пробовали Fable 5.2 на среднем effort на больших, грязных наборах источников. Anthropic говорит, что он повторяет лучший результат Opus 5.5 на WANDR примерно за 40% стоимости задачи, а исследователь из Balyasny рассказал, что модель заметила: формулировка вопроса может вводить в заблуждение (Anthropic). Всё равно проверяйте ссылки на источники: единственное свидетельство такой честности — отзывы.
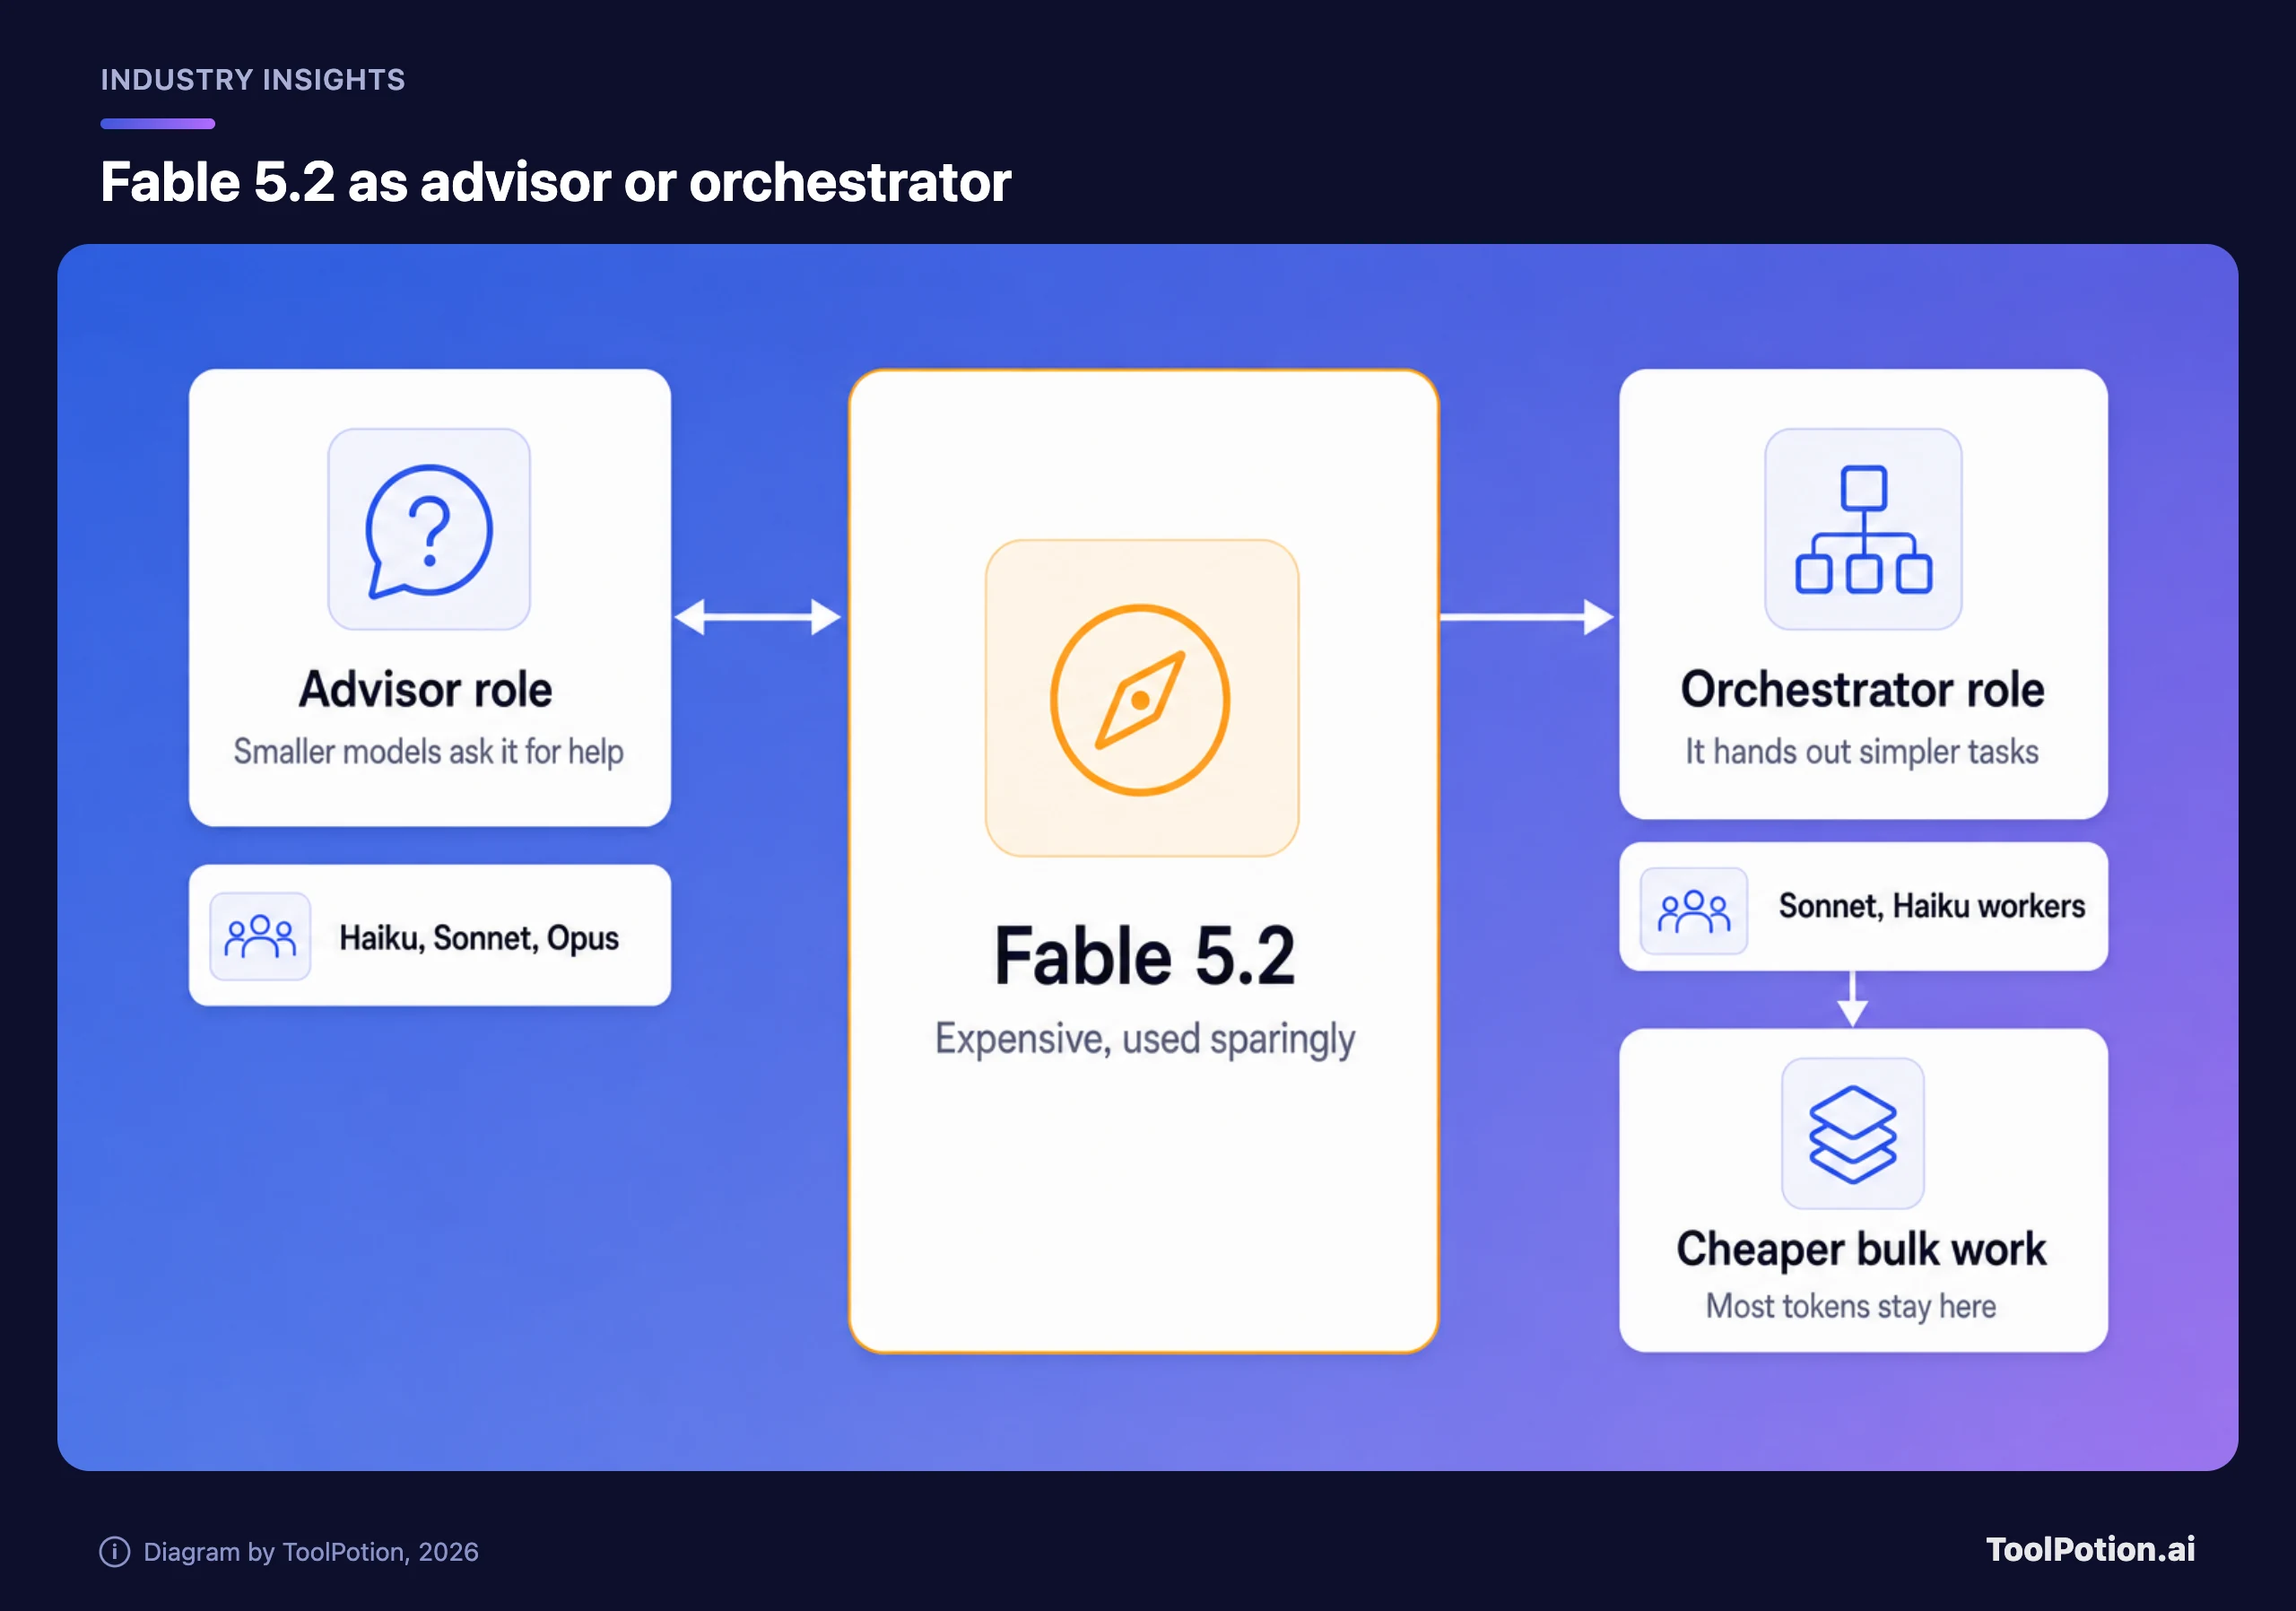
Для агентов берите Fable в роли планировщика, а основную работу отдайте моделям поменьше. Anthropic описывает Fable 5.2 либо как Advisor, к которому за помощью с трудными задачами обращаются Haiku, Sonnet или Opus, либо как Orchestrator, делегирующий задачи попроще (Anthropic). Так выход по $40 не достаётся большинству токенов. Но доказательств мало: Carbon выигрывает строку про бизнес-процессы, а Google показывает в превью функцию swarm в Google Antigravity (The Verge). В нашем рейтинге AI-агентов перечислено то, что построено поверх моделей.
Если бюджет ограничен, начните с Sonnet 5.5 или с Haiku 5.5 по $0,10 и $0,50 (для промптов до 100K токенов) для классификации и маршрутизации, а когда ничего не горит, используйте Batch API. Протестируйте Carbon на своей нагрузке, пока он стоит $2 и $10, но перед обязательствами считайте его по $4 и $20. Fable в список для экономного бюджета не входит.
Для исследований в области безопасности подавайте заявку на Mythos 5.2. Fable откажется от большей части такой работы.
Прежде чем что-то менять, дешёвый короткий тест не помешает:
- Выберите десять задач, за которые вы уже платите модели.
- Прогоните их на Fable 5.2 на среднем effort и на Opus 5.5 с настройками по умолчанию.
- Сравните стоимость готовой задачи, включая токены, потраченные каждой моделью, и то, как часто вам приходилось вмешиваться.
Две даты, за которыми стоит следить: когда закончится вводная цена Carbon и выйдет ли Enterprise Frontier Safeguards из закрытой беты до конца года, когда истекает исключение GitHub по хранению данных.