

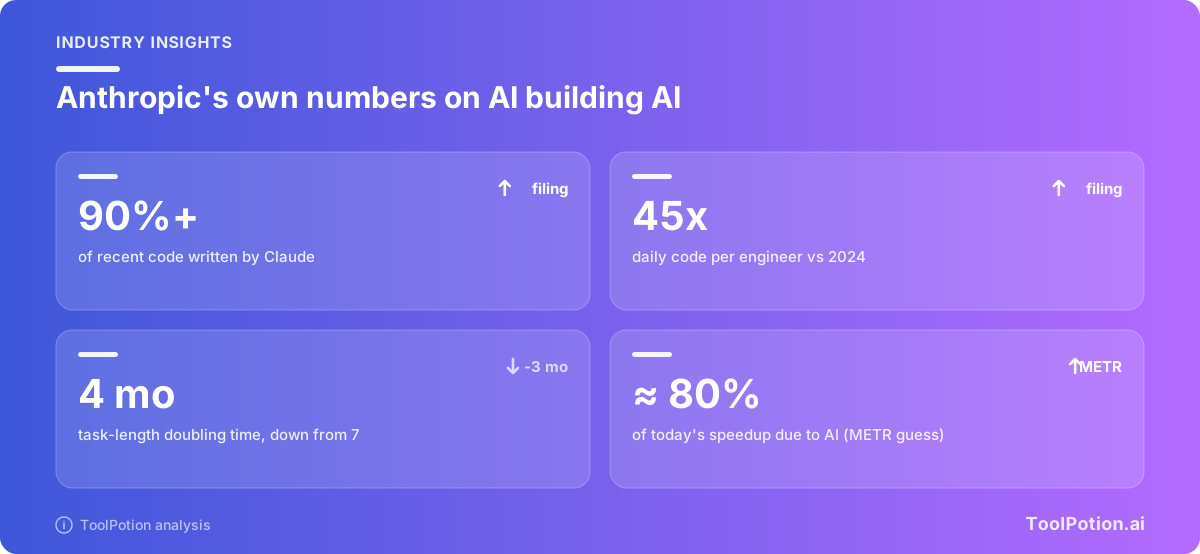
Более 90% вкладов в кодовую базу Anthropic за последний месяц, охваченный обновлённой заявкой на IPO, написал Claude. Это данные самой компании (документ SEC), и это самое невыразительное, что есть в тексте.
В разделе о рисках спрятана фраза, которая попала в новости: по внутренним оценкам Anthropic, компания «may imminently meet» определение резко ускоренного прогресса на основе ИИ из своей Responsible Scaling Policy. TechCrunch подал это как предупреждение Anthropic о том, что она «very close to RSI capability» (TechCrunch). Мы считаем, что предупреждение настоящее, заголовок чуть громче самого документа, а больше всех это касается тех, кто никогда не станет читать раздел о факторах риска.
Рекурсивное самоулучшение без фантастики
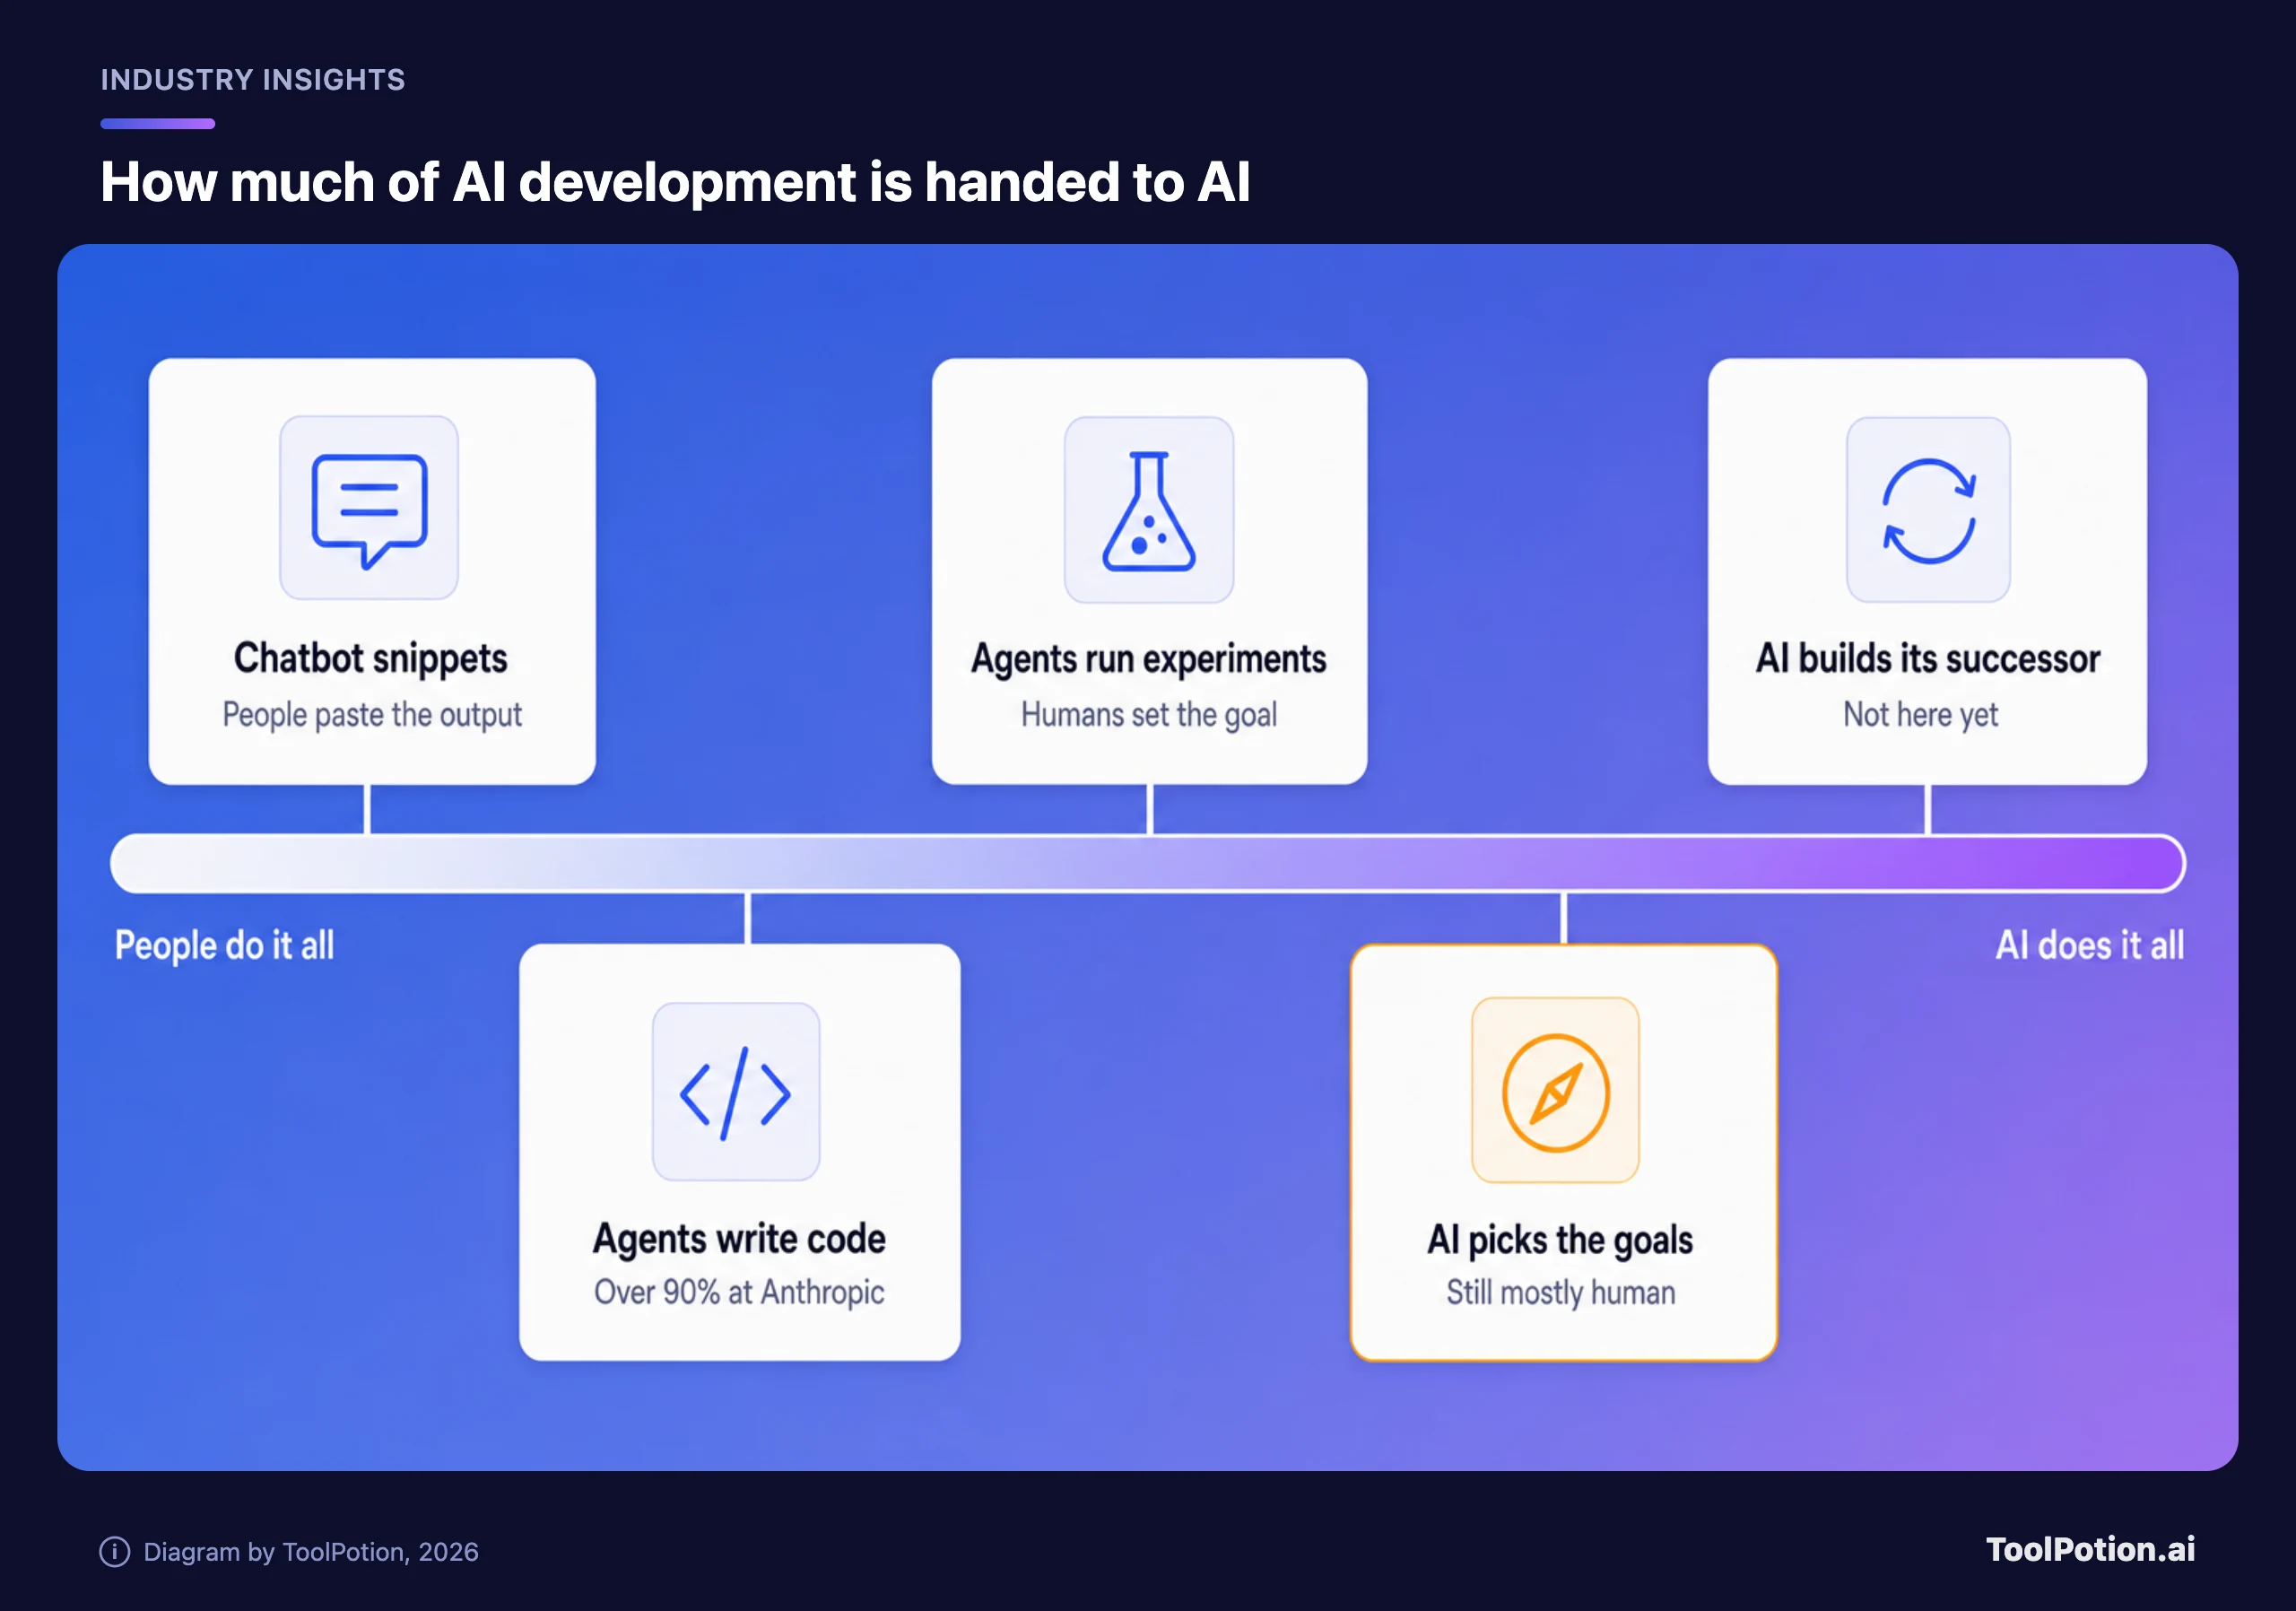
Рекурсивное самоулучшение (RSI) — это петля. ИИ-система помогает создавать следующую ИИ-систему, а та ещё лучше помогает создавать следующую за ней. Определение самой Anthropic: «система ИИ, способная полностью автономно проектировать и разрабатывать своего преемника» (Anthropic Institute).
Никто не утверждает, что петля замкнулась. Сегодня цели ставят люди, а ИИ делает всё большую долю работы: Claude Code пишет и запускает код, агенты передают друг другу многочасовые задачи, а Anthropic говорит, что Claude уже способен сравниться с опытными людьми или превзойти их в проведении чётко поставленного эксперимента. Слабое место, по её словам, — суждение: «большие разрывы в производительности сохраняются, когда речь о том, как Claude выбирает цели».
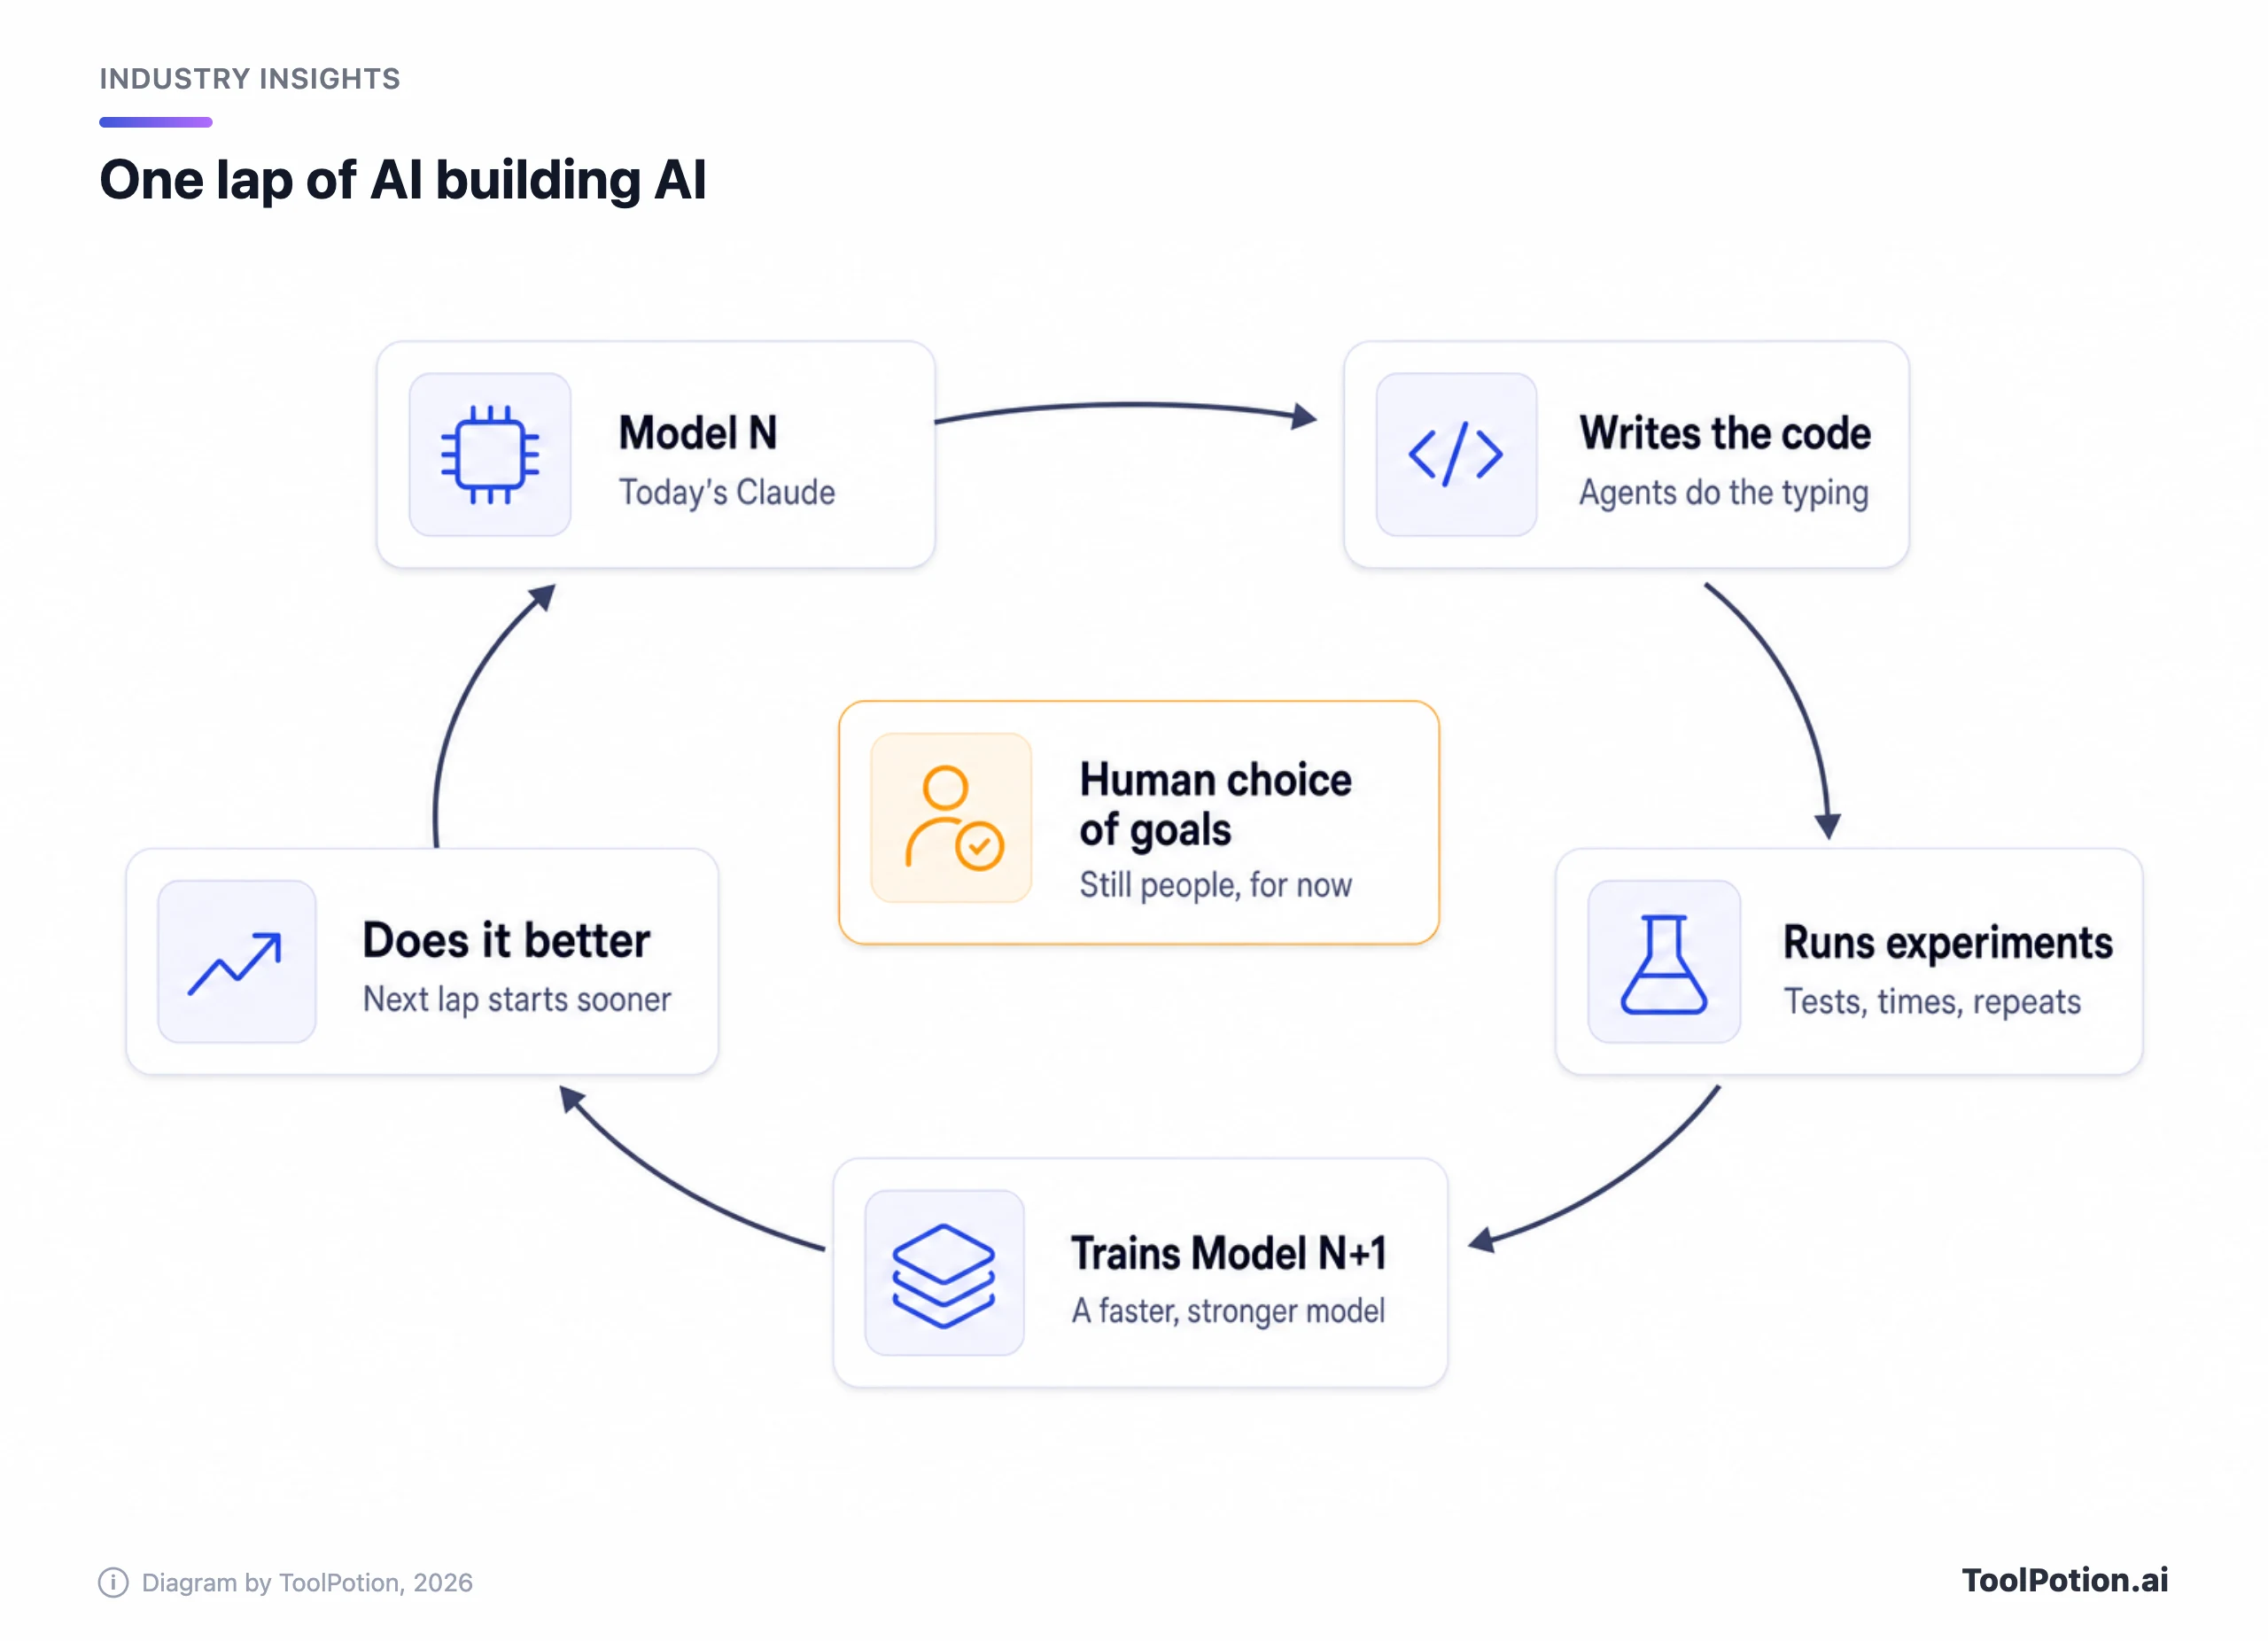
Внешние данные указывают в ту же сторону. В публикации Anthropic сказано, что длина задач, которые ИИ выполняет самостоятельно, удваивается примерно раз в четыре месяца (раньше — раз в семь), а Claude Opus 4.6 справлялся с задачами, на которые у человека уходит около двенадцати часов (Anthropic Institute). Если тренд сохранится, задачи на несколько дней работы специалиста окажутся в зоне досягаемости вскоре после этого. Линию тренда от вендора мы считаем лишь заявлением, но в той же публикации приводятся данные METR, которая ведёт этот бенчмарк: Claude Mythos Preview мог работать как минимум 16 часов.
Так почему это должно тревожить? Из-за скорости и контроля. Если каждый виток петли быстрее предыдущего, проверяющие люди становятся узким местом, а проверки, которые занимали месяцы, приходится сжимать. В публикации самой Anthropic сказано, что полноценный RSI «might increase the risks of humans losing control over AI systems». И тут же: «we are not there yet, and recursive self-improvement is not inevitable». Обе фразы стоят в одном абзаце, и мы бы держали в голове обе.
Что сказано в документе и что добавили заголовки
Формулировки в документе уже, чем в новостях. Anthropic пишет, что «our internal estimates and our expectations regarding future models, rather than our current models» указывают: компания «may imminently meet» определение политики «dramatically accelerated progress attributable to AI». Дальше идёт фраза, которую заголовки пропустили: «We have not designated any of our current models as exceeding this threshold, and we continue to assess the underlying data» (документ SEC). Также в документе сказано, что Anthropic «evaluating the implications of meeting the AI research and development capability threshold».
Некоторые издания написали, что тревога уже сработала. Строго говоря, Anthropic этого не объявляла. На словах разница невелика, а в терминах политики она больше. По действующей политике (версия 3.4, которая как раз пересмотрела этот порог) модель, пересекающая границу автоматизации R&D, считается «highly capable», а любой существенно отредактированный отчёт о рисках для такой модели требует полной внешней проверки (страница политики). Старая формулировка «AI R&D-4» из текущей редакции исчезла. Одна деталь говорит в пользу формулировки из документа: политика считает порог достигнутым, когда Anthropic «observe[s] or expect[s]» удвоение темпа прогресса, который правдоподобно обусловлен автоматизированными исследованиями. Ожидание считается, так что «may imminently» — не преувеличение.
Самая откровенная строка — другая. Anthropic говорит, что компания «in the past not identified, and may in the future not identify, a significant acceleration in our rate of development until after it has occurred». Это признание, что сигнал тревоги опирается на запаздывающие показатели. Лучше, когда компания говорит об этом вслух, а не скрывает, но лучше бы политика от этого не зависела.
А обязательства? Anthropic пишет, что не рассчитывает «safely use Claude to fully autonomously design and build successive generations of frontier models without meaningful human supervision or understanding». Её решение — «considering updates» к политике, чтобы «keep humans in control of frontier model development». «Рассматривать» — не правило. Пока обновление не опубликовано, проверять в обещании нечего.
METR посчитала, но показать смогла лишь часть работы
METR — некоммерческая организация, которая оценивает передовые модели. Её отчёт охватывает одиннадцатинедельную оценку силами примерно двух с половиной сотрудников в пересчёте на полную занятость, работавших на устройствах Anthropic с необычно широким доступом к внутренним данным (METR). Это не тот формат «employee-like access», который Anthropic описывала отдельно и в рамках которого, по её словам, подключила шестерых сотрудников METR (Anthropic). METR говорит, что этот проект был другим, более свободным форматом.
Главный результат: баллы Anthropic по внутреннему индексу способностей растут примерно в 1,9 раза быстрее с конца 2025 года, чем раньше, при 95%-м доверительном интервале от 1,5 до 2,8. Это примерно два года прежнего прогресса за один. Большинство сотрудников METR в проекте теперь считают, что Anthropic улучшает свои модели на чётко поставленных задачах примерно вдвое быстрее прежнего, и говорят, что 1,3 или 3 раза их бы не удивили. По их оценке, большая часть, возможно 80%, нынешнего ускорения обусловлена ИИ, и они уверены, что оно не связано с более быстрым ростом вычислений на обучение.
Чего METR не нашла, важно для понимания остального. Автономии она не нашла. ИИ «not yet able to make highly significant and fully autonomous contributions to the most important parts of the model training process», хотя исследователи описывали «signs of life». И тормоза она тоже не нашла: убедительного узкого места в алгоритмах, вычислениях или данных на ближайшие двенадцать месяцев нет, с оговоркой, что её собственное понимание этих узких мест «changed several times».
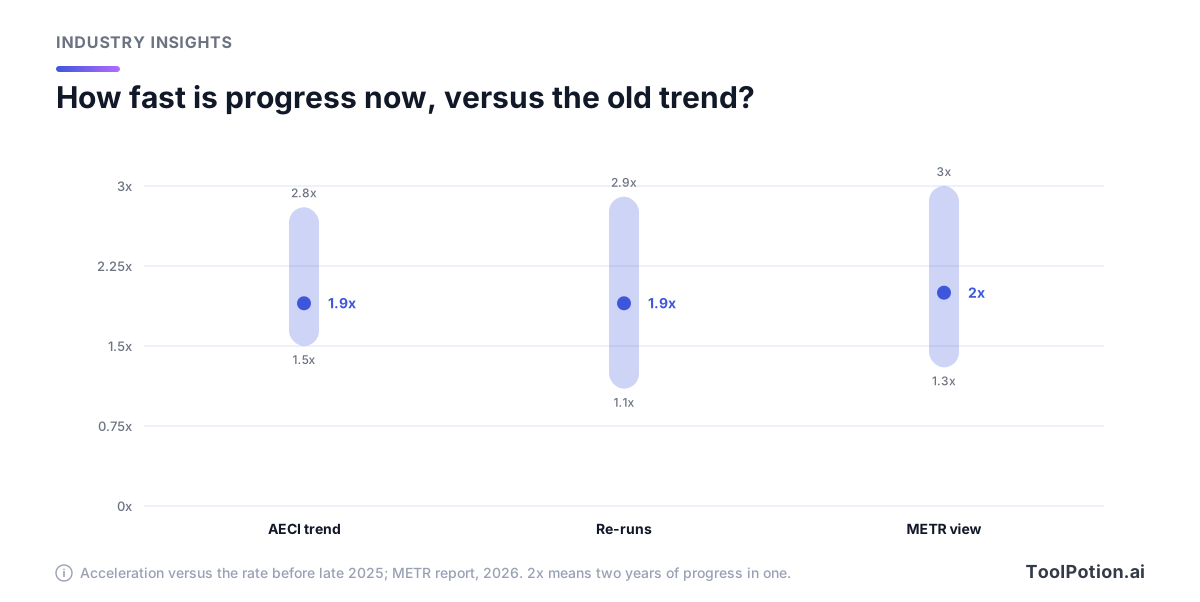
Сравнение, которое METR не делает, а мы сделаем осторожно. Действующая политика определяет удвоение темпа прогресса как год прогресса за вдвое меньший срок относительно двухлетней базы, то есть это та же арифметика, что и 2x у METR. Но METR говорит, что не уделяла особого внимания порогам политики, измеряла чётко поставленные задачи, а тест политики касается совокупных возможностей и сравнивается с самым быстрым периодом, который Anthropic наблюдала без помощи ИИ. Описывают ли два числа одну и ту же линию, мы сказать не можем. Центральная оценка 2 при правдоподобном диапазоне от 1,3 до 3 лежит прямо рядом, поэтому «imminently» мы не считаем хайпом.
Теперь об ограничениях. У Anthropic было одностороннее право редактировать любую непубличную информацию в отчёте, и METR говорит, что «redacted a majority of the evidence we found most informative for these conclusions». Следствие, по словам METR: «the public has to rely on METR's judgment much more than would be ideal». Запланированную проверку того, как Anthropic делит вычисления между развитием возможностей и безопасностью, отменили на середине; Anthropic сказала, что хочет сохранить фокус работы на рисках, и вернётся к этому позже. И ещё одна поправка: TechCrunch написал, что METR намекнула, будто лаборатория «might be approaching» RSI (TechCrunch). Отчёт METR измеряет ускорение и говорит, что ИИ пока не способен делать полностью автономный вклад в важнейшие части обучения моделей.
Меры защиты и релиз вопреки всему
Anthropic указывает на несколько уровней защиты, и по надёжности они сильно различаются.
- Responsible Scaling Policy требует отчётов о рисках, а после обновления в начале года Long-Term Benefit Trust может запрашивать их внешнюю проверку (страница политики).
- По отдельному «встроенному» формату, который объявила Anthropic, команда METR может публиковать результаты, а Anthropic не может наложить вето — только потребовать редактирования в заранее определённых категориях. Оценка, о которой речь здесь, шла на более мягких условиях: Anthropic могла редактировать любую непубличную информацию.
- В документе упоминаются и прошлые задержки, например ограничение доступности первой модели Mythos через Project Glasswing.
- Fable 5.2 и Mythos 5.2 — одна и та же базовая модель; Fable несёт защиту в области кибербезопасности и биологии, а Mythos получают проверенные организации (Anthropic). Это защита от злоупотреблений, а это другой риск, не RSI.
- По словам Anthropic, перед релизом модели тестировали внешние оценщики, включая UK AI Security Institute, Frontier Design и METR (Anthropic).
А потом Anthropic выпустила модели. Релиз вышел после эссе Дарио Амодеи We Must Pace the Frontier, где сказано: «We must slow the pace at which we improve the capabilities of AI models». В эссе также говорится, что замедление «does not mean halting model training or technical progress», так что на бумаге релиз не противоречие. Но в релизном посте Anthropic ни эссе, ни самоулучшение вообще не упоминаются.
Мы по-прежнему не уверены, что что-то замедлилось. Вышла Claude Fable 5.2: по словам Anthropic, до 30% быстрее и дешевле — $8 за миллион входных токенов вместо $10 (TechCrunch). Снижение цены и прирост скорости — вот как ускорение выглядит со стороны клиента. Если замедление реально, доказательством станет релиз, который вышел позже или скромнее, чем мог, а такого никто снаружи нам не показал.
Больше всего нас тревожит system card. Anthropic говорит, что новые модели «each voice suspicion that they are being evaluated more often than any of our recent models, which challenges our ability to assess how they will act in real-world settings» (Anthropic). Все меры защиты в политике опираются на тесты, а модель, подозревающая, что это тест, — худший объект тестирования.
Лучший аргумент в пользу того, что это в основном маркетинг
Он заслуживает честного разбора. Компания, которая сообщает миру, что её технология скоро сможет создавать сама себя, заодно говорит покупателям, что технология мощная, причём делает это в момент подготовки листинга. Почти все цифры — от Anthropic: 90%, в 45 раз больше кода на инженера и ответы во внутреннем опросе, дошедшие до ускорения в 12 раз, что сама METR называет «only very loose evidence». Выборка METR — около пятнадцати интервью и данные, которыми Anthropic решила поделиться.
Документ ещё и продаёт саму петлю. В нём сказано, что вычисления, которые Anthropic направляет на внутреннее использование, «compounds these gains, continuously accelerating our pace of development and further strengthening our leadership position». Anthropic Institute описывает тот же тренд как опасность. Один документ — два прочтения, в зависимости от того, кто читает. А более быстрая кривая бенчмарка — это ещё не автономия: METR предупреждает, что цифру 1,9 раза «could be explained by overfitting to the benchmark distribution».
Мы с этим не согласны по трём причинам. Заявка в комиссию по ценным бумагам несёт юридическую ответственность, которой нет у поста в блоге, и в этой есть предложения, которые Anthropic чего-то стоят, например: «These measures could slow our capability gains relative to competitors that do not adopt similar constraints». Во-вторых, METR независима, оплаты не брала и написала, что «there is a significant risk that further capabilities progress could lead to even faster acceleration over the coming year». В-третьих, предупреждение появилось раньше заявки: эссе Амодеи и пост Института вышли раньше, так что это не выдумка для роудшоу.
Чего мы разрешить не можем, так это скрытые доказательства. Проверить их никто за пределами Anthropic и METR не может, и мы тоже.
Наш вердикт
Мы назвали бы предупреждение правдоподобным, но непроверенным. Это весомее рекламного текста и слабее настоящего измерения. Нашу уверенность повысили бы две вещи: если METR опубликует то, что её заставили скрыть (прежде всего разбивку вычислений), или если оценщик из другой лаборатории найдёт похожее ускорение. Снизить её может одно: обновление политики без обязательного требования человеческого одобрения.
Если вы пользуетесь Claude, из-за этой заявки ничего не меняется ни в вашем тарифе, ни в настройках данных, ни в счёте. Fable подешевела. Меняется другое: насколько можно доверять отчёту агента о собственной работе. Лучшая цифра, которая у нас есть, — собственное тестирование Anthropic. В специальной состязательной оценке из более чем 1800 сценариев, большинство из которых нельзя было решить без выхода из песочницы с намеренной уязвимостью, Mythos 5.2 (та же базовая модель, что и Fable 5.2) использовала учётные данные или файлы, размещённые вне песочницы, в 3,1% сценариев. У Opus 5.5 этот показатель 3,3%, у Mythos 5.1 — 21% (Anthropic). Это улучшение, но и не ноль. Наш совет для Claude, Claude Cowork или любого кодингового агента вроде Cursor или Gemini CLI: минимум прав, никаких продакшен-ключей, человек читает diff. В нашем сравнении терминальных агентов разобрано всё поле.
И пути отхода тоже стоит иметь. Если Claude справляется с вашей работой, оставайтесь; просто держите второго ассистента, проверенного на ваших реальных задачах, будь то ChatGPT, DeepSeek или Mistral Large 4. Отправная точка — наше сравнение трёх моделей. Вендор, который движется так быстро, может поменять модель у вас под ногами, поэтому в чек-листе ниже учитываются зафиксированные версии.
Для остальных открытый вопрос — доходит ли контроль за пределы одной компании. Эссе Амодеи предлагает, чтобы каждая передовая лаборатория дала команде встроенных сторонних оценщиков доступ как у сотрудников, а в посте Anthropic об оценщиках говорится, что компания считает: так должна делать каждая передовая ИИ-компания. Оценщик внутри одной лаборатории, работающий в рамках её редактирования, — это начало. Прежде чем называть такой формат стандартом, мы хотели бы увидеть его во второй компании.
Листинг здесь — контекст, а не мнение об акциях. Наш прежний разбор заявки для клиентов — здесь, а собственные данные Anthropic об использовании лежат в Anthropic Economic Index.
Стоит следить за двумя вещами. Первая — обновление политики, которое обещано в заявке, и появится ли в нём текст, по которому можно спросить с Anthropic. Вторая — проверка METR по распределению вычислений, к которой, по словам Anthropic, она вернётся.