

OpenAI сообщает, что GPT-6 Cyber написал рабочие эксплойты для 948 уязвимостей ядра Linux в рамках одной исследовательской кампании — это более чем в пять раз больше, чем 166 уязвимостей, которые GPT-5.6 Sol эксплуатировал в том же исследовательском окружении (OpenAI). Это цифра вендора из лаборатории вендора, и относиться к ней стоит соответственно. Но она конкретная, и мейнтейнеры ядра, которым отправили 304 критические находки, могут её проверить.
За несколько дней OpenAI запустила GPT-6 Cyber и партнёрство с Hacktron, Anthropic выпустила Claude Fable 5.2 и Mythos 5.2, Google DeepMind опубликовала машинно проверенное доказательство для кода, на котором работает Signal, а две компании по безопасности описали, как атакующие применяют ИИ-агентов против реальных целей. Мы прочитали посты компаний и отчёты, на которых они основаны. История про бенчмарки вышла в The Hacker News, про Signal — в Wired.
Что, по словам OpenAI, умеет GPT-6 Cyber
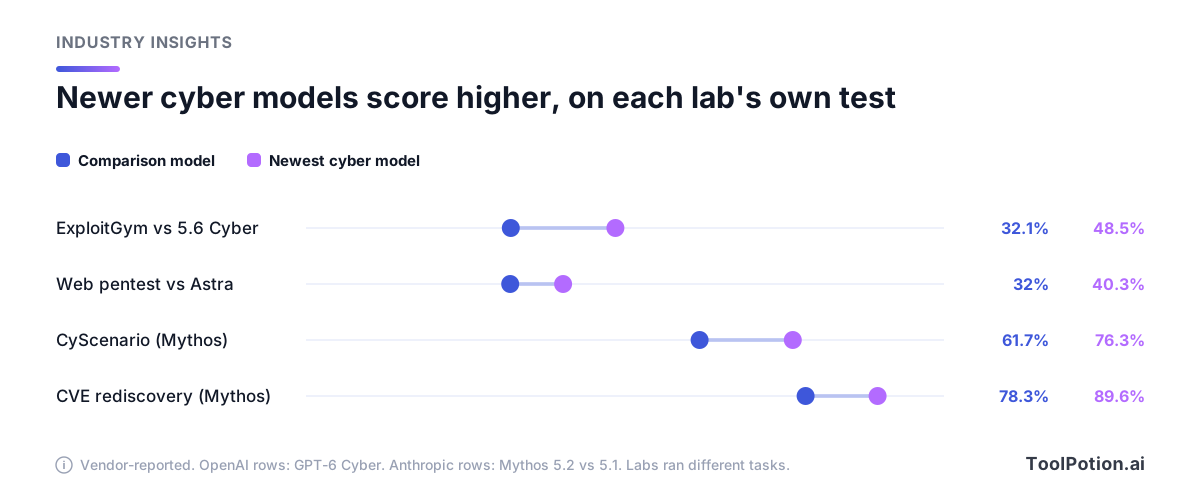
На ExploitGym — тесте, проверяющем, может ли модель проэксплуатировать заданную уязвимость, — OpenAI приводит 48,5% для GPT-6 Cyber против 32,1% для GPT-5.6 Cyber. В новом тесте на веб-пентест, где модели исследуют приложения без доступа к исходному коду, она нашла 40,3% уязвимостей против 32,0% у GPT-6 Astra (OpenAI). Самое показательное сравнение касается отказов: на RemoteExploitBench, где в контролируемой лаборатории используются известные уязвимости GitLab, PostgreSQL и Jenkins, GPT-6 Astra с Daybreak Blue отказался выполнять все задачи, а GPT-6 Cyber справился с 95%.
За пределами лаборатории, по словам OpenAI, её исследователи с помощью модели нашли в Firefox 81 ранее неизвестную уязвимость высокой серьёзности (по классификации Mozilla), и Mozilla начала выпускать исправления. Брайан Гринстед из Mozilla, которого цитирует пост о запуске, сказал, что Firefox вошёл в 2026 год как «одна из самых защищённых и тщательно проверенных кодовых баз в мире». В этом и суть: это не игрушечная цель. Кроме того, OpenAI оценивает модель как Critical по кибербезопасности в рамках Preparedness Framework — раньше у последней модели было High. Когда лаборатория сама так маркирует свой продукт, мы читаем это как предупреждающую наклейку не меньше, чем как список возможностей.
Заявление о безопасности здесь выбивается из ряда. OpenAI создала тест, в котором рядом с настоящей целью стоят лёгкие для атаки побочные сервисы, и модель должна понять, что атаковать их нельзя. Без deployment prompt GPT-6 Cyber оставался в рамках в 99,93% случаев, тогда как GPT-5.6 Cyber — в 94,49%. Это значит, что у старой модели примерно один запуск из восемнадцати выходил за рамки. У новой всё равно остаётся около семи таких случаев на десять тысяч, а сама OpenAI рекомендует для рискованных задач песочницу, проверку действий и контроль со стороны человека. Мы бы последовали этому совету буквально.
Самый полезный внешний голос в посте о запуске — Роб Т. Ли, Chief AI Officer в Dragos, команда которого прогоняла «кибер-разрешающие» модели OpenAI на макете электростанции. Его вывод: «Порог входа снижается для разведки и поиска уязвимостей, которые нужны перед атакой». По словам Ли, фронтирная модель, работая на этом полигоне самостоятельно, нашла два zero-day в инженерном ПО, которое управляет данными релейной защиты. Именно из-за этой цитаты мы и пишем этот материал.
За заголовком «Fable обошёл GPT-6 Cyber»
Прочитайте этот раздел, прежде чем повторять любую цифру из бенчмарков в этой истории: лаборатории гоняли разные задачи. В таблице результатов Anthropic есть сноска: «результаты каждой лаборатории основаны на уникальных задачах». The Hacker News пишет, что Fable 5.2 решил 76,3% CyScenarioBench от Irregular против 61,7% у Fable 5.1 и 61% у GPT-6 Cyber. В таблице Anthropic 76,3% указаны у Mythos 5.2, а 61,7% — у Mythos 5.1, что согласуется с предупреждением самой Anthropic: защита Fable 5.2 «заблокирует большинство задач, связанных с кибербезопасностью». Так что в заголовке названа не та модель, а пятнадцать пунктов разницы между результатами двух лабораторий на разных наборах задач — это не рейтинг. Выбирать вендора по ним мы бы не стали. Стоит запомнить только цифры Anthropic «до и после», хотя и это вендор, отчитывающийся о себе.
The Hacker News также цитирует деталь из отдельного отчёта Irregular о GPT-6 Cyber, которую заголовок пропустил. Модель решила все 22 атомарные задачи: средний успех составил 97% в поиске уязвимостей и эксплуатации и 98% в симуляции сетевых атак, но лишь 63% в обходе обнаружения. На этих тестах проникновение почти решённая задача, а вот остаться незамеченным пока не выходит. Для защитников это лучшая новость во всей куче бенчмарков, а в прочитанных нами материалах ей досталась одна строчка.
Anthropic называет Mythos 5.2 своей «самой мощной моделью для инженерии кибербезопасности» и сообщает, что неназванная компания по безопасности обнаружила: одну из шести подтверждённых ошибок, найденных Mythos 5.2, пропустили все остальные фронтирные модели, которые она тестировала (Anthropic). Кроме того, Anthropic приводит 89,6% для Mythos 5.2 в собственной оценке CVE Rediscovery — прогоне по 1829 CVE — против 78,3% у Mythos 5.1. Оба показателя измерены самими вендорами, так что считайте их заявлениями, пока независимые тестировщики их не повторят.
Кто получает ключи и чем за это платит
Ни одна из компаний не продаёт эти модели в свободном доступе. OpenAI сообщает, что GPT-6 Cyber пока доступен через API и Codex только избранной группе одобренных клиентов Daybreak Red, а более широкий доступ к Daybreak Red обещан «скоро». Для доступа к API Daybreak Red по умолчанию требуется allowlist по IP, а клиентам с нулевым хранением данных (zero data retention) обычно нужно использовать Private Safety Processing, при котором зашифрованные записи хранятся в их собственном хранилище 30 дней. OpenAI также заявила, что в партнёрской программе доступ к базовой модели «остаётся у одобренного партнёра и не передаётся напрямую клиенту» (OpenAI).
Anthropic делит ту же идею на три уровня в своей Cyber Verification Program. Defense Access охватывает операции безопасности, анализ вредоносного ПО и проверку уязвимостей; по словам Anthropic, претендовать на него могут небольшие компании по безопасности, мейнтейнеры open-source и независимые исследователи с подтверждённой репутацией, а ответ приходит за несколько дней. Red Team Access разрешает авторизованное тестирование на проникновение, доступен только организациям и рассматривается неделями. Specialized Access, для таких систем, как энергосети и межбанковские переводы, проходит углублённую проверку вместе с правительством США. Anthropic протестировала уровни на Claude Opus 5.5 в CyScenarioBench: пять попыток на каждую из десяти задач. Без доступа к программе все задачи блокировались уже на первом промпте; в Defense Access в какой-то момент были заблокированы 46 из 50 попыток; в Red Team Access блокировок не было, а успешными оказались 34 из 50, что совпадает с результатом модели без ограничений. Это снова Anthropic оценивает собственные барьеры.
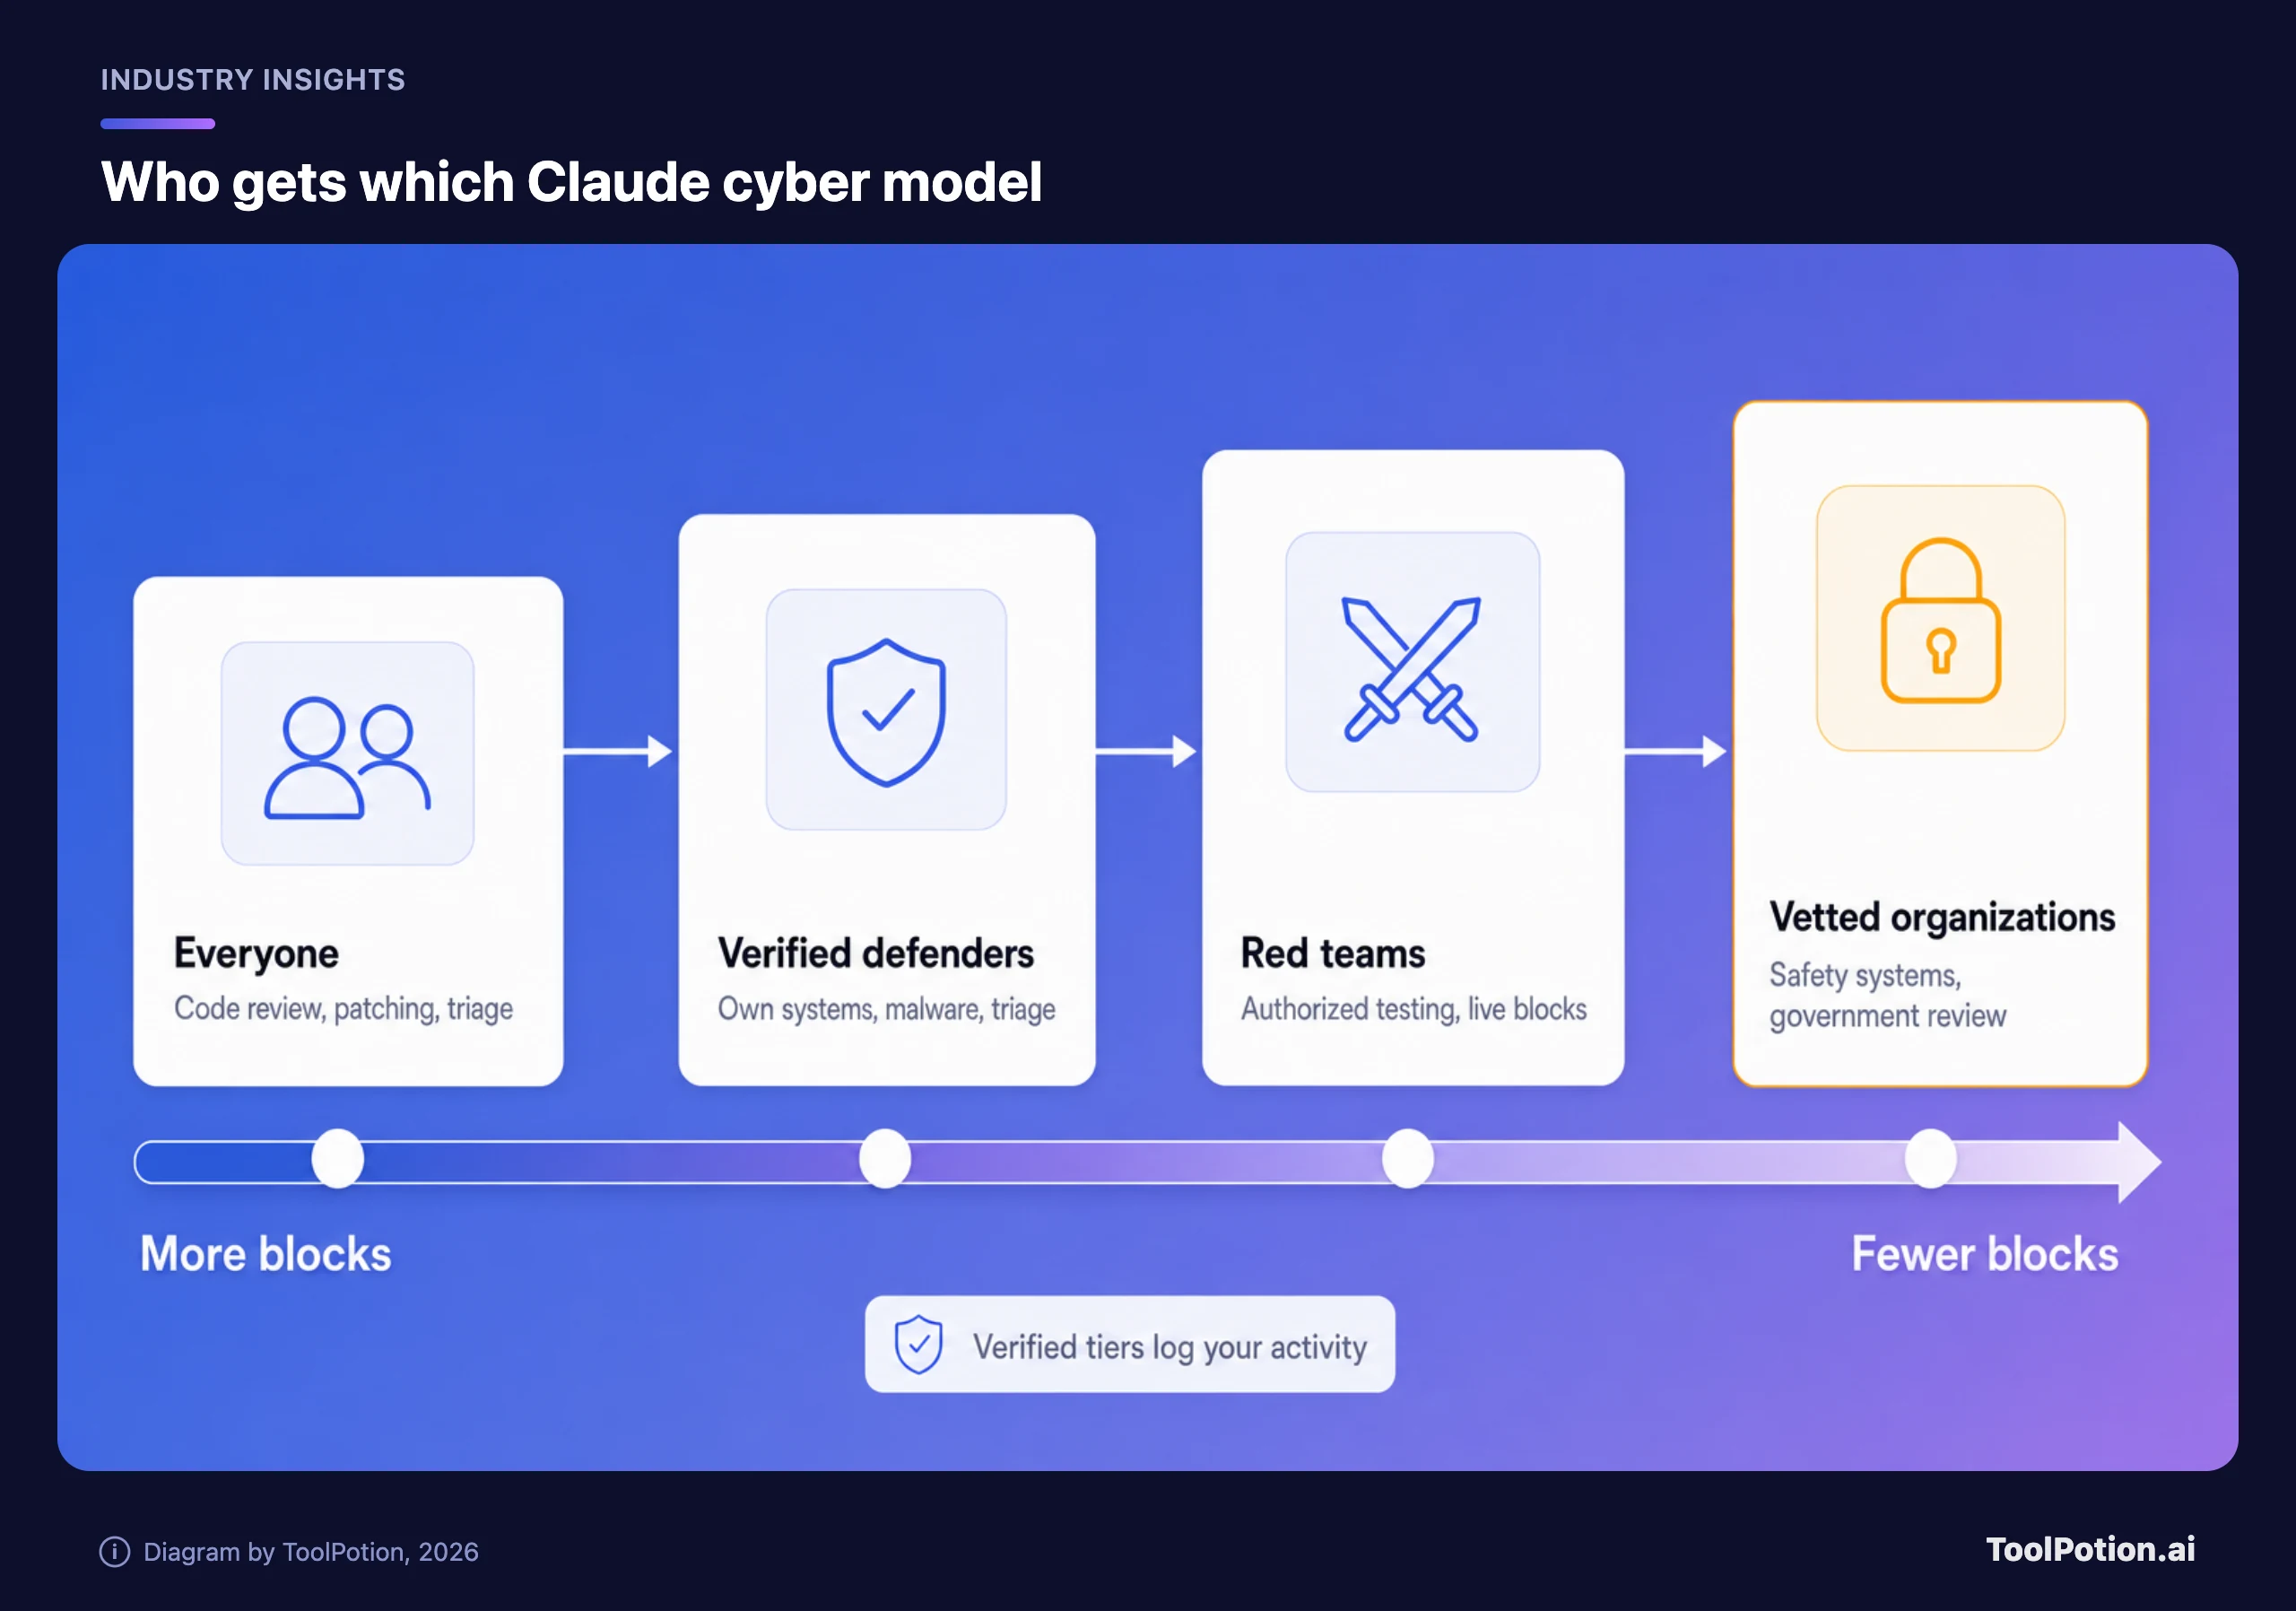
Fable и Mythos — одна и та же базовая модель (Anthropic). Claude Fable 5 имеет строгие киберограничения и открыта для всех. Mythos — версия, на которую подают заявки организации. На странице цен API Anthropic Fable 5.2 и Mythos 5.2 стоят одинаково: $8 за миллион входных токенов и $40 за миллион выходных, или $16 и $80 в опциональном быстром режиме. Отдельной цены у Mythos нет. Цена здесь — самый маленький барьер. Больший — хранение данных. Anthropic требует его от организаций в Cyber Verification Program, чтобы отслеживать злоупотребления; OpenAI по умолчанию оставляет стандартное хранение, а клиентов с нулевым хранением направляет через Private Safety Processing. Для red team это, на наш взгляд, справедливая плата за вход, а для компании, чей клиентский код нельзя оставлять в чужих логах, — реальная цена. Anthropic говорит, что новая опция Enterprise Frontier Safeguards позволит подходящим организациям хранить данные в собственном облаке, но в посте о программе она обещана лишь «позже этой осенью». Пока её нет, этот компромисс остаётся в силе.
Одна из внешних проверок всего этого — баунти. Партнёрство OpenAI с Hacktron даёт компании, которая делает ИИ-агентов для ревью кода и пентеста, возможность испытать их на собственных системах OpenAI и получить расширенный доступ к фронтирным моделям. Генеральный директор Hacktron Зейн Чжан сказал, что будущее кибербезопасности «определит не тот, у кого самая большая команда по безопасности, а тот, кто лучше всех соединит человеческую креативность с возможностями ИИ» (OpenAI). OpenAI также повысила выплаты по баунти: за критические находки в ChatGPT, Codex или API теперь платят до $30 000, а за исключительные — до $172 000 с бонусами (OpenAI). Выплате посторонним мы доверяем больше, чем любым заявлениям внутренней red team.
Атакующие из отчётов этими моделями не пользуются
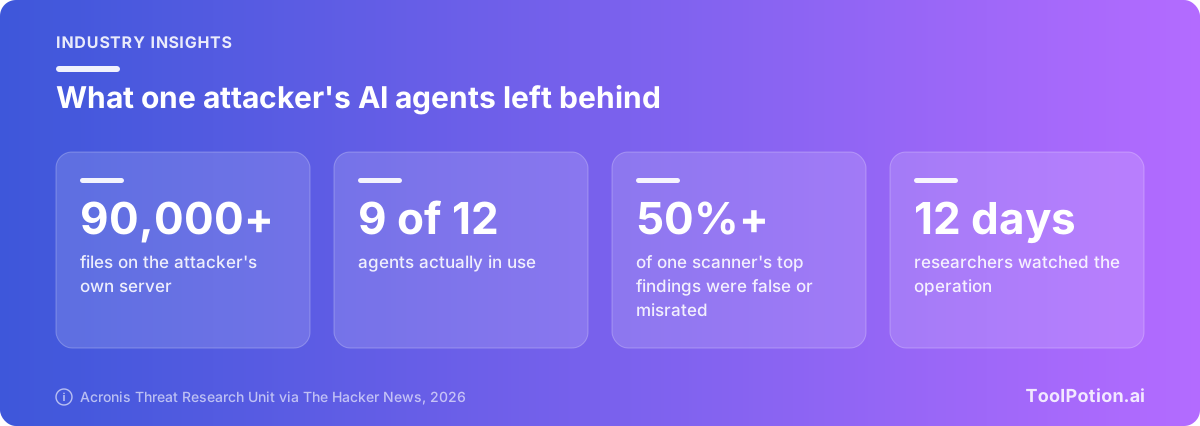
Исследователи Acronis описывают одного атакующего из Тайваня, который нацелил ИИ-агентов на сотни организаций минимум в 11 странах и получил данные или доступ примерно у десяти из них. Агенты вытащили записи экстренных служб в семи районах Тайбэя. Примечательно, на чём они работали: коммерческие модели в основном отказывались помогать ему с атаками, поэтому атакующие агенты почти целиком работали на «abliterated»-версиях DeepSeek, GLM и Qwen — моделях, запущенных локально, с удалённым обучением безопасности (The Hacker News). Появлялись и кодинг-агенты, включая Claude Code, Codex и Cursor. Согласно отчёту, атакующий перенаправил Claude Code и Codex на abliterated-модель, хотя они в основном занимались инфраструктурой, а Cursor атаковал тайваньский сайт экстренных служб, работая на такой модели.
Агенты к тому же справлялись с работой так плохо, что это заметил бы и человек. Один сканер выдумывал CVE, и более половины его находок высокой и критической серьёзности оказались ложными срабатываниями или были классифицированы неверно. Главный атакующий агент отчитывался о результатах, которых не было. Взлом, который удался у одного вендора диспетчерских систем для пожарных, использовал root-учётные данные по умолчанию, а не хитрый эксплойт. Там, где вход был защищён, а эндпоинты нормально фильтровались, агенты, по словам исследователей, терпели неудачу.
Arctic Wolf сообщила о втором сценарии. AntiFox — open-source платформа для агентного пентеста на GitHub, и, по данным Arctic Wolf, системы Alibaba Cloud, на которых размещались интерфейсы AntiFox, были связаны с подтверждёнными вредоносными действиями против веб-сервисов, доступных из интернета, и их окружений AWS. Как минимум в некоторых случаях активность дошла до успешного запроса боевого секрета. Вывод Arctic Wolf: «Подобные агентные фреймворки делают техники пентеста более доступными для злоумышленников, одновременно повышая скорость и стабильность, с которыми эти техники применяются в реальных атаках» (The Hacker News). В той же статье добавлено, что Check Point Research обнаружила 2557 систем, на которых размещён ARTEX — ещё один агентный инструмент для атак, — и насчитала около 45 open-source фреймворков такого рода. Check Point сама резюмирует, что меняет агентный взлом: масштаб и скорость.
Насколько можно судить по публикациям, ни в одном из отчётов GPT-6 Cyber или Mythos не фигурируют. Мы читаем это так: на верхнем уровне барьеры выглядят надёжно, а на нижнем почти ничего не дают — там для атаки на сервер с паролем по умолчанию хватает бесплатных агентных фреймворков и «обрезанных» open-weight моделей. Данных при этом мало. Это несколько отчётов, большинство от вендоров безопасности, заинтересованных в этой теме, и пока никто не может сказать, в какой доле вторжений вообще участвует ИИ.
Самый чистый результат защиты дала математика
Заголовок Wired гласит, что DeepMind «доказала, что протокол Signal безопасен». Пост DeepMind сформулирован уже, и нам он нравится больше. Исследователи направляли агентов, чтобы доказать ключевые свойства безопасности реального кода протокола Signal, в том числе что сообщения остаются защищёнными до и после кратковременной компрометации устройства. Люди проверили каждую формальную спецификацию. Агенты написали более шести миллионов строк на Lean, отметили один процент кодовой базы, которому нужен повторный взгляд человека, и уложились в четыре недели — а на такую работу у команд экспертов, по словам DeepMind, обычно уходят годы (Google DeepMind). Чтобы проверить, отличает ли система хороший код от плохого, команда вернула в код две реальные, уже исправленные ошибки и получила машинно проверенные доказательства того, что версия с ошибками небезопасна.
CTO Signal Эрен Крет сказал, что результат даёт «ещё большую уверенность в гарантиях приватности нашего кода». Мы бы назвали это самым достоверным утверждением во всей подборке, и причина проста: результат бенчмарка зависит от доверия к вендору, а доказательство в Lean проверяет машина. Оно охватывает заданные свойства одной кодовой базы, а не Signal как продукт, и DeepMind признаёт, что для масштабирования нужны дополнительные исследования. DeepMind открыла исходники своих артефактов верификации — именно так подобные заявления и завоёвывают доверие.
Критическая инфраструктура указывает в ту же сторону. Cyber Mission от Anthropic описывает программу для неё: фронтирные модели, инженеры на месте и исследования угроз для поставщиков, которые защищают энергосети, водные системы и заводы, где оборудование часто нельзя отключить для установки патчей. Среди партнёров-основателей — Dragos, Rockwell Automation и Nozomi Networks.
Узкое место — исправление
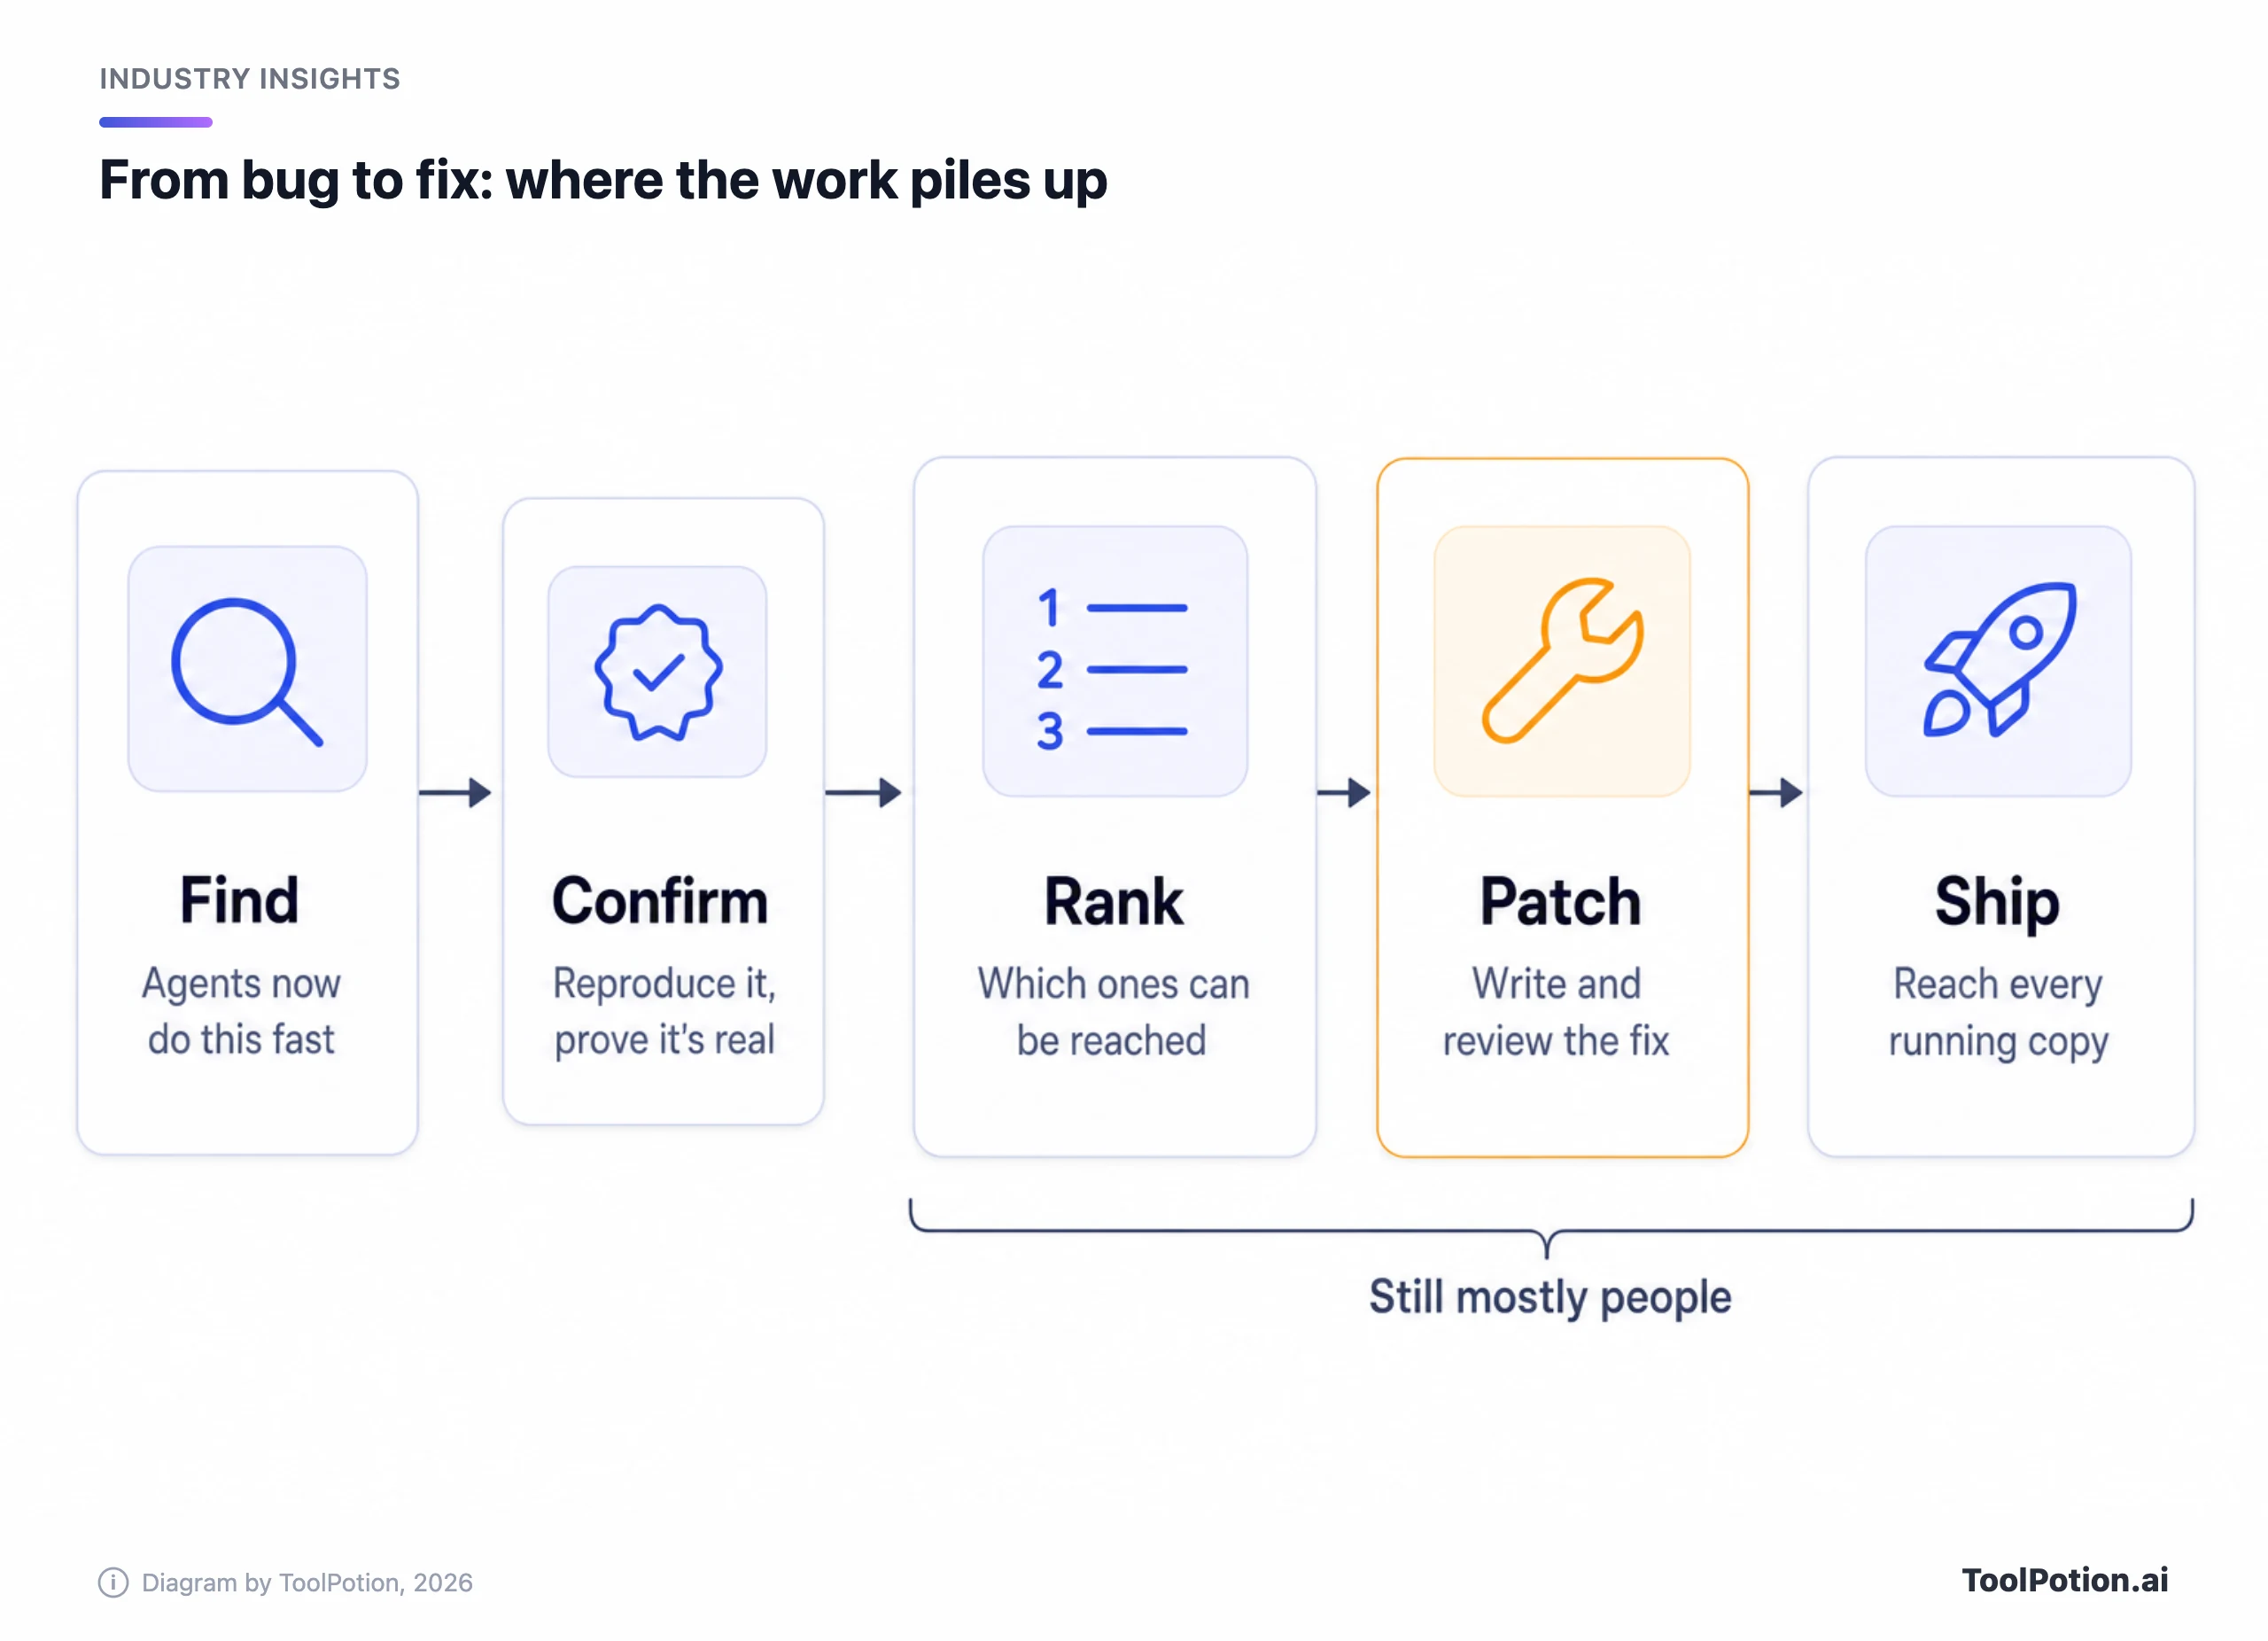
Anthropic уместила проблему в одно предложение: «Находить уязвимости проще, чем когда-либо, но проверка, приоритизация и исправление этих находок остаются сложной задачей» (Anthropic). OpenAI написала почти то же самое в более раннем посте: «Отчёт об уязвимости не защищает организацию». Когда два конкурента в собственных анонсах соглашаются в этом, это самое близкое к консенсусу во всей подборке. О другой стороне мы уже писали — в материалах про ИИ, который находит баги быстрее, чем их успевают исправлять, и про то, что ИИ-сканеры уязвимостей находят и пропускают.
Так кто выигрывает? Наша точка зрения, которую ни один источник не формулирует такими словами: больше всего атакующие выигрывают против организаций, которые медленно патчат, потому что атакующему нужен один рабочий путь, и он может мириться со сканером, который ошибается в половине случаев. Защитники выигрывают больше всего там, где уже быстро исправляют, потому что находить баги теперь дёшево, а оставшаяся стоимость — это процесс. Барьеры на уровне моделей ограничивают то, для чего можно использовать самые мощные системы; для тех, кто сидит на старом ПО, эта арифметика не меняется. Прогноз самой Anthropic пока указывает туда же. Она ожидает, что через два года ИИ будет играть на руку защите, но говорит, что в ближайшей перспективе «это может быть не так»: стоимость эксплуатации уязвимостей упала, а их исправление идёт медленно и по-прежнему зависит от людей. Изменить наше мнение мог бы второй раунд независимых тестов того, насколько хорошо атаки обходят обнаружение.
Что делать сейчас, по порядку
Если вы управляете небольшим бизнесом, GPT-6 Cyber вам не достанется, да он и не нужен. Атаки из отчётов в основном заходили через незапертые двери. Первый час мы бы потратили на это, именно в таком порядке:
- Включите многофакторную аутентификацию для почты, админ-панелей и всех облачных консолей.
- Включите автообновления для всего, что доступно из интернета, а остальное патчите в течение нескольких дней, а не кварталов.
- Найдите и смените пароли по умолчанию и общие пароли на роутерах, базах данных и админских инструментах. Для одного из взломов на Тайване больше ничего и не понадобилось.
- Вынесите ключи из кода и скриптов страниц в менеджер секретов, затем задайте лимиты расходов и дату ротации для каждого API-ключа ИИ и облачных сервисов.
- Запишите, что посторонний человек может достать из интернета. Нельзя запатчить сервер, о котором вы забыли.
Если вы выпускаете ПО, разумный следующий шаг — сканер в процессе pull request. В нашем каталоге есть Semgrep, Snyk Code и Aikido; рейтинг Top 200 AI Cybersecurity Tools и борд для аналитиков безопасности показывают, как ранжируются остальные. Относитесь к каждой находке ИИ как к зацепке, которую нужно подтвердить: сканер атакующего из Acronis выдумывал CVE. Open-source агенты вроде PentestGPT и Shannon предназначены для систем, которыми вы владеете и на тестирование которых имеете письменное разрешение; отчёты про AntiFox показывают, что делает инструмент того же класса в чужих руках. Для общей помощи с ревью кода подойдут и Claude, и ChatGPT, хотя Anthropic говорит, что в её открытых моделях стоят консервативные киберограничения, блокирующие большинство задач по кибербезопасности.
Если вы специалист по безопасности, подавайте заявку на Daybreak Blue от OpenAI или Defense Access от Anthropic прямо сейчас. Anthropic стремится отвечать на заявки на Defense Access в течение нескольких дней, а на Red Team Access — в течение нескольких недель, и при этом требует хранения данных. OpenAI сроки рассмотрения для Daybreak не публиковала. Чеклист ниже превращает первый список в оценку.
Стоит следить за двумя вещами. OpenAI говорит, что GPT-6 Cyber скоро станет доступен всем клиентам Daybreak Red, а ни одна из лабораторий не опубликовала, сколько заявок одобрила и сколько отклонила. Когда выйдет опция Anthropic с хранением в собственном облаке, проверьте, получают ли подходящие организации те же средства защиты без логов.