

На этой неделе Anthropic запустила бесплатный AI-сканер безопасности для open-source проектов с добровольным подключением, и произошло это в непростой момент. AI уже умеет находить настоящие баги в коде, который люди годами проверяли вручную. Он же умеет завалить мейнтейнера-волонтёра ложными отчётами. Верно и то и другое, и небольшой команде нужно решить, что с этим делать.
Новый сервис называется OSS Scanner. Он периодически сканирует подключённые проекты на уязвимости с помощью сильнейших моделей Anthropic. К каждому отчёту прилагается воспроизводящий пример (reproducer), объяснение и, если получается, готовый патч-кандидат (Anthropic). Рядом с ним стоят похожие инициативы от Google, OpenAI, GitHub, Snyk и Semgrep, а также растущая гора низкокачественных AI-отчётов, из-за которой некоторые мейнтейнеры закрыли двери для внешних сообщений.
В этом материале мы наводим порядок: что делают такие инструменты, какие из них бесплатны, как подключиться и не навредить себе, и какой процесс по силам команде из двух человек. Если коротко: AI-сканеры уже достаточно хороши, чтобы относиться к ним серьёзно, но то, что они выдают, нельзя вливать в код, не прочитав.
Что делает OSS Scanner от Anthropic
Основные мейнтейнеры подключаются, открыв pull request в нужном репозитории на GitHub по шаблону. Anthropic решает по каждому проекту отдельно, используя критерии, похожие на критерии Google OSS-Fuzz: у проекта должно быть «критическое значение для инфраструктуры и безопасности пользователей» (Anthropic). То есть это не для любого хобби-репозитория. Думайте о curl и wolfSSL, о библиотеках, на которые ссылается половина интернета.
Сервис бесплатный. Сканы оплачивает фонд, который Anthropic называет Defender Advantage Fund (SiliconANGLE), и компания заявляет, что для подключённых проектов участие остаётся бесплатным.
Важнее всего то, чего здесь нет. Отчёты «полностью генерируются моделью, без проверки и триажа человеком», и Anthropic прямо говорит, что часть из них будет ошибочной (Anthropic). Один из примеров, который она приводит, — неверная оценка критичности. Проекты, у которых нет людей для разбора отчётов, могут по-прежнему пользоваться существующим процессом раскрытия уязвимостей от Anthropic, где сначала всё проверяют люди (SiliconANGLE).
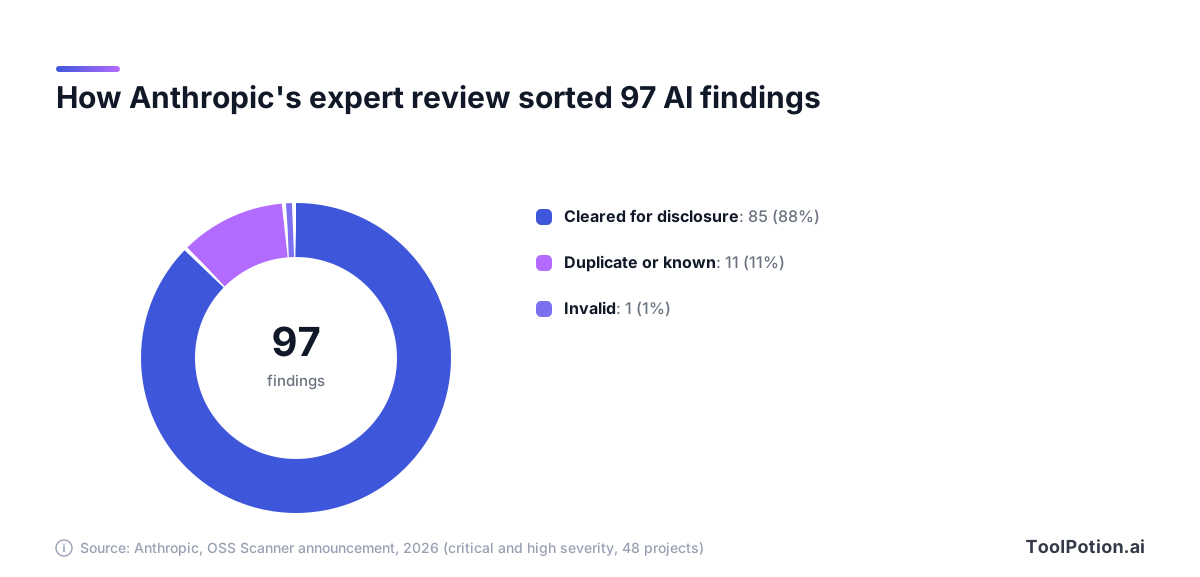
Собственные цифры Anthropic показывают, почему компания считает такой обмен оправданным. Эксперты-пентестеры проверили 97 находок критической и высокой степени опасности в 48 проектах. Из них 85 подошли для скоординированного раскрытия, 11 были дубликатами или реальными, но уже известными проблемами, и одна оказалась ошибочной (Anthropic). Отдельно wolfSSL сообщила, что в раннем тесте 72 из 74 отчётов оказались верными, и по ним оформили пять CVE (SiliconANGLE).
Даниэль Стенберг, который ведёт curl, сказал, что сканер нашёл «одну из худших уязвимостей curl за последние несколько лет» (Anthropic). Имейте в виду: все эти цифры исходят от Anthropic или её партнёров. Компания также ожидает долю истинно положительных срабатываний выше 90% (Anthropic), но это прогноз, а не гарантия для вашего репозитория.
Что на самом деле делает AI-сканер: находит, доказывает, чинит
Статический анализ старой школы сверяет код с правилами. Он быстрый и предсказуемый, но заваливает вас предупреждениями. Новые агентные сканеры работают скорее как младший исследователь безопасности: читают код, строят гипотезу, где он ломается, пытаются вызвать поломку и только потом пишут отчёт.
Именно на этот средний шаг и стоит смотреть. Находка с рабочим эксплойтом — совсем не то же самое, что находка с абзацем уверенного текста.
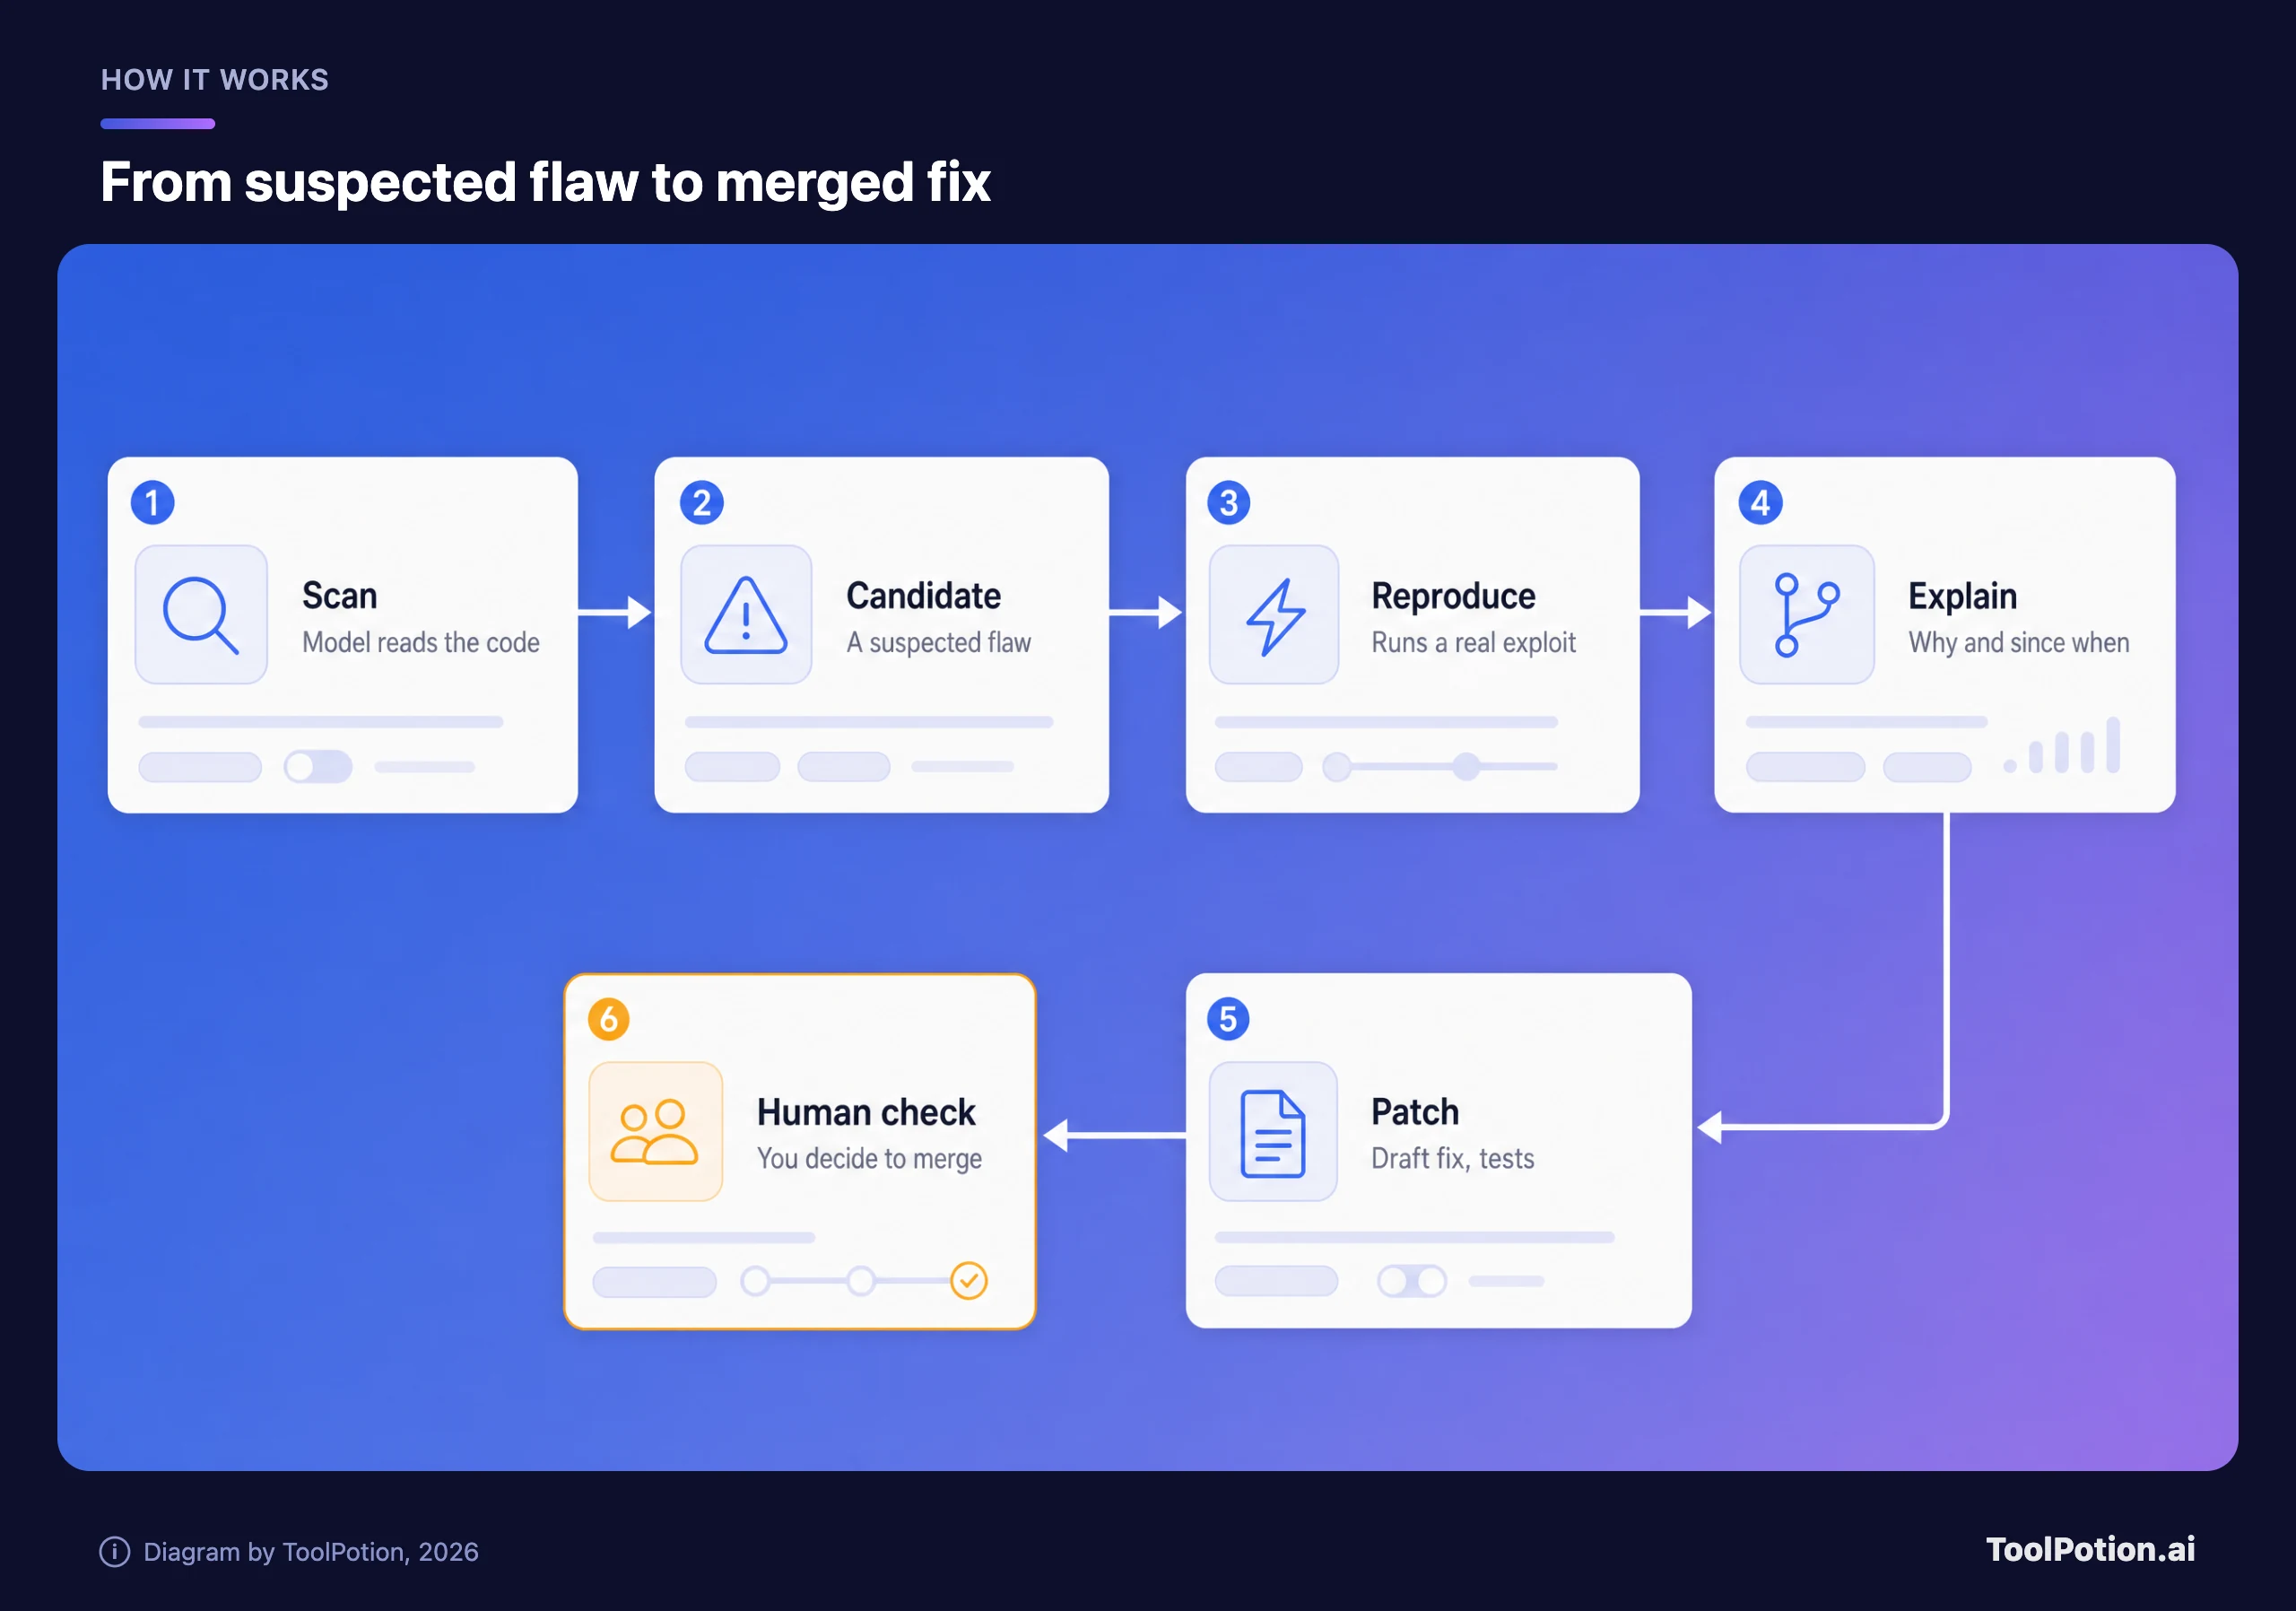
Читайте конвейер слева направо. Первые три шага — про правоту: кандидат проходит реальную проверку, прежде чем его кто-то увидит. Шаги четыре и пять — про пользу: объяснение, что сломалось, и черновик исправления. Последний блок — ваш, и он не случайно янтарного цвета. Google говорит, что каждый патч CodeMender проходит проверку человеком, а Autofix от GitHub только предлагает исправления. Сканер Anthropic — исключение в части триажа, поэтому последний блок достаётся вам.
Расклад сил в 2026 году
OSS Scanner не одинок. Google DeepMind создала Big Sleep, агента для поиска багов, и CodeMender, который пишет исправления. DeepMind сообщила, что уже отправила в open-source проекты 72 исправления безопасности и что каждый патч сначала проверили исследователи-люди (Google DeepMind). С тех пор CodeMender перешёл в публичное превью для корпоративных клиентов Google Cloud: он создаёт proof-of-concept эксплойты в песочнице и возвращает протестированные исправления в виде диффов на проверку разработчику (Infosecurity Magazine).
Версия OpenAI стартовала как Aardvark, агент на базе GPT-5: он строит модель угроз вашего репозитория, следит за новыми коммитами, подтверждает проблемы в песочнице и предлагает патчи. OpenAI заявила, что он показал 92% на известных и синтетических уязвимостях в тестовых репозиториях и нашёл проблемы, по которым получили десять CVE ID (OpenAI). Затем OpenAI включила его в Codex под новым названием: на странице Aardvark теперь написано «Aardvark is now Codex Security», доступно как research preview (OpenAI). В документации Codex Security описан как агент, который помогает командам «находить, подтверждать и исправлять уязвимости», а облачная версия пока остаётся в research preview (OpenAI docs).
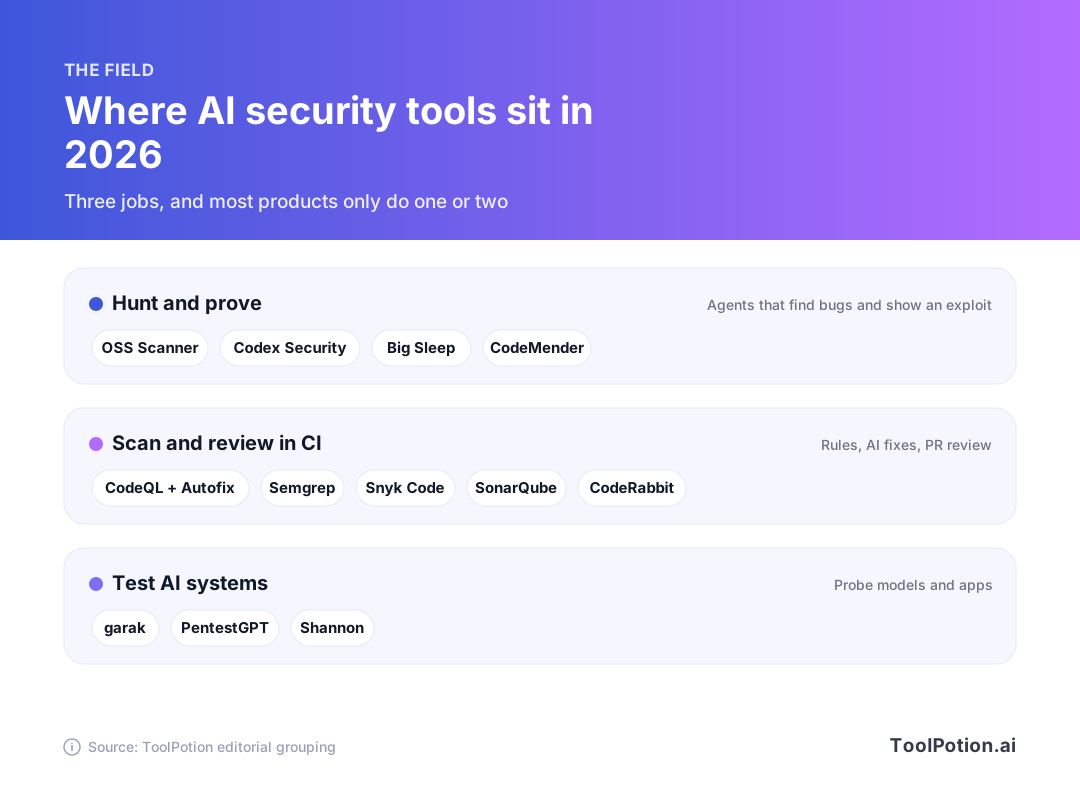
Карта группирует инструменты по задачам, и эта группировка наша, а не вендоров. Верхний ряд ищет и доказывает. Средний живёт в вашем пайплайне и работает с каждым коммитом. Нижний смотрит в другую сторону и тестирует сами AI-системы.
В среднем ряду GitHub Copilot Autofix предлагает исправления для алертов CodeQL, сканера GitHub. Semgrep и Snyk Code делают похожую работу на собственных движках, а SonarQube охватывает качество кода и проверки безопасности. CodeRabbit проверяет pull request'ы. В нижнем ряду garak ищет слабые места в языковых моделях, а PentestGPT проводит пентесты с помощью модели. Более широкий набор мы ранжируем в рейтинге AI-инструментов кибербезопасности, а инструменты для pull request'ов разобраны в рейтинге инструментов код-ревью.
| Инструмент | Основная задача | Кому доступен |
|---|---|---|
| OSS Scanner (Anthropic) | Находит и доказывает баги, пишет черновики патчей | Подключённые open-source проекты, бесплатно |
| Codex Security (OpenAI) | Находит, подтверждает и исправляет | Research preview внутри Codex |
| CodeMender (Google) | Сканирует, доказывает и патчит | Публичное превью, клиенты Google Cloud |
| Copilot Autofix (GitHub) | Предлагает исправления для алертов CodeQL | Бесплатно для публичных репозиториев |
| Semgrep | Сканирование по правилам с AI-функциями | Бесплатно до 10 контрибьюторов |
| Snyk Code | Сканирование кода и зависимостей | Бесплатный план, 100 тестов Code в месяц |
Большая часть данных в этой таблице взята со страниц вендоров, а вендоры о своих продуктах говорят снисходительно. Самая полезная колонка здесь — условия доступа. Они быстро меняются.
Обратная сторона: мейнтейнеры тонут
Те же модели, что находят настоящие баги, пишут и убедительные фальшивые. Самый яркий пример — curl. Его bug bounty работала с 2019 года до начала 2026-го, выплатила свыше $100 000 за 87 подтверждённых уязвимостей, а затем закрылась. К 2025 году подтверждалось менее 5% отчётов, тогда как раньше было 15% и больше (Daniel Stenberg).
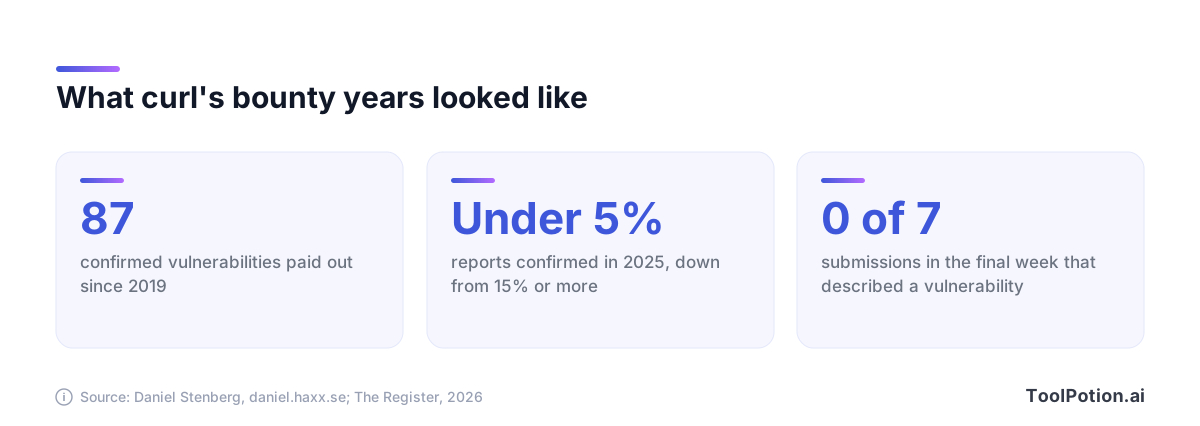
За последнюю неделю перед закрытием bounty curl получил семь заявок, и ни в одной не описывалась уязвимость (The Register). Логика Стенберга была прямой: цель — «убрать стимул присылать нам мусор и плохо проработанные отчёты. Сгенерированные AI или нет». Пётр Карвас из Apache Log4j описал ту же картину: многие отчёты «упускают основы нашей модели безопасности, добавляя шум вместо пользы» (Daniel Stenberg).
Позже curl пошёл дальше. Стенберг написал, что этим летом проект на месяц приостановил приём отчётов об уязвимостях, и назвал это «возможно, нашим лучшим проектным решением за долгое время» (Daniel Stenberg).
Обратите внимание: тот самый проект, который закрыл bounty, чтобы избавиться от AI-шума, похвалил AI-сканер, нашедший одну из его худших ошибок. Противоречия тут нет. Разница в рабочем reproducer'е и в отправителе, который уже всё проверил. Модель, доказавшая свою правоту, отнимает у мейнтейнера минуты. Человек, вставивший вывод модели как есть, — часы.
Сканер Anthropic обходится без человека-посредника, и в этом и его привлекательность, и риск. Доставка ускоряется, но отчёт может прийти к вам, так и не побывав в чьих-то глазах. Если вы ведёте проект, ждите такого от каждого вендора из таблицы.
У атакующих те же модели
В собственном анонсе Anthropic сказано: «передовые модели могут использоваться для эксплуатации уязвимостей и проведения кибероопераций» (Anthropic). Практический вывод прост: любой может направить сильную модель на публичный код и спросить, где он ломается, а open source публичен по определению.
В этом и состоит настоящий довод в пользу сканирования собственного кода. Дело не в том, что AI-сканеры — волшебство. Просто окно между появлением бага и моментом, когда его найдёт кто-то другой, сужается, и лучше успеть первым. Проект без сканирования не безопасен. Он просто не под наблюдением.
Что бесплатно, а что нет
Значительная часть полезного слоя бесплатна, если ваш код публичный. Copilot Autofix включён по умолчанию для публичных репозиториев с CodeQL, подписка на Copilot не нужна (GitHub). GitHub сделал его бесплатным для всех публичных репозиториев ещё в 2024 году (GitHub changelog).
Бесплатная версия Semgrep покрывает до 10 контрибьюторов и 10 репозиториев, в неё входят 60 AI-кредитов (Semgrep). Бесплатный план Snyk допускает пять проектов и 100 тестов Snyk Code в месяц (Snyk), а ещё у компании есть программа, по которой мейнтейнеры open source могут запросить бесплатный доступ.
Платные края в основном связаны с приватным кодом и агентами. Новый агентный autofix от GitHub, пока в превью, расходует AI-кредиты, а Copilot Autofix в приватных репозиториях требует лицензии Code Security (GitHub). Для Codex Security нужен доступ к research preview (OpenAI docs).
Как подключиться безопасно
«Бесплатно» не значит «без последствий». Сканер, который читает ваш код и присылает вам отчёты, влияет на ваш рабочий процесс, процесс раскрытия уязвимостей и иногда на репутацию. Несколько шагов помогут держать это под контролем.
- Сначала проверьте соответствие критериям. OSS Scanner ищет проекты с критическим значением для инфраструктуры или безопасности, так что прочитайте критерии в репозитории Anthropic, прежде чем тратить время на pull request.
- Решите, куда приходят отчёты. Используйте закрытый канал, например приватные уведомления об уязвимостях на GitHub или почту security, чтобы находка не стала публичной до появления исправления.
- Назначьте ответственного. Один человек получает все отчёты и решает, что с ними делать. Если ответственных двое, каждый решает, что этим занят другой.
- Прочитайте условия по данным у любого хостируемого сканера. Например, Semgrep говорит, что AI-функции, на которые вы согласились, могут обрабатывать фрагменты файлов с находками (Semgrep). Знайте, что покидает вашу машину.
- Начните с доступа только на чтение и оставляйте патчи в виде предложений. Ни один инструмент не должен пушить в вашу основную ветку.
- Запишите сроки раскрытия до того, как придёт первый отчёт. Правилу, которое вы написали на холодную голову, следовать гораздо проще.
Ничего экзотического здесь нет. Это та же гигиена, которую хороший мейнтейнер применяет к любому внешнему исследователю, только настроенная до того, как хлынет поток.
Процесс для небольшой команды
Если вы команда из двух-десяти человек и выпускаете продукт, агентный сканер в первый же день вам не нужен. Вам нужна очередь, которую реально можно разобрать. В цикле ниже шесть шагов, и янтарный — тот, который большинство команд пропускает.
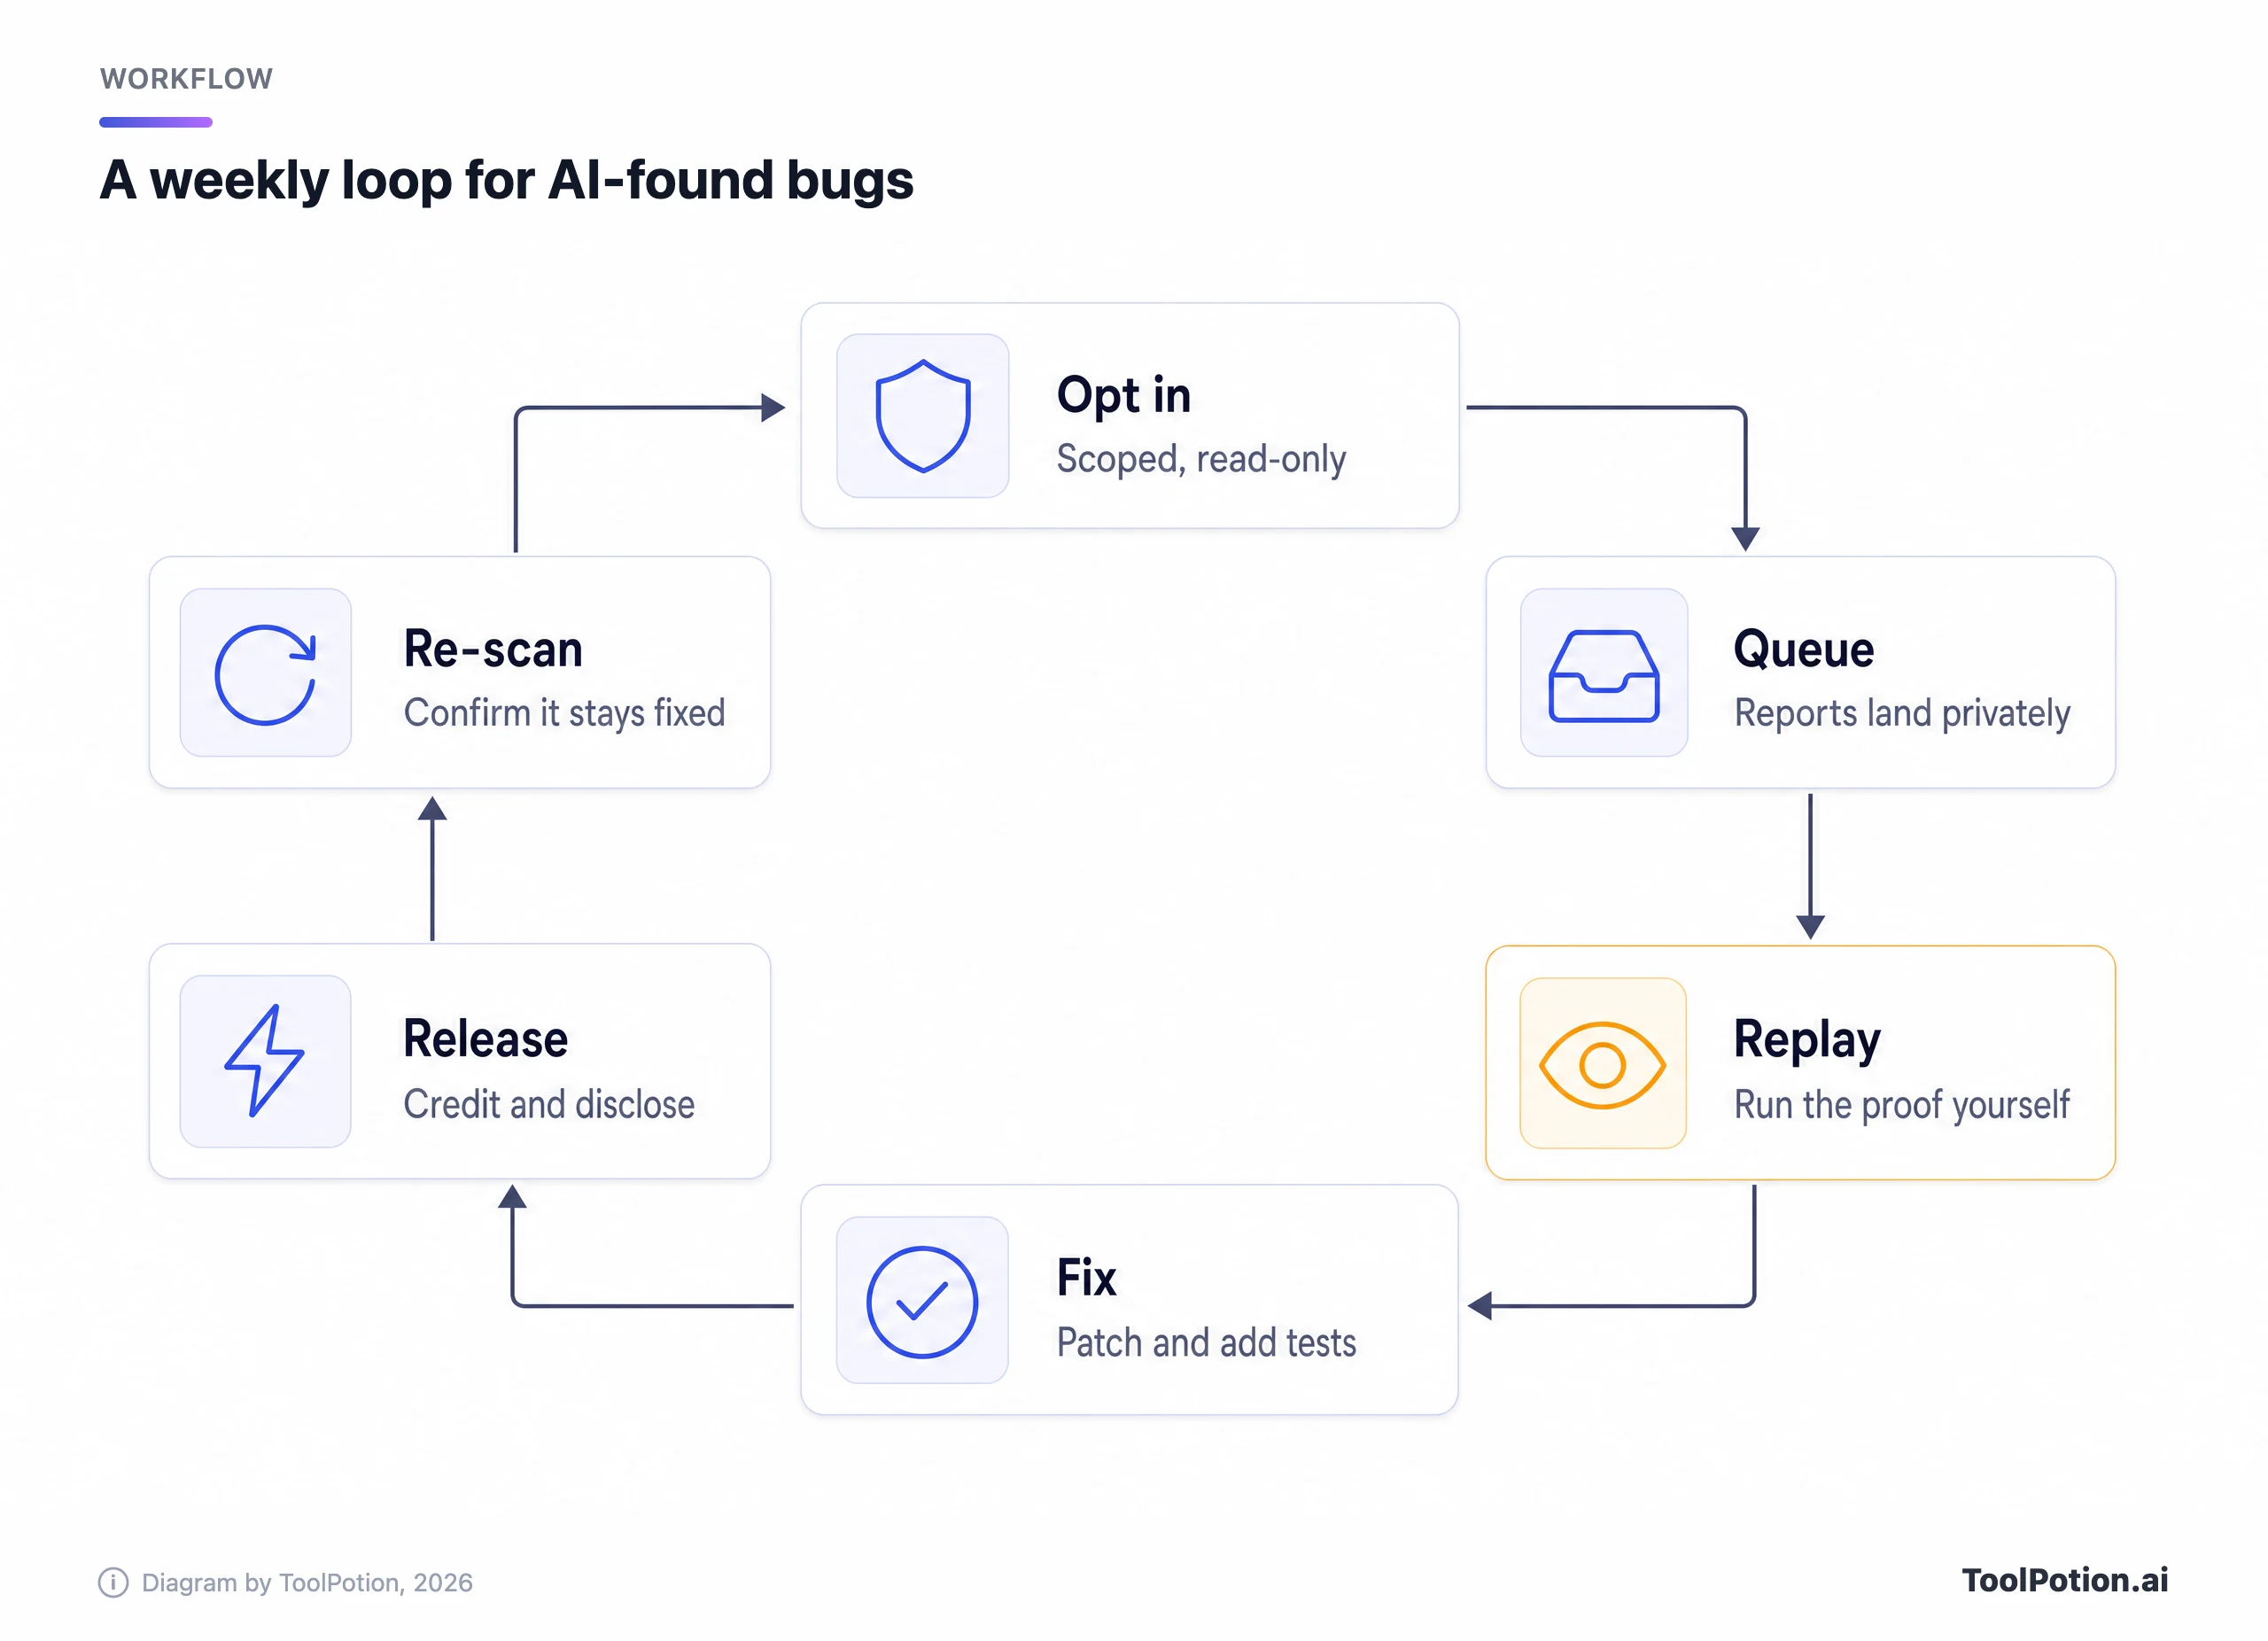
Воспроизведение — шаг, который отличает полезный сканер от шумного. Если в отчёте есть reproducer, запустите его сами. Если нет, попросите. Модель, которая не может показать, что её утверждение работает, дала вам гипотезу, а гипотезы стоят дёшево.
Не знаете, с чего начать? Дерево решений ниже разбирает типичные случаи. Это редакционный совет, построенный на условиях вендоров, описанных выше, так что подстройте его под свою ситуацию.
Для большинства небольших команд лучший первый шаг — бесплатный сканер pull request'ов плюс один человек, отвечающий за результаты. Агентный инструмент добавляйте после того, как очередь несколько недель остаётся спокойной. Хобби-репозиторию хватит бесплатных настроек по умолчанию, которые уже даёт хостинг. А библиотеке, стоящей на критическом пути, как раз стоит подавать заявку на OSS Scanner.
Считаем стоимость триажа
Время на триаж никто не выносит на страницу с ценами, но именно эта стоимость решает, поможет сканер или навредит. Даже хороший инструмент выдаёт какие-то дубликаты: в собственной проверке Anthropic их было 11 из 97. Калькулятор ниже переводит объём ваших отчётов в часы.
Попробуйте повысить долю ошибочных отчётов и посмотрите, как быстро растут часы. Затем снизьте время на отчёт до 15 минут: это грубая картина того, сколько может сэкономить рабочее доказательство (число — иллюстрация, а не измерение). Эта разница и есть довод в пользу того, чтобы требовать reproducer'ы — и от AI-инструментов, и от людей.
Когда отчёты начнут приходить, помогают несколько привычек. Графика ниже подводит итог.
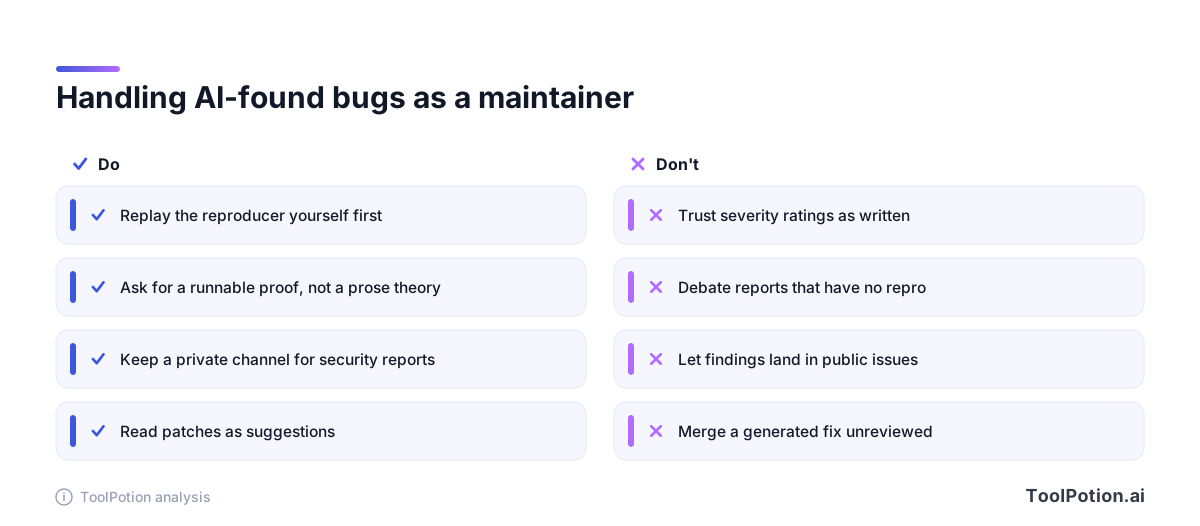
Первую пару стоит повторить. Оценки критичности ставит модель, и сама Anthropic предупреждает, что они могут быть неверными (SiliconANGLE). Оценивайте сами, когда воспроизведёте проблему. Ассистент вроде Claude Code поможет написать исправление и регрессионный тест, когда вы решили, что баг настоящий, но решение остаётся за вами. Больше контекста по таким инструментам — в нашем рейтинге AI-ассистентов для кода и в гиде по инструментам AI-ревью кода.
Где эти инструменты пока слабы
Они хороши в классах багов, оставляющих след в коде: ошибки памяти, инъекции, пропущенные проверки. Слабее они там, где изъян зависит от реальной бизнес-логики, например кому разрешено что утверждать. Сканер не может знать ваших намерений.
Они не заменяют и остальную безопасность. Google CodeMender оставляет проверку патчей людям перед отправкой в upstream (Google DeepMind), а GitHub пишет, что Autofix работает по принципу best-effort и не может подтвердить, что исправление закрывает алерты от кастомных запросов (GitHub). Вендоры, которым это выгоднее всего, всё равно говорят: проверяйте результат.
Честный предел — объём. Находить баги становится дешевле быстрее, чем их исправлять. Сканер, который вываливает на проект из трёх человек сорок настоящих находок, создал бэклог, а не более безопасный продукт. Выбирайте инструменты по тому, сколько вы успеваете исправить за месяц, а не по тому, сколько они способны найти.
Частые вопросы
Открыт ли OSS Scanner от Anthropic для любого репозитория на GitHub?
Нет. Подключение добровольное, решение принимается по каждому проекту отдельно, критерии похожи на OSS-Fuzz: у проекта должно быть критическое значение для инфраструктуры и безопасности пользователей. Мейнтейнеры подают заявку через pull request в репозиторий Anthropic на GitHub.
Заменяют ли AI-сканеры пентест?
Не для того, что важно вашим клиентам. Баги на уровне кода они покрывают хорошо, а изъяны бизнес-логики плохо. Относитесь к ним как к дополнительному слою, который работает постоянно, наряду с периодическим ревью силами людей.
Можно ли использовать Claude или Gemini напрямую для аудита кода?
Можно вставить код в Claude или Google Gemini и попросить проверить его на безопасность. Для одной функции это помогает. Но у них не будет песочницы, модели угроз по всему репозиторию и проверки эксплойтов, которые добавляют специализированные агенты выше, так что ждите больше ложных срабатываний.
Что делать, если пришёл написанный AI отчёт, который выглядит фальшивым?
Попросите reproducer для конкретной версии. Настоящая находка на такой вопрос ответит. Выдуманная часто нет. Если кто-то продолжает присылать такое, вы вправе закрыть отчёт и идти дальше.
Безопасно ли запускать бесплатные сканеры на приватном коде?
Читайте условия каждого из них. Одни работают целиком на вашей машине, другие отправляют фрагменты файлов в хостируемую модель. Прежде чем подключать приватный репозиторий, выясните, что вендор хранит и как долго.