

«Мы пока не утверждаем, что до конца понимаем это доказательство». Так заявил комитет, который OpenAI назначила для проверки своего результата по Янгу — Миллсу; цитата приводится по Scientific American. Группа под руководством физика Дэвида Гросса только что подтвердила, что доказательство одной из двух частей задачи проходит проверку в Lean, языке программирования, который проверяет математические выкладки. Но объяснить, как это доказательство работает, комитет всё равно не смог.
Мы изучили свежие материалы об ИИ в науке: эту статью, пять постов Anthropic, бенчмарк OpenAI для «мокрой» лаборатории, материал TechCrunch о стартапе PSI и пост блогера, чьи ИИ-агенты обнаружили поселение майя, которого нет в официальном реестре Мексики. Заголовки заметно опережают всё это. Поэтому мы взяли шесть популярных утверждений и сверили каждое с тем, что на самом деле говорят источники.
Утверждение 1: ИИ уже сам открывает новую науку
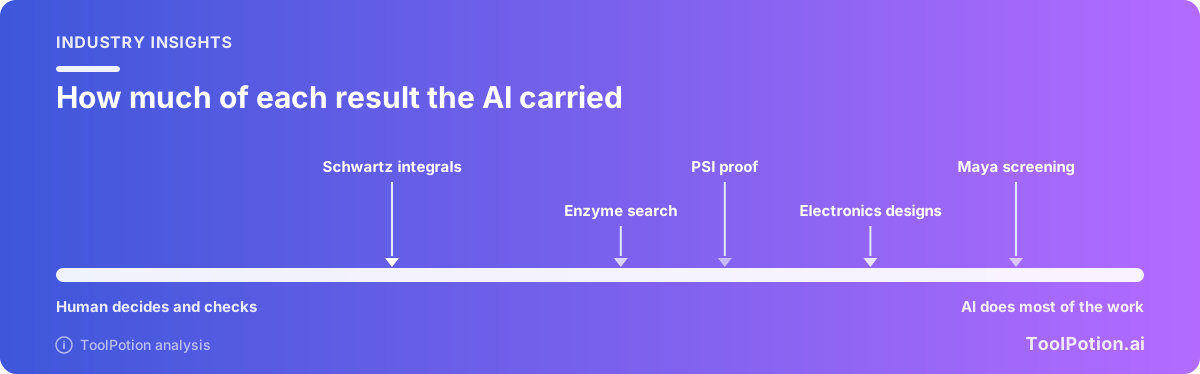
Вердикт: не сам. Лучшие случаи настоящие, но в каждом из них человек выбирал вопрос, проводил проверки или делал и то и другое.
Начнём с биологии. Anthropic сообщает, что агенты Claude нашли ферментную систему с CRISPR-подобными повторами, задействовав примерно 950 агентов, 210 млн токенов и 21 час (Anthropic). Один агент заметил паттерн повторов. Исходный промпт задали учёные Anthropic, и всю лабораторную работу тоже сделали они; большинство кандидатов Claude отсеялось при проверке, а описание вышло в виде препринта. Работа над основной функцией системы всё ещё идёт. В посте сказано, что Claude «похоже, первым заметил» определяющие признаки системы и что Claude «может самостоятельно обнаруживать аномалии»: для этапа поиска это справедливо, для остального нет. Фэн Чжан из MIT и Broad Institute, прочитав препринт, назвал его в том же посте «ярким примером того, как ИИ-агенты могут вносить вклад в биологические открытия» и сказал, что находка «заслуживает дальнейшего изучения».
Физик Мэтью Шварц, приглашённый исследователь в Anthropic, откровеннее многих. В гостевом посте для Anthropic он рассказывает о 30 интегралах, которые прошли весь путь с Claude: 15 воспроизвели известные результаты, а 15 раньше никто не вычислял (Anthropic). Подходящие задачи он называет «задачами по форме Claude» и добавляет: «чтобы получить хоть что-то научно ценное, часто приходится водить их за руку». Когда он привлёк внешних экспертов, выяснилось, что «почти во всех случаях Claude был технически прав, но результат был не так уж интересен, пока эксперт не помог нас направить». По его словам, Claude «склонен выбирать старые споры, много цитируемые, но давно забытые». Решать, что стоит решать, продолжали люди.
Теперь PSI. TechCrunch пишет, что Дэвид Турутян, сотрудник технической команды стартап-лаборатории Physical Superintelligence (PSI), получил ранний доступ к модели Anthropic Fable 5.2 и решил 18-летнюю задачу из квантовых вычислений, гипотезу Ааронсона — Амбайниса (TechCrunch). Скотт Ааронсон, поставивший эту задачу, пишет, что не совсем понимает доказательство, но считает его верным: оно было автоформализовано в Lean, и его объяснила команда ведущих исследователей, которым его показали в PSI. Сам Турутян описывает результат скромно: «Это отрицательный результат, который позволяет людям понять: окей, здесь мы больше не ищем». Решение, судя по всему, закрывает одну дорогу к квантовому ускорению, а не все.
Мы бы назвали это быстрым и неутомимым соавтором, которому нужен кто-то другой, чтобы выбрать задачу. Это немало. Но это не автономность, и сами посты компаний говорят об этом, если дочитать до оговорок.
Утверждение 2: результаты проверены
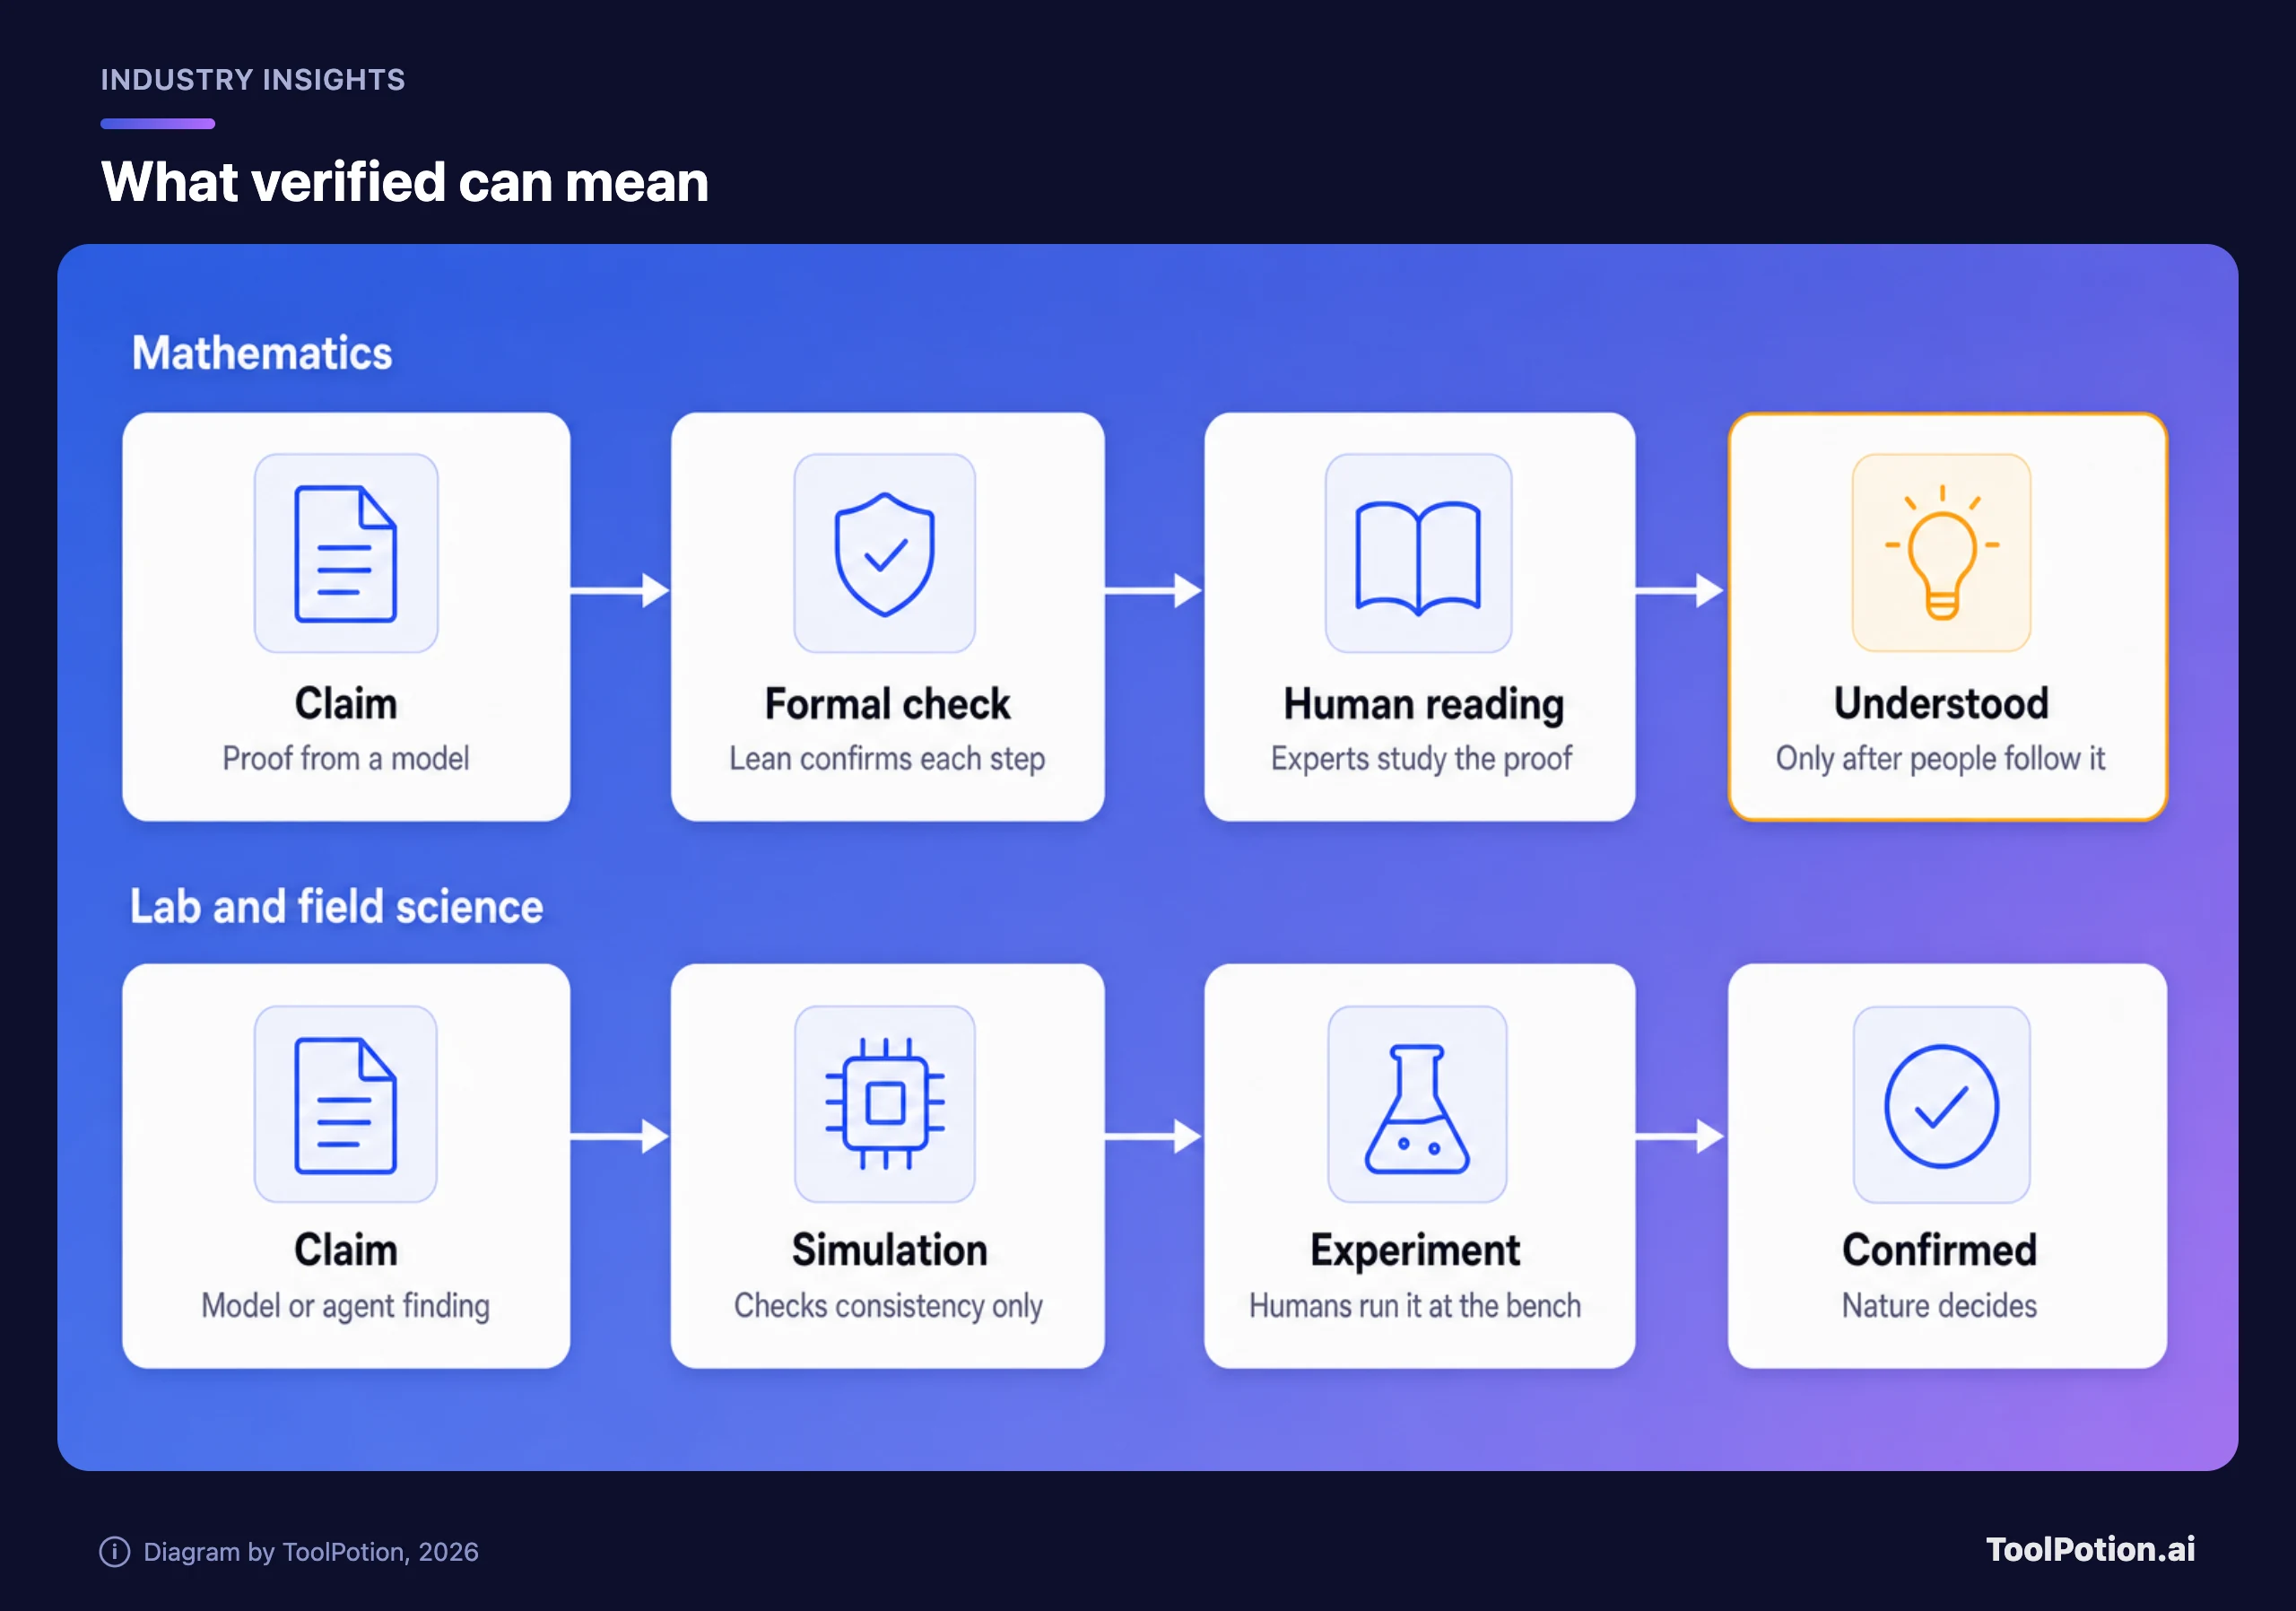
Вердикт: отчасти. В математике формальный верификатор — серьёзная проверка. В других областях «проверено» может означать что угодно: от симуляции до сверки с реестром.
В математике Lean может механически подтвердить, что доказательство следует из заданного утверждения. Это сильная проверка, и именно поэтому результаты PSI и OpenAI вообще воспринимают всерьёз. Но репортаж Scientific American показывает её пределы. Заявление OpenAI относится к части задачи Янга — Миллса о существовании; вторая часть, о массовой щели, остаётся нерешённой. Комитет использовал собственную модель OpenAI Astra, чтобы разобраться в коде на Lean, и прямо говорит, что пока не утверждает, будто понимает доказательство.
Есть и вопрос открытости. Scientific American отмечает, что такой «пастушеский» подход противоречит рекомендациям по прозрачности от консультативной группы, связанной с OpenAI, и разозлил часть математиков, увидевших в нём закрытость от сообщества. Доказательство на Lean теперь опубликовано. Скотт Армстронг из NYU сказал, что рад, что оно наконец вышло в открытый доступ, и добавил: «Эту проверку можно провести эффективнее и быстрее в открытую» (Scientific American). Мы с ним согласны. Доказательство, которое видел только назначенный OpenAI комитет, было заявлением, ожидающим проверки, и теперь проверка наконец может начаться.
За пределами математики Lean нет. Генеральный директор PSI Мэтт Пайнс сказал TechCrunch, что физика отличается от математики тем, что «в ваших моделях реальности есть голос у природы», а теоретическая физика, которую ведут машины, «ещё не здесь, но движется к этому». Шварц обнаружил, что «автоматическим проверкам по-прежнему нельзя доверять». А пост про майя, к которому мы ещё вернёмся, получил официальный ответ: мексиканский институт не нашёл зарегистрированного объекта в указанном месте. Это подтверждает отсутствие записи в реестре. Но не подтверждает существование поселения.
Утверждение 3: агенты могут управлять лабораторией
Вердикт: пока нет. Планировать, проектировать и анализировать они умеют. Пипетки и паяльники по-прежнему в руках людей.
Пост Anthropic про электронику — сильнейший недавний пример, и его стоит прочитать целиком. Вместе с производителем плат Diode (Anthropic сообщает, что у неё есть коммерческие отношения с этой компанией) Claude (модель Fable 5.2) спроектировал спикерфон с USB-C, хаб для голосового ассистента и портативного виртуального питомца: от схемы до разводки и прошивки (Anthropic). Инженеры Diode изготовили платы по файлам Claude, а прототипы собрали и протестировали вручную, потому что Claude не был подключён ни к измерительному оборудованию, ни к станкам, на которых делают печатные платы. Устройства не проходили электрическую валидацию, настройку антенн, термические испытания и сертификацию. В посте также приведён рост на бенчмарках (69% на внутреннем тесте разводки Diode PCB Gym против 25% у предыдущей модели): это цифры Anthropic по тесту, проведённому по её заказу, а стоимость показана только на оси графика, но не в тексте.
В биологии OpenAI опубликовала BioBasicsBench, бенчмарк из 100 задач, который, по её словам, измеряет, насколько хорошо ИИ-агенты интерпретируют сырые экспериментальные данные и справляются с повседневной работой «мокрой» лаборатории (OpenAI). Тест сделан самим вендором, а бенчмарк остаётся заявлением, пока его не запустят люди со стороны.
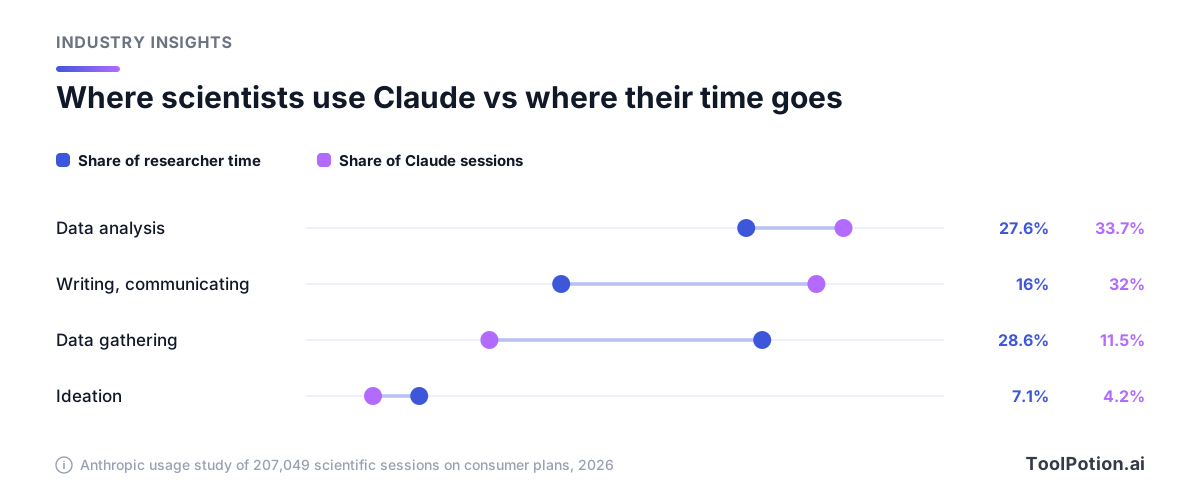
Исследование Anthropic по 207 049 научным сессиям на потребительских тарифах показывает ту же картину в реальной жизни. Сбор данных занимает 28,6% времени исследователей, но лишь 11,5% сессий в Claude, и разрыв больше всего там, где есть физические барьеры, например при сборе клинических или биохимических данных (Anthropic). Слова самого исследования: «физические узкие места остаются мощными».
Утверждение 4: теперь это может сделать любой
Вердикт: начать может любой. Чтобы получить результат, который выдержит проверку, нужен человек, знающий область.
История с майя — самый чистый тест. Пьетро Миотти, по его словам не археолог, направил 48 агентов на примерно 1200 квадратных километров открытых лидарных данных NASA и получил поселение на вершине холма с площадью и пирамидой, а затем и официальный ответ — меньше чем за 72 часа (его пост). Описание метода у него образцово простое: «Никакой особой модели или классификатора не было: агенты буквально смотрели на картинки».
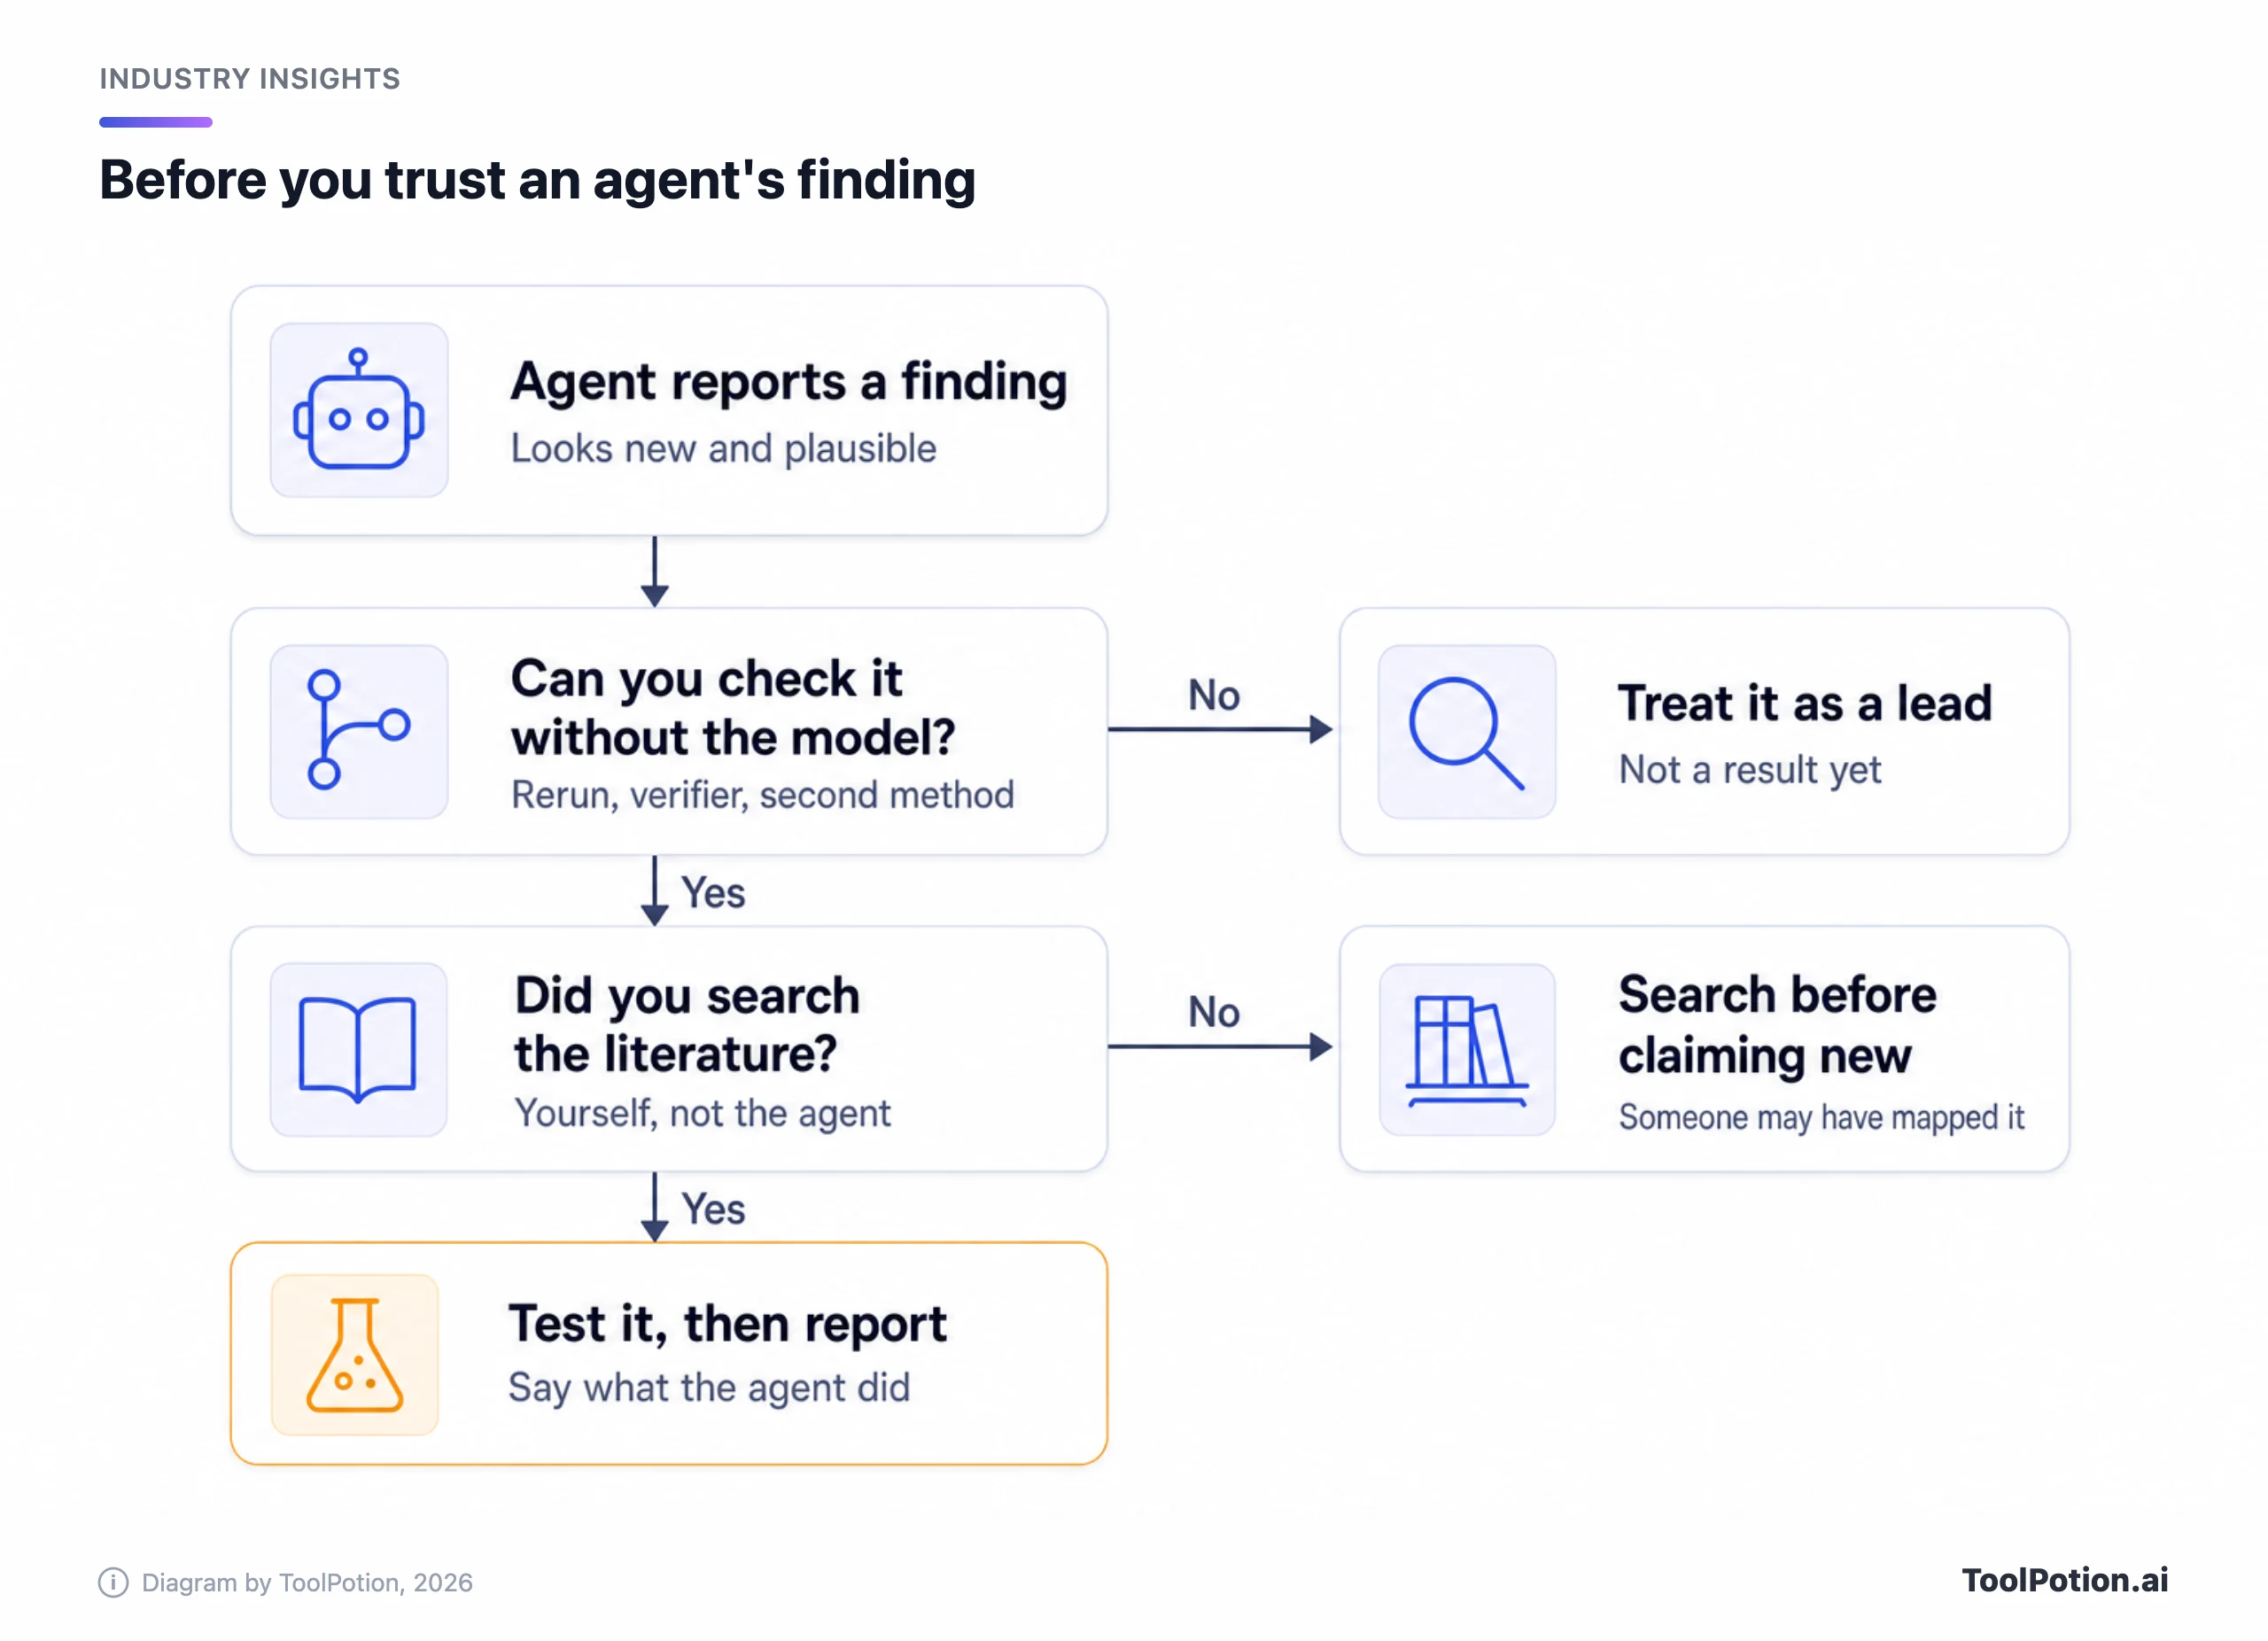
Затем поправка, которая теперь стоит в начале страницы. «Агенты пропустили это при просмотре литературы, поэтому они переоткрыли, а не открыли». Поселение уже нанесено на карту в статье 2025 года Эстрады-Белли и коллег, просто его ещё не было в мексиканском реестре. Миотти молодец, что поставил это на первое место. Он также говорит, что не знает испанского и доверился переводу своего отчёта, сделанному агентами, что история о классическом периоде — это «домыслы после долгого чата с агентами», а реконструкция на картинке сгенерирована ИИ. Наземного обследования в тексте нет.
Как мы это читаем: это хорошая демонстрация дешёвого скрининга и плохая демонстрация открытия. Смотреть теперь почти бесплатно. А чтобы узнать, смотрел ли кто-то до вас, по-прежнему нужен специалист или хотя бы поиск по литературе, который агенты нормально не провели. Путь PSI был другим и поучительным: компания придержала результат, пока модель Anthropic не была почти готова к выпуску, и использовала это время, чтобы показать его исследователям, способным его объяснить. Джим Хэлверсон, профессор Northeastern и консультант PSI, сказал TechCrunch: «Лучшие практики ещё только формируются».
Утверждение 5: учёных вот-вот автоматизируют
Вердикт: не доказано, а громче всех об этом говорят те, у кого есть в этом интерес.
Турутян сказал TechCrunch: «Я полностью допускаю, что эта статья может оказаться последней в моей жизни». Пайнс рассказал, что шесть-девять месяцев назад в разговорах с инвесторами ему «приходилось слегка преувеличивать», утверждая, что теоретическая физика скоро станет в основном делом машин, и что сейчас этого «ещё нет». По опросу Anthropic, около 40% из 528 исследователей ожидают, что к 2030 году ИИ будет самостоятельно выполнять целые исследовательские проекты, но их набирали среди заявителей на гранты Anthropic AI for Science, так что они, вероятно, пользуются ИИ активнее большинства (Anthropic).
Модельные оценки скромнее. По расчётам Anthropic, нынешние возможности при широком внедрении могли бы взять на себя от 27 до 52% времени исследователей, необходимого для нового исследования, а это означает рост выпуска от 1,35 раза в гуманитарных науках до 2,02 раза в статистике. Гипотетический сценарий из отчёта, в котором ИИ автоматизирует всю нефизическую работу, даёт примерно 15-кратный рост в статистике и информатике, но лишь 3–4-кратный в экспериментальных науках вроде биологии и химии, где узким местом остаются физические этапы. Это сценарий, а не измерение. Даже скромный вариант — большая перемена для области. Но это не замена, и в отчёте отмечено, что сегодня работа с ИИ в основном вспомогательная или совместная. О том, кому достанется заслуга, Шварц говорит лучше, чем сказали бы мы: это «не решится, если делать вид, будто вклад человека — это набор текста».
Утверждение 6: если модель ИИ подходит под данные, мы понимаем систему
Вердикт: ложь, и авторы, которые строят такие системы, сами это говорят.
Гостевой пост группы из Тюбингена (Якоб Маке, Даниэль Гедон и Стефан Валь, все — получатели грантов Anthropic AI for Science) об обучении ИИ строить научные модели выстраивает аргумент аккуратно. Одним и тем же данным соответствует много моделей, поэтому полезный результат — это набор правдоподобных моделей и список того, в чём они сходятся (Anthropic). Авторы признают, что эти системы «в основном тестировались на переоткрытии моделей, которые учёные уже знают», а данных по задачам без известного ответа мало. И пишут: «ИИ-система, которая просто выдаёт вам модель, может дать ответ, но не даёт понимания».
Мы считаем, что последнюю фразу стоит повесить над каждым лабораторным столом и над столом каждого студента. Соответствие данным — это число. Объяснение — это то, с помощью чего человек может предсказать, что будет дальше.
Алгоритм для исследователей и студентов
Ничто из сказанного выше не значит «не пользуйтесь этими инструментами». Данные Anthropic об использовании показывают, что учёные и так применяют их там, где они работают лучше всего: в основном для анализа и письма. Вот алгоритм, которому мы бы следовали, построенный на том, что пошло не так в описанных случаях.
- Поручайте агентам работу, результат которой вы можете проверить сами: анализ данных, перенос кода между языками, скрининг статей или изображений. Claude Code и Claude Cowork созданы для такой работы, а наше сравнение терминальных кодинг-агентов охватывает весь рынок.
- Заранее решите, что считается проверкой и кто её проводит. Не та же самая модель. Формальный верификатор, второй анализ, лабораторный эксперимент или коллега.
- Когда агент говорит, что нашёл что-то новое, проведите поиск по литературе сами. Специальный инструмент вроде Elicit, Consensus, SciSpace или ResearchRabbit займёт минуты, а случай с майя показывает, во что обходится пропуск этого шага. Более длинный список есть в нашем рейтинге ИИ-ассистентов для исследований.
- Физический этап оставляйте за людьми и фиксируйте его. Если результат зависит от измерения, образца или выезда на место, именно там его и проверяют.
- Когда пишете отчёт, укажите, что сделал агент и что проверили вы. Шварц прямо говорит, что вклад человека — не набор текста.
- Студентам: свои первые модели стройте сами. Авторы из Тюбингена пишут: «именно процесс построения даёт понимание». Используйте агента, чтобы критиковать вашу модель, а не чтобы он вручил вам готовую.
Если вам нужен более старый и лучше проверенный пример того, как ИИ занимается биологией, это по-прежнему AlphaFold: он предсказывает структуры, которые затем проверяют в лабораториях. Для работы с литературой и исследований в агентном стиле есть ещё Edison Scientific, Scientific Agent Skills для оснащения ваших собственных агентов и подборка Top 250 AI Tools for Researchers. Что касается универсальных ассистентов, ChatGPT vs Claude vs Gemini сравнивает ChatGPT с двумя главными конкурентами, а рейтинги ИИ-ассистентов для исследований и ИИ-агентов ранжируют специализированные инструменты.
Где мы сходимся во мнении и что заставило бы нас передумать
Реально: агенты теперь — полезные, неутомимые аналитики и инженеры. Прототипы электроники работают, ферментная зацепка интересна, а проверенное в Lean доказательство от модели — настоящий результат, кто бы ни понял его первым. 15 новых интегралов Шварца — настоящие результаты в узкой области.
Хайп: автономность, вольно трактуемое «проверено» и грядущая волна автоматизированных учёных. Почти в каждом впечатляющем результате выше есть человек, который делает ту часть работы, что решает, правда ли это, и сами люди об этом говорят. Мы также хотели бы, чтобы лаборатории печатали стоимость в долларах рядом с результатом бенчмарка. Кредиты и количество токенов скрывают, во сколько обходится открытие, а 210 млн токенов на один поиск фермента — цифра, которая интересует бюджет любой лаборатории.
Нас переубедили бы две вещи. Первая: математики вне комитета OpenAI прочитают код Lean по Янгу — Миллсу и сообщат, что поняли его. Вторая: рецензируемая версия работы о ферменте, где сказано, что эта система делает. Пока этого нет, мы считаем обе работы многообещающими и незавершёнными.