

Perplexity — лучший AI-ассистент для исследований для большинства людей в 2026 году, а NotebookLM стоит выбирать, когда ответ должен опираться на ваши собственные файлы. Дальше выбор зависит от того, что именно вы изучаете: научные статьи, клинический вопрос, стопку PDF или открытый интернет. В рейтинге ниже представлены 25 лучших инструментов, а в этом гайде разобраны те, на которые стоит потратить время.
Категория выглядит перегруженной, но делится она вполне чётко. Одни инструменты ищут в вебе. Другие читают только то, что вы им дали. Третьи ищут по научной литературе, а один известный сервис создан для врачей. Отличие хорошего выбора от рискованного везде одно и то же: вы должны видеть, откуда взято каждое утверждение, и уметь его проверить.
Этот вопрос проходит через весь материал. Цитаты здесь и есть продукт, а цитаты бывают неверными.
Топ-25 прямо сейчас
- # 1Лучший выборPerplexity — AI Ответный ДвигательИИ-приложениеPerplexity — это бесплатный ответный двигатель на основе ИИ, который предоставляет точные, надежные и актуальные ответы на любые вопросы, делая поиск информации эффективным и простым.92ToolRankЭлита
- # 2Второе местоNotebookLMМобильное приложениеNotebookLM — это персонализированный AI-ассистент для исследований, который помогает пользователям понимать любую тему. Он предлагает удобный интерфейс и мощные функции для повышения продуктивности и упрощения исследовательских процессов.74ToolRankСильный
- # 3Третье местоOpenEvidenceИИ-приложениеOpenEvidence — это официальная медицинская платформа знаний в Америке, разработанная для медицинских работников. Она предоставляет основанные на доказательствах ответы, основанные на рецензируемых исследованиях из ведущих медицинских журналов, улучшая клиническое принятие решений в момент оказания помощи.73ToolRankСильный
- 4OpenAI PrismИИ-приложениеOpenAI Prism — это бесплатный редактор LaTeX и рабочее пространство, созданное для ученых. Он интегрирует ChatGPT и Codex для улучшения научного письма и сотрудничества, предоставляя помощь в корректуре, управлении цитатами и форматировании.64ToolRankСильный
- 5SciSpace AI для исследованийИИ-приложениеSciSpace — это AI-ассистент для исследований, разработанный для академиков, который позволяет проводить систематические обзоры литературы по более чем 280 миллионам статей и помогает в написании статей с указанными источниками. Доверяют миллионы студентов, аспирантов и исследователей по всему миру.62ToolRankСильный
- 6Google PinpointИИ-приложениеGoogle Pinpoint помогает журналистам быстро находить важные истории в больших коллекциях PDF-документов, рукописных материалов, изображений, архивов электронной почты и аудиофайлов с использованием ИИ и машинного обучения.61ToolRankСильный
- 7ConsensusИИ-приложениеConsensus — это поисковая система для научных публикаций на базе ИИ, которая анализирует рецензируемую литературу для ускорения исследований. Она помогает пользователям находить, организовывать и анализировать научные статьи в 10 раз быстрее, превращая обзор литературы из дней в минуты. Платформа поддерживает строгие академические исследования благодаря расширенным возможностям фильтрации и суммаризации.61ToolRankСильный
- 8Westlaw Precision AIИИ-приложениеWestlaw Precision AI — это современный инструмент для юридических исследований, который использует ИИ и надежный контент для предоставления быстрых, экспертных аналитических данных. Он помогает юридическим специалистам уверенно переходить от исследований к стратегии, обеспечивая всесторонние и проверяемые результаты.60ToolRankСильный
- 9ElicitИИ-приложениеElicit — это исследовательский помощник на базе ИИ, который помогает ученым и исследователям находить, обобщать и извлекать данные из более чем 138 миллионов научных статей. Он автоматизирует систематические обзоры литературы, генерирует исследовательские отчеты и предоставляет цитаты на уровне предложений для обеспечения точности, что способствует более быстрому обнаружению и принятию решений на основе фактических данных в различных отраслях.60ToolRankСильный
- 10Gemini NotebookИИ-приложениеGemini Notebook — это основанный на источниках AI исследовательский блокнот от Google, предназначенный для быстрого суммирования и ведения заметок. Он служит виртуальным исследовательским помощником, предоставляя надежную информацию и инсайты.59ToolRankУверенный
- 11Платформа инноваций PatSnap AIИИ-приложениеPatSnap — это платформа на основе ИИ, предлагающая поиск патентов, составление, мониторинг и аналитику ИС. Она ускоряет продуктивность НИОКР на 75%, используя более 2 миллиардов экспертных данных, которым доверяют более 15 000 новаторов по всему миру.58ToolRankУверенный
- 12Semantic ScholarИИ-приложениеSemantic Scholar — это бесплатный исследовательский инструмент на базе ИИ, разработанный для помощи ученым в поиске релевантной научной литературы. Он использует передовые технологии ИИ и инженерии для понимания семантики научных статей, что упрощает поиск и взаимодействие с академическим контентом во всех научных областях. Платформа направлена на повышение доступности и контекстуализации исследований.57ToolRankУверенный
- 13Rayyan AI Review PlatformИИ-приложениеRayyan — это платформа на базе ИИ, разработанная для ускорения систематических обзоров и литературных обзоров для исследователей. Она автоматизирует ключевые задачи, такие как скрининг, дедупликация и извлечение данных, позволяя командам быстрее и эффективнее синтезировать доказательства. Rayyan, которому доверяют более миллиона исследователей по всему миру, оптимизирует весь рабочий процесс обзора.56ToolRankУверенный
- 14Readwise ReaderИИ-приложениеReadwise Reader — это универсальное приложение для чтения, предназначенное для заядлых читателей. Оно объединяет статьи, PDF и многое другое в одном месте, предлагая мощные функции поиска и выделения.55ToolRankУверенный
- 15ResearchRabbitИИ-приложениеResearchRabbit упрощает обзор литературы, помогая исследователям находить связанные статьи, строить карты цитирования и отслеживать тенденции исследований. Он превращает исследование академической литературы из утомительной задачи в процесс открытия, движимый любопытством, экономя драгоценное время ученых и студентов.55ToolRankУверенный
- 16SciteИИ-приложениеScite — это инструмент ИИ, который ищет более 300 миллионов научных статей, чтобы предоставить ответы, основанные на цитатах. Он помогает исследователям понять силу доказательств, стоящих за утверждениями, делая поиск литературы более эффективным и надежным.55ToolRankУверенный
- 17HebbiaИИ-приложениеHebbia — это платформа ИИ, разработанная для специалистов в области финансов, предлагающая институциональную аналитику для поддержки принятия важных решений. Она подключается к источникам финансовых данных, позволяя пользователям анализировать документы, выявлять инсайты и автоматизировать рабочие процессы. Hebbia, которой доверяют ведущие финансовые институты, стремится повысить скорость и влияние инвестиционных процессов.53ToolRankУверенный
- 18LinerИИ-приложениеLiner — это инструмент на базе ИИ, предназначенный для улучшения веб-браузинга и исследований. Он позволяет пользователям выделять, организовывать и сохранять контент с веб-страниц, создавая персонализированную базу знаний. Платформа призвана оптимизировать поиск и запоминание информации для студентов, исследователей и профессионалов, стремящихся эффективно управлять онлайн-данными.53ToolRankУверенный
- 19База данных ScopusИИ-приложениеScopus — это обширная база данных аннотаций и цитирований, которая предоставляет доступ к научной, технической, медицинской и социальной литературе. Она предлагает продвинутые инструменты поиска и метрики для исследователей, чтобы выявлять тенденции, находить соавторов и измерять влияние исследований.53ToolRankУверенный
- 20ScholarcyИИ-приложениеScholarcy упрощает исследование, подводя итоги статей, научных работ и учебников в интерактивные карточки. Это помогает пользователям понять сложные исследования и эффективно организовать свои знания.53ToolRankУверенный
- 21Dimensions AIИИ-приложениеDimensions AI — это комплексная исследовательская база данных, которая связывает гранты, публикации, наборы данных, клинические испытания, патенты и политические документы. Она предоставляет инструменты для анализа исследований, позволяя пользователям быстро ориентироваться и интерпретировать глобальные исследовательские данные для стратегических выводов.52ToolRankУверенный
- 22InstrumentlИИ-приложениеInstrumentl — это платформа управления грантами на основе ИИ, которая помогает некоммерческим организациям эффективно находить, выигрывать и управлять грантами. Она предлагает обширную базу данных, ИИ-управляемое соответствие и инструменты для написания предложений и управления после получения гранта, все в одном рабочем пространстве.51ToolRankУверенный
- 23GPT ResearcherРепозиторий GitHubGPT Researcher — это автономный агент, предназначенный для глубоких исследований по любой теме, создающий подробные, фактические и беспристрастные отчеты со ссылками. Он использует агенты планирования и выполнения для генерации исследовательских вопросов и сбора информации. Инструмент предлагает параметры настройки и поддерживает различные форматы файлов для локальных исследований.51ToolRankУверенный
- 24Connected PapersИИ-приложениеConnected Papers — это визуальный инструмент, разработанный для исследователей и прикладных ученых с целью поиска и изучения научных статей, релевантных их работе. Он генерирует интерактивные графы похожих статей, помогая пользователям получить наглядное представление о тенденциях, популярных работах и динамике в определенной области, гарантируя, что ни одно важное исследование не будет упущено.51ToolRankУверенный
- 25Atlas.tiИИ-приложениеAtlas.ti — это ведущая программа для качественного анализа данных, предлагающая инструменты на основе ИИ для исследователей, студентов и бизнеса. Она поддерживает различные форматы данных и предоставляет интуитивно понятные функции для эффективного анализа и сотрудничества.50ToolRankУверенный





Как работает ToolRank
ToolRank — собственный рейтинговый движок ToolPotion.
Он непрерывно оценивает сотни сигналов со всего открытого веба — реальный трафик и популярность, силу аудитории и сообщества, авторитетность и долговечность, распространение и вовлечённость — и обрабатывает миллионы точек данных, чтобы каждый инструмент занял то место, которое заслужил.
Каждый тип ИИ оценивается собственной моделью: то, что подтверждает популярность SaaS-приложения, не подходит для open-source-фреймворка или канала автора. Отсутствие на какой-либо платформе никогда не идёт инструменту в минус — ToolRank оценивает те данные, которые есть.
Никаких платных мест. Никаких цифр со слов самих авторов.
Краткие рекомендации
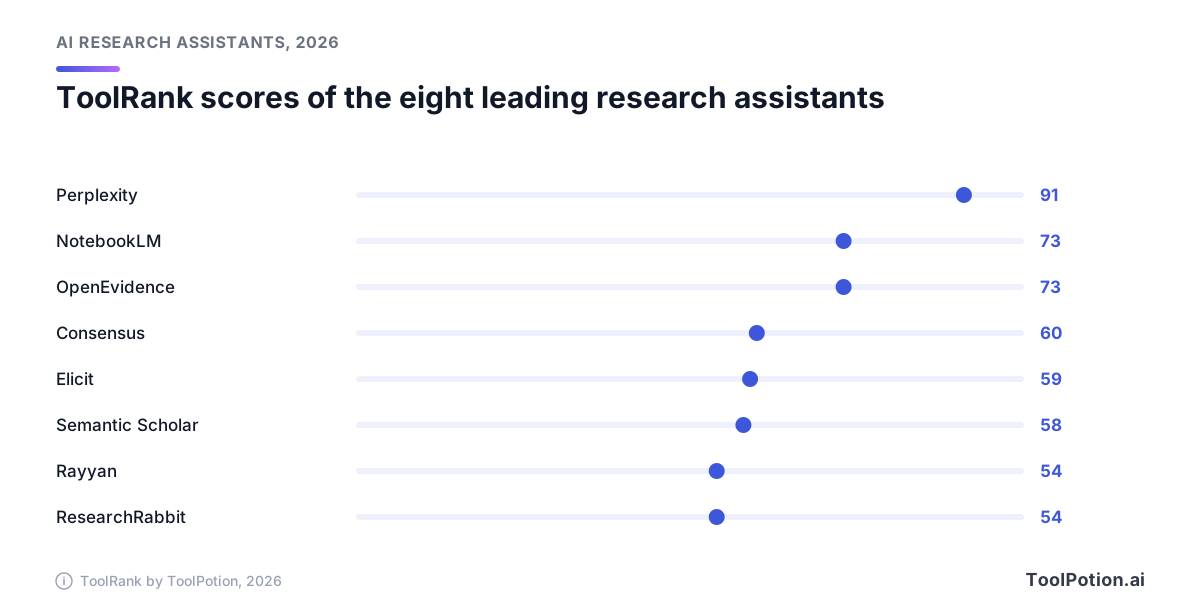
- Лучший в целом — Perplexity: он занимает 1-е место в рейтинге 2026 года с ToolRank 91 (элитный уровень) и опережает следующего участника на 18 баллов.
- Лучший для работы со своими документами — NotebookLM, теперь с брендом Gemini Notebook: он отвечает по загруженным вами источникам и больше ни по чему.
- Для академической литературы Consensus даёт быстрый срез того, что говорят исследования, а Elicit извлекает данные из статей.
- Semantic Scholar — лучший бесплатный вариант для научного поиска, а создаёт его некоммерческий институт.
- Врачам стоит присмотреться к OpenEvidence, который создан для медицинских вопросов.
- Тем, кто делает систематический обзор, лучше начать с Rayyan: он берёт на себя рутину скрининга.
Это лидеры рейтинга Top 100 AI Research Assistants. По диаграмме видно, насколько плотно сгруппирована середина списка и как высоко над ней стоит Perplexity.
Что изменилось в 2026 году
В 2026 году Google переименовала NotebookLM в Gemini Notebook. В компании заявляют, что это тот же самостоятельный продукт, теперь с защищённым облачным компьютером, который запускает код по вашим источникам, и сообщают о более чем 30 млн пользователей (Google). В нашем рейтинге по-прежнему используется название NotebookLM. Кроме того, NotebookLM совершил самый большой скачок среди лидеров: с 10-го места на 2-е в рейтинге 2026 года.
OpenEvidence остаётся бесплатным для медицинских специалистов и финансируется за счёт рекламы фармацевтических и других компаний. Его CEO говорил, что хотел бы изменить эту модель (NBC News). Кто будет платить вместо рекламодателей, пока никто не сказал.
Менее радостные перемены касаются научных статей. Ранее в этом году arXiv начал выдавать годовые баны на подачу работ авторам, чьи статьи содержат непроверенный AI-текст, включая выдуманные ссылки (SMU Libraries). Если вы это цитируете, вы за это отвечаете. Таков новый базовый стандарт.
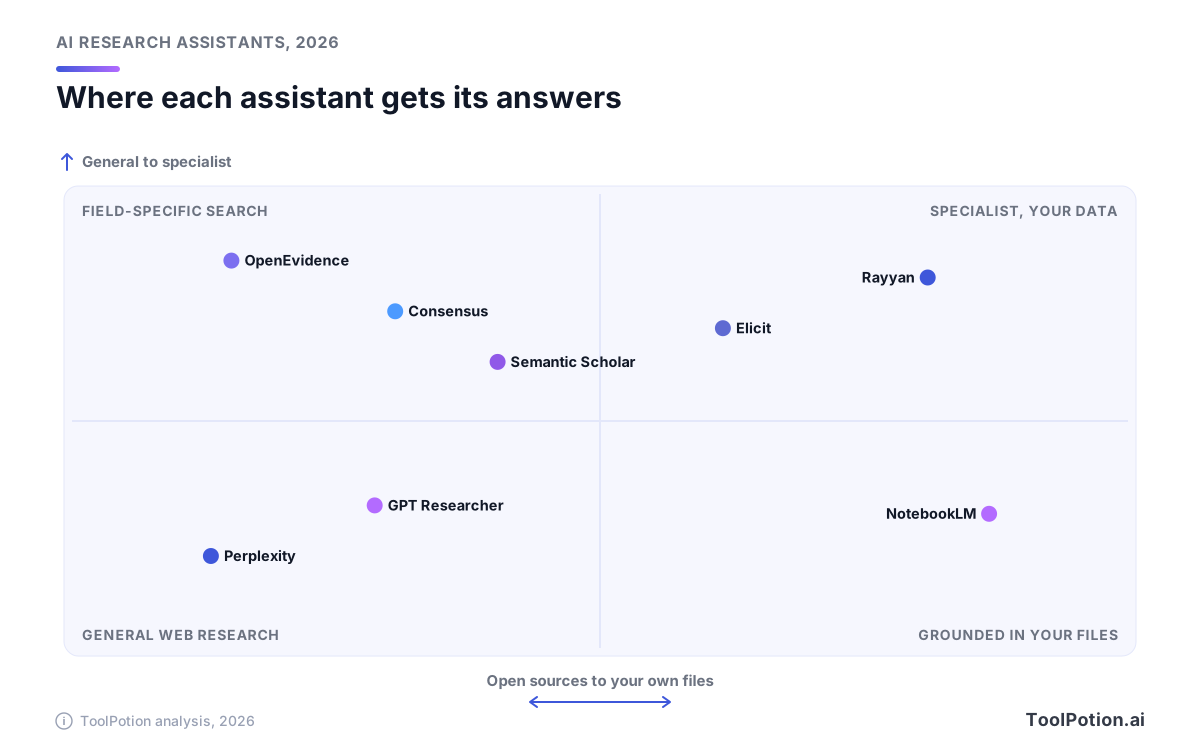
На карте ниже инструменты разложены по тому, откуда они берут ответы и насколько узкая у них специализация.
Проблема доверия — это проблема цитат
Ответ с опорой на источники строится в пять шагов, и ошибка может проскользнуть на любом из них.
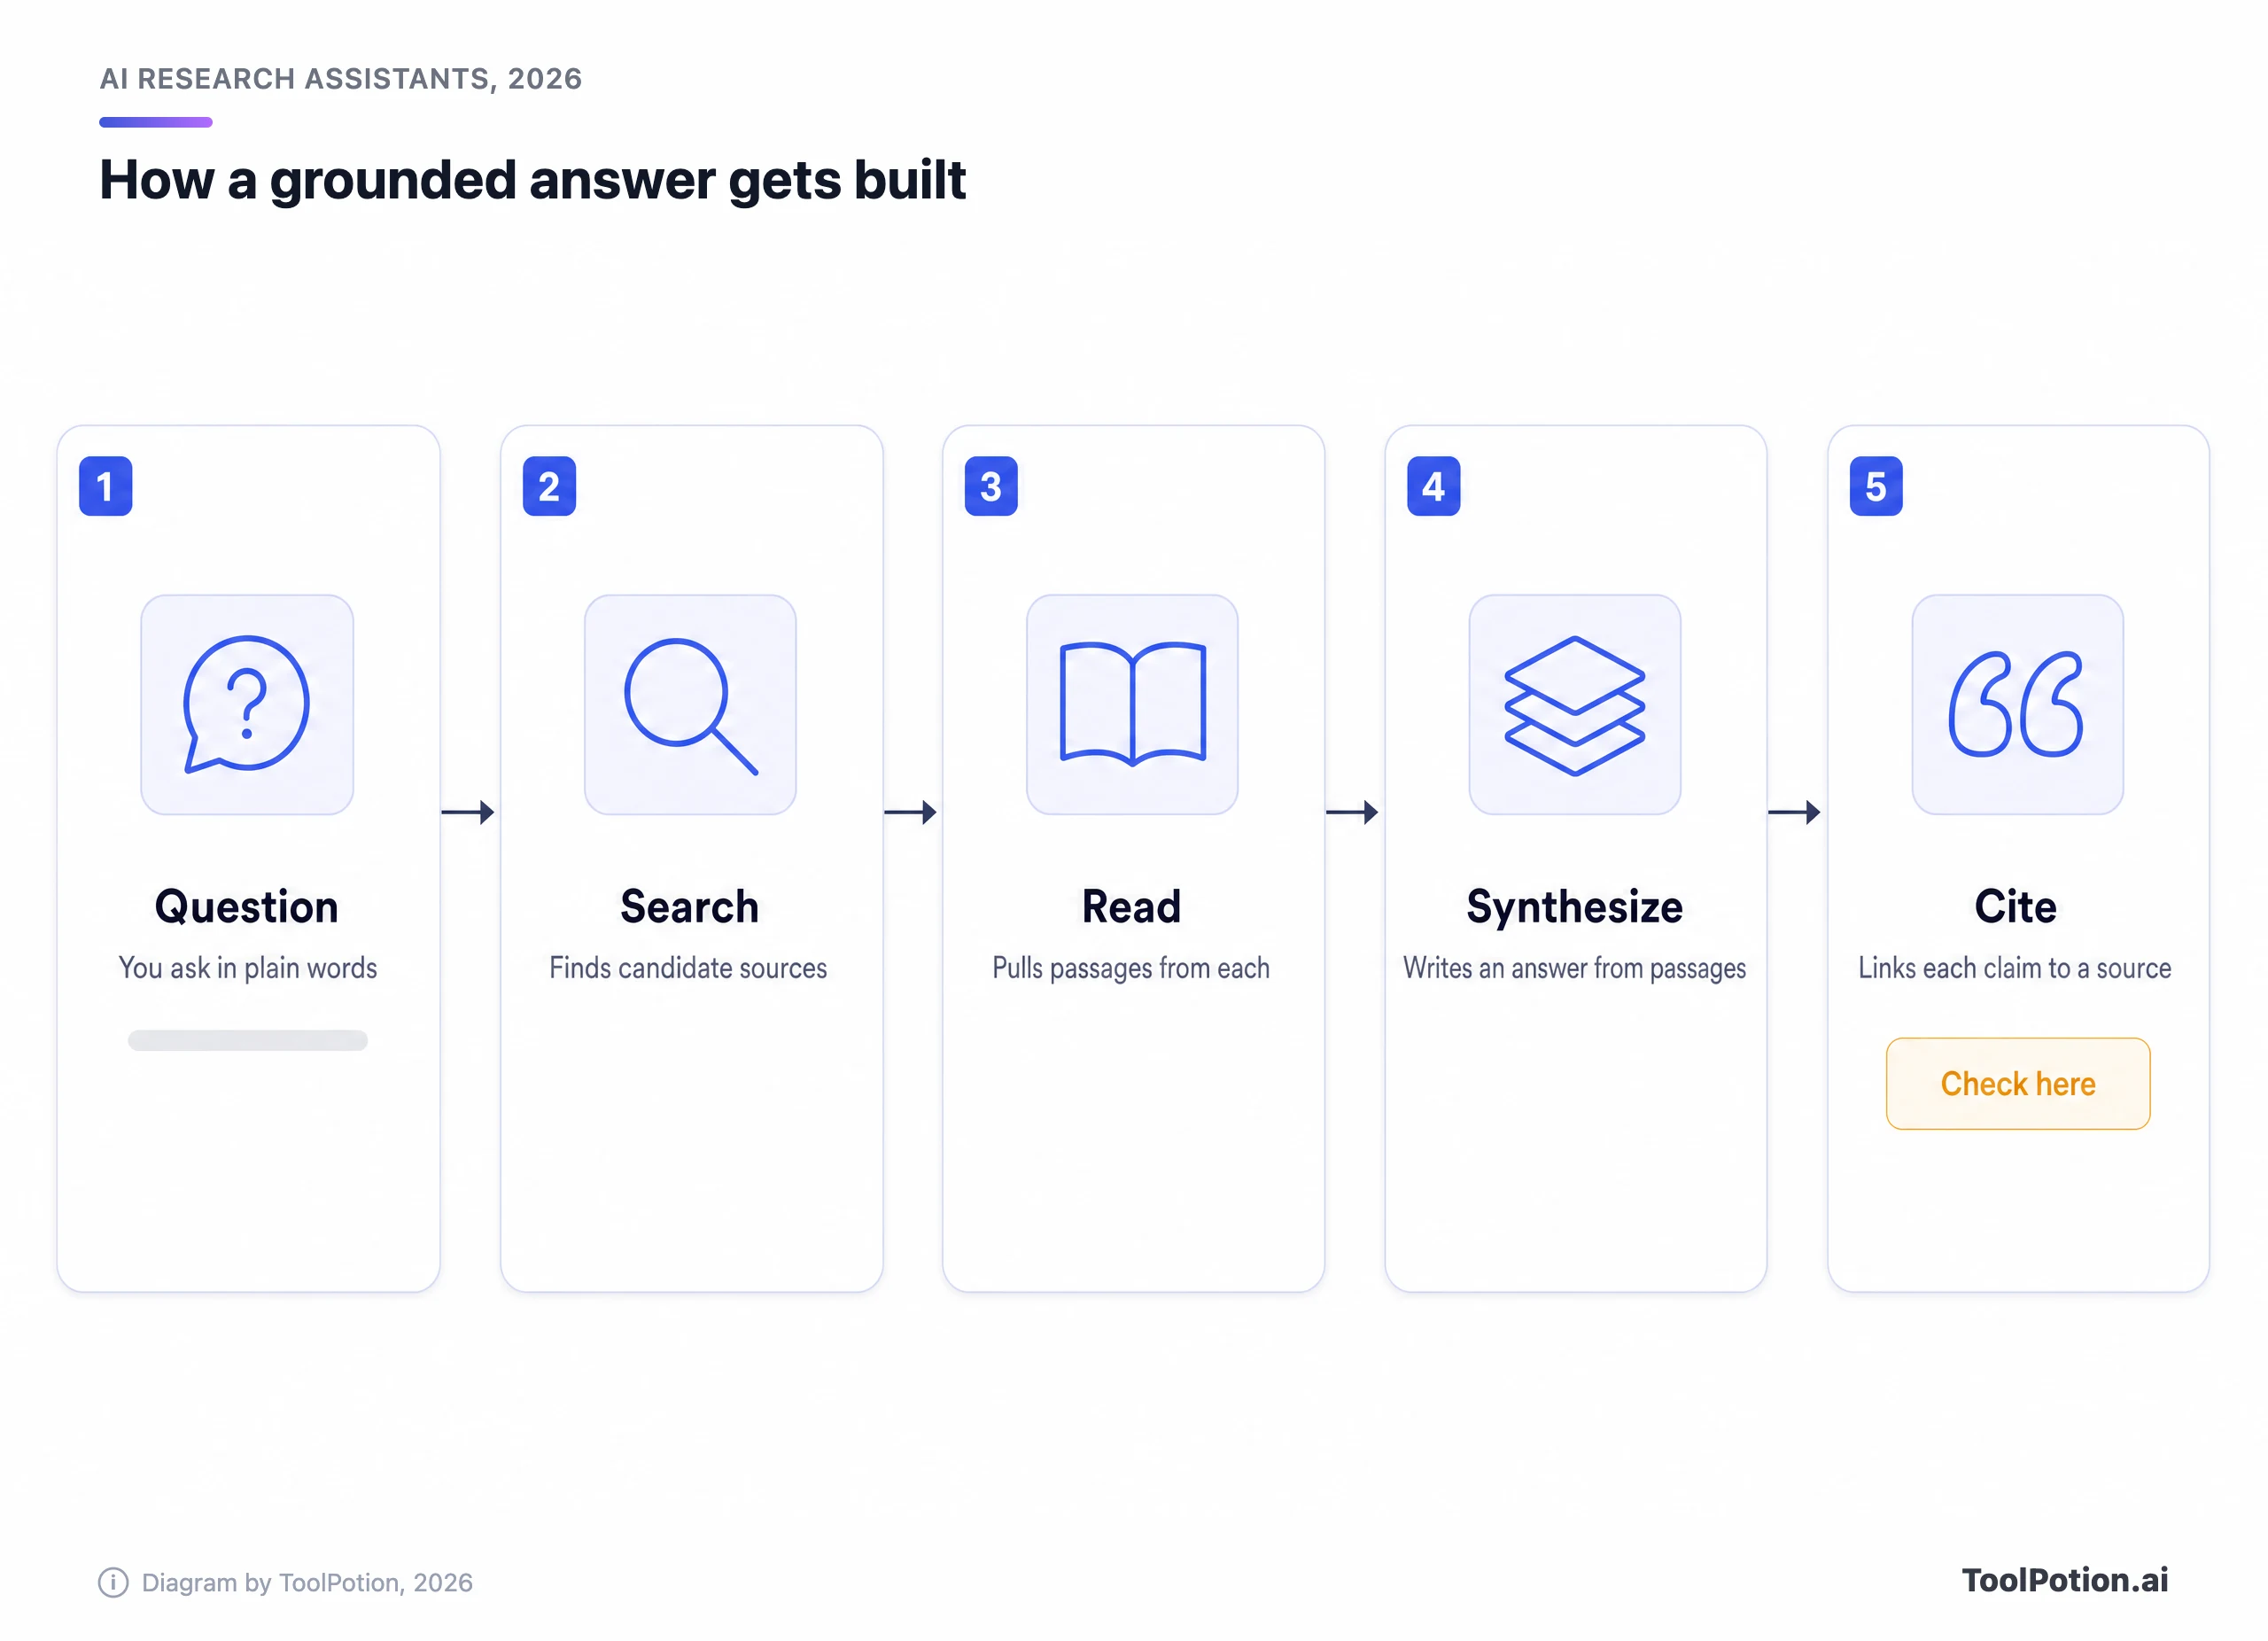
Поиск может пропустить ключевую статью. Чтение может ограничиться аннотацией. На этапе написания текст может разойтись с тем, что сказано в отрывках. А на последнем шаге к утверждению может быть привязана настоящая ссылка, которая его не подтверждает. Тест библиотекарей в HKUST показал, что Scite получал полный текст, тогда как остальные инструменты в основном выдавали аннотации (HKUST Library).
Самый известный аудит провёл Tow Center при Колумбийском университете. Восьми AI-поисковикам давали отрывки из новостных статей и просили указать заголовок, издателя, дату и URL. В сумме они ошиблись более чем в 60% запросов. Лучше всех справился Perplexity с долей ошибок 37%, но платные версии Perplexity и Grok ошибались увереннее бесплатных, а несколько инструментов приводили выдуманные или нерабочие ссылки (Columbia Journalism Review). Тест измерял, насколько хорошо поисковики определяют источник новостных отрывков, а не то, как они цитируют научные статьи. Воспринимайте его как предупреждение об излишней уверенности, а не как приговор какому-то одному инструменту.
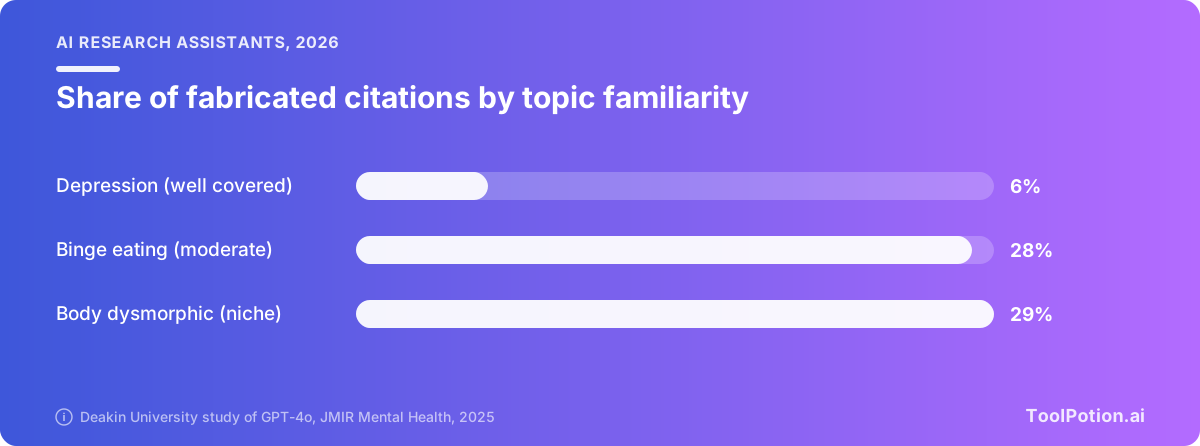
Что касается научных работ, самые убедительные данные относятся к обычным чат-ботам, и именно поэтому важна опора на источники. Исследователи из Университета Дикина попросили GPT-4o написать шесть литературных обзоров по темам психического здоровья. Из выданных им ссылок 19,9% оказались выдуманными, а в 45,4% реальных были ошибки, например неверные DOI (EurekAlert). Полезнее всего здесь закономерность: доля выдуманных ссылок составила 6% по депрессии, очень хорошо изученной теме, и 28–29% по двум менее освещённым.
Специализированные ассистенты справляются лучше, но не идеально. В тесте HKUST Scite, Elicit, Consensus и Scopus AI вернули реальные цитаты на вопрос о сне и наборе веса. А вот сопоставить каждый аргумент с источником получилось уже не у всех, и слабее всех оказался Scopus AI: его аргументы источники не подтверждали. Библиотекари назвали результат отправной точкой, а не заменой литературного обзора. Вопрос был один и на хорошо изученную тему, так что на узких темах ждите результатов хуже.
Рабочее правило простое. Откройте источник, прежде чем использовать утверждение. Перепроверяйте всё важное повторным запуском. А новый инструмент проверяйте на теме, которую вы знаете досконально.
Обзор лидеров
Perplexity: лучший для быстрых ответов с цитатами по открытому вебу
Perplexity занимает 1-е место в рейтинге 2026 года с ToolRank 91 (элитный уровень) — это единственный элитный балл в списке. Он ищет в вебе и показывает источники рядом с ответом, так что первый проход делается быстро, а второй — легко. Подвох тот, что нашёл Tow Center: из восьми поисковиков он ошибался меньше всех, но всё равно в 37% случаев, когда его просили определить источник новостных отрывков. Это другая задача, чем цитирование научных статей. Pro добавляет переключатель моделей и более глубокие исследовательские прогоны и стоит $20 в месяц, а Max — $200, по данным гайда CloudZero по ценам на 2026 год; есть и бесплатный тариф.
NotebookLM: лучший, когда ответ должен опираться на ваши файлы
NotebookLM на 2-м месте с баллом 73, сильный уровень. Вы загружаете статьи, заметки или расшифровки, и он отвечает только по ним, что сужает пространство для выдуманных фактов. Обратная сторона: он не подскажет, что вы забыли добавить. Бесплатный план допускает 100 блокнотов, 50 источников на блокнот и 50 чатов в день, а платные планы Google AI поднимают эти лимиты (Google Help). Для папки с диссертацией или стопки отчётов это самый подходящий вариант в рейтинге.
OpenEvidence: лучший для врачей, проверяющих литературу
OpenEvidence на 3-м месте: тоже 73 балла и тоже сильный уровень, и это единственный медицинский специалист у вершины. Он отвечает на клинические вопросы по рецензируемым журналам и бесплатен для медицинских специалистов. Данных о точности пока мало. Препринт, в котором тестировали 100 узкоспециальных сценариев из датасета экзаменационных вопросов MedXpertQA, показал точность не выше 34% в быстром поиске и 41% в Deep Consult, а авторы заключили, что экспертный контроль остаётся необходим (medRxiv). Это препринт, и вопросы были сложными. Тем не менее такие инструменты не заменяют клинициста, и никто не должен использовать их вместо врача.
Consensus: лучший для быстрого среза того, что говорят исследования
Consensus на 4-м месте с баллом 60, сильный уровень, в рейтинге 2026 года он поднялся с 6-го места. Он ищет по научным статьям, поэтому на вопрос «да или нет» вы получаете сводку исследований, а не гору веб-страниц. В тесте HKUST он выдавал длинные структурированные сводки примерно с десятью цитатами в каждой. Актуальные тарифы смотрите на странице цен, прежде чем покупать подписку.
Elicit: лучший для извлечения данных из множества статей
Elicit на 5-м месте, поднялся с 8-го, балл 59 (надёжный уровень). Его сильная сторона — извлечение данных: вы собираете таблицу статей и запрашиваете из каждой одни и те же детали, например размер выборки или результат. Бесплатный план Basic ищет по 138 млн статей. Pro стоит $49 в месяц ($588 в год) и добавляет процесс систематического обзора, способный отсеивать до 5 000 статей, а Scale — $169 (цены Elicit). Скачок от бесплатного плана к $49 крутой, а серьёзные функции спрятаны за ним.
Semantic Scholar: лучший бесплатный научный поиск
Semantic Scholar на 6-м месте с баллом 58, в рейтинге 2026 года он опустился с 4-го. Это прежде всего поисковик и лишь потом ассистент, его создал некоммерческий Allen Institute for AI. Он индексирует более 200 млн статей и ничего не стоит (Semantic Scholar). Чата, который думает за вас, здесь нет. Для многих студентов это плюс.
Rayyan: лучший для скрининга в систематических обзорах
Rayyan на 8-м месте с баллом 54. Команды используют его, чтобы отсеивать тысячи заголовков и аннотаций по критериям включения, а AI подсказывает, какие из них, вероятно, релевантны. Бесплатный план включает 3 активных обзора и 2 бесплатных рецензента, а Essential стартует от $4,99 в месяц при годовой оплате (Rayyan). Это инструмент для рабочего процесса, так что не ждите строки вопроса, которая напишет вам ответ.
ResearchRabbit: лучший для картирования области по нескольким исходным статьям
ResearchRabbit поднялся с 16-го места на 9-е, балл 54. Вы начинаете со статей, которым доверяете, а он строит коллекции и карты цитирований связанных работ. Он находит статьи, но не пересказывает их. В паре с инструментом для чтения он оправдывает себя на раннем этапе проекта, когда вы ещё не представляете, как выглядит область.
Scite: лучший для проверки, подтверждают ли утверждение более поздние работы
Scite на 10-м месте с баллом 54. Его Smart Citations показывают, подтверждают ли более поздние работы статью или оспаривают её. Этот контекст скрывает простой подсчёт цитирований. В сравнении HKUST его сводка оказалась самой полной из четырёх, и только он получал полный текст. Поиск и ассистент доступны по платному плану от $20 в месяц при годовой оплате (цены Scite). Попробуйте его, когда утверждение важно настолько, что вы хотите знать, кто его оспаривал.
GPT Researcher: лучший open-source вариант для глубокого веб-исследования
GPT Researcher на 17-м месте с баллом 50 — единственный open-source проект в топ-25. Агент-планировщик формулирует исследовательские вопросы, другие агенты собирают материал, а издатель собирает отчёт с цитатами. Проект распространяется под лицензией Apache-2.0 и имеет около 29 900 звёзд на GitHub (GitHub). Вы запускаете его сами и подключаете свою модель, так что он больше подходит разработчикам и любителям поэкспериментировать, чем студенту с горящим дедлайном.
Ещё три инструмента попали в рейтинг, но пока не получили баллов. Scopus Database (№7) — база данных цитирований, Readwise Reader (№11) — приложение для отложенного чтения, а Atlas.ti (№15) предназначен для качественного анализа. Они полезны, но это инструменты другого типа, поэтому на диаграммах выше их нет.
Как выбрать
Начинайте с того, какими исследованиями вы занимаетесь: это решает большую часть вопроса. Цена идёт второй, а отполированность инструмента — последней.
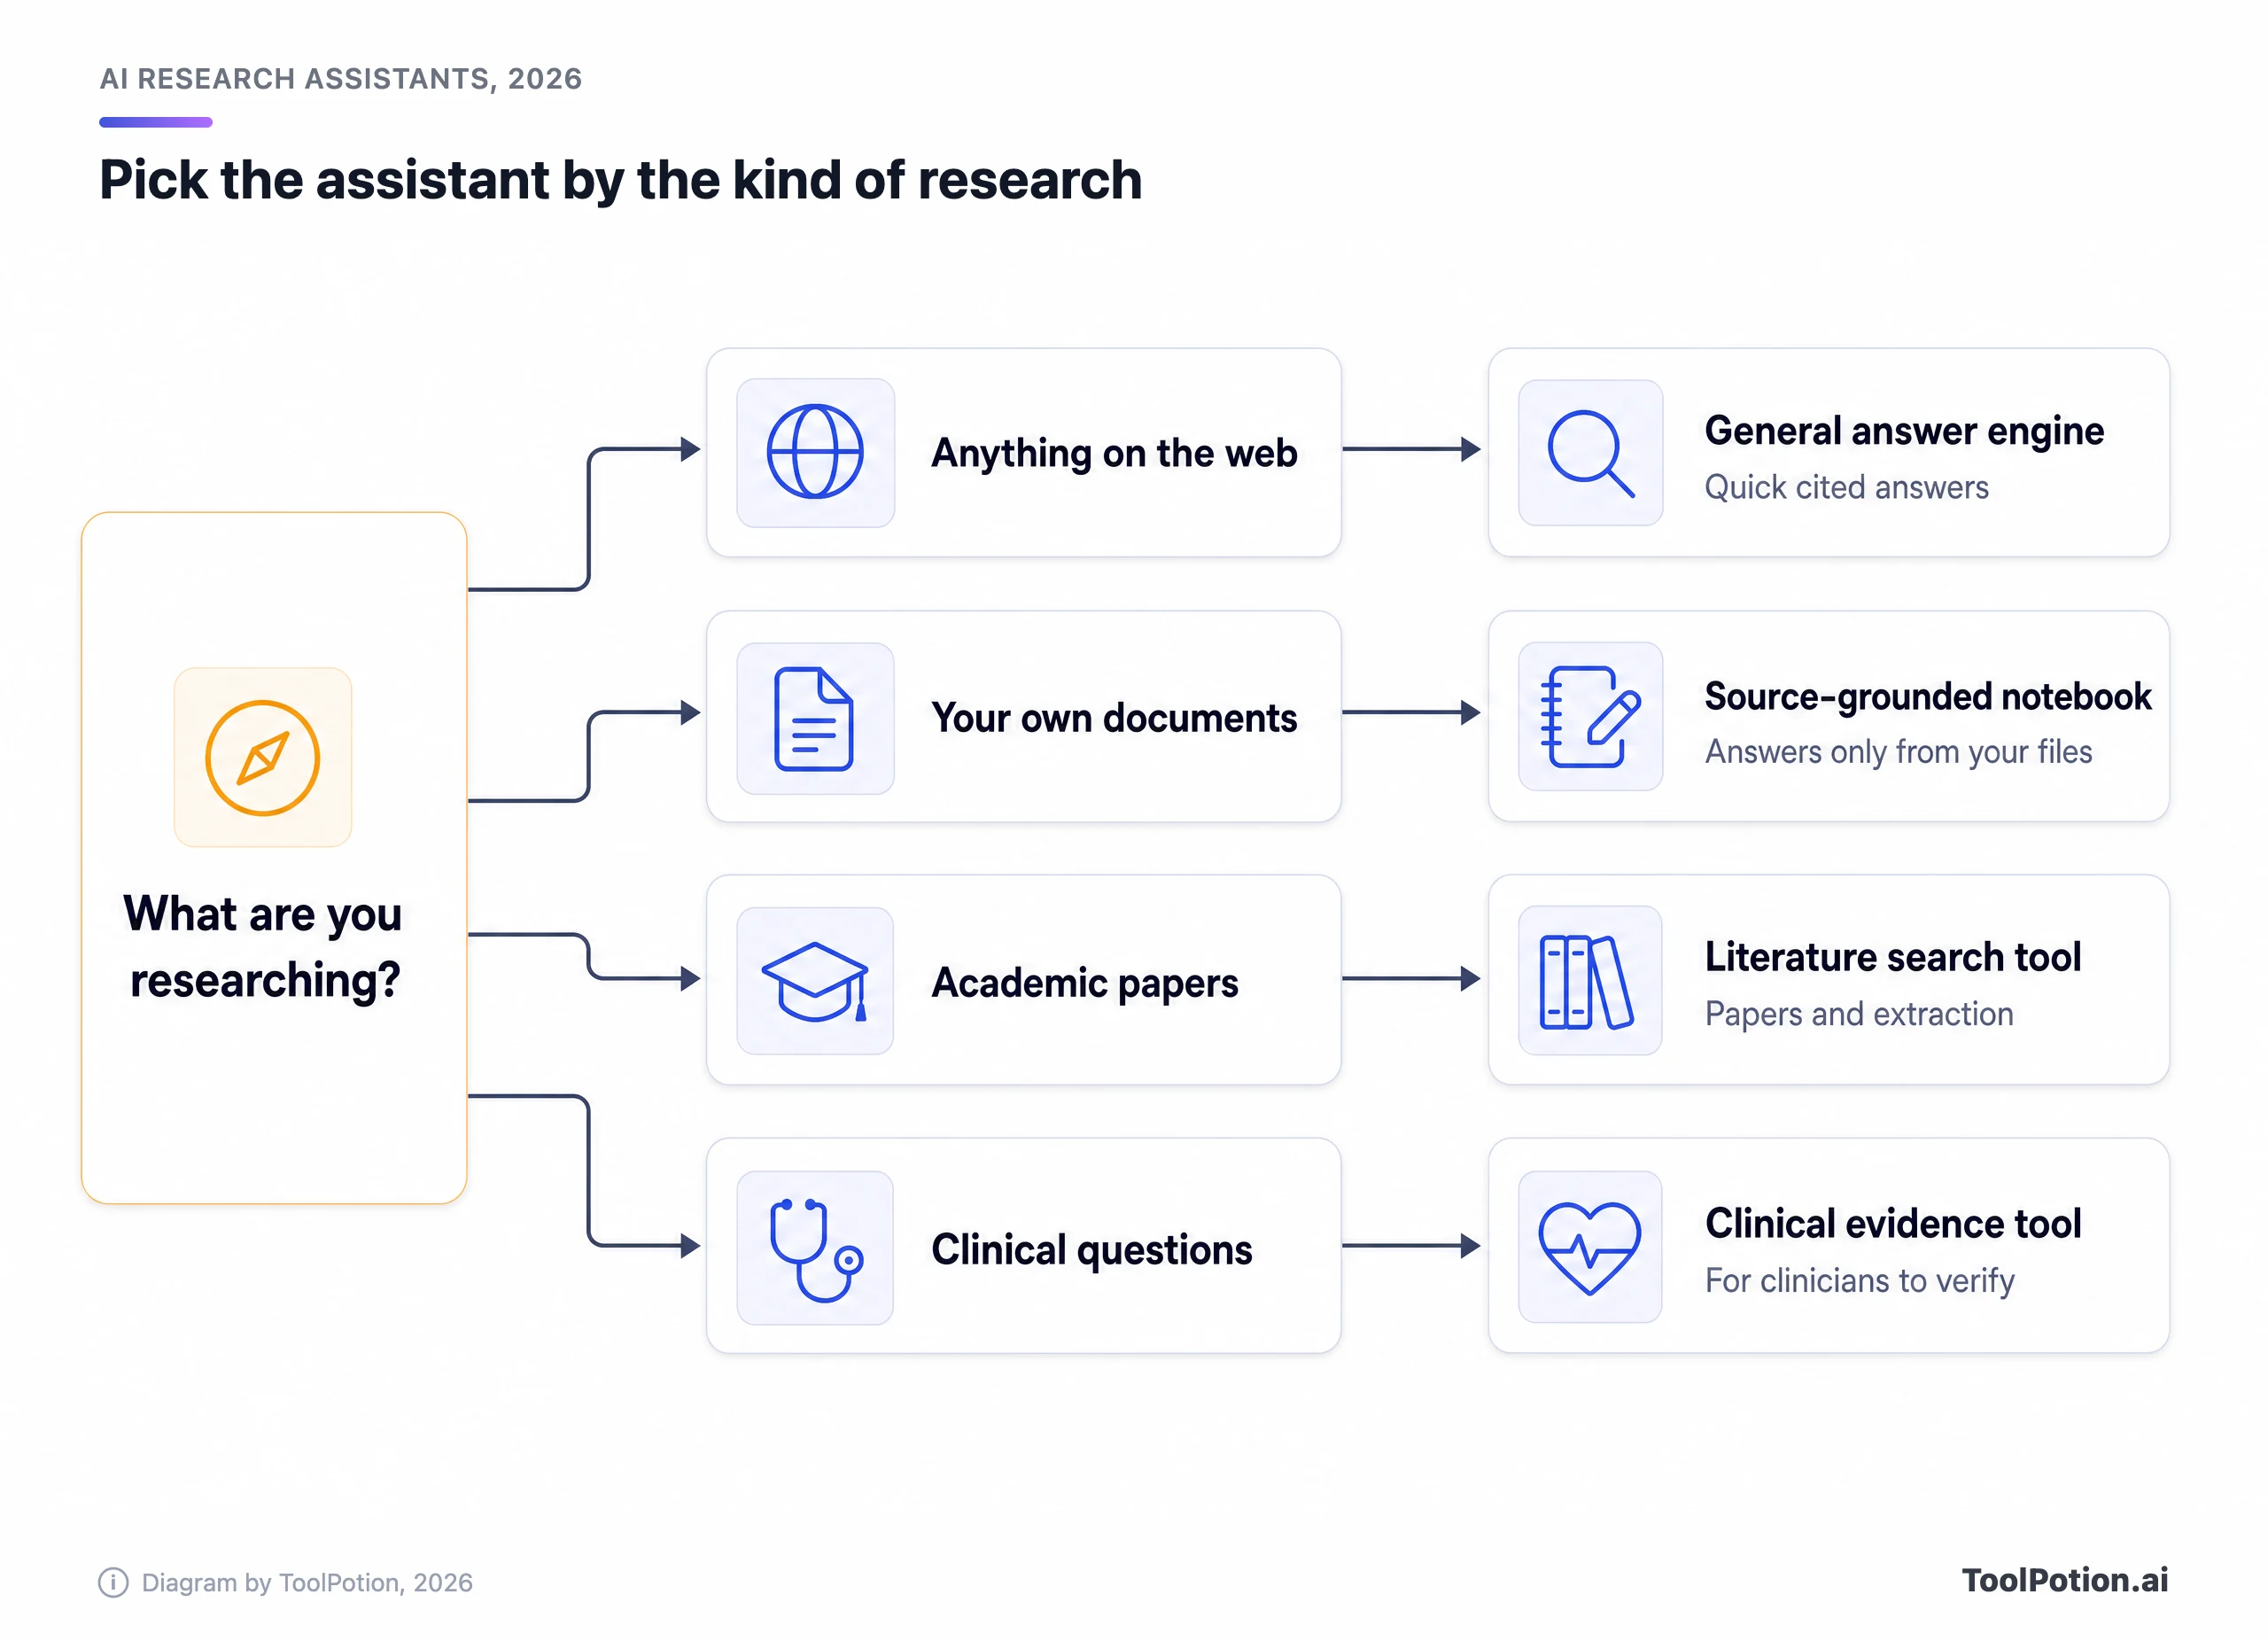
Типичный сложный случай — написание литературного обзора. Используйте Consensus или Semantic Scholar, чтобы найти, что уже есть, ResearchRabbit, чтобы идти по следу цитирований, Elicit, чтобы извлечь данные, и Rayyan, если обзор должен быть формальным. Если вы работаете с фиксированным набором отчётов или интервью, NotebookLM лучше всех остальных. Если нужен быстрый ответ по теме, которую вы можете проверить, подойдёт Perplexity.
Две ситуации требуют особой осторожности. Всё медицинское должно проходить через специалиста, а OpenEvidence предназначен для врачей, не для пациентов. А на узких темах, где цифры Deakin подскочили, нужно открывать каждую ссылку.
Цены важны меньше, чем бесплатные тарифы, поэтому начните с них. В таблице девять лидеров отсортированы по тому, что они ищут и сколько стоят. Если мы не смогли подтвердить цифру, это указано.
О ToolRank
ToolRank — независимый рейтинг AI-инструментов от ToolPotion, и место в нём купить нельзя. В каждом рейтинге для каждой оценённой позиции указаны балл и уровень. Все рейтинги можно посмотреть на странице лидербордов ToolRank.
Ошибки, которые стоят исследователям времени
Самая частая — использовать обычный чат-бот для составления списка литературы. Почему это не работает, объясняют цифры Deakin, а чем это может обернуться, показывает бан на arXiv. Ассистент для исследований, который показывает, откуда взял данные, — более безопасная отправная точка, а тот, что читает только ваши документы, ещё безопаснее.
Вторая — покупать самый дорогой тариф в первый же день. Тариф Max у Perplexity стоит $200 в месяц, а Scale у Elicit — $169, и оба рассчитаны на интенсивное использование. Большинство студентов и аналитиков до этих лимитов не дорастают. Начните с бесплатного тарифа, упритесь в ограничение и платите именно за то, в которое упёрлись.
Третья — принимать краткое содержание за литературный обзор. Инструмент может рассказать, что говорят десять аннотаций. Но он не скажет, какие исследования слабые, какие устарели и чего в наборе не хватает. Это по-прежнему ваша работа, и именно здесь живой читатель зарабатывает своё признание.
Последняя — задавать медицинский вопрос немедицинскому инструменту и верить гладкости ответа. Не делайте этого.
Растущие и новые имена, за которыми стоит следить
Connected Papers поднялся с 15-го места на 13-е благодаря визуальной карте связей между статьями. Несколько более молодых инструментов идут вплотную за топ-25. Ai2 Asta (№27) создан тем же институтом, что и Semantic Scholar, и сочетает понимание литературы с открытиями на основе данных. Keenious (№34) предлагает статьи на основе того, что вы пишете, и встраивается в Word. PapersFlow (№32) предлагает литературные обзоры внутри AI-рабочего пространства, а AnswerThis (№40) отвечает с прямыми цитатами. STORM (№33) — исследовательский прототип Стэнфорда, который составляет статьи в стиле Википедии с источниками.
В полном каталоге AI-ассистентов для исследований есть остальные. Если ваша задача уже, лучше начать со смежных рейтингов, например AI-инструменты для поиска академической литературы, AI-инструменты для исследователей, академическое письмо и цитирование и инструменты для общения с PDF-документами. Или вернитесь наверх к живому лидерборду ассистентов для исследований, чтобы увидеть, кто где стоит.
Часто задаваемые вопросы
Какой AI-ассистент для исследований лучший из бесплатных?
Semantic Scholar полностью бесплатен. Бесплатные тарифы есть и у Perplexity, NotebookLM и Elicit, причём бесплатный план NotebookLM допускает 50 источников на блокнот. Начните с них, прежде чем за что-либо платить.
Могут ли AI-ассистенты для исследований выдумывать цитаты?
Да. Чаще всего это делают обычные чат-боты, как показало исследование Deakin, а инструменты с опорой на источники — реже. Но даже реальную цитату можно привязать к утверждению, которого в статье нет, поэтому каждый раз открывайте источник.
NotebookLM — это то же самое, что Gemini Notebook?
Да. Google переименовала его в 2026 году и заявляет, что он остаётся самостоятельным продуктом.
OpenEvidence бесплатный?
Он бесплатен для медицинских специалистов и оплачивается рекламой. Он создан для медицинских специалистов и не заменяет клиническое суждение врача.
Какой инструмент лучше всего подходит для литературного обзора?
Ни один не закрывает всё сам. Сочетайте инструмент поиска вроде Consensus или Semantic Scholar с ResearchRabbit для построения карты и Elicit для извлечения данных, а для формального систематического обзора добавьте Rayyan.
Как проверить ссылку, сгенерированную AI?
Перейдите к статье и убедитесь, что она существует. Затем убедитесь, что в ней сказано то, что утверждает ответ, и сверьте DOI с сайтом издателя. Десять минут такой проверки лучше отозванного утверждения.