

Инженеры Anthropic однажды позволили главному агенту раздавать короткие поручения вроде «исследуй дефицит полупроводников». Субагенты поняли задачу по-разному: один изучал автомобильный чиповый кризис 2021 года, а двое других дублировали работу по цепочкам поставок 2025 года (Anthropic Engineering). Ничего не упало. Каждый агент сделал что-то разумное с запросом, который можно было прочитать несколькими способами.
Большинство из нас повторяет эту ошибку, когда передаёт работу ChatGPT, Claude, Gemini CLI или одному из терминальных кодинг-агентов. Мы пишем задачу и называем её брифом. Ниже: шесть частей, которые нужны брифу, три переписанных примера, которые можно взять себе, шаблон и таблица типичных провалов. Наша позиция, которую мы будем отстаивать по ходу: сначала пишите строку «готово, когда», вместо «спроси, если не уверен» давайте конкретный список действий и уберите стены из заглавных букв. Цитаты из документации вендоров подтверждают одни наши выводы и ничего не говорят о других, и мы отмечаем, где что.
Задача — это ещё не бриф
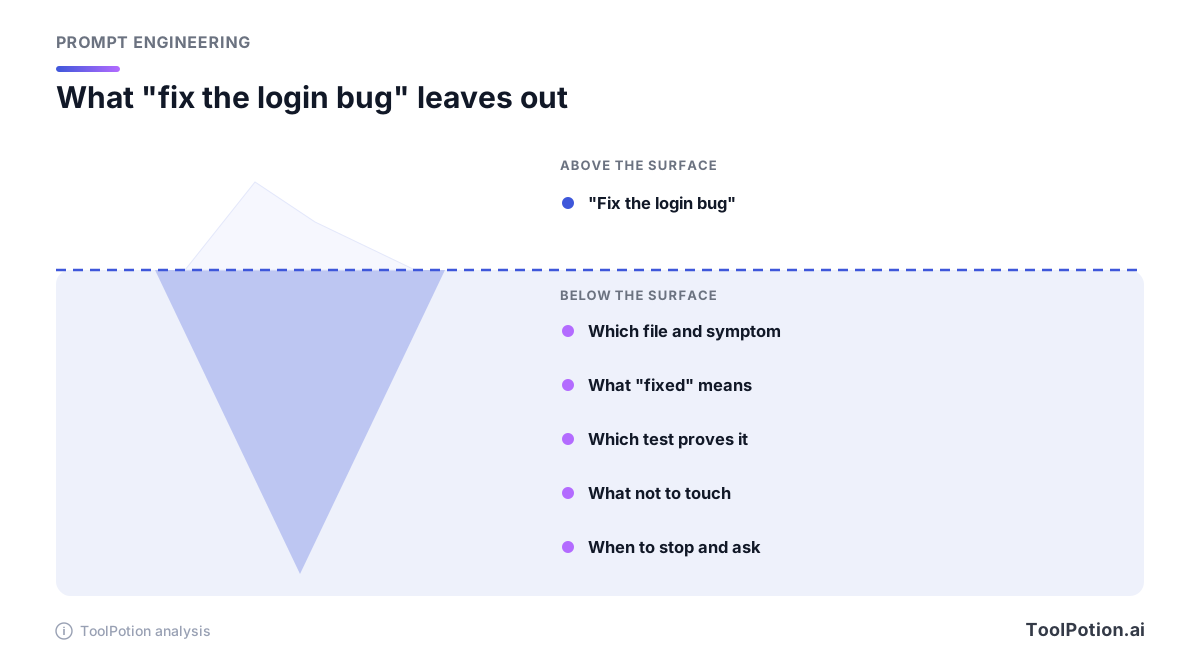
Задача называет занятие. Бриф даёт исполнителю всё, что иначе ему пришлось бы додумывать. В руководстве Anthropic по промптам это описано через нового сотрудника: «Представьте Claude как блестящего, но нового сотрудника, который не знает ваших правил и рабочих процессов» (Anthropic docs). OpenAI проводит похожую границу между типами моделей. Reasoning-модель — «как старший коллега»: ей можно дать цель, и детали она продумает сама. GPT-модель — «как младший коллега», который лучше всего работает «с чёткими инструкциями для конкретного результата» (OpenAI docs).
OpenAI говорит, что reasoning-модели хорошо справляются с общими указаниями. Мы бы не стали на это полагаться, когда работа идёт десятки шагов и имеет побочные эффекты. Старший коллега всё равно не знает, что для вас значит «готово», а ошибка джуниора стоит одного письма. Агент же действует на основе первого неверного прочтения на каждом следующем шаге, как показал главный агент Anthropic.
У Anthropic есть тест, который нам нравится, потому что занимает две минуты: «Покажите промпт коллеге, который почти ничего не знает о задаче, и попросите выполнить его. Если он растеряется, Claude тоже» (Anthropic docs). Если подрядчик не смог бы начать работу по вашему сообщению, не прислав пять вопросов, то агент ответит на эти пять вопросов сам, молча, и вы узнаете об этом по результату.
Сначала напишите строку «готово, когда»
На странице лучших практик Claude Code об этом сказано прямо: «Claude останавливается, когда работа выглядит законченной». Если нет ничего, что можно запустить и что покажет, закончена ли работа, то, как продолжает страница, «на практике тестовым набором становитесь вы, и каждая ошибка остаётся на месте, пока вы случайно её не заметите» (Claude Code docs).
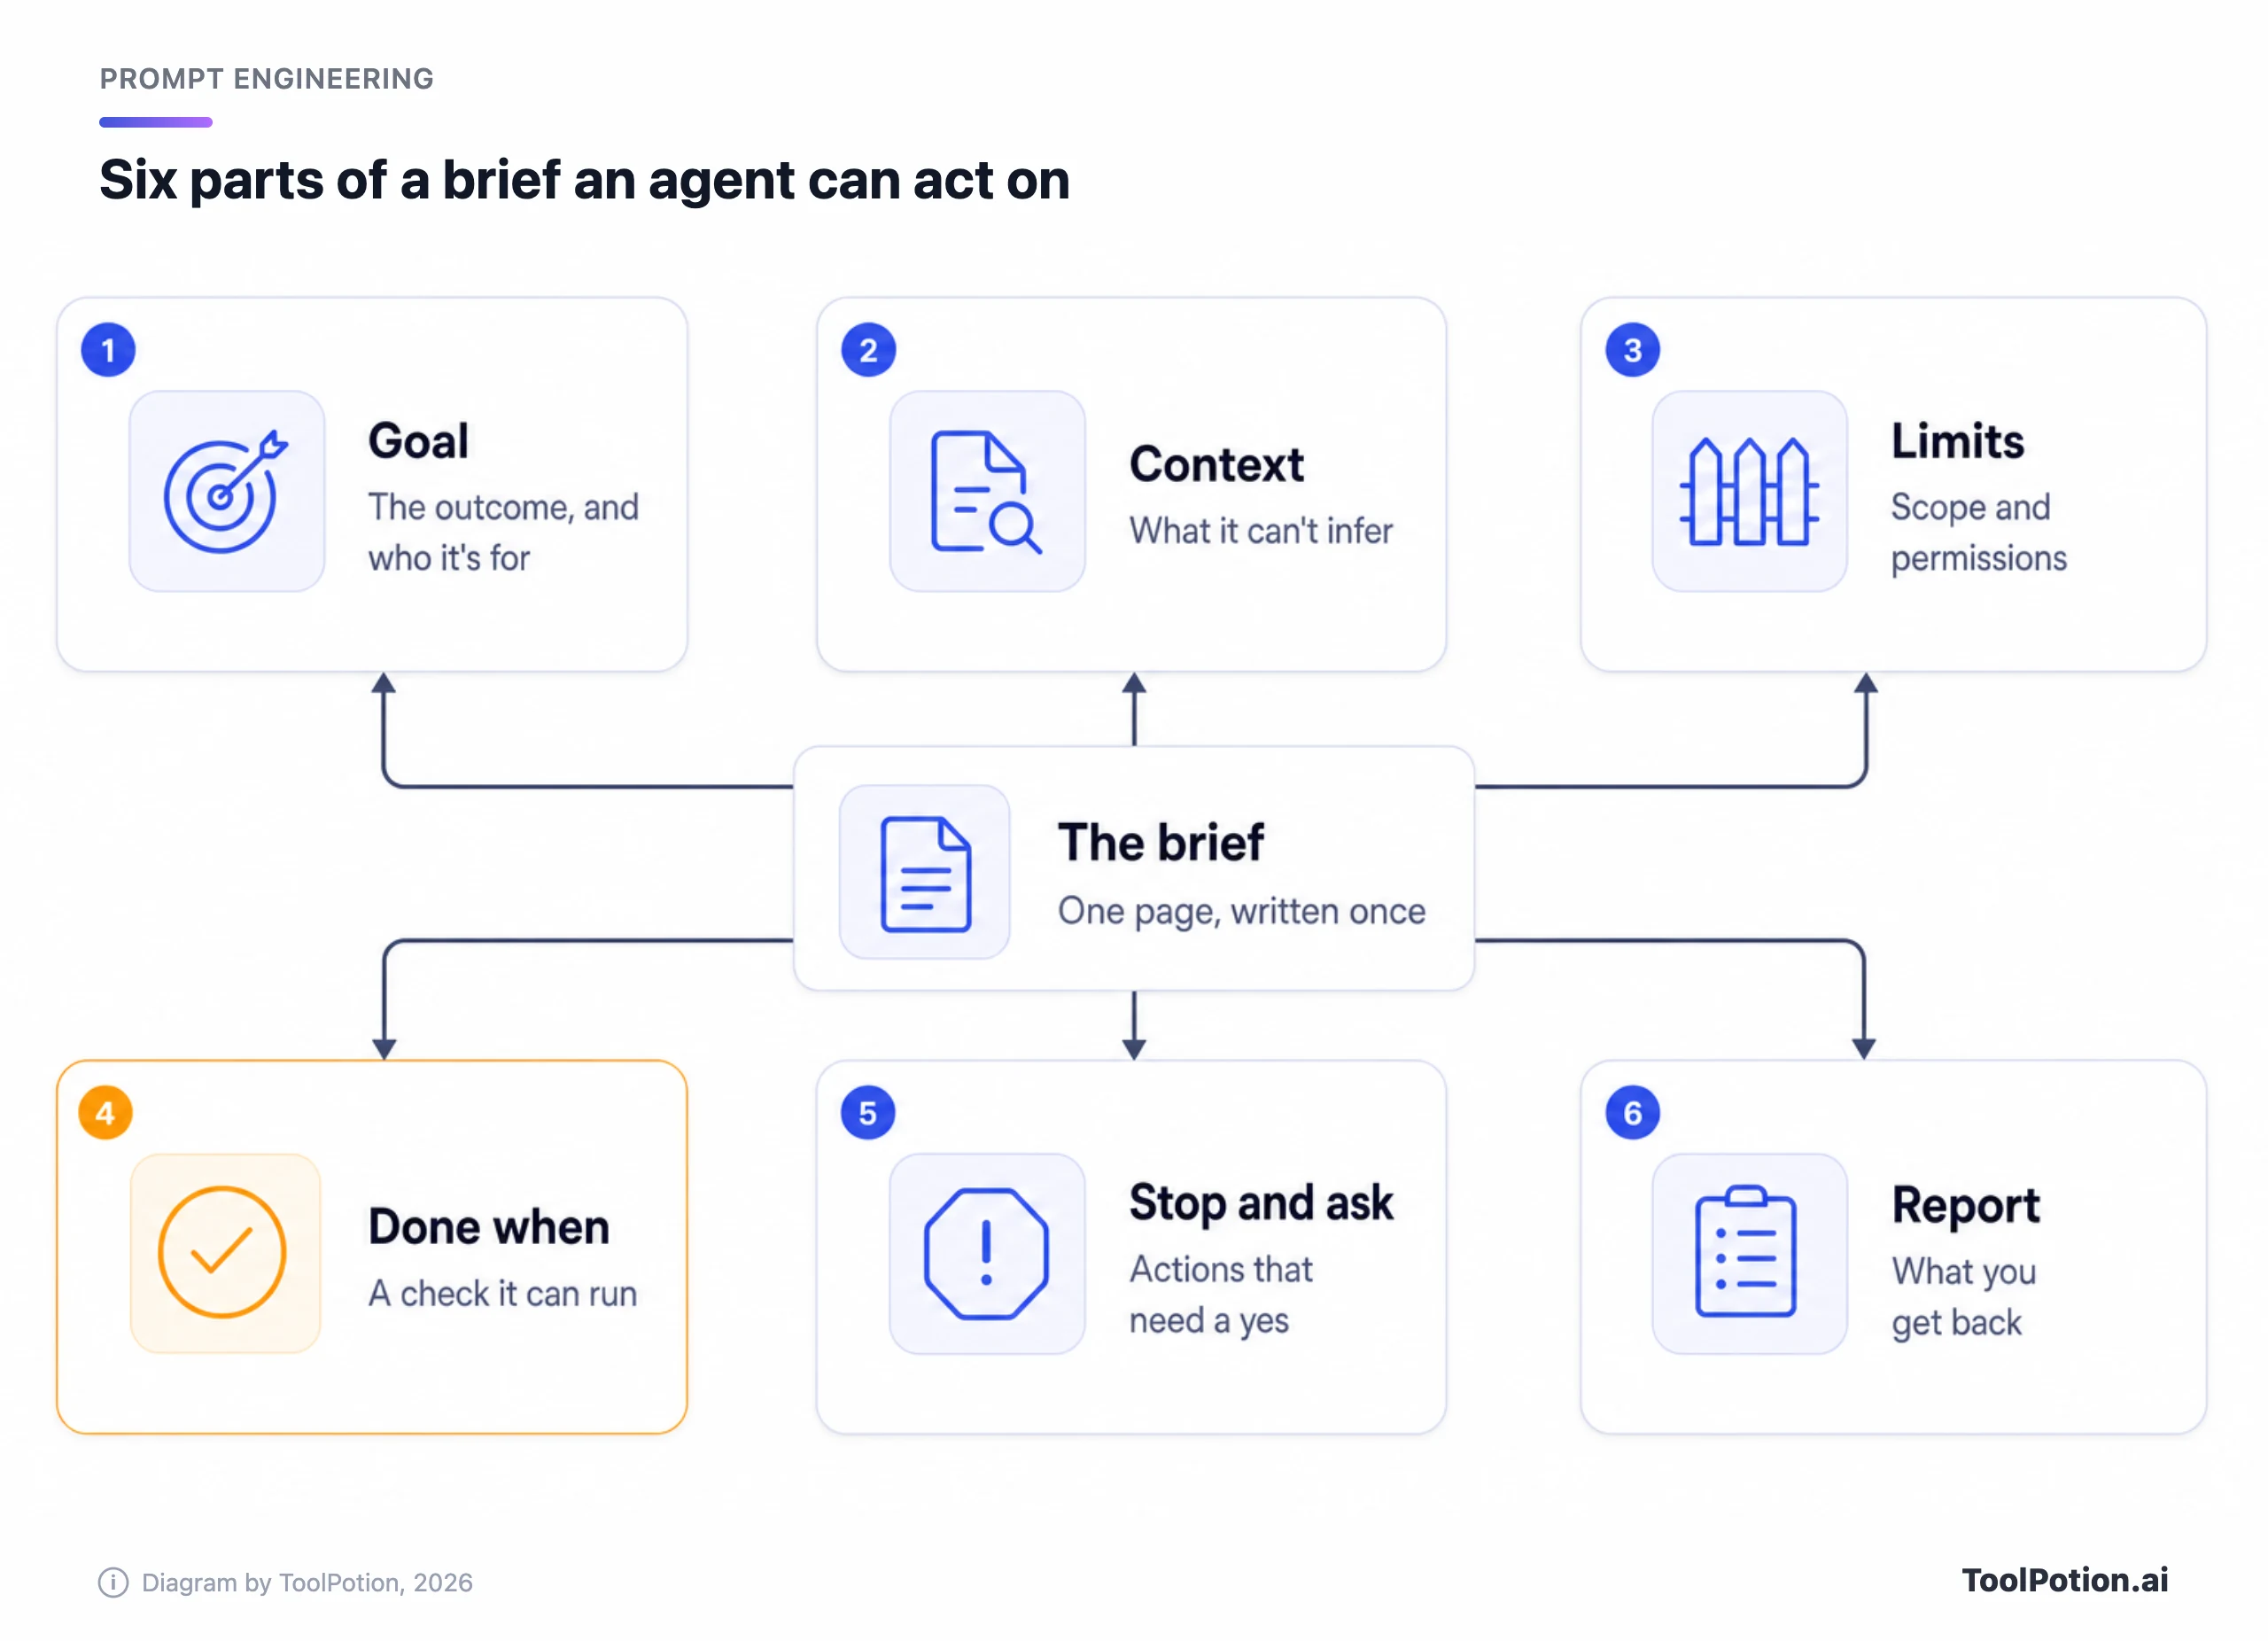
Руководство OpenAI по Codex приходит к той же идее с другой стороны. Оно советует включать в промпт четыре вещи: цель, контекст, ограничения и «Готово, когда» — формулируется как вопрос о том, что должно быть верно до завершения задачи, «например, тесты проходят, поведение изменилось или баг больше не воспроизводится» (OpenAI Codex docs). Два вендора, два продукта, один скелет. Мы добавляем две свои части (остановись и спроси, отчёт) и пишем строку «готово, когда» первой, хотя в готовом брифе она четвёртая: она заставляет вас выяснить, чего вы на самом деле хотите.
Вне кода та же строка работает с другой проверкой. «Таблица из двенадцати вендоров, ссылка на источник рядом с каждой ценой и пометка у каждой цены, которая не опубликована» — это агент может сосчитать. «Тщательное сравнение» он может только почувствовать.
Шесть частей брифа сверху вниз
Цель называет результат и того, кто им пользуется
Одно-два предложения. Скажите, что вы хотите получить в конце и что это будет питать: рекомендацию, которую двое партнёров прочтут за пять минут, исправление, которое уйдёт в релиз в пятницу, шортлист для закупки. Назначение меняет то, что агент включает и что отбрасывает. «Изучи цены» даёт объём. «Порекомендуй один инструмент дешевле $15 за место» даёт решение.
Контекст — всё, что он не найдёт сам
В документации Claude Code есть полезный фильтр: «Мог бы он найти это, прочитав код? Пошёл бы он действительно смотреть? Если оба ответа “да”, не включайте». (Claude Code docs) Остаётся то, что не дошло до репозитория: решение со встречи, аккаунт, которым агент должен пользоваться, инструмент, который вы уже пробовали и отбросили, уровень читателя.
Объясняйте и причину правила. В руководстве Anthropic сказано, что контекст или мотивация за инструкцией «могут дать Claude больше информации о ваших целях и помочь выдать более точные ответы», а собственный пример слабого варианта — голое «NEVER use ellipses» (Anthropic docs).
Ограничения говорят, что входит в задачу, а что под запретом
Агенты склонны делать больше, чем вы просили. В руководстве Anthropic сказано, что у Claude Opus 4.5 и 4.6 есть склонность «создавать лишние файлы, добавлять ненужные абстракции или закладывать гибкость, о которой не просили», и приводится пример инструкции, включающей «Не добавляй функции, не рефакторь код и не делай „улучшений“ сверх того, что просили». (Anthropic docs) Руководство связывает эту привычку именно с этими двумя моделями, так что проверьте на той, которую используете. Саму фразу мы бы взяли в любом случае. Затем добавьте свой список: папки, которых можно касаться, источники, которыми можно пользоваться, аккаунты, в которые заходить нельзя.
Руководство Google по Gemini включает оценку рисков в число настроек, которыми управляет промпт агента, и говорит, что можно явно разделить малорискованные исследовательские действия (чтение) и высокорискованные изменения состояния (запись) (Google AI docs). Полезно именно это разделение. Чтению и запуску тестов разрешение не нужно; удалению, отправке и оплате нужно.
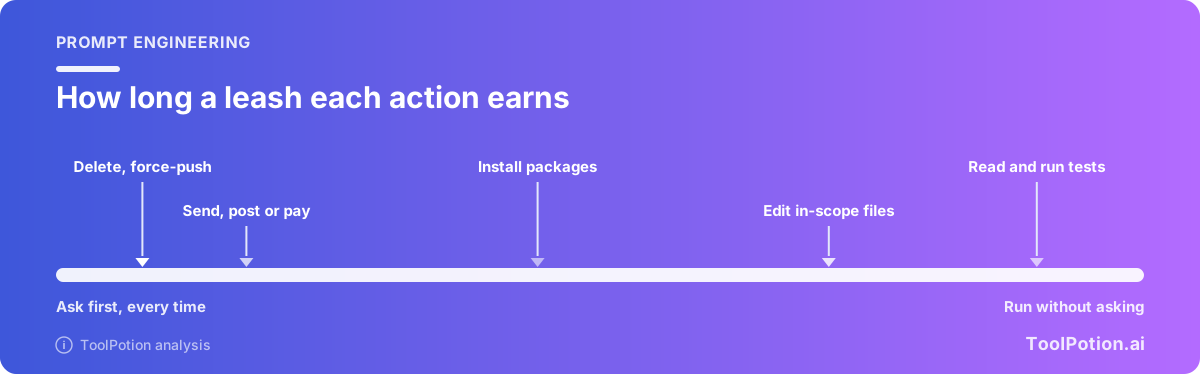
Оговорка, прежде чем вы начнёте на всё это опираться. Слова в брифе — это просьбы. Песочница, токен только для чтения или правило доступа — это принуждение, и одно другое не заменяет. Наше руководство по изоляции ИИ-агентов посвящено стороне принуждения; эта статья — только о том, что вы пишете.
«Готово, когда» — это проверка, которую можно запустить
Назовите команду, число или файл. «Тесты проходят» — это начало. «pnpm test проходит, а новый тест доказывает, что сто первый запрос за минуту получает 429» — это проверка. Для исследования укажите, сколько элементов, какие поля и что писать, если поле найти не удалось. Если проверка может провалиться, скажите агенту, что делать дальше, и ограничьте число попыток. В руководстве Google отмечено: «Высокая настойчивость повышает шансы на успех, но рискует более высокими затратами токенов или циклами», поэтому «повтори упавший тест дважды, затем остановись и сообщи» — лучше, чем молчание (Google AI docs).
«Остановись и спроси» — это список действий, а не настроение
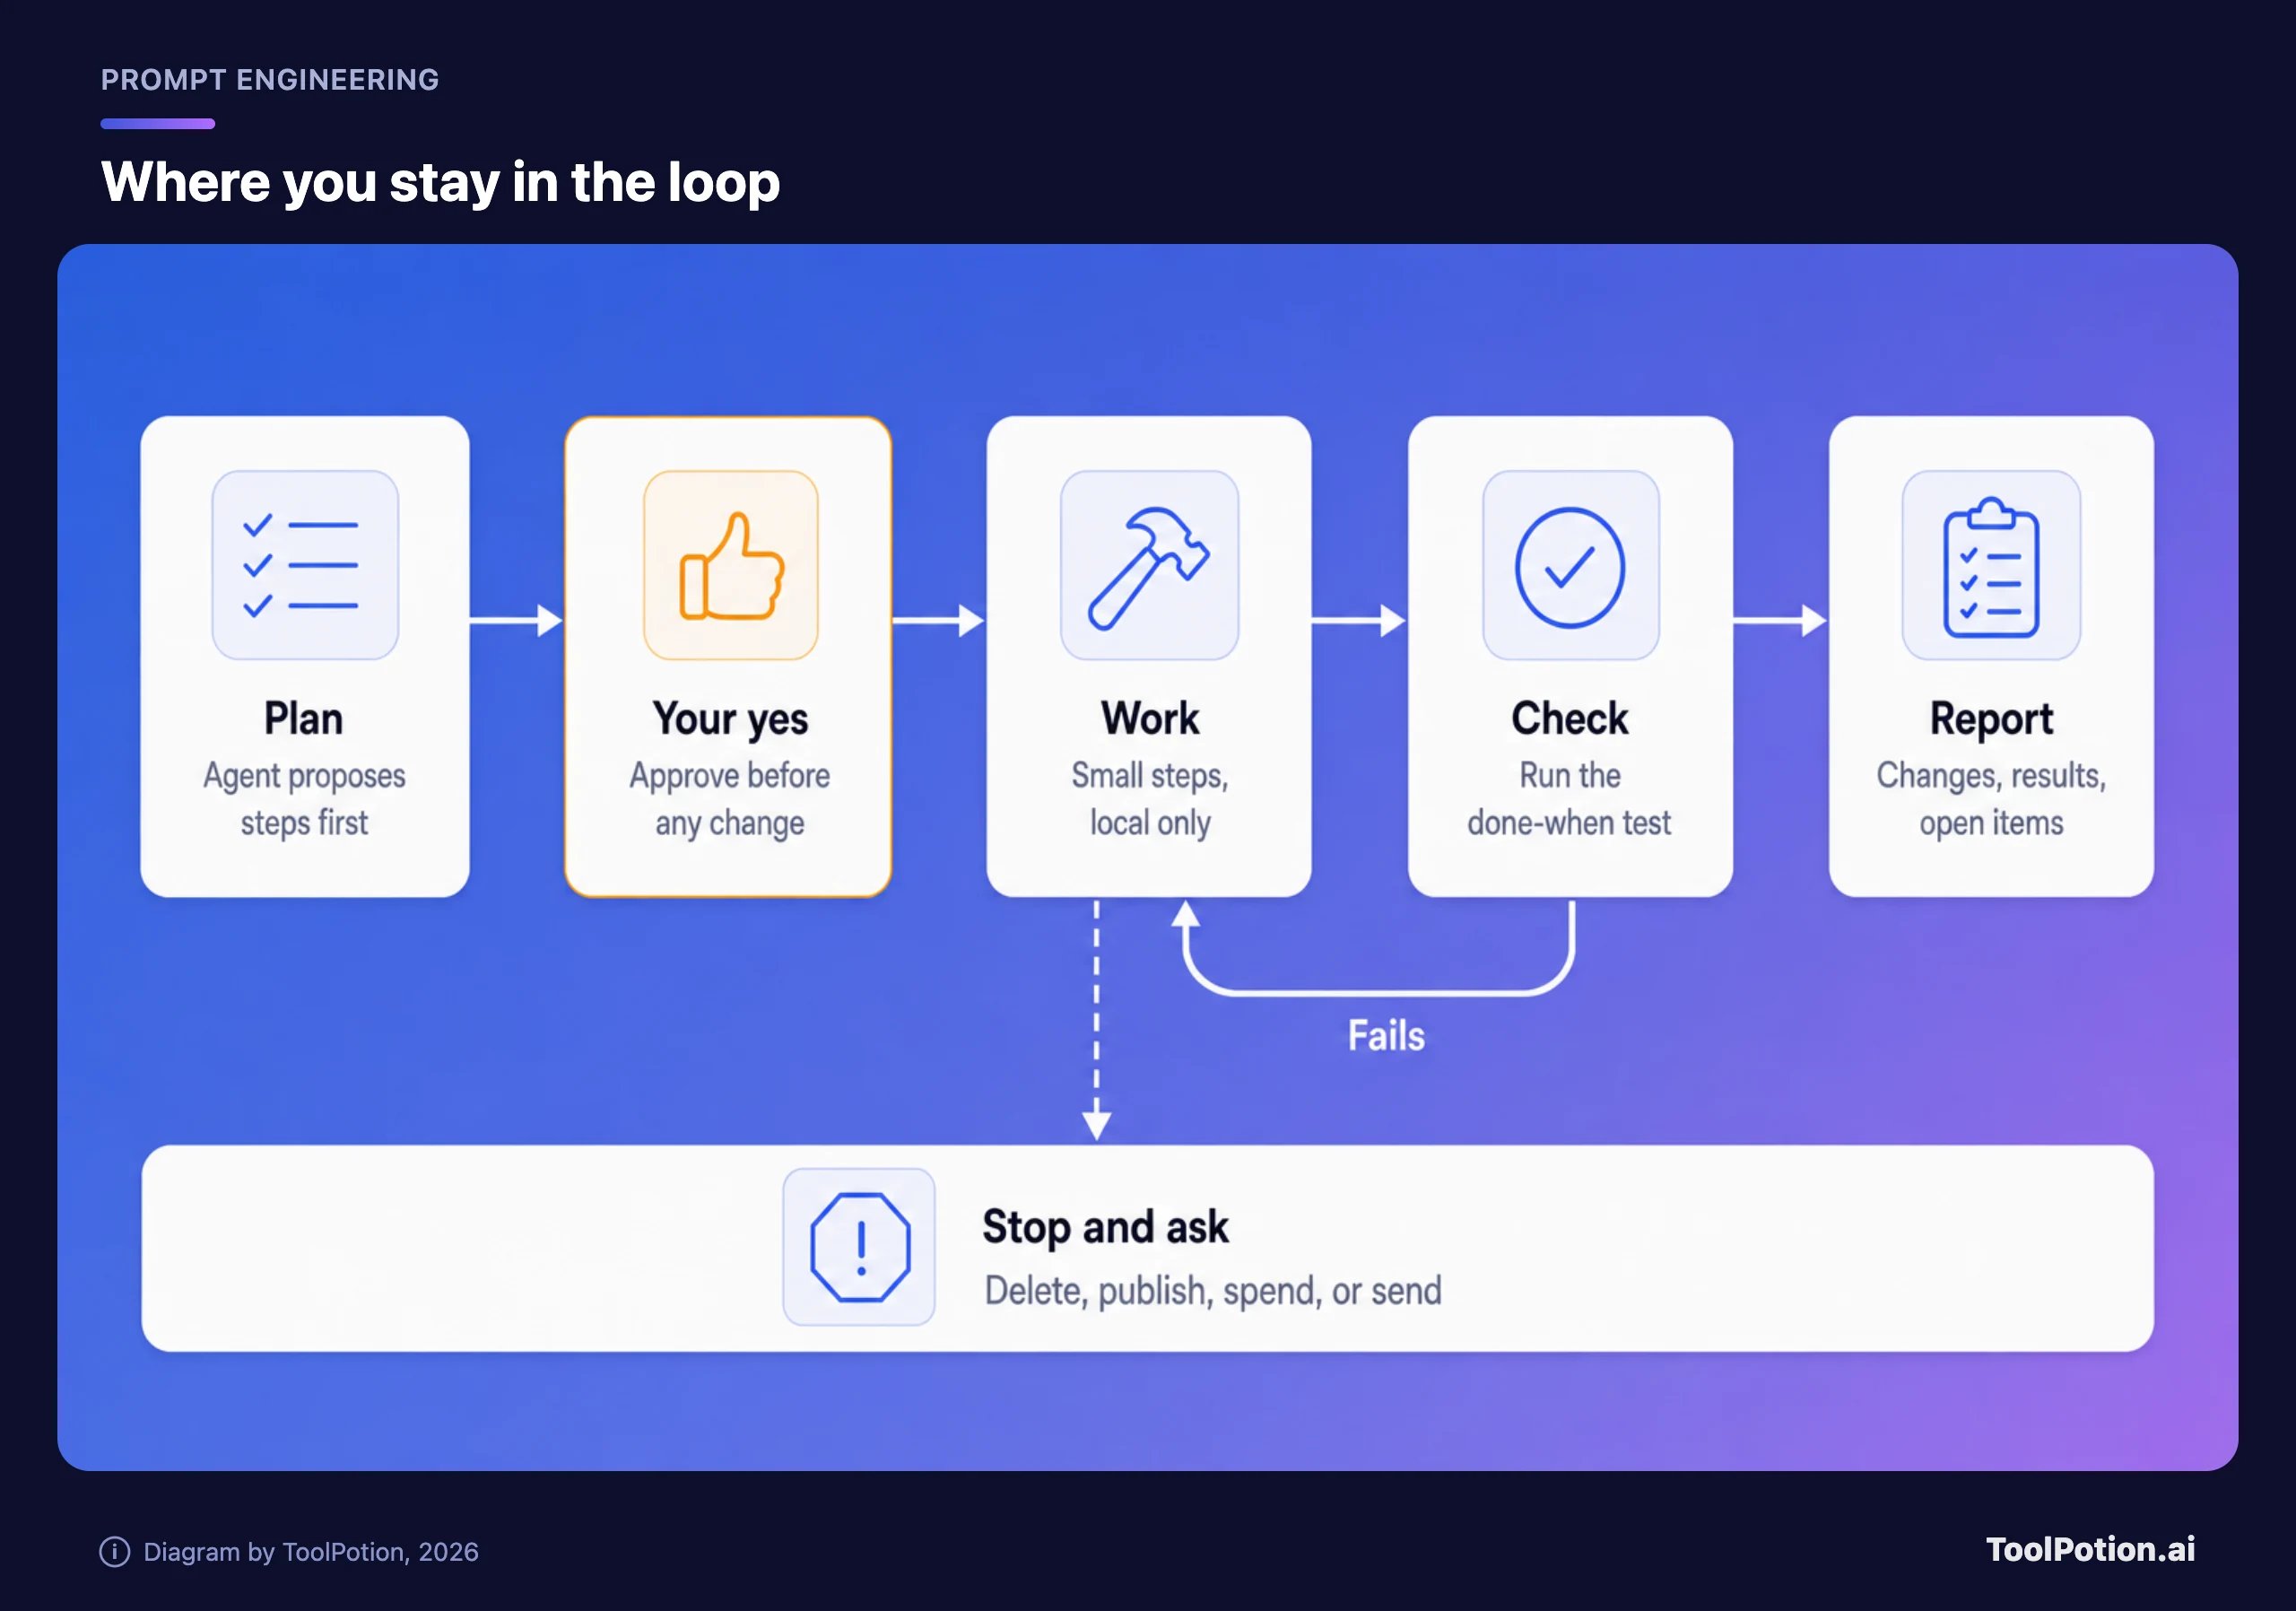
«Спроси меня, если не уверен» заставляет агента принимать решение на основе суждения, а увлечённый агент редко в чём-то не уверен. Составьте вместо этого список действий. В руководстве Anthropic есть пример промпта именно для этого, написанный для Claude Opus 4.6: для действий, «которые трудно отменить, затрагивают общие системы или могут быть разрушительными, спросите пользователя, прежде чем продолжать», а среди примеров — удаление файлов или веток, git push --force и отправка сообщений (Anthropic docs). Список — то, что мы бы скопировали, какой бы моделью вы ни пользовались.
В эссе Anthropic о проектировании агентов описан этот паттерн: агенты «могут затем приостанавливаться для обратной связи от человека на контрольных точках или при столкновении с препятствиями» (Anthropic Engineering). Пусть первой контрольной точкой будет план. Попросите шаги до любых изменений, прочитайте их, затем скажите «вперёд». Это стоит одного круга туда-обратно, и, по нашему мнению, дешевле контрольной точки не найти.
Отчёт — место, где вы говорите, что должно вернуться
Попросите перечислить внесённые изменения, выполненные проверки с результатами, всё, что агент предположил, и всё, что решил не делать. Последний пункт люди забывают чаще всего. Именно там агент сообщает, что пропустил миграцию, потому что вы сказали не трогать схему.
Три брифа: до и после
Каждое из переписанных ниже заданий занимает примерно 120–150 слов. Это длиннее среднего промпта и короче, чем принято бояться. Все три брифа — наши выдуманные примеры: задачи, инструменты и цифры придуманы для иллюстрации, и ни один не взят у вендора или из реального проекта.
Исследовательский агент (выдуманный пример)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.Кодинг-агент (выдуманный пример)
В документации Claude Code есть собственный пример «до и после»: «добавь виджет календаря» превращается в просьбу следовать шаблону существующего файла виджета и «не добавлять новых библиотек» (Claude Code docs). Вот тот же приём на задаче покрупнее, написанный для Claude Code или Codex.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.Агент для почты (выдуманный пример)
Этот бриф подойдёт для любого ассистента, которого вы подпускаете к почте, — для таких задач продаются агентские продукты вроде Manus и Claude Cowork. Почта — то место, где «наведи порядок» легко превращается в «удалил».
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.Строка «Цель» между «до» и «после» почти не меняется. Весь вес — в последних четырёх строках: проверка, остановка, отчёт и ограничение, которое говорит, чего агенту нельзя делать никогда.
Шаблон для вставки
Удаляйте любую неподходящую строку, но делайте это осознанно.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
Оцените по нему собственный черновик. Восемь вопросов с ответом «да» или «нет», тридцать секунд.
Как проваливаются брифы и что бы мы изменили
| Провал | Что вы видите | Что изменить |
|---|---|---|
| Цель — это занятие | Страницы текста, но нет решения | Укажите, что питает результат |
| Нет «готово, когда» | Останавливается на «выглядит готовым» или не останавливается вовсе | Добавьте проверку, которую можно запустить, и лимит повторов |
| Рамки не заданы | Лишние файлы, рефакторинг, непрошеные улучшения | Перечислите, что под запретом |
| Предупреждения без причин | Стена строк NEVER, которую игнорируют или применяют слишком широко | Добавьте причину одной фразой |
| Одобрение только подразумевается | Удаляет, пушит или отправляет по собственному суждению | Назовите действия и сначала попросите план |
| Накапливаются правки | Инструкции противоречат друг другу | Перепишите бриф и начните заново |
О двух пунктах стоит сказать подробнее. Первый — куча заглавных букв. Мы сомневаемся, что усиление акцента когда-либо компенсировало отсутствие причины, и руководство Anthropic указывает туда же: голое «NEVER use ellipses» там приведено как слабый пример. В документации Claude Code добавлено: «Фразы вроде “думай шаг за шагом” или “будь тщательным” — обычный текст промпта, а не ключевые слова» (Claude Code docs). Поэтому мы бы убрали шаблонное «будь тщательным». Руководство Anthropic при этом рекомендует задавать Claude роль, пусть даже одним предложением, так что запрещать её мы не станем; мы бы пропустили лишь персону «эксперта мирового уровня», потому что шесть частей брифа и так говорят агенту больше, чем титул.
Второй — обратная проблема. Пример агентского промпта в руководстве OpenAI (показан для модели gpt-6-astra, как образец, а не как правило) велит модели «продолжать, пока запрос пользователя не будет полностью решён» и говорит «Не останавливайся, выполнив только часть запроса» (OpenAI docs). Для задачи с чёткой финишной чертой это разумно, а для задачи без неё — ловушка. Настойчивый агент с расплывчатой целью может бесконечно тратить токены в цикле; о высокой настойчивости говорит и руководство Google. В эссе Anthropic сказано, что для сохранения контроля обычно включают «условия остановки (например, максимальное число итераций)» (Anthropic Engineering).
Ещё одну привычку мы бы бросили: вставлять бриф в тред, где уже накопилось десять правок. У агента теперь одиннадцать наборов инструкций и никакого способа расставить их по приоритету.
Понаблюдайте первую минуту, потом перепишите
В документации Claude Code советуют: «Следите первую минуту, нажмите Esc, как только Claude начнёт уходить в сторону, а после двух неудачных поправок запустите /clear и напишите промпт получше вместо третьей поправки» (Claude Code docs). Мы бы применили это к любому агенту: первый план и первые действия показывают, прочитан ли ваш бриф так, как вы задумали.
Если вы пока не можете написать бриф, пусть агент возьмёт у вас интервью. В документации Claude Code предлагают промпт вроде «Интервьюируй меня, пока не сможешь написать спецификацию, затем запиши её в SPEC.md», а руководство по Codex советует попросить сначала задать вам вопросы и «оспорить ваши предположения» (Claude Code docs и OpenAI Codex docs). Затем начните новую сессию с готовой спецификации.
Брифы, которые сработали дважды, заслуживают постоянного места. Постоянные правила (как запускать тесты, что никогда не трогать) кладите в файл AGENTS.md или CLAUDE.md; OpenAI говорит: «Короткий и точный AGENTS.md полезнее длинного файла, набитого расплывчатыми правилами» (OpenAI Codex docs). Процедуру, которую вы повторяете, можно превратить в skill, об этом мы пишем в статье От промптов к skills. Что вообще загружать в сессию — тема нашего материала о context engineering, а привычки, которые сохраняют работоспособность промптов при выходе новых моделей, описаны в Prompt Patterns That Survive Model Updates. Инструменты, построенные вокруг такого делегирования, смотрите в наших подборках: ИИ-агенты, задачи по созданию агентов и инструменты для prompt engineering.
Частые вопросы
Какой длины должен быть бриф?
Достаточной, чтобы вместить шесть частей, — для большинства задач это от 100 до 200 слов. Постоянные предпочтения относятся в файл правил, чтобы каждый бриф описывал только текущую задачу. Если бриф вырос больше чем на страницу, задачу, скорее всего, стоит разделить надвое.
Нужны ли ChatGPT, Claude и Gemini разные брифы?
Скелет один. Четыре части из руководства OpenAI по Codex, совет Anthropic давать контекст и спрашивать перед рискованными действиями и измерения агента у Google (обработка неоднозначности, оценка рисков, настойчивость) описывают один и тот же набор потребностей разными словами. Оформление немного различается: руководство Google рекомендует XML-подобные теги или заголовки Markdown и говорит «Выберите один формат и используйте его последовательно» (Google AI docs). Какой ассистент лучше подходит для какой работы — отдельный вопрос, который мы разбираем в статье ChatGPT vs Claude vs Gemini в 2026.
Что сказать агенту делать, если он не уверен?
Дайте ему правило, которое можно применить. «Считай допустимым всё обратимое и перечисли это в отчёте; всё необратимое сначала согласуй» работает лучше, чем «спроси, если не уверен». В руководстве Google тот же выбор сформулирован как вопрос о том, когда модель может делать допущения, а когда обязана остановиться и запросить уточнение или разрешение.
Достаточно ли хорошего брифа, чтобы агент был безопасным?
Нет. Бриф уменьшает число ошибок, но не предотвращает ни одной. Anthropic рекомендует «обширное тестирование в изолированных средах вместе с подходящими ограничителями» (Anthropic Engineering), а наше руководство по изоляции охватывает права доступа и журналы аудита.
Агент всё равно ошибся. Что делать?
Найдите первый шаг, на котором он свернул не туда, и посмотрите, что бриф говорил об этом шаге. Добавьте одну строку, которая предотвратила бы ошибку, и перезапустите в новой сессии.