

Ваши результаты посредственны, потому что входные данные раздуты, устарели или неправильно упорядочены. Не потому что вы неправильно сформулировали запрос. Собственная документация Anthropic прямо об этом говорит: «больше контекста — не значит автоматически лучше. По мере роста количества токенов точность и recall ухудшаются — это явление называется контекстным гниением» (Claude Platform docs). Контекстная инженерия решает эту проблему: Anthropic определяет её как курирование «оптимального набора токенов (информации) во время вывода LLM» (Anthropic Engineering).
Цифры безжалостны к максималистской привычке. В тесте NoLiMa 11 из 13 моделей, заявляющих контекст от 128K токенов, показали менее половины своего результата при коротком контексте уже при 32K токенах (arXiv:2502.05167).
Это руководство для тех, кто использует ChatGPT, Claude, Gemini и Copilot, а не создаёт агентские фреймворки: какую настройку менять, в каком продукте и чего это стоит.
Контекстная инженерия пришла на смену магии промптов
Если ваши результаты посредственны, формулировка запроса редко бывает проблемой. Контекстная инженерия — это практика, которая это исправила: Anthropic определяет её как «набор стратегий по курированию и поддержанию оптимального набора токенов (информации) во время вывода LLM, включая всю остальную информацию, которая может там оказаться помимо запросов», и называет её естественным развитием промпт-инженерии (Anthropic Engineering). Вопрос сместился с «как это сформулировать?» к «какая конфигурация контекста с наибольшей вероятностью вызовет желаемое поведение модели?»
От «как это сформулировать?» к «что должно быть в окне?»
Формулировка по-прежнему важна на краях. Просто она больше не является точкой приложения усилий. Идеально сформулированный вопрос при раздутом, наполовину нерелевантном окне проигрывает грубому вопросу при чистом окне — и остальная часть этой статьи в основном служит доказательством этого утверждения.
Большинство из 212 инструментов промпт-инженерии, которые мы отслеживаем, оптимизируют формулировку вводимого предложения. Почти ни один не затрагивает пять других вещей, которые делят с ним окно.
Пять входных данных, которыми вы реально управляете
Каждый запрос собирает окно из частей, которые вы можете видеть и изменять:
- Системные инструкции: поле инструкций в пользовательском GPT, описание Claude Project или файл CLAUDE.md в вашем репозитории.
- Память: то, что продукт сохранил о вас между сессиями — как правило, без отображения полного текста.
- Прикреплённые документы и качество их парсинга — это наименее оценённая переменная во всём стеке.
- Извлечённые чанки, если инструмент выполняет retrieval, плюс всё, что ретривер посчитал релевантным.
- Предыдущие обмены в разговоре, включая каждый тупик, который вы бросили двадцать сообщений назад.
- Определения инструментов, которые расходуют токены вне зависимости от того, вызывается ли инструмент.
Их шесть, и вы управляете всеми из интерфейса продукта. Никакого фреймворка, никакого API-ключа.
Это руководство по входным данным, написанное для тех, кто использует ChatGPT, Claude, Gemini и Copilot, а не строит агентские системы поверх них. Какую настройку менять, в каком продукте и что говорят цифры 2026 года о её ценности.
Объяснение окна контекста ИИ: заявленный размер против реально используемого
Цифра в спецификации — это ограничение хранилища, а не гарантия производительности. Модель, принимающая миллион токенов, с удовольствием их примет, а затем ответит хуже, чем если бы у неё было 3 000. Воспринимайте заявленное окно как потолок комнаты, а не как размер стола, за которым можно работать.
Что реально расходует окно
Больше, чем вы думаете. Каждая часть API-запроса занимает один и тот же бюджет: системный промпт, каждое сообщение в треде включая результаты инструментов, изображения и PDF, сами определения инструментов и собственный вывод модели включая расширенное мышление (Claude Platform docs). Кэшированные префиксы тоже занимают окно. Кэширование промптов меняет то, что вы платите за эти токены, а не то, считаются ли они.
Поэтому чат, который кажется коротким, может нести 40 000 токенов прикреплённого PDF, схем инструментов и предыдущих рассуждений, которые вы никогда не видите. Именно это страницы энциклопедии обходят стороной.
Обрыв на 32K, о котором не пишут в спецификациях
Бенчмарк NoLiMa убрал буквальное пересечение слов между вопросом и ответом, скрытым в стоге сена, а затем запустил 13 моделей, все из которых заявляют контекст от 128K или более. До 1K токенов они справлялись нормально. При 32K у 11 из 13 результат упал ниже половины собственного базового уровня при коротком контексте, а Llama 3.1 70B упала с 94,3% до 42,7% (NoLiMa, arXiv:2502.05167). Этот препринт вышел в феврале 2025 года, поэтому он предшествует всем моделям из таблицы ниже. Характер находки сохранился в более новых работах, но конкретные проценты — это устаревающие данные, а не актуальный рейтинг.
Каковы сегодняшние окна на самом деле (данные 2026 года)
| Модель | Окно контекста | Максимальный вывод | Изображений/страниц PDF на запрос |
|---|---|---|---|
| Claude Fable 5.1, Opus 5, Sonnet 5 (и Mythos 5.1, Opus 4.8/4.7/4.6, Sonnet 4.6) | 1M токенов, стандартная цена по умолчанию | 128k | 600 |
| Claude Sonnet 4.5 и старше | 200k | — | 100 |
| OpenAI GPT-5.4 | 1 050 000 токенов | 128 000 | — |
Anthropic предоставляет это окно в 1M без бета-заголовка и без наценки (Claude Platform docs). У OpenAI оно номинально больше и ценится по-другому: превысьте 272K входных токенов в GPT-5.4 — и вся сессия будет тарифицироваться по 2x для входящих и 1,5x для исходящих (OpenAI API docs). Там раздутость — это статья расходов в счёте, а не только налог на качество.
При сравнении ёмкостей у разных вендоров проверяйте собственную страницу спецификаций модели, а не обзоры: только в 2026 году окна менялись дважды, и устаревших таблиц повсюду хватает. Наш каталог 324 моделей ИИ — отправная точка для поиска нужной страницы.
Контекстное гниение: почему добавление большего обычно ухудшает результаты
Деградация имеет механизм, и он не таинственен. Трансформер должен моделировать n² попарных связей по n токенам, поэтому каждый добавляемый токен заставляет все остальные немного сильнее конкурировать за внимание модели. Инженерная команда Anthropic называет это конечным бюджетом внимания, аналогичным рабочей памяти человека, и говорит, что внимание «растягивается тонко» по мере роста контекста. Их рекомендация прямолинейна: найти «наименьший возможный набор высокосигнальных токенов, максимизирующих вероятность желаемого результата».
Проблема бюджета внимания
Собственная документация Anthropic признаёт это, не пытаясь приукрасить. «Больше контекста — не значит автоматически лучше», — говорит документация платформы. «По мере роста количества токенов точность и recall ухудшаются — это явление называется контекстным гниением.» Это вендор, продающий вам окно на 1M токенов, говорящий вам его не заполнять.
Тот же вопрос, тот же ответ, в 375 раз больше шума
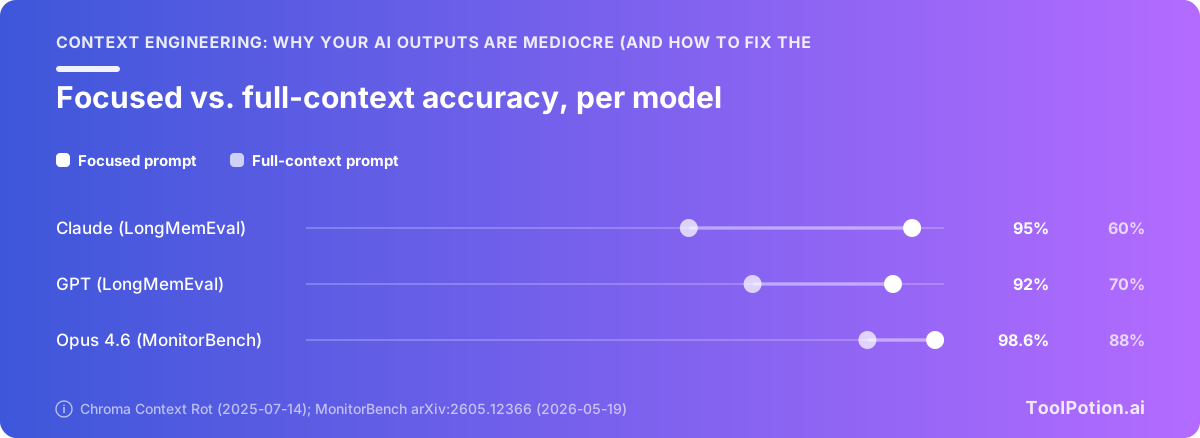
Chroma протестировала 18 моделей, включая GPT-4.1, Claude 4, Gemini 2.5 и Qwen3, и обнаружила, что надёжность падает при более длинных входных данных даже в тривиальных задачах — таких как retrieval и воспроизведение слов (Chroma). Запуск LongMemEval — тот, который стоит запомнить. Каждое семейство моделей показало значительно лучшие результаты на сфокусированных промптах примерно в 300 токенов, содержащих только релевантные обмены, чем на полных промптах около 113K токенов, несущих всю историю разговора. При этом модели Claude показали наибольший разрыв. Тот же вопрос. Тот же ответ, присутствующий в контексте в обоих случаях. Единственная переменная — количество нерелевантного материала вокруг него.
Chroma также обнаружила, что модели показывали лучшие результаты на перемешанных стогах сена, чем на логически связных документах, — и это справедливо для всех 18 моделей. Связный окружающий текст даёт модели больше правдоподобно выглядящих мест для приземления. Тот отчёт вышел 14 июля 2025 года, поэтому ему больше года, и он предшествует текущему поколению моделей.
Эффект не устарел. В MonitorBench добавление 800K токенов безобидных, нерелевантных действий снизило recall Opus 4.6 с 98,6% до 88% (arXiv:2605.12366). Задача не изменилась. Изменилась только набивка.
Где это бьёт вас в обычной работе
Вы уже сталкивались с этим, просто не называли это так. Чат, который блестяще выполнил ваше задание на 12-м сообщении и выдаёт банальные ответы на 90-м — потому что задание теперь похоронено под 78 сообщениями наполовину брошенных черновиков. Ноутбук NotebookLM, где вы добавили 40 источников для полноты картины и начали получать более расплывчатые ответы, чем при восьми. Сессия кодирования, где модель забывает ограничение, которое вы озвучили час назад, и уверенно переписывает код вокруг него.
Ничего из этого не говорит о том, что модель стала ленивей. Это вы тратите бюджет внимания на токены, которые не оправдывают своё место.
Подготовка документов: шаг, который почти все пропускают
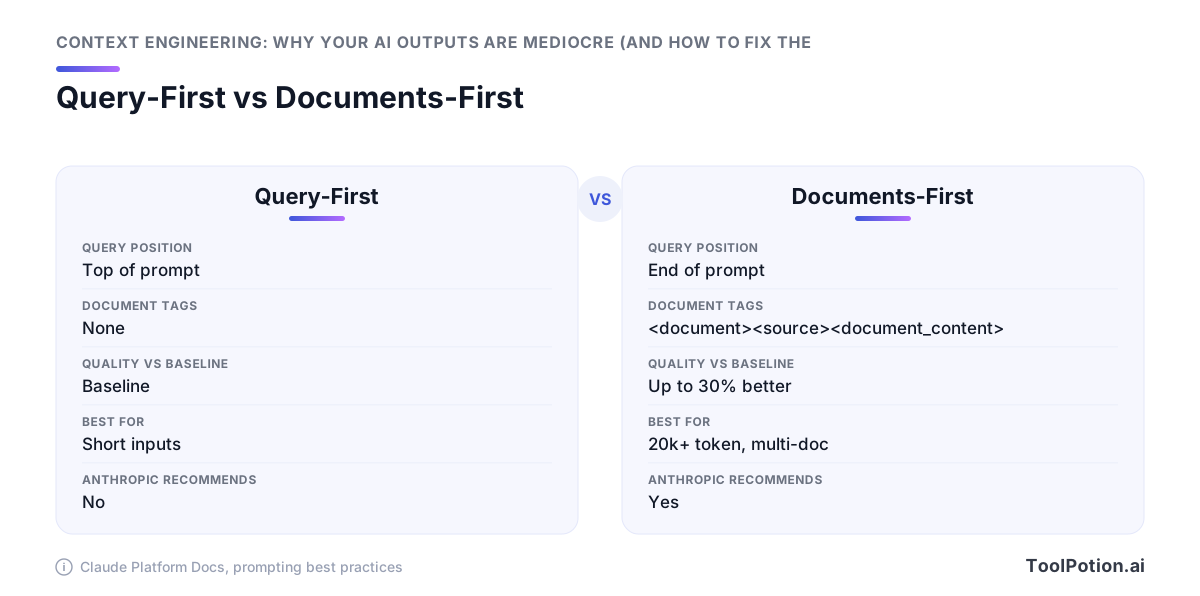
То, куда вы помещаете документ в промпте, меняет ответ, который вы получаете. Для входных данных объёмом свыше 20 000 токенов документация Anthropic по промптингу советует размещать длинные данные вверху — над запросом, инструкциями и примерами: «запросы в конце могут улучшить качество ответов до 30 процентов в тестах, особенно при сложных многодокументных входных данных» (Claude Platform docs). Большинство людей делают наоборот: сначала печатают вопрос, а потом вставляют отчёт ниже.
Размещайте длинные материалы вверху
Та же документация даёт вам каркас, который стоит скопировать дословно: оберните каждый документ в теги <document> с подтегами <source> и <document_content>, чтобы модель могла определить, где заканчивается один файл и начинается следующий (Claude Platform docs). Затем попросите её процитировать соответствующие отрывки перед ответом. Это одно предложение заставляет модель находить доказательства в тексте, а не реконструировать их из смутных воспоминаний, и даёт вам нечто проверяемое, когда ответ выглядит неверным.
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
Размечайте источники, чтобы модель могла их цитировать
Одна оговорка перед тем, как стандартизировать этот подход: вендоры расходятся во мнениях. Anthropic ставит длинные данные первыми; руководство Google говорит противоположное — завершайте инструкциями. Поэтому шаблон промпта, взятый из туториала по Gemini и вставленный в Claude, может работать хуже, не выглядя сломанным. Протестируйте один и тот же набор документов в обоих порядках на той модели, за которую вы платите, по десять вопросов каждый раз, и оставьте тот порядок, который побеждает. Это двадцать минут работы против заявленного выигрыша в 30%.
Выбор парсера определяет, что вообще увидит модель
Ничто из этого не спасёт испорченное извлечение. Таблица отсканированного счёта, превратившаяся в одну длинную строку; двухколоночная статья, перемежающая строки; сноска, вставленная в середину предложения — модель добросовестно читает этот мусор и отвечает на его основе. Шаг извлечения устанавливает потолок точности, и всё последующее ограничено им. Относитесь к парсеру как к решению о качестве и протестируйте два-три варианта на вашем самом некрасивом реальном файле, прежде чем остановиться. В нашем каталоге перечислено 217 инструментов ИИ для работы с документами и PDF, и разрыв между хорошими и плохими виден в ваших результатах, а не в их маркетинговых страницах.
Гигиена retrieval: меньше, но лучших чанков лучше, чем больше
Прежде чем строить слой retrieval, проверьте, нужен ли он вам. Собственные рекомендации Anthropic говорят: если ваша база знаний меньше 200 000 токенов (около 500 страниц), вы можете просто включить её целиком в промпт без retrieval (Anthropic Engineering). Большинство внутренних вики, справочников продуктов и наборов политик укладываются в этот предел.
Нужен ли вам вообще retrieval?
Если корпус помещается — откажитесь от векторной базы данных. Вы избежите решений по разбиению на чанки, дрейфа эмбеддингов и целого класса скрытых сбоев, когда нужный абзац так и не попал в промпт. Дополните это кэшированием промптов, чтобы не платить полную цену за одни и те же 200K токенов при каждом вызове.
Выше этого размера retrieval перестаёт быть необязательным, и качество становится стеком небольших улучшений, которые накапливаются.
Три улучшения, которые накапливаются
Anthropic проверял их по одному. Добавление чанко-специфического контекста к каждому чанку перед эмбеддингом сократило неудачи в top-20 retrieval с 5,7% до 3,7% — примерно на 35%. Добавление контекстуального гибридного поиска BM25 снизило неудачи до 2,9% — сокращение на 49%. Наложение прохода переранжирования сверху довело до 1,9% — общее сокращение на 67% (Anthropic Engineering). Каждый шаг сам по себе негламурный, и вместе три из них дают примерно втрое больший эффект, чем первый.
Урезание определений инструментов тоже имеет значение
Схемы инструментов — это контекст. Если вы передаёте модели сорок определений инструментов, а ей нужны два, вы заплатили за тридцать восемь отвлекающих факторов. В работе RAG-MCP извлекались только релевантные схемы вместо перечисления всех, что сократило токены промпта более чем вдвое, а точность выбора инструмента выросла с 13,62% до 43,13% (arXiv:2505.03275). Это та же дисциплина, что и отбор чанков, применённая на уровень выше.
Паттерн субагентов Anthropic расширяет её ещё дальше: специализированные агенты выполняют поиск и возвращают сжатые резюме объёмом около 1 000–2 000 токенов координирующему агенту, так что основной контекст никогда не видит необработанные транскрипты поиска (Anthropic Engineering). Если вы выбираете компоненты, а не пишете их, в нашем каталоге перечислено 550 агентов ИИ и набор фреймворков retrieval и агентов, реализующих эти паттерны из коробки.
Функции памяти: какую настройку менять в каждом инструменте
Каждый потребительский ИИ-продукт теперь добавляет в ваш контекст то, что вы не вводили. Сохранённые факты, предыдущие чаты, активность приложений, загруженные файлы проекта. Вы не сможете заниматься контекстной инженерией в чат-приложении, пока не узнаете, что уже сидит в окне до вашего первого слова.
Неверная память обходится дороже, чем никакой памяти. Это высокосигнальный текст, который модель воспринимает как факт, и он находится близко к вашим инструкциям — там, где внимание сильнее всего. Устаревшие должности, старое имя клиента, предпочтение, заданное однажды для разовой задачи — каждое из них незаметно смещает каждый последующий ответ.
ChatGPT: два независимых переключателя
Память ChatGPT — это два механизма, а не один. Сохранённые воспоминания — это отдельные сохранённые факты, которые можно прочитать и удалить по отдельности, тогда как ссылка на историю чатов тянется из ваших предыдущих разговоров через отдельный путь retrieval (Embrace The Red). Отключение одного оставляет другой работать. Если ваши результаты всё ещё пахнут проектом прошлого месяца после очистки сохранённых воспоминаний — это переключатель истории, который вы пропустили.
Claude: знания проекта и записи памяти в середине разговора
После объединения Cowork 25 августа 2026 года Claude записывает воспоминания в середине разговора, а не только на границах сессий — то, что вы говорите в чате, переносится в последующие сессии (TechCrunch). Это значит, что случайное замечание может стать постоянным контекстом.
Знания проекта — лучший рычаг, потому что это корпус, который вы выбрали сами. Держите его в пределах правила Anthropic в 200 000 токенов (примерно 500 страниц), и он может присутствовать целиком без слоя retrieval, угадывающего, какие чанки важны (Anthropic). Обрезайте его как список для чтения, а не как архив.
Gemini: три перекрывающиеся системы, где «выкл» не значит «удалено»
Gemini слоит личный контекст, сохранённую информацию, которую вы написали сами, и активность из подключённых приложений Google. Отключение источника прекращает новые записи. Оно не удаляет то, что уже сохранено, поэтому аудит означает посещение каждой настройки по отдельности и удаление — а не просто выключение.
NotebookLM: альтернатива с ограниченным числом источников
NotebookLM ограничивает количество источников, которые может содержать ноутбук, и это ограничение работает в вашу пользу. Оно вынуждает к тому курированию, которое три других инструмента позволяют пропустить — той же дисциплине, которую предписывает Anthropic: найти наименьший набор высокосигнальных токенов, дающих нужный результат (Anthropic). Когда вопрос требует восьми документов, а не восьмидесяти — начните именно там.
Выберите один инструмент в качестве вашего памятесодержащего ассистента и держите остальные чистыми. Среди 13 174 ИИ-приложений в нашем каталоге те, что делают память проверяемой по каждому элементу, стоят больше, чем те, которые обещают помнить всё.
Инструкции на уровне проекта — это многоразовый контекст
Самый дешёвый контекст, который вы когда-либо напишете, — это контекст, написанный один раз. Каждый серьёзный инструмент ИИ теперь имеет слот для постоянных инструкций, которые добавляются в каждую сессию: AGENTS.md и CLAUDE.md в репозитории, Claude Projects, пользовательские инструкции ChatGPT, файлы инструкций Copilot. Большинство людей оставляют эти слоты пустыми и затем перепечатывают одни и те же три абзаца предыстории в каждый новый чат.
Почему файл постоянных инструкций лучше, чем повторные объяснения
Исследование на 10 репозиториях и 124 пул-реквестах измерило, что делает файл AGENTS.md на уровне репозитория с поведением агента, и результат касается не только корректности. Медианное время выполнения упало на 28,64% — с 98,57 секунды до 70,34 секунды — а выходные токены сократились на 16,58% при сопоставимых показателях завершения (arXiv:2601.20404). Агент перестал исследовать, чтобы выяснить то, что вы и так уже знали.
Это аргумент в одном предложении. Хороший постоянный контекст делает модель быстрее и дешевле, а не только точнее — потому что большую часть токенов агент сжигает на повторное открытие ваших соглашений. Если вы выбираете из 260 ИИ-ассистентов для кодирования в нашем каталоге, то умеет ли инструмент читать файл инструкций проекта — лучший фильтр, чем большинство сравнений функций.
Что реально в нём стоит держать
Держите его достаточно коротким, чтобы вы сами его читали. Пять вещей заслуживают своего места:
- Соглашения, которые код не объявляет — например, какой тест-раннер реальный, а какой мёртвый.
- Ваш словарь. Если «аккаунт» и «тенант» означают здесь разные вещи — скажите об этом один раз.
- Желаемая форма вывода в том формате, который вам нужен (дифф, таблица, пять пунктов).
- Короткий список запретов. Не трогать сгенерированные файлы, не добавлять зависимости без согласования.
- Где находится источник истины, чтобы модель запрашивала его, а не угадывала.
Оставьте за бортом всё, что инструмент может прочитать сам. Деревья директорий, списки файлов, пересказанные сигнатуры функций, резюме вашего README. Это токены, потраченные на дублирование того, что агент может получить за один вызов, и они конкурируют за внимание с инструкциями, которые важны. Переписывайте файл, когда его начинают игнорировать — обычно это значит, что он стал слишком длинным.
Раздутость контекста имеет цену
Небрежный контекст обходится деньгами в счёте, а не только качеством в выводе. Два механизма ценообразования делают это конкретным, и оба поощряют одну и ту же дисциплину: небольшой, стабильный, упорядоченный префикс.
Ступенчатая функция на 272K для GPT-5.4
GPT-5.4 от OpenAI принимает окно контекста в 1 050 000 токенов с до 128 000 выходными токенами, но промпты свыше 272K входных токенов «тарифицируются по 2x для входящих и 1,5x для исходящих за всю сессию» (OpenAI API docs). Читайте внимательно. Одно пересечение черты не стоит вам чуть больше за превышение. Оно переоценивает всю сессию, включая вывод — так что одна небрежная вставка дампа в 300K токенов удваивает ваш счёт за входящие данные для каждого последующего обмена.
Вы платите вдвое за токены, которые с наибольшей вероятностью ухудшают ваш ответ.
Кэширование поощряет стабильный префикс
Claude API оценивает чтение из кэша в 0,1x базовой входящей цены — скидка 90% — тогда как запись в кэш стоит 1,25x при TTL 5 минут или 2x при TTL 1 час (Claude Platform docs). Проработанный пример: 100K токенов, повторно используемых десять раз, обходятся в $1,075 против $5,00 без кэша — экономия 78,5%.
Эта скидка применяется только если префикс совпадает байт в байт. Кэширование работает по точному префиксу — поэтому если вы меняете порядок документов, вставляете метку времени в системный промпт или перемешиваете определения инструментов между обменами, вы снова платите цену записи вместо цены чтения. Привычка, которая поддерживает кэш тёплым, — та же, что поддерживает высокий recall: ставьте стабильный материал первым в фиксированном порядке и меняйте в конце только запрос.
Аудит контекста, который вы можете провести на этой неделе
Здесь ничего не требует API-ключа или инженерного тикета. Каждый пункт — это настройка, которая у вас уже есть.
Шесть проверок перед следующей долгой сессией
- Откройте новый чат вместо продолжения вчерашнего. Сфокусированные промпты Chroma (~300 токенов релевантных обменов) превзошли полные истории на 113K токенов во всех семействах моделей, которые они тестировали, при этом Claude показал наибольший разрыв (Chroma).
- Прочитайте сохранённые воспоминания и удалите устаревшие. Сохранённые факты добавляются в контекст вне зависимости от того, помогают ли они.
- Прикрепите три хороших документа вместо двенадцати посредственных и оберните каждый в теги
<document>с подтегом<source>, чтобы модель могла их различить (Claude docs). - Размещайте длинный материал над вашим вопросом. При входных данных от 20K токенов такой порядок даёт до 30% лучших ответов в тестах Anthropic (Claude docs).
- Запишите постоянные инструкции один раз. AGENTS.md на уровне репозитория сократил медианное время выполнения на 28,64% и выходные токены на 16,58% на 124 PR (arXiv).
- Сохраняйте этот префикс идентичным от обмена к обмену. Стабильные префиксы попадают в кэш по 0,1x входящей цены (Claude docs).
Одна привычка, которая исправляет большинство плохих результатов
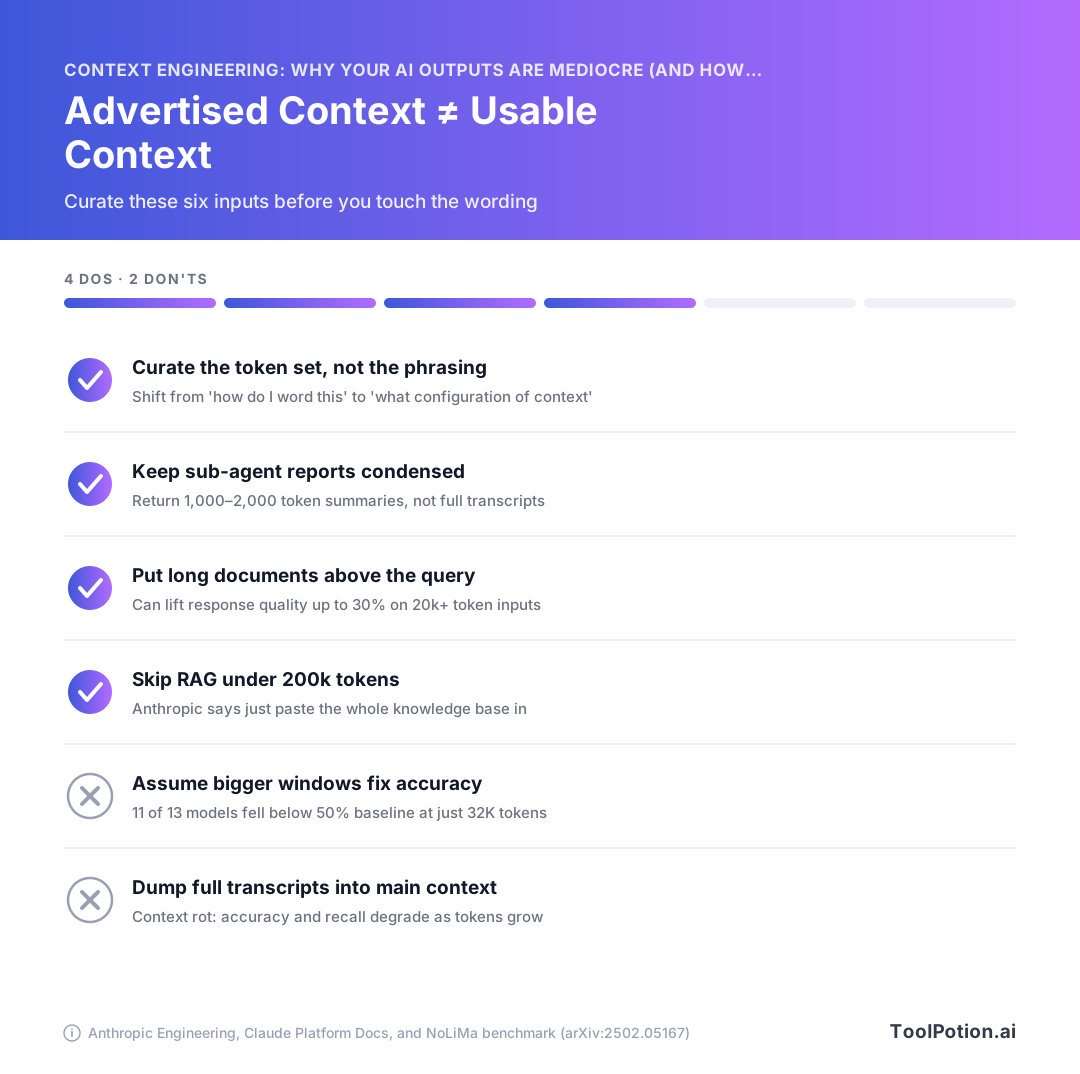
Прежде чем переписывать промпт, посмотрите, что уже находится в окне, и уберите что-нибудь. Собственные документы Anthropic это говорят: «больше контекста — не значит автоматически лучше» (Claude docs). Меняйте то, чем вы кормите модель, прежде чем менять то, как вы её спрашиваете.
Часто задаваемые вопросы
Что такое контекстная инженерия и чем она отличается от промпт-инженерии?
Anthropic определяет контекстную инженерию как «набор стратегий по курированию и поддержанию оптимального набора токенов (информации) во время вывода LLM, включая всю остальную информацию, которая может там оказаться помимо запросов» (Anthropic Engineering). Промпт-инженерия спрашивает, как сформулировать запрос. Контекстная инженерия спрашивает, какая конфигурация контекста с наибольшей вероятностью вызовет нужное поведение, и охватывает всё, что занимает окно: системный промпт, каждое сообщение включая результаты инструментов, изображения и PDF, сами определения инструментов и собственный вывод модели включая расширенное мышление (Claude Platform docs). Anthropic представляет её как естественное развитие промпт-инженерии, а не замену ей.
Всегда ли большее окно контекста означает лучший вывод ИИ?
Нет. Заявленный и реально используемый контекст — это два разных числа: бенчмарк NoLiMa протестировал 13 моделей, все заявляющих поддержку от 128K или более, и при 32K токенах 11 из 13 набрали меньше половины собственного базового уровня при коротком контексте, а Llama 3.1 70B упала с 94,3% до 42,7% (arXiv:2502.05167, февраль 2025). Собственная документация платформы Anthropic говорит прямо: «больше контекста — не значит автоматически лучше. По мере роста количества токенов точность и recall ухудшаются» (Claude Platform docs). Заполнение окна также обходится деньгами ступенчато, а не линейно: OpenAI тарифицирует промпты GPT-5.4 свыше 272K входных токенов по 2x для входящих и 1,5x для исходящих за всю сессию (OpenAI API docs).
Что такое контекстное гниение и как его избежать?
Контекстное гниение — это деградация точности и recall по мере роста количества токенов в запросе; Anthropic называет его в собственной документации (Claude Platform docs). Исследование Context Rot от Chroma протестировало 18 моделей, включая GPT-4.1, Claude 4, Gemini 2.5 и Qwen3, и обнаружило падение надёжности при более длинных входных данных даже в тривиальных задачах retrieval и воспроизведения слов; в тесте LongMemEval каждое семейство моделей показало лучшие результаты на сфокусированном промпте ~300 токенов, чем на том же вопросе, похороненном в ~113K токенах истории разговора, при этом модели Claude показали наибольший разрыв (Chroma, июль 2025). Избегайте этого, вставляя только нужные отрывки, начиная новые чаты для новых тем вместо продолжения старых и используя специализированных агентов, возвращающих сжатые резюме от 1 000 до 2 000 токенов координирующему агенту вместо полных транскриптов (Anthropic Engineering).
Стоит ли отключать память в ChatGPT, Claude или Gemini?
Зависит от задачи, потому что память добавляет в окно токены, которые вы не выбирали, а всё это идёт в зачёт общему итогу (Claude Platform docs). Для рутинного написания текстов, где знание модели о вашей роли, стиле и стеке экономит вам повторный ввод — оставьте включённой. Для высококритичного анализа конкретного документа начните чистый чат с отключённой памятью: Chroma обнаружила, что каждое семейство моделей отвечало лучше с сфокусированного промпта ~300 токенов, чем с того же ответа, окружённого ~113K токенами посторонней истории (Chroma). Воспринимайте память как постоянный промпт, за который вы платите при каждом обмене, и обрезайте её так же, как обрезали бы системный промпт.
Нужен ли мне RAG, или я могу просто вставить документы в промпт?
Рекомендации Anthropic гласят, что при малом масштабе retrieval часто не нужен: «если ваша база знаний меньше 200 000 токенов (около 500 страниц материала), вы можете просто включить всю базу знаний в промпт» (Anthropic Engineering, сентябрь 2024). Выше этого значения гигиена retrieval накапливается в бенчмарке Anthropic: добавление чанко-специфического контекста перед эмбеддингом сократило неудачи в top-20 retrieval с 5,7% до 3,7%, добавление контекстуального гибридного поиска BM25 довело до 2,9%, а проход переранжирования — до 1,9%, общее сокращение на 67%. Если корпус помещается, вставка является лучшим вариантом по умолчанию, а кэширование промптов делает повторное использование дешёвым — чтение из кэша тарифицируется по 0,1x базовой входящей цены (Claude Platform docs).
Где размещать длинные документы в промпте — до или после вопроса?
Для Claude размещайте длинные данные вверху — над запросом, инструкциями и примерами. Документация Anthropic по промптингу даёт это как конкретное правило для входных данных от 20K токенов и указывает, что «запросы в конце могут улучшить качество ответов до 30 процентов в тестах, особенно при сложных многодокументных входных данных» (Claude Platform docs). Та же документация рекомендует оборачивать каждый документ в теги <document> с подтегами <source> и <document_content> и просить модель процитировать соответствующие отрывки перед ответом. Вендоры не сходятся во мнениях об упорядочении, поэтому шаблон, скопированный из cookbook одного провайдера, может плохо работать на модели другого — стоит один раз проверить оба порядка на вашей задаче.