

Паттерны промптинга, которые переживают обновление модели, — это те, что несут информацию, которую модель не может вывести самостоятельно: роль, задающая аудиторию, контекст, которого у неё нет, задача с правилом принятия решений и выходной контракт, применяемый за пределами промпта. Всё остальное — фольклор с ограниченным сроком годности.
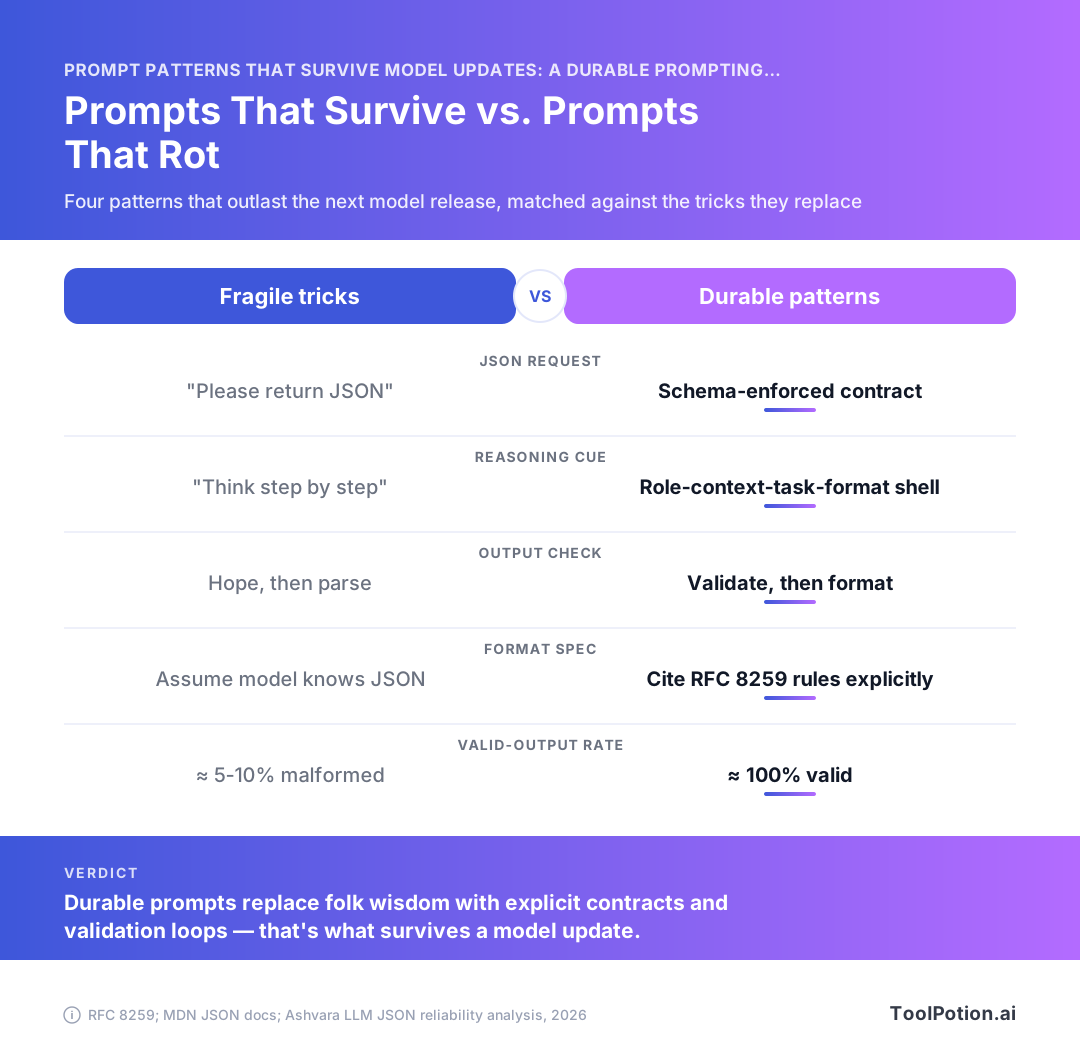
Эту разницу лучше всего видно на примере JSON. Вежливая просьба вернуть JSON оставляет примерно 5–10% некорректных выводов, режим JSON даёт около 95–99% валидных, а декодирование с ограничением по схеме — фактически 100% (Ashvara). Одно намерение, три уровня применения, принципиально разные показатели ошибок в день релиза.
Это руководство охватывает четыре паттерна, которые продолжают работать в Claude, GPT и Gemini, хрупкие приёмы, которые стоит удалить из своей библиотеки, и небольшой набор тестов, который превращает следующий релиз модели в diff, а не в инцидент.
Почему промпты устаревают: режим отказа, который никто не версионирует
Промпты деградируют не случайно. Они деградируют по предсказуемой линии разлома: части, опирающиеся на поведение конкретной модели, аннулируются следующим чекпоинтом, а части, в которых явно указано, что вам нужно, — выживают.
Два вида промптов: те, что описывают намерение, и те, что эксплуатируют особенность
Промпт-намерение говорит, каким должен быть вывод, кто его читает и что считается ошибкой. Промпт-особенность говорит то, что случайно сработало в прошлый вторник. ТОЛЬКО ВОЗВРАЩАЙ JSON заглавными буквами. Троекратное повторение одной и той же инструкции, потому что двух раз не хватило. Магическая преамбула, скопированная с форумного треда. Эти приёмы были настроены под поведение декодирования одного чекпоинта, и ни один из них не сообщает будущей модели, что вам на самом деле нужно.
Наивный промптинг «пожалуйста, верни JSON» по-прежнему даёт примерно 5–10% некорректных выводов (Ashvara), и это число — свойство модели, а не вашего промпта. Замените модель — число изменится. Вы так и не записали контракт, поэтому вам нечем предъявить претензии к новой модели.
Что конкретно ломается в день релиза
Поломка редко бывает явной. Ваш парсер начинает падать на завершающей запятой (примерно 40% ошибок JSON в одном анализе приходится именно на это, Flying Fish Space), или модель становится более разговорчивой и оборачивает чистый вывод в предложение-преамбулу. При этом темп выпуска новых моделей означает, что чекпоинт, под который вы настраивали промпт, может уже не обрабатывать трафик в следующем квартале.
Сравните это с вызовом с ограничением по схеме, где генерация ограничена заданной вами формой и синтаксическая корректность составляет фактически 100% (Ashvara). Применение находится за пределами текста промпта. Обновление модели может изменить тон, многословность и глубину рассуждений, не затрагивая его.
Тест на устойчивость: будет ли этот промпт по-прежнему иметь смысл для более умной модели?
Один вопрос, задаваемый к каждому вашему промпту: если бы модель стала вдвое умнее за ночь, эта инструкция по-прежнему была бы полезной?
«Верни объект с ключами id, status и confidence, где status — одно из трёх литеральных значений» — проходит. RFC 8259 уже фиксирует используемый вами словарь: четыре примитивных типа, два структурных типа и ровно три буквальных имени в нижнем регистре (RFC 8259). Эта инструкция читаема любой моделью — сейчас и в будущем. «Сделай глубокий вдох и думай шаг за шагом» — не проходит, потому что это компенсирует слабость, которой у следующего релиза может уже не быть. Удаляйте компенсации, оставляйте контракты.
Паттерны промптинга, которые переносимы: роль, контекст, задача, формат
Реструктурируйте каждый произвольный промпт в четыре слота и помещайте в каждый только ту информацию, которую модель не может вывести самостоятельно. Роль, контекст, задача, формат. Оболочка переживает обновления моделей, потому что каждый слот несёт факты о вашей задаче, а не фольклор о том, как чекпоинт прошлого квартала реагировал на лесть.
Четыре слота и что в них должно быть
Роль — это кто является читателем вывода и какую экспертизу предполагает ответ. «Ты — эксперт мирового класса» задаёт настроение и не несёт никакой информации. «Ты пишешь для инженера по платежам, который уже знает, что такое ключ идемпотентности» говорит модели, какие объяснения она может пропустить.
Контекст — это всё, что модель никак не может знать: схема, вышестоящая система, граничные случаи, с которыми вы уже столкнулись в продакшене, тот факт, что ваш парсер отклоняет UTF-8 BOM. Задача — единственный глагол и его объект. Формат — выходной контракт, и он должен быть достаточно конкретным для механической проверки.
Слот формата, в котором написано «верни JSON», — это пожелание. Слот формата, в котором указаны ключи, их типы и что происходит, когда значение неизвестно, — это контракт, который можно протестировать. JSON даёт вам четыре примитивных типа (строка, число, булево, null) и два структурных типа, объекты и массивы (RFC 8259), так что существует небольшой конечный словарь для точного описания. Пишите null вместо «оставьте пустым», потому что литеральные имена true, false и null — в нижнем регистре, и ничто другое не является допустимым (RFC 8259).
Почему оболочка переносима между Claude, GPT и Gemini
Ни один из четырёх слотов не зависит от токенизатора, особенностей системного промпта или флага возможностей провайдера. Каждой модели необходимо сообщать, какие поля вы хотите и что ваш нижестоящий код делает с ними, поэтому одна и та же оболочка переносится в Claude, GPT и Gemini без переписывания. Эта переносимость также делает её обновляемой: когда выходит новый чекпоинт, слот контекста по-прежнему верен, а слот формата — по-прежнему контракт, который применяет ваш валидатор. Вы меняете модель, перезапускаете тесты, и diff пустой.
Большинство из 212 инструментов промптинга, шаблонизирующих эту структуру в нашем каталоге, продают вам слоты в виде формы. Того же эффекта можно добиться с помощью heredoc и четырёх комментариев.
Написание ограничений как фактов, а не заклинаний
Есть тест на то, принадлежит ли строка вашему промпту: мог бы компетентный подрядчик действовать по ней без уточняющих вопросов? «Будь тщательным» — нет. «Имена свойств берутся в двойные кавычки, после последнего элемента нет завершающей запятой» — да, и это соответствует реальным режимам отказа, поскольку завершающие запятые в одном анализе составляют около 40% ошибок JSON (Flying Fish Space).
Заклинание перестаёт отрабатывать свои токены, так и не давая явного сбоя, тогда как записанный факт сохраняет своё значение на любом чекпоинте, на который вы его направите.
Разобранный пример переписывания до/после
| До (произвольный) | После (четыре слота) |
|---|---|
| «Ты — эксперт-аналитик данных. Тщательно извлеки детали счёта и верни JSON. Будь точным!» | Роль: вывод потребляется Python-вызовом json.loads, ни один человек его не читает. Контекст: счета — это OCR-обработанные PDF; названия поставщиков часто усечены; суммы могут содержать символ валюты. Задача: извлечь vendor, invoice_number, total_cents, issued_date. Формат: один JSON-объект, ключи точно как указано, total_cents — целое число без ведущих нулей, неизвестные значения как null, никакого текста до или после. |
Версия «после» ничего не говорит о личности модели и говорит всё о ваших данных. Обратите внимание, что null и {} — оба валидные JSON, но означают разное (Jsonic), поэтому выберите одно и запишите. Ведущие нули также недопустимы в числах JSON (MDN), поэтому слот формата явно прописывает правило для целых чисел, вместо того чтобы доверять модели помнить грамматику.
Скаффолды few-shot, настроенные для переноса
Выбирайте примеры за ту неоднозначность, которую они разрешают. Блок few-shot, демонстрирующий четыре случая, где человек бы заколебался, учит тому, что следующей модели всё ещё нужно. Блок, показывающий четыре простых случая в определённом стиле, учит тону, а тон — это именно то, что каждый чекпоинт всё лучше угадывает самостоятельно.
Примеры, обучающие границе решения, а не словарному запасу
Прежде чем вставить пример, спросите: что изменится, если его удалить? Если ответ — «вывод будет звучать чуть менее похоже на нас», удалите его. Если ответ — «модель будет классифицировать возврат с частичной доставкой как возврат товара, а не как спор», оставьте, потому что это решение не выводится из описания задачи.
Тот же тест применим к форме вывода. Один пример, показывающий пустой результат как [], а не null, стоит больше, чем пять примеров заполненных результатов, поскольку пустой массив и null — оба валидные JSON, но означают разное (Jsonic). Модели по-разному угадывают это, и один пример закрывает вопрос навсегда.
Граничные случаи и негативы отрабатывают свою стоимость в токенах
Два-три из ваших примеров должны быть случаями, которые вы неправильно обработали в продакшене. Отсутствующее поле. Ввод, который уже находится в целевом формате. Запись, где правильный ответ — «недостаточно данных», но полезная модель вместо этого придумает значение.
Негативы работают, когда вы сопровождаете их исправлением, а не формулируете запрет. Покажите некорректный вывод и исправленный рядом, и граница станет конкретной. Инструкции «не используй одинарные кавычки» сами по себе устаревают, а одинарные кавычки — один из повторяющихся нарушителей, ведущих к некорректному JSON, наряду с завершающими запятыми, на которые приходится около 40% ошибок в одном анализе (Flying Fish Space).
Сколько примеров нужно и когда переходить на ноль
Начинайте с нуля. Добавляйте примеры только тогда, когда тестовый случай не проходит, и добавляйте наименьший пример, который исправляет ситуацию. Большинство промптов для классификации и извлечения стабилизируются между тремя и шестью; за восемью вы обычно компенсируете описание задачи, которое так и не написали должным образом.
Переходите на ноль всякий раз, когда схема справляется с работой. Декодирование с ограничением по схеме даёт фактически 100% синтаксически валидного JSON (Ashvara), поэтому там примеры формата — лишний груз. Оставляйте примеры для суждений, тратьте схему на структуру.
Запах переобучения: примеры, которые следующая модель будет имитировать слишком буквально
Следите за примерами, поверхностные признаки которых случайны. Если каждый пример ввода содержит около 40 слов, более сильная модель может воспринять длину как сигнал. Если все четыре примера попадают на одну метку, вы смещаете априорное распределение. Если ваши примеры используют имена-заглушки вроде Acme Corp, ожидайте, что рано или поздно эти имена появятся в реальном выводе.
Перезапускайте набор few-shot примеров против нового чекпоинта на неделе его выхода и сравнивайте выводы для случаев, не охваченных примерами. Именно там проявляется утечка имитации. Команды, публикующие реальные отчёты о развёртывании, как правило, держат набор примеров под версионным контролем именно по этой причине: пример, который нельзя сравнить через diff, — это пример, который нельзя вывести из употребления.
Выходные контракты, переживающие модель
Сдвигайте применение вниз по стеку, пока формат не перестанет зависеть от того, как чекпоинт себя чувствует в этот день. Вежливая просьба о JSON — самый слабый доступный уровень, и именно на нём работает большая часть продакшен-кода.
Три уровня надёжности: прозаический запрос, режим JSON, декодирование с ограничением
| Уровень | Как вы запрашиваете | Что приходит в ответ |
|---|---|---|
| 1 | «Пожалуйста, верни JSON» в тексте промпта | Примерно 5–10% выводов некорректны (Ashvara) |
| 2 | Включён режим JSON провайдера | Около 95–99% синтаксически валидных по наблюдениям в продакшене (Ashvara) |
| 3 | Генерация ограничена по предоставленной схеме | Фактически 100% синтаксически валидных (Ashvara) |
Используйте третий уровень везде, где его поддерживает ваш провайдер. Тогда валидность обеспечивает декодер, а не веса, и смена модели не может её регрессировать. Сохраняйте контракт на уровне промпта в любом случае, потому что декодирование с ограничением гарантирует форму и ничего не говорит о том, правильны ли значения. Если не хотите писать обвязку самостоятельно, фреймворки, оборачивающие применение схемы, в нашем каталоге насчитывают 128 записей.
Что контракт должен специфицировать помимо «верни JSON»
Назовите ключи, тип за каждым ключом и поведение, когда модели нечего туда поставить.
- Каждый ключ прописан именно так, как его ожидает ваш парсер, с типом из шести JSON-типов: четыре примитива (string, number, boolean, null) и два структурных типа, object и array (RFC 8259).
- Только литералы в нижнем регистре. Грамматика допускает ровно три из них: false, null, true (RFC 8259).
- Уникальные имена ключей внутри каждого объекта — RFC 8259 рекомендует это, чтобы каждый парсер одинаково определял соответствие имя–значение.
- Нужно ли опускать необязательные ключи или выводить их со значением null, а также любое перечисление, которое вы ожидаете, записанное как литеральные строки.
Режимы отказа, которые стоит кодировать: завершающие запятые, одинарные кавычки, неэкранированные строки
Один анализ показывает, что завершающие запятые составляют около 40% всех ошибок JSON, а одинарные кавычки, неэкранированные кавычки внутри строк, отсутствующие запятые и скрытые символы UTF-8 BOM охватывают большую часть остального (Flying Fish Space). Явный запрет этих пяти режимов отказа стоит вам около 25 токенов в слоте формата, и этот запрет остаётся верным на любой модели, которую вы когда-либо на него направите. Дополните его шагом валидации-перед-форматированием на своей стороне, а не доверяйте строке напрямую (QuickTinyData).
Пустой объект, пустой массив, null: три разных ответа
Именно здесь контракты протекают между версиями модели, и никто этого не замечает. Пустой объект и пустой массив — оба валидные JSON, и оба означают нечто иное, чем null (Jsonic). Один чекпоинт возвращает [] для нулевых совпадений, следующий — null, и ваш нижестоящий код воспринимает один из них как ошибку.
Выберите представление, запишите его в контракте и проверяйте его. Вашему парсеру также нужно выживать при голом значении на верхнем уровне, поскольку любое единственное JSON-значение считается полным документом, включая одиночную строку или число 42 (Jsonic).
Хрупкие приёмы, умирающие с каждым релизом
Откройте свою библиотеку промптов и поищите эти четыре паттерна. Каждое совпадение — кандидат на удаление, потому что каждый из них компенсировал слабость модели, которую либо исправили, либо переместили.
Типичная вставка «думай шаг за шагом»
Добавление «думай шаг за шагом» к промпту имело смысл, когда модели сразу переходили к ответу. Современные модели рассуждений уже по умолчанию декомпозируют задачу, поэтому фраза добавляет токены и иногда превращает короткую задачу классификации в три абзаца повествования, которое затем приходится убирать.
Сохраняйте инструкции по рассуждению только когда они специфичны для задачи: «перечисли конфликтующие пункты, прежде чем выбрать один» говорит модели, о чём рассуждать. Устойчивая замена — слот задачи в вашей оболочке роль-контекст-задача-формат, в котором прописан промежуточный артефакт, который вы хотите получить. Типовое заклинание — в мусорную корзину.
Угрозы, взятки и ролевое давление
«Тебя уволят, если ты ошибёшься.» «Я дам тебе чаевые $200.» «Ты — лучший аналитик в мире.» Всё это опиралось на особенности конкретных RLHF-чекпоинтов, а особенности не переживают переобучения. Хуже того, они нефальсифицируемы: вы не можете написать тест, доказывающий, что именно чаевые исправили ваш вывод, поэтому строка навсегда остаётся в промпте без возражений.
Заменяйте давление ограничением. Рубрика, по которой модель оценивает себя сама, или явный список того, что считается провалом, выполняет ту же работу и продолжает работать при смене чекпоинта.
Хаки форматирования, воюющие с токенизатором
Дополнять промпты требованиями ЗАГЛАВНЫМИ БУКВАМИ, тройными восклицательными знаками или длинными рядами разделителей вроде ##### — это фольклор. В части разделителей было зерно истины (чёткие границы разделов помогают), но эскалация — нет. Два символа новой строки и XML-подобный тег лучше сорока решёток.
То же касается «без блоков кода, без преамбулы, без объяснений, вывести ТОЛЬКО JSON», сложенных тремя способами. Скажите это один раз в слоте формата, а затем поместите гарантию туда, где гарантии на самом деле живут: ограничение генерации по предоставленной схеме — это то, что выводит вас на фактически 100% синтаксически валидного JSON (Ashvara), и никакое количество запретов на уровне промпта не приближается к этому числу.
Упрашивание в промпте там, где нужен парсер
Режимы отказа скучны и структурны: завершающие запятые после последнего элемента, ключи без кавычек, недопустимые символы кавычек, отсутствующие запятые, несовпадающие фигурные скобки (QuickTinyData). Завершающие запятые одни составляют около 40% ошибок JSON в одном наборе данных об ошибках (Flying Fish Space), и они запрещены самим форматом (MDN). Никакое количество вежливых просьб не закроет этот пробел.
Уберите упрашивание. Поместите туда схему и валидатор, а промпту оставьте задачу объяснить, что означают поля.
Циклы оценки относятся к промптам как к версионированным артефактам
Создайте двадцать тестовых случаев до того, как строить что-то умное. Промпт без набора тестов — это промпт, который нельзя обновить, потому что вы не можете сказать, сделала ли новая модель его лучше или сломала единственный случай, важный для вашего крупнейшего клиента, не сообщив вам об этом.
Двадцать — не компромиссное число. Этого достаточно, чтобы охватить известные вам классы отказов, достаточно мало, чтобы написать за один день, и достаточно дёшево, чтобы перезапускать при каждом чекпоинте, не задумываясь о счёте.
Минимально жизнеспособный набор тестов: 20 случаев, одна проверка каждый
Одна проверка на случай, и пусть она будет булевой: был ли вывод успешно разобран, содержал ли он обязательное поле, отказал ли он там, где должен был отказать. Рубрики, модели-судьи и оценки сходства появятся позже, когда булева значение станет зелёным. Случаи с тремя проверками превращаются в случаи, которые невозможно отладить, а красный прогон ничего не говорит о том, которая из трёх сломалась.
Выбирайте двадцать из реального трафика, с акцентом на некрасивый конец. Пять счастливых путей, пять неоднозначных входов, пять состязательных или пустых, пять тех, что когда-то ломались в продакшене. Храните их рядом с промптом в том же репозитории, в том же коммите. Если промпт изменился, а случаи — нет, это комментарий при ревью.
Сначала валидируй, потом форматируй: заимствуем рабочий процесс отладки JSON
JSON-сообщество решило этот спор много лет назад. Руководство по устранению неполадок QuickTinyData рекомендует сначала валидировать и только потом форматировать, потому что красивое форматирование сломанного документа скрывает именно ту структурную ошибку, которую вы ищете: завершающие запятые, ключи без кавычек, неверные символы кавычек, отсутствующие запятые, несовпадающие фигурные скобки (QuickTinyData).
Запускайте набор тестов аналогичным образом. Проверяйте валидность перед качеством. Вывод модели, для которого не проходит json.loads, не должен переходить к семантической проверке и не должен получать частичного зачёта. Вашему набору тестов нужны два столбца — процент разбора и процент прохождения, — и второй считает только строки, где первый успешен.
Знание распределения ошибок говорит вам, что проверять. Один анализ показывает, что завершающие запятые составляют около 40% ошибок JSON, а одинарные кавычки, неэкранированные кавычки внутри строк, отсутствующие запятые и скрытые символы UTF-8 BOM составляют большую часть остального (Flying Fish Space). BOM заслуживает отдельной проверки, потому что он невидим в каждом редакторе, который вы будете использовать для просмотра вывода.
Регрессионные прогоны в день релиза
Выходит новый чекпоинт. Вы запускаете двадцать, получаете diff, принимаете решение. Это вся процедура, и она занимает около четырёх минут, если вы правильно построили набор.
- Зафиксируйте старую модель и перезапустите набор, чтобы убедиться, что ваш базовый результат по-прежнему воспроизводится. Если нет — проблема в вашей тестовой установке, а не в релизе.
- Запустите набор против нового чекпоинта и запишите процент разбора и процент прохождения отдельно.
- Прочитайте каждый случай, который переключился, в обоих направлениях. Случай, который начал проходить, может быть удачей, и он заслуживает столько же внимания, что и регрессия.
- Выпустите, откатитесь или исправьте промпт. Затем зафиксируйте новые базовые показатели рядом с файлом промпта.
Это особенно важно в агентских стеках, где один неудачный разбор каскадирует, потому что сбой всплывает тремя вызовами инструмента спустя как нечто, совершенно непохожее на ошибку форматирования.
Фиксация версий и что делать, когда это невозможно
Везде, где можете, фиксируйтесь на датированных ID моделей и воспринимайте алиас как плавающую зависимость, которую вы решили не блокировать. Некоторые провайдеры не дают вам пин или объявляют тот, что у вас есть, устаревшим в короткий срок. Когда это происходит, ваш набор тестов — это то, что стоит между молчаливым изменением поведения и обращением в поддержку, которое вы не можете воспроизвести.
Запускайте набор по расписанию против непривязанного эндпоинта. Раз в неделю — достаточно. Вы обнаружите дрейф до того, как ваши пользователи опишут его в баг-репорте.
Перенос одного промпта между Claude, GPT и Gemini
Примерно 80% хорошо построенного промпта переносится без изменений. Остальное — адаптерный слой, который вы пишете один раз на провайдера, а затем в основном забываете. Если вы переписываете всё целиком для каждого поставщика, ваш промпт нёс специфичное для провайдера поведение, которое ему никогда не было нужно нести.
Что остаётся неизменным: оболочка, примеры, контракт
Четырёхслотовая оболочка переходит между провайдерами без правок. Роль, контекст, задача, формат описывают работу, а работа не меняется при смене чекпоинтов. То же для вашего блока few-shot: примеры, разрешающие подлинную неоднозначность в вашей области, учат каждую модель одному и тому же, потому что неоднозначность живёт в ваших данных, а не в декодере.
Ваш выходной контракт тоже остаётся неизменным, и так должно быть. Всё, что возвращает провайдер, должно удовлетворять одному и тому же парсеру: имена свойств в двойных кавычках, никаких завершающих запятых, никаких NaN или Infinity, и только четыре допустимых пробельных символа (пробел, табуляция, перевод строки, возврат каретки) (MDN). Напишите схему один раз. Валидируйте все три вывода одним валидатором и сравнивайте сбои.
Держите набор тестов нейтральным к провайдеру. Двадцать случаев, которые проходят на Claude и не проходят на Gemini, говорят вам кое-что полезное. Двадцать случаев, написанных под особенности Claude, не говорят вам ничего.
Что вы перенастраиваете для каждого провайдера: вес системного сообщения, разделители, API применения
Три вещи получают адаптер. Сколько вашей инструкции идёт в системное сообщение, а сколько — в пользовательский ход, поскольку провайдеры взвешивают их по-разному. Что вы используете для разделения блоков — XML-подобные теги или заголовки markdown. И какой API применения вы вызываете.
Последнее — самая сложная часть. Режим JSON любого вида обеспечивает синтаксис и на этом останавливается: наблюдения в продакшене дают около 95–99% синтаксически валидных, тогда как ограничение генерации по предоставленной схеме — фактически 100% (Ashvara). Ни один уровень не говорит ничего о том, являются ли ключи теми, что вы запросили, поэтому проверка схемы остаётся в вашем коде независимо от того, какой провайдер вы используете. Если вы выбираете цели, стоит сделать проход для сравнения самих моделей перед тем как определиться, а многопровайдерные платформы в нашем каталоге возьмут на себя часть этой адаптерной работы.
Чеклист переносимости перед отправкой
- Удалите каждое предложение, в котором называется модель, версия или известное поведение одной из них. Это строки, которые ломаются первыми.
- Запустите одинаковый набор тестов против всех трёх провайдеров и записывайте процент прохождения по каждому случаю, а не только среднее.
- Убедитесь, что валидатор схемы запускается для каждого ответа независимо от того, заявляет ли провайдер о поддержке декодирования с ограничением.
- Перечитайте документацию по применению каждого провайдера при подключении адаптера и держите любые необходимые формулировки или флаги внутри адаптера, а не в общем промпте.
- Записывайте, какой адаптер сработал. Когда выходит чекпоинт и качество меняется, вы хотите знать, изменился ли под вами промпт или адаптер.
Если промпт не проходит этот чеклист только на одном провайдере, ошибка почти всегда в адаптере, а не в оболочке.
Часто задаваемые вопросы
Нужно ли переписывать промпты каждый раз, когда выходит новая модель?
Нет, и если вы это делаете, ваш промпт, вероятно, содержал специфичные для модели хаки, а не инструкции. Части, пережившие обновления, — это те, что привязаны к чему-то за пределами модели: описанию задачи, входным данным и выходному контракту вроде JSON-схемы. Декодирование с ограничением по предоставленной схеме даёт фактически 100% синтаксически валидного JSON независимо от того, какая модель стоит за ним, потому что ограничение живёт в декодере. При смене модели вам не нужно ничего переписывать. Что нужно перезапустить — это ваш набор тестов.
«Думай шаг за шагом» по-прежнему работает на современных моделях?
В основном это мёртвый груз. Эта фраза была обходным решением для моделей, которые сразу переходили к ответу, а современные модели уже декомпозируют многошаговую работу без подсказок. Хуже того, добавление её к промпту, требующему строгого вывода JSON, приглашает модель выводить рассуждения в прозе вокруг объекта, что является именно тем классом сбоев, который толкает наивные промпты к расчётным 5–10% некорректного JSON. Если вам нужны рассуждения, дайте им именованное поле в вашей схеме и позвольте парсеру держать их отдельно от полезной нагрузки.
Достаточно ли режима JSON или нужна схема?
Используйте схему. Режим JSON выводит вас примерно на 95–99% синтаксически валидного вывода, что звучит нормально, пока вы не запускаете десять тысяч вызовов в день и не получаете сотню сбоев. Декодирование с ограничением по схеме доводит синтаксическую валидность до фактически 100%, а также фиксирует имена ваших ключей, что важно, поскольку RFC 8259 рассматривает JSON-объект как неупорядоченный набор пар имя–значение и только рекомендует уникальные имена. Синтаксическая валидность — это не семантическая корректность, поэтому в любом случае продолжайте валидировать разобранный объект по своим правилам.
Сколько few-shot примеров должен включать устойчивый промпт?
Два-четыре, и выбирайте их за охват граничных случаев, а не за объём. Примеры, показывающие один и тот же счастливый путь снова и снова, не учат модель ничему, чего она ещё не умеет; примеры, фиксирующие неудобные случаи, — это те, что переносятся между моделями. Для структурированного вывода потратьте хотя бы один пример на различие между пустым контейнером и отсутствующим значением, поскольку [пустой объект {} и пустой массив [] — оба валидные JSON, но семантически отличаются от null](https://jsonic.io/guides/json-examples). Если ваши примеры содержат форматирование, которое строгий парсер отверг бы, вы обучаете сбою: завершающие запятые одни составляют около 40% ошибок JSON в одном анализе.
Насколько большим должен быть набор тестов промпта, чтобы быть полезным?
Тридцать-пятьдесят размеченных случаев поймают большинство регрессий, и двадцать лучше, чем ноль, с которым работают большинство команд. Размер важен меньше, чем состав: акцентируйте набор на режимах отказа, которые вы реально видели в продакшене, — ключи без кавычек, одинарные кавычки, неэкранированные кавычки внутри строк, отсутствующие запятые и скрытые символы UTF-8 BOM, все из которых встречаются в задокументированных разбивках ошибок JSON. Запускайте валидацию перед форматированием, чтобы выявлять структурные поломки, а не маскировать их, — именно такой рабочий процесс рекомендует QuickTinyData. Версионируйте набор вместе с промптом и перезапускайте его в день выхода новой модели.
Может ли один и тот же промпт действительно работать без изменений в Claude, GPT и Gemini?
Тело инструкции переносится чисто. Слой применения вывода — нет, потому что режим JSON и декодирование с ограничением по схеме настраиваются по-разному для каждого провайдера, поэтому планируйте один промпт и три тонких адаптера. Хранение контракта в формате, с которым каждый провайдер уже согласен, помогает: RFC 8259 не зависит от языка и определяет четыре примитивных типа плюс объекты и массивы, с true, false и null в нижнем регистре как единственными литеральными именами. Если вы ищете инструменты для управления промптами между провайдерами, наш каталог содержит 212 инструментов промптинга и 324 записи в разделе AI-моделей.